Kubernetes — рушій оркестрування контейнерів, створений для автоматичного розгортання, масштабування і управління контейнеризованими застосунками, є проєктом з відкритим вихідним кодом. Цей проєкт знаходиться під егідою Cloud Native Computing Foundation.
2.1 - Доступні версії документації
Цей вебсайт містить документацію для поточної версії Kubernetes та чотирьох попередніх версій Kubernetes.
Доступність документації для версії Kubernetes не повʼязана з тим, чи підтримується ця версія. Дізнайтеся більше про період підтримки, щоб дізнатися, які версії Kubernetes офіційно підтримуються і як довго.
3 - Стандартні атрибути пристроїв для динамічного виділення ресурсів
Kubernetes визначає набір стандартних атрибутів пристроїв у домені resource.kubernetes.io для використання з динамічним виділенням ресурсів (DRA). Ці атрибути мають чітко визначену семантику, тому обмеження matchAttribute працюють для пристроїв з різних драйверів DRA без необхідності знань, специфічних для драйвера.
Драйверам DRA рекомендується публікувати ці атрибути, коли це доречно. Допоміжна бібліотека DRA Kubernetes (k8s.io/dynamic-resource-allocation/deviceattribute) надає функції, які драйвери можуть викликати для отримання правильних значень з sysfs.
Стандартні атрибути
resource.kubernetes.io/numaNode
Визначає топологію NUMA пристрою. Цей атрибут може бути:
Скалярним цілим числом: фізичний вузол NUMA пристрою, зчитаний із запису numa_node у sysfs ядра. Ця форма працює без жодної функціональної можливості.
Списком цілих чисел (потребує функціональної можливості DRAListTypeAttributes): фізичний вузол NUMA, за яким ідуть вузли NUMA того самого сокета на мінімальній відстані ACPI SLIT. Наприклад, у системі AMD EPYC з 4 вузлами NUMA на сокет, пристрій на вузлі NUMA 5 може публікувати [5, 4, 6, 7], щоб вказати, що вузли NUMA 4, 6 та 7 знаходяться на тому самому сокеті та рівновіддалені.
Використовуйте matchAttribute разом із цим атрибутом, щоб розмістити пристрої з різних драйверів на одному NUMA-вузлі. При використанні значень типу списку планувальник виконує операцію перетину множин: два пристрої вважаються сумісними, якщо їхні списки NUMA-вузлів мають хоча б одне спільне значення.
Пристрої без спорідненості NUMA (numa_node = -1 у sysfs) не повинні публікувати цей атрибут.
Допоміжні функції для авторів драйверів DRA:
GetNUMANodeAttributeByPCIBusID(pciBusID, attrForm): для пристроїв PCI (GPU, NIC, контролерів NVMe). Зчитує numa_node з sysfs і, коли attrForm є ListAttribute, обчислює список на основі SLIT.
GetNUMANodeAttribute(numaNode, attrForm): для пристроїв, які вже знають свій вузол NUMA (CPU, памʼять).
GetNUMANodeForCPU(cpuID): повертає вузол NUMA для ядра CPU.
resource.kubernetes.io/pciBusID
Адреса шини PCI пристрою PCI у розширеній нотації BDF (Domain:Bus:Device.Function). Цей атрибут однозначно ідентифікує пристрій PCI на вузлі.
resource.kubernetes.io/pcieRoot
PCIe Root Complex пристрою PCI у форматі pci<domain>:<bus>. Пристрої, які спільно використовують той самий PCIe Root Complex, підключені до тієї самої ієрархії комутаторів PCIe. Використовуйте matchAttribute з цим атрибутом, щоб розміщувати пристрої під тим самим коренем PCIe для звʼязку з найменшою затримкою.
4 - Початок роботи
У цьому розділі розглянуто різні варіанти налаштування і запуску Kubernetes.
Різні рішення Kubernetes відповідають різним вимогам: легкість в експлуатації, безпека, система контролю, наявні ресурси та досвід, необхідний для управління кластером.
Ви можете розгорнути Kubernetes кластер на робочому комп'ютері, у хмарі чи в локальному дата-центрі, або обрати керований Kubernetes кластер. Також можна створити індивідуальні рішення на базі різних провайдерів хмарних сервісів або на звичайних серверах.
Простіше кажучи, ви можете створити Kubernetes кластер у навчальному і в прод оточеннях.
Навчальне оточення
Для вивчення Kubernetes використовуйте рішення на базі Docker: інструменти, підтримувані спільнотою Kubernetes, або інші інструменти з сімейства проектів для налаштування Kubernetes кластера на локальному комп'ютері.
Таблиця інструментів для локального розгортання Kubernetes, які підтримуються спільнотою або входять до сімейства проектів Kubernetes.
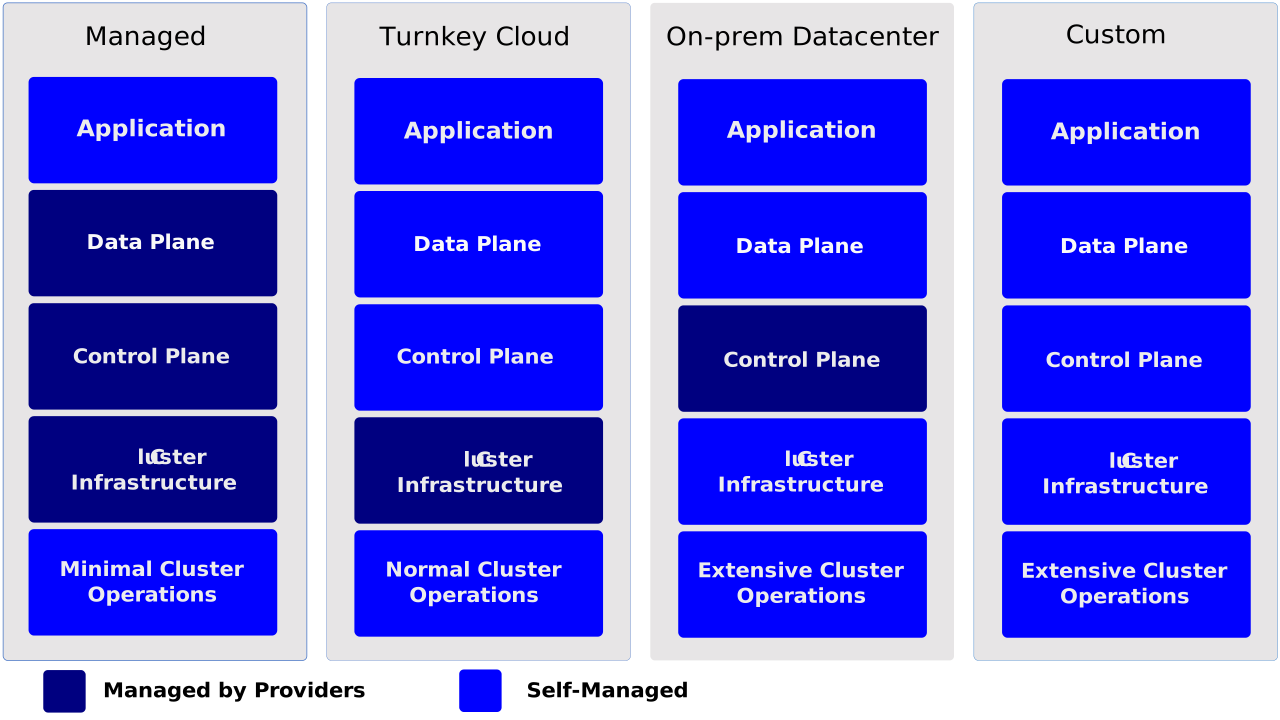
Обираючи рішення для проду, визначіться, якими з функціональних складових (або абстракцій) Kubernetes кластера ви хочете керувати самі, а управління якими - доручити провайдеру.
На діаграмі нижче показані можливі абстракції Kubernetes кластера із зазначенням, які з них потребують самостійного управління, а які можуть бути керовані провайдером.
Рішення для прод оточення
Таблиця рішень для прод оточення містить перелік провайдерів і технологій, які вони пропонують.
Таблиця рішень для прод оточення містить перелік провайдерів і їх технологій.
4.3.1 - Встановлення Kubernetes за допомогою інструментів розгортання
4.3.1.1 - Запуск кластерів з kubeadm
4.4 - Найкращі практики
5 - Рецензування змін
У цьому розділі описано, як рецензувати вміст.
6 - Концепції
Розділ "Концепції" допоможе вам дізнатися про складові системи Kubernetes та абстракції, які використовує Kubernetes для представлення вашого кластера, а також краще зрозуміти, як працює Kubernetes.
6.1 - Огляд
Kubernetes — це переносима, розширювана та відкрита платформа для управління контейнеризованими робочими навантаженнями та сервісами, яка полегшує як декларативне налаштування, так і автоматизацію. Вона має велику екосистему, яка швидко зростає. Сервіси, підтримка та інструменти Kubernetes широко доступні.
Ця сторінка містить огляд Kubernetes.
Назва Kubernetes (/ˌk(j)uːbərˈnɛtɪs, Кубернетіс) походить від грецького слова, що означає особу, що керує кораблем — керманич1. K8s — це скорочення Kubernetes, яке складається з першої літери «K», потім восьми літер і, нарешті, літери «s». Google зробив Kubernetes проєктом з відкритим кодом у 2014 році. Kubernetes поєднує понад 15 років досвіду Google запуску промислових робочих навантажень у великому масштабі з найкращими ідеями та практиками спільноти.
Чому вам потрібен Kubernetes та що він може робити?
Контейнери — це гарний спосіб обʼєднати та запустити ваші застосунки. У промисловому середовищі вам потрібно керувати контейнерами, які запускають застосунки, і гарантувати відсутність простоїв. Наприклад, якщо контейнер падає, повинен запуститися інший контейнер. Чи не було б легше, якби такою поведінкою займалася система?
Ось саме тут Kubernetes приходить на допомогу! Kubernetes надає вам основу для надійного запуску розподілених систем. Він піклується про масштабування та відмовостійкість для ваших застосунків, забезпечує шаблони розгортання та багато іншого. Наприклад, Kubernetes може легко керувати канарковими розгортаннями (canary deployment) для вашої системи.
Kubernetes пропонує:
Виявлення сервісів та балансування навантаження
Kubernetes може надати доступ до контейнера за допомогою імені DNS або його власної IP-адреси. Якщо навантаження на контейнер зростає, Kubernetes може балансувати навантаження та розподіляти мережевий трафік, що робить роботу розгортання стабільною.
Оркестрування зберігання
Kubernetes дозволяє автоматично монтувати вибрану вами систему зберігання, наприклад локальне сховище, сховища публічних хмарних провайдерів тощо.
Автоматизоване розгортання та відкочування
Ви можете описати бажаний стан розгорнутих контейнерів, використовуючи Kubernetes, і він може змінювати фактичний стан на бажаний із контрольованою швидкістю. Наприклад, ви можете автоматизувати Kubernetes так, щоб він створював нові контейнери для вашого розгортання, видаляв наявні контейнери та передавав усі їхні ресурси новому контейнеру.
Автоматичне пакування
Ви надаєте Kubernetes кластер вузлів, які він може використовувати для виконання контейнеризованих завдань. Ви вказуєте Kubernetes, скільки процесорних потужностей (ЦП) та памʼяті (ОЗП) потрібно кожному контейнеру. Kubernetes може помістити контейнери на ваші вузли, щоб найкращим чином використовувати ресурси.
Самозцілення
Kubernetes перезапускає контейнери, які зазнали збою, замінює контейнери, завершує контейнери, які не відповідають на задану користувачем перевірку стану, і не показує їх клієнтам, доки вони не будуть готові до обслуговування.
Керування секретами та конфігурацією
Kubernetes дозволяє зберігати чутливі дані й керувати ними, зокрема паролі, OAuth-токени та SSH-ключі. Ви можете розгортати та оновлювати секрети й конфігурацію застосунків без перезбирання образів контейнерів і без розкриття секретів у конфігурації вашого стеку.
Пакетне виконання
Окрім сервісів, Kubernetes може керувати вашими пакетними та CI-навантаженнями, за потреби замінюючи контейнери, що зазнали збою.
Горизонтальне масштабування
Масштабуйте застосунок угору та вниз простою командою, через UI або автоматично залежно від використання ЦП.
Подвійний мережевий стек IPv4/IPv6
Виділення адрес IPv4 та IPv6 для Podʼів та Services.
Розширюваність за задумом
Додавайте нові функції до свого кластера Kubernetes без зміни основного коду Kubernetes.
Чим не є Kubernetes?
Kubernetes не є традиційною всеохопною PaaS-платформою (Platform as a Service). Оскільки Kubernetes працює на рівні контейнерів, а не на апаратному рівні, він надає деякі загальноприйняті функції PaaS, такі як розгортання, масштабування, балансування навантаження, і дозволяє користувачам інтегрувати власні рішення для логування, моніторингу та оповіщення. Однак Kubernetes не є монолітним, і ці стандартні рішення є необовʼязковими та підключуваними. Kubernetes надає будівельні блоки для створення платформ для розробників, але зберігає свободу вибору та гнучкість там, де це важливо.
Kubernetes:
Не обмежує типи підтримуваних застосунків. Kubernetes прагне підтримувати надзвичайно різноманітні робочі навантаження, включаючи stateless (без збереження стану), stateful (зі збереженням стану) та навантаження з обробки даних. Якщо застосунок може працювати в контейнері, він повинен чудово працювати в Kubernetes.
Не розгортає вихідний код і не збирає ваш застосунок. Робочі процеси безперервної інтеграції, доставки та розгортання (CI/CD) визначаються культурою та уподобаннями організації, а також технічними вимогами.
Не надає сервіси на рівні застосунків, такі як проміжне програмне забезпечення (middleware, наприклад, шини повідомлень), фреймворки обробки даних (наприклад, Spark), бази даних (наприклад, MySQL), кеші або кластерні системи зберігання (наприклад, Ceph) як вбудовані сервіси. Такі компоненти можуть працювати в Kubernetes та/або бути доступними застосункам, що працюють в Kubernetes, за допомогою переносних механізмів, таких як Open Service Broker.
Не диктує рішення для логування, моніторингу або оповіщення. Він забезпечує деякі інтеграції як доказ концепції та механізми збору та експорту метрик.
Не надає та не ставить вимог щодо мови/системи конфігурації (наприклад, Jsonnet). Він надає декларативний API, який може використовуватись довільними формами декларативних специфікацій.
Не надає та не застосовує жодних комплексних систем конфігурації, обслуговування, управління або самозцілення машин.
Крім того, Kubernetes — це не просто система оркестрування. Насправді він усуває необхідність оркестрування. Технічним визначенням оркестрування є виконання визначеного робочого процесу: спочатку зробіть A, потім B, потім C. На відміну від цього, Kubernetes складається з набору незалежних компонованих процесів управління, які безперервно наближають поточний стан до заданого бажаного стану. Не має значення, як ви перейдете від A до C. Централізоване управління також не потрібне. Завдяки цьому система простіша у використанні, потужніша, надійніша, стійкіша та краще розширюється.
Історичний контекст появи Kubernetes
Погляньмо на те, чому Kubernetes настільки корисний, повернувшись в минуле.
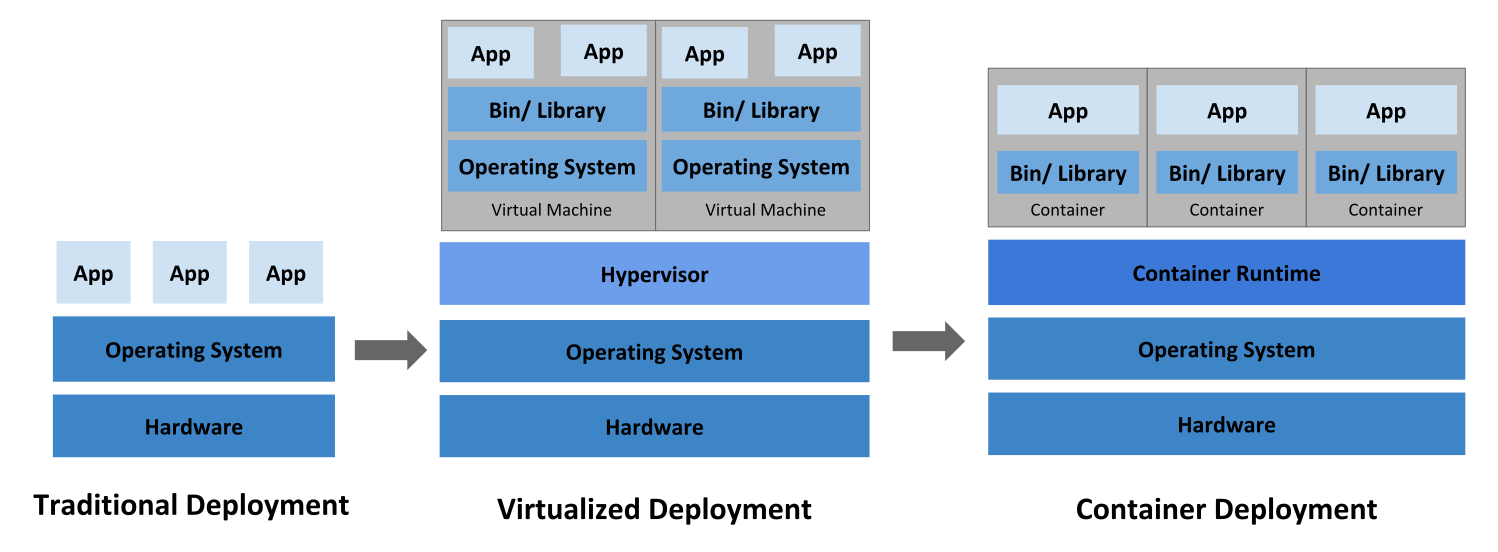
Ера традиційного розгортання:
Спочатку організації запускали свої застосунки на фізичних серверах. Не було можливості визначити межі ресурсів для застосунків на фізичному сервері, і це спричиняло проблеми з розподілом ресурсів. Наприклад, якщо на фізичному сервері працює кілька застосунків, можуть бути випадки, коли один застосунок займе більшу частину ресурсів, і в результаті інші застосунки працюватимуть гірше. Рішенням було б запускати кожен застосунок на окремому фізичному сервері. Але це не масштабувалося, оскільки ресурси використовувалися не повністю, і організаціям було дорого підтримувати багато фізичних серверів.
Ера віртуалізованого розгортання:
Як розвʼязання цієї проблеми виникла віртуалізація. Вона дозволяє запускати кілька віртуальних машин (VM) на ЦП одного фізичного сервера. Віртуалізація дозволяє ізолювати застосунки в межах віртуальних машин та надає такий рівень безпеки, що інформація з одного застосунку не може бути вільно доступною в іншому застосунку.
Віртуалізація дозволяє краще використовувати ресурси фізичного сервера та забезпечує кращу масштабованість, оскільки застосунок можна легко додати чи оновити, зменшує витрати на апаратне забезпечення та дає багато іншого. За допомогою віртуалізації ви можете представити набір фізичних ресурсів у вигляді кластера одноразових віртуальних машин.
Кожна віртуальна машина є повноцінною машиною, на якій працюють усі компоненти, включаючи власну операційну систему, поверх віртуалізованого апаратного забезпечення.
Ера контейнеризації:
Контейнери подібні до віртуальних машин, але вони мають менш суворі умови ізоляції, що дозволяє застосункам спільно використовувати операційну систему (ОС). Тому контейнери вважаються легшими, ніж віртуальні машини. Так само як і віртуальні машини, контейнер має власну файлову систему, частку ЦП, памʼять, простір процесів тощо. Оскільки вони відокремлені від базової інфраструктури, їх просто переносити між хмарами та дистрибутивами ОС.
Контейнери набули популярності, оскільки вони надають додаткові переваги, такі як:
Гнучке створення та розгортання застосунків: підвищено простоту та ефективність створення образу контейнера порівняно з використанням образу віртуальної машини.
Безперервна розробка, інтеграція та розгортання: забезпечує надійне та часте створення та розгортання образу контейнера зі швидким та ефективним відкатом (через незмінність образу).
Розділення обовʼязків Dev та Ops: створення образів контейнерів застосунків під час збирання/випуску, а не під час розгортання, тим самим застосунки відокремлюються від інфраструктури.
Спостережуваність: не тільки відображає інформацію та метрики на рівні ОС, але й стан застосунків та інші сигнали.
Узгодженість середовищ розробки, тестування та промислової експлуатації: все працює так само на ноутбуці, як і в хмарі.
Переносимість між хмарами та дистрибутивами ОС: працює на Ubuntu, RHEL, CoreOS, у власній інфраструктурі, в основних публічних хмарах і будь-де ще.
Управління, орієнтоване на застосунки: підвищує рівень абстракції від запуску ОС на віртуальному обладнанні до запуску застосунків в ОС з використанням логічних ресурсів.
Слабко повʼязані, розподілені, еластичні, звільнені мікросервіси: застосунки розбиваються на менші, незалежні частини та можуть бути розгорнуті та керовані динамічно — на відміну від монолітного стека, що працює на одній великій спеціально призначеній для цього машині.
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
Ваш кластер може потребувати додаткового програмного забезпечення на кожному вузлі; наприклад, ви можете також запускати systemd на вузлі Linux для контролю локальних компонентів.
Надбудови
Надбудови розширюють функціональність Kubernetes. Ось кілька важливих прикладів:
Для збереження логів контейнерів у централізованому сховищі логів.
Гнучкість архітектури
Kubernetes дозволяє гнучко розгортати ці компоненти та керувати ними. Архітектуру можна адаптувати до різних потреб, від невеликих середовищ розробки до великомасштабних промислових розгортань.
Для отримання більш детальної інформації про кожен компонент та різні способи налаштування кластерної архітектури, дивіться сторінку Архітектура кластера.
6.1.2 - Обʼєкти в Kubernetes
Обʼєкти Kubernetes є постійними сутностями в системі Kubernetes. Kubernetes використовує ці сутності для подання стану вашого кластера. Дізнайтеся про модель обʼєктів Kubernetes та про те, як працювати з цими обʼєктами.
Ця сторінка пояснює, як обʼєкти Kubernetes подаються в API Kubernetes, та як ви можете описати їх у форматі .yaml.
Розуміння обʼєктів Kubernetes
Обʼєкти Kubernetes є постійними сутностями в системі Kubernetes. Kubernetes використовує ці сутності для подання стану вашого кластера. Зокрема, вони можуть описувати:
Які контейнеризовані застосунки працюють (і на яких вузлах)
Ресурси, доступні для цих застосунків
Політики щодо того, як ці застосунки поводяться, такі як політики перезапуску, оновлення та стійкості до відмов
Обʼєкт Kubernetes є "записом про наміри" — після створення обʼєкта система Kubernetes постійно працюватиме, щоб переконатися, що обʼєкт існує. Створюючи обʼєкт, ви фактично повідомляєте системі Kubernetes ваші побажання щодо того, як має виглядати робоче навантаження вашого кластера; це бажаний стан вашого кластера.
Для роботи з обʼєктами Kubernetes — чи то для створення, зміни чи видалення — вам потрібно використовувати API Kubernetes. Наприклад, коли ви використовуєте інтерфейс командного рядка kubectl, CLI виконує необхідні виклики API Kubernetes за вас. Ви також можете використовувати API Kubernetes безпосередньо у ваших власних програмах за допомогою однієї з клієнтських бібліотек.
Специфікація та стан обʼєкта
Майже кожен обʼєкт Kubernetes містить два вкладених поля обʼєкта, які керують конфігурацією обʼєкта: spec та status обʼєкта. Для обʼєктів, які мають spec, вам потрібно встановити його під час створення обʼєкта, надаючи опис характеристик, які ви хочете, щоб ресурс мав: його бажаний стан.
status описує поточний стан обʼєкта, який надається та оновлюється системою Kubernetes та її компонентами. Панель управління Kubernetes постійно та активно керує фактичним станом кожного обʼєкта, щоб він відповідав бажаному стану, який ви вказали.
Наприклад: у Kubernetes Deployment є обʼєктом, який може представляти застосунок, який працює на вашому кластері. При створенні Deployment ви можете встановити spec Deployment, щоб вказати, що ви хочете, щоб працювало три репліки застосунку. Система Kubernetes читає spec Deployment та запускає три екземпляри вашого застосунку, оновлюючи status відповідно до вашого spec. Якщо один із цих екземплярів зазнає збою (зміна стану), система Kubernetes реагує на відмінність між spec та status, вносячи виправлення: у цьому випадку запускаючи екземпляр на заміну.
З докладнішою інформацією про spec, status та metadata обʼєктів Kubernetes звертайтесь до Kubernetes API Conventions.
Опис обʼєктів Kubernetes
Коли ви створюєте обʼєкт Kubernetes, ви повинні визначити spec обʼєкта, який описує бажаний стан обʼєкта, а також деякі основні відомості про обʼєкт, наприклад його назву (name). Коли ви використовуєте API Kubernetes для створення обʼєкта, чи безпосередньо, чи за допомогою kubectl, цей запит до API має містити ці відомості у вигляді JSON в тілі запиту. Найчастіше інформація про обʼєкт подається kubectl у вигляді файлу, який називається маніфестом. За домовленістю, маніфести обʼєктів Kubernetes подаються у форматі YAML (ви також можете використовувати JSON). Інструменти, такі як kubectl, перетворюють інформацію з маніфесту у JSON або інший підтримуваний формат серіалізації, надсилаючи HTTP-запити до API.
Ось приклад маніфесту, який містить обовʼязкові поля обʼєкта та його spec для Kubernetes Deployment:
apiVersion:apps/v1kind:Deploymentmetadata:name:nginx-deploymentspec:selector:matchLabels:app:nginxreplicas:2# tells deployment to run 2 pods matching the templatetemplate:metadata:labels:app:nginxspec:containers:- name:nginximage:nginx:1.14.2ports:- containerPort:80
Один зі способів створення Deployment за допомогою маніфесту, подібного до показаного вище, — використання команди kubectl apply в інтерфейсі командного рядка kubectl, передаючи файл .yaml як аргумент. Ось приклад:
В маніфесті (файл YAML або JSON) обʼєкта Kubernetes, який ви хочете створити, ви повинні вказати значення для таких полів:
apiVersion — версія API Kubernetes, яку ви використовуєте для створення обʼєкта
kind — тип обʼєкта, який ви хочете створити
metadata — дані, які допомагають унікально ідентифікувати обʼєкт, включаючи рядок name, UID та, необовʼязково, namespace
spec — опис бажаного стану обʼєкта
Точний формат spec обʼєкта є різним для кожного типу обʼєкта в Kubernetes та містить вкладені поля, що притаманні конкретному типу обʼєкта. Довідник API Kubernetes може допомогти знайти формат spec для всіх типів обʼєктів, які ви можете створити за допомогою Kubernetes.
Наприклад, подивіться на поле spec для обʼєкта Pod. Для кожного Podʼа поле .spec описує Pod та його бажаний стан (наприклад, назву образу контейнера для кожного контейнера всередині цього Podʼа). Інший приклад специфікації обʼєкта — поле spec для обʼєкта StatefulSet. Для StatefulSet поле .spec описує StatefulSet та його бажаний стан. У .spec StatefulSet є шаблон для обʼєктів Pod. Цей шаблон описує Podʼи, які контролер StatefulSet створить, щоб задовольнити специфікацію StatefulSet. Різні типи обʼєктів Kubernetes можуть мати різні .status; дивіться довідник API Kubernetes для отримання відомостей про структуру поля .status та його вміст для кожного типу обʼєкта.
Починаючи з Kubernetes v1.25, API-сервер надає перевірку полів на стороні сервера, яка виявляє невідомі та дубльовані поля в обʼєкті. Це надає всю функціональність kubectl --validate на стороні сервера.
kubectl використовує прапорець --validate для встановлення рівня перевірки полів маніфесту. Його значенням може бути ignore, warn та strict, також можна вказати true (еквівалент strict) та false (еквівалент ignore). Типове значення перевірки для kubectl — --validate=true.
Strict
Сувора перевірка, повертає збій під час виявлення помилок.
Warn
Перевірка виконується, але виявлення помилок призводить до виведення попереджень, а не збою.
Ignore
Перевірка на стороні сервера не виконується.
Якщо kubectl не може підʼєднатися до API-сервера, який підтримує перевірку полів, він використовує перевірку на стороні клієнта. Kubernetes v1.27 та пізніші версії завжди пропонуватимуть перевірку полів; версії до v1.27, скоріш за все — ні. Якщо версія Kubernetes на вашому кластері старіша за v1.27, звіртесь з документацією до вашої версії Kubernetes.
Що далі
Якщо ви тільки починаєте свій шлях в Kubernetes, дізнайтесь більше про:
Щоб глибше ознайомитися з обʼєктами в Kubernetes, прочитайте інші сторінки цього розділу:
6.1.2.1 - Управління обʼєктами Kubernetes
Інструмент командного рядка kubectl підтримує кілька різних способів створення та управління обʼєктами Kubernetes. Цей документ надає огляд різних підходів. Для отримання деталей щодо управління обʼєктами за допомогою Kubectl читайте Книгу Kubectl.
Техніки управління
Попередження:
Обʼєкт Kubernetes повинен управлятися лише з використанням однієї техніки. Змішування різних технік для того самого обʼєкта призводить до невизначеної поведінки.
Техніка управління
Діє на
Рекомендоване середовище
Підтримувані автори змін
Крива навчання
Імперативні команди
Живі обʼєкти
Проєкти розробки
1+
Найлегша
Імперативна конфігурація обʼєктів
Окремі файли
Промислові проєкти
1
Середня
Декларативна конфігурація обʼєктів
Теки файлів
Промислові проєкти
1+
Найскладніша
Імперативні команди
Під час використання імперативних команд користувач працює безпосередньо з живими обʼєктами в кластері. Користувач надає операції команді kubectl у вигляді аргументів чи прапорців.
Це рекомендований спосіб початку роботи або виконання одноразового завдання в кластері. Оскільки цей метод працює безпосередньо з живими обʼєктами, він не зберігає історії попередніх конфігурацій.
Команди вимагають лише одного кроку для внесення змін до кластера.
Недоліки порівняно із конфігуруванням обʼєктів:
Команди не інтегруються з процесами перегляду змін.
Команди не надають журналу аудиту, повʼязаного зі змінами.
Команди не надають джерела записів, окрім самих живих обʼєктів.
Команди не надають шаблону для створення нових обʼєктів.
Імперативне конфігурування обʼєктів
В імперативній конфігурації обʼєктів команда kubectl вказує операцію (create, replace тощо), необовʼязкові прапорці та принаймні одне імʼя файлу. Зазначений файл повинен містити повне визначення обʼєкта у форматі YAML або JSON.
Див. API-довідник для отримання докладніших відомостей щодо визначення обʼєктів.
Попередження:
Імперативна команда replace замінює поточну специфікацію на нову, відкидаючи всі зміни обʼєкта, яких немає у файлі конфігурації. Цей підхід не повинен використовуватися із типами ресурсів, специфікації яких оновлюються незалежно від файлу конфігурації. Наприклад, у Services типу LoadBalancer поле externalIPs оновлюється кластером незалежно від файлу конфігурації.
Приклади
Створити обʼєкти, визначені у файлі конфігурації:
kubectl create -f nginx.yaml
Видалити обʼєкти, визначені у двох файлах конфігурації:
kubectl delete -f nginx.yaml -f redis.yaml
Оновити обʼєкти, визначені у файлі конфігурації, перезаписавши живу конфігурацію:
kubectl replace -f nginx.yaml
Компроміси
Переваги порівняно з імперативними командами:
Конфігурація обʼєктів може зберігатися у системі контролю версій, такій як Git.
Конфігурація обʼєктів може інтегруватися з процесами, такими як перегляд змін перед надсиланням (push) та журнали аудиту.
Конфігурація обʼєктів надає шаблон для створення нових обʼєктів.
Недоліки порівняно з імперативними командами:
Конфігурація обʼєктів потребує базового розуміння схеми обʼєкта.
Конфігурація обʼєктів потребує додаткового кроку у вигляді написання файлу YAML.
Переваги порівняно із декларативною конфігурацією обʼєктів:
Поведінка імперативної конфігурації обʼєктів простіша та її легше зрозуміти.
Станом на версію Kubernetes 1.5 імперативна конфігурація обʼєктів є більш зрілою.
Недоліки порівняно із декларативною конфігурацією обʼєктів:
Імперативна конфігурація обʼєктів працює краще з файлами, а не з теками.
Оновлення живих обʼєктів мають відображатися у файлах конфігурації, інакше вони будуть втрачені під час наступної заміни.
Декларативна конфігурація обʼєктів
Під час використання декларативної конфігурації обʼєктів користувач працює з конфігураційними файлами обʼєктів, збереженими локально, проте користувач не визначає операції, які слід виконати над файлами. Операції створення, оновлення та видалення автоматично визначаються для кожного обʼєкта за допомогою kubectl. Це дозволяє працювати з теками, де для різних обʼєктів можуть бути потрібні різні операції.
Примітка:
Декларативна конфігурація обʼєктів зберігає зміни, внесені іншими авторами, навіть якщо зміни не зливаються назад у файл конфігурації обʼєкта. Це можливо за допомогою використання операції API patch для запису тільки виявлених відмінностей, замість використання операції API replace для заміни всього файлу конфігурації обʼєкта.
Приклади
Обробити всі файли конфігурації обʼєктів у теці configs та створити або внести патчі до живих обʼєктів. Спочатку ви можете використовувати diff, щоб побачити, які зміни будуть внесені, а потім застосувати їх:
Переваги порівняно з імперативною конфігурацією обʼєктів:
Зміни, внесені безпосередньо в живі обʼєкти, зберігаються, навіть якщо вони не зливаються назад у файли конфігурації.
Декларативна конфігурація обʼєктів краще підтримує роботу з теками та автоматично визначає типи операцій (створення, патч, видалення) для кожного обʼєкта.
Недоліки порівняно з імперативною конфігурацією обʼєктів:
Декларативну конфігурацію обʼєктів важче налагоджувати, а її результати важче зрозуміти, коли вони неочікувані.
Часткові оновлення за допомогою diffs створюють складні операції злиття та накладання патчів.
Кожен обʼєкт у вашому кластері має Назву, яка є унікальною для цього типу ресурсу. Кожен обʼєкт Kubernetes також має UID, який є унікальним в усьому вашому кластері.
Наприклад, ви можете мати лише один обʼєкт Pod із назвою myapp-1234 в одному й тому самому просторі імен, а також ви можете мати один обʼєкт Pod та один Deployment із назвами myapp-1234 кожен.
Наданий клієнтом рядок, який посилається на обʼєкт в URL ресурсу, наприклад /api/v1/pods/some-name.
Водночас лише один обʼєкт певного виду (kind) може мати певну назву. Проте якщо ви видалите обʼєкт, ви можете створити новий обʼєкт з такою самою назвою.
Назви повинні бути унікальними між усіма версіями API того самого ресурсу.
Kubernetes унікально ідентифікує обʼєкти за допомогою комбінації чотирьох атрибутів:
Група API (наприклад, apps)
Тип ресурсу (наприклад, deployments)
Простір імен (для ресурсів із просторами імен)
Назва
Хоча ви можете отримати доступ до ресурсу через різні версії API (наприклад, v1 або v1beta1), версія є просто іншим представленням того самого базового обʼєкта. Оскільки версія не є частиною унікальної ідентифікації, ви не можете створити два обʼєкти з однаковою назвою та типом ресурсу в одному просторі імен, використовуючи різні версії API.
Примітка:
У випадках, коли обʼєкти представляють фізичний обʼєкт, наприклад, Node, що представляє фізичний хост, коли хост створюється заново з тією самою назвою без видалення та повторного створення Node, Kubernetes розглядає новий хост як старий, що може призвести до неузгодженостей.
Сервер може згенерувати назву, якщо в запиті на створення ресурсу замість name вказати generateName. Коли використовується generateName, надане значення використовується як префікс назви, до якого сервер додає згенерований суфікс. Навіть якщо назву згенеровано, вона може конфліктувати з наявними назвами, що призведе до відповіді HTTP 409. Це стало набагато менш імовірним в Kubernetes v1.31 і пізніших версіях, оскільки сервер зробить до 8 спроб згенерувати унікальну назву перед тим, як повернути відповідь HTTP 409.
Нижче наведено чотири типи обмежень на назви ресурсів, які часто використовуються.
Назви DNS-піддоменів
Більшість типів ресурсів потребують назви, яку можна використовувати як DNS-піддомен згідно з RFC 1123. Це означає, що назва повинна:
містити не більше 253 символів
містити лише буквено-цифрові символи, '-' чи '.' в нижньому регістрі
починатися буквено-цифровим символом
закінчуватися буквено-цифровим символом
Назви міток RFC 1123
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1123. Це означає, що назва повинна:
містити не більше 63 символів
містити лише буквено-цифрові символи чи '-' в нижньому регістрі
починатися алфавітним символом
закінчуватися буквено-цифровим символом
Примітка:
Коли увімкнено функціональну можливість RelaxedServiceNameValidation, назви обʼєктів Service можуть починатися з цифри.
Назви міток RFC 1035
Деякі типи ресурсів вимагають, щоб їх назви відповідали стандарту міток DNS, як визначено в RFC 1035. Це означає, що назва повинна:
містити не більше 63 символів
містити лише буквено-цифрові символи чи '-' в нижньому регістрі
починатися алфавітним символом
закінчуватися буквено-цифровим символом
Примітка:
Хоча RFC 1123 технічно дозволяє міткам починатися з цифри, поточна реалізація Kubernetes вимагає, щоб мітки як RFC 1035, так і RFC 1123 починалися з літери. Винятком є увімкнення функціональної можливості RelaxedServiceNameValidation для обʼєктів Service, що дозволяє назвам Service починатися з цифри.
Назви сегментів шляху
Деякі типи ресурсів вимагають, щоб їх назви можна було безпечно кодувати як сегмент шляху. Іншими словами, назва не може бути "." або "..", і вона не може містити "/" або "%".
Ось приклад маніфесту для Pod із назвою nginx-demo.
Деякі типи ресурсів мають додаткові обмеження на їх назви.
UID
Рядок, створений системами Kubernetes для унікальної ідентифікації обʼєктів.
Кожен обʼєкт, створений протягом усього життя кластера Kubernetes, має унікальний UID. Він призначений для розрізнення історичних екземплярів схожих сутностей.
UID Kubernetes — це універсальні унікальні ідентифікатори (також відомі як UUID). UUID стандартизовані згідно з ISO/IEC 9834-8 та ITU-T X.667.
Мітки — це пари ключ/значення, які прикріплені до обʼєктів, таких як Pod. Мітки призначені для вказування ідентифікувальних атрибутів обʼєктів, які мають значення та стосуються користувачів, але безпосередньо не визначають семантику для основної системи. Мітки можуть бути використані для організації та вибору підмножини обʼєктів. Мітки можуть бути прикріплені до обʼєктів під час створення та пізніше додані та змінені в будь-який час. Кожен обʼєкт може мати набір міток ключ/значення. Кожен ключ повинен бути унікальним для даного обʼєкта.
Мітки дозволяють ефективно виконувати запити та спостереження та є ідеальними для використання в інтерфейсах користувача та інтерфейсах командного рядка. Неідентифікувальну інформацію слід записувати за допомогою анотацій.
Мотивація
Мітки дозволяють користувачам звʼязувати свої власні організаційні структури з обʼєктами системи слабко повʼязаним способом, не вимагаючи зберігання цих звʼязків в клієнтах.
Розгортання сервісів і конвеєри пакетної обробки часто є багатовимірними сутностями (наприклад, кілька розділів чи розгортань, кілька каналів випуску, кілька рівнів, кілька мікросервісів на кожному рівні). Управління часто потребує наскрізних операцій, які порушують інкапсуляцію строго ієрархічних уявлень, особливо жорстких ієрархій, визначених інфраструктурою, а не користувачами.
Це приклади загальновживаних міток; ви вільні розробляти свої власні домовленості. Памʼятайте, що ключ мітки повинен бути унікальним для даного обʼєкта.
Синтаксис та набір символів
Мітки — це пари ключ/значення. Дійсні ключі міток мають два сегменти: необовʼязковий префікс та назву, розділені скісною рискою (/). Сегмент назви є обовʼязковим і має бути не більше 63 символів, починатися та закінчуватися буквено-цифровим символом ([a-z0-9A-Z]), і може містити дефіси (-), підкреслення (_), крапки (.) та буквено-цифрові символи між ними. Префікс є необовʼязковим. Якщо вказаний, префікс повинен бути піддоменом DNS: серією DNS-міток, розділених крапками (.), не довше 253 символів загалом, за якими слідує скісна риска (/).
Якщо префікс відсутній, ключ мітки вважається приватним для користувача. Автоматизовані компоненти системи (наприклад, kube-scheduler, kube-controller-manager, kube-apiserver, kubectl або інші сторонні засоби автоматизації), які додають мітки до обʼєктів користувача, повинні вказати префікс.
Префікси kubernetes.io/ та k8s.io/ є зарезервованими для основних компонентів Kubernetes.
Дійсне значення мітки:
повинно бути не більше 63 символів (може бути порожнім),
крім порожнього значення, повинно починатися та закінчуватися буквено-цифровим символом ([a-z0-9A-Z]),
може містити дефіси (-), підкреслення (_), крапки (.) та буквено-цифрові символи між ними.
Наприклад, ось маніфест для Pod із двома мітками environment: production та app: nginx:
На відміну від назв та UID, мітки не забезпечують унікальності. Загалом, ми очікуємо, що багато обʼєктів матимуть ті самі мітки.
За допомогою селектора міток клієнт або користувач може ідентифікувати набір обʼєктів. Селектор міток є основним примітивом групування в Kubernetes.
На цей момент API підтримує два типи селекторів: на основі рівності та на основі множини. Селектор міток може складатися з кількох вимог, які розділені комами. У випадку кількох вимог всі повинні бути задоволені, таким чином кома виступає логічним оператором AND (&&).
Семантика порожніх або невизначених селекторів залежить від контексту, і типи API, які використовують селектори, повинні документувати їхню чинність та значення.
Примітка:
Для деяких типів API, таких як ReplicaSets, селектори міток двох екземплярів не повинні перетинатися в одному просторі імен, бо контролер може вважати це конфліктними інструкціями та не зможе визначити, скільки реплік повинно бути присутньо.
Увага:
Для умов на основі рівності і на основі множини немає логічного оператора OR (||). Переконайтеся, що ваші вирази фільтрації структуровані відповідно.
Вимоги на основі рівності
Вимоги на основі рівності чи нерівності дозволяють фільтрувати обʼєкти за ключами та значеннями міток. Відповідні обʼєкти повинні задовольняти всі вказані обмеження міток, хоча вони також можуть мати додаткові мітки. Допускаються три види операторів: =, ==, !=. Перший та другий представляють рівність (equality) і є синонімами, тоді як останній представляє нерівність (inequality).
Наприклад:
environment=productiontier !=frontend
Перший вибирає всі ресурси з ключем environment та значенням production. Другий вибирає всі ресурси з ключем tier та значеннями, відмінними від frontend, а також усі ресурси без міток із ключем tier. Можна відфільтрувати ресурси в production, виключивши frontend, за допомогою оператора коми: environment=production,tier!=frontend.
Один зі сценаріїв використання вимог на основі рівності — вказування критеріїв вибору вузлів для Podʼів. Наприклад, зразок Podʼа нижче вибирає вузли, де мітка accelerator існує і має значення nvidia-tesla-p100.
Вимоги на основі множини дозволяють фільтрувати ключі за набором значень. Підтримуються три види операторів: in, notin та exists (тільки ідентифікатор ключа). Наприклад:
environment in (production, qa)tier notin (frontend, backend)partition!partition
Перший приклад вибирає всі ресурси з ключем, рівним environment, та значенням, рівним production або qa.
Другий приклад вибирає всі ресурси з ключем, рівним tier, та значеннями, іншими ніж frontend та backend, а також усі ресурси без міток із ключем tier.
Третій приклад вибирає всі ресурси, які мають мітку з ключем partition; значення не перевіряються.
Четвертий приклад вибирає всі ресурси без мітки з ключем partition; значення не перевіряються.
Так само розділювач-кома діє як оператор AND. Таким чином, фільтрування ресурсів із ключем partition (незалежно від значення) та з environment, відмінним від qa, можна досягти за допомогою partition,environment notin (qa). Селектор міток на основі множини є загальною формою рівності, оскільки environment=production еквівалентно environment in (production); так само для != та notin.
Вимоги на основі множини можна комбінувати з вимогами на основі рівності. Наприклад: partition in (customerA, customerB),environment!=qa.
API
Фільтрація LIST та WATCH
Для операцій list і watch ви можете вказати селектори міток для фільтрації наборів обʼєктів, що повертаються; фільтр задається за допомогою параметра запиту. (Щоб дізнатися докладніше про watch у Kubernetes, прочитайте ефективне виявлення змін).
Дозволені обидва типи вимог (тут подано так, як вони зʼявляться у рядку URL-запиту):
вимоги на основі рівності: ?labelSelector=environment%3Dproduction,tier%3Dfrontend
вимоги на основі множини: ?labelSelector=environment+in+%28production%2Cqa%29%2Ctier+in+%28frontend%29
Обидва стилі селекторів міток можуть бути використані для отримання переліку ресурсів чи спостереження за ними через клієнта REST. Наприклад, спрямовуючись до apiserver за допомогою kubectl та використовуючи вимогу на основі рівності, можна написати:
kubectl get pods -l environment=production,tier=frontend
чи використовуючи вимогу на основі множини:
kubectl get pods -l 'environment in (production),tier in (frontend)'
Як вже зазначалося, вимоги на основі множини є більш виразними. Наприклад, вони можуть реалізувати оператор OR в значеннях:
kubectl get pods -l 'environment in (production, qa)'
чи обмежувати негативний збіг за допомогою оператора notin:
kubectl get pods -l 'environment,environment notin (frontend)'
Посилання на набори в обʼєктах API
Деякі обʼєкти Kubernetes, такі як services та replicationcontrollers, також використовують селектори міток для вказівки наборів інших ресурсів, таких як Podʼи.
Service та ReplicationController
Набір Podʼів, на який спрямований service, визначається селектором міток. Так само сукупність Podʼів, якою повинен керувати replicationcontroller, також визначається селектором міток.
Селектори міток для обох обʼєктів визначаються у файлах json або yaml за допомогою мап, і підтримуються лише селектори вимог на основі рівності:
"selector":{"component":"redis",}
або
selector:component:redis
Цей селектор (відповідно у форматі json або yaml) еквівалентний component=redis або component in (redis).
matchLabels — це мапа пар {key,value}. Одна пара {key,value} у мапі matchLabels еквівалентна елементу matchExpressions, де поле key — це "key", оператор — "In", а масив values містить лише "value". matchExpressions — це список вимог селектора Podʼів. Допустимі оператори включають In, NotIn, Exists та DoesNotExist. Масив values повинен бути непорожнім у випадку In та NotIn. Усі вимоги, як із matchLabels, так і з matchExpressions, обʼєднуються логічною операцією AND: усі вони повинні бути задоволені для збігу.
Вибір множини вузлів
Одним із варіантів використання вибору за мітками є обмеження множини вузлів, на які може бути заплановано Pod. Дивіться документацію щодо вибору вузла для отримання докладнішої інформації.
Ефективне використання міток
Ви можете застосовувати одну мітку до будь-яких ресурсів, але це не завжди є найкращою практикою. Є багато сценаріїв, де слід використовувати кілька міток для розрізнення наборів ресурсів один від одного.
Наприклад, різні застосунки можуть використовувати різні значення для мітки app, але багаторівневий застосунок, такий як приклад гостьової книги, додатково повинен відрізняти кожний рівень.
У наступних прикладах мітка app включена для зручності при ручних запитах та простому використанні CLI. Мітка app.kubernetes.io/name відповідає рекомендованим конвенціям Kubernetes щодо міток і краще підходить для інструментів та автоматизації.
NAME READY STATUS RESTARTS AGE
guestbook-redis-replica-2q2yf 1/1 Running 0 3m
guestbook-redis-replica-qgazl 1/1 Running 0 3m
Оновлення міток
Іноді вам може знадобитися змінити мітки наявних Podʼів та інших ресурсів перед створенням нових ресурсів. Це можна зробити за допомогою kubectl label. Наприклад, якщо ви хочете позначити всі свої NGINX Podʼи як рівень фронтенду, виконайте:
Спочатку фільтруються всі Podʼи з міткою "app=nginx", а потім вони позначаються як "tier=fe". Щоб переглянути Podʼи, які ви позначили, виконайте:
kubectl get pods -l app=nginx -L tier
NAME READY STATUS RESTARTS AGE TIER
my-nginx-2035384211-j5fhi 1/1 Running 0 23m fe
my-nginx-2035384211-u2c7e 1/1 Running 0 23m fe
my-nginx-2035384211-u3t6x 1/1 Running 0 23m fe
Це виводить всі Podʼи "app=nginx", з додатковим стовпчиком міток рівня Podʼів (вказаним за допомогою -L або --label-columns).
У Kubernetes простори імен (namespaces) забезпечують механізм для ізоляції груп ресурсів у межах одного кластера. Назви ресурсів повинні бути унікальними в межах простору імен, але не між просторами імен. Засноване на просторах імен обмеження застосовується лише до обʼєктів, які входять до простору імен (наприклад, Deployments, Services тощо), а не до обʼєктів, що поширюються на весь кластер (наприклад, StorageClass, Nodes, PersistentVolumes тощо).
Коли використовувати кілька просторів імен
Простори імен призначені для використання в середовищах з багатьма користувачами, розподіленими між різними командами чи проєктами. Для кластерів від кількох до десятків користувачів вам, ймовірно, взагалі не потрібно створювати простори імен чи думати про них. Почніть використовувати простори імен, коли ви потребуєте функції, які вони забезпечують.
Простори імен задають область дії для назв. Назви ресурсів повинні бути унікальними в межах простору імен, але не між просторами імен. Простори імен не можуть бути вкладені один в одного, і кожен ресурс Kubernetes може бути лише в одному просторі імен.
Простори імен — це спосіб розділити ресурси кластера між кількома користувачами (за допомогою квот ресурсів).
Не обовʼязково використовувати кілька просторів імен для відокремлення трохи відмінних ресурсів, таких як різні версії того самого програмного забезпечення: використовуйте мітки для розрізнення ресурсів в межах одного простору імен.
Примітка:
Для промислового кластера розгляньте можливість не використовувати простір імен default. Замість цього створюйте і використовуйте інші простори імен.
Початкові простори імен
Після запуску в Kubernetes є чотири початкові простори імен:
default
Kubernetes включає цей простір імен, щоб ви могли почати використовувати новий кластер без попереднього створення простору імен.
kube-node-lease
Цей простір імен містить обʼєкти Lease, повʼязані з кожним вузлом. Лізинги вузлів дозволяють kubelet надсилати пульс, щоб панель управління могла виявити відмову вузла.
kube-public
Цей простір імен може бути прочитаний усіма клієнтами (включаючи тих, які не автентифіковані). Цей простір імен в основному призначений для внутрішнього використання кластером, у випадку, коли деякі ресурси повинні бути видимими та доступними публічно по всьому кластеру. Публічний аспект цього простору імен — це лише домовленість, яка не є обовʼязковою.
kube-system
Простір імен для обʼєктів, створених системою Kubernetes.
Під час створення Service створюється відповідний DNS-запис. Цей запис має форму <service-name>.<namespace-name>.svc.cluster.local, що означає, що якщо контейнер використовує тільки <service-name>, він буде розвʼязаний у сервіс, локальний для простору імен. Це корисно для використання тієї самої конфігурації в кількох просторах імен, таких як Development, Staging та Production. Якщо вам потрібно досягти обʼєкта в іншому просторі імен, вам слід використовувати повне кваліфіковане доменне імʼя (FQDN).
Якщо створити простори імен із тими самими назвами, що й публічні домени верхнього рівня (TLD), Services у цих просторах імен можуть мати короткі імена DNS, які перетинаються з публічними записами DNS. Робоче навантаження з будь-якого простору імен, яке виконує DNS-запит без крапки в кінці, буде перенаправлено на ці сервіси, які матимуть пріоритет над публічним DNS.
Щоб помʼякшити це, надавайте привілеї на створення просторів імен лише довіреним користувачам. Якщо необхідно, ви можете додатково налаштувати сторонні перевірки на забезпечення безпеки, такі як вебхуки допуску, щоб блокувати створення будь-якого простору імен із назвою публічного TLD.
Не всі обʼєкти належать до простору імен
Більшість ресурсів Kubernetes (наприклад, Pods, Services, Deployments та інші) перебувають у певних просторах імен. Однак самі ресурси просторів імен не належать до жодного простору імен. А ресурси низького рівня, такі як Nodes та PersistentVolumes, не перебувають в жодному просторі імен.
Щоб переглянути, які ресурси Kubernetes є в просторі імен, а які — ні:
# В просторі іменkubectl api-resources --namespaced=true# Не в просторі іменkubectl api-resources --namespaced=false
Автоматичне додавання міток
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.22
Панель управління Kubernetes встановлює незмінну міткуkubernetes.io/metadata.name для всіх просторів імен. Значення мітки — це назва простору імен.
Ви можете використовувати анотації Kubernetes, щоб додати довільні неідентифікувальні метадані до обʼєктів.
Клієнти, такі як інструменти та бібліотеки, можуть отримувати ці метадані.
Додавання метаданих до обʼєктів
Ви можете використовувати як мітки, так і анотації для додавання метаданих до обʼєктів Kubernetes. Мітки можна використовувати для вибору обʼєктів та пошуку колекцій обʼєктів, які відповідають певним умовам. На відміну від цього, анотації не використовуються для ідентифікації та вибору обʼєктів. Метадані в анотації можуть бути невеликими або великими, структурованими або неструктурованими, і можуть включати символи, які не дозволені в мітках. Можна використовувати як мітки, так і анотації в метаданих того самого обʼєкта.
Анотації, подібно до міток, є парами ключ/значення:
Ключі та значення в мапі повинні бути рядками. Іншими словами, ви не можете використовувати числові, булеві, спискові або інші типи як для ключів, так і для їх значень.
Ось кілька прикладів інформації, яку можна записати в анотаціях:
Поля, керовані декларативним рівнем конфігурації. Додавання цих полів як анотацій відмежовує їх від типових значень, встановлених клієнтами чи серверами, а також від автогенерованих полів та полів, встановлених системами автоматичного визначення розміру чи автомасштабування.
Інформація про збірку, реліз чи образ, така як часові мітки, ідентифікатори релізу, гілка git, номери PR, хеші образу та адреса реєстру.
Вказівники на репозиторії логування, моніторингу, аналітики чи аудиту.
Інформація про клієнтську бібліотеку чи інструмент, яку можна використовувати для налагодження: наприклад, назва, версія та інформація про збірку.
Інформація про походження користувача чи інструменту/системи, така як URL-адреси повʼязаних обʼєктів з інших компонентів екосистеми.
Метадані легких інструментів розгортання: наприклад, конфігурація чи контрольні точки.
Номери телефонів або пейджерів відповідальних осіб, чи записи в каталозі, які вказують, де можна знайти цю інформацію, наприклад, на вебсайті команди.
Директиви від кінцевого користувача до реалізації щодо зміни поведінки чи використання нестандартних функцій.
Замість використання анотацій ви можете зберігати цей тип інформації у зовнішній базі даних чи каталозі, але це значно ускладнило б створення спільних клієнтських бібліотек та інструментів для розгортання, управління, інтроспекції тощо.
Синтаксис та набір символів
Анотації — це пари ключ/значення. Допустимі ключі анотацій мають два сегменти: необовʼязковий префікс і назва, розділені скісною рискою (/). Назва є обовʼязковою та має містити не більше 63 символів, починаючись та закінчуючись буквено-цифровим символом ([a-z0-9A-Z]), і може містити дефіси (-), підкреслення (_), крапки (.) та буквено-цифрові символи між ними. Префікс є необовʼязковим. Якщо вказано, префікс повинен бути піддоменом DNS: серією DNS-міток, розділених крапками (.), загальною довжиною не більше 253 символів, за якою слідує скісна риска (/).
Якщо префікс відсутній, ключ анотації вважається приватним для користувача. Автоматизовані компоненти системи (наприклад, kube-scheduler, kube-controller-manager, kube-apiserver, kubectl чи інші автоматизовані засоби від сторонніх розробників), які додають анотації до обʼєктів кінцевого користувача, повинні вказати префікс.
Префікси kubernetes.io/ та k8s.io/ зарезервовані для основних компонентів Kubernetes.
Значення анотацій не мають жодних обмежень щодо набору символів — на відміну від значень міток, значення анотацій можуть містити будь-які рядки, включаючи спеціальні символи, пробіли та структуровані дані, такі як JSON або YAML. Якщо ви плануєте зберігати двійкові дані (наприклад, CBOR), проєкт Kubernetes рекомендує кодувати їх у форматі base64. Однак загальний розмір всіх анотацій на одному обʼєкті (ключі та значення разом) не повинен перевищувати 256 КіБ.
Наприклад, ось маніфест для Pod, який має анотацію imageregistry: https://hub.docker.com/:
Селектори полів дозволяють вам вибирати обʼєкти Kubernetes на основі значень одного або кількох полів ресурсу. Ось кілька прикладів запитів для селекторів полів:
metadata.name=my-service
metadata.namespace!=default
status.phase=Pending
Ця команда kubectl вибирає всі Podʼи, для яких значення поля status.phase дорівнює Running:
kubectl get pods --field-selector status.phase=Running
Примітка:
Селектори полів, по суті, є фільтрами ресурсів. Типово селектори/фільтри не застосовуються, а це означає, що вибрані всі ресурси вказаного типу. Це робить запити kubectl get pods та kubectl get pods --field-selector "" еквівалентними.
Підтримувані поля
Підтримувані селектори полів варіюються залежно від типу ресурсу Kubernetes. Усі типи ресурсів підтримують поля metadata.name та metadata.namespace. Використання непідтримуваних селекторів полів призводить до помилки. Наприклад:
kubectl get ingress --field-selector foo.bar=baz
Error from server (BadRequest): Unable to find "ingresses" that match label selector "", field selector "foo.bar=baz": "foo.bar" is not a known field selector: only "metadata.name", "metadata.namespace"
Усі власні типи ресурсів підтримують поля metadata.name та metadata.namespace.
Крім того, поле spec.versions[*].selectableFields у CustomResourceDefinition оголошує, які інші поля власного ресурсу можна використовувати у селекторах полів. Дивіться статтю поля, які можна вибрати для власних ресурсів для отримання додаткових відомостей про те, як використовувати селектори полів з CustomResourceDefinitions.
Підтримувані оператори
Ви можете використовувати оператори =, == та != з селекторами полів (= та == означають те саме). Наприклад, ця команда kubectl вибирає всі Services Kubernetes, які не перебувають у просторі імен default:
kubectl get services --all-namespaces --field-selector metadata.namespace!=default
Як і селектори міток та інші селектори, селектори полів можна обʼєднувати в ланцюжок у вигляді списку, розділеного комами. Ця команда kubectl вибирає всі Podʼи, для яких значення status.phase не дорівнює Running, а поле spec.restartPolicy дорівнює Always:
kubectl get pods --field-selector=status.phase!=Running,spec.restartPolicy=Always
Кілька типів ресурсів
Ви можете використовувати селектори полів для кількох типів ресурсів. Ця команда kubectl вибирає всі Statefulsets та Services, які не перебувають у просторі імен default:
kubectl get statefulsets,services --all-namespaces --field-selector metadata.namespace!=default
6.1.2.7 - Завершувачі
Завершувачі — це ключі простору імен, які наказують Kubernetes чекати до виконання певних умов перед тим, як повністю видаляти ресурси, позначені для видалення. Завершувачі сповіщають контролери, що потрібно очистити ресурси, якими володів видалений обʼєкт.
Коли ви наказуєте Kubernetes видалити обʼєкт, для якого є завершувачі, API Kubernetes позначає обʼєкт для видалення, заповнюючи поле .metadata.deletionTimestamp, і повертає код стану 202 (HTTP «Accepted»). Цільовий обʼєкт залишається в стані завершення, поки панель управління чи інші компоненти виконують дії, визначені завершувачами. Після завершення цих дій контролер видаляє відповідні завершувачі з цільового обʼєкта. Коли поле metadata.finalizers порожнє, Kubernetes вважає видалення завершеним і видаляє обʼєкт.
Ви можете використовувати завершувачі для керування збором сміття ресурсів. Наприклад, ви можете визначити завершувач для очищення повʼязаних ресурсів API чи інфраструктури перед тим, як контролер видалить обʼєкт, що завершується.
Ви можете використовувати завершувачі для управління збиранням сміттяобʼєктів, сповіщаючи контролери про необхідність виконання певних завдань з очищення перед видаленням цільового ресурсу.
Зазвичай завершувачі не вказують код для виконання. Замість цього вони являють собою списки ключів для конкретного ресурсу, аналогічні анотаціям. Kubernetes автоматично вказує деякі завершувачі, але ви також можете вказати свої.
Як працюють завершувачі
При створенні ресурсу за допомогою файлу маніфесту ви можете вказати завершувачі у полі metadata.finalizers. Коли ви намагаєтеся видалити ресурс, API-сервер, що обробляє запит на видалення, помічає значення у полі finalizers і робить таке:
Модифікує обʼєкт, додаючи поле metadata.deletionTimestamp з часом, коли ви почали видалення.
Запобігає видаленню обʼєкта, поки всі елементи не будуть видалені з його поля metadata.finalizers.
Повертає код статусу 202 (HTTP "Accepted")
Контролер, який керує цим завершувачем, помічає оновлення обʼєкта, яке встановлює metadata.deletionTimestamp, що вказує на те, що було запитано видалення обʼєкта. Потім контролер намагається виконати вимоги завершувачів, вказаних для цього ресурсу. Кожного разу, коли виконується умова завершувача, контролер видаляє цей ключ із поля finalizers ресурсу. Коли поле finalizers порожнє, обʼєкт із встановленим полем deletionTimestamp автоматично видаляється. Ви також можете використовувати завершувачі для запобігання видаленню некерованих ресурсів.
Розповсюджений приклад завершувача — kubernetes.io/pv-protection, який запобігає
випадковому видаленню обʼєктів PersistentVolume. Коли обʼєкт PersistentVolume
використовується Podʼом, Kubernetes додає завершувач pv-protection. Якщо ви
намагаєтеся видалити PersistentVolume, він потрапляє в стан Terminating, але
контролер не може видалити його через наявність завершувача. Коли Pod перестає
використовувати PersistentVolume, Kubernetes очищує завершувач pv-protection,
і контролер видаляє том.
Примітка:
Коли ви видаляєте обʼєкт за допомогою DELETE, Kubernetes додає відмітку видалення для цього обʼєкта і одразу починає обмежувати зміни в полі .metadata.finalizers для обʼєкта, який тепер очікує видалення. Ви можете видаляти наявні завершувачі (видаляти запис зі списку finalizers), але не можете додати новий завершувач. Ви також не можете модифікувати deletionTimestamp для обʼєкта, якщо він вже встановлений.
Після запиту на видалення ви не можете відновити цей обʼєкт. Єдиний спосіб — видалити його і створити новий схожий обʼєкт.
Примітка:
Назви власних завершувачів повинні бути загальнодоступними кваліфікованими назвами, такими як example.com/finalizer-name. Kubernetes забезпечує дотримання цього формату; API-сервер відхиляє запис обʼєктів, якщо зміна не використовує кваліфіковані назви для будь-якого власного завершувача.
Посилання на власників, мітки та завершувачі
Так само як і мітки, посилання на власника описують стосунки між обʼєктами в Kubernetes, але використовуються для іншої цілі. Коли контролер керує обʼєктами типу Pod, він використовує мітки для відстеження змін у групах повʼязаних обʼєктів. Наприклад, коли Job створює один чи
декілька Podʼів, контролер Job додає мітки до цих Podʼів та відстежує зміни
у будь-яких Podʼах у кластері з такою ж міткою.
Контролер Job також додає посилання на власника до цих Podʼів, посилаючись на Job, який створило Podʼи. Якщо ви видаляєте Job, поки ці Podʼи працюють, Kubernetes використовує посилання на власника (а не мітки), щоб визначити, які Podʼи в кластері потрібно прибрати.
Kubernetes також обробляє завершувачі, коли виявляє посилання на власника в ресурсі, призначеному для видалення.
У деяких ситуаціях завершувачі можуть блокувати видалення залежних обʼєктів, що може призвести до того, що цільовий обʼєкт-власник залишатиметься довше, ніж очікувалося, і не буде повністю видалений. У таких ситуаціях вам слід перевірити завершувачі та посилання на власника в цільовому власнику та залежних
обʼєктах, щоб зʼясувати причину.
Примітка:
У випадках, коли обʼєкти застрягають в стані видалення, уникайте ручного видалення завершувачів для продовження процесу видалення. Завершувачі, як правило, додаються до ресурсів з певною метою, тому примусове їх видалення може призвести до проблем у вашому кластері. Це слід робити лише тоді, коли призначення завершувача зрозуміло та може бути виконано іншим способом (наприклад, ручне очищення деякого залежного обʼєкта).
У Kubernetes деякі обʼєкти є власниками інших обʼєктів. Наприклад, ReplicaSet є власником групи Podʼів. Ці підлеглі обʼєкти є залежними від свого власника.
Власність відрізняється від механізму міток та селекторів, який також використовують деякі ресурси. Наприклад, розгляньте Service, який створює обʼєкти EndpointSlice. Service використовує мітки, щоб панель управління могла визначити, які обʼєкти EndpointSlice використовуються для цього Service. Крім міток, кожен EndpointSlice, керований від імені Service, має посилання на власника. Посилання на власника допомагають різним частинам Kubernetes уникати втручання в обʼєкти, якими вони не керують.
Посилання на власника в специфікаціях обʼєктів
Залежні обʼєкти мають поле metadata.ownerReferences, яке містить посилання на їх власника. Дійсне посилання на власника складається з назви обʼєкта та UID в межах того ж простору імен, що й залежний обʼєкт. Kubernetes автоматично встановлює значення цього поля для обʼєктів, які є залежностями інших обʼєктів, таких як ReplicaSets, DaemonSets, Deployments, Jobs та CronJobs, та ReplicationControllers. Ви також можете налаштувати ці звʼязки вручну, змінивши значення цього поля. Однак зазвичай цього не потрібно робити, і можна дозволити Kubernetes автоматично керувати цими звʼязками.
Залежні обʼєкти також мають поле ownerReferences.blockOwnerDeletion, яке має булеве значення і контролює, чи можуть певні залежні обʼєкти блокувати збір сміття, що видаляє їх власника. Kubernetes автоматично встановлює це поле в true, якщо контролер (наприклад, контролер Deployment) встановлює значення поля metadata.ownerReferences. Ви також можете встановити значення поля blockOwnerDeletion вручну, щоб контролювати, які залежні обʼєкти блокують збір сміття.
Контролер допуску Kubernetes контролює доступ користувачів до зміни цього поля для залежних ресурсів на основі прав видалення власника. Цей контроль перешкоджає несанкціонованим користувачам затримувати видалення обʼєкта-власника.
Примітка:
Посилання на власника з іншого простору імен заборонені за задумом. Залежні обʼєкти в межах простору імен можуть вказувати власників рівня кластера або рівня простору імен. Власник рівня простору імен повинен існувати в тому самому просторі імен, що й залежний обʼєкт. Якщо це не так, посилання на власника вважається відсутнім, і залежний обʼєкт підлягає видаленню після перевірки відсутності всіх власників.
Залежні обʼєкти рівня кластера можуть вказувати тільки власників рівня кластера. У v1.20+, якщо залежний обʼєкт рівня кластера вказує як власника тип у межах простору імен, вважається, що він має нерозвʼязне посилання на власника, і його не можна прибрати збором сміття.
У v1.20+, якщо збирач сміття виявляє недійсний ownerReference між просторами імен або залежний обʼєкт рівня кластера з ownerReference, що посилається на тип у межах простору імен, повідомляється про попереджувальну подію з причиною OwnerRefInvalidNamespace та involvedObject недійсного залежного елемента. Ви можете перевірити наявність такого роду подій (Event), запустивши kubectl get events -A --field-selector=reason=OwnerRefInvalidNamespace.
Власність та завершувачі
Коли ви наказуєте Kubernetes видалити ресурс, API-сервер дозволяє контролеру, що керує ресурсом, обробити будь-які правила завершувача для ресурсу. Завершувачі запобігають випадковому видаленню ресурсів, які вашому кластеру можуть ще бути потрібні для коректної роботи. Наприклад, якщо ви намагаєтеся видалити PersistentVolume, який все ще використовується Podʼом, видалення не відбувається негайно, оскільки PersistentVolume має завершувач kubernetes.io/pv-protection. Замість цього том залишається в стані Terminating до тих пір, поки Kubernetes не очистить завершувач, що відбувається тільки після того, як PersistentVolume більше не привʼязаний до Podʼа.
Kubernetes також додає завершувачі до ресурсу-власника, коли ви використовуєте або каскадне видалення на передньому плані або каскадне видалення сиріт. Під час видалення на передньому плані додається завершувач foreground, так що контролер повинен видалити залежні ресурси, які також мають ownerReferences.blockOwnerDeletion=true, перш ніж він видалить власника. Якщо ви вказуєте політику видалення покинутих ресурсів (сиріт), Kubernetes додає завершувач orphan, так що контролер ігнорує залежні ресурси після того, як він видаляє обʼєкт-власника.
Ви можете візуалізувати обʼєкти Kubernetes і керувати ними не лише за допомогою kubectl і панелі керування (dashboard), а й за допомогою інших інструментів. Загальний набір міток дозволяє інструментам працювати між собою, описуючи обʼєкти спільним чином, який можуть розуміти всі інструменти.
Крім підтримки інструментів, рекомендовані мітки описують застосунки так, що до них можна робити запити.
Метадані організовані навколо концепції застосунку. Kubernetes не є платформою як сервіс (PaaS) і не має та не навʼязує формального поняття застосунку. Замість цього застосунки є неформальними та описуються метаданими. Визначення того, що включає застосунок, є гнучким.
Примітка:
Це рекомендовані мітки. Вони полегшують управління застосунками, але не обовʼязкові для будь-яких основних інструментів.
Спільні мітки та анотації мають спільний префікс: app.kubernetes.io. Мітки без префіксу є приватними для користувачів. Спільний префікс забезпечує, що спільні мітки не перешкоджають роботі власних міток користувачів.
Мітки
Щоб повною мірою скористатися цими мітками, їх слід застосовувати до кожного обʼєкта ресурсу.
Ключ
Опис
Приклад
Тип
app.kubernetes.io/name
Назва застосунку
mysql
рядок
app.kubernetes.io/instance
Унікальна назва, що ідентифікує екземпляр застосунку
mysql-abcxyz
рядок
app.kubernetes.io/version
Поточна версія застосунку (наприклад, SemVer 1.0, хеш ревізії тощо)
5.7.21
рядок
app.kubernetes.io/component
Компонент всередині архітектури
database
рядок
app.kubernetes.io/part-of
Назва застосунку вищого рівня, частиною якого є цей застосунок
wordpress
рядок
app.kubernetes.io/managed-by
Інструмент, який використовується для управління роботою застосунку
Helm
рядок
Щоб проілюструвати ці мітки в дії, розгляньте такий обʼєкт StatefulSet:
# Це уривокapiVersion:apps/v1kind:StatefulSetmetadata:labels:app.kubernetes.io/name:mysqlapp.kubernetes.io/instance:mysql-abcxyzapp.kubernetes.io/version:"5.7.21"app.kubernetes.io/component:databaseapp.kubernetes.io/part-of:wordpressapp.kubernetes.io/managed-by:Helm
Застосунки та екземпляри застосунків
Застосунок можна встановити один або декілька разів у кластер Kubernetes і, у деяких випадках, у той самий простір імен. Наприклад, WordPress можна встановити більше одного разу, де різні вебсайти є різними екземплярами WordPress.
Назва застосунку та назва екземпляра записуються окремо. Наприклад, у WordPress є app.kubernetes.io/name — wordpress, тоді як назва екземпляра представлена як app.kubernetes.io/instance зі значенням wordpress-abcxyz. Це дозволяє ідентифікувати застосунок та його екземпляр. Кожен екземпляр застосунку повинен мати унікальну назву.
Приклади
Щоб проілюструвати різні способи використання цих міток, наведено приклади різної складності.
Простий Stateless Service
Розгляньте випадок простого Stateless Service, розгорнутого за допомогою обʼєктів Deployment та Service. Наведені нижче два уривки представляють, як можуть бути використані мітки у їх найпростішій формі.
Deployment використовується для нагляду за Podʼами, які виконують сам застосунок.
Розгляньмо трохи складніший застосунок: вебзастосунок (WordPress) із базою даних (MySQL), встановлений за допомогою Helm. Наведені нижче уривки ілюструють початок обʼєктів, які використовуються для розгортання цього застосунку.
Початок цього Deployment використовується для WordPress:
Зверніть увагу, що StatefulSet та Service для MySQL містять інформацію як про MySQL, так і про WordPress, ширший застосунок.
6.1.2.10 - Версії зберігання
API-сервер Kubernetes зберігає обʼєкти, покладаючись на etcd-сумісне сховище (часто це сам etcd). Кожен обʼєкт серіалізується за допомогою певної версії типу API; наприклад, представлення v1 ConfigMap. Kubernetes використовує термін версія зберігання для опису того, як зберігається обʼєкт у вашому кластері.
API Kubernetes також покладається на автоматичне перетворення; наприклад, якщо у вас є HorizontalPodAutoscaler, то ви можете взаємодіяти з цим HorizontalPodAutoscaler, використовуючи будь-яку комбінацію версій v1 та v2 API HorizontalPodAutoscaler. Kubernetes відповідає за перетворення кожного API-запиту, щоб клієнти не бачили, яка версія насправді серіалізується.
Для адміністраторів кластерів версія зберігання обʼєкта є важливим поняттям для розуміння, оскільки саме вона звʼязує представлення обʼєкта у API з фактичним кодуванням у бекенді сховища. Це може бути важливим у разі, коли певне бінарне кодування обʼєкта має значення, наприклад для шифрування в стані спокою або визнання API застарілим.
Той самий API може мати кілька версій зберігання, які API-сервер може перетворювати на схему обʼєкта. Один обʼєкт, що є частиною цього ресурсу, повинен мати лише одну версію зберігання в будь-який момент часу. Це означає, що API-сервер знає бінарне кодування обʼєктів і може виконувати динамічне перетворення між всіма збереженими версіями до представлення обʼєкта у API.
Версія обʼєкта є повністю відокремленою від версії зберігання. Наприклад, API-обʼєкти v1alpha1 та v1beta1 для того самого ресурсу будуть закодовані однаково в сховищі, доки версія зберігання не буде оновлена між двома обʼєктами.
Відповідність версій зберігання ресурсам
Кожен ресурс матиме 1 активну версію зберігання в будь-який момент часу, тобто будь-який запис до обʼєкта збереже обʼєкт у цій версії зберігання. Однак версію зберігання можна оновлювати, що дозволяє зберігати обʼєкти в різних версіях. Один обʼєкт зберігатиметься лише в одній версії зберігання в будь-який момент часу.
Зчитування з API-сервера конвертуватиме збережені дані в API-представлення обʼєкта. Це дозволяє старим версіям зберігання зберігатися необмежений час, доки не відбудуться оновлення обʼєкта. З іншого боку, записи конвертуватимуть збережений обʼєкт у нове представлення після оновлення.
Версії зберігання для власних ресурсів
Власні ресурси визначаються динамічно, тому їхні версії зберігання відрізняються від версій вбудованих типів Kubernetes. Вбудовані обʼєкти загалом мають своє кодування сховища, визначене окремо від їхніх типів API, де збережений обʼєкт діє як центральний елемент, а конкретна версія ресурсу не має значення, окрім того, що це поле у схемі обʼєкта.
Однак для власних ресурсів певну версію ресурсу необхідно встановити як версію зберігання. Схема, визначена цією конкретною версією власного ресурсу, буде використовуватися як кодування ресурсу на рівні сховища. Див. розширений набір функцій CRD для отримання детальнішої інформації про налаштування API та керування версіями.
Наприклад, див. це CustomResourceDefinition для crontabs:
apiVersion:apiextensions.k8s.io/v1kind:CustomResourceDefinitionmetadata:name:crontabs.example.comspec:group:example.com# перелік версій, що підтримуються цим CustomResourceDefinitionversions:- name:v1beta1# Кожна версія може бути увімкнена/вимкнена за допомогою прапорця Served.served:true# Одна і тільки одна версія повинна бути позначена як версія зберігання.storage:trueschema:openAPIV3Schema:type:objectproperties:host:type:stringport:type:string- name:v1served:truestorage:falseschema:openAPIV3Schema:type:objectproperties:host:type:stringport:type:stringtime:type:stringconversion:strategy:Nonescope:Namespacednames:plural:crontabssingular:crontabkind:CronTabshortNames:- ct
Визначення API v1beta1 використовується як версія зберігання, тобто будь-які оновлення або створення crontabs зберігатимуться разом зі схемою обʼєкта API v1beta1. У цьому випадку це фактично означатиме, що обʼєкт API v1 ніколи не зможе зберігати поле time, оскільки воно не є частиною визначення сховища. Ця схема використовується на рівні сховища як двійкове кодування самого обʼєкта. Спроба встановити дві версії як версію, що зберігається, одночасно вважається недійсною, оскільки це означатиме, що дві схеми даних вважатимуться дійсними способами зберігання обʼєктів одночасно.
Після зміни версії, яка використовується для зберігання, ця версія API буде використовуватися для зберігання будь-яких нових або оновлених CR. Спостереження за обʼєктом або його отримання лише конвертуватиме обʼєкт зі старої версії зберігання, не змінюючи його. Тільки оновлення або створення матиме ефект і використовуватиме щойно визначену версію зберігання.
Як версії зберігання впливають на шифрування в стані спокою
Існують інструменти для шифрування сховища в стані спокою, особливо для Secrets кластера. Це додає додатковий рівень захисту від витоку даних, оскільки фактично збережені дані в кластері зашифровані. Це означає, що API-сервер фактично розшифровує дані під час їх отримання зі сховища. API-сервер повинен мати ключ для цієї версії зберігання, щоб правильно декодувати обʼєкт.
Версія зберігання в цьому випадку — це більше, ніж просто двійкове кодування обʼєкта. Якщо те, що зберігається, можна якимось чином перетворити на обʼєкт API, його можна використовувати як версію зберігання.
Міграція на іншу версію зберігання
Кілька версій зберігання для одного ресурсу можуть створювати проблеми для адміністраторів кластера. Адміністратор кластера не може видаляти старі версії API для CRD, які можуть не підтримуватися, доки не переконається, що всі обʼєкти більше не використовують повʼязану з ним версію зберігання. Через велику кількість обʼєктів та непрозоре уявлення про те, які з них є новими, а які все ще підтримуються старими версіями зберігання, важко визначити, коли версію можна безпечно видалити. Якщо версію видалено передчасно, обʼєкт може взагалі не вдатися прочитати.
Ще одним важливим питанням є використання ключів шифрування, як визначено у розділі вище. Оскільки ресурс повинен активно використовуватися для оновлення версії зберігання, після ротації ключів як старий, так і новий ключ шифрування повинні залишатися у використанні, доки адміністратор не переконається, що всі обʼєкти були записані принаймні один раз. Це створює як ризики для безпеки, так і проблеми з зручністю використання, оскільки ключ не може бути повністю вилучений з використання до того часу.
Див. міграцію версій зберігання для прикладів того, як виконати міграцію, щоб переконатися, що всі обʼєкти використовують новішу версію зберігання без ручного втручання.
6.1.3 - API Kubernetes
API Kubernetes дозволяє запитувати та змінювати стан обʼєктів у Kubernetes. Основа панелі управління Kubernetes — це API-сервер та HTTP API, який він надає. Користувачі, різні частини вашого кластера та зовнішні компоненти взаємодіють між собою через API-сервер.
Основою панелі управління Kubernetes є API-сервер. API-сервер надає HTTP API, який дозволяє кінцевим користувачам, різним частинам вашого кластера та зовнішнім компонентам взаємодіяти між собою.
API Kubernetes дозволяє вам запитувати та змінювати стан обʼєктів API у Kubernetes (наприклад: Pods, Namespaces, ConfigMaps та Events).
Більшість операцій можна виконати за допомогою інтерфейсу командного рядка kubectl або інших інструментів командного рядка, таких як kubeadm, які, своєю чергою, використовують API. Однак ви також можете отримати доступ до API безпосередньо за допомогою викликів REST. Kubernetes надає набір клієнтських бібліотек для тих, хто хоче писати застосунки з використанням API Kubernetes.
Кожен кластер Kubernetes публікує специфікацію API, які він обслуговує. Kubernetes використовує два механізми для публікації цих специфікацій API; обидва корисні для забезпечення автоматичної сумісності. Наприклад, інструмент kubectl отримує та кешує специфікацію API для увімкнення функціонала автозавершення командного рядка та інших функцій. Нижче наведено два підтримувані механізми:
Discovery API надає інформацію про API Kubernetes: назви API, ресурси, версії та операції, які підтримуються. Цей термін є специфічним для Kubernetes, оскільки це окремий API, відмінний від Kubernetes OpenAPI. Він задуманий як короткий огляд доступних ресурсів і не описує детальну схему ресурсів. Довідкові відомості про схеми ресурсів дивіться в документі OpenAPI.
Документ Kubernetes OpenAPI надає (повні) схеми OpenAPI v2.0 та v3.0 для всіх точок доступу API Kubernetes. OpenAPI v3 є бажаним методом доступу до OpenAPI, оскільки він надає повніше й точніше подання API. Цей варіант містить всі можливі API-шляхи, так само як і всі ресурси, що використовуються та створюються для кожної операції на кожній точці доступу. Тут також є компоненти розширюваності, які підтримує кластер. Дані містять повну специфікацію та значно перевищують за обсягом те, що надає Discovery API.
Discovery API
Kubernetes публікує через Discovery API перелік усіх підтримуваних версій груп і ресурсів. Для кожного ресурсу він містить таке:
Назва
Область дії: кластер або простір імен
URL точки доступу та підтримувані дієслова
Альтернативні назви
Група, версія, вид (kind)
API доступний як в агрегованому, так і в неагрегованому вигляді. Агреговане виявлення обслуговує дві точки доступу (endpoint), тоді як неагреговане — окрему точку доступу для кожної версії групи.
Агреговане виявлення
This is a stable feature in Kubernetes, and has been since the 1.30 release. You can no longer toggle this feature (the associated feature gate has been removed).
Kubernetes надає стабільну підтримку агрегованого виявлення, публікуючи всі ресурси, які підтримує кластер, через дві точки доступу (/api та /apis). Надсилання запиту до цієї точки доступу різко зменшує кількість запитів, потрібних для отримання даних виявлення з кластера. Ви можете отримати доступ до даних, надсилаючи запити до відповідних точок доступу із заголовком Accept, що вказує на ресурс агрегованого виявлення: Accept: application/json;v=v2;g=apidiscovery.k8s.io;as=APIGroupDiscoveryList.
Якщо тип ресурсу не вказано в заголовку Accept, стандартною відповіддю для точок доступу /api та /apis буде документ неагрегованого виявлення.
Документ виявлення для вбудованих ресурсів можна знайти в репозиторії Kubernetes GitHub. Цей документ GitHub можна використовувати як довідник базового набору доступних ресурсів, якщо кластер Kubernetes недоступний для запитів.
Точка доступу також підтримує ETag і кодування protobuf.
Неагреговане виявлення
Без агрегації виявлення інформація публікується рівнями, де кореневі точки доступу публікують дані виявлення для підлеглих документів.
Список усіх версій груп, підтримуваних кластером, публікується в точках доступу /api та /apis. Наприклад:
Для отримання документа виявлення для кожної версії групи за адресою /apis/<group>/<version> (наприклад, /apis/rbac.authorization.k8s.io/v1alpha1) потрібні додаткові запити. Ці точки доступу оголошують список ресурсів, що обслуговуються певною версією групи. Ці точки доступу використовуються командою kubectl для отримання списку ресурсів, підтримуваних кластером.
Kubernetes працює як з OpenAPI v2.0, так і з OpenAPI v3.0. OpenAPI v3 є бажаним методом доступу до OpenAPI, оскільки він пропонує повніше (без втрат) представлення ресурсів Kubernetes. Через обмеження OpenAPI версії 2 певні поля видалено з опублікованого OpenAPI, включаючи, але не обмежуючись, default, nullable, oneOf.
OpenAPI V2
API-сервер Kubernetes надає агреговану специфікацію OpenAPI v2 через точку доступу /openapi/v2. Ви можете запросити формат відповіді, використовуючи такі заголовки запиту:
Дійсні значення заголовків запиту для запитів OpenAPI v2
головним чином для внутрішньокластерного використання
application/json
типово
*
обслуговує application/json
Попередження:
Правила валідації, опубліковані як частина схем OpenAPI, можуть бути неповними, і зазвичай такими вони й є. Додаткова перевірка відбувається на API-сервері. Якщо вам потрібна точна і повна перевірка, kubectl apply --dry-run=server виконує всі застосовні перевірки (а також активує перевірку часу допуску).
OpenAPI V3
This is a stable feature in Kubernetes, and has been since the 1.27 release. You can no longer toggle this feature (the associated feature gate has been removed).
Kubernetes підтримує публікацію опису своїх API у форматі OpenAPI v3.
Надається точка доступу /openapi/v3 для перегляду списку всіх доступних груп/версій. Ця точка повертає лише JSON. Ці групи/версії вказані в такому форматі:
Відносні URL вказують на незмінний опис OpenAPI для поліпшення кешування на стороні клієнта. Також API-сервер встановлює відповідні заголовки кешування HTTP (Expires на 1 рік вперед та Cache-Control на immutable). При використанні застарілого URL API-сервер повертає перенаправлення на найновіший URL.
API-сервер Kubernetes публікує специфікацію OpenAPI v3 для кожної версії групи Kubernetes через точку доступу /openapi/v3/apis/<group>/<version>?hash=<hash>.
Дивіться таблицю нижче для прийнятних заголовків запиту.
Дійсні значення заголовків запиту для запитів OpenAPI v3
Kubernetes 1.37 публікує OpenAPI v2.0 та v3.0; найближчим часом підтримка 3.1 не планується.
Серіалізація Protobuf
Kubernetes реалізує альтернативний формат серіалізації на основі Protobuf, який призначений головним чином для комунікації всередині кластера. Докладніше про цей формат читайте в пропозиції дизайну серіалізації Kubernetes Protobuf та файлах мови опису інтерфейсу (IDL) для кожної схеми, які розташовані в пакунках Go, які визначають обʼєкти API.
Постійне зберігання
Kubernetes зберігає серіалізований стан обʼєктів, записуючи їх у etcd.
Групи API та версіювання
Щоб полегшити видалення полів або перебудову представлень ресурсів, Kubernetes підтримує кілька версій API, кожна з різним API-шляхом, таким як /api/v1 або /apis/rbac.authorization.k8s.io/v1alpha1.
Версіювання робиться на рівні API, а не на рівні ресурсу чи поля, щоб забезпечити чіткий, послідовний погляд на ресурси та поведінку системи, а також для можливості керування доступом до застарілих та/або експериментальних API.
Ресурси API розрізняються за їхньою групою API, типом ресурсу, простором імен (для ресурсів з підтримкою просторів імен) та назвою. API-сервер обробляє конвертацію між версіями API прозоро: всі різні версії фактично є представленням тих самих даних. API-сервер може обслуговувати ті самі базові дані через кілька версій API.
Наприклад, припустимо, є дві версії API, v1 та v1beta1, для того самого ресурсу. Якщо ви спочатку створили обʼєкт, використовуючи версію v1beta1 його API, ви можете згодом читати, оновлювати чи видаляти цей обʼєкт, використовуючи або версію API v1beta1, або версію v1, поки версія v1beta1 не буде застарілою та видаленою. На цьому етапі ви можете продовжувати отримувати доступ та модифікувати обʼєкт, використовуючи API версії v1.
Зміни в API
Будь-яка система, яка досягла успіху, повинна рости та змінюватися, коли зʼявляються нові випадки її використання або змінюються поточні. Тому Kubernetes розробив свій API так, щоб він постійно змінювався та розвивався. Проєкт Kubernetes має за мету не порушувати сумісність з наявними клієнтами та забезпечити цю сумісність на тривалий час, щоб інші проєкти мали можливість адаптуватися.
Загалом нові ресурси API та нові поля ресурсів можна додавати часто й регулярно. Видалення ресурсів чи полів вимагає дотримання політики застарівання API.
Kubernetes твердо зобовʼязується підтримувати сумісність з офіційними API Kubernetes, як тільки вони досягнуть загальної доступності (GA), як правило, у версії API v1. Крім того, Kubernetes підтримує сумісність з даними, що зберігаються через бета-версії API офіційних API Kubernetes, і гарантує, що дані можуть бути перетворені та доступні через версії GA API, коли функція стане стабільною.
Якщо ви використовуєте бета-версію API, вам слід перейти до наступної бета- або стабільної версії API, як тільки це API стане стабільним (GA). Найкращий час для цього — під час періоду застарівання бета-API, оскільки обʼєкти одночасно доступні через обидві версії API. Як тільки бета-API завершить свій період застарівання і більше не буде обслуговуватися, слід використовувати версію API, яка його замінює.
Примітка:
Попри те, що Kubernetes також ставить перед собою мету зберігати сумісність для версій альфа API, в деяких випадках це неможливо. Якщо ви використовуєте будь-які альфа-версії API, перевірте примітки до випуску Kubernetes при оновленні кластера, в разі змін API, які можуть бути несумісними та вимагати видалення всіх наявних альфа-обʼєктів перед оновленням.
Дивіться довідник з версій API для отримання докладнішої інформації про визначення рівня API.
Розширення API
API Kubernetes можна розширити одним з двох способів:
Власні ресурси дозволяють декларативно визначити, як API-сервер повинен надавати вибраний вами ресурс API.
Ви також можете розширити API Kubernetes, реалізовуючи шар агрегації.
Дізнайтеся про точки доступу API, типи ресурсів та зразки з Довідника API.
Дізнайтеся про те, що є сумісною зміною та як змінити API, в Зміни в API.
6.1.4 - Інструмент командного рядка kubectl
kubectl є основним інструментом командного рядка для взаємодії з кластером Kubernetes. Ця сторінка надає огляд kubectl та його ролі в екосистемі Kubernetes.
Kubernetes надає інструмент командного рядка для взаємодії з панеллю управління кластера Kubernetes за допомогою API Kubernetes.
Інструмент kubectl взаємодіє з вашим кластером через API Kubernetes. kubectl шукає файл налаштувань з назвою config у теці $HOME/.kube. Ви можете вказати інші файли kubeconfig, встановивши змінну середовища KUBECONFIG або використавши прапорець --kubeconfig.
Роль kubectl
kubectl є основним інструментом для створення, перегляду, оновлення та видалення обʼєктів Kubernetes. Він доповнює компоненти Kubernetes, які працюють у вашому кластері, та API Kubernetes, який реалізують ці компоненти. Незалежно від того, чи запускаєте ви kubectl з вашого ноутбука, чи з Podʼа всередині кластера, він надсилає запити до API-сервера. Інші клієнти, такі як клієнтські бібліотеки та вебпанелі, такі як Headlamp, також взаємодіють через той самий API.
Як працює kubectl
Інструмент kubectl підключається до API-сервера та автентифікується за допомогою відомостей про кластер, користувача та контекст, визначених у вашому файлі kubeconfig. Коли ви запускаєте kubectl ззовні кластера, він використовує файл kubeconfig для пошуку адреси API-сервера та облікових даних. Коли kubectl працює всередині Podʼа (наприклад, у CI/CD конвеєрі), він може використовувати автентифікацію всередині кластера на основі токена ServiceAccount, змонтованого в Podʼі.
Коли ви запускаєте команду, kubectl перетворює ваші наміри на один або кілька HTTP-запитів до API Kubernetes. API-сервер перевіряє кожен запит, застосовує його до стану кластера, збереженого в etcd, і повертає результат. Це означає, що кожна дія kubectl, чи то створення Deployment, чи читання логів, проходить тим самим шляхом через API.
Оскільки ваш kubeconfig може визначати кілька кластерів, користувачів і контекстів, ви можете використовувати kubectl для перемикання між кластерами без повторного налаштування середовища. Використовуйте kubectl config use-context, щоб змінити активний контекст.
Що можна робити з kubectl
Інструмент kubectl підтримує багато операцій, які можна умовно розділити на такі категорії:
Керування ресурсами — Створення, оновлення та видалення обʼєктів, таких як Podʼи, Deployments та Services. Використовуйте kubectl apply для декларативного керування за допомогою конфігураційних файлів.
Перевірка стану кластера — Перегляд списків та описів обʼєктів, подій та використання ресурсів.
Налагодження — Перегляд логів контейнерів, виконання команд всередині запущеного контейнера або перенаправлення портів до Podʼа.
Операції з кластером — Очищення вузлів для обслуговування, позначення вузлів як непридатних для планування, щоб запобігти появі нових навантажень, та керування конфігурацією кластера.
Скрипти та автоматизація — Форматування виводу у JSON, YAML або власні колонки за допомогою JSONPath для використання у скриптах та конвеєрах.
Для ознайомлення з синтаксисом, довідником команд та прикладами, дивіться довідку kubectl.
Декларативне vs імперативне керування
Для робочих навантажень у промисловому середовищі рекомендується використовувати декларативне керування обʼєктами за допомогою kubectl apply з конфігураційними файлами з контролем версій. Декларативне керування допомагає відстежувати зміни, співпрацювати та інтегруватися з GitOps-процесами. Імперативні команди (такі як kubectl create або kubectl run) корисні для розробки та експериментів, але їх важче відтворювати та перевіряти.
Розширення kubectl за допомогою втулків
Ви можете розширювати kubectl за допомогою втулків, які додають нові команди. Втулки є автономними бінарними файлами, які дотримуються конвенції іменування kubectl-<назва-втулка>. Спільнота Kubernetes підтримує багато втулків, і ви можете керувати ними за допомогою менеджера втулків Krew.
Сумісність версій
Інструмент kubectl підтримує різницю версій плюс-мінус одну мінорну версію відносно панелі управління кластера. Наприклад, kubectl v1.32 працює з панелями управління в кластерах версій v1.31, v1.32 та v1.33. Використання сумісної версії запобігає непередбачуваній поведінці. Дивіться Політику версійної розбіжності для отримання деталей.
Що далі
Ознайомтеся з довідкою kubectl для отримання відомостей про синтаксис та деталі команд.
Кластер Kubernetes складається з панелі управління та набору робочих машин, які називаються вузлами, що запускають контейнеризовані застосунки. Кожен кластер потребує принаймні одного робочого вузла для запуску Podʼів.
Робочі вузли розміщують Podʼи, які є компонентами робочого навантаження застосунку. Панель управління керує робочими вузлами та Podʼами в кластері. У промислових середовищах панель управління зазвичай працює на кількох компʼютерах, а кластер зазвичай має кілька вузлів, забезпечуючи відмовостійкість та високу доступність.
Цей документ описує різні компоненти, які вам потрібні для повноцінного та працездатного кластера Kubernetes.
Схема 1. Компоненти кластера Kubernetes.
Про цю архітектуру
На схемі 1 представлено приклад еталонної архітектури кластера Kubernetes. Фактичний розподіл компонентів може змінюватися залежно від конкретних налаштувань кластера та вимог.
На схемі на кожному вузлі запущено компонент kube-proxy. Вам потрібен компонент мережевого проксі на кожному вузлі, щоб гарантувати, що Service API та повʼязана з ним поведінка доступні у вашій кластерній мережі. Втім, деякі мережеві втулки надають власну, сторонню реалізацію проксі-сервера. Коли ви використовуєте такий мережевий втулок, вузлу не потрібно запускати kube-proxy.
Компоненти панелі управління
Компоненти панелі управління приймають глобальні рішення щодо кластера (наприклад, планування), а також виявляють та реагують на події в кластері (наприклад, запуск нового Podʼа, коли умова поля replicas в Deployment не виконується).
Компоненти панелі управління можуть запускатися на будь-якій машині у кластері. Однак для спрощення скрипти налаштування зазвичай запускають всі компоненти панелі управління на одній машині та не запускають контейнерів користувача на цій машині. Див. Створення кластерів з високою доступністю за допомогою kubeadm для прикладу налаштування панелі управління, яка працює на кількох машинах.
kube-apiserver
API-сервер є компонентом панелі управління Kubernetes, який надає доступ до API Kubernetes. API-сервер є фронтендом для панелі управління Kubernetes.
Основна реалізація API-сервера Kubernetes — kube-apiserver. kube-apiserver спроєктований для горизонтального масштабування, тобто масштабується за допомогою розгортання додаткових екземплярів. Ви можете запустити кілька екземплярів kube-apiserver та балансувати трафік між ними.
etcd
Узгоджене та високодоступне сховище ключ-значення, яке використовується як сховище Kubernetes для всіх даних кластера.
Якщо ваш кластер Kubernetes використовує etcd як основне сховище, переконайтеся, що у вас є план резервного копіювання даних.
Ви можете знайти докладну інформацію про etcd в офіційній документації.
kube-scheduler
Компонент панелі управління, що відстежує щойно створені Podʼи, які ще не розподілені по вузлах, і обирає вузол, на якому вони працюватимуть.
Під час вибору вузла враховуються такі фактори: індивідуальна і колективна потреба в ресурсах, обмеження за апаратним/програмним забезпеченням і політиками, характеристики affinity та anti-affinity, локальність даних, взаємний вплив робочих навантажень і граничні терміни виконання.
kube-controller-manager
Компонент панелі управління, який запускає процеси контролерів.
За логікою, кожен контролер є окремим процесом. Однак для спрощення їх збирають в один бінарний файл і запускають як єдиний процес.
Існує багато різних типів контролерів. Деякі приклади:
Контролер вузлів: відповідає за виявлення та реагування, коли вузли виходять з ладу.
Контролер Job: відстежує обʼєкти Job, що представляють одноразові завдання, а потім створює Podʼи для виконання цих завдань до завершення.
Контролер EndpointSlice: заповнює обʼєкти EndpointSlice (для забезпечення звʼязку між Services та Podʼами).
Контролер ServiceAccount: створює стандартні ServiceAccounts для нових просторів імен.
Наведений вище список не є вичерпним.
cloud-controller-manager
Компонент панелі управління Kubernetes, що вбудовує логіку управління, специфічну для хмари. Cloud controller manager дозволяє звʼязувати ваш кластер з API хмарного провайдера та відокремлює компоненти, що взаємодіють із хмарною платформою, від компонентів, які взаємодіють тільки з вашим кластером.
cloud-controller-manager запускає лише ті контролери, які специфічні для вашого хмарного провайдера. Якщо ви використовуєте Kubernetes у себе на власних потужностях або в навчальному середовищі всередині вашого ПК, кластер не матиме cloud-controller-manager.
Як і kube-controller-manager, cloud-controller-manager обʼєднує кілька логічно незалежних циклів управління в один бінарний файл, який ви запускаєте як один процес. Ви можете масштабувати його горизонтально (запускати більше однієї копії) для покращення продуктивності або для підвищення стійкості до збоїв.
Такі контролери можуть мати залежності від хмарного провайдера:
Контролер вузлів: перевіряє у хмарного провайдера, чи було видалено вузол у хмарі після того, як він перестав відповідати.
Контролер маршрутів: налаштовує маршрути в основній хмарній інфраструктурі.
Контролер Service: створює, оновлює та видаляє балансувальники навантаження хмарного провайдера.
Компоненти вузлів
Компоненти вузлів працюють на кожному вузлі, підтримуючи роботу Podʼів та забезпечуючи середовище виконання Kubernetes.
kubelet
Агент, запущений на кожному вузлі кластера. Забезпечує запуск і роботу контейнерів в Podʼах.
kubelet використовує специфікації PodSpecs, які надаються за допомогою різних механізмів, і забезпечує працездатність і справність усіх контейнерів, що описані у PodSpecs. kubelet керує лише тими контейнерами, що були створені Kubernetes.
kube-proxy (опційно)
kube-proxy є мережевим проксі, що запущений на кожному вузлі кластера і реалізує частину концепції Kubernetes Service.
kube-proxy підтримує мережеві правила на вузлах. Ці правила дозволяють мережеву взаємодію з вашими Podʼами з мережевих сеансів усередині чи поза межами кластера.
kube-proxy використовує шар фільтрації пакетів операційної системи, за його наявності. В іншому випадку kube-proxy скеровує трафік самостійно.
Якщо ви використовуєте мережевий втулок, який самостійно реалізує пересилання пакетів для Services та надає еквівалентну поведінку kube-proxy, то вам не потрібно запускати kube-proxy на вузлах вашого кластера.
Середовище виконання контейнерів
Основний компонент, який дозволяє Kubernetes ефективно запускати контейнери. Він відповідає за керування виконанням і життєвим циклом контейнерів у середовищі Kubernetes.
Надбудови використовують ресурси Kubernetes (DaemonSet, Deployment тощо) для реалізації функцій кластера. Оскільки вони надають функції на рівні кластера, ресурси, що належать надбудовам, розміщуються в просторі імен kube-system.
Вибрані надбудови описані нижче; для розширеного списку доступних надбудов дивіться Надбудови.
DNS
Хоча інші надбудови не є строго необхідними, всі кластери Kubernetes повинні мати кластерний DNS, оскільки багато прикладів залежать від нього.
Кластерний DNS — це DNS-сервер, який доповнює інші DNS-сервери у вашому середовищі та обслуговує DNS-записи для сервісів Kubernetes.
Контейнери, запущені за допомогою Kubernetes, автоматично включають цей DNS-сервер до своїх DNS-пошуків.
Вебінтерфейс (Dashboard)
Dashboard — це універсальний вебінтерфейс для кластерів Kubernetes. Він дозволяє користувачам керувати застосунками, що працюють у кластері, та усувати проблеми з ними, а також із самим кластером.
Моніторинг ресурсів контейнерів
Моніторинг ресурсів контейнерів записує загальні метрики часових рядів для контейнерів у центральну базу даних та надає інтерфейс для перегляду цих даних.
Логування на рівні кластера
Механізм логування на рівні кластера відповідає за збереження логів контейнерів в центральному сховищі логів з інтерфейсом пошуку та перегляду.
Мережеві втулки
Мережеві втулки — це програмні компоненти, які реалізують специфікацію інтерфейсу мережі контейнерів (CNI). Вони відповідають за виділення IP-адрес Podʼам та забезпечення їх звʼязку між собою у кластері.
Варіації архітектури
Хоча основні компоненти Kubernetes залишаються незмінними, способи їх розгортання та управління можуть відрізнятися. Розуміння цих варіацій є ключовим для проєктування та підтримки кластерів Kubernetes, що відповідають специфічним операційним потребам.
Варіанти розгортання панелі управління
Компоненти панелі управління можна розгортати кількома способами:
Традиційне розгортання
Компоненти панелі управління працюють безпосередньо на виділених машинах або віртуальних машинах, часто керованих як служби systemd.
Статичні Podʼи
Компоненти панелі управління розгортаються як статичні Podʼи, керовані kubelet на певних вузлах. Це поширений підхід, який використовують такі інструменти, як kubeadm.
Самостійне розміщення
Панель управління працює як Podʼи у самому кластері Kubernetes, якими керують Deployments та StatefulSets або інші примітиви Kubernetes.
Керовані сервіси Kubernetes
Хмарні провайдери часто абстрагують панель управління, керуючи її компонентами як частиною послуги, яку вони надають.
Розміщення робочих навантажень
Розміщення робочих навантажень, включаючи компоненти панелі управління, може варіюватися залежно від розміру кластера, вимог до продуктивності та операційних політик:
У менших або розробницьких кластерах компоненти панелі управління та робочі навантаження користувачів можуть працювати на тих самих вузлах.
Великі промислові кластери часто виділяють певні вузли для компонентів панелі управління, відокремлюючи їх від робочих навантажень користувачів.
Деякі організації запускають критично важливі надбудови або інструменти моніторингу на вузлах панелі управління.
Інструменти управління кластером
Такі інструменти, як kubeadm, kops та Kubespray, пропонують різні підходи до розгортання та управління кластерами, кожен з яких має свій метод розташування та управління компонентами.
Налаштування та розширюваність
Архітектура Kubernetes дозволяє значне налаштування:
Власні планувальники можна розгортати паралельно зі стандартним планувальником Kubernetes або замінювати його повністю.
API-сервери можна розширювати за допомогою CustomResourceDefinitions та API Aggregation.
Хмарні провайдери можуть глибоко інтегруватися з Kubernetes за допомогою cloud-controller-manager.
Гнучкість архітектури Kubernetes дозволяє організаціям налаштовувати свої кластери відповідно до специфічних потреб, балансуючи фактори, такі як операційна складність, продуктивність та управлінські витрати.
Kubernetes виконує ваше робоче навантаження шляхом розміщення контейнерів у Podʼах для запуску на вузлах. Вузол може бути віртуальною або фізичною машиною, залежно від кластера. Кожен вузол керується панеллю управління і містить необхідні служби для запуску Podʼів.
Зазвичай в кластері є кілька вузлів; в умовах навчання чи обмежених ресурсів може бути всього один вузол.
Є два основних способи додавання вузлів до API-сервера:
kubelet на вузлі самостійно реєструється в панелі управління.
Ви (або інший користувач) вручну додаєте обʼєкт Node.
Після створення обʼєкта Node або якщо kubelet на вузлі самостійно реєструється, панель управління перевіряє, чи новий обʼєкт Node є дійсним. Наприклад, якщо ви спробуєте створити вузол із таким JSON-маніфестом:
Kubernetes внутрішньо створює обʼєкт Node (його представлення). Kubernetes перевіряє, чи kubelet, що відповідає полю metadata.name обʼєкта Node, зареєструвався в API-сервері. Якщо вузол є справним (тобто всі необхідні служби працюють), то він може запускати Podʼи. В іншому випадку цей вузол ігнорується для будь-якої діяльності кластера, доки він не стане справним.
Примітка:
Kubernetes зберігає обʼєкт для недійсного вузла та продовжує перевіряти, чи він стає справним.
Ви або контролер маєте явно видалити обʼєкт Node, щоб припинити цю перевірку його справності.
Назва ідентифікує Node. Два вузли не можуть мати однакову назву одночасно. Kubernetes також припускає, що ресурс із такою самою назвою — це той самий обʼєкт. У випадку вузла припускається неявно, що екземпляр, який використовує ту саму назву, матиме той самий стан (наприклад, мережеві налаштування, вміст кореневого диска) та атрибути, такі як мітки вузла. Це може призвести до невідповідностей, якщо екземпляр був змінений без зміни його назви. Якщо вузол потрібно замінити або значно оновити, наявний обʼєкт Node потрібно спочатку видалити з API-сервера, а після оновлення додати знову.
Самореєстрація вузлів
Коли прапорець kubelet --register-node є true (типово), kubelet спробує зареєструвати себе в API-сервері. Це бажаний підхід, який використовується більшістю дистрибутивів.
Для самореєстрації kubelet запускається з такими параметрами:
--kubeconfig — Шлях до облікових даних для автентифікації на API-сервері.
--cloud-provider — Як взаємодіяти з хмарним провайдером для отримання метаданих про себе.
--register-node — Автоматична реєстрація в API-сервері.
Нічого не відбувається, якщо register-node є false.
--node-ip — Необовʼязковий розділений комами список IP-адрес вузла. Можна вказати лише одну адресу для кожного сімейства адрес. Наприклад, у кластері з одним стеком IPv4 ви встановлюєте це значення як IPv4-адресу, яку повинен використовувати kubelet для вузла. Див. Налаштування подвійного стека IPv4/IPv6 для отримання відомостей про запуск кластера з подвійним стеком.
Якщо ви не вказали цей аргумент, kubelet використовує стандартну IPv4-адресу вузла, якщо є; якщо у вузла немає адреси IPv4, тоді kubelet використовує стандартну IPv6-адресу вузла.
Як зазначено в розділі Унікальність назв вузлів, коли потрібно оновити конфігурацію вузла, доброю практикою є повторна реєстрація вузла в API-сервері. Наприклад, якщо kubelet перезапускається з новим набором --node-labels, але використовується та сама назва Node, зміна не набуде чинності, оскільки мітки встановлюються (або змінюються) лише під час реєстрації вузла в API-сервері.
Podʼи, вже заплановані на Node, можуть погано поводитися або викликати проблеми, якщо конфігурація Node буде змінена при перезапуску kubelet. Наприклад, вже запущений Pod може виявитися несумісним із новими мітками, призначеними вузлу, тоді як інші Podʼи, несумісні з цим Podʼом, будуть заплановані на основі цієї нової мітки. Перереєстрація вузла гарантує, що вузол буде очищено від усіх Podʼів і їх буде належним чином переплановано.
Ручне адміністрування вузлів
Ви можете створювати та змінювати обʼєкти Node за допомогою kubectl.
Коли ви хочете створювати обʼєкти Node вручну, встановіть прапорець kubelet --register-node=false.
Ви можете змінювати обʼєкти Node незалежно від налаштувань --register-node. Наприклад, ви можете встановлювати мітки на наявному вузлі або позначати його як непридатний для планування.
Ви можете встановити необовʼязкові ролі для вузлів, додавши одну або кілька міток node-role.kubernetes.io/<role>: <role> до вузла, де символи <role> обмежуються правилами синтаксису для міток.
Kubernetes ігнорує значення мітки для ролей вузлів; за домовленістю, ви можете задати для неї той самий рядок, який ви використовували для ролі вузла у ключі мітки.
Ви можете використовувати мітки на вузлах разом із селекторами вузлів на Podʼах для управління плануванням. Наприклад, ви можете дозволити Podʼу запускатися лише на підмножині доступних вузлів.
Позначення вузла як непридатного для планування перешкоджає планувальнику розміщувати нові Podʼи на цьому вузлі, але не впливає на наявні Podʼи на вузлі. Це корисно як підготовчий крок перед перезавантаженням вузла чи іншим обслуговуванням.
Щоб позначити вузол як непридатний для планування, виконайте:
Podʼи, які є частиною DaemonSet, толерують запуск на вузлі, непридатному для планування. Зазвичай DaemonSets надають служби, локальні для вузла, які мають працювати на ньому, навіть якщо він очищується від робочих навантажень.
Обʼєкти Lease у просторі іменkube-node-lease. Кожен вузол має асоційований обʼєкт Lease.
Контролер вузлів
Контролер вузлів — це компонент панелі управління Kubernetes, який керує різними аспектами роботи вузлів.
У контролера вузлів є кілька ролей у житті вузла. По-перше, він призначає блок CIDR вузлу при його реєстрації (якщо призначення CIDR увімкнено).
По-друге, він підтримує актуальність внутрішнього списку вузлів контролера зі списком доступних машин хмарного провайдера. Під час роботи в хмарному середовищі, коли вузол несправний, контролер вузлів запитує в хмарного провайдера, чи ще доступна віртуальна машина (VM) для цього вузла. Якщо ні, контролер вузлів видаляє вузол зі свого списку вузлів.
По-третє, він відстежує справність вузлів. Контролер вузлів відповідає за:
У випадку, якщо вузол стає недоступним, оновлення умови Ready у полі .status вузла. У цьому випадку контролер вузлів встановлює умову Ready в Unknown.
Якщо вузол залишається недоступним: запуск виселення, ініційоване API для всіх Podʼів на недосяжному вузлі. Типово контролер вузлів чекає 5 хвилин між позначенням вузла як Unknown та поданням першого запиту на виселення.
Стандартно контролер вузлів перевіряє стан кожного вузла кожні 5 секунд. Цей період можна налаштувати за допомогою прапорця --node-monitor-period у компоненті kube-controller-manager.
Обмеження швидкості виселення
У більшості випадків контролер вузлів обмежує швидкість виселення до --node-eviction-rate (типово 0,1) за секунду, тобто він не виселятиме Podʼи більш ніж з 1 вузла за 10 секунд.
Поведінка виселення змінюється, коли вузол у певній зоні доступності стає несправним. Контролер вузлів перевіряє, яка частина вузлів в зоні є несправною (умова Ready — Unknown або False) у той самий час:
Якщо частка несправних вузлів становить принаймні --unhealthy-zone-threshold (типово 0,55), тоді швидкість виселення зменшується.
Якщо кластер малий (тобто має не більше ніж --large-cluster-size-threshold вузлів — типово 50), тоді виселення припиняється.
В іншому випадку швидкість виселення зменшується до --secondary-node-eviction-rate (типово 0,01) в секунду.
Причина того, що ці політики реалізовані окремо для кожної зони доступності, полягає в тому, що одна зона може втратити зʼєднання з панеллю управління, тоді як інші залишаються підключеними. Якщо ваш кластер не охоплює кілька зон доступності хмарного провайдера, тоді механізм виселення не враховує недоступність окремих зон.
Однією з ключових причин розподілу вузлів за зонами доступності є можливість переміщення навантаження в справні зони, коли одна ціла зона виходить з ладу. Таким чином, якщо всі вузли в зоні несправні, контролер вузлів виселяє Podʼи зі звичайною швидкістю --node-eviction-rate. Крайній випадок — коли всі зони повністю несправні (жоден вузол в кластері не є справним). У такому випадку контролер вузлів припускає, що існує якась проблема зі зʼєднанням між панеллю управління та вузлами, і не виконує жодних виселень. (Якщо стався збій і деякі вузли відновились, контролер вузлів виселяє Podʼи з решти вузлів, які є несправними або недосяжними).
Контролер вузлів також відповідає за виселення Podʼів, що працюють на вузлах із taints NoExecute, якщо ці Podʼи не толерують цей taint. Контролер вузлів також додає taints, відповідні проблемам вузла, таким як недосяжність вузла або неготовність вузла. Це означає, що планувальник не розміщуватиме Podʼи на несправних вузлах.
Відстеження місткості ресурсів
Обʼєкти Node відстежують інформацію про ресурсну місткість вузла: наприклад, кількість доступної памʼяті та кількість процесорів. Вузли, які реєструються самостійно, повідомляють про свою місткість під час реєстрації. Якщо ви додаєте вузол вручну, то вам потрібно встановити інформацію про місткість вузла при його додаванні.
Планувальник Kubernetes забезпечує, що на вузлі є достатньо ресурсів для всіх Podʼів. Планувальник перевіряє, що сума запитів контейнерів на вузлі не перевищує місткості вузла. Ця сума запитів включає всі контейнери, керовані kubelet, але не включає жодні контейнери, запущені безпосередньо середовищем виконання контейнерів, а також виключає будь-які процеси, які працюють поза контролем kubelet.
This is a stable feature in Kubernetes, and has been since the 1.27 release. You can no longer toggle this feature (the associated feature gate has been removed).
Якщо ви увімкнули функціональну можливість TopologyManager, то kubelet може використовувати підказки топології при прийнятті рішень щодо призначення ресурсів. Див. Керування політиками топології на вузлі для отримання додаткової інформації.
Цей документ описує шляхи звʼязку між API-сервером та кластером Kubernetes. Мета — надати користувачам можливість налаштувати своє встановлення та посилити конфігурацію мережі так, щоб кластер можна було запускати в ненадійній мережі (або на повністю публічних IP-адресах у хмарному середовищі).
Звʼязок вузла з панеллю управління
У Kubernetes існує шаблон API "hub-and-spoke". Усе використання API з боку вузлів (або Podʼів, які на них працюють) завершується на API-сервері. Інші компоненти панелі управління не призначені для надання віддалених сервісів. API-сервер налаштований для прослуховування віддалених підключень на захищеному порту HTTPS (зазвичай 443) з однією або кількома увімкненими формами автентифікації клієнта. Рекомендується увімкнути одну чи кілька форм авторизації, особливо якщо анонімні запити або токени службового облікового запису дозволені.
Вузли повинні бути забезпечені публічним кореневим сертифікатом для кластера, щоб вони могли безпечно підключатися до API-сервера разом з дійсними обліковими даними клієнта. Добрий підхід — надавати kubelet облікові дані клієнта у формі клієнтського сертифіката. Див. завантаження TLS kubelet для автоматичного надання клієнтських сертифікатів kubelet.
Podʼи, які бажають підʼєднатися до API-сервера, можуть це зробити безпечно, використовуючи службовий обліковий запис (service account), так що Kubernetes автоматично вставлятиме публічний кореневий сертифікат та дійсний токен на предʼявника у Pod під час його створення. Service kubernetes (у просторі імен default) налаштована з віртуальною IP-адресою, яка перенаправляється (через kube-proxy) на точку доступу HTTPS на API-сервері.
Компоненти панелі управління також взаємодіють з API-сервером через захищений порт.
У результаті типовий режим роботи для зʼєднань від вузлів та Podʼів, що працюють на вузлах, до панелі управління є захищеним і може працювати через ненадійні та/або публічні мережі.
Звʼязок панелі управління з вузлом
Існують два основних шляхи звʼязку панелі управління (API-сервера) з вузлами. Перший — від API-сервера до процесу kubelet, який працює на кожному вузлі в кластері. Другий — від API-сервера до будь-якого вузла, Podʼа чи Service через проксі API-сервера.
Звʼязок API-сервера з kubelet
Зʼєднання від API-сервера до kubelet використовуються для:
Отримання логів для Podʼів.
Приєднання (зазвичай через kubectl) до запущених Podʼів.
Забезпечення функціональності перенаправлення портів kubelet.
Ці зʼєднання завершуються на точці доступу HTTPS kubelet. Стандартно API-сервер не перевіряє сертифікат обслуговування kubelet, що робить зʼєднання вразливим до атаки "людина посередині" і небезпечним для використання через ненадійні та/або публічні мережі.
Щоб перевірити це зʼєднання, використовуйте прапорець --kubelet-certificate-authority, щоб надати API-серверу пакет кореневих сертифікатів для перевірки сертифіката обслуговування kubelet.
Якщо це неможливо, скористайтеся тунелюванням SSH між API-сервером та kubelet, якщо необхідно, щоб уникнути підключення через ненадійну або публічну мережу.
Зʼєднання від API-сервера до вузла, Podʼа чи Service типово використовують прості HTTP-зʼєднання і, отже, не автентифікуються й не шифруються. Їх можна використовувати через захищене зʼєднання HTTPS, підставивши https: перед назвою вузла, Podʼа чи Service в URL API, але вони не будуть перевіряти сертифікат, наданий точкою доступу HTTPS, та не надаватимуть облікові дані клієнта. Таким чином, хоча зʼєднання буде зашифрованим, воно не гарантує цілісності. Ці зʼєднання поки не є безпечними для використання через ненадійні або публічні мережі.
Тунелі SSH
Kubernetes підтримує тунелі SSH, щоб захистити канали звʼязку від панелі управління до вузлів. У цій конфігурації API-сервер ініціює тунель SSH до кожного вузла в кластері (підключаючись до SSH-сервера, який прослуховує порт 22) і передає весь трафік, призначений для kubelet, вузла, Podʼа чи Service, через тунель. Цей тунель гарантує, що трафік не виходить за межі мережі, в якій працюють вузли.
Примітка:
Тунелі SSH наразі застарілі, тому не варто їх використовувати, якщо ви не знаєте, що робите. Служба Konnectivity — це заміна для цього каналу звʼязку.
Служба Konnectivity
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.18
Як заміна тунелям SSH, служба Konnectivity надає проксі на рівні TCP для звʼязку панелі управління з кластером. Служба Konnectivity складається з двох частин: сервера Konnectivity в мережі панелі управління та агентів Konnectivity в мережі вузлів. Агенти Konnectivity ініціюють зʼєднання з сервером Konnectivity та підтримують мережеві підключення. Після ввімкнення служби Konnectivity весь трафік від панелі управління до вузлів проходить через ці зʼєднання.
Для налаштування служби Konnectivity у своєму кластері скористайтеся завданням служби Konnectivity.
У робототехніці та автоматизації control loop (цикл управління) — це нескінченний цикл, який регулює стан системи.
Ось один приклад циклу управління — термостат у кімнаті.
Коли ви встановлюєте температуру, це означає, що ви повідомляєте термостату про бажаний стан. Фактична температура в кімнаті — це поточний стан. Термостат діє так, щоб наблизити поточний стан до бажаного стану, вмикаючи чи вимикаючи відповідне обладнання.
У Kubernetes контролери — це цикли управління, які спостерігають за станом вашого кластера, а потім вносять або запитують зміни там, де це необхідно. Кожен контролер намагається наблизити поточний стан кластера до бажаного.
Шаблон контролера
Контролер відстежує принаймні один тип ресурсу Kubernetes. Ці обʼєкти мають поле spec, яке представляє бажаний стан. Контролер(и) для цього ресурсу відповідають за наближення поточного стану до цього бажаного стану.
Контролер може виконати дію самостійно; частіше в Kubernetes контролер надсилає повідомлення API-серверу, які мають корисні побічні ефекти. Нижче ви побачите приклади цього.
Управління через API-сервер
Контролер Job — це приклад вбудованого контролера Kubernetes. Вбудовані контролери управляють станом, взаємодіючи з API-сервером кластера.
Job — це ресурс Kubernetes, який запускає Pod або, можливо, кілька Podʼів, щоб виконати завдання і потім зупинитися.
(Після процесу планування, обʼєкти Pod стають частиною бажаного стану для kubelet).
Коли контролер Job бачить нове завдання, він переконується, що десь у вашому кластері kubeletʼи на наборі вузлів виконують потрібну кількість Podʼів, щоб виконати роботу. Контролер Job не запускає жодних Podʼів або контейнерів самостійно. Замість цього контролер Job вказує API-серверу створити або видалити Podʼи. Інші компоненти панелі управління реагують на нову інформацію (є нові Podʼи для планування та запуску), і зрештою робота виконується.
Після того, як ви створите нове завдання, бажаний стан полягає в тому, щоб це завдання було завершене. Контролер Job наближає поточний стан цього завдання до бажаного: створює Podʼи, які виконують потрібну вам роботу, щоб завдання було ближчим до завершення.
Контролери також оновлюють обʼєкти, які їх конфігурують. Наприклад, коли роботу для завдання виконано, контролер Job оновлює обʼєкт Job, щоб позначити його як Finished.
(Це трошки схоже на те, як деякі термостати вимикають світловий індикатор, щоб сповістити, що ваша кімната тепер має температуру, яку ви встановили).
Безпосереднє управління
На відміну від Job, деякі контролери повинні вносити зміни за межами вашого кластера.
Наприклад, якщо ви використовуєте цикл управління, щоб переконатися, що у вашому кластері є достатньо вузлів, то цей контролер потребує чогось поза поточним кластером, щоб налаштовувати нові вузли за потреби.
Контролери, які взаємодіють із зовнішнім станом, отримують свій бажаний стан від API-сервера, а потім безпосередньо взаємодіють із зовнішньою системою для наближення поточного стану до бажаного.
(Фактично є контролер, що горизонтально масштабує вузли у вашому кластері).
Важливим тут є те, що контролер вносить певні зміни, щоб досягти вашого бажаного стану, а потім повідомляє поточний стан назад на API-сервер вашого кластера. Інші цикли управління можуть спостерігати за цими даними та виконувати свої дії.
У прикладі з термостатом, якщо в кімнаті дуже холодно, то інший контролер може також увімкнути обігрівач для захисту від морозу. У кластерах Kubernetes панель управління опосередковано працює з інструментами управління IP-адресами, сервісами сховища, API хмарних провайдерів та іншими сервісами, розширюючи Kubernetes для цього.
Бажаний стан порівняно з поточним
Kubernetes дивиться на системи з погляду cloud-native і здатний обробляти постійні зміни.
Ваш кластер може змінюватися в будь-який момент під час роботи, а цикли управління автоматично виправляють збої. Це означає, що, потенційно, ваш кластер ніколи не досягає стабільного стану.
Поки контролери вашого кластера працюють і можуть робити корисні зміни, не має значення, чи є загальний стан сталим, чи ні.
Дизайн
Як принцип дизайну, Kubernetes використовує багато контролерів, кожен з яких керує певним аспектом стану кластера. Найчастіше певний цикл управління (контролер) використовує один вид ресурсу як свій бажаний стан і має інший вид ресурсу, яким він управляє, щоб досягти цього бажаного стану. Наприклад, контролер для ресурсу Job відстежує обʼєкти Job (для виявлення нової роботи) та обʼєкти Pod (для запуску обʼєктів Job і подальшого визначення, коли робота закінчена). У цьому випадку щось інше створює обʼєкти Job, тоді як контролер Job створює Podʼи.
Корисно мати прості контролери, а не один великий набір взаємозалежних циклів управління. Контролери можуть виходити з ладу, тому Kubernetes спроєктовано з урахуванням цього.
Примітка:
Може існувати кілька контролерів, які створюють або оновлюють один і той самий вид обʼєктів. За лаштунками контролери Kubernetes переконуються, що вони звертають увагу лише на ресурси, повʼязані з ресурсом, який ними керує.
Наприклад, ви можете мати ресурси Deployments і Jobs; обидва ці ресурси створюють Podʼи. Контролер Job не видаляє Podʼи, які створив ваш Deployment, оскільки є інформація (мітки), яку контролери можуть використовувати для розрізнення цих Podʼів.
Способи запуску контролерів
Kubernetes постачається з набором вбудованих контролерів, які працюють всередині kube-controller-manager. Ці вбудовані контролери забезпечують важливі основні функції.
Контролер Deployment та контролер Job — це приклади контролерів, які постачаються разом з Kubernetes (контролери, вбудовані в систему). Kubernetes дозволяє вам запускати стійку панель управління, так що, якщо будь-який з вбудованих контролерів не зможе виконувати завдання, інша частина панелі управління візьме на себе його обовʼязки.
Ви можете знайти контролери, які працюють поза панеллю управління, для розширення Kubernetes. Або, якщо ви хочете, ви можете написати новий контролер самостійно. Ви можете запустити свій власний контролер як набір Podʼів, або поза межами Kubernetes. Те, що найкраще підходить, буде залежати від того, що саме робить цей контролер.
Часто в розподілених системах є потреба в лізингу, який забезпечує механізм блокування спільних ресурсів та координації дій між членами групи. У Kubernetes концепцію лізингу представлено обʼєктами Lease в групі APIcoordination.k8s.io, які використовуються для критичних для системи можливостей, таких як пульс вузлів (heartbeats) та вибір лідера на рівні компонентів.
Пульс вузлів
Kubernetes використовує API Lease для передачі пульсу (heartbeats) kubelet вузла на API-сервер Kubernetes. Для кожного Node існує обʼєкт Lease з відповідною назвою в просторі імен kube-node-lease. Під капотом кожен сигнал пульсу kubelet — це запит на оновлення цього обʼєкта Lease, який оновлює поле spec.renewTime для обʼєкта Lease. Панель управління Kubernetes використовує відмітку часу цього поля для визначення доступності цього вузла.
Kubernetes також використовує лізинги, щоб у будь-який момент часу працював лише один екземпляр компонента. Це використовується компонентами панелі управління, такими як kube-controller-manager та kube-scheduler в конфігураціях з високою доступністю, де лише один екземпляр компонента має активно працювати, тоді як інші екземпляри перебувають в режимі очікування.
Прочитайте координовані вибори лідера, щоб дізнатися про те, як Kubernetes використовує Lease API для вибору екземпляра компонента, який буде виконувати роль лідера.
Звільнення блокування вибору лідера kube controller manager під час виходу
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
Коли функціональна можливість ControllerManagerReleaseLeaderElectionLockOnExit увімкнена, kube-controller-manager активно звільняє блокування вибору лідера під час переходу лідерства, замість того, щоб чекати закінчення терміну дії блокування. Це дозволяє швидше обрати нового лідера, зменшуючи затримку переходу лідерства.
Ідентичність API-сервера
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.26; (стандартно увімкнено)
Починаючи з Kubernetes v1.26, кожен kube-apiserver використовує API Lease для публікації своєї ідентичності для решти системи. Хоча це само по собі не є особливо корисним, це забезпечує механізм для клієнтів для визначення кількості екземплярів kube-apiserver, які керують панеллю управління Kubernetes. Наявність лізингів kube-apiserver уможливлює майбутні функції, які можуть потребувати координації між усіма kube-apiserver.
Ви можете перевірити лізинги, якими володіє кожен kube-apiserver, перевіривши обʼєкти лізингу в просторі імен kube-system з назвою apiserver-<sha256-hash>. Або ви можете використовувати селектор міток apiserver.kubernetes.io/identity=kube-apiserver:
kubectl -n kube-system get lease -l apiserver.kubernetes.io/identity=kube-apiserver
NAME HOLDER AGE
apiserver-07a5ea9b9b072c4a5f3d1c3702 apiserver-07a5ea9b9b072c4a5f3d1c3702_0c8914f7-0f35-440e-8676-7844977d3a05 5m33s
apiserver-7be9e061c59d368b3ddaf1376e apiserver-7be9e061c59d368b3ddaf1376e_84f2a85d-37c1-4b14-b6b9-603e62e4896f 4m23s
apiserver-1dfef752bcb36637d2763d1868 apiserver-1dfef752bcb36637d2763d1868_c5ffa286-8a9a-45d4-91e7-61118ed58d2e 4m43s
Хеш SHA256, який використовується в назвах лізингу, базується на імені хоста операційної системи, яке бачить цей API-сервер. Кожен kube-apiserver повинен бути налаштований на використання імені хоста, унікального в межах кластера. Нові екземпляри kube-apiserver, які використовують те саме імʼя хоста, перехоплюють наявні лізинги за допомогою нового ідентифікатора власника, замість того щоб створювати нові обʼєкти лізингу. Ви можете перевірити імʼя хоста, яке використовує kube-apiserver, перевіривши значення мітки kubernetes.io/hostname:
kubectl -n kube-system get lease apiserver-07a5ea9b9b072c4a5f3d1c3702 -o yaml
Прострочені лізинги від kube-apiserver, які вже не існують, прибираються новими kube-apiserver через 1 годину.
Ви можете вимкнути лізинги ідентичності API-сервера, вимкнувши функціональну можливістьAPIServerIdentity.
Робочі навантаження
Ваші власні робочі навантаження можуть визначити своє власне використання лізингів. Наприклад, ви можете запускати власний контролер, де основний член чи лідер виконує операції, яких не виконують інші члени групи. Ви визначаєте лізинг так, щоб репліки контролера могли вибирати чи обирати лідера, використовуючи API Kubernetes для координації. Якщо ви використовуєте лізинг, гарною практикою є визначати назву лізингу, яка очевидно повʼязана з продуктом чи компонентом. Наприклад, якщо у вас є компонент з назвою Example Foo, використовуйте лізинг з назвою example-foo.
Якщо оператор кластера чи інший кінцевий користувач може розгортати кілька екземплярів компонента, виберіть префікс назви та механізм (такий як хеш від назви Deployment), щоб уникнути конфліктів назв лізингів.
Ви можете використовувати інший підхід, якщо він досягає того самого результату: відсутність конфліктів між різними програмними продуктами.
6.2.5 - Cloud Controller Manager
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.11
Технології хмарної інфраструктури дозволяють вам запускати Kubernetes в публічних, приватних та гібридних хмарах. Kubernetes вірить в автоматизовану інфраструктуру, що працює за допомогою API без тісного звʼязку між компонентами.
Cloud-controller-manager — це компонент панелі управління Kubernetes, що вбудовує логіку управління, специфічну для хмари. Cloud controller manager дозволяє звʼязувати ваш кластер з API хмарного провайдера та відокремлює компоненти, що взаємодіють із хмарною платформою, від компонентів, які взаємодіють тільки з вашим кластером.
Відокремлюючи логіку сумісності між Kubernetes і базовою хмарною інфраструктурою, компонент cloud-controller-manager дає змогу хмарним провайдерам випускати функції з іншою швидкістю порівняно з основним проєктом Kubernetes.
Cloud-controller-manager структурується за допомогою механізму втулків, який дозволяє різним хмарним провайдерам інтегрувати свої платформи з Kubernetes.
Дизайн
Cloud-controller-manager працює в панелі управління як реплікований набір процесів (зазвичай це контейнери в Podʼах). Кожен cloud-controller-manager реалізує кілька контролерів в одному процесі.
Примітка:
Ви також можете запускати cloud-controller-manager як надбудову Kubernetes, а не як частину панелі управління.
Функції cloud-controller-manager
Контролери всередині cloud-controller-manager включають:
Контролер вузлів
Контролер вузлів відповідає за оновлення обʼєктів Node при створенні нових серверів у вашій хмарній інфраструктурі. Контролер вузлів отримує інформацію про хости, які працюють у вашому обліковому записі у хмарному провайдері. Контролер вузлів виконує такі функції:
Оновлення обʼєкта Node відповідним унікальним ідентифікатором сервера, отриманим з API хмарного провайдера.
Додавання до обʼєкта Node анотацій та міток з інформацією, специфічною для хмари, такою як регіон, в якому розгорнуто вузол, та доступні йому ресурси (CPU, памʼять тощо).
Отримання імені хоста та мережевих адрес.
Перевірка стану вузла. Якщо вузол перестає відповідати, цей контролер перевіряє за допомогою API вашого хмарного провайдера, чи сервер був деактивований / видалений / завершений. Якщо вузол був видалений з хмари, контролер видаляє обʼєкт Node з вашого кластера Kubernetes.
Деякі реалізації від хмарних провайдерів розділяють це на контролер вузлів та окремий контролер життєвого циклу вузла.
Контролер маршрутів
Контролер маршрутів відповідає за налаштування маршрутів у хмарі відповідним чином, щоб контейнери на різних вузлах вашого кластера Kubernetes могли взаємодіяти один з одним.
Залежно від хмарного провайдера контролер маршрутів може також виділяти блоки IP-адрес для мережі Podʼів.
Контролер Service
Services інтегруються з компонентами хмарної інфраструктури, такими як керовані балансувальники навантаження, IP-адреси, мережеве фільтрування пакетів та перевірка стану цільового обʼєкта. Контролер Service взаємодіє з API вашого хмарного провайдера для налаштування балансувальників навантаження та інших компонентів інфраструктури, коли ви оголошуєте ресурс Service, який їх потребує.
Авторизація
У цьому розділі розглядаються доступи, яких потребує cloud-controller-manager для різних обʼєктів API для виконання своїх операцій.
Контролер вузлів
Контролер вузлів працює тільки з обʼєктами Node. Він вимагає повного доступу для читання та модифікації обʼєктів Node.
v1/Node:
get
list
create
update
patch
watch
delete
Контролер маршрутів
Контролер маршрутів відстежує створення обʼєктів Node та налаштовує маршрути відповідним чином. Він вимагає доступу Get до обʼєктів Node.
v1/Node:
get
Контролер Service
Контролер Service відстежує події create, update та delete обʼєктів Service, а потім відповідним чином налаштовує балансувальники навантаження для цих Services.
Для доступу до Service потрібні доступи list та watch. Для оновлення Service потрібен доступ patch та update до підресурсу status.
v1/Service:
list
get
watch
patch
update
Інші
Реалізація ядра cloud-controller-manager потребує доступу до створення Event, а для забезпечення безпечної роботи — доступу до створення ServiceAccounts.
v1/Event:
create
patch
update
v1/ServiceAccount:
create
RBAC ClusterRole для cloud-controller-manager виглядає так:
Хочете знати, як реалізувати свій власний cloud-controller-manager або розширити наявний проєкт?
Cloud-controller-manager використовує інтерфейси Go, зокрема, інтерфейс CloudProvider, визначений у cloud.go з kubernetes/cloud-provider, щоб дозволити підключати реалізації для будь-якої хмари.
Реалізація загальних контролерів, виділених у цьому документі (Node, Route та Service), а також допоміжний каркас разом із загальним інтерфейсом хмарного провайдера є частиною ядра Kubernetes. Реалізації, специфічні для хмарних провайдерів, знаходяться поза ядром Kubernetes і реалізують інтерфейс CloudProvider.
У Linux контрольні групи обмежують ресурси, які виділяються процесам.
kubelet та середовище виконання контейнерів повинні співпрацювати з cgroups для забезпечення управління ресурсами для Podʼів та контейнерів, що включає запити та обмеження CPU/памʼяті для контейнеризованих робочих навантажень.
Є дві версії cgroups у Linux: cgroup v1 і cgroup v2. cgroup v2 — це нове покоління API cgroup в Linux.
Що таке cgroup v2?
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
cgroup v2 — це наступне покоління API Linux cgroup. cgroup v2 надає єдину систему управління з розширеними можливостями управління ресурсами.
cgroup v2 пропонує кілька поліпшень порівняно з cgroup v1, таких як:
Розширене управління розподілом ресурсів та ізоляція між різними ресурсами
Обʼєднаний облік різних типів виділення памʼяті (мережева памʼять, памʼять ядра і т. д.)
Облік відкладених змін ресурсів, таких як запис кешу сторінок
Деякі можливості Kubernetes використовують виключно cgroup v2 для поліпшення управління ресурсами та ізоляцією. Наприклад, можливість MemoryQoS покращує якість обслуговування памʼяті та покладається на примітиви cgroup v2.
Використання cgroup v2
Рекомендованим способом використання cgroup v2 є використання дистрибутиву Linux, який стандартно вмикає та використовує cgroup v2.
kubelet та середовище виконання контейнерів налаштовані на використання cgroup-драйвера systemd
Підтримка cgroup v2 дистрибутивами Linux
Для ознайомлення зі списком дистрибутивів Linux, які використовують cgroup v2, див. документацію cgroup v2
Container Optimized OS (з версії M97)
Ubuntu (з версії 21.10, рекомендовано 22.04+)
Debian GNU/Linux (з Debian 11 bullseye)
Fedora (з версії 31)
Arch Linux (з квітня 2021)
RHEL та схожі дистрибутиви (з версії 9)
Щоб перевірити, чи ваш дистрибутив використовує cgroup v2, див. документацію вашого дистрибутиву або скористайтеся інструкціями в Визначенні версії cgroup на вузлах Linux.
Також можна увімкнути cgroup v2 вручну у вашому дистрибутиві Linux, змінивши аргументи завантаження ядра. Якщо ваш дистрибутив використовує GRUB, systemd.unified_cgroup_hierarchy=1 повинно бути додано в GRUB_CMDLINE_LINUX в /etc/default/grub, а потім виконайте sudo update-grub. Однак рекомендованим підходом є використання дистрибутиву, який вже стандартно вмикає cgroup v2.
Міграція на cgroup v2
Щоб перейти на cgroup v2, переконайтеся, що ваша система відповідає вимогам, а потім оновіть її до версії ядра, яка стандартно вмикає cgroup v2.
Kubelet автоматично виявляє, що ОС працює з cgroup v2 і діє відповідно без додаткової конфігурації.
При переході на cgroup v2 не повинно бути помітної різниці в використанні, якщо користувачі не звертаються безпосередньо до файлової системи cgroup чи на вузлі, чи зсередини контейнерів.
cgroup v2 використовує інший API, ніж cgroup v1, тому, якщо є застосунки, які безпосередньо отримують доступ до файлової системи cgroup, вони повинні бути оновлені до новіших версій, які підтримують cgroup v2. Наприклад:
Деякі сторонні агенти моніторингу та безпеки можуть залежати від файлової системи cgroup. Оновіть ці агенти до версій, які підтримують cgroup v2.
Якщо ви використовуєте cAdvisor як окремий DaemonSet для моніторингу Podʼів та контейнерів, оновіть його до v0.43.0 чи новіше.
Якщо ви розгортаєте Java-застосунки, віддайте перевагу використанню версій, які повністю підтримують cgroup v2:
Якщо ви використовуєте пакунок uber-go/automaxprocs, переконайтеся, що ви використовуєте версію v1.5.1 чи вище.
Якщо ви розгортаєте застосунки на Node.js, віддавайте перевагу версіям, які виявляють обмеження памʼяті cgroup v2. Node.js читає обмеження памʼяті cgroup v2 (через libuv) починаючи з Node.js v20.3.0. Лінія випуску v18 ненадійно виявляє обмеження памʼяті cgroup v2. Версії без цієї підтримки можуть читати загальну памʼять хоста замість обмеження, застосованого до Podʼа, що може призвести до неправильного розміру heap і завершення роботи через нестачу памʼяті (OOM). У версіях, яких це стосується, встановіть розмір heap явно, наприклад за допомогою прапорця --max-old-space-size.
Визначення версії cgroup на вузлах Linux
Версія cgroup залежить від використаного дистрибутиву Linux та версії cgroup, налаштованої в ОС. Щоб перевірити, яка версія cgroup використовується вашим дистрибутивом, виконайте команду stat -fc %T /sys/fs/cgroup/ на вузлі:
stat -fc %T /sys/fs/cgroup/
Для cgroup v2 вивід — cgroup2fs.
Для cgroup v1 вивід — tmpfs.
Визнання застарілим cgroup v1
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.35
Kubelet більше стандартно не буде запускатися на вузлі cgroup v1. Щоб вимкнути це налаштування, адміністратор кластера повинен встановити failCgroupV1 на false у файлі конфігурації kubelet.
Kubernetes розроблено з можливостями самозцілення, які допомагають підтримувати працездатність і доступність робочих навантажень. Він автоматично замінює збійні контейнери, переплановує робочі навантаження, коли вузли стають недоступними, і забезпечує підтримку бажаного стану системи.
Можливості самозцілення
Перезапуски на рівні контейнера: Якщо контейнер всередині Podʼа виходить з ладу, Kubernetes перезапускає його відповідно до restartPolicy.
Заміна реплік: Якщо Pod у Deployment або StatefulSet виходить з ладу, Kubernetes створює Pod на заміну, щоб підтримувати вказану кількість реплік. Якщо Pod, який є частиною DaemonSet, виходить з ладу, панель управління створює Pod на заміну для запуску на тому самому вузлі.
Відновлення постійного сховища: Якщо на вузлі працює Pod з підключеним PersistentVolume (PV), і вузол виходить з ладу, Kubernetes може повторно приєднати том до нового Podʼа на іншому вузлі.
Балансування навантаження для Services: Якщо Pod, що перебуває за Service, виходить з ладу, Kubernetes автоматично видаляє його з точок доступу Service, щоб направляти трафік лише до справних Podʼів.
Ось деякі з ключових компонентів, які забезпечують самозцілення Kubernetes:
kubelet: Забезпечує роботу контейнерів і перезапускає ті, які вийшли з ладу.
Контролери Deployment (через ReplicaSet), ReplicaSet, StatefulSet і DaemonSet: Підтримують бажану кількість реплік Podʼа.
Контролер PersistentVolume: Керує приєднанням і відʼєднанням томів для робочих навантажень зі збереженням стану.
Візьміть до уваги
Збої в сховищі: Якщо постійний том стає недоступним, можуть знадобитися кроки відновлення.
Помилки застосунків: Kubernetes може перезапускати контейнери, але проблеми в самому застосунку необхідно вирішувати окремо.
Читайте про автомасштабування вузлів. Автомасштабування вузлів також забезпечує автоматичне відновлення, якщо вузли виходять з ладу у вашому кластері.
6.2.8 - Збір сміття
Збір сміття — це загальний термін для різних механізмів, які Kubernetes використовує для очищення ресурсів кластера. Це дозволяє очищати ресурси, такі як:
Багато обʼєктів в Kubernetes повʼязані один з одним через посилання на власника. Посилання на власника повідомляють панелі управління, які обʼєкти залежать від інших. Kubernetes використовує посилання на власника для того, щоб дати панелі управління та іншим клієнтам API можливість очищати повʼязані ресурси перед видаленням обʼєкта. У більшості випадків Kubernetes автоматично керує посиланнями на власника.
Власність відрізняється від механізму міток та селекторів, які також використовують деякі ресурси. Наприклад, розгляньте Service, який створює обʼєкти EndpointSlice. Service використовує мітки, щоб дозволити панелі управління визначити, які обʼєкти EndpointSlice використовуються для цього Service. Окрім міток, кожен обʼєкт EndpointSlice, керований від імені Service, має посилання на власника. Посилання на власника допомагають різним частинам Kubernetes уникати втручання в обʼєкти, якими вони не керують.
Примітка:
Посилання на власника з іншого простору імен заборонені за задумом. Залежні обʼєкти в межах простору імен можуть вказувати власників рівня кластера або рівня простору імен. Власник рівня простору імен повинен існувати в тому самому просторі імен, що й залежний обʼєкт. Якщо це не так, таке посилання вважається відсутнім, і залежний обʼєкт підлягає видаленню після перевірки відсутності всіх власників.
Залежні обʼєкти рівня кластера можуть вказувати тільки власників рівня кластера. У v1.20+, якщо залежний обʼєкт рівня кластера вказує як власника тип у межах простору імен, вважається, що він має нерозвʼязне посилання на власника, і його не можна прибрати збором сміття.
У v1.20+, якщо збирач сміття виявляє недійсний ownerReference між просторами імен або залежний обʼєкт рівня кластера з ownerReference, що посилається на тип у межах простору імен, повідомляється про попереджувальну подію з причиною OwnerRefInvalidNamespace та involvedObject недійсного залежного елемента. Ви можете перевірити наявність такого роду подій, запустивши kubectl get events -A --field-selector=reason=OwnerRefInvalidNamespace.
Каскадне видалення
Kubernetes перевіряє та видаляє обʼєкти, які більше не мають посилань на власника, наприклад, Podʼи, які залишилися після видалення ReplicaSet. Коли ви видаляєте обʼєкт, ви можете контролювати, чи автоматично видаляє Kubernetes залежні обʼєкти, у процесі, що називається каскадним видаленням. Існують два типи каскадного видалення:
Каскадне видалення на передньому плані
Каскадне видалення у фоні
Ви також можете контролювати те, як і коли збір сміття видаляє ресурси, які мають посилання на власника, використовуючи завершувачі Kubernetes.
Каскадне видалення на передньому плані
У каскадному видаленні на передньому плані обʼєкт власника, який видаляється, спочатку потрапляє в стан deletion in progress. У цьому стані з обʼєктом власника відбувається таке:
API-сервер Kubernetes встановлює поле metadata.deletionTimestamp обʼєкта на час, коли обʼєкт був позначений на видалення.
API-сервер Kubernetes також встановлює поле metadata.finalizers в foregroundDeletion.
Обʼєкт залишається видимим через API Kubernetes, поки не буде завершений процес видалення.
Після того як обʼєкт власника потрапляє в стан deletion in progress, контролер видаляє відомі йому залежні обʼєкти. Після видалення всіх відомих залежних обʼєктів контролер видаляє обʼєкт власника. На цьому етапі обʼєкт більше не є видимим в API Kubernetes.
Під час каскадного видалення на передньому плані єдиними залежними обʼєктами, які блокують видалення власника, є ті, що мають поле ownerReference.blockOwnerDeletion=true і перебувають у кеші контролера збору сміття. Кеш контролера збору сміття може не містити обʼєкти, тип ресурсу яких не вдається успішно перелічити / відстежувати, або обʼєкти, які створюються одночасно з видаленням обʼєкта-власника. Дивіться Використання каскадного видалення на передньому плані, щоб дізнатися більше.
Каскадне видалення у фоні
Під час фонового каскадного видалення API-сервер Kubernetes негайно видаляє обʼєкт-власник, а контролер збирача сміття (ваш власний або стандартний) очищає залежні обʼєкти у фоновому режимі. Якщо існує завершувач, він гарантує, що обʼєкти не будуть видалені, доки не будуть виконані всі необхідні завдання з очищення. Типово Kubernetes використовує каскадне видалення у фоні, якщо ви не використовуєте видалення вручну на передньому плані або не вибираєте залишити залежні обʼєкти.
Коли Kubernetes видаляє обʼєкт власника, залишені залежні обʼєкти називаються залишеними обʼєктами. Типово Kubernetes видаляє залежні обʼєкти. Щоб дізнатися, як перевизначити цю поведінку, дивіться Видалення власників та залишені залежності.
Збір сміття невикористаних контейнерів та образів
kubelet виконує збір сміття невикористаних образів кожні пʼять хвилин та невикористаних контейнерів кожну хвилину. Ви повинні уникати використання зовнішніх інструментів для збору сміття, оскільки вони можуть порушити поведінку kubelet та видаляти контейнери, які повинні існувати.
Щоб налаштувати параметри для збору сміття невикористаних контейнерів та образів, налаштуйте kubelet за допомогою файлу конфігурації та змініть параметри, повʼязані зі збором сміття, використовуючи ресурс типу KubeletConfiguration.
Життєвий цикл образу контейнера
Kubernetes керує життєвим циклом всіх образів через свій менеджер образів, який є частиною kubelet, співпрацюючи з cadvisor. Kubelet враховує такі обмеження щодо використання дискового простору під час прийняття рішень про збір сміття:
HighThresholdPercent
LowThresholdPercent
Використання дискового простору вище встановленого значення HighThresholdPercent викликає збір сміття, який видаляє образи в порядку їх останнього використання, починаючи з найстаріших. Kubelet видаляє образи до тих пір, поки використання дискового простору не досягне значення LowThresholdPercent.
Збір сміття для невикористаних контейнерних образів
Ви можете вказати максимальний час, протягом якого локальний образ може бути невикористаний, незалежно від використання дискового простору. Це налаштування kubelet, яке ви вказуєте для кожного вузла.
Щоб налаштувати параметр, встановіть значення поля imageMaximumGCAge у файлі конфігурації kubelet.
Значення вказується як тривалість. Дивіться визначення тривалості в глосарії для отримання докладних відомостей.
Наприклад, ви можете встановити значення поля конфігурації 12h45m, що означає 12 годин 45 хвилин.
Примітка:
Ця функція не відстежує використання образів між перезапусками kubelet. Якщо kubelet перезапускається, вік відстежуваного образу скидається, що призводить до того, що kubelet очікує повний проміжок часу imageMaximumGCAge перш ніж вважати образ придатним для збору сміття на основі його віку.
Збір сміття контейнерів
Kubelet збирає сміття невикористаних контейнерів на основі таких змінних, які ви можете визначити:
MinAge: мінімальний вік, за якого kubelet може видаляти контейнер. Щоб вимкнути, встановіть значення 0.
MaxPerPodContainer: максимальна кількість мертвих контейнерів, які може мати кожен Pod. Щоб вимкнути, встановіть значення менше 0.
MaxContainers: максимальна кількість мертвих контейнерів у кластері. Щоб вимкнути, встановіть значення менше 0.
Крім цих змінних, kubelet збирає сміття невизначених та видалених контейнерів, як правило, починаючи з найстарших.
MaxPerPodContainer та MaxContainers можуть потенційно конфліктувати одне з одним в ситуаціях, де збереження максимальної кількості контейнерів на кожен Pod (MaxPerPodContainer) перевищить допустиму загальну кількість глобальних мертвих контейнерів (MaxContainers). У цій ситуації kubelet коригує MaxPerPodContainer для вирішення конфлікту. У найгіршому випадку може бути знижений MaxPerPodContainer до 1 та виселені найдавніші контейнери. Крім того, контейнери, які належать Podʼам, які були видалені, видаляються, коли стають старшими за MinAge.
Примітка:
Kubelet збирає сміття лише для контейнерів, якими він керує.
Налаштування збору сміття
Ви можете налаштовувати збір сміття ресурсів, налаштовуючи параметри, специфічні для контролерів, що керують цими ресурсами. На наступних сторінках показано, як налаштовувати збір сміття:
Дізнайтеся про контролер TTL, який очищає завершені завдання.
6.2.9 - Проксі змішаних версій
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
У Kubernetes 1.37 включено бета-функцію, яка дозволяє API-серверу проксіювати запити ресурсів до інших рівноправних API-серверів. Це також дозволяє клієнтам отримати цілісне уявлення про ресурси, що обслуговуються в усьому кластері, за допомогою виявлення. Це корисно, коли існують кілька API-серверів, що працюють на різних версіях Kubernetes в одному кластері (наприклад, під час тривалого впровадження нового релізу Kubernetes).
Це дозволяє адміністраторам кластерів налаштовувати високодоступні кластери, які можна оновлювати безпечніше:
гарантуючи, що контролери, які покладаються на виявлення для показу повного списку ресурсів для важливих завдань, завжди отримують повний огляд усіх ресурсів. Ми називаємо це повним виявленням у масштабі кластера — Peer-aggregated discovery.
направляючи запити на ресурси (зроблені під час оновлення) на відповідний kube-apiserver. Це проксіювання запобігає появі у користувачів несподіваних помилок 404 Not Found, спричинених процесом оновлення. Цей механізм називається Mixed Version Proxy.
Активація Peer-aggregated Discovery та Mixed Version Proxy
kube-apiserver \
--feature-gates=UnknownVersionInteroperabilityProxy=true\
# обовʼязкові аргументи командного рядка для цієї функції--peer-ca-file=<шлях до сертифіката CA kube-apiserver>
--proxy-client-cert-file=<шлях до сертифіката агрегатора проксі>,
--proxy-client-key-file=<шлях до ключа агрегатора проксі>,
--requestheader-client-ca-file=<шлях до сертифіката CA агрегатора>,
# requestheader-allowed-names може бути встановлено як порожнє значення, щоб дозволити будь-яке Common Name--requestheader-allowed-names=<дійсні значення Common Name для перевірки сертифіката клієнта проксі>,
# необовʼязкові прапорці для цієї функції--peer-advertise-ip=`IP цього kube-apiserver, який повинні використовувати рівноправні сервери для проксіювання запитів`--peer-advertise-port=`порт цього kube-apiserver, який повинні використовувати рівноправні сервери для проксіювання запитів`# …і інші прапорці як зазвичай
Транспорт та автентифікація проксі між API-серверами
Вихідний kube-apiserver повторно використовує
наявні прапорці автентифікації клієнта API-сервера--proxy-client-cert-file та --proxy-client-key-file для представлення своєї ідентичності, яку перевіряє рівноправний сервер (цільовий kube-apiserver). Цільовий API-сервер перевіряє це підключення на основі конфігурації, яку ви вказуєте за допомогою аргументу командного рядка --requestheader-client-ca-file.
Для автентифікації сертифікатів цільового сервера вам слід налаштувати пакет сертифікатів центру сертифікації, вказавши аргумент командного рядка --peer-ca-fileвихідному API-серверу.
Налаштування для зʼєднання з рівноправним API-сервером
Для встановлення мережевого розташування kube-apiserver, яке рівноправні сервери будуть використовувати для проксіювання запитів, використовуйте аргументи командного рядка --peer-advertise-ip та --peer-advertise-port для kube-apiserver або вказуйте ці поля в конфігураційному файлі API-сервера. Якщо ці прапорці не вказані, рівноправні сервери будуть використовувати значення з аргументів командного рядка --advertise-address або --bind-address для kube-apiserver. Якщо ці прапорці теж не встановлені, використовується типовий інтерфейс хоста.
Peer-aggregated discovery
Коли ви вмикаєте цю функцію, запити на виявлення автоматично вмикаються для надання комплексного документа виявлення (з переліком усіх ресурсів, що обслуговуються будь-яким apiserver у кластері) стандартно.
Якщо ви хочете запросити документ non peer-aggregated discovery, ви можете вказати це, додавши до запиту на виявлення такий заголовок Accept:
Коли ви вмикаєте проксіювання змішаних версій, шар агрегації завантажує спеціальний фільтр, який виконує такі дії:
Коли запит ресурсу надходить до API-сервера, який не може обслуговувати цей API (чи то тому, що його версія старіша за появу цього API, чи тому, що API вимкнено на API-сервері), API-сервер намагається надіслати запит до рівноправного API-сервера, який може обслуговувати затребуваний API. Це відбувається шляхом ідентифікації груп API / версій / ресурсів, які локальний сервер не розпізнає, і спроби проксіювати ці запити до рівноправного API-сервера, який може обробити запит.
Якщо рівноправний API-сервер не відповідає, то вихідний API-сервер відповідає помилкою 503 ("Service Unavailable").
Як це працює під капотом
Коли API-сервер отримує запит ресурсу, він спочатку перевіряє, які API-сервери можуть обслуговувати затребуваний ресурс. Ця перевірка відбувається за допомогою документа non peer-aggregated discovery.
Якщо ресурс є в документі non peer-aggregated discovery, отриманому від API-сервера, що отримав запит (наприклад, GET /api/v1/pods/some-pod), запит обробляється локально.
Якщо ресурс у запиті (наприклад, GET /apis/resource.k8s.io/v1beta1/resourceclaims) не знайдено в документі non peer-aggregated discovery, отриманому з API-сервера, який намагається обробити запит (API-сервер обробки), ймовірно, через те, що API resource.k8s.io/v1beta1 був введений в новій версії Kubernetes, а API-сервер обробки працює на старій версії, яка його не підтримує, тоді API-сервер обробки знаходить рівноправні API-сервери, які обслуговують відповідну групу API / версію / ресурс (у цьому випадку resource.k8s.io/v1beta1/resourceclaims) перевіряючи документи non peer-aggregated discovery усіх рівноправних API-серверів. Потім API-сервер обробки проксіює запит до одного з відповідних рівноправних kube-apiserver, які знають про запитуваний ресурс.
Якщо для цієї групи API / версії / ресурсу немає відомого рівноправного сервера, API-сервер обробки передає запит до власного ланцюжка обробників, який повинен зрештою повернути відповідь 404 ("Not Found").
Якщо API-сервер обробки визначив і вибрав рівноправний API-сервер, але той не відповідає (через проблеми з підключенням до мережі або стан гонитви між отриманням запиту та реєстрацією контролером інформації про рівноправний сервер у панелі управління), API-сервер обробки відповідає помилкою 503 ("Service Unavailable").
6.3 - Контейнери
Технологія для пакування застосунку разом із його залежностями часу виконання.
На цій сторінці міститься огляд контейнерів та образів контейнерів, а також їх використання для розробки та промислової експлуатації.
Слово контейнер є дуже перевантаженим терміном. Щоразу, коли ви використовуєте це слово, перевіряйте, чи ваша аудиторія використовує те саме визначення.
Кожен контейнер, який ви запускаєте, є повторюваним; стандартизація завдяки включеним залежностям означає, що ви отримуєте однакову поведінку, де б ви його не запускали.
Контейнери відокремлюють застосунки від базової інфраструктури хоста. Це полегшує розгортання в різних хмарних або ОС-середовищах.
Кожен вузол в кластері Kubernetes запускає контейнери, які формують Podʼи, призначені цьому вузлу. Контейнери в Podʼі розташовуються та плануються разом, щоб запускатися на тому самому вузлі.
Образи контейнерів
Образ контейнера — це готовий до запуску пакунок програмного забезпечення, який містить все необхідне для запуску застосунку: код та будь-яке середовище виконання, якого він потребує, бібліотеки застосунку та системні бібліотеки, а також типові значення для будь-яких важливих налаштувань.
Контейнери призначені для того, щоб бути stateless та незмінними: ви не повинні змінювати код контейнера, який вже працює. Якщо у вас є контейнеризований застосунок та ви хочете внести зміни, правильний процес полягає в тому, щоб зібрати новий образ, який містить ці зміни, а потім створити контейнер заново, щоб запустити його з оновленого образу.
Середовище виконання контейнерів
Основний компонент, який дозволяє Kubernetes ефективно запускати контейнери. Він відповідає за керування виконанням і життєвим циклом контейнерів у середовищі Kubernetes.
Зазвичай ви можете дозволити вашому кластеру обрати стандартне середовище виконання для Podʼа. Якщо вам потрібно використовувати більше одного середовища виконання контейнерів у вашому кластері, ви можете вказати RuntimeClass для Podʼа, щоб переконатися, що Kubernetes запускає ці контейнери за допомогою певного середовища виконання.
Ви також можете використовувати RuntimeClass для запуску різних Podʼів з однаковим середовищем виконання контейнерів, але з різними налаштуваннями.
6.3.1 - Образи контейнерів
Образ контейнера представляє бінарні дані, які інкапсулюють застосунок та всі його програмні залежності. Образи контейнерів — це виконувані пакунки програмного забезпечення, які можуть працювати окремо і роблять дуже чітко визначені припущення щодо свого середовища виконання.
Зазвичай ви створюєте образ контейнера свого застосунку та розміщуєте його в реєстрі, перш ніж посилатися на нього у Podʼі.
Ця сторінка надає огляд концепції образів контейнерів.
Примітка:
Якщо ви шукаєте образи контейнерів для випуску Kubernetes (наприклад, v1.37, остання мінорна версія), відвідайте розділ Завантаження Kubernetes.
Назви образів
Образам контейнерів зазвичай дається назва, така як pause, example/mycontainer або kube-apiserver. Образ також може містити імʼя хоста реєстру; наприклад: fictional.registry.example/imagename, а також, можливо, номер порту; наприклад: fictional.registry.example:10443/imagename.
Після частини назви образу ви можете додати теґ або дайджест (так само, як під час використання команд на кшталт docker чи podman). Теґи дозволяють ідентифікувати різні версії одного ряду образів. Дайджест — унікальний ідентифікатор конкретної версії образу. Дайджести є хешами, які визначаються вмістом образу, і вони не змінюються. Теґи можна переносити на інші образи, а дайджести залишаються незмінними.
Теґи образів складаються з малих і великих літер, цифр, підкреслень (_), крапок (.) та дефісів (-). Довжина теґу може бути до 128 символів, а сам теґ має відповідати такому шаблону: [a-zA-Z0-9_][a-zA-Z0-9._-]{0,127}. Дізнатись більше та знайти регулярний вираз для перевірки можна в OCI Distribution Specification. Якщо ви не вказуєте теґ, Kubernetes вважає, що ви маєте на увазі теґ latest.
Дайджест образу складається з назви алгоритму хешу (наприклад, sha256) і значення хешу. Наприклад: sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07. Додаткову інформацію про формат дайджесту можна знайти в OCI Image Specification.
Деякі приклади назв образів, які може використовувати Kubernetes:
busybox — тільки назва образу, без теґу або дайджесту. Kubernetes використовує публічний реєстр Docker і теґ latest. Те саме, що й docker.io/library/busybox:latest.
busybox:1.32.0 — назва образу з теґом. Kubernetes використовує публічний реєстр Docker. Те саме, що й docker.io/library/busybox:1.32.0.
registry.k8s.io/pause:latest — назва образу із власним реєстром і теґом latest.
registry.k8s.io/pause:3.5 — назва образу із власним реєстром і теґом, відмінним від latest.
registry.k8s.io/pause@sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07 — назва образу з дайджестом.
registry.k8s.io/pause:3.5@sha256:1ff6c18fbef2045af6b9c16bf034cc421a29027b800e4f9b68ae9b1cb3e9ae07 — назва образу з теґом і дайджестом. Для завантаження використовується лише дайджест.
Оновлення образів
При першому створенні Deployment, StatefulSet, Podʼа чи іншого обʼєкта, що включає PodTemplate, а політику завантаження явно не вказано, стандартна політика завантаження всіх контейнерів у цьому Podʼі буде встановлена в IfNotPresent. Ця політика призводить до того, що kubelet пропускає завантаження образів, якщо вони вже існують.
Політика завантаження образів
imagePullPolicy для контейнера та теґ образу впливають на те, колиkubelet намагається завантажити (отримати) вказаний образ.
Ось список значень, які можна встановити для imagePullPolicy та їхній вплив:
IfNotPresent
образ завантажується лише тоді, коли він ще не присутній локально.
Always
кожного разу, коли kubelet запускає контейнер, kubelet звертається до середовища виконання контейнерів для завантаження образу. Середовище виконання контейнерів звертається до реєстру, розвʼязує теґ або назву образу в дайджест і завантажує будь-які шари, які ще не кешовані локально. Якщо всі шари вже присутні, середовище виконання контейнерів використовує кешований образ без повторного завантаження. Сам kubelet не перевіряє, чи образ кешований локально; він завжди делегує це середовищу виконання контейнерів.
Never
kubelet не намагається отримати образ. Якщо образ вже присутній локально, kubelet намагається запустити контейнер; в іншому випадку запуск закінчується невдачею. Див. попередньо завантажені образи для отримання деталей.
Семантика кешування середовища виконання контейнерів робить ефективним навіть imagePullPolicy: Always, якщо реєстр доступний. Середовище виконання контейнерів може помітити, що шари образів вже існують на вузлі, так що їх не потрібно знову завантажувати.
Примітка:
Ви повинні уникати використання теґу :latest при розгортанні контейнерів в промисловому середовищі, оскільки так важче відстежити, яка версія образу запущена, і складніше виконати відкат.
Замість цього використовуйте значущий теґ, такий як v1.42.0, і/або дайджест.
Щоб переконатися, що Pod завжди використовує ту саму версію образу контейнера, ви можете вказати дайджест образу; замініть <image-name>:<tag> на <image-name>@<digest> (наприклад, image@sha256:45b23dee08af5e43a7fea6c4cf9c25ccf269ee113168c19722f87876677c5cb2).
При використанні теґів образів, якщо реєстр образів змінив код, який представляє теґ вашого образу, ви могли б отримати суміш Podʼів, що запускають старий і новий код. Дайджест образу унікально ідентифікує конкретну версію образу, тому Kubernetes запускає той самий код кожного разу, коли він запускає контейнер із вказаними назвою образу та дайджестом. Зазначення образу за допомогою дайджесту фіксує код, який ви запускаєте, так що зміна в реєстрі не може призвести до такого змішаного використання версій.
Є сторонні контролери допуску, що змінюють Podʼи (і PodTemplates) під час створення, так що робоче навантаження визначається на основі дайджесту образу, а не теґу. Це може бути корисно, якщо ви хочете переконатися, що ваші робочі навантаження запускають один і той самий код, незалежно від того, які зміни теґів відбуваються в реєстрі.
Стандартна політика завантаження образів
Коли ви (чи контролер) подаєте новий Pod API-серверу, ваш кластер встановлює поле imagePullPolicy при виконанні певних умов:
якщо ви не вказуєте поле imagePullPolicy, але вказуєте дайджест образу контейнера, imagePullPolicy автоматично встановлюється в IfNotPresent.
якщо ви не вказуєте поле imagePullPolicy, а теґ образу контейнера — :latest, imagePullPolicy автоматично встановлюється в Always;
якщо ви не вказуєте ні поле imagePullPolicy, ні теґ образу контейнера, imagePullPolicy автоматично встановлюється в Always;
якщо ви не вказуєте поле imagePullPolicy, але вказуєте теґ образу контейнера, який не є :latest, imagePullPolicy автоматично встановлюється в IfNotPresent.
Примітка:
Значення imagePullPolicy контейнера завжди встановлюється при першому створенні обʼєкта і не оновлюється, якщо теґ чи дайджест образу пізніше зміниться.
Наприклад, якщо ви створите Deployment з образом, теґ якого не є:latest, і пізніше оновите образ цього Deployment до теґу :latest, поле imagePullPolicyне зміниться на Always. Вам слід вручну змінити політику завантаження для будь-якого обʼєкта після його початкового створення.
Обовʼязкове завантаження образів
Якщо ви хочете завжди виконувати завантаження, ви можете зробити одне з такого:
Встановіть imagePullPolicy контейнера в Always.
Не вказуйте imagePullPolicy і використовуйте :latest як теґ образу; Kubernetes встановить політику в Always під час подання Podʼа.
Не вказуйте ні imagePullPolicy, ні теґ образу; Kubernetes встановить політику в Always під час подання Podʼа.
Коли kubelet починає створювати контейнери для Podʼа за допомогою середовища виконання контейнерів, можливо, контейнер перебуває у стані Waiting з причини ImagePullBackOff.
Статус ImagePullBackOff означає, що контейнер не може запуститися через те, що Kubernetes не може завантажити образ контейнера (з причин, таких як неправильна назва образу або спроба завантаження з приватного реєстру без imagePullSecret). Частина BackOff вказує на те, що Kubernetes буде продовжувати пробувати завантажити образ зі збільшенням інтервалів між спробами.
Kubernetes збільшує інтервал між кожною спробою до тих пір, поки не досягне вбудованого обмеження, яке становить 300 секунд (5 хвилин).
Завантаження образу відповідно до класу середовища виконання
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.29; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the RuntimeClassInImageCriApi feature gate for all relevant components in your cluster.
У Kubernetes є альфа-підтримка для виконання завантаження образів на основі RuntimeClass Podʼа.
Якщо ви увімкнете функціональну можливістьRuntimeClassInImageCriApi, kubelet вказує образи контейнерів кортежем із назви образу та обробника середовища виконання, а не лише назвою чи дайджестом образу. Ваше середовище виконання контейнерів може адаптувати свою поведінку залежно від обраного обробника. Завантаження образів на основі класу середовища виконання буде корисним для контейнерів, що використовують віртуальні машини, таких як контейнери Windows Hyper-V.
Послідовне та паралельне завантаження образів
Типово kubelet завантажує образи послідовно. Іншими словами, kubelet надсилає лише один запит на завантаження образу до служби образів одночасно. Інші запити на завантаження образів мають чекати, поки завершиться обробка поточного запиту.
Вузли приймають рішення про завантаження образу незалежно один від одного. Навіть коли ви використовуєте послідовні запити на завантаження образів, два різні вузли можуть завантажувати один і той самий образ паралельно.
Якщо ви хочете увімкнути паралельне завантаження образів, ви можете встановити поле serializeImagePulls у значення false в конфігурації kubelet. Якщо serializeImagePulls встановлено в false, запити на завантаження образів будуть надсилатись до служби образів негайно, і кілька образів буде завантажено одночасно.
Вмикаючи паралельне завантаження образів, переконайтеся, що служба образів вашого середовища виконання контейнерів може обробляти паралельне завантаження образів.
Kubelet ніколи не завантажує кілька образів паралельно від імені одного Podʼа. Наприклад, якщо у вас є Pod із контейнером ініціалізації та контейнером застосунку, завантаження образів для цих двох контейнерів не буде виконуватись паралельно. Однак якщо у вас є два Podʼи, які використовують різні образи, kubelet завантажує образи паралельно для цих двох різних Podʼів, коли увімкнено паралельне завантаження образів.
Максимальна кількість паралельних завантажень образів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
Коли serializeImagePulls встановлено в значення false, kubelet стандартно не обмежує максимальну кількість образів, які завантажуються одночасно. Якщо ви хочете обмежити кількість паралельних завантажень образів, ви можете встановити поле maxParallelImagePulls у конфігурації kubelet. Якщо maxParallelImagePulls дорівнює n, тільки n образів можуть завантажуватися одночасно, і будь-яке завантаження образу за межами n буде чекати, поки завершиться принаймні одне завантаження образу, яке вже триває.
Обмеження кількості паралельних завантажень образів допоможе уникнути зайвого використання пропускної здатності мережі або дискових операцій вводу/виводу, коли увімкнено паралельне завантаження образів.
Ви можете встановити maxParallelImagePulls на додатне число, більше або рівне 1. Якщо ви встановите maxParallelImagePulls більше або рівне 2, ви повинні встановити serializeImagePulls в значення false. Kubelet не буде запущено з недійсними налаштуваннями maxParallelImagePulls.
Мультиархітектурні образи з індексами образів
Окрім надання бінарних образів, реєстр контейнерів також може обслуговувати індекс образу контейнера. Індекс образу може посилатися на кілька маніфестів образу для версій контейнера, специфічних для архітектури. Ідея полягає в тому, що ви можете мати імʼя для образу (наприклад: pause, example/mycontainer, kube-apiserver) та дозволити різним системам отримувати правильний бінарний образ для використання на їхній архітектурі машини.
Проєкт Kubernetes зазвичай створює образи контейнерів для своїх випусків із назвами, що містять суфікс -$(ARCH). Для зворотної сумісності генеруйте старіші образи із суфіксами. Наприклад, образ pause буде мультиархітектурним образом із маніфестами для всіх підтримуваних архітектур, а pause-amd64 — зворотно сумісною версією для старіших конфігурацій або файлів YAML із жорстко закодованими назвами образів із суфіксами.
Використання приватних реєстрів
Приватні реєстри можуть вимагати автентифікації для виявлення та/або завантаження образів з них. Облікові дані можна надати кількома способами:
Всі Podʼи можуть використовувати будь-які образи, кешовані на вузлі
Вимагає root-доступу на всіх вузлах для налаштування
Розширення від постачальників або локальні розширення
Якщо ви використовуєте власну конфігурацію вузла, ви (або ваш хмарний провайдер) можете реалізувати власний механізм автентифікації вузла в реєстрі контейнерів.
Ці варіанти пояснюються докладніше нижче.
Зазначення imagePullSecrets в Podʼі
Примітка:
Це рекомендований підхід для запуску контейнерів на основі образів з приватних реєстрів.
У Kubernetes підтримується вказівка ключів реєстру образів контейнерів у Podʼі. Усі imagePullSecrets мають бути Secrets, які існують у тому самому Namespace, що й Pod. Ці Secrets мають бути типу kubernetes.io/dockercfg або kubernetes.io/dockerconfigjson.
Налаштування вузлів для автентифікації в приватному реєстрі
Конкретні інструкції щодо встановлення облікових даних залежать від середовища виконання контейнерів та реєстру, який ви вибрали для використання. Вам слід звертатися до документації щодо вашого рішення для отримання найточнішої інформації.
Для прикладу конфігурування приватного реєстру образів контейнерів дивіться завдання Завантаження образу з приватного реєстру. У цьому прикладі використовується приватний реєстр в Docker Hub.
Постачальник облікових даних Kubelet для отримання автентифікованих образів
Ви можете налаштувати kubelet для виклику бінарного втулка, щоб динамічно отримувати облікові дані реєстру для образу контейнера. Це найнадійніший та універсальний спосіб отримання облікових даних для приватних реєстрів, але також вимагає конфігурації kubelet для його увімкнення.
Ця техніка може бути особливо корисною для запуску статичних Podʼів, які потребують образів контейнерів, розміщених у приватному реєстрі. Використання ServiceAccount або Secret для надання облікових даних приватного реєстру є неможливим у специфікації статичного Podʼа, оскільки він не може мати посилань на інші ресурси API у своїй специфікації.
Тлумачення config.json відрізняється між оригінальною реалізацією Docker та тлумаченням Kubernetes. У Docker ключі auths можуть вказувати тільки кореневі URL-адреси, тоді як Kubernetes дозволяє використовувати URL-адреси із шаблонами glob, а також шляхи, які відповідають префіксу. Єдиним обмеженням є те, що шаблони glob (*) повинні включати крапку (.) для кожного піддомену. Кількість піддоменів, що мають збіг, повинна дорівнювати кількості шаблонів glob (*.), наприклад:
*.kubernetes.ioне збігатиметься з kubernetes.io, але збігатиметься з abc.kubernetes.io
*.*.kubernetes.ioне збігатиметься з abc.kubernetes.io, але збігатиметься з abc.def.kubernetes.io
prefix.*.io збігатиметься з prefix.kubernetes.io
*-good.kubernetes.io збігатиметься з prefix-good.kubernetes.io
Це означає, що файл config.json, подібний до цього, є дійсним:
Операції завантаження образів передають облікові дані середовищу виконання контейнерів CRI для кожного дійсного шаблону. Наприклад, такі назви образів контейнерів матимуть збіг:
my-registry.example/images
my-registry.example/images/my-image
my-registry.example/images/another-image
sub.my-registry.example/images/my-image
Однак ці назви образів контейнерів не матимуть збігу:
a.sub.my-registry.example/images/my-image
a.b.sub.my-registry.example/images/my-image
Kubelet виконує операції завантаження образів послідовно для кожного знайденого набору облікових даних. Це означає, що можливі кілька записів у config.json для різних шляхів:
Тепер, якщо контейнер вказує образ my-registry.example/images/subpath/my-image, то kubelet спробує завантажити його з обох джерел автентифікації, якщо завантаження з одного з них виявиться невдалим.
Попередньо завантажені образи
Примітка:
Цей спосіб підходить, якщо ви можете контролювати конфігурацію вузла. Він не буде надійно працювати, якщо ваш хмарний провайдер управляє вузлами та автоматично їх замінює.
Типово kubelet намагається отримати кожен образ з вказаного реєстру. Однак якщо властивість imagePullPolicy контейнера встановлена на IfNotPresent або Never, то використовується локальний образ (переважно або виключно, відповідно).
Якщо ви хочете покладатися на попередньо завантажені образи як заміну автентифікації в реєстрі, вам слід переконатися, що всі вузли кластера мають однакові попередньо завантажені образи.
Це може бути використано для попереднього завантаження певних образів для швидкості або як альтернатива автентифікації в приватному реєстрі.
Перевірка облікових даних під час завантаження образів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Якщо увімкнено функціональну можливість KubeletEnsureSecretPulledImages, Kubernetes перевірятиме облікові дані для кожного образу, який потребує їх для завантаження, навіть якщо цей образ вже присутній на вузлі. Ця перевірка гарантує, що образи із запиту Podʼа, які не були успішно завантажені за допомогою наданих облікових даних, повинні бути повторно завантажені з реєстру. Крім того, при повторному завантаженні образів з тими самими обліковими даними, які раніше призвели до успішного завантаження образів, не потрібно повторно завантажувати їх з реєстру, а вони перевіряються локально без доступу до реєстру (за умови, що образ доступний локально). Це контролюється полем imagePullCredentialsVerificationPolicy у конфігурації Kubelet.
Ця конфігурація контролює, коли потрібно перевіряти облікові дані для завантаження образів, якщо образ вже присутній на вузлі:
NeverVerify: Імітує поведінку, коли цю функціональну можливість вимкнено. Якщо образ присутній локально, облікові дані для завантаження образу не перевірятимуться.
NeverVerifyPreloadedImages: Образи, завантажені за межами kubelet, не перевірятимуться, але всі інші образи будуть перевірятися. Це стандартна поведінка.
NeverVerifyAllowListedImages: Образи, завантажені поза kubelet і згадані у списку preloadedImagesVerificationAllowlist, вказаному у конфігурації kubelet, не перевірятимуться.
AlwaysVerify: Всі образи будуть перевірятися перед тим, як їх буде використано.
Ця перевірка застосовується до попередньо завантажених образів, образів, завантажених за допомогою Secrets рівня вузла, та образів, завантажених за допомогою Secrets рівня Podʼа.
Примітка:
У випадку ротації облікових даних, облікові дані, які було використано для завантаження образу, і надалі проходитимуть перевірку без необхідності звернення до реєстру. Нові або змінені облікові дані вимагатимуть повторного завантаження образу з реєстру.
Перше увімкнення KubeletEnsureSecretPulledImages
Коли функція KubeletEnsureSecretPulledImages вмикається вперше, чи то через оновлення kubelet, чи то явним увімкненням цієї функції, і якщо kubelet має доступ до будь-яких образів у цей момент, усі вони вважатимуться попередньо завантаженими. Це відбувається тому, що в цьому випадку kubelet не має записів про образи, що завантажуються. Kubelet зможе почати створювати записи про завантаження образів лише тоді, коли образ завантажується вперше.
Якщо це викликає занепокоєння, рекомендується очистити вузли від усіх образів, які не повинні вважатися попередньо завантаженими, перед увімкненням функції.
Зверніть увагу, що видалення теки, що містить записи про завантаження образів, матиме той самий ефект при перезапуску kubelet, зокрема всі образи, які зараз кешовані на вузлах середовищем виконання контейнерів, вважатимуться попередньо завантаженими.
Створення Secret з Docker-конфігом
Вам потрібно знати імʼя користувача, пароль реєстру та адресу електронної пошти клієнта для автентифікації в реєстрі, а також його імʼя хоста. Виконайте таку команду, підставивши відповідні значення замість заповнювачів:
Це особливо корисно, якщо ви використовуєте кілька приватних реєстрів контейнерів, оскільки kubectl create secret docker-registry створює Secret, який працює лише з одним приватним реєстром.
Примітка:
Podʼи можуть посилатися лише на Secrets для завантаження образів у своєму власному просторі імен, так що цей процес слід виконати один раз для кожного простору імен.
Посилання на imagePullSecrets у Podʼі
Тепер ви можете створювати Podʼи, які посилаються на цей Secret, додавши розділ imagePullSecrets до визначення Podʼа. Кожен елемент у масиві imagePullSecrets може посилатися тільки на Secret у тому ж просторі імен.
Ви можете використовувати це разом із .docker/config.json на рівні вузла. Облікові дані буде обʼєднано.
Сценарії використання
Існує кілька рішень для конфігурації приватних реєстрів. Ось деякі типові сценарії використання та рекомендовані рішення.
Кластер, в якому використовуються лише непропрієтарні (наприклад, відкриті) образи. Немає потреби приховувати образи.
Використовуйте відкриті образи з відкритого реєстру.
Конфігурація не потрібна.
Деякі хмарні провайдери автоматично кешують або дзеркалюють відкриті образи, що підвищує доступність та скорочує час їх отримання.
Кластер, в якому використовуються деякі пропрієтарні образи, які повинні бути прихованими від тих, хто поза компанією, але доступними для всіх користувачів кластера.
Використовуйте розміщений приватний реєстр.
Можлива ручна конфігурація на вузлах, які повинні мати доступ до приватного реєстру.
Або запустіть внутрішній приватний реєстр за вашим фаєрволом з відкритим доступом на читання.
Не потрібна конфігурація Kubernetes.
Використовуйте розміщений сервіс реєстру образів контейнерів, який контролює доступ до образів.
Він працюватиме краще з автомасштабуванням вузлів, ніж ручна конфігурація вузла.
Або на кластері, де зміна конфігурації вузла незручна, використовуйте imagePullSecrets.
Кластер із пропрієтарними образами, кілька з яких вимагають строгого контролю доступу.
Переконайтеся, що контролер допуску AlwaysPullImages активний. У протилежному випадку всі Podʼи потенційно мають доступ до всіх образів.
Перемістіть конфіденційні дані в ресурс Secret, а не додавайте їх в образ.
Багатокористувацький кластер, де кожен орендар потребує власного приватного реєстру.
Переконайтеся, що контролер допуску AlwaysPullImages активний. У протилежному випадку всі Podʼи всіх орендарів потенційно мають доступ до всіх образів.
Запустіть приватний реєстр з обовʼязковою авторизацією.
Створіть облікові дані реєстру для кожного орендаря, збережіть їх у Secret та внесіть Secret у кожний простір імен орендаря.
Орендар додає цей Secret до imagePullSecrets кожного простору імен.
Якщо вам потрібен доступ до декількох реєстрів, ви можете створити Secret для кожного реєстру окремо.
Застарілий вбудований постачальник облікових даних kubelet
У старіших версіях Kubernetes kubelet мав пряму інтеграцію з обліковими даними хмарного провайдера. Це давало йому можливість динамічно отримувати облікові дані для реєстрів образів.
Існувало три вбудовані реалізації інтеграції постачальника облікових даних kubelet: ACR (Azure Container Registry), ECR (Elastic Container Registry) та GCR (Google Container Registry).
Починаючи з версії Kubernetes v1.26 застарілий механізм було видалено, тому вам потрібно або:
налаштувати постачальника облікових даних образів kubelet на кожному вузлі; або
вказати облікові дані для завантаження образів, використовуючи imagePullSecrets та принаймні один Secret.
Ця сторінка описує ресурси, доступні контейнерам в середовищі контейнера.
Середовище контейнера
Середовище контейнера Kubernetes надає кілька важливих ресурсів контейнерам:
Файлову систему, яка є комбінацією образу та одного чи декількох томів.
Інформацію про сам контейнер.
Інформацію про інші обʼєкти в кластері.
Інформація про контейнер
hostname контейнера — це назва Podʼа, в якому він працює. Вона доступна через команду hostname або виклик функції gethostname у бібліотеці libc.
Назва та простір імен Podʼа доступні як змінні середовища через downward API.
Змінні середовища, визначені користувачем у визначенні Podʼа, також доступні для контейнера, так само як будь-які статично визначені змінні середовища в образі контейнера.
Інформація про кластер
Список всіх сервісів, які були активні під час створення контейнера, доступний цьому контейнеру як змінні середовища. Цей список обмежений сервісами в межах того ж простору імен, що й новий Pod контейнера, та сервісами панелі управління Kubernetes.
Для сервісу з назвою foo, який експонує набір Podʼів, кожен з яких виконує контейнер із назвою bar, визначаються такі змінні:
FOO_SERVICE_HOST=<хост, на якому працює сервіс>
FOO_SERVICE_PORT=<порт, на якому працює сервіс>
Сервіси мають виділені IP-адреси, які доступні для контейнера через DNS, якщо увімкнено надбудову DNS.
Ця сторінка описує ресурс RuntimeClass та механізм вибору середовища виконання.
RuntimeClass — це функція для вибору конфігурації середовища виконання контейнерів. Конфігурація середовища виконання контейнерів використовується для запуску контейнерів у Podʼі.
Обґрунтування
Ви можете встановити різне значення RuntimeClass для різних Podʼів, щоб забезпечити баланс між продуктивністю та безпекою. Наприклад, якщо частина вашого робочого навантаження вимагає високого рівня підтвердження захищеності інформації, ви можете вибрати планування цих Podʼів так, щоб вони працювали в середовищі виконання контейнерів, яке використовує апаратну віртуалізацію. Таким чином ви скористаєтеся додатковою ізоляцією альтернативного середовища ціною деяких додаткових накладних витрат.
Ви також можете використовувати RuntimeClass для запуску різних Podʼів з однаковим середовищем виконання, але з різними налаштуваннями.
Налаштування
Налаштуйте реалізацію CRI на вузлах (залежить від середовища виконання).
Створіть відповідні ресурси RuntimeClass.
1. Налаштуйте реалізацію CRI на вузлах
Конфігурації, доступні через RuntimeClass, залежать від конкретної реалізації інтерфейсу середовища виконання контейнерів (CRI). Для отримання інструкцій щодо налаштування перегляньте відповідну документацію (нижче) для вашої реалізації CRI.
Примітка:
Стандартно RuntimeClass передбачає однорідну конфігурацію вузла в усьому кластері (що означає, що всі вузли налаштовані однаковим чином щодо середовищ виконання контейнерів). Щоб підтримувати різнорідні конфігурації вузлів, див. Планування нижче.
Кожна конфігурація має відповідний handler, на який посилається RuntimeClass. Handler повинен бути дійсним імʼям DNS-мітки.
2. Створіть відповідні ресурси RuntimeClass
Кожна конфігурація, налаштована на кроці 1, повинна мати асоційований handler, який ідентифікує конфігурацію. Для кожного handler створіть обʼєкт RuntimeClass.
Ресурс RuntimeClass наразі має всього 2 значущі поля: назва RuntimeClass (metadata.name) та handler (handler). Визначення обʼєкта виглядає так:
# RuntimeClass визначений у групі API node.k8s.ioapiVersion:node.k8s.io/v1kind:RuntimeClassmetadata:# Назва, за якою посилатимуться на RuntimeClass.# RuntimeClass — ресурс без простору імен.name:myclass# Назва відповідної конфігурації CRIhandler:myconfiguration
Рекомендується обмежити операції запису RuntimeClass (create/update/patch/delete), щоб вони були доступні тільки адміністраторам кластера. Зазвичай це типове налаштування. Докладніше див. Огляд авторизації.
Використання
Після налаштування RuntimeClass для кластера ви можете вказати runtimeClassName в специфікації Podʼа, щоб використовувати його. Наприклад:
Це доручить kubelet використовувати вказаний RuntimeClass для запуску цього Podʼа. Якщо зазначений RuntimeClass не існує або CRI не може виконати відповідний handler, Pod увійде в термінальну фазуFailed. Шукайте відповідну подію для отримання повідомлення про помилку.
Якщо runtimeClassName не вказано, буде використовуватися стандартний RuntimeHandler, що еквівалентно поведінці за вимкненої функції RuntimeClass.
Обробники середовища виконання налаштовуються через конфігурацію containerd за шляхом /etc/containerd/config.toml. Дійсні обробники налаштовуються в розділі runtimes:
Обробники середовища виконання налаштовуються через конфігурацію CRI-O за шляхом /etc/crio/crio.conf. Дійсні обробники налаштовуються в таблиці crio.runtime:
Зазначаючи поле scheduling для RuntimeClass, ви можете встановити обмеження, щоб забезпечити, що Podʼи, які працюють із цим RuntimeClass, плануються на вузли, які його підтримують. Якщо scheduling не встановлено, припускається, що цей RuntimeClass підтримується всіма вузлами.
Щоб гарантувати, що Podʼи потрапляють на вузли, які підтримують конкретний RuntimeClass, цей набір вузлів повинен мати спільні мітки, які потім обираються полем runtimeclass.scheduling.nodeSelector. NodeSelector RuntimeClass обʼєднується з nodeSelector Podʼа під час допуску, фактично беручи перетин множин вузлів, обраних кожним із них. Якщо виникає конфлікт, Pod буде відхилено.
Якщо підтримувані вузли мають taints, що не дають запускатися на вузлі Podʼам з іншим RuntimeClass, ви можете додати tolerations до RuntimeClass. Як і з nodeSelector, tolerations обʼєднуються з tolerations Podʼа під час допуску, фактично беручи обʼєднання множин вузлів, які толерує кожен із них.
Щоб дізнатися більше про налаштування селектора вузла і tolerations, див. Призначення Podʼів вузлам.
Накладні витрати Podʼів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Ви можете вказати ресурси overhead, що повʼязані із запуском Podʼа. Вказівка накладних витрат дозволяє кластеру (включаючи планувальник) враховувати це при прийнятті рішень про Podʼи та ресурси.
Накладні витрати Podʼа визначаються через поле overhead в RuntimeClass. За допомогою цього поля ви можете вказати накладні витрати запуску Podʼів, що використовують цей RuntimeClass, та забезпечити облік цих накладних витрат в Kubernetes.
На цій сторінці описано, як контейнери, керовані kubelet, можуть використовувати фреймворк хуків життєвого циклу контейнера для запуску коду, викликаного подіями під час управління їх життєвим циклом.
Огляд
Аналогічно багатьом фреймворкам програмування, які мають хуки життєвого циклу компонентів, таким як Angular, Kubernetes надає контейнерам хуки життєвого циклу. Ці хуки дозволяють контейнерам бути в курсі подій у своєму циклі управління та виконувати код, реалізований в обробнику, коли відповідний хук життєвого циклу виконується.
Хуки контейнера
Контейнерам доступні два хуки:
PostStart
Цей хук виконується відразу після створення контейнера. Він працює одночасно з ENTRYPOINT контейнера (головним процесом), що означає, що хук може виконуватися до, під час або після запуску головного процесу.
До обробника не передаються жодні параметри.
Примітка:
Хоча хук працює одночасно з процесом контейнера,
він може затримувати оновлення статусу контейнера; контейнер може не переходити в стан Running до завершення роботи хука.
PreStop
Цей хук викликається негайно перед тим, як контейнер буде завершено через запит API або подію управління, таку як невдача проби на живучість/запуску, витіснення, конкуренція за ресурси та інші. Виклик хука PreStop не вдасться, якщо контейнер вже перебуває у стані terminated або completed, і хук повинен завершити виконання до того, як може бути відправлений сигнал TERM для зупинки контейнера. Відлік пільгового періоду припинення Podʼа починається до виконання хука PreStop, тому, незалежно від результату обробника, контейнер врешті-решт завершиться протягом пільгового періоду припинення Podʼа. Жодні параметри не передаються обробнику.
За допомогою хука життєвого циклу StopSignal можна визначити сигнал зупинки, який буде надіслано контейнеру, коли його буде зупинено. Якщо ви встановите цей параметр, він перевизначить будь-яку інструкцію STOPSIGNAL, визначену в образі контейнера.
Детальніший опис поведінки завершення за допомогою власних сигналів зупинки можна знайти в розділі Сигнали зупинки.
Реалізації обробника хуків
Контейнери можуть мати доступ до хука, реалізувавши та зареєструвавши обробник для цього хука. Існують три типи обробників хука, які можна реалізувати для контейнерів:
Exec — Виконує конкретну команду, таку як pre-stop.sh, всередині cgroups та namespaces контейнера. Ресурси, спожиті командою, зараховуються на рахунок контейнера.
HTTP — Виконує HTTP-запит до конкретного endpoint в контейнері.
Sleep — Призупиняє контейнер на вказаний час.
Виконання обробника хука
Коли викликається хук управління життєвим циклом контейнера, система управління Kubernetes виконує обробник відповідно до дії хука: httpGet, tcpSocket (застаріло) та sleep виконуються процесом kubelet, а exec виконується в контейнері.
Виклик обробника хука PostStart ініціюється при створенні контейнера, тобто точка входу контейнера ENTRYPOINT і хук PostStart спрацьовують одночасно. (Це означає, що, як правило, не має сенсу використовувати HTTP-хук для PostStart, оскільки немає гарантії, що процес контейнера буде повністю запущений, коли хук запуститься.) Якщо хук PostStart виконується занадто довго або зависає, це може завадити контейнеру перейти у стан running.
Хуки PreStop не викликаються асинхронно від сигналу зупинки контейнера; хук повинен завершити своє виконання до того, як може бути відправлений сигнал TERM. Якщо хук PreStop зависає під час виконання, фаза Podʼа буде Terminating і залишиться такою, поки Pod не буде вбито після закінчення його terminationGracePeriodSeconds. Цей період припинення роботи застосовується до загального часу, необхідного як для виконання хука PreStop, так і для зупинки контейнера. Якщо, наприклад, terminationGracePeriodSeconds дорівнює 60, і хук займає 55 секунд для завершення, а контейнер зупиняється нормально через 10 секунд після отримання сигналу, то контейнер буде вбитий перш, ніж він зможе завершити роботу, оскільки terminationGracePeriodSeconds менше, ніж загальний час (55+10), необхідний для цих двох подій.
Якщо хук PostStart або PreStop завершується збоєм, контейнер буде вбито.
Користувачам слід робити свої обробники хуків якомога легкими. Проте є випадки, коли тривалі команди мають сенс, наприклад, коли потрібно зберегти стан перед зупинкою контейнера.
Гарантії доставки хуків
Доставка хука має відбуватися щонайменше один раз, що означає, що хук може бути викликано кілька разів для будь-якої події, такої як для PostStart чи PreStop. Реалізація хука повинна правильно це обробляти.
Як правило, здійснюються лише разові доставки. Якщо, наприклад, приймач HTTP-хука не працює і не може приймати трафік, спроба повторно надіслати не відбувається. Однак у деяких рідкісних випадках може статися подвійна доставка. Наприклад, якщо kubelet перезапускається посеред надсилання хука, хук може бути повторно відправлений після того, як kubelet знову запрацює.
Налагодження обробників хуків
Логи обробника хука не відображаються в подіях Podʼа. Якщо обробник зазнає збою з будь-якої причини, він розсилає подію. Для PostStart це подія FailedPostStartHook, а для PreStop це подія FailedPreStopHook. Щоб самостійно згенерувати подію FailedPostStartHook, змініть файл lifecycle-events.yaml, замінивши команду postStart на "badcommand", і застосуйте його. Ось приклад виводу події, який ви побачите після виконання kubectl describe pod lifecycle-demo:
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 7s default-scheduler Successfully assigned default/lifecycle-demo to ip-XXX-XXX-XX-XX.us-east-2...
Normal Pulled 6s kubelet Successfully pulled image "nginx" in 229.604315ms
Normal Pulling 4s (x2 over 6s) kubelet Pulling image "nginx"
Normal Created 4s (x2 over 5s) kubelet Created container lifecycle-demo-container
Normal Started 4s (x2 over 5s) kubelet Started container lifecycle-demo-container
Warning FailedPostStartHook 4s (x2 over 5s) kubelet Exec lifecycle hook ([badcommand]) for Container "lifecycle-demo-container" in Pod "lifecycle-demo_default(30229739-9651-4e5a-9a32-a8f1688862db)" failed - error: command 'badcommand' exited with 126: , message: "OCI runtime exec failed: exec failed: container_linux.go:380: starting container process caused: exec: \"badcommand\": executable file not found in $PATH: unknown\r\n"
Normal Killing 4s (x2 over 5s) kubelet FailedPostStartHook
Normal Pulled 4s kubelet Successfully pulled image "nginx" in 215.66395ms
Warning BackOff 2s (x2 over 3s) kubelet Back-off restarting failed container
6.3.5 - Інтерфейс середовища виконання контейнерів (CRI)
CRI — це інтерфейс втулка, який дозволяє kubelet використовувати різноманітні середовища виконання контейнерів, не маючи потреби перекомпілювати компоненти кластера.
Kubelet діє як клієнт при підключенні до середовища виконання контейнерів через gRPC. Точки доступу служб середовища виконання та образів мають бути доступні в середовищі виконання контейнерів; їх можна налаштувати окремо в kubelet за допомогою прапорця командного рядка--container-runtime-endpoint.
Для Kubernetes v1.26 і пізніших версій kubelet вимагає, щоб середовище виконання контейнерів підтримувало API CRI v1. Якщо середовище виконання контейнерів не підтримує API v1, kubelet не зареєструє вузол.
Оновлення
Під час оновлення версії Kubernetes на вузлі kubelet перезапускається. Якщо середовище виконання контейнерів не підтримує API CRI v1, kubelet не зможе зареєструватися і повідомить про помилку. Якщо через оновлення середовища виконання контейнерів потрібне повторне зʼєднання gRPC, середовище виконання повинно підтримувати API CRI v1, щоб зʼєднання було успішним. Для цього може знадобитися перезапуск kubelet після правильного налаштування середовища виконання контейнерів.
Потокове отримання списків
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CRIListStreaming feature gate for all relevant components in your cluster.
Стандартні RPC-запити списку CRI (ListContainers, ListPodSandbox, ListImages) повертають усі результати в одній унарній відповіді. На вузлах із великою кількістю контейнерів (наприклад, понад приблизно 10 000, включаючи як ті, що працюють, так і зупинені), ці відповіді можуть перевищувати типове обмеження gRPC на розмір повідомлення у 16 МіБ, що призводить до збою kubelet під час узгодження стану з середовищем виконання контейнерів.
З увімкненою функціональною можливістю CRIListStreaming kubelet використовує серверні потокові RPC (такі як StreamContainers, StreamPodSandboxes, StreamImages), які дозволяють середовищу виконання контейнерів розподіляти результати по кількох повідомленнях відповіді, обходячи обмеження на розмір одного повідомлення. Це особливо корисно для:
Середовищ із високим обігом контейнерів (системи CI/CD)
Якщо середовище виконання контейнерів не підтримує потокові RPC, kubelet автоматично повертається до стандартних унарних RPC для забезпечення зворотної сумісності.
Зрозумійте Podʼи, найменші обчислювальні обʼєкти, які можна розгорнути в Kubernetes, та абстракції вищого рівня, які допомагають вам їх запускати.
Робоче навантаження є застосунком, який запущено в Kubernetes.
Неважливо, чи є ваше робоче навантаження одним компонентом, чи кількома, які працюють разом, в Kubernetes ви запускаєте його всередині набору Podʼів. У Kubernetes Pod представляє набір з одного чи більше запущених контейнерів у вашому кластері.
Podʼи Kubernetes мають визначений життєвий цикл. Наприклад, як тільки Pod запущено у вашому кластері, будь-яка критична помилка на вузлі, де запущено цей Pod, означає, що всі Podʼи на цьому вузлі зазнають збою. Kubernetes розглядає цей рівень збою як кінцевий: вам потрібно створити новий Pod, щоб відновити роботу, навіть якщо вузол пізніше стане справним.
Однак, щоб значно полегшити роботу, вам не потрібно керувати кожним Podʼом окремо. Натомість ви можете використовувати ресурси робочого навантаження, які керують набором Podʼів за вас. Ці ресурси налаштовують контролери, які стежать за тим, щоб працювала правильна кількість Podʼів потрібного типу, яка відповідає вказаному вами стану.
Kubernetes надає кілька вбудованих ресурсів робочого навантаження:
Deployment та ReplicaSet (що є заміною застарілого типу ресурсу ReplicationController). Deployment є хорошим вибором для керування робочим навантаженням, яке не зберігає стану, де будь-який Pod у Deployment є взаємозамінним і може бути замінений, якщо це потрібно.
StatefulSet дозволяє вам запускати один або кілька повʼязаних Podʼів, які відстежують стан певним чином. Наприклад, якщо ваше робоче навантаження зберігає дані в постійному сховищі, ви можете запустити StatefulSet, який поєднує кожен Pod з PersistentVolume. Ваш код, який працює в Podʼах цього StatefulSet, може реплікувати дані на інші Podʼи того самого StatefulSet, щоб покращити загальну стійкість.
DaemonSet визначає Podʼи, які надають можливості, що є локальними для вузлів. Кожного разу, коли ви додаєте вузол до свого кластера, який відповідає специфікації в DaemonSet, панель управління планує Pod для цього DaemonSet на новому вузлі. Кожен Pod в DaemonSet виконує роботу, схожу на роботу системного демона на класичному сервері Unix/POSIX. DaemonSet може бути фундаментальним для роботи вашого кластера, як, наприклад, втулок для роботи мережі кластера, він може допомогти вам керувати вузлом, або надати необовʼязкову поведінку, яка покращує платформу контейнерів, яку ви використовуєте.
Job та CronJob надають різні способи визначення завдань, які виконуються до завершення та зупиняються. Ви можете використовувати Job для визначення завдання, яке виконується до завершення, тільки один раз. Ви можете використовувати CronJob для запуску того самого Job кілька разів згідно з розкладом.
У ширшій екосистемі Kubernetes ви можете знайти ресурси робочого навантаження від сторонніх розробників, які надають додаткові можливості. Використовуючи визначення власних ресурсів, ви можете додати ресурс робочого навантаження від стороннього розробника, якщо ви хочете використовувати конкретну функцію, яка не є частиною основної функціональності Kubernetes. Наприклад, якщо ви хочете запустити групу Podʼів для вашого застосунку, але зупинити роботу, якщо не всі Podʼи доступні (можливо, для якогось високопродуктивного розподіленого завдання), ви можете реалізувати або встановити розширення, яке надає цю функцію.
Розміщення робочих навантажень
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Хоча стандартні ресурси робочого навантаження (наприклад, Deployments та Jobs) керують життєвим циклом Podʼів, ви можете мати складні вимоги до планування, де групи Podʼів мають розглядатися як єдине ціле.
Workload API дозволяє визначати PodGroupTemplates для групування Podʼів та застосування до них розширених політик планування, таких як групове планування. Контролери створюють обʼєкти PodGroup з цих шаблонів під час виконання, а Pods посилаються на свій PodGroup через поле spec.schedulingGroup. Це особливо корисно для пакетної обробки та робочих навантажень машинного навчання, де необхідне розміщення "все або нічого".
Що далі
Окрім читання про кожен вид API для керування робочими навантаженнями, ви можете дізнатися, як виконувати конкретні завдання:
Як тільки ваш застосунок працює, ви, можливо, захочете зробити його доступним в Інтернеті як Service або, для вебзастосунків, використовуючи Ingress.
6.4.1 - Podʼи
Podʼи — найменші придатні для розгортання обчислювальні одиниці, які ви можете створювати в Kubernetes і якими можете керувати.
Pod (ім. чол. рід; як у випадку з групою китів або гороховим стручком) — це група з одного або кількох контейнерів, які мають спільні ресурси зберігання та мережі, а також специфікацію щодо того, як запускати контейнери. Вміст Podʼа завжди розміщується та планується разом і працює в спільному контексті. Pod моделює «логічний хост» конкретного застосунку: він містить один або кілька контейнерів застосунку, які відносно тісно повʼязані між собою. Поза хмарним середовищем застосунки, що виконуються на одній фізичній або віртуальній машині, аналогічні хмарним застосункам, що виконуються на одному логічному хості.
Окрім контейнерів застосунків, Pod може містити init-контейнери, які запускаються під час старту Podʼа. Ви також можете впровадити ефемерні контейнери для налагодження запущеного Podʼа.
Спільний контекст Podʼа — це набір просторів імен Linux, cgroups та, можливо, інших аспектів ізоляції — тих самих речей, що забезпечують ізоляцію контейнера. В межах контексту Podʼа окремі застосунки можуть мати додаткові рівні ізоляції.
Pod схожий на набір контейнерів зі спільними просторами імен та спільними томами файлової системи.
Podʼи в кластері Kubernetes використовуються двома основними способами:
Podʼи, що запускають один контейнер. Модель «один контейнер на Pod» є найпоширенішим сценарієм використання Kubernetes. У цьому випадку Pod можна розглядати як обгортку навколо одного контейнера; Kubernetes керує Podʼами, а не контейнерами безпосередньо.
Podʼи, що запускають кілька контейнерів, які мають працювати разом. Pod може інкапсулювати застосунок, який складається з кількох розміщених разом контейнерів, що тісно повʼязані та мають спільно використовувати ресурси. Ці розміщені разом контейнери утворюють єдину цілісну одиницю.
Групування в одному Podʼі кількох контейнерів, які розміщені разом і керуються спільно, — відносно складний сценарій використання. Використовуйте цей підхід лише в тих конкретних випадках, коли ваші контейнери тісно повʼязані.
Для забезпечення реплікації (з метою підвищення відмовостійкості або розширення потужності) не потрібно запускати кілька контейнерів; якщо вам потрібно кілька реплік, дивіться Керування навантаженням.
Використання Podʼів
Нижче наведено приклад Podʼа, який складається з контейнера, що запускає образ nginx:1.14.2.
Зазвичай Podʼи не створюють напряму, а створюють за допомогою ресурсів робочих навантажень. Дивіться Робота з Podʼами, щоб дізнатися більше про те, як Podʼи використовуються разом з ресурсами робочих навантажень.
Ресурси робочих навантажень для керування Podʼами
Зазвичай вам не потрібно створювати Podʼи напряму, навіть одиничні Podʼи. Натомість створюйте їх за допомогою ресурсів робочих навантажень, таких як Deployment або Job. Якщо ваші Podʼи потребують відстеження стану, розгляньте використання ресурсу StatefulSet.
Кожен Pod призначений для запуску одного екземпляра певного застосунку. Якщо ви хочете масштабувати свій застосунок горизонтально (щоб надати більше ресурсів загалом, запустивши більше екземплярів), вам слід використовувати кілька Podʼів, по одному для кожного екземпляра. У Kubernetes це зазвичай називається реплікацією. Репліковані Podʼи зазвичай створюються ресурсом робочого навантаження та його контролером, які й керують ними як групою.
Ознайомтесь з розділом Podʼи та контролери для отримання додаткової інформації про те, як Kubernetes використовує ресурси робочих навантажень та їх контролери для реалізації масштабування та автоматичного відновлення роботи застосунку.
Podʼи мають вбудовану підтримку двох видів спільних ресурсів для контейнерів, що входять до їх складу: мережі та зберігання.
Робота з Podʼами
Ви навряд чи створюватимете окремі Podʼи напряму в Kubernetes, навіть одиничні Podʼи. Це тому, що Podʼи спроєктовано як відносно ефемерні, одноразові сутності. Коли Pod створено (безпосередньо вами або опосередковано контролером), новий Pod планується до запуску на вузлі вашого кластера. Pod залишається на цьому вузлі, доки не завершить виконання, доки обʼєкт Pod не буде видалено, доки Pod не буде виселено через брак ресурсів або доки вузол не зазнає збою.
Примітка:
Перезапуск контейнера в Podʼі не слід плутати з перезапуском Podʼа. Pod — це не процес, а середовище для запуску контейнерів. Pod існує до тих пір, поки його не видалено.
Назва Podʼа має бути дійсним DNS-піддоменом, але це може призвести до неочікуваних результатів для імені хоста Podʼа. Для найкращої сумісності назва має відповідати суворішим правилам для DNS-мітки.
Операційна система Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Ви маєте встановити значення поля .spec.os.name як windows або linux, щоб визначити операційну систему, яку потребують контейнери в цьому Podʼі. Наразі це єдині операційні системи, які підтримує Kubernetes. У майбутньому цей список може бути розширено.
kubelet відмовляється запускати Pod, якщо значення .spec.os.name не збігається з операційною системою вузла. Однак у Kubernetes v1.37 значення .spec.os.name не впливає на те, як kube-scheduler обирає вузол для запуску Podʼа. У будь-якому кластері, де вузли працюють під керуванням більш ніж однієї операційної системи, слід правильно встановити мітку kubernetes.io/os на кожному вузлі та визначати Podʼи з nodeSelector на основі мітки операційної системи. Якщо ви не вкажете nodeSelector на основі ОС, kube-scheduler може призначити Pod на вузол, ОС якого не підходить для його контейнерів. Стандарти безпеки Podʼів також використовують поле .spec.os.name, щоб уникнути застосування політик, які не стосуються цієї операційної системи.
Podʼи та контролери
Ви можете використовувати ресурси робочих навантажень, щоб створювати кілька Podʼів і керувати ними. Контролер ресурсу опікується реплікацією, розгортанням та автоматичним відновленням у разі збою Podʼа. Наприклад, якщо вузол зазнає збою, контролер помічає, що Podʼи на цьому вузлі перестали працювати, і створює Pod-замінник. Планувальник розміщує Pod-замінник на справному вузлі.
Ось кілька прикладів ресурсів робочих навантажень, які керують одним чи більше Podʼами:
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Стандартно Kubernetes планує кожний Pod окремо. Однак деякі тісно повʼязані застосунки потребують одночасного планування групи Podʼів для коректної роботи.
Ви можете повʼязати Pod з PodGroup за допомогою поля групи планування (spec.schedulingGroup). Це повідомляє kube-scheduler, що Pod належить до певної групи, і дає йому змогу застосовувати скоординовані рішення щодо розміщення на рівні групи одразу для всієї групи.
Шаблони Podʼів
Контролери ресурсів робочих навантажень створюють Podʼи із шаблону Podʼа (pod template) та керують цими Podʼами від вашого імені.
PodTemplate — це специфікації для створення Podʼів, які входять до складу ресурсів робочих навантажень, таких як Deployments, Jobs та DaemonSets.
Кожен контролер ресурсу робочого навантаження використовує PodTemplate всередині обʼєкта робочого навантаження для створення фактичних Podʼів. PodTemplate є частиною бажаного стану будь-якого ресурсу робочого навантаження, який ви використовуєте для запуску вашого застосунку.
Коли ви створюєте Pod, ви можете додати змінні середовища до шаблону Podʼа для контейнерів, які запускаються в Podʼі.
Нижче наведено маніфест простого Job із template, який запускає один контейнер. Контейнер в цьому Podʼі виводить повідомлення, а потім призупиняється.
apiVersion:batch/v1kind:Jobmetadata:name:hellospec:template:# Це шаблон Podʼаspec:containers:- name:helloimage:busybox:1.28command:['sh','-c','echo "Hello, Kubernetes!" && sleep 3600']restartPolicy:OnFailure# Кінець шаблону Podʼа
Зміна шаблону Podʼа або перемикання на новий шаблон не має прямого впливу на Podʼи, які вже існують. Якщо ви змінюєте шаблон Podʼа для ресурсу робочого навантаження, цей ресурс має створити Podʼи-замінники, які використовують оновлений шаблон.
Наприклад, контролер StatefulSet переконується, що запущені Podʼи відповідають поточному шаблону Podʼа для кожного обʼєкта StatefulSet. Якщо ви редагуєте StatefulSet, щоб змінити його шаблон Podʼа, StatefulSet починає створювати нові Podʼи на основі оновленого шаблону. Зрештою всі старі Podʼи замінюються новими, і оновлення завершується.
Кожен ресурс робочого навантаження реалізує власні правила для обробки змін у шаблоні Podʼа. Якщо ви хочете дізнатися більше саме про StatefulSet, прочитайте розділ Стратегія оновлення у навчальному матеріалі «Основи StatefulSet».
На вузлах kubelet безпосередньо не спостерігає за жодними деталями шаблонів Podʼів та оновлень і не керує ними; ці деталі абстраговані. Ця абстракція та розділення відповідальностей спрощує семантику системи та робить можливим розширення поведінки кластера без зміни наявного коду.
Оновлення та заміна Podʼів
Як зазначено в попередньому розділі, коли шаблон Podʼа для ресурсу робочого навантаження змінюється, контролер створює нові Podʼи на основі оновленого шаблону замість оновлення наявних Podʼів або застосування до них патчів.
Kubernetes не забороняє вам керувати Podʼами напряму. Ви можете оновлювати деякі поля запущеного Podʼа на місці. Однак операції оновлення Podʼа, такі як patch та replace, мають деякі обмеження:
Більшість метаданих Podʼа є незмінними. Наприклад, ви не можете змінити поля namespace, name, uid або creationTimestamp.
Якщо metadata.deletionTimestamp встановлено, новий запис не може бути доданий до списку metadata.finalizers.
Оновлення Podʼа не можуть змінювати поля, крім spec.containers[*].image, spec.initContainers[*].image, spec.activeDeadlineSeconds, spec.terminationGracePeriodSeconds, spec.tolerations або spec.schedulingGates. Для spec.tolerations ви можете додавати лише нові записи.
Під час оновлення поля spec.activeDeadlineSeconds дозволені два типи оновлень:
присвоєння незаданому полю додатного числа;
зміна значення поля з додатного числа на менше невідʼємне число.
Субресурси Podʼів
Наведені вище правила оновлення застосовуються до звичайних оновлень Podʼів, але інші поля Podʼа можна оновлювати через субресурси.
Resize: Субресурс resize дозволяє оновлювати ресурси контейнерів (spec.containers[*].resources). Дивіться Зміна розміру ресурсів контейнера для більш детальної інформації.
Ефемерні контейнери: Субресурс ephemeralContainers дозволяє додавати ефемерні контейнери до Podʼа. Дивіться Ефемерні контейнери для більш детальної інформації.
Status: Субресурс status дозволяє оновлювати статус Podʼа. Зазвичай його використовують лише kubelet та інші системні контролери.
Binding: Субресурс binding дозволяє встановити spec.nodeName Podʼа за допомогою запиту Binding. Зазвичай його використовує лише планувальник.
Покоління Podʼа
Поле metadata.generation є унікальним. Воно автоматично встановлюється системою таким чином, що нові Podʼи мають значення metadata.generation, рівне 1, і кожне оновлення змінюваних полів у специфікації Podʼа збільшуватиме значення metadata.generation на 1.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate PodObservedGenerationTracking, Kubernetes ignores it but does not report any error.
observedGeneration — це поле, яке фіксується в розділі status обʼєкта Pod. kubelet встановлює status.observedGeneration, щоб повʼязати стан Podʼа з його поточним статусом. Поле status.observedGeneration Podʼа відображатиме metadata.generation Podʼа в момент, коли повідомляється про статус Podʼа.
Примітка:
Полем status.observedGeneration керує kubelet, і зовнішні контролери не повинні його змінювати.
Різні поля статусу можуть бути повʼязані або з metadata.generation поточного циклу синхронізації, або з metadata.generation попереднього циклу синхронізації. Ключова відмінність полягає в тому, чи зміна в spec відображається безпосередньо в status, чи є опосередкованим результатом запущеного процесу.
Безпосередні оновлення статусу
Для полів статусу, у яких безпосередньо відображається виділена специфікація, observedGeneration буде повʼязано з поточним metadata.generation (покоління N).
Ця поведінка застосовується до:
Статусу Resize: Статус операції зміни розміру ресурсу.
Виділених ресурсів: Ресурси, виділені Podʼу після зміни розміру.
Ефемерних контейнерів: Коли додається новий ефемерний контейнер, і він перебуває у стані Waiting.
Опосередковані оновлення статусу
Для полів статусу, які є опосередкованим результатом виконання специфікації, observedGeneration буде повʼязано з metadata.generation попереднього циклу синхронізації (покоління N-1).
Ця поведінка застосовується до:
Образу контейнера: ContainerStatus.ImageID показує образ з попереднього покоління, поки новий образ не буде завантажено, а контейнер не буде оновлено.
Фактичних ресурсів: Під час незавершеної зміни розміру фактичні ресурси, що використовуються, все ще належать запиту попереднього покоління.
Стану контейнера: Під час незавершеної зміни розміру стан контейнера з політикою, що вимагає перезапуску, відображає запит попереднього покоління.
activeDeadlineSeconds, terminationGracePeriodSeconds та deletionTimestamp: Вплив цих полів на статус Podʼа є результатом раніше отриманої специфікації.
Спільні ресурси та комунікація
Podʼи дають змогу контейнерам, що входять до їх складу, спільно використовувати дані та взаємодіяти між собою.
Зберігання в Podʼах
Pod може визначати набір спільних томів. Всі контейнери в Podʼі можуть отримати доступ до спільних томів, що дозволяє цим контейнерам спільно використовувати дані. Також томи дають змогу постійним даним у Podʼі зберегтися, якщо один із його контейнерів доведеться перезапустити. Дивіться розділ Зберігання для отримання додаткової інформації про те, як Kubernetes реалізує спільне зберігання та робить його доступним для Podʼів.
Мережеві можливості Podʼа
Кожному Podʼу присвоюється унікальна IP-адреса для кожного сімейства адрес. Кожен контейнер у Podʼі використовує спільний мережевий простір імен, що включає IP-адресу та мережеві порти. Всередині Podʼа (і тільки там) контейнери, що належать до Podʼа, можуть спілкуватися один з одним за допомогою localhost. Коли контейнери в Podʼі спілкуються із сутностями поза межами Podʼа, вони повинні координувати використання спільних мережевих ресурсів (таких як порти). Всередині Podʼа контейнери використовують спільну IP-адресу та простір портів і можуть знаходити один одного через localhost. Контейнери в Podʼі також можуть спілкуватися між собою, використовуючи стандартні засоби міжпроцесної комунікації, такі як семафори SystemV або спільну памʼять POSIX. Контейнери в різних Podʼах мають різні IP-адреси і не можуть спілкуватися за допомогою IPC на рівні ОС без спеціальної конфігурації. Контейнери, які хочуть взаємодіяти з контейнером, що працює в іншому Podʼі, можуть використовувати IP-мережу для спілкування.
Контейнери в межах Podʼа сприймають імʼя хоста системи як імʼя, що збігається з налаштованим name для Podʼа. Більше інформації про це можна знайти в розділі Мережа в кластері.
Налаштування безпеки Podʼів
Щоб встановити обмеження безпеки для Podʼів і контейнерів, використовуйте поле securityContext у специфікації Podʼа. Це поле дає вам можливість детально контролювати, що може робити Pod або окремі контейнери. Докладнішу інформацію див. у розділі Розширена конфігурація Podʼів.
Для базової конфігурації безпеки слід дотримуватися стандарту безпеки Podʼів Baseline та запускати контейнери з правами, відмінними від root. Ви можете налаштувати прості контексти безпеки:
Щоб дізнатися про розширені налаштування контексту безпеки, зокрема про можливості (capabilities), профілі seccomp та детальні параметри безпеки, перейдіть до розділу Концепції безпеки.
Коли ви визначаєте Pod, ви можете за бажанням вказати, скільки кожного ресурсу потрібно контейнеру. Найчастіше вказують CPU та памʼять (RAM).
Коли ви вказуєте запит ресурсу (request) для контейнерів у Podʼі, kube-scheduler використовує цю інформацію щоб визначити, на якому вузлі розмістити Pod. Коли ви вказуєте обмеження ресурсу (limit) для контейнера, kubelet забезпечує дотримання цих обмежень, щоб запущений контейнер не міг використовувати більше цього ресурсу, ніж встановлене вами обмеження.
Обмеження CPU застосовуються через тротлінг CPU. Коли контейнер наближається до свого обмеження CPU, ядро обмежує його доступ до CPU. Обмеження памʼяті застосовуються ядром через завершення процесів за нестачі памʼяті (OOM kills), коли контейнер перевищує своє обмеження.
Примітка:
Встановлення обмежень CPU повʼязане з компромісами. Обмеження CPU допомагають запобігти проблемам «шумного сусіда», коли одне робоче навантаження позбавляє ресурсів інші на тому ж вузлі. Це особливо важливо в багатокористувацьких середовищах. Однак обмеження CPU можуть призводити до тротлінгу навіть тоді, коли на вузлі є вільні ресурси CPU, що потенційно погіршує продуктивність робочих навантажень, чутливих до затримок. Рішення про встановлення обмежень CPU залежить від вашого середовища, характеристик робочого навантаження та вимог до ізоляції.
Статичні Podʼи керуються безпосередньо демоном kubelet на конкретному вузлі, без спостереження за ними з боку API-сервера. У той час як більшістю Podʼів керує панель управління (наприклад, Deployment), для статичних Podʼів kubelet безпосередньо наглядає за кожним статичним Podʼом (та перезапускає його, якщо він зазнає збою).
Статичні Podʼи завжди привʼязані до одного kubelet на конкретному вузлі. Основне призначення статичних Podʼів — запуск самостійно розміщеної панелі управління: іншими словами, використання kubelet для нагляду за окремими компонентами панелі управління.
За докладнішою інформацією звертайтесь до розділу Статичні Podʼи.
Podʼи з кількома контейнерами
Podʼи спроєктовано для підтримки кількох взаємодіючих процесів (у вигляді контейнерів), які утворюють єдину цілісну одиницю сервісу. Контейнери в Podʼі автоматично розміщуються та плануються разом на одній фізичній або віртуальній машині в кластері. Контейнери можуть спільно використовувати ресурси та залежності, взаємодіяти між собою та координувати, коли та як вони завершують роботу.
Podʼи в кластері Kubernetes використовуються двома основними способами:
Podʼи, що запускають один контейнер. Модель «один контейнер на Pod» є найпоширенішим сценарієм використання Kubernetes. У цьому випадку Pod можна розглядати як обгортку навколо одного контейнера; Kubernetes керує Podʼами, а не контейнерами безпосередньо.
Podʼи, що запускають кілька контейнерів, які мають працювати разом. Pod може інкапсулювати застосунок, який складається з кількох розміщених разом контейнерів, що тісно повʼязані та мають спільно використовувати ресурси. Ці розміщені разом контейнери утворюють єдину цілісну одиницю сервісу — наприклад, один контейнер надає публічний доступ до даних, збережених у спільному томі, тоді як окремий sidecar-контейнер оновлює ці файли. Pod обгортає ці контейнери, ресурси зберігання та ефемерну мережеву ідентичність в єдину одиницю.
Наприклад, у вас може бути контейнер, який виконує функції вебсервера для файлів у спільному томі, та окремий sidecar-контейнер, який оновлює ці файли з віддаленого джерела, як показано на цій діаграмі:
Деякі Podʼи мають init-контейнери та контейнери застосунку. Стандартно init-контейнери запускаються та завершують роботу до запуску контейнерів застосунку.
У вас також можуть бути sidecar-контейнери, які надають допоміжні сервіси основному Podʼу застосунку (наприклад, service mesh).
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate SidecarContainers, Kubernetes ignores it but does not report any error.
Стандартно увімкнена функціональна можливістьSidecarContainers дозволяє вказати restartPolicy: Always для init-контейнерів. Встановлення політики перезапуску Always гарантує, що контейнери, для яких ви її встановили, вважатимуться sidecar-контейнерами, що працюють протягом усього життєвого циклу Podʼа. Контейнери, які ви явно визначаєте як sidecar-контейнери, запускаються перед основним Podʼом застосунку та працюють, доки Pod не завершить роботу.
Проби контейнерів
Проба — це діагностика, яку kubelet періодично виконує для контейнера. Для виконання діагностики kubelet може використовувати різні дії:
ExecAction (виконується за допомогою середовища виконання контейнерів)
TCPSocketAction (перевіряється безпосередньо kubelet)
HTTPGetAction (перевіряється безпосередньо kubelet)
Ви можете дізнатися більше про проби в документації про життєвий цикл Podʼа.
Прочитайте про Розширену конфігурацію Podʼів, щоб дізнатися про цю тему докладніше. На цій сторінці висвітлюються аспекти конфігурації Podʼів, що виходять за межі основних положень, зокрема:
PriorityClasses
RuntimeClasses
розширені способи налаштування планування: того, як Kubernetes вирішує, на якому вузлі має працювати Pod.
Для розуміння контексту того, чому Kubernetes обгортає загальний API Pod іншими ресурсами (такими як StatefulSets або Deployments), ви можете ознайомитися з попередніми розробками, зокрема:
Ця сторінка описує життєвий цикл Podʼа. Podʼи проходять визначений життєвий цикл, починаючи з фазиPending, переходячи до Running, якщо принаймні один з основних контейнерів успішно запускається, а потім до фази Succeeded або Failed, залежно від того, чи завершився будь-який контейнер у Podʼі зі збоєм.
Поки Pod працює, kubelet керує контейнерами та перетворює специфікацію Podʼа для середовища виконання контейнерів. Kubelet також керує виконанням проб, які відстежують справність вашого застосунку.
Podʼи, подібно до окремих контейнерів застосунків, вважаються відносно ефемерними (а не довговічними) сутностями. Podʼи створюються, отримують унікальний ідентифікатор (UID) і плануються до запуску на вузлах, де залишаються до завершення (відповідно до політики перезапуску) або видалення. Якщо вузол виходить з ладу, Podʼи, які працюють на ньому (або заплановані на нього), позначаються для видалення. Панель управління позначає Podʼи для вилучення після закінчення періоду очікування.
Час життя Podʼа
Поки Pod працює, kubelet може перезапускати контейнери, щоб усунути певні види несправностей. У межах Podʼа Kubernetes відстежує різні стани контейнера і визначає, які дії вжити, щоб Pod знову став справним. Це робиться в циклі опитування, який періодично узгоджує бажаний стан (специфікацію Podʼа) з фактичним станом запущених контейнерів.
В API Kubernetes Pod має як специфікацію, так і фактичний статус. Статус обʼєкта Pod складається з набору станів Podʼа. Ви також можете додавати власні дані про готовність до даних станів Podʼа, якщо це корисно для вашого застосунку.
Podʼи плануються лише один раз за час свого життя; призначення Podʼа на певний вузол називається привʼязкою, а процес вибору вузла — плануванням. Після того, як Pod було заплановано і привʼязано до вузла, Kubernetes намагається запустити цей Pod на цьому вузлі. Pod працює на цьому вузлі, доки не зупиниться або доки його не буде завершено; якщо Kubernetes не може запустити Pod на вибраному вузлі (наприклад, якщо вузол аварійно завершить роботу до запуску Podʼа), то цей конкретний Pod ніколи не запуститься.
Ви можете використати готовність Podʼів до планування, щоб затримати планування Podʼа, доки не буде видалено всі його шлюзи планування (scheduling gates). Наприклад, ви можете визначити набір Podʼів, але запустити планування лише після того, як всі Podʼи будуть створені.
Podʼи та відновлення після збоїв
Якщо один з контейнерів у Podʼі виходить з ладу, Kubernetes може спробувати перезапустити саме цей контейнер. Щоб дізнатися більше, прочитайте «Як Podʼи вирішують проблеми з контейнерами».
Однак Podʼи можуть вийти з ладу так, що кластер не зможе цього виправити, і в такому разі Kubernetes не намагається далі відновлювати Pod; натомість Kubernetes видаляє Pod і покладається на інші компоненти, які забезпечують автоматичне відновлення.
Якщо Pod заплановано на вузол і цей вузол вийшов з ладу, то цей Pod вважається несправним, і Kubernetes зрештою видаляє його. Pod не переживе виселення через нестачу ресурсів або обслуговування вузла.
У Kubernetes використовується абстракція вищого рівня, яка називається контролер, яка виконує роботу з керування відносно одноразовими екземплярами Podʼів.
Конкретний Pod (визначений UID) ніколи не «переплановується» на інший вузол; натомість цей Pod може бути замінений новим, майже ідентичним Podʼом. Якщо ви створюєте Pod-замінник, він може навіть мати ту саму назву (як у .metadata.name), що й старий Pod, але замінник матиме інший .metadata.uid, ніж старий Pod.
Kubernetes не гарантує, що заміну наявного Podʼа буде заплановано на той самий вузол, де був старий Pod, який замінюється.
Повʼязаний час життя
Коли говорять, що щось має такий самий час життя, як і Pod, наприклад том, це означає, що ця річ існує стільки часу, скільки існує цей конкретний Pod (саме з цим UID). Якщо цей Pod буде видалений з будь-якої причини, і навіть якщо буде створений ідентичний замінник, повʼязана річ (у цьому прикладі — том) також буде знищена і створена знову.
Малюнок 1.
Багатоконтейнерний Pod, який містить sidecar-контейнер для завантаження файлів і вебсервер. Pod використовує ефемерний том emptyDir як спільне сховище для контейнерів.
Фаза Podʼа
Поле status Podʼа — це обʼєкт PodStatus, який має поле phase.
Фаза Podʼа — це простий, високорівневий підсумок того, на якому етапі свого життєвого циклу перебуває Pod. Фаза не призначена ні бути всеосяжним зведенням спостережень за станом контейнера чи Podʼа, ні бути всеосяжним скінченним автоматом.
Кількість і значення фаз Podʼа суворо контролюються. Окрім того, що задокументовано тут, не слід нічого припускати про Podʼи з певним значенням phase.
Ось можливі значення для phase:
Значення
Опис
Pending
Pod прийнято кластером Kubernetes, але один чи кілька контейнерів ще не налаштовано й не підготовлено до запуску. Це включає час, який Pod витрачає на очікування планування, а також час, який витрачається на завантаження образів контейнерів з мережі.
Running
Pod привʼязаний до вузла, і всі контейнери створені. Принаймні один контейнер все ще працює або перебуває у процесі запуску чи перезапуску.
Succeeded
Всі контейнери в Podʼі завершили роботу успішно і не будуть перезапущені.
Failed
Всі контейнери в Podʼі завершили роботу, і принаймні один контейнер завершився зі збоєм. Іншими словами, контейнер вийшов зі статусом, відмінним від нуля, або його роботу завершила система, і контейнер не налаштований на автоматичний перезапуск.
Unknown
З якоїсь причини не вдалося отримати стан Podʼа. Ця фаза, як правило, виникає через помилку у звʼязку з вузлом, де повинен виконуватися Pod.
Примітка:
Якщо Podʼу раз у раз не вдається запуститися, у полі Status деяких команд kubectl може зʼявитися CrashLoopBackOff. Аналогічно, під час видалення Podʼа у полі Status деяких команд kubectl може зʼявитися Terminating.
Не плутайте Status, поле відображення kubectl, призначене для зручності користувача, з phase Podʼа. Фаза Podʼа є явною частиною моделі даних Kubernetes і API Pod.
NAMESPACE NAME READY STATUS RESTARTS AGE
alessandras-namespace alessandras-pod 0/1 CrashLoopBackOff 200 2d9h
Pod отримує час на коректне завершення, який стандартно становить 30 секунд. Ви можете використовувати прапорець --force для примусового завершення роботи Podʼа.
Починаючи з Kubernetes 1.27, kubelet переводить видалені Podʼи в термінальну фазу (Failed або Succeeded залежно від статусів завершення роботи контейнерів Podʼа) перед їх видаленням з API-сервера, за винятком двох випадків:
Якщо вузол виходить з ладу або втрачає звʼязок з рештою кластера, Kubernetes застосовує політику встановлення phase всіх Podʼів на втраченому вузлі у Failed.
Стани контейнера
Окрім фази Podʼа загалом, Kubernetes відстежує стан кожного контейнера всередині Podʼа. Ви можете використовувати хуки життєвого циклу контейнера, щоб запускати події на певних етапах життєвого циклу контейнера.
Як тільки планувальник призначає Pod вузлу, kubelet починає створювати контейнери для цього Podʼа, використовуючи середовище виконання контейнерів. Існує три можливі стани контейнера: Waiting (Очікування), Running (Виконання) та Terminated (Завершено).
Щоб перевірити стан контейнерів Podʼа, ви можете використовувати kubectl describe pod <name-of-pod>. Вивід показує стан для кожного контейнера в межах цього Podʼа.
Кожен стан має конкретне значення:
Waiting
Якщо контейнер не перебуває ні в стані Running, ні в стані Terminated, то він перебуває в стані Waiting. Контейнер у стані Waiting усе ще виконує операції, необхідні для завершення запуску: наприклад, завантажує образ контейнера з реєстру образів контейнерів або застосовує дані Secret. Коли ви використовуєте kubectl для опитування Podʼа із контейнером, який перебуває в стані Waiting, ви також бачите поле Reason, яке стисло пояснює, чому контейнер перебуває в цьому стані.
Running
Статус Running вказує на те, що виконання контейнера відбувається без проблем. Якщо було налаштовано хук postStart, він уже виконався і завершився. Коли ви використовуєте kubectl для опитування Podʼа із контейнером, який перебуває в стані Running, ви також бачите інформацію про те, коли контейнер перейшов у стан Running.
Terminated
Контейнер у стані Terminated розпочав виконання і потім або виконався до кінця, або зазнав збою з певної причини. Коли ви використовуєте kubectl для опитування Podʼа із контейнером, який перебуває в стані Terminated, ви бачите причину, код виходу та час початку та завершення періоду виконання цього контейнера.
Якщо у контейнера є налаштований хук preStop, цей хук запускається перед тим, як контейнер перейде в стан Terminated.
Як Podʼи вирішують проблеми з контейнерами
Kubernetes обробляє збої контейнерів у межах Podʼів за допомогою політики restartPolicy, визначеної в spec Podʼа. Ця політика визначає, як Kubernetes реагує на завершення контейнерів через помилки або з інших причин, у такій послідовності:
Початковий збій: Kubernetes намагається негайно перезапустити контейнер на основі restartPolicy Podʼа.
Повторні збої: Після початкового збою Kubernetes застосовує експоненційну затримку для наступних перезапусків, описану в restartPolicy. Це запобігає перевантаженню системи швидкими повторними спробами перезапуску.
Стан CrashLoopBackOff: Це означає, що для певного контейнера зараз діє механізм затримки, бо цей контейнер перебуває в циклі збоїв: він раз у раз зазнає збою та перезапускається.
Скидання затримки: Якщо контейнер успішно працює протягом певного часу (наприклад, 10 хвилин), Kubernetes скидає затримку, розглядаючи будь-який новий збій як перший.
На практиці, CrashLoopBackOff — це стан або подія, яку можна помітити у виводі команди kubectl під час отримання опису або перегляду списку Podʼів, коли контейнер в Podʼі не запускається належним чином, а потім безперервно намагається запуститися, але безуспішно.
Іншими словами, коли контейнер потрапляє в цикл збоїв, Kubernetes застосовує експоненційну затримку, про яку було згадано в політиці перезапуску контейнера. Цей механізм не дає несправному контейнеру перевантажувати систему безперервними невдалими спробами запуску.
CrashLoopBackOff може бути спричинений такими проблемами:
Помилки застосунків, які призводять до завершення контейнера.
Помилки конфігурації, такі як неправильні змінні середовища або відсутність конфігураційних файлів.
Обмеження ресурсів, коли контейнеру може бракувати памʼяті або CPU для правильного запуску.
Невдалі перевірки справності, якщо застосунок не починає обслуговувати запити у передбачений час.
Проби життєздатності або проби запуску контейнера, що повертають результат Failure, як зазначено в розділі про проби.
Щоб розібратися у причинах проблеми CrashLoopBackOff, користувач може:
Перевірити логи: Використовуйте kubectl logs <name-of-pod>, щоб перевірити логи контейнера. Часто це найпряміший спосіб діагностики проблеми, що спричиняє збої.
Перевірити події: Використовуйте kubectl describe pod <name-of-pod> для перегляду подій для Podʼа, які можуть надати підказки про проблеми конфігурації або ресурсів.
Перевірити конфігурацію: Переконайтеся, що конфігурація Podʼа, включаючи змінні середовища та змонтовані томи, є правильною і що всі необхідні зовнішні ресурси доступні.
Перевірити обмеження ресурсів: Переконайтеся, що контейнеру виділено достатньо CPU та памʼяті. Іноді збільшення ресурсів у визначенні Podʼа може вирішити проблему.
Налагодити застосунок: У коді застосунку можуть бути помилки або неправильні налаштування. Запуск цього образу контейнера локально або в середовищі розробки може допомогти діагностувати проблеми, специфічні для застосунку.
Перезапуск контейнера
Коли контейнер у вашому Podʼі зупиняється або зазнає збою, Kubernetes може його перезапустити. Перезапуск не завжди є доречним; наприклад, init-контейнери запускаються лише один раз (у разі успіху), під час запуску Podʼа.
Ви можете налаштувати перезапуски як політику, що застосовується до всіх Podʼів, або за допомогою конфігурації на рівні контейнера (наприклад, коли ви визначаєте sidecar-контейнер), або задати перевизначення на рівні контейнера.
Перезапуск контейнера та відмовостійкість
Проєкт Kubernetes рекомендує дотримуватися принципів cloud native, включаючи відмовостійкий дизайн, який враховує неоголошені або довільні перезапуски. Ви можете досягти цього або завершивши Pod зі збоєм і покладаючись на автоматичну заміну, або спроєктувавши відмовостійкість на рівні контейнера. Обидва підходи допомагають забезпечити доступність вашого робочого навантаження загалом, незважаючи на часткові збої.
Політика перезапуску контейнера на рівні Podʼа
spec Podʼа має поле restartPolicy із можливими значеннями Always, OnFailure та Never. Стандартне значення — Always.
restartPolicy для Podʼа застосовується до контейнерів застосунків в Podʼі та до звичайних init-контейнерів. Sidecar-контейнери не враховують поле restartPolicy на рівні Podʼа: у Kubernetes sidecar визначається як запис всередині initContainers, у якого restartPolicy на рівні контейнера встановлено в Always. Для init-контейнерів, які завершують роботу з помилкою, kubelet виконує їх перезапуск, якщо restartPolicy на рівні Podʼа — OnFailure або Always:
Always: автоматично перезапускає контейнер після будь-якого завершення.
OnFailure: перезапускає контейнер тільки після його завершення з помилкою (код виходу відмінний від нуля).
Never: ніколи автоматично не перезапускає контейнер, що завершив роботу.
Порівняння поведінки перезапуску
Наступна таблиця показує, як контейнери поводяться за різних політик перезапуску та кодів виходу:
Код виходу
restartPolicy: Always
restartPolicy: OnFailure
restartPolicy: Never
Sidecar-контейнери
0 (Успіх)
Перезапускається
Не перезапускається
Не перезапускається
Завжди перезапускається
Ненульовий (Збій)
Перезапускається
Перезапускається
Не перезапускається
Завжди перезапускається
Примітка:
Поведінка перезапуску особливо важлива під час вибору між Deployments та Jobs:
Deployments зазвичай використовують restartPolicy: Always (єдине дозволене значення) для безперервної роботи застосунків.
Jobs зазвичай використовують restartPolicy: OnFailure або restartPolicy: Never для належного оброблення завдань пакетної обробки.
Sidecar-контейнери є init-контейнерами, які завжди перезапускаються незалежно від restartPolicy Podʼа, оскільки вони мають власну політику перезапуску на рівні контейнера restartPolicy: Always.
Приклади сценаріїв
Ось конкретні приклади, що демонструють різну поведінку перезапуску:
Приклад 1: Вебсервер з restartPolicy: Always (типово для Deployments)
apiVersion:v1kind:Podmetadata:name:web-serverspec:restartPolicy:Always # Контейнер перезапускається незалежно від коду виходуcontainers:- name:nginximage:nginx:1.14.2# Якщо цей контейнер аварійно завершить роботу або завершиться з будь-якої причини, його буде перезапущено
Приклад 2: Завдання пакетної обробки з restartPolicy: OnFailure
apiVersion:batch/v1kind:Jobmetadata:name:data-processorspec:template:spec:restartPolicy:OnFailure # Перезапускається лише за ненульового коду виходуcontainers:- name:processorimage:busybox:1.28command:['sh','-c','echo "Processing data..."; exit 0']# Код виходу 0: Job успішно завершено, перезапуск не відбувається# Код виходу 1+: Контейнер перезапускається для повторної спроби завдання
Приклад 3: Одноразове завдання з restartPolicy: Never
apiVersion:v1kind:Podmetadata:name:migration-taskspec:restartPolicy:Never # Ніколи не перезапускається, незалежно від коду виходуcontainers:- name:migrateimage:busybox:1.28command:['sh','-c','echo "Running migration..."; exit 1']# Навіть із кодом виходу 1 (збій) контейнер не буде перезапущено# Pod залишиться в стані Failed
Sidecar-контейнери та політики перезапуску
Sidecar-контейнери мають особливу поведінку перезапуску, яка відрізняється від звичайних контейнерів застосунків:
Sidecar-контейнери ігнорують restartPolicy на рівні Podʼа: Вони використовують власне поле restartPolicy на рівні контейнера, яке завжди встановлено в Always
Незалежний життєвий цикл: Sidecar-контейнери можуть перезапускатися незалежно від основного контейнера застосунку
Постійна робота: Sidecar-контейнери продовжують працювати протягом усього часу життя Podʼа, надаючи допоміжні сервіси
Приклад: Pod із sidecar-контейнером
apiVersion:v1kind:Podmetadata:name:app-with-sidecarspec:restartPolicy:OnFailure # Застосовується лише до основного контейнераinitContainers:- name:logging-sidecar # Це sidecar-контейнерimage:fluent/fluent-bit:1.8restartPolicy:Always # Sidecar завжди перезапускається незалежно від коду виходу# Надає сервіси логування протягом усього часу життя Podʼаcontainers:- name:main-app # Дотримується політики перезапуску на рівні Podʼаimage:nginx:1.14.2# Перезапускається лише у разі помилки (ненульовий код виходу) через політику OnFailure Podʼа
Примітка:
Хоча основний контейнер застосунку дотримується політики restartPolicy: OnFailure на рівні Podʼа, sidecar-контейнер буде перезапущений незалежно від його коду виходу, оскільки sidecar-контейнери завжди мають restartPolicy: Always на рівні контейнера.
Коли kubelet обробляє перезапуск контейнера згідно з налаштованою політикою перезапуску, це стосується лише перезапусків, які призводять до заміни контейнерів всередині того ж Podʼа та на тому ж вузлі. Після завершення контейнерів у Podʼі kubelet перезапускає їх із затримкою, що зростає експоненційно (10 с, 20 с, 40 с, …), і обмеженою пʼятьма хвилинами (300 секунд). Якщо контейнер виконується протягом 10 хвилин без проблем, kubelet скидає таймер затримки перезапуску для цього контейнера. У розділі Sidecar-контейнери та життєвий цикл Podʼа пояснюється поведінка init containers, коли для них вказано поле restartPolicy.
Політика та правила перезапуску окремих контейнерів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Якщо у вашому кластері увімкнено функціональну можливість ContainerRestartRules, ви можете вказати restartPolicy та restartPolicyRules для окремих контейнерів, щоб перевизначити політику перезапуску Podʼа. Політика перезапуску контейнера та правила застосовуються до контейнерів застосунків в Podʼі та до звичайних init-контейнерів.
Нативний для Kubernetes sidecar-контейнер має restartPolicy на рівні контейнера, встановлену в Always.
Перезапуски контейнерів відбуватимуться з такою ж експоненційною затримкою, як і за політики перезапуску Podʼа, описаної вище. Підтримувані політики перезапуску контейнерів:
Always: автоматично перезапускає контейнер після будь-якого завершення.
OnFailure: перезапускає контейнер тільки після його завершення з помилкою (код виходу відмінний від нуля).
Never: ніколи автоматично не перезапускає контейнер, що завершив роботу.
Крім того, для окремих контейнерів можна вказати restartPolicyRules. Якщо вказано поле restartPolicyRules, то також повинно бути вказано restartPolicy контейнера. restartPolicyRules визначають список правил, які застосовуються під час завершення контейнера. Кожне правило складатиметься з умови та дії. Підтримувана умова — exitCodes, яка порівнює код виходу контейнера зі списком заданих значень. Підтримувана дія — Restart, що означає, що контейнер буде перезапущено. Правила будуть оцінюватися по порядку. За першого збігу буде застосовано дію. Якщо жодна з умов правил не збіглася, Kubernetes повернеться до налаштованої restartPolicy контейнера.
Наприклад, Pod з політикою перезапуску OnFailure, який має контейнер try-once. Це дозволяє Podʼу перезапускати лише певні контейнери:
apiVersion:v1kind:Podmetadata:name:on-failure-podspec:restartPolicy:OnFailurecontainers:- name:try-once-container # Цей контейнер буде запущено лише один раз, оскільки політика перезапуску — Never.image:registry.k8s.io/busybox:1.27.2command:['sh','-c','echo "Only running once" && sleep 10 && exit 1']restartPolicy:Never- name:on-failure-container # Цей контейнер буде перезапущено у разі збою.image:registry.k8s.io/busybox:1.27.2command:['sh','-c','echo "Keep restarting" && sleep 1800 && exit 1']
Pod з політикою перезапуску Always, який має init-контейнер, що виконується лише один раз. Якщо init-контейнер зазнає збою, Pod зазнає збою. Це дозволяє Podʼу завершитися зі збоєм, якщо ініціалізація не вдалася, але продовжувати працювати після успішної ініціалізації:
apiVersion:v1kind:Podmetadata:name:fail-pod-if-init-failsspec:restartPolicy:AlwaysinitContainers:- name:init-once # Цей init-контейнер спробує запуститися лише один раз. Якщо він зазнає збою, Pod зазнає збою.image:registry.k8s.io/busybox:1.27.2command:['sh','-c','echo "Failing initialization" && sleep 10 && exit 1']restartPolicy:Nevercontainers:- name:main-container# Цей контейнер завжди перезапускатиметься після успішної ініціалізації.image:registry.k8s.io/busybox:1.27.2command:['sh','-c','sleep 1800 && exit 0']
Pod з політикою перезапуску Never, який має контейнер, що ігнорує одні коди виходу та перезапускається на конкретних кодах виходу. Це корисно для розрізнення між помилками, після яких контейнер можна перезапустити, і тими, які не дозволяють зробити перезапуск:
apiVersion:v1kind:Podmetadata:name:restart-on-exit-codesspec:restartPolicy:Nevercontainers:- name:restart-on-exit-codesimage:registry.k8s.io/busybox:1.27.2command:['sh','-c','sleep 60 && exit 0']restartPolicy:Never # Політика перезапуску контейнера повинна бути вказана, якщо вказані правилаrestartPolicyRules:# Перезапускати контейнер, лише якщо він завершується з кодом 42- action:RestartexitCodes:operator:Invalues:[42]
Правила перезапуску можуть бути використані для багатьох складніших сценаріїв керування життєвим циклом. Зверніть увагу, що на правила перезапуску впливають ті самі невідповідності, що й на звичайну політику перезапуску. Перезапуски kubelet, збір сміття в середовищі виконання контейнерів, періодичні проблеми зі звʼязком із панеллю управління можуть призвести до втрати стану, і контейнери можуть бути повторно запущені, навіть якщо ви очікуєте, що контейнер не буде перезапущено.
Перезапуск усіх контейнерів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Якщо у вашому кластері увімкнено функціональну можливість RestartAllContainersOnContainerExits, ви можете вказати RestartAllContainers як дію в restartPolicyRules на рівні контейнера. Коли завершення контейнера відповідає правилу з цією дією, весь Pod завершується і перезапускається на місці.
Такий перезапуск «на місці» є ефективнішим способом скидання стану Podʼа порівняно з повним видаленням і повторним створенням. Це особливо цінно для робочих навантажень, де перепланування є дорогим, наприклад, для пакетних завдань або завдань навчання AI/ML.
Як працюють перезапуски Podʼів на місці
Коли спрацьовує дія RestartAllContainers, kubelet виконує такі кроки:
Швидке завершення: Усі запущені контейнери в Podʼі завершуються. Налаштований параметр terminationGracePeriodSeconds не враховується, а налаштовані хуки preStop не виконуються. Це забезпечує швидке вимкнення.
Збереження ресурсів Podʼа: Основні ресурси Podʼа зберігаються:
UID Podʼа, IP-адреса та мережевий простір імен
Пісочниця Podʼа та будь-які підключені пристрої
Усі томи, включаючи томи emptyDir та змонтовані томи
Оновлення статусу Podʼа: Статус Podʼа оновлюється: стан PodRestartInPlace встановлюється в True. Це робить процес перезапуску спостережуваним.
Повна послідовність перезапуску: Після завершення роботи всіх контейнерів стан PodRestartInPlace встановлюється в False, і Pod починає стандартний процес запуску:
Init-контейнери запускаються повторно по черзі.
Запускаються sidecar-контейнери та звичайні контейнери.
Ключовим аспектом цієї можливості є те, що всі контейнери перезапускаються, включаючи ті, які раніше успішно завершилися або зазнали збою. Дія RestartAllContainers перевизначає будь-яку налаштовану restartPolicy на рівні контейнера або Podʼа.
Цей механізм корисний у сценаріях, коли всім контейнерам потрібно почати з чистого аркуша, наприклад:
Коли init-контейнер налаштовує середовище, яке може бути пошкоджено, ця можливість забезпечує повторне виконання процесу налаштування.
Sidecar-контейнер може контролювати стан основного застосунку та запускати повний перезапуск Podʼа, якщо застосунок переходить у стан, з якого неможливо відновити роботу.
Розглянемо робоче навантаження, де sidecar-спостерігач відповідає за перезапуск основного застосунку з відомого справного стану, якщо той натрапляє на помилку. Спостерігач може завершитися з певним кодом, щоб ініціювати повний перезапуск робочого Podʼа на місці.
apiVersion:v1kind:Podmetadata:name:ml-workerspec:restartPolicy:Never# The pod itself should not restart unless explicitly told to.initContainers:- name:setup-environmentimage:registry.k8s.io/busybox:1.27.2command:['sh','-c','echo "Setting up environment"']# This init container runs once to prepare the environment.# It will run again after a RestartAllContainers action.- name:watcher-sidecarimage:registry.k8s.io/busybox:1.27.2# In a real-world scenario, this would be a dedicated watcher image.# This command simulates the watcher exiting with a special code.command:['sh','-c','sleep 60; exit 88']restartPolicy:AlwaysrestartPolicyRules:- action:RestartAllContainersexitCodes:# Exit code 88 triggers a full pod restart.operator:Invalues:[88]containers:- name:main-applicationimage:registry.k8s.io/busybox:1.27.2command:['sh','-c','echo "Application is running"; sleep 3600']
У цьому прикладі:
Загальна політика перезапуску Podʼа — Never.
watcher-sidecar виконує команду, а потім завершується з кодом 88.
Код завершення відповідає правилу, що запускає дію RestartAllContainers.
Потім весь Pod, включаючи init-контейнер setup-environment і контейнер main-application, перезапускається на місці. Pod зберігає свій UID, пісочницю, IP-адресу та томи.
Зменшена затримка перезапуску контейнера
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.33; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the ReduceDefaultCrashLoopBackOffDecay feature gate for all relevant components in your cluster.
З увімкненою альфа-функціональною можливістю ReduceDefaultCrashLoopBackOffDecay затримка повторних спроб запуску контейнера у вашому кластері починатиметься з 1 с (замість 10 с) і експоненційно зростатиме у 2 рази з кожним перезапуском до максимальної затримки 60 с (замість 300 с, тобто 5 хвилин).
Якщо ви використовуєте цю можливість з альфа-можливістю KubeletCrashLoopBackOffMax (описано нижче), окремі вузли можуть мати різні значення максимальної затримки.
Налаштовувана затримка перезапуску контейнера
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
З увімкненою функціональною можливістю KubeletCrashLoopBackOffMax ви можете змінити максимальну затримку між повторними спробами запуску контейнера, яка стандартно становить 300 секунд (5 хвилин). Ця конфігурація встановлюється для кожного вузла за допомогою конфігурації kubelet. У вашій конфігурації kubelet у полі crashLoopBackOff встановіть значення поля maxContainerRestartPeriod між "1s" і "300s". Як описано вище у Політиці перезапуску контейнерів, затримки на цьому вузлі все одно починатимуться з 10 секунд і збільшуватимуться експоненційно у 2 рази з кожним перезапуском, але тепер вони будуть обмежені вашим налаштованим максимумом. Якщо значення maxContainerRestartPeriod, яке ви налаштували, менше початкового стандартного значення у 10 секунд, початкову затримку буде встановлено на налаштоване максимальне значення.
Дивіться такі приклади налаштування kubelet:
# затримки перезапуску контейнерів починаються з 10 секунд і збільшуються# у 2 рази з кожним перезапуском, максимум до 100 сkind:KubeletConfigurationcrashLoopBackOff:maxContainerRestartPeriod:"100s"
# затримки між перезапусками контейнера завжди будуть дорівнювати 2 сkind:KubeletConfigurationcrashLoopBackOff:maxContainerRestartPeriod:"2s"
Якщо ви використовуєте цю можливість разом з альфа-можливістю ReduceDefaultCrashLoopBackOffDecay (описано вище), стандартні значення кластера для початкової та максимальної затримки будуть уже не 10 і 300 секунд, а 1 і 60 секунд. Конфігурація для кожного вузла має пріоритет над стандартними значеннями, встановленими ReduceDefaultCrashLoopBackOffDecay, навіть якщо це призведе до того, що вузол матиме довшу максимальну затримку, ніж інші вузли у кластері.
Стани Podʼа
Pod має PodStatus, який містить масив PodConditions, через які Pod пройшов або не пройшов. Kubelet керує такими PodConditions:
PodScheduled: Pod заплановано на вузол.
PodReadyToStartContainers: пісочницю Podʼа успішно створено, мережу налаштовано, томи зберігання змонтовано, а будь-які динамічні ресурси (якщо їх запитано) виділено.
ContainersReady: всі контейнери в Podʼі готові.
Initialized: всі init-контейнери успішно завершили виконання.
Ready: Pod може обслуговувати запити і його слід додати до пулів балансування навантаження всіх відповідних Services.
DisruptionTarget: Pod скоро буде завершено через порушення (наприклад, витіснення, виселення або збір сміття).
PodResizePending: було запитано зміну розміру Podʼа, але її неможливо застосувати. Дивіться Статус зміни розміру Podʼа.
Вказує, чи застосовується цей стан, з можливими значеннями "True", "False" або "Unknown".
lastProbeTime
Мітка часу останньої перевірки стану Podʼа.
lastTransitionTime
Мітка часу останнього переходу Podʼа з одного статусу в інший.
reason
Машиночитаний текст у форматі UpperCamelCase, який вказує причину останнього переходу стану.
message
Зрозуміле людині повідомлення з подробицями щодо останнього переходу статусу.
Готовність Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.14
Ваш застосунок може внести додатковий зворотний звʼязок або сигнали в PodStatus: готовність Podʼа. Щоб використовувати це, встановіть readinessGates в spec Podʼа, щоб вказати список додаткових станів, які kubelet оцінює для визначення готовності Podʼа.
Шлюзи готовності (readiness gates) визначаються поточним станом полів status.condition Podʼа. Якщо Kubernetes не може знайти такий стан у полі status.conditions Podʼа, статус цього стану стандартно вважається "False".
Наприклад:
kind:Pod...spec:readinessGates:- conditionType:"www.example.com/feature-1"status:conditions:- type:Ready # вбудований стан Podʼаstatus:"False"lastProbeTime:nulllastTransitionTime:2018-01-01T00:00:00Z- type:"www.example.com/feature-1"# додатковий стан Podʼаstatus:"False"lastProbeTime:nulllastTransitionTime:2018-01-01T00:00:00ZcontainerStatuses:- containerID:docker://abcd...ready:true...
Стани Podʼа, які ви додаєте, повинні мати назви, що відповідають формату ключа міток Kubernetes.
Статус для готовності Podʼа
Команда kubectl patch не підтримує зміну статусу обʼєкта накладанням патчів. Щоб встановити ці status.conditions для Podʼа, застосунки та оператори повинні використовувати дію PATCH. Ви можете використовувати клієнтську бібліотеку Kubernetes для написання коду, який встановлює власні стани Podʼа для готовності Podʼа.
Pod, який використовує власні стани, оцінюється як готовий лише тоді, коли істинні обидва такі твердження:
Всі контейнери в Podʼі готові.
Усі стани, вказані в readinessGates, мають значення True.
Коли контейнери Podʼа перебувають у стані Ready, але принаймні один власний стан відсутній або має значення False, kubelet встановлює стан Podʼа в ContainersReady.
Готовність Podʼа до запуску контейнерів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37
Примітка:
На ранніх етапах розробки цей стан називали PodHasNetwork.
Після того, як Pod заплановано на вузол, kubelet має його допустити, а всі необхідні томи зберігання мають бути змонтовані. Щойно ці фази завершаться, kubelet працює із середовищем виконання контейнерів (використовуючи Container Runtime Interface (CRI)), щоб налаштувати пісочницю середовища виконання та мережу для Podʼа. Якщо Pod використовує Динамічне виділення ресурсів, ці ресурси також виділяються під час цієї фази. Стан PodReadyToStartContainers додається до поля status.conditions Podʼа.
Kubelet встановлює цей стан в False, коли виявляє, що Pod не має пісочниці середовища виконання з налаштованою мережею. Це трапляється в таких випадках:
На початковому етапі життєвого циклу Podʼа, коли kubelet ще не почав налаштовувати пісочницю для Podʼа за допомогою середовища виконання контейнерів.
Пізніше в життєвому циклі Podʼа, коли пісочницю Podʼа було знищено через:
перезавантаження вузла без виселення Podʼа
для середовищ виконання контейнерів, які використовують віртуальні машини для ізоляції, — перезавантаження віртуальної машини пісочниці Podʼа, що потім вимагає створення нової пісочниці та нової конфігурації мережі контейнера.
Після створення пісочниці, налаштування мережі, монтування томів та (якщо запитано) динамічного виділення ресурсів kubelet встановлює стан PodReadyToStartContainers в True. Завантаження образу та створення контейнера відбуваються після цього.
Для Podʼа з init-контейнерами kubelet встановлює стан Initialized в True після успішного завершення init-контейнерів (що відбувається після успішного створення пісочниці та налаштування мережі втулком середовища виконання). Для Podʼа без init-контейнерів kubelet встановлює стан Initialized в True перед початком створення пісочниці та налаштування мережі.
Зміна розміру Podʼів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate InPlacePodVerticalScaling, Kubernetes ignores it but does not report any error.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Kubernetes підтримує зміну ресурсів CPU та памʼяті, виділених для Podʼів, після їх створення. (Для інших ресурсів інфраструктури потрібно використовувати інші методи, специфічні для цих ресурсів.) Існує два основні підходи до зміни розміру CPU та памʼяті:
Зміна розміру Podʼа на місці
Ви можете змінити розмір ресурсів CPU та памʼяті на рівні контейнера Podʼа без повторного створення Podʼа. Це також називається вертикальним масштабуванням Podʼа на місці. Це дозволяє вам регулювати розподіл ресурсів для запущених контейнерів, потенційно уникаючи порушення роботи застосунків.
Щоб виконати зміну розміру на місці, оновіть бажаний стан Podʼа за допомогою субресурсу /resize. Kubelet спробує застосувати нові значення ресурсів до контейнерів, що працюють. Стани Podʼа PodResizePending та PodResizeInProgress (описані в розділі Стани Podʼа) вказують на статус операції зміни розміру. Для отримання додаткової інформації про статус зміни розміру див. Статус зміни розміру контейнера.
Основні моменти, які слід враховувати під час зміни розміру на місці:
На місці можна змінювати розмір лише ресурсів CPU та памʼяті.
Більш cloud native підхід до зміни ресурсів Podʼа полягає у використанні ресурсу робочого навантаження, який ним керує (наприклад, Deployment або StatefulSet). Коли ви оновлюєте специфікації ресурсів у шаблоні Podʼа, контролер робочого навантаження створює нові Podʼи з оновленими ресурсами та завершує старі Podʼи відповідно до своєї стратегії оновлення.
Цей підхід:
Працює з будь-якою версією Kubernetes.
Може змінювати будь-яку специфікацію Podʼа, а не тільки ресурси.
Призводить до заміни Podʼа, тому вам слід спроєктувати робоче навантаження таким чином, щоб воно могло обробляти заплановані порушення. Розгляньте можливість використання PodDisruptionBudget для контролю доступності.
Вимагає, щоб вашими Podʼами керував ресурс робочого навантаження.
Ви також можете використовувати VerticalPodAutoscaler для автоматичного керування рекомендаціями та оновленнями ресурсів Podʼів.
Проби контейнерів
Kubernetes дозволяє визначати проби для безперервного моніторингу стану контейнерів у Podʼі. Проба — це діагностика, яку періодично виконує kubelet для контейнера. Для виконання діагностики kubelet або виконує код всередині контейнера, або виконує мережевий запит.
На основі результатів проб Kubernetes може перезапускати несправні контейнери або припиняти надсилання трафіку до контейнерів, які не готові.
Kubelet може за бажанням виконувати три типи проб для запущених контейнерів і реагувати на них, кожен із цих типів має своє призначення. Для механізмів проб (exec, grpc, httpGet, tcpSocket), полів конфігурації та детальних рекомендацій щодо використання дивіться Проби життєздатності, готовності та запуску.
Проба запуску
Проби запуску перевіряють, чи запущено застосунок всередині контейнера. Якщо проба запуску налаштована, Kubernetes не виконує проби життєздатності або готовності, поки проба запуску не буде успішною, що дає застосунку час завершити ініціалізацію.
Цей тип проби виконується лише під час запуску, на відміну від проб життєздатності та готовності, які виконуються періодично.
Якщо проба запуску не вдається, kubelet завершує контейнер, і до контейнера застосовується його політика перезапуску.
Проба життєздатності
Проби життєздатності визначають, коли потрібно перезапустити контейнер. Наприклад, проби життєздатності можуть виявити взаємне блокування, коли застосунок працює, але не може просуватися далі. Перезапуск контейнера в такому стані може допомогти зробити застосунок більш доступним, незважаючи на помилки.
Якщо контейнер не проходить пробу життєздатності більше разів, ніж дозволено налаштуваннями, kubelet перезапускає цей контейнер. Проби життєздатності не чекають успіху проб готовності. Якщо ви хочете почекати перед виконанням проби життєздатності, ви можете або визначити initialDelaySeconds, або використовувати пробу запуску.
Проба готовності
Проби готовності визначають, коли контейнер готовий приймати трафік. Це корисно, коли потрібно дочекатися виконання застосунком тривалих початкових завдань, таких як встановлення мережевих зʼєднань, завантаження файлів та прогрів кешів. Проби готовності також можуть бути корисними пізніше в життєвому циклі контейнера, наприклад, під час відновлення після тимчасових збоїв або перевантажень.
Якщо проба готовності повертає невдалий результат, контролер EndpointSlice видаляє IP-адресу Podʼа з EndpointSlices усіх Services, які відповідають Podʼу.
Проби готовності виконуються в контейнері протягом усього його життєвого циклу.
Завершення роботи Podʼів
Оскільки Podʼи представляють процеси, які виконуються на вузлах кластера, важливо дозволити цим процесам коректно завершувати роботу, коли вони більше не потрібні (а не зупиняти їх раптово сигналом KILL, не даючи можливості прибрати за собою).
Мета дизайну полягає в тому, щоб ви могли запитувати видалення і знати, коли процеси завершуються, а також мати можливість гарантувати, що видалення врешті-решт завершиться. Коли ви запитуєте видалення Podʼа, кластер реєструє та відстежує призначений період коректного завершення до того, як буде дозволено примусово знищити Pod. Завдяки цьому відстеженню примусового вимкнення kubelet намагається виконати коректне вимкнення.
Зазвичай під час такого коректного завершення роботи Podʼа kubelet надсилає запити до середовища виконання контейнерів, щоб спробувати зупинити контейнери в Podʼі, спочатку надсилаючи сигнал TERM (також відомий як SIGTERM) основному процесу в кожному контейнері з тайм-аутом періоду коректного завершення. Запити на зупинку контейнерів обробляються середовищем виконання контейнерів асинхронно. Порядок обробки цих запитів не гарантується. Багато середовищ виконання контейнерів враховують значення STOPSIGNAL, визначене в образі контейнера і, якщо воно відрізняється, надсилають значення STOPSIGNAL, визначене в образі контейнера, замість TERM. Після закінчення періоду коректного завершення сигнал KILL надсилається всім залишковим процесам, а потім Pod видаляється з API-сервера. Якщо kubelet або сервіс керування середовищем виконання контейнерів перезапускається під час очікування завершення процесів, кластер повторює спробу спочатку, включаючи повний початковий період коректного завершення.
Сигнали зупинки
Сигнал зупинки, який використовується для завершення роботи контейнера, може бути визначено в образі контейнера за допомогою інструкції STOPSIGNAL. Якщо в образі контейнера не визначено жодного сигналу зупинки, для завершення роботи контейнера буде використано стандартний сигнал середовища виконання контейнерів (SIGTERM як для containerd, так і для CRI-O).
Визначення власних сигналів зупинки
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.33; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the ContainerStopSignals feature gate for all relevant components in your cluster.
Якщо увімкнено функціональну можливість ContainerStopSignals, ви можете налаштувати власний сигнал зупинки для ваших контейнерів з життєвого циклу контейнера. Щоб визначати сигнали зупинки в життєвому циклі контейнера, поле spec.os.name Podʼа має бути заданим. Перелік допустимих сигналів залежить від ОС, на яку заплановано Pod. Для Podʼів, запланованих на вузли Windows, ми підтримуємо тільки SIGTERM і SIGKILL як допустимі сигнали.
Ось приклад специфікації Podʼа, що визначає власний сигнал зупинки:
Якщо в життєвому циклі визначено сигнал зупинки, він перевизначить сигнал, визначений в образі контейнера. Якщо у специфікації контейнера не визначено жодного сигналу зупинки, контейнер повернеться до стандартної поведінки.
Порядок завершення роботи Podʼа
Порядок завершення роботи Podʼа на прикладі:
Ви використовуєте інструмент kubectl, щоб вручну видалити певний Pod, зі стандартним періодом коректного завершення (30 секунд).
Pod в API-сервері оновлюється: записується час, після якого Pod вважається «мертвим», разом із періодом коректного завершення. Якщо ви використовуєте kubectl describe для перевірки Podʼа, який ви видаляєте, цей Pod показується як «Terminating». На вузлі, де працює Pod: щойно kubelet бачить, що Pod позначено як такий, що завершує роботу (встановлено тривалість коректного вимкнення), kubelet розпочинає локальний процес вимкнення Podʼа.
Якщо один із контейнерів Podʼа має визначений хукpreStop і terminationGracePeriodSeconds у специфікації Podʼа не встановлено в 0, kubelet виконує цей хук всередині контейнера. Стандартне значення terminationGracePeriodSeconds — 30 секунд.
Якщо хук preStop все ще виконується після закінчення періоду коректного завершення, kubelet запитує невелике одноразове подовження цього періоду на 2 секунди.
Примітка:
Якщо хуку preStop потрібно більше часу для завершення, ніж дозволяє стандартний період коректного завершення, вам слід змінити terminationGracePeriodSeconds відповідно до цього.
Kubelet ініціює надсилання середовищем виконання контейнерів сигналу TERM процесу 1 всередині кожного контейнера.
Є спеціальний порядок, якщо для Podʼа вказані будь-які sidecar-контейнери. В іншому випадку контейнери в Podʼі отримують сигнал TERM у різний час і в довільному порядку. Якщо порядок завершення роботи має значення, розгляньте можливість використання хука preStop для синхронізації (або перейдіть на використання sidecar-контейнерів).
Одночасно з тим, як kubelet розпочинає коректне вимкнення Podʼа, панель управління оцінює, чи слід вилучити цей Pod, що вимикається, з обʼєктів EndpointSlice, де ці обʼєкти представляють Service із налаштованим селектором. ReplicaSets та інші ресурси робочого навантаження більше не вважають такий Pod дійсною реплікою, що обслуговує запити.
Podʼи, які вимикаються повільно, не повинні продовжувати обслуговувати звичайний трафік і мають почати завершення роботи та закінчити обробку відкритих зʼєднань. Деяким застосункам недостатньо закінчити обробку відкритих зʼєднань, і вони потребують коректнішого завершення роботи, наприклад, очищення та завершення сеансів.
Будь-які точки доступу, які представляють Podʼи, що завершують роботу, не вилучаються негайно з EndpointSlices, а статус, який вказує на стан завершення, надається через API EndpointSlice. Точки доступу, що завершують роботу, завжди мають статус ready зі значенням false (для зворотної сумісності з версіями до 1.26), тому балансувальники навантаження не використовуватимуть їх для звичайного трафіку.
Якщо потрібне очищення трафіку на Podʼі, що завершує роботу, фактичну готовність можна перевірити за станом serving. Докладніше про те, як реалізувати очищення зʼєднань, можна дізнатися в навчальному матеріалі Порядок завершення роботи Podʼів та Endpointʼів
kubelet забезпечує завершення та вимкнення Podʼа.
Коли період коректного завершення спливає, а в Podʼі все ще працює якийсь контейнер, kubelet ініціює примусове вимкнення. Середовище виконання контейнерів надсилає SIGKILL усім процесам, які ще працюють у будь-якому контейнері в Podʼі. Kubelet також прибирає прихований контейнер pause, якщо це середовище виконання контейнерів його використовує.
kubelet переводить Pod у термінальну фазу (Failed або Succeeded залежно від кінцевого стану його контейнерів).
kubelet ініціює примусове видалення обʼєкта Pod з API-сервера, встановлюючи період коректного завершення в 0 (негайне видалення).
API-сервер видаляє API-обʼєкт Podʼа, який після цього більше не видимий для жодного клієнта.
Примусове завершення Podʼів
Увага:
Примусове видалення може потенційно порушити роботу деяких робочих навантажень та їхніх Podʼів.
Стандартно всі видалення є коректними протягом 30 секунд. Команда kubectl delete підтримує опцію --grace-period=<seconds>, яка дозволяє перевизначити стандартне значення власним.
Встановлення періоду коректного завершення в 0 примусово та негайно видаляє Pod з API-сервера. Якщо Pod все ще працював на вузлі, це примусове видалення змушує kubelet негайно розпочати прибирання.
Використовуючи kubectl, ви повинні вказати додатковий прапорець --force разом із --grace-period=0, щоб виконати примусове видалення.
Під час примусового видалення API-сервер не чекає підтвердження від kubelet, що Pod завершено на вузлі, на якому він працював. Він
негайно видаляє Pod в API, щоб можна було створити новий Pod із такою самою назвою. На вузлі Podʼи, налаштовані на негайне завершення, все ще отримують невеликий період коректного завершення перед примусовим знищенням.
Увага:
Негайне видалення не чекає підтвердження того, що запущений ресурс було завершено. Ресурс може продовжувати працювати в кластері нескінченно.
Якщо вам потрібно примусово видалити Podʼи, які є частиною StatefulSet, дивіться документацію для видалення Podʼів з StatefulSet.
Завершення роботи Podʼа та sidecar-контейнери
Якщо ваш Pod містить один або більше sidecar-контейнерів (init-контейнерів з політикою перезапуску Always), kubelet затримає надсилання сигналу TERM цим sidecar-контейнерам, доки останній основний контейнер повністю не завершить роботу. Sidecar-контейнери будуть завершені у зворотному порядку, в якому вони визначені в специфікації Podʼа. Це забезпечує продовження обслуговування sidecar-контейнерами інших контейнерів у Podʼі, доки вони не стануть непотрібними.
Це означає, що повільне завершення роботи основного контейнера також затримає завершення роботи sidecar-контейнерів. Якщо період коректного завершення спливе до закінчення процесу завершення роботи, Pod може перейти до примусового завершення. У цьому випадку всі залишкові контейнери в Podʼі будуть завершені одночасно з коротким періодом коректного завершення.
Аналогічно, якщо Pod має хук preStop, який перевищує період коректного завершення, може статися аварійне завершення. Загалом, якщо ви використовували хуки preStop для керування порядком завершення без sidecar-контейнерів, тепер ви можете видалити їх і дозволити kubelet автоматично керувати завершенням роботи sidecar-контейнерів.
Збір сміття Podʼів
Для Podʼів, що завершилися зі збоєм, обʼєкти API залишаються в API кластера, поки людина чи контролер явно їх не видалять.
Збирач сміття Podʼів (PodGC), який є контролером панелі управління, прибирає завершені Podʼи (з фазою Succeeded або Failed), коли кількість Podʼів перевищує налаштований поріг (визначений параметром terminated-pod-gc-threshold в kube-controller-manager). Це запобігає витоку ресурсів під час створення та завершення Podʼів з часом.
Крім того, PodGC очищує будь-які Podʼи, які відповідають одній з таких умов:
є осиротілими Podʼами — привʼязаними до вузла, якого вже не існує,
Разом із прибиранням Podʼів PodGC також позначає їх як такі, що зазнали збою, якщо вони перебувають у нетермінальній фазі. Крім того, PodGC додає стан порушення роботи Podʼа під час прибирання осиротілого Podʼа. Дивіться стани порушення роботи Podʼа, щоб дізнатися більше.
Поведінка Podʼа під час перезапуску kubelet
Якщо ви перезапускаєте kubelet, Podʼи (та їхні контейнери) продовжують працювати навіть під час перезапуску. Коли на вузлі працюють Podʼи, зупинка або перезапуск kubelet на цьому вузлі не призводить до того, що kubelet зупиняє всі локальні Podʼи перед тим, як зупинитися сам. Щоб зупинити Podʼи на вузлі, ви можете використовувати kubectl drain.
Виявлення перезапусків kubelet
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.35; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the ChangeContainerStatusOnKubeletRestart feature gate for all relevant components in your cluster.
Коли kubelet запускається, він перевіряє, чи є вже вузол із привʼязаними Podʼами. Якщо стан Ready вузла залишається незмінним, тобто стан не змінився з true на false, Kubernetes виявляє це як перезапуск kubelet. (Можна перезапустити kubelet іншими способами, наприклад, щоб виправити помилку вузла, але в таких випадках Kubernetes вибирає безпечний варіант і розглядає це як зупинку kubelet, а потім його запуск).
Коли kubelet перезапускається, статусами контейнерів керують по-різному залежно від налаштування функціональної можливості:
Стандартно kubelet не змінює статуси контейнерів після перезапуску. Контейнери, для яких було встановлено ready: true, залишаються готовими.
Якщо ви зупините kubelet на достатньо довгий час, щоб він не пройшов серію перевірок пульсу вузла, а потім зачекаєте, перш ніж знову запустити kubelet, Kubernetes може почати виселяти Podʼи з цього вузла. Однак, навіть якщо виселення Podʼів починається, Kubernetes не позначає окремі контейнери в цих Podʼах як ready: false. Виселення на рівні Podʼа відбувається після того, як панель управління додає вузлу taint node.kubernetes.io/not-ready (через провал перевірок пульсу).
У Kubernetes 1.37 ви можете вибрати стару поведінку, за якої kubelet завжди змінює значення контейнерів ready після перезапуску kubelet на false.
Ця стара поведінка довгий час була стандартною, але спричиняла проблеми для користувачів Kubernetes, особливо у великих розгортаннях. Хоча функціональна можливість дозволяє тимчасово повернутися до цієї старої поведінки, проєкт Kubernetes рекомендує подавати звіт про помилку, якщо ви зіткнулися з проблемами. Функціональну можливістьChangeContainerStatusOnKubeletRestart буде видалено в майбутньому.
Для докладної інформації про статус Podʼа та контейнера в API, перегляньте документацію API, яка охоплює status для Podʼа.
6.4.1.2 - Стани Podʼа
У Kubernetes багато обʼєктів мають стани (conditions). Стан — це показник певного аспекту фактичного становища того, що представляє обʼєкт. Podʼи мають стани, і стани Podʼів у Kubernetes є важливим аспектом, що дозволяє контролерам (а також тим, хто займається усуненням несправностей) оцінювати справність Podʼів.
Фаза Podʼа надає високорівневий огляд того, на якому етапі життєвого циклу перебуває Pod, але одне значення не може показати повну картину. Наприклад, Pod може перебувати у фазі Running, але не бути готовим до обслуговування трафіку. Стани Podʼа доповнюють фазу, відстежуючи незалежно один від одного різні аспекти статусу Podʼа, наприклад, чи було його заплановано, чи готові його контейнери, чи триває зміна розміру, або чи буде робота Podʼа незабаром порушена через taint.
Структура стану Podʼа
Статус Podʼа включає масив PodConditions, які вказують, чи пройшов Pod певні контрольні точки.
Кожен елемент масиву PodCondition має такі поля:
Поля PodCondition
Поле
Опис
type
Назва стану Podʼа.
status
Вказує, чи застосовний цей стан, з можливими значеннями "True", "False" або "Unknown".
lastProbeTime
Час останньої перевірки стану Podʼа.
lastTransitionTime
Час останнього переходу Podʼа з одного стану в інший.
reason
Текст у форматі UpperCamelCase, придатний для машинного зчитування, що вказує причину останнього переходу стану.
message
Повідомлення, придатне для сприйняття людиною, що містить детальну інформацію про останній перехід стану.
observedGeneration
.metadata.generation Podʼа на момент запису стану. Див. Генерація Podʼа.
Вбудовані стани Podʼа
Kubernetes керує такими станами Podʼа:
Стани життєвого циклу: встановлюються під час проходження Podʼом свого життєвого циклу, приблизно в такому порядку: PodScheduled, PodReadyToStartContainers, Initialized, ContainersReady, Ready.
Інші стани: встановлюються у відповідь на конкретні операції або події: DisruptionTarget, PodResizePending, PodResizeInProgress.
У міру проходження Podʼом свого життєвого циклу kubelet встановлює такі стани приблизно в такому порядку:
PodScheduled: Pod було заплановано на вузол.
PodReadyToStartContainers: пісочницю Podʼа було успішно створено та налаштовано мережу. Пісочницю та мережу налаштовують середовище виконання контейнерів та втулок CNI.
Initialized: всі init-контейнери успішно завершилися. Для Podʼа без init-контейнерів встановлюється в True перед створенням пісочниці.
ContainersReady: всі контейнери в Podʼі готові. Готовність контейнера визначається його пробою готовності, якщо вона налаштована.
Ready: Pod здатний обслуговувати запити і повинен бути доданий до пулів балансування навантаження всіх відповідних Services. Podʼи, які не є Ready, видаляються з точок доступу Service.
Примітка:
Стан Ready залежить не лише від ContainersReady. Якщо Pod вказує readinessGates, всі ці власні стани також повинні бути True, щоб Pod був Ready. Див. Готовність Podʼа для деталей.
Ви можете перевірити стани Podʼа за допомогою kubectl:
kubectl get pod <pod-name> -o yaml
Цей вивід показує, як виглядає поле status.conditions для запущеного Podʼа:
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate PodReadyToStartContainersCondition, Kubernetes ignores it but does not report any error.
Примітка:
Під час ранньої розробки цей стан називався PodHasNetwork.
Після того, як Pod заплановано на вузол, kubelet має його допустити, а всі необхідні томи зберігання мають бути змонтовані. Після завершення цих фаз kubelet працює із середовищем виконання контейнерів (використовуючи Container Runtime Interface, CRI), щоб налаштувати пісочницю середовища виконання та мережу для Podʼа. Стан PodReadyToStartContainers додається до поля status.conditions Podʼа.
Kubelet встановлює цей стан в False, коли виявляє, що Pod не має пісочниці середовища виконання з налаштованою мережею. Це відбувається в таких сценаріях:
На ранньому етапі життєвого циклу Podʼа, коли kubelet ще не почав налаштовувати пісочницю для Podʼа за допомогою середовища виконання контейнерів.
На пізньому етапі життєвого циклу Podʼа, коли пісочницю Podʼа було знищено через:
перезавантаження вузла без виселення Podʼа
для середовищ виконання контейнерів, які використовують віртуальні машини для ізоляції, перезавантаження віртуальної машини пісочниці Podʼа, що вимагає створення нової пісочниці та нової конфігурації мережі контейнера.
Kubelet встановлює стан PodReadyToStartContainers в True після того, як втулок середовища виконання успішно завершить створення пісочниці та налаштування мережі для Podʼа. Після встановлення стану PodReadyToStartContainers в True kubelet може почати завантаження образів контейнерів та створення контейнерів.
Для Podʼа з init-контейнерами kubelet встановлює стан Initialized в True після успішного завершення init-контейнерів (що відбувається після успішного створення пісочниці та налаштування мережі втулком середовища виконання). Для Podʼа без init-контейнерів kubelet встановлює стан Initialized в True перед початком створення пісочниці та налаштування мережі.
Інші стани Podʼа
Такі стани не є частиною нормального проходження життєвого циклу Podʼа. Вони встановлюються у відповідь на конкретні операції або події.
DisruptionTarget
Спеціальний стан Podʼа DisruptionTarget додається для того, щоб вказати, що Pod буде видалено через порушення. Поле reason цього стану додатково вказує одну з таких причин завершення Podʼа:
PreemptionByScheduler
Pod підлягає витісненню планувальником, щоб звільнити місце для нового Podʼа з вищим пріоритетом. Для отримання додаткової інформації див. Пріоритет та витіснення Podʼів.
DeletionByTaintManager
Pod підлягає видаленню менеджером Taint (який є частиною контролера життєвого циклу вузла в kube-controller-manager) через NoExecute taint, який Pod не толерує; див. виселення на основі taint.
У всіх інших сценаріях порушення, таких як виселення через перевищення обмежень контейнерів Podʼа, Podʼи не отримують стан DisruptionTarget, оскільки ці порушення, ймовірно, були спричинені самим Podʼом і повторилися б під час повторної спроби.
Примітка:
Процес порушення роботи Podʼа може бути зупинено. Панель управління може повторно спробувати продовжити порушення роботи того самого Podʼа, але це не гарантовано. В результаті стан DisruptionTarget може бути додано до Podʼа, але цей Pod може фактично не бути видаленим. У такій ситуації через деякий час стан порушення роботи Podʼа буде очищено.
Разом з очищенням Podʼів, механізм збору сміття Podʼів (PodGC) також позначає їх як невдалі, якщо вони перебувають у нетермінальній фазі (див. також збір сміття Podʼів).
Під час використання Job (або CronJob) ви можете використовувати ці стани порушення роботи Podʼів як частину політики збоїв Podʼа вашого Job.
Для отримання додаткової інформації див. Порушення.
PodResizePending та PodResizeInProgress
Kubelet оновлює стани Podʼа, щоб вказати статус запиту на зміну розміру:
type: PodResizePending: Kubelet не може негайно виконати запит. Поле message надає пояснення, чому.
reason: Infeasible: Запитана зміна розміру неможлива на поточному вузлі (наприклад, запит більше ресурсів, ніж є на вузлі).
reason: Deferred: Запитана зміна розміру наразі неможлива, але може стати можливою пізніше (наприклад, якщо інший Pod буде видалено). Kubelet повторно спробує зміну розміру.
type: PodResizeInProgress: Kubelet прийняв зміну розміру та виділив ресурси, але зміни ще застосовуються. Зазвичай це триває недовго, але може зайняти більше часу залежно від типу ресурсу та поведінки середовища виконання. Будь-які помилки під час виконання повідомляються у полі message (разом з reason: Error).
Якщо запитана зміна розміру є Deferred, kubelet періодично повторно намагатиметься виконати зміну розміру, наприклад, коли інший Pod буде видалено або зменшено масштаб.
Ваш застосунок може додавати додаткові відгуки або сигнали в .status Podʼа; це відомо як розширена готовність Podʼів. Щоб використовувати це, встановіть readinessGates у spec Podʼа, щоб вказати список додаткових станів, які kubelet оцінює для готовності Podʼа. Потім ви реалізуєте або встановлюєте контролер, який керує цими власними станами, і kubelet використовує це як додаткове вхідне значення для визначення готовності Podʼа.
Шлюзи готовності (readiness gates) визначаються поточним станом полів status.condition для Podʼа. Якщо Kubernetes не може знайти такий стан у полі status.conditions Podʼа, його статус стандартно дорівнює "False".
Стани Podʼа, які ви додаєте, повинні мати назви, що відповідають формату ключів міток Kubernetes.
Статус готовності Podʼа
Щоб встановити ці status.conditions для Podʼа, застосунки та оператори повинні використовувати дію PATCH на субресурсі статусу Podʼа. Ви можете використовувати kubectl patch з --subresource=status, або бібліотеку клієнта Kubernetes, щоб написати код, який встановлює власні стани Podʼа для готовності Podʼа.
Pod, який використовує власні стани, вважається готовим тільки тоді, коли виконуються обидва такі твердження:
Всі контейнери в Podʼі готові.
Усі стани, зазначені в readinessGates, мають значення True.
Коли контейнери Podʼа готові, але принаймні один власний стан відсутній або має значення False, kubelet встановлює стан Ready Podʼа в status: "False" з reason: ReadinessGatesNotReady.
Ця сторінка надає загальний огляд init-контейнерів: спеціалізованих контейнерів, які запускаються перед запуском контейнерів застосунків в Podʼі. Init-контейнери можуть містити утиліти або сценарії налаштування, які відсутні в образі застосунку.
Ви можете вказати init-контейнери в специфікації Podʼа разом із масивом containers (який описує контейнери застосунку).
У Kubernetes sidecar-контейнер — це контейнер, який запускається перед основним контейнером застосунку і продовжує працювати. Цей документ стосується init-контейнерів — контейнерів, які виконуються до завершення під час ініціалізації Podʼа.
Що таке init-контейнери
У Podʼі може бути кілька контейнерів, які виконують застосунки, але також може бути один чи кілька init-контейнерів, які виконуються до того, як стартують контейнери застосунків.
Init-контейнери точно такі самі, як і звичайні контейнери, за винятком того, що:
Init-контейнери завжди виконуються до завершення.
Кожен init-контейнер повинен успішно завершити свою роботу, перш ніж почне роботу наступний.
Якщо init-контейнер Podʼа зазнає збою, kubelet повторно перезапускає цей init-контейнер, доки він не завершиться успішно. Однак якщо restartPolicy Podʼа дорівнює Never, і init-контейнер зазнає збою під час запуску цього Podʼа, Kubernetes вважає весь Pod невдалим.
Щоб вказати init-контейнер для Podʼа, додайте поле initContainers у специфікацію Podʼа, у вигляді масиву обʼєктів container (аналогічно полю containers застосунку та його вмісту). Дивіться Container в
довідці API для отримання докладнішої інформації.
Статус init-контейнерів повертається у полі .status.initContainerStatuses у вигляді масиву статусів контейнерів (аналогічно полю .status.containerStatuses).
Відмінності від звичайних контейнерів
Init-контейнери підтримують всі поля та можливості контейнерів застосунків, включаючи обмеження ресурсів, томи та налаштування безпеки. Однак
запити та обмеження ресурсів для init-контейнера обробляються по-іншому, як описано в розділі Спільне використання ресурсів всередині контейнерів.
Звичайні init-контейнери (іншими словами, виключаючи sidecar-контейнери) не підтримують поля lifecycle, livenessProbe, readinessProbe чи startupProbe. Init-контейнери повинні успішно завершити свою роботу перед тим, як Pod може бути готовий; sidecar-контейнери продовжують працювати протягом життєвого циклу Podʼа і підтримують деякі проби. Дивіться sidecar-контейнер для отримання додаткової інформації про ці контейнери.
Якщо ви вказали кілька init-контейнерів для Podʼа, kubelet виконує кожен такий контейнер послідовно. Кожен init-контейнер повинен успішно завершити свою роботу, перш ніж може бути запущено наступний. Коли всі init-контейнери завершать свою роботу, kubelet ініціалізує контейнери застосунків для Podʼа та запускає їх як зазвичай.
Відмінності від sidecar-контейнерів
Init-контейнери запускаються і завершують свої завдання до того, як розпочнеться робота основного контейнера застосунку. На відміну від sidecar-контейнерів, init-контейнери не продовжують працювати паралельно з основними контейнерами.
Init-контейнери запускаються і завершують свою роботу послідовно, і основний контейнер не починає свою роботу, доки всі init-контейнери успішно не завершать свою роботу.
Init-контейнери не підтримують lifecycle, livenessProbe, readinessProbe чи startupProbe, у той час, як sidecar-контейнери підтримують всі ці проби, щоб керувати своїм життєвим циклом.
Init-контейнери використовують ті самі ресурси (CPU, памʼять, мережу), що й основні контейнери застосунків, але не взаємодіють з ними напряму. Однак вони можуть використовувати спільні томи для обміну даними.
Використання init-контейнерів
Оскільки init-контейнери мають образи, окремі від контейнерів застосунків, вони мають кілька переваг для коду, повʼязаного із запуском:
Init-контейнери можуть містити утиліти або власний код для налаштування, які відсутні в образі застосунку. Наприклад, немає потреби створювати образ FROM іншого образу лише для використання інструменту, такого як sed, awk, python чи dig під час налаштування.
Ролі створення та розгортання образу застосунку можуть працювати незалежно одна від одної без необхідності спільного створення єдиного образу застосунку.
Init-контейнери можуть працювати з іншим поданням файлової системи, ніж контейнери застосунків у тому самому Podʼі. Отже, їм можна надати доступ до Secrets, до яких контейнери застосунків не мають доступу.
Оскільки init-контейнери завершують свою роботу, перш ніж будь-які контейнери застосунків розпочнуть свою роботу, вони пропонують механізм блокування або затримки запуску контейнера застосунку до виконання певних умов. Після того, як умови виконані, всі контейнери застосунків у Podʼі можуть стартувати паралельно.
Init-контейнери можуть безпечно виконувати утиліти або власний код, який інакше зробив би образ контейнера застосунку менш безпечним. Відокремлюючи непотрібні інструменти, ви можете обмежити поверхню атаки вашого образу контейнера застосунку.
Приклади
Ось кілька ідей, як використовувати init-контейнери:
Очікування на створення Service, використовуючи команду оболонки у вигляді одного рядка, наприклад:
for i in {1..100};do sleep 1;if nslookup myservice;thenexit 0;fi;done;exit1
Реєстрація Podʼа на віддаленому сервері зі значеннями, отриманими з Downward API за допомогою команди, подібної цій:
curl -X POST http://$MANAGEMENT_SERVICE_HOST:$MANAGEMENT_SERVICE_PORT/register -d 'instance=$(<POD_NAME>)&ip=$(<POD_IP>)'
Очікування певного часу перед запуском контейнера застосунку за допомогою команди, подібної цій:
Додавання значень у файл конфігурації та виклик інструменту шаблонування для динамічного створення файлу конфігурації для основного контейнера застосунку. Наприклад, додайте значення POD_IP у конфігурацію та створіть основний файл конфігурації застосунку за допомогою Jinja.
Init-контейнери в роботі
У цьому прикладі визначається простий Pod, який має два init-контейнери. Перший чекає на myservice, а другий — на mydb. Як тільки обидва init-контейнери завершаться, Pod запускає контейнер застосунку зі свого розділу spec.
apiVersion:v1kind:Podmetadata:name:myapp-podlabels:app.kubernetes.io/name:MyAppspec:containers:- name:myapp-containerimage:busybox:1.28command:['sh','-c','echo The app is running! && sleep 3600']initContainers:- name:init-myserviceimage:busybox:1.28command:['sh','-c',"until nslookup myservice.$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace).svc.cluster.local; do echo waiting for myservice; sleep 2; done"]- name:init-mydbimage:busybox:1.28command:['sh','-c',"until nslookup mydb.$(cat /var/run/secrets/kubernetes.io/serviceaccount/namespace).svc.cluster.local; do echo waiting for mydb; sleep 2; done"]
Ви можете запустити цей Pod, виконавши:
kubectl apply -f myapp.yaml
Вивід буде подібний до цього:
pod/myapp-pod created
І перевірте його статус за допомогою:
kubectl get -f myapp.yaml
Вивід буде подібний до цього:
NAME READY STATUS RESTARTS AGE
myapp-pod 0/1 Init:0/2 0 6m
або докладніше:
kubectl describe -f myapp.yaml
Вивід буде подібний до цього:
Name: myapp-pod
Namespace: default
[...]
Labels: app.kubernetes.io/name=MyApp
Status: Pending
[...]
Init Containers:
init-myservice:
[...]
State: Running
[...]
init-mydb:
[...]
State: Waiting
Reason: PodInitializing
Ready: False
[...]
Containers:
myapp-container:
[...]
State: Waiting
Reason: PodInitializing
Ready: False
[...]
Events:
FirstSeen LastSeen Count From SubObjectPath Type Reason Message
--------- -------- ----- ---- ------------- -------- ------ -------
16s 16s 1 {default-scheduler } Normal Scheduled Successfully assigned myapp-pod to 172.17.4.201
16s 16s 1 {kubelet 172.17.4.201} spec.initContainers{init-myservice} Normal Pulling pulling image "busybox"
13s 13s 1 {kubelet 172.17.4.201} spec.initContainers{init-myservice} Normal Pulled Successfully pulled image "busybox"
13s 13s 1 {kubelet 172.17.4.201} spec.initContainers{init-myservice} Normal Created Created container init-myservice
13s 13s 1 {kubelet 172.17.4.201} spec.initContainers{init-myservice} Normal Started Started container init-myservice
Щоб переглянути логи init-контейнерів у цьому Podʼі, виконайте:
kubectl logs myapp-pod -c init-myservice # Огляд першого init-контейнераkubectl logs myapp-pod -c init-mydb # Огляд другого init-контейнера
На цей момент ці init-контейнери будуть чекати виявлення Services з назвами mydb та myservice.
Ось конфігурація, яку ви можете використовувати для того, щоб ці Services зʼявилися:
Потім ви побачите, що ці init-контейнери завершаться, і Pod myapp-pod переходить у стан Running:
kubectl get -f myapp.yaml
Вивід буде подібний до цього:
NAME READY STATUS RESTARTS AGE
myapp-pod 1/1 Running 0 9m
Цей простий приклад повинен дати вам натхнення для створення ваших власних init-контейнерів. У розділі Що далі є посилання на більш детальний приклад.
Докладний опис поведінки
Під час запуску Podʼа kubelet затримує виконання init-контейнерів, доки мережа та сховище не будуть готові. Після цього kubelet виконує init-контейнери Podʼа в порядку, в якому вони зазначені в специфікації Podʼа.
Кожен init-контейнер має успішно завершитися перед тим, як буде запущений наступний контейнер. Якщо контейнер не вдалося запустити через помилку середовища виконання або він завершується з помилкою, його перезапускають згідно з політикою перезапуску Podʼа (restartPolicy). Однак якщо політика перезапуску Podʼа (restartPolicy) встановлена на Always, init-контейнери використовують політику перезапуску OnFailure.
Pod не може бути Ready, поки всі init-контейнери не завершаться успішно. Порти init-контейнерів не агрегуються в Service. Pod, що ініціалізується, перебуває в стані Pending, але повинен мати умову Initialized, встановлену на false.
Якщо Pod перезапускається або був перезапущений, всі init-контейнери мають виконатися знову.
Зміни в специфікації init-контейнерів обмежуються полем образу контейнера. Безпосередня зміна поля image init-контейнера не призводить до перезапуску Podʼа або його перестворення. Якщо Pod ще не було запущено, ці зміни можуть вплинути на те, як він завантажиться.
Для шаблону Podʼа ви зазвичай можете змінити будь-яке поле init-контейнера; наслідки цієї зміни залежать від того, де використовується шаблон Podʼа.
Оскільки init-контейнери можуть бути перезапущені, повторно виконані або виконані заново, код init-контейнерів повинен бути ідемпотентним. Зокрема, код, що записує дані в будь-який том emptyDir, має бути підготовлений до того, що файл виводу вже може існувати.
Init-контейнери мають усі поля контейнера застосунку. Проте Kubernetes забороняє використання readinessProbe, оскільки init-контейнери не можуть визначати готовність окремо від завершення. Це забезпечується під час валідації.
Використовуйте activeDeadlineSeconds в Podʼі, щоб запобігти нескінченним збоям init-контейнерів. Активний крайній термін охоплює init-контейнери. Однак рекомендується використовувати activeDeadlineSeconds лише якщо команди розгортають свій застосунок як Job, оскільки activeDeadlineSeconds впливає навіть після завершення роботи init-контейнера. Pod, який вже працює правильно, буде завершено через activeDeadlineSeconds, якщо ви його налаштуєте.
Назва кожного контейнера застосунку та init-контейнера в Podʼі має бути унікальною; для контейнера, назва якого збігається з назвою іншого, буде згенеровано помилку валідації.
Спільне використання ресурсів всередині контейнерів
З урахуванням порядку виконання init-контейнерів, sidecar-контейнерів і контейнерів застосунків застосовуються такі правила
використання ресурсів:
Найвищий запит чи обмеження будь-якого конкретного ресурсу, визначеного у всіх init-контейнерах, вважається ефективним запитом/обмеженням ініціалізації. Якщо для будь-якого ресурсу не вказано обмеження, це вважається найвищим обмеженням.
Ефективний запит/обмеження Podʼа для ресурсу — це більше з:
суми запитів/обмежень усіх контейнерів застосунків для ресурсу
ефективного запиту/обмеження ініціалізації для ресурсу
Планування виконується на основі ефективних запитів/обмежень, що означає, що init-контейнери можуть резервувати ресурси для ініціалізації, які не використовуються протягом життя Podʼа.
Рівень якості обслуговування (QoS), ефективний рівень QoS Podʼа, — це рівень QoS як для init-контейнерів, так і для контейнерів застосунків.
Квоти та обмеження застосовуються на основі ефективного запиту та обмеження Podʼа.
Init-контейнери та cgroups Linux
У Linux розподіл ресурсів для контрольних груп (cgroups) рівня Podʼа ґрунтується на ефективному запиті та обмеженні Podʼа, так само як і для планувальника.
Причини перезапуску Podʼа
Pod може перезапускатися, що призводить до повторного виконання init-контейнерів, з таких причин:
Перезапускається контейнер інфраструктури Podʼа. Це трапляється рідко, і це мав би зробити хтось із root-доступом до вузлів.
Всі контейнери в Podʼі завершуються, коли restartPolicy встановлено в Always, що примушує до перезапуску, а запис про завершення init-контейнера було втрачено через збір сміття.
Pod не буде перезапущено, коли змінюється образ init-контейнера, або запис про завершення init-контейнера було втрачено через збір сміття. Це стосується Kubernetes v1.20 і пізніших версій. Якщо ви використовуєте старішу версію Kubernetes, ознайомтеся з документацією версії, яку ви використовуєте.
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate SidecarContainers, Kubernetes ignores it but does not report any error.
Sidecar-контейнери — це додаткові контейнери, які працюють разом з основним контейнером застосунку всередині одного Podʼа. Ці контейнери використовуються для розширення чи покращення функціональності основного контейнера застосунку, надаючи додаткові сервіси чи функціональність, таку як логування, моніторинг, безпеку або синхронізацію даних, не змінюючи безпосередньо код основного застосунку.
Зазвичай в одному Podʼі є лише один контейнер застосунку. Наприклад, якщо у вас є вебзастосунок, який потребує локального вебсервера, локальний вебсервер буде sidecar-контейнером, а сам вебзастосунок — це контейнер застосунку.
Sidecar-контейнери в Kubernetes
Kubernetes реалізує sidecar-контейнери як особливий випадок init-контейнерів; sidecar-контейнери залишаються запущеними після запуску Podʼа. У цьому документі термін звичайні init-контейнери використовується для чіткого посилання на контейнери, які працюють лише під час запуску Podʼа.
За умови, що у вашому кластері увімкнено функціональну можливість SidecarContainers (стандартно активна починаючи з Kubernetes v1.29), ви можете вказати restartPolicy для контейнерів, вказаних у полі initContainers Podʼа. Ці sidecar-контейнери, які перезапускаються, є незалежними від інших init-контейнерів та від основних контейнерів застосунку у тому ж Podʼі, і можуть бути запущені, зупинені або перезапущені без впливу на основний контейнер застосунку та інші init-контейнери.
Ви також можете запустити Pod із декількома контейнерами, які не позначені як init-контейнери або sidecar. Це доцільно, якщо контейнери в межах Podʼа необхідні для його роботи в цілому, але вам не потрібно керувати тим, які контейнери спочатку запускаються або зупиняються. Ви також можете це зробити, якщо вам потрібно підтримувати старі версії Kubernetes, які не підтримують поле restartPolicy на рівні контейнера.
Приклад застосунку
Нижче наведено приклад Deployment з двома контейнерами, один з яких є sidecar:
Примітка:
У цьому прикладі sidecar-контейнер навмисно визначений в initContainers з restartPolicy: Always. Kubernetes розглядає такі контейнери як sidecar-контейнери, які продовжують працювати впродовж усього терміну існування Podʼа.
apiVersion:apps/v1kind:Deploymentmetadata:name:myapplabels:app:myappspec:replicas:1selector:matchLabels:app:myapptemplate:metadata:labels:app:myappspec:containers:- name:myappimage:alpine:latestcommand:['sh','-c','while true; do echo "logging" >> /opt/logs.txt; sleep 1; done']volumeMounts:- name:datamountPath:/optinitContainers:- name:logshipperimage:alpine:latest# Setting restartPolicy: Always makes this a sidecar container.restartPolicy:Alwayscommand:['sh','-c','tail -F /opt/logs.txt']volumeMounts:- name:datamountPath:/optvolumes:- name:dataemptyDir:{}
Sidecar-контейнери та життєвий цикл Podʼа
Якщо init-контейнер створено з параметром restartPolicy, встановленим на Always, він розпочне роботу і залишиться запущеним протягом усього життя Podʼа. Це може бути корисно для запуску допоміжних сервісів, відокремлених від основних контейнерів застосунку.
Якщо для цього init-контейнера вказано readinessProbe, результат буде використовуватися для визначення стану ready Podʼа.
Оскільки ці контейнери визначені як init-контейнери, вони користуються тими самими гарантіями порядку та послідовності, що й звичайні init-контейнери, що дозволяє змішувати sidecar-контейнери зі звичайними init-контейнерами у складних потоках ініціалізації Podʼа.
Порівняно зі звичайними init-контейнерами, sidecar-контейнери, визначені в initContainers, продовжують роботу після їх запуску. Це важливо, коли в .spec.initContainers для Podʼа є більше одного запису. Після запуску init-контейнера типу sidecar (kubelet встановлює статус started для цього контейнера в true), kubelet запускає наступний init-контейнер з упорядкованого списку .spec.initContainers. Цей статус стає true через те, що в контейнері працює процес і немає визначеного startupProbe, або внаслідок успішного виконання startupProbe.
Під час завершення роботи Podʼа kubelet відкладає завершення sidecar-контейнерів до повної зупинки основного контейнера застосунку. Після цього sidecar-контейнери вимикаються у порядку, протилежному порядку їх появи у специфікації Podʼа. Такий підхід гарантує, що sidecar-контейнери залишаються в робочому стані, підтримуючи інші контейнери в Podʼі, до тих пір, поки їх обслуговування більше не буде потрібне.
Jobs із sidecar-контейнерами
Якщо ви визначаєте Job, який використовує sidecar у вигляді init-контейнерів у стилі Kubernetes, sidecar-контейнер у кожному Podʼі не заважає завершенню Job після завершення основного контейнера.
Ось приклад Job із двома контейнерами, один з яких — це sidecar-контейнер:
apiVersion:batch/v1kind:Jobmetadata:name:myjobspec:template:spec:containers:- name:myjobimage:alpine:latestcommand:['sh','-c','echo "logging" > /opt/logs.txt']volumeMounts:- name:datamountPath:/optinitContainers:- name:logshipperimage:alpine:latest# Setting restartPolicy: Always makes this a sidecar container.restartPolicy:Alwayscommand:['sh','-c','tail -F /opt/logs.txt']volumeMounts:- name:datamountPath:/optrestartPolicy:Nevervolumes:- name:dataemptyDir:{}
Відмінності від контейнерів застосунків
Sidecar-контейнери працюють поруч з контейнерами застосунку в одному Podʼі. Однак вони не виконують основну логіку застосунку; замість цього вони надають допоміжну функціональність основному застосунку.
Sidecar-контейнери мають власні незалежні життєві цикли. Їх можна запускати, зупиняти та перезапускати незалежно від контейнерів застосунку. Це означає, що ви можете оновлювати, масштабувати чи обслуговувати sidecar-контейнери, не впливаючи на основний застосунок.
Sidecar-контейнери спільно використовують з основним контейнером ті самі простори імен мережі та сховища. Це спільне розташування дозволяє їм тісно взаємодіяти та спільно використовувати ресурси.
З погляду Kubernetes коректне завершення sidecar-контейнера є менш важливим. Якщо інші контейнери використали весь виділений час для коректного завершення роботи, то sidecar-контейнери отримають сигнал SIGTERM, а потім SIGKILL, перш ніж вони встигнуть коректно завершити роботу. Отже, коди виходу, відмінні від 0 (0 означає успішний вихід), для sidecar-контейнерів є нормальним явищем під час завершення роботи Podʼа, і зовнішні інструменти зазвичай мають їх ігнорувати.
Відмінності від init-контейнерів
Sidecar-контейнери працюють поруч з основним контейнером, розширюючи його функціональність та надаючи додаткові сервіси.
Sidecar-контейнери працюють паралельно з основним контейнером застосунку. Вони активні протягом усього життєвого циклу Podʼа та можуть бути запущені та зупинені незалежно від основного контейнера. На відміну від init-контейнерів, sidecar-контейнери підтримують проби, щоб контролювати їхній життєвий цикл.
Sidecar-контейнери можуть взаємодіяти безпосередньо з основними контейнерами застосунків, оскільки вони, так само як і init-контейнери, завжди спільно використовують ту саму мережу і за бажанням також можуть спільно використовувати томи (файлові системи).
Init-контейнери зупиняються до того, як основний контейнер застосунку розпочне роботу, тож init-контейнер не може обмінюватись повідомленнями з контейнером застосунку в Podʼі. Будь-які дані передаються лише в один бік (наприклад, init-контейнер може залишити інформацію у томі emptyDir).
Зміна образу sidecar-контейнера не призведе до перезапуску Podʼа, але спровокує перезапуск контейнера.
Спільне використання ресурсів всередині контейнерів
З урахуванням порядку виконання init-контейнерів, sidecar-контейнерів і контейнерів застосунків застосовуються такі правила використання ресурсів:
Найвищий запит чи обмеження будь-якого конкретного ресурсу, визначеного у всіх init-контейнерах, вважається ефективним запитом/обмеженням ініціалізації. Якщо для будь-якого ресурсу не вказано обмеження, це вважається найвищим обмеженням.
Ефективний запит/обмеження Podʼа для ресурсу — це сума накладних витрат Podʼа та більшого з:
суми запитів/обмежень усіх контейнерів, що не є init-контейнерами (контейнерів застосунків і sidecar-контейнерів), для ресурсу
ефективного запиту/обмеження ініціалізації для ресурсу
Планування виконується на основі ефективних запитів/обмежень, що означає, що init-контейнери можуть резервувати ресурси для ініціалізації, які не використовуються протягом життя Podʼа.
Рівень якості обслуговування (QoS), ефективний рівень QoS Podʼа, — це рівень QoS для всіх init-контейнерів, sidecar-контейнерів і контейнерів застосунків.
Квоти та обмеження застосовуються на основі ефективного запиту та обмеження Podʼа.
Sidecar-контейнери та cgroups Linux
У Linux розподіл ресурсів для контрольних груп (cgroups) рівня Podʼа ґрунтується на ефективному запиті та обмеженні Podʼа, так само як і для планувальника.
Ця сторінка надає огляд ефемерних контейнерів: особливого типу контейнера, який працює тимчасово в наявному Pod для виконання дій, ініційованих користувачем, таких як усунення несправностей. Ефемерні контейнери використовуються для огляду сервісів, а не для створення застосунків.
Розуміння ефемерних контейнерів
Podʼи є фундаментальним елементом застосунків Kubernetes. Оскільки Podʼи призначені бути одноразовими та замінними, ви не можете додати контейнер до Podʼа після його створення. Замість цього ви зазвичай видаляєте та замінюєте Podʼи у контрольований спосіб, використовуючи Deployments.
Іноді, однак, необхідно оглянути стан наявного Podʼа, наприклад, для усунення несправностей, коли важко відтворити помилку. У цих випадках ви можете запустити ефемерний контейнер у наявному Podʼі, щоб оглянути його стан та виконати довільні команди.
Що таке ефемерний контейнер?
Ефемерні контейнери відрізняються від інших контейнерів тим, що вони не мають гарантій щодо ресурсів або виконання, і їх ніколи автоматично не перезапускають, тому вони не підходять для створення застосунків. Ефемерні контейнери описуються за допомогою того самого ContainerSpec, що й звичайні контейнери, але багато полів несумісні та заборонені для ефемерних контейнерів.
В ефемерних контейнерів не може бути портів, тому такі поля, як ports, livenessProbe, readinessProbe, заборонені.
Виділення ресурсів для Podʼа незмінне, тому встановлення resources заборонене.
Ефемерні контейнери створюються за допомогою спеціального обробника ephemeralcontainers в API замість того, щоб додавати їх безпосередньо до pod.spec, тому не можна додати ефемерний контейнер за допомогою kubectl edit.
Як і звичайний контейнер, ефемерний контейнер не можна змінити або видалити після додавання до Podʼа.
Ефемерні контейнери корисні для інтерактивного усунення несправностей, коли kubectl exec недостатній, оскільки контейнер зазнав збою або образ контейнера не містить засобів налагодження.
Зокрема, образи distroless дозволяють вам розгортати мінімальні образи контейнерів, які зменшують поверхню атаки та вплив помилок і вразливостей. Оскільки образи distroless не включають оболонку або будь-які засоби налагодження, складно налагоджувати образи distroless, використовуючи лише kubectl exec.
6.4.1.6 - Проби життєздатності, готовності та запуску
Kubernetes дозволяє визначати проби для безперервного моніторингу стану контейнерів у Podʼі. Проба — це діагностична перевірка контейнера, яку періодично виконує kubelet. Для виконання діагностики kubelet або виконує код всередині контейнера, або робить мережевий запит.
На основі результатів проб Kubernetes може перезапускати несправні контейнери або припиняти надсилання трафіку до контейнерів, які не готові.
Типи проб
Kubelet може за потреби виконувати три види проб у запущених контейнерах і реагувати на їхні результати; кожна з них має власне призначення:
Проби запуску перевіряють, чи застосунок у контейнері запущено. Якщо проба запуску налаштована, Kubernetes не виконує проби життєздатності або готовності, поки проба запуску не буде успішною, що дозволяє застосунку завершити ініціалізацію.
Цей тип проб виконується лише під час запуску, на відміну від проб життєздатності та готовності, які виконуються періодично. Якщо проба запуску завершується невдало, kubelet завершує контейнер, і до нього застосовується його політика перезапуску.
Проба життєздатності
Проби життєздатності (Liveness) визначають, коли слід перезапустити контейнер. Наприклад, проби життєздатності можуть виявити ситуацію взаємного блокування, коли застосунок працює, але не може просуватися далі. Перезапуск контейнера в такому стані допомагає забезпечити більшу доступність застосунку, незважаючи на наявність помилок.
Якщо контейнеру не вдається пройти пробу життєздатності більше разів, ніж передбачено налаштованим порогом, kubelet перезапускає контейнер. Проби життєздатності не чекають, поки проби готовності будуть успішними. Якщо ви хочете почекати перед виконанням проби життєздатності, ви можете визначити initialDelaySeconds або використовувати пробу запуску.
Увага:
Проби життєздатності можуть бути ефективним засобом відновлення після збоїв у роботі застосунків, проте їх слід застосовувати з обережністю. Проби життєздатності необхідно ретельно налаштовувати, щоб гарантувати, що вони дійсно вказують на незворотний збій у роботі застосунку, наприклад, на взаємне блокування.
Неправильна реалізація проб життєздатності може призвести до каскадних збоїв. Це призводить до перезапуску контейнера під високим навантаженням; невдалих запитів клієнтів, оскільки ваш застосунок стає менш масштабованим; та збільшення навантаження на решту Podʼів через кілька несправних Podʼів. Потрібно розуміти різницю між пробами життєздатності та пробами готовності, а також коли їх застосовувати для вашого застосунку.
Проба готовності
Проби готовності визначають, коли контейнер готовий приймати трафік. Вони корисні, коли застосунок очікує на виконання трудомістких початкових завдань, таких як встановлення мережевих зʼєднань, завантаження файлів і наповнення кешу. Проби готовності також можуть бути корисними на більш пізніх етапах життєвого циклу контейнера, наприклад, під час відновлення після тимчасових збоїв або перевантажень.
Якщо проба готовності повертає неуспішний стан, контролер EndpointSlice видаляє IP-адресу Podʼа з EndpointSlices усіх Services, що відповідають цьому Podʼу.
Проби готовності виконуються в контейнері протягом всього його життєвого циклу.
Примітка:
Якщо ви хочете мати можливість завершувати обробку запитів під час видалення Podʼа, вам не обовʼязково потрібна проба готовності; коли Pod видаляється, відповідна точка доступу в EndpointSlice оновить свої стани: стан готовності точки доступу буде встановлено на false, тому балансувальники навантаження не використовуватимуть Pod для звичайного трафіку. Дивіться Завершення роботи Podʼа для отримання додаткової інформації про те, як kubelet обробляє видалення Podʼа.
Коли використовувати кожну пробу
Коли слід використовувати пробу запуску?
Проби запуску корисні для Podʼів, які мають контейнери, що довго запускаються. Замість того, щоб встановлювати довгий інтервал життєздатності, ви можете налаштувати окрему конфігурацію для перевірки контейнера під час його запуску, що дає більше часу, ніж дозволив би інтервал життєздатності.
Якщо ваш контейнер зазвичай запускається більше ніж \( initialDelaySeconds + failureThreshold \times periodSeconds \), слід вказати пробу запуску, яка перевіряє ту саму точку доступу, що й проба життєздатності. Стандартне значення для periodSeconds становить 10 секунд. Потім слід встановити failureThreshold достатньо високим, щоб дозволити контейнеру запуститися, не змінюючи стандартне значення для проби життєздатності. Це допомагає захиститися від взаємних блокувань.
Коли слід використовувати пробу життєздатності?
Якщо процес у вашому контейнері може самостійно аварійно завершуватися, щойно виникає проблема або він стає несправним, вам не обовʼязково потрібна проба життєздатності; kubelet автоматично виконає правильну дію відповідно до restartPolicy Podʼа.
Якщо ви хочете, щоб ваш контейнер був завершений і перезапущений у разі невдачі проби, тоді використовуйте пробу життєздатності та встановіть restartPolicy на Always або OnFailure.
Поширеним підходом для проб життєздатності є використання тієї самої низьковитратної точки доступу HTTP, що й для проб готовності, але з вищим failureThreshold. Це гарантує, що Pod вважатиметься неготовим протягом певного часу, перш ніж його буде примусово завершено.
Коли слід використовувати пробу готовності?
Щоб почати надсилати трафік до Podʼа лише після успішного проходження проби, вкажіть пробу готовності. Проба готовності може бути такою ж, як і проба життєздатності, але наявність проби готовності в специфікації означає, що Pod почне працювати без отримання трафіку і почне отримувати трафік лише після того, як проба почне успішно проходити.
Ви також можете використовувати пробу готовності, щоб дозволити контейнеру самостійно зупинятися для обслуговування, перевіряючи точку доступу, специфічну для проби готовності, яка відрізняється від проби життєздатності.
Коли ваш застосунок має строгі залежності від бекенд-сервісів, ви можете реалізувати як пробу життєздатності, так і пробу готовності. Проба життєздатності проходить, коли сам застосунок є справним, але проба готовності додатково перевіряє, чи доступний кожен необхідний бекенд-сервіс. Це допомагає уникнути направлення трафіку до Podʼів, які можуть відповідати лише повідомленнями про помилки.
Для контейнерів, яким під час запуску потрібно завантажувати великі обсяги даних, конфігураційні файли або виконувати міграції, розгляньте можливість використання проби запуску. Однак, якщо ви хочете визначити різницю між застосунком, який зазнав невдачі, і застосунком, який все ще обробляє свої стартові дані, можливо, вам більше підійде проба готовності.
Механізми перевірки
Існує чотири різні способи перевірки контейнера за допомогою проб. Кожна проба повинна визначати точно один із цих чотирьох механізмів:
exec
Виконує вказану команду всередині контейнера. Діагностика вважається успішною, якщо команда завершується з кодом стану 0.
grpc
Виконує віддалений виклик процедури за допомогою gRPC. Цільовий обʼєкт повинен реалізовувати перевірки стану gRPC. Діагностика вважається успішною, якщо status відповіді дорівнює SERVING. Для отримання додаткової інформації див. gRPC-проби.
httpGet
Виконує запит HTTP GET до IP-адреси Podʼа на вказаному порту та шляху. Діагностика вважається успішною, якщо відповідь має код стану від 200 до 399 включно. Для отримання додаткової інформації див. HTTP-проби.
tcpSocket
Виконує перевірку TCP на IP-адресу Podʼа на вказаному порту. Діагностика вважається успішною, якщо порт відкритий. Якщо віддалена система (контейнер) закриває зʼєднання відразу після його відкриття, це також вважається справним станом. Для отримання додаткової інформації див. TCP-проби.
Увага:
На відміну від інших механізмів, реалізація проби exec передбачає створення/відгалуження кількох процесів під час кожного виконання. В результаті, у випадку кластерів з високою щільністю Podʼів, меншими інтервалами initialDelaySeconds, periodSeconds, налаштування будь-якої проби з механізмом exec може призвести до збільшення навантаження на CPU вузла. У таких сценаріях розгляньте можливість використання альтернативних механізмів проб, щоб уникнути цих накладних витрат.
Результати проб
Kubelet оцінює результат виконання кожної проби та діє відповідно. Кожна проба має один із трьох результатів:
Success
Контейнер пройшов діагностику.
Failure
Контейнер не пройшов діагностику. Для проб життєздатності та запуску kubelet завершує контейнер, і до нього застосовується його політика перезапуску. Для проб готовності kubelet позначає контейнер як неготовий, і Pod перестає отримувати трафік від відповідних Services.
Unknown
Діагностика не вдалася (жодних дій не слід виконувати, kubelet здійснить подальші перевірки).
Якщо контейнер не надає певну пробу, kubelet завжди вважає результат Success. Для проб готовності, зокрема, результат вважається Failure до закінчення початкової затримки.
Поля конфігурації
Проби мають ряд полів, які можна використовувати для більш точного контролю поведінки перевірок запуску, життєздатності та готовності. Наприклад:
Кількість секунд після запуску контейнера, перш ніж будуть ініційовані проби запуску, життєздатності або готовності. Якщо визначена проба запуску, затримки проб життєздатності та готовності не починаються, поки проба запуску не буде успішною. У деяких старих версіях Kubernetes initialDelaySeconds може ігноруватися, якщо periodSeconds було встановлено на значення більше, ніж initialDelaySeconds. Однак у поточних версіях initialDelaySeconds завжди враховується, і проба не почнеться до закінчення цієї початкової затримки. Стандартне значення — 0 секунд. Мінімальне значення — 0.
periodSeconds
Як часто (у секундах) виконувати пробу. Стандартно — 10 секунд. Мінімальне значення — 1. Поки контейнер не готовий, проба готовності може виконуватися в інший час, ніж налаштований інтервал periodSeconds. Це робиться для того, щоб Pod став готовим швидше.
timeoutSeconds
Кількість секунд, після яких проба вважається такою, що перевищила час очікування. Стандартне значення — 1 секунда. Мінімальне значення — 1.
successThreshold
Мінімальна кількість послідовних успішних спроб, щоб проба вважалася успішною після невдачі. Стандартне значення — 1. Для проб життєздатності та запуску має бути 1. Мінімальне значення — 1.
failureThreshold
Після того, як проба не вдалася failureThreshold разів поспіль, Kubernetes вважає, що загальна перевірка не вдалася: контейнер не готовий/справний/живий. Стандартне значення — 3. Мінімальне значення — 1. У випадку проби запуску або життєздатності, якщо принаймні failureThreshold проб не вдалося, Kubernetes вважає контейнер несправним і запускає перезапуск для цього конкретного контейнера. Kubelet дотримується налаштування terminationGracePeriodSeconds для цього контейнера. Для невдалої проби готовності kubelet продовжує виконувати контейнер, який не пройшов перевірку, і також продовжує виконувати інші проби; оскільки перевірка не вдалася, kubelet встановлює станReady для Podʼа у значення false.
terminationGracePeriodSeconds
Налаштуйте період очікування для kubelet між ініціюванням завершення роботи несправного контейнера та примусовою зупинкою цього контейнера середовищем виконання контейнерів. Стандартно успадковується значення на рівні Podʼа для terminationGracePeriodSeconds (30 секунд, якщо не вказано), а мінімальне значення — 1. Див. terminationGracePeriodSeconds на рівні проби для детальнішої інформації.
Увага:
Неправильна реалізація проб готовності може призвести до постійного зростання кількості процесів у контейнері та вичерпання ресурсів, якщо це залишити без контролю.
terminationGracePeriodSeconds на рівні проби
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.28
У версіях 1.25 і вище користувачі можуть вказати terminationGracePeriodSeconds на рівні проби як частину специфікації проби. Коли встановлені обидва значення terminationGracePeriodSeconds на рівні Podʼа і проби, kubelet використовує значення на рівні проби.
Під час встановлення terminationGracePeriodSeconds зверніть увагу на таке:
Kubelet завжди враховує поле terminationGracePeriodSeconds на рівні проби, якщо воно присутнє в Podʼі.
Якщо у вас є наявні Podʼи, де встановлено поле terminationGracePeriodSeconds, і ви більше не бажаєте використовувати періоди очікування завершення роботи на рівні проби, вам потрібно видалити ці Podʼи.
Наприклад:
spec:terminationGracePeriodSeconds:3600# рівень Podʼаcontainers:- name:testimage:...ports:- name:liveness-portcontainerPort:8080livenessProbe:httpGet:path:/healthzport:liveness-portfailureThreshold:1periodSeconds:60# Перевизначення значення terminationGracePeriodSeconds на рівні PodʼаterminationGracePeriodSeconds:60
Значення terminationGracePeriodSeconds на рівні проби не може бути встановлено для проб готовності. Воно буде відхилено API-сервером.
Деталі механізму проб
HTTP-проби
HTTP-проби мають додаткові поля, які можна встановити в httpGet:
host: Імʼя хоста для підключення, стандартно IP-адреса Podʼа. Ймовірно, ви захочете встановити "Host" у httpHeaders замість цього.
scheme: Схема для підключення до хоста (HTTP або HTTPS). Стандартно "HTTP".
path: Шлях для доступу до HTTP-сервера. Стандартно "/".
httpHeaders: Власні заголовки для встановлення в запиті. HTTP дозволяє повторювані заголовки.
port: Назва або номер порту для доступу до контейнера. Номер повинен бути в діапазоні від 1 до 65535.
protocol: Протокол для використання в запиті проби. Стандартно HTTP1. Встановіть HTTP2, щоб виконувати пробу через HTTP/2 без шифрування (h2c). Вимагає увімкнення функціональної можливостіH2CContainerProbe.
Для HTTP-проби kubelet надсилає HTTP-запит на вказаний порт і шлях для виконання перевірки. Kubelet надсилає пробу на IP-адресу Podʼа, якщо адреса не перевизначена за допомогою необовʼязкового поля host у httpGet. Якщо поле scheme встановлено в HTTPS, kubelet надсилає HTTPS-запит, пропускаючи перевірку сертифіката. У більшості сценаріїв ви не захочете встановлювати поле host. Ось один сценарій, де ви б його встановили. Припустимо, контейнер слухає на 127.0.0.1, а поле hostNetwork Podʼа встановлено в true. Тоді host у httpGet слід встановити на 127.0.0.1. Якщо ваш Pod покладається на віртуальні хости, що, ймовірно, є більш поширеним випадком, ви не повинні використовувати host, а натомість встановити заголовок Host у httpHeaders.
Для HTTP-проби kubelet надсилає два заголовки запиту на додачу до обовʼязкового заголовка Host:
User-Agent, який стандартно дорівнює kube-probe/1.37, де 1.37 — це версія kubelet.
Accept, який стандартно дорівнює */*.
Ви можете перевизначити ці заголовки, визначивши httpHeaders для проби. Наприклад:
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the H2CContainerProbe feature gate for all relevant components in your cluster.
Ви можете налаштувати HTTP-пробу для використання HTTP/2 без шифрування (h2c), встановивши поле protocol на HTTP2. Коли protocol встановлено на HTTP2, kubelet використовує h2c (HTTP/2 через звичайний TCP) замість HTTP/1.1. Типове значення protocol — HTTP1. Встановлення protocol: HTTP2 вимагає scheme: HTTP (типове значення); API-сервер відхиляє комбінацію protocol: HTTP2 з scheme: HTTPS. Для отримання додаткових відомостей див. Використання HTTP/2 без шифрування (h2c) з HTTP-пробами.
Обробка перенаправлень
Коли kubelet перевіряє контейнер за допомогою HTTP, він слідує за перенаправленнями лише у випадку, якщо перенаправлення відбувається на той самий хост. Це включає перенаправлення, які змінюють протокол з HTTP на HTTPS, навіть якщо проба налаштована з scheme: HTTP.
Якщо перенаправлення відбувається на інший хост, kubelet не слідує за ним. Замість цього kubelet вважає пробу успішною і записує подію ProbeWarning.
Якщо kubelet слідує за перенаправленням і отримує 11 або більше перенаправлень загалом, проба вважається успішною і записується подія ProbeWarning. Наприклад:
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 29m default-scheduler Successfully assigned default/httpbin-7b8bc9cb85-bjzwn to daocloud
Normal Pulling 29m kubelet Pulling image "docker.io/kennethreitz/httpbin"
Normal Pulled 24m kubelet Successfully pulled image "docker.io/kennethreitz/httpbin" in 5m12.402735213s
Normal Created 24m kubelet Created container httpbin
Normal Started 24m kubelet Started container httpbin
Warning ProbeWarning 4m11s (x1197 over 24m) kubelet Readiness probe warning: Probe terminated redirects
Увага:
Під час обробки проби httpGet kubelet припиняє читання тіла відповіді після 10KiB. Успішність проби визначається виключно кодом стану відповіді, який знаходиться в заголовках відповіді.
Якщо ви перевіряєте точку доступу, що повертає тіло відповіді більше ніж 10KiB, kubelet все одно позначить пробу як успішну на основі коду стану, але закриє зʼєднання після досягнення межі 10KiB. Це раптове закриття може спричинити появу в логах вашого застосунку помилок connection reset by peer або broken pipe errors, які важко відрізнити від реальних проблем мережі.
Для надійних проб httpGet наполегливо рекомендується використовувати спеціальні точки доступу перевірки стану, які повертають мінімальне тіло відповіді. Якщо ви повинні використовувати наявну точку доступу з великим обсягом даних, розгляньте можливість використання проби exec для виконання запиту HEAD замість цього.
TCP-проби
Для TCP-проби kubelet встановлює зʼєднання проби на вузлі, а не в Podʼі, що означає, що ви не можете використовувати назву сервісу в параметрі host, оскільки kubelet не може її розвʼязати.
gRPC-проби
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.27
Якщо ваш застосунок реалізує Протокол перевірки стану gRPC, ви можете налаштувати Kubernetes для використання його для перевірки запуску, життєздатності або готовності застосунку.
Для використання gRPC-проби необхідно налаштувати port. Якщо ви хочете розрізняти проби різних типів і проби для різних функцій, ви можете використовувати поле service. Ви можете встановити service зі значенням liveness і налаштувати вашу точку доступу gRPC Health Checking так, щоб вона відповідала на цей запит інакше, ніж коли service має значення readiness. Це дозволяє використовувати ту саму точку доступу для різних видів перевірки стану контейнера, замість того щоб слухати на двох різних портах. Якщо ви хочете вказати власну назву сервісу та також вказати тип проби, проєкт Kubernetes рекомендує використовувати назву, яка обʼєднує ці значення. Наприклад: myservice-liveness (використовуючи - як роздільник).
Примітка:
На відміну від HTTP або TCP-проб, ви не можете вказати порт перевірки стану за назвою, і ви не можете налаштувати власне імʼя хоста.
Проблеми конфігурації (наприклад: неправильний порт або сервіс, не реалізований протокол перевірки стану) вважаються невдачею проби, подібно до HTTP та TCP-проб.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GRPCContainerProbeTLS feature gate for all relevant components in your cluster.
Ви можете налаштувати gRPC-пробу для підключення через TLS, встановивши поле mode на TLS. Коли mode встановлено на TLS, kubelet використовує TLS з InsecureSkipVerify (він не перевіряє сертифікат сервера). Типове значення mode — Plaintext. Для отримання додаткових відомостей див. Використання TLS з gRPC-пробами.
Для повної специфікації полів, повʼязаних з пробами, дивіться довідку API: Pod, Container, Probe
6.4.1.7 - Порушення
Цей посібник призначений для власників застосунків, які хочуть створити високодоступні застосунки та, таким чином, повинні розуміти, які типи порушень можуть трапитися з Podʼами.
Також це стосується адміністраторів кластера, які хочуть виконувати автоматизовані дії з кластером, такі як оновлення та автомасштабування кластерів.
Добровільні та невідворотні порушення
Podʼи не зникають, поки хтось (людина або контролер) не знищить їх, або не трапиться невідворотна помилка обладнання чи системного програмного забезпечення.
Ми називаємо ці невідворотні випадки невідворотними порушеннями застосунку. Приклади:
апаратна відмова фізичної машини, на якій працює вузол
Окрім вичерпання ресурсів, усі ці ситуації мають бути знайомі більшості користувачів; вони не є специфічними для Kubernetes.
Ми називаємо інші випадки добровільними порушеннями. До них належать як дії, ініційовані власником застосунку, так і ті, які ініціює адміністратор кластера. Типові дії власника застосунку включають:
видалення Deployment або іншого контролера, який керує Podʼом
оновлення шаблону Podʼа в Deployment, що призводить до перезапуску
безпосереднє видалення Podʼа (наприклад, випадково)
Очищення вузла з кластера для зменшення масштабу кластера (дізнайтеся більше про автомасштабування вузлів).
Видалення Podʼа з вузла, щоб щось інше помістилося на цей вузол.
Ці дії можуть бути виконані безпосередньо адміністратором кластера чи за допомогою автоматизації, запущеної адміністратором кластера, або вашим провайдером хостингу кластера.
Зверніться до адміністратора кластера або проконсультуйтеся з документацією вашого хмарного провайдера або дистрибутиву, щоб визначити, чи увімкнено які-небудь джерела добровільних порушень для вашого кластера. Якщо жодне з них не увімкнено, ви можете пропустити створення бюджетів порушень Podʼів (Pod Disruption Budget).
Увага:
Не всі добровільні порушення обмежені бюджетами порушень Podʼів. Наприклад, видалення Deployment чи Pod обходить бюджети порушень Podʼів.
Робота з порушеннями
Ось кілька способів помʼякшення невідворотних порушень:
Реплікуйте свій застосунок, якщо вам потрібна вища доступність. (Дізнайтеся про запуск реплікованих stateless та stateful застосунків.)
Для ще вищої доступності під час запуску реплікованих застосунків розподіліть їх по стійках (за допомогою anti-affinity) чи по зонах (якщо використовуєте
кластер з кількома зонами.)
Частота добровільних порушень різниться. На базовому кластері Kubernetes немає автоматизованих добровільних порушень (тільки ті, які ініціює користувач). Однак адміністратор кластера або провайдер хостингу може запускати деякі додаткові сервіси, які призводять до добровільних порушень. Наприклад, розгортання оновлень програмного забезпечення вузла може призвести до добровільних порушень. Також деякі реалізації автомасштабування кластера (вузла) можуть призводити до добровільних порушень для дефрагментації та ущільнення вузлів. Адміністратор кластера або провайдер хостингу мають задокументувати, якого рівня добровільних порушень, якщо такі є, слід очікувати.
Деякі параметри конфігурації, такі як використання PriorityClasses у вашій специфікації Podʼа, також можуть призводити до добровільних (і невідворотних) порушень.
Бюджети порушень Podʼів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
Kubernetes пропонує функції, що допомагають запускати застосунки з високою доступністю навіть тоді, коли ви допускаєте часті добровільні порушення.
Як власник застосунку, ви можете створити бюджет порушень Podʼів (PodDisruptionBudget, PDB) для кожного застосунку. PDB обмежує кількість Podʼів реплікованого застосунку, які можуть одночасно не працювати через добровільні порушення. Наприклад, застосунок на основі кворуму хоче гарантувати, що кількість запущених реплік ніколи не впаде нижче необхідної для кворуму. Вебфронтенд може хотіти гарантувати, що кількість реплік, які обслуговують навантаження, ніколи не впаде нижче певного відсотка від загальної кількості.
Менеджери кластерів та провайдери хостингу повинні використовувати інструменти, які дотримуються бюджетів порушень Podʼів, викликаючи Eviction API замість прямого видалення Podʼів або Deployments.
Наприклад, команда kubectl drain дозволяє вам позначити вузол як такий, що виводиться з експлуатації. Коли ви виконуєте kubectl drain, інструмент намагається виселити всі Podʼи з вузла, який ви виводите з експлуатації. Запит на виселення, який kubectl робить від вашого імені, може тимчасово бути відхилено, тому інструмент періодично повторює всі невдалі запити, доки всі Podʼи на цільовому вузлі не будуть завершені або доки не буде досягнуто налаштованого тайм-ауту.
PDB визначає кількість реплік, яку застосунок може витримати, порівняно з тим, скільки їх має бути. Наприклад, Deployment, який має .spec.replicas: 5, повинен мати 5 Podʼів в будь-який момент часу. Якщо PDB дозволяє бути 4 Podʼам одночасно, то Eviction API дозволить добровільне порушення роботи одного (але не двох) Podʼів одночасно.
Група Podʼів, з яких складається застосунок, визначається за допомогою селектора міток, такого самого, як і той, який використовується контролером застосунку (deployment, stateful-set тощо).
"Передбачена" кількість Podʼів обчислюється з .spec.replicas ресурсу робочого навантаження, який керує цими Podʼами. Панель управління визначає ресурс робочого навантаження, що володіє Podʼом, оглядаючи .metadata.ownerReferences Podʼа.
Невідворотні порушення неможливо запобігти за допомогою PDB; однак вони враховуються в бюджеті.
Podʼи, які видаляються або недоступні через поетапне оновлення застосунку, дійсно враховуються в бюджеті порушень, але ресурси робочого навантаження (такі як Deployment і StatefulSet) не обмежуються PDB під час поетапного оновлення. Натомість обробка збоїв під час оновлення застосунку налаштовується в специфікації конкретного ресурсу робочого навантаження.
Рекомендується встановлювати політику виселення несправних PodʼівAlwaysAllow у ваших PodDisruptionBudgets для підтримки виселення застосунків, що працюють неправильно, під час очищення вузла. Стандартно очищення чекає, доки Podʼи застосунку стануть справними, перш ніж продовжитися.
Коли Pod виселяється за допомогою API виселення, він коректно завершується з урахуванням налаштування terminationGracePeriodSeconds його PodSpec.
Приклад PodDisruptionBudget
Припустимо, що у кластері є 3 вузли, від node-1 до node-3. У кластері працює кілька застосунків. Один з них має 3 репліки, які спочатку називаються pod-a, pod-b і pod-c. Також показано інший, не повʼязаний з ними Pod без PDB — pod-x. Спочатку Podʼи розташовані так:
node-1
node-2
node-3
pod-a доступний
pod-b доступний
pod-c доступний
pod-x доступний
Усі 3 Podʼи є частиною Deployment, і вони разом мають PDB, який вимагає, щоб одночасно було доступними принаймні 2 з 3 Podʼів.
Наприклад, припустимо, що адміністратор кластера хоче перезавантажитися в нову версію ядра, щоб виправити помилку в ядрі. Адміністратор кластера спочатку намагається очистити node-1 за допомогою команди kubectl drain. Цей інструмент намагається виселити pod-a і pod-x. Це вдається негайно. Обидва Podʼи одночасно переходять у стан terminating. Це переводить кластер у стан:
node-1 очищується
node-2
node-3
pod-a завершується
pod-b доступний
pod-c доступний
pod-x завершується
Deployment помічає, що один з Podʼів завершується, тому він створює заміну під назвою pod-d. Оскільки node-1 закрито для планування (cordoned), заміна опиняється на іншому вузлі. Також щось створило pod-y як заміну для pod-x.
(Примітка: для StatefulSet, pod-a, який міг би мати назву щось на зразок pod-0, повинен був би повністю завершити свою роботу,
перш ніж його заміна, яка також має назву pod-0, але має інший UID, може бути створена. В іншому випадку приклад застосовується і до StatefulSet.)
Тепер кластер перебуває у такому стані:
node-1 очищується
node-2
node-3
pod-a завершується
pod-b доступний
pod-c доступний
pod-x завершується
pod-d запускається
pod-y
У якийсь момент Podʼи завершують свою роботу, і кластер виглядає так:
node-1 очищений
node-2
node-3
pod-b доступний
pod-c доступний
pod-d запускається
pod-y
На цьому етапі, якщо нетерплячий адміністратор кластера намагається очистити node-2 або node-3, команда очищення буде заблокована, оскільки доступно тільки 2 Podʼи для Deployment, і його PDB вимагає принаймні 2. Після того, як пройде певний час, pod-d стає доступним.
Тепер стан кластера виглядає так:
node-1 очищений
node-2
node-3
pod-b доступний
pod-c доступний
pod-d доступний
pod-y
Тепер адміністратор кластера намагається очистити node-2. Команда drain спробує виселити два Podʼи в певному порядку, скажімо, спочатку pod-b, а потім pod-d. Їй вдасться виселити pod-b. Але коли вона спробує виселити pod-d, то отримає відмову, через те, що це залишить тільки один доступний Pod для Deployment.
Deployment створює заміну для pod-b з назвою pod-e. Оскільки в кластері недостатньо ресурсів для планування pod-e, очищення знову буде заблоковано. Кластер може опинитися в такому стані:
node-1 очищений
node-2
node-3
немає вузла
pod-b завершується
pod-c доступний
pod-e очікує
pod-d доступний
pod-y
На цьому етапі адміністратор кластера повинен додати вузол назад до кластера, щоб продовжити оновлення.
Ви можете побачити, як Kubernetes змінює частоту випадків порушень відповідно до:
скільки реплік потрібно для застосунку
скільки часу потрібно для коректного вимкнення екземпляра
скільки часу потрібно для запуску нового екземпляра
типу контролера
місткості ресурсів кластера
Стани порушення роботи Podʼа
This is a stable feature in Kubernetes, and has been since the 1.31 release. You can no longer toggle this feature (the associated feature gate has been removed).
Спеціальний стан Podʼа DisruptionTarget додається для того, щоб вказати, що Pod буде видалено через порушення. Поле reason цього стану додатково вказує одну з таких причин завершення Podʼа:
Pod має бути видалений Менеджером Taint (який є частиною контролера життєвого циклу вузла в kube-controller-manager) через NoExecute taint, який Pod не толерує; див. виселення на основі taint.
У всіх інших сценаріях порушення, таких як виселення через перевищення обмежень контейнерів Podʼа, Podʼи не отримують стан DisruptionTarget, оскільки ці порушення, ймовірно, були спричинені самим Podʼом і повторилися б під час повторної спроби.
Примітка:
Процес порушення роботи Podʼа може бути зупинено. Панель управління може повторно спробувати продовжити порушення роботи того самого Podʼа, але це не гарантовано. В результаті стан DisruptionTarget може бути додано до Podʼа, але цей Pod може фактично не бути видаленим. У такій ситуації через деякий час стан порушення роботи Podʼа буде очищено.
Разом з очищенням Podʼів механізм збору сміття Podʼів (PodGC) також позначає їх як невдалі, якщо вони перебувають у нетермінальній фазі (див. також збір сміття Podʼів).
Під час використання Job (або CronJob) ви можете використовувати ці стани порушення роботи Podʼів як частину політики збоїв Podʼа вашого Job.
Розділення ролей власника кластера та власника застосунку
Часто корисно розглядати менеджера кластера і власника застосунку як окремі ролі з обмеженим знанням одне про одного. Це розділення обовʼязків може мати сенс у таких сценаріях:
коли багато команд розробки застосунків використовують спільний кластер Kubernetes і є природна спеціалізація ролей
коли використовуються інструменти або сервіси сторонніх розробників для автоматизації управління кластером
Бюджети порушень Podʼів підтримують це розділення ролей, надаючи
інтерфейс між цими ролями.
Якщо у вашій організації немає такого розділення обовʼязків,
вам може не знадобитися використовувати бюджети порушень Podʼів.
Як виконувати дії, що порушують роботу, у вашому кластері
Якщо ви є адміністратором кластера і вам потрібно виконати дію, що порушує роботу, на всіх вузлах вашого кластера, таку як оновлення вузла чи системного програмного забезпечення, ось кілька варіантів:
Прийняти простій під час оновлення.
Перемикнутися на іншу повну репліку кластера.
Відсутність простою, але може бути дорогою як для дубльованих вузлів, так і для зусиль людей для оркестрування перемикання.
Розробляти застосунки, стійкі до порушень, і використовувати PDB.
Відсутність простою.
Мінімальне дублювання ресурсів.
Дозволяє більше автоматизації адміністрування кластера.
Написання застосунків, стійких до порушень, складне, але робота над стійкістю до добровільних порушень здебільшого збігається з роботою над підтримкою автомасштабування та стійкістю до невідворотних порушень.
Дізнайтеся про оновлення Deployment, включаючи кроки для забезпечення його доступності під час розгортання.
6.4.1.8 - Імʼя хоста Podʼа
Ця сторінка пояснює, як встановити імʼя хоста Podʼа, можливі побічні ефекти після налаштування та механізми, що лежать в основі.
Стандартне імʼя хоста Podʼа
Коли створюється Pod, імʼя його хоста (яке спостерігається зсередини Podʼа) походить від значення metadata.name Podʼа. І імʼя хоста, і відповідне повністю кваліфіковане доменне імʼя (FQDN) встановлюються у значення metadata.name (з точки зору Podʼа)
Pod, створений цим маніфестом, матиме імʼя хоста та повністю кваліфіковане доменне імʼя (FQDN) встановлені як busybox-1.
Імʼя хоста з полями hostname та subdomain Podʼа
Специфікація Podʼа включає необовʼязкове поле hostname. Коли воно встановлене, це значення має пріоритет над metadata.name Podʼа як імʼя хоста (яке спостерігається зсередини Podʼа). Наприклад, Pod з spec.hostname встановленим як my-host матиме імʼя хоста встановлене як my-host.
Специфікація Podʼа також включає необовʼязкове поле subdomain, яке вказує, що Pod належить до піддомену в межах свого простору імен. Якщо Pod має spec.hostname встановлений як "foo" і spec.subdomain встановлений як "bar" у просторі імен my-namespace, імʼя його хоста стає foo, а його повністю кваліфіковане доменне імʼя (FQDN) стає foo.bar.my-namespace.svc.cluster-domain.example (спостерігається зсередини Podʼа).
Коли встановлені і hostname, і subdomain, DNS-сервер кластера створить записи A та/або AAAA на основі цих полів. Дивіться: Поля hostname та subdomain Podʼа.
Імʼя хоста з полем setHostnameAsFQDN Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.22
Коли Pod налаштований на використання повністю кваліфікованого доменного імені (FQDN), його імʼя хоста є коротким імʼям хоста. Наприклад, якщо у вас є Pod з повністю кваліфікованим доменним імʼям busybox-1.busybox-subdomain.my-namespace.svc.cluster-domain.example, то стандартно команда hostname всередині цього Podʼа повертає busybox-1, а команда hostname --fqdn повертає FQDN.
Коли в специфікації Podʼа встановлено і setHostnameAsFQDN: true, і поле subdomain, kubelet записує FQDN Podʼа як імʼя хоста для простору імен цього Podʼа. У цьому випадку і hostname, і hostname --fqdn повертають FQDN Podʼа.
FQDN Podʼа будується так само, як було визначено раніше. Воно складається з поля spec.hostname Podʼа (якщо вказано) або поля metadata.name, spec.subdomain, назви простору імен та суфікса домену кластера.
Примітка:
У Linux поле імені хоста ядра (поле nodename структури utsname) обмежено 64 символами.
Якщо Pod вмикає цю функцію, а його FQDN довший за 64 символи, він не зможе запуститися. Pod залишатиметься в статусі Pending (відображається як ContainerCreating через kubectl), генеруючи події помилок, такі як "Failed to construct FQDN from Pod hostname and cluster domain".
Це означає, що під час використання цього поля ви повинні переконатися, що сумарна довжина полів metadata.name (або spec.hostname) та spec.subdomain Podʼа не призводить до появи FQDN, що перевищує 64 символи.
Імʼя хоста з полем hostnameOverride Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.37. It was first available in the v1.34 release.
Встановлення значення для hostnameOverride в специфікації Podʼа змушує kubelet безумовно встановлювати як імʼя хоста, так і повністю кваліфіковане доменне імʼя (FQDN) Podʼа у значення hostnameOverride.
Поле hostnameOverride має обмеження довжини 64 символи і повинно відповідати стандарту імен піддоменів DNS, визначеному в RFC 1123.
Це впливає лише на імʼя хоста всередині Podʼа; це не впливає на записи A або AAAA Podʼа в DNS-сервері кластера.
Якщо hostnameOverride встановлено разом з полями hostname та subdomain:
Імʼя хоста всередині Podʼа перевизначається значенням hostnameOverride.
Записи A та/або AAAA Podʼа в DNS-сервері кластера все ще генеруються на основі полів hostname та subdomain.
Примітка: Якщо встановлено hostnameOverride, ви не можете одночасно встановлювати поля hostNetwork та setHostnameAsFQDN. API-сервер явно відхилить будь-який запит на створення, що намагається використати цю комбінацію.
Для деталей щодо поведінки, коли hostnameOverride встановлено в комбінації з іншими полями (hostname, subdomain, setHostnameAsFQDN, hostNetwork), див. таблицю в деталях проєкту KEP-4762.
6.4.1.9 - Класи якості обслуговування (Quality of Service) Podʼів
Ця сторінка представляє класи якості обслуговування (Quality of Service, QoS) в Kubernetes та пояснює, як Kubernetes присвоює кожному Podʼу клас QoS як наслідок обмежень ресурсів, які ви вказуєте для контейнерів у цьому Podʼі. Kubernetes покладається на цю класифікацію для прийняття рішень про те, які Podʼи виселяти, коли на вузлі бракує доступних ресурсів.
Класи якості обслуговування
Kubernetes класифікує Podʼи, які ви запускаєте, і розподіляє кожен Pod у певний клас якості обслуговування (quality of service, QoS). Kubernetes використовує цю класифікацію, щоб впливати на те, як обробляються різні Podʼи. Kubernetes робить цю класифікацію на основі запитів ресурсівконтейнерів у цьому Podʼі, а також того, як ці запити співвідносяться з обмеженнями ресурсів. Це відомо як клас якості обслуговування (QoS). Kubernetes присвоює кожному Podʼу клас QoS на основі запитів та обмежень ресурсів його складових контейнерів. Kubernetes використовує класи QoS, щоб вирішити, які Podʼи виселяти з вузла, що перебуває під тиском на вузол. Можливі класи QoS: Guaranteed, Burstable та BestEffort. Коли на вузлі закінчуються ресурси, Kubernetes спочатку виселяє Podʼи BestEffort, що працюють на цьому вузлі, потім Burstable і нарешті Guaranteed. Коли це виселення спричинене тиском на ресурси, кандидатами на виселення є лише Podʼи, що перевищують запити ресурсів.
Guaranteed
Podʼи, які мають клас Guaranteed, мають найстрогіші обмеження ресурсів і найменшу ймовірність бути виселеними. Гарантується, що їх не буде завершено, доки вони не перевищать свої обмеження або доки не залишиться Podʼів з нижчим пріоритетом, які можна витіснити з вузла. Вони не можуть отримувати ресурси понад вказані обмеження. Ці Podʼи також можуть використовувати ексклюзивні CPU за допомогою політику управління CPU типу static.
Критерії
Щоб Pod отримав клас QoS Guaranteed:
Кожен контейнер в Podʼі повинен мати обмеження та запит на памʼять, обидва більші за нуль.
Для кожного контейнера у Podʼі обмеження памʼяті повинен дорівнювати запиту памʼяті.
Кожен контейнер в Podʼі повинен мати обмеження та запит на CPU, обидва більші за нуль.
Для кожного контейнера у Podʼі обмеження CPU повинен дорівнювати запиту CPU.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34; (стандартно увімкнено)
Pod повинен мати обмеження памʼяті на рівні Podʼа і запит на памʼять, і їхні значення повинні бути рівними.
Pod повинен мати обмеження та запит CPU на рівні Podʼа, і їхні значення повинні бути рівними.
Burstable
Podʼи, які мають клас Burstable, мають певні гарантії нижньої межі ресурсів на основі запиту, але не вимагають конкретного обмеження. Якщо обмеження не вказано, стандартно воно дорівнює місткості вузла, що дозволяє Podʼам гнучко збільшувати свої ресурси, якщо ті доступні. У разі виселення Podʼа через тиск на ресурси вузла ці Podʼи виселяються лише після виселення всіх Podʼів з класом BestEffort. Оскільки Burstable Pod може містити контейнер, який не має обмежень чи запитів ресурсів, Pod з класом Burstable може намагатися використовувати будь-яку кількість ресурсів вузла.
Критерії
Pod отримує клас QoS Burstable, якщо:
Pod не відповідає критеріям класу QoS Guaranteed.
Принаймні один контейнер у Podʼі має запит або обмеження памʼяті чи CPU, або Pod має запит або обмеження памʼяті чи CPU на рівні Podʼа.
BestEffort
Podʼи в класі BestEffort можуть використовувати ресурси вузла, які не призначені спеціально для Podʼів інших класів QoS. Наприклад, якщо у вас є вузол із 16 ядрами CPU, доступними для kubelet, і ви призначили 4 ядра CPU Podʼу з класом Guaranteed, Pod у класі QoS BestEffort може намагатися використовувати будь-яку кількість із решти 12 ядер CPU.
Kubelet віддає перевагу виселенню Podʼів з класом BestEffort, якщо вузол потрапляє в стан тиску на ресурси.
Критерії
Pod має клас QoS BestEffort, якщо він не відповідає критеріям ані Guaranteed, ані Burstable. Іншими словами, Pod має клас BestEffort лише в тому випадку, якщо жоден з контейнерів у Podʼі не має обмеження або запиту памʼяті, і жоден з контейнерів у Podʼі не має обмеження або запиту CPU, а Pod не має жодних обмежень або запитів щодо памʼяті або CPU на рівні Podʼа. Контейнери в Podʼі можуть запитувати інші ресурси (не CPU чи памʼять) і все одно класифікуватися як BestEffort.
Memory QoS з cgroup v2
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
Memory QoS використовує контролер памʼяті cgroup v2 для керування тротлінгом і захистом памʼяті в Kubernetes. Ця функція використовує клас QoS Podʼа для визначення, які налаштування cgroup слід застосувати, але вона не впливає на класифікацію Podʼів.
Типова конфігурація kubelet не вмикає тротлінг памʼяті або захист памʼяті. Щоб увімкнути будь-яку з цих поведінок, налаштуйтеmemoryThrottlingFactor або memoryReservationPolicy відповідно.
Тротлінг памʼяті
Тротлінг памʼяті контролюється полем конфігурації kubeletmemoryThrottlingFactor. Його типове значення — nil, що означає, що kubelet не встановлює memory.high. Щоб увімкнути тротлінг памʼяті, встановіть memoryThrottlingFactor у значення більше 0 та менше або рівне 1.
Для Podʼів типу Burstable kubelet використовує memory.high, щоб застосувати тротлінг до виділення памʼяті до того, як робоче навантаження досягне свого жорсткого обмеження (memory.max). Поріг тротлінгу для контейнера обчислюється за такою формулою:
Наприклад, з memoryThrottlingFactor, встановленим на 0.9, контейнер із запитом 256 MiB і обмеженням 1 GiB отримає memory.high, встановлений приблизно на 947 MiB. Якщо контейнер Burstable не має обмеження памʼяті, kubelet використовує доступну для розподілу памʼять вузла замість обмеження.
Для контейнерів BestEffort, які не мають запиту або обмеження памʼяті, kubelet обчислює memory.high, використовуючи нульовий запит та доступну для розподілу памʼять вузла замість обмеження. Контейнери Guaranteed не отримують memory.high, оскільки їхні запити дорівнюють обмеженням.
Налаштування резервування памʼяті
Резервування памʼяті контролюється через поле конфігурації kubelet
memoryReservationPolicy:
None (стандартно): kubelet не встановлює memory.min або memory.low для контейнерів і Podʼів. Жодна памʼять не блокується ядром жорстко.
TieredReservation: kubelet встановлює багаторівневий захист памʼяті на основі класу QoS Podʼа:
Podʼи Guaranteed: memory.min встановлюється на запити памʼяті. Ядро не буде звільняти цю памʼять за жодних обставин.
Podʼи Burstable: memory.low встановлюється на запити памʼяті. Ядро переважно зберігає цю памʼять, але може звільнити її за надзвичайного тиску.
Podʼи BestEffort: захист памʼяті не встановлюється.
Наприклад, така конфігурація kubelet вмикає тротлінг памʼяті з коефіцієнтом 0.9 та багаторівневий захист памʼяті:
Ви можете налаштовувати кожне поле незалежно. Опустіть memoryThrottlingFactor, щоб kubelet не встановлював memory.high, або встановіть memoryReservationPolicy: None, щоб вимкнути захист памʼяті.
Оскільки захист памʼяті cgroup v2 є ієрархічним, kubelet також налаштовує батьківські cgroup. Він встановлює memory.min на кореневій cgroup kubepods як суму запитів памʼяті для Podʼів Guaranteed та Burstable. Він встановлює memory.low на кореневій cgroup kubepods та cgroup QoS Burstable як суму запитів памʼяті для Podʼів Burstable. Без такого покриття батьківських cgroup захист на рівні Podʼа та контейнера був би неефективним.
Увага:
Для Podʼа Guaranteed запити памʼяті дорівнюють обмеженням памʼяті. З memoryReservationPolicy: TieredReservationmemory.min тому дорівнює memory.max. Для робочого навантаження, яке використовує великий кеш сторінок, ядро може бути не в змозі звільнити достатньо кешу сторінок, перш ніж cgroup досягне memory.max, що може призвести до завершення через OOM (OOM kill). Встановіть обмеження памʼяті так, щоб включити достатній запас для кешу сторінок.
Вимкнення або відкочування Memory QoS
Щоб вимкнути Memory QoS, встановіть функціональну можливість MemoryQoS на false, переконайтеся, що memoryReservationPolicy не встановлено або встановлено у None, та перезапустіть kubelet. Під час запуску kubelet скидає memory.min та memory.low на кореневій cgroup kubepods та memory.low на cgroup QoS Burstable до нуля. Значення memory.min та memory.low на рівні Podʼа та контейнера можуть залишатися, але вони неефективні, оскільки відповідний захист батьківських cgroup дорівнює нулю.
Коли Memory QoS вимкнено, kubelet встановлює memory.high на max щоразу, коли середовище виконання контейнерів застосовує конфігурацію ресурсів до нового, перезапущеного або зміненого на місці контейнера. Вже запущений контейнер, який не перезапускається та не змінює розмір, може зберігати своє попереднє значення memory.high до наступного перезапуску або зміни розміру на місці.
Системні вимоги
Для роботи Memory QoS необхідна версія Linux із cgroup v2. Рекомендується використовувати ядро версії 5.9 або вище, оскільки обмеження memory.high у старих версіях ядра може спричинити відому помилку livelock. Якщо функція MemoryQoS увімкнена на старішому ядрі, kubelet записує попередження в лог під час запуску.
Деяка поведінка незалежна від класу QoS
Деяка поведінка є незалежною від класу QoS, який визначає Kubernetes. Наприклад:
Будь-який контейнер, що перевищує обмеження ресурсів, буде завершено та перезапущено kubelet без впливу на інші контейнери в цьому Podʼі.
Якщо контейнер перевищує свій запит ресурсу і вузол, на якому він працює, стикається з нестачею ресурсів, Pod, в якому він перебуває, стає кандидатом для виселення. Якщо це станеться, всі контейнери в цьому Podʼі будуть завершені. Kubernetes може створити новий Pod, зазвичай на іншому вузлі.
Запит ресурсів Podʼа дорівнює сумі запитів ресурсів його складових контейнерів, а обмеження Podʼа дорівнює сумі обмежень ресурсів його складових контейнерів.
Планувальник kube-scheduler не враховує клас QoS під час вибору того, які Podʼи витіснити. Витіснення може відбуватися, коли кластер не має достатньо ресурсів для запуску всіх визначених вами Podʼів.
Клас QoS визначається під час створення Podʼа і залишається незмінним протягом усього терміну існування Podʼа. Якщо пізніше ви спробуєте виконати зміну розміру на місці, що призведе до зміни класу QoS, зміна розміру буде відхилена під час перевірки допуску.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Ви можете повʼязати Pod з PodGroup, щоб вказати, що Pod належить до групи Pods, які плануються разом. Це дозволяє планувальнику застосовувати політики на рівні групи, такі як групове планування, замість того, щоб розглядати кожен Pod окремо.
Визначення групи планування
Коли увімкнено функціональну можливість GenericWorkload, ви можете встановити поле spec.schedulingGroup у маніфесті Pod. Це поле встановлює звʼязок із конкретним обʼєктом PodGroup у тому самому просторі імен за назвою.
Поле schedulingGroup є незмінним. Після встановлення Pod не можна перемістити до іншого PodGroup.
Поведінка
Коли ви встановлюєте spec.schedulingGroup, планувальник шукає вказаний PodGroup і застосовує визначену в ньому політику планування:
Якщо PodGroup використовує політику basic, кожен Pod планується незалежно, використовуючи стандартну поведінку Kubernetes. Групування використовується як мітка на рівні групи.
Якщо PodGroup використовує політику gang, Pod входить у життєвий цикл планування "все або нічого". Планувальник намагається розмістити принаймні minCountPods у групі одночасно; жоден з них не привʼязується до вузлів, якщо мінімум не досягнуто.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup увімкнено, PodGroup також може вказувати батьківський CompositePodGroup. В ієрархічному робочому навантаженні планування регулюється політиками, визначеними для всього дерева груп (такими як багаторівневе групове планування або обмеження топології).
Відсутні посилання на групи
Якщо Pod посилається на PodGroup, що ще не існує, Pod залишається в стані очікування. Аналогічно, якщо згаданий PodGroup вказує батьківський CompositePodGroup (через spec.parentCompositePodGroupName), який ще не створено, планування не починається, і Pod залишається в стані очікування, доки вся ієрархія груп не існуватиме в кластері.
Планувальник автоматично розглядає Pod повторно, щойно всі необхідні ресурси PodGroup та CompositePodGroup будуть існувати.
Що далі
Дізнайтеся про PodGroup API та його життєвий цикл.
Статичні Podʼи (Static Pods) керуються безпосередньо демоном kubelet на конкретному вузлі, без спостереження за ними з боку API-сервера. На відміну від Podʼів, які керуються панеллю управління (наприклад, Deployment), kubelet стежить за кожним статичним Podʼом і перезапускає його у разі збою.
Статичні Podʼи завжди привʼязані до одного kubelet на конкретному вузлі.
Основне призначення статичних Podʼів — запуск самостійно розміщеної панелі управління: іншими словами, використання kubelet для контролю окремих компонентів панелі управління. Наприклад, kubeadm використовує статичні Podʼи для запуску kube-apiserver, kube-controller-manager, kube-scheduler та etcd на вузлах панелі управління.
Примітка:
Якщо ваш кластер запускає компоненти панелі управління як Podʼи, вони, ймовірно, є статичними Podʼами. Ви можете розпізнати їхні дзеркальні Podʼи в просторі імен kube-system за анотацією kubernetes.io/config.mirror.
Дзеркальні Podʼи
Kubelet автоматично намагається створити дзеркальний Pod на API-сервері Kubernetes для кожного статичного Podʼа. Це означає, що Podʼи, що працюють на вузлі, видимі на API-сервері, але керувати ними звідти не можна. До назв Podʼів буде додано імʼя хоста вузла з дефісом перед ним.
Kubelet передає мітки зі статичного Podʼа до дзеркального Podʼа. Ви можете використовувати ці мітки як зазвичай через селектори.
Якщо ви спробуєте використати kubectl для видалення дзеркального Podʼа з API-сервера, kubelet не видалить статичний Pod. Kubelet створить дзеркальний Pod заново.
Якщо ви запускаєте кластер Kubernetes і використовуєте статичні Podʼи для запуску Podʼів на кожному вузлі, вам, ймовірно, слід натомість використовувати DaemonSet.
Статичні Podʼи не керуються панеллю управління, тому їх не можна розгортати, відкочувати або масштабувати за допомогою стандартних механізмів Kubernetes. DaemonSets надають ці можливості і є рекомендованим підходом для запуску робочих навантажень на рівні вузла.
Статичні Podʼи запускаються kubelet до того, як API-сервер стане доступним, що робить їх придатними для ініціалізації компонентів панелі управління. DaemonSets потребують запущеної панелі управління.
Дізнайтеся про компоненти Kubernetes та як панель управління використовує статичні Podʼи.
Дізнайтеся про DaemonSets як альтернативу статичним Podʼам.
6.4.1.12 - Простори імен користувачів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate UserNamespacesSupport, Kubernetes ignores it but does not report any error.
Ця сторінка пояснює, як використовуються простори імен користувачів у Podʼах Kubernetes. Простір імен користувачів ізолює користувача, який працює всередині контейнера, від користувача на хості.
Процес, який працює як root у контейнері, може працювати на хості як інший користувач (не root); іншими словами, процес має повні привілеї для операцій всередині простору імен користувачів, але не має привілеїв для операцій за його межами.
Ви можете використовувати цю функцію, щоб зменшити шкоду, яку скомпрометований контейнер може заподіяти хосту або іншим Podʼам на тому самому вузлі. Є кілька вразливостей безпеки, які оцінено як ВИСОКІ або КРИТИЧНІ, і які неможливо було використати, коли простори імен користувачів активні. Очікується, що простори імен користувачів також помʼякшуватимуть деякі майбутні вразливості.
Перш ніж ви розпочнете
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Це функція, доступна лише для Linux, і потребує підтримки в Linux для монтування idmap на використовуваних файлових системах. Це означає:
На вузлі файлова система, яку ви використовуєте для /var/lib/kubelet/pods/, або власна тека, яку ви налаштовуєте для цього, повинна підтримувати монтування idmap.
Всі файлові системи, які використовуються в томах Podʼа, повинні підтримувати монтування idmap.
На практиці це означає, що вам потрібне ядро Linux принаймні версії 6.3, оскільки tmpfs почав підтримувати монтування idmap у цій версії. Це зазвичай потрібно, оскільки кілька функцій Kubernetes використовують tmpfs (токен ServiceAccount, який монтується стандартно, використовує tmpfs, Secrets також використовують tmpfs тощо).
Деякі популярні файлові системи, які підтримують монтування idmap в Linux 6.3, — це: btrfs, ext4, xfs, fat, tmpfs, overlayfs.
Крім того, середовище виконання контейнерів та його базове середовище виконання OCI повинні підтримувати простори імен користувачів. Підтримку надають такі середовища виконання OCI:
crun версії 1.9 або вище (рекомендована версія 1.13+).
Для використання просторів імен користувачів з Kubernetes також потрібне середовище виконання контейнерів CRI, щоб використовувати цю функцію з Podʼами Kubernetes:
containerd: версія 2.0 (і новіші) підтримує простори імен користувачів для контейнерів.
CRI-O: версія 1.25 (і новіші) підтримує простори імен користувачів для контейнерів.
Стан підтримки просторів імен користувачів в cri-dockerd відстежується у тікеті на GitHub.
Вступ
Простори імен користувачів — це функція Linux, яка дозволяє зіставляти користувачів у контейнері з іншими користувачами на хості. Крім того, можливості, надані Podʼу в просторі імен користувачів, чинні лише в цьому просторі імен і недійсні поза ним.
Pod може увімкнути використання просторів імен користувачів, встановивши поле pod.spec.hostUsers в false.
Kubelet вибере UID/GID хоста, на які зіставляється Pod, і зробить це так, щоб жодні два Podʼи на одному вузлі не використовували однакове зіставлення.
Поля runAsUser, runAsGroup, fsGroup тощо в pod.spec завжди посилаються на користувача всередині контейнера. Ці користувачі використовуватимуться для монтування томів (вказаних у pod.spec.volumes), і тому UID/GID хоста не матимуть жодного впливу на запис/читання з томів, які може монтувати Pod. Іншими словами, inode, створені/зчитані у томах, змонтованих Podʼом, будуть такими самими, як якби Pod не використовував простори імен користувачів.
Таким чином, Pod може легко вмикати та вимикати простори імен користувачів (не впливаючи на права власності на файли томів), а також надавати спільний доступ до томів з Podʼами без просторів імен користувачів, просто вказавши відповідних користувачів всередині контейнера (RunAsUser, RunAsGroup, fsGroup тощо). Це стосується будь-якого тому, який може бути змонтовано в Pod, включно з hostPath (якщо Podʼу дозволено монтувати томи hostPath).
Стандартно дійсні UID/GID, коли цю функцію активовано, лежать у діапазоні 0-65535. Це стосується файлів та процесів (runAsUser, runAsGroup тощо).
Файли з UID/GID за межами цього діапазону вважатимуться такими, що належать до overflow ID, зазвичай 65534 (налаштовано в /proc/sys/kernel/overflowuid та /proc/sys/kernel/overflowgid). Однак змінити ці файли неможливо, навіть якщо працювати як користувач/група 65534.
Якщо діапазон 0-65535 розширено за допомогою налаштування, вищезазначені обмеження застосовуються до розширеного діапазону.
Більшість застосунків, які потребують запуску з правами root, але не мають доступу до інших просторів імен хоста чи ресурсів, повинні продовжувати працювати без змін, якщо простори імен користувачів активовано.
Розуміння просторів імен користувачів для Podʼів
Кілька середовищ виконання контейнерів із їхньою типовою конфігурацією (таких як Docker Engine, containerd, CRI-O) використовують простори імен Linux для ізоляції. Існують інші технології, які також можна використовувати з цими середовищами (наприклад, Kata Containers використовує віртуальні машини замість просторів імен Linux). Ця сторінка стосується середовищ виконання контейнерів, які використовують простори імен Linux для ізоляції.
Під час створення Podʼа стандартно використовується кілька нових просторів імен для ізоляції: мережевий простір імен для ізоляції мережі контейнера, простір імен PID для ізоляції перегляду процесів тощо. Якщо використовується простір імен користувачів, це ізолює користувачів у контейнері від користувачів на вузлі.
Це означає, що контейнери можуть працювати як root і зіставлятися з користувачем, який не є root, на хості. Всередині контейнера процес буде вважати себе root (і, отже, інструменти типу apt, dnf тощо працюватимуть нормально), тоді як насправді процес не має привілеїв на хості. Ви можете перевірити це, наприклад, дізнавшись, від імені якого користувача працює процес контейнера, виконавши ps aux на хості. Користувач, якого показує ps, не той самий, що і користувач, якого ви бачите, якщо ви виконаєте команду id всередині контейнера.
Ця абстракція обмежує те, що може трапитися, наприклад, якщо контейнеру вдасться втекти на хост. Оскільки контейнер працює як непривілейований користувач на хості, обмежено те, що він може зробити на хості.
Крім того, оскільки користувачі в кожному Podʼі будуть зіставлені з різними користувачами на хості, що не перетинаються, обмежено те, що вони можуть зробити з іншими Podʼами.
Можливості, надані Podʼу, також обмежуються простором імен користувачів Podʼа і здебільшого є недійсними поза ним, а деякі навіть абсолютно нечинні. Ось два приклади:
CAP_SYS_MODULE не має жодного ефекту, якщо його надано Podʼу, що використовує простори імен користувачів, Pod не може завантажити модулі ядра.
CAP_SYS_ADMIN обмежений простором імен користувачів Podʼа та є недійсним поза його межами.
Без використання просторів імен користувачів контейнер, який працює як root, у разі втечі контейнера, має привілеї root на вузлі. І якщо контейнеру надано деякі можливості, ці можливості є дійсними на хості. Цього не відбувається, коли ми використовуємо простори імен користувачів.
Якщо ви хочете дізнатися більше подробиць про те, що змінюється під час використання просторів імен користувачів, дивіться man 7 user_namespaces.
Налаштування вузла для підтримки просторів імен користувачів
Типово kubelet призначає UID/GID Podʼам вище діапазону 0-65535, ґрунтуючись на припущенні, що файли та процеси хоста використовують UID/GID у цьому діапазоні, що є стандартним для більшості дистрибутивів Linux. Цей підхід запобігає будь-якому перетину між UID/GID хоста та UID/GID Podʼів.
Уникнення перетину є важливим для помʼякшення впливу вразливостей, таких як CVE-2021-25741, де потенційно Pod може читати довільні файли на хості. Якщо UID/GID Podʼа та хоста не перетинаються, те, що може робити Pod, обмежено: UID/GID Podʼа не буде відповідати власнику/групі файлів хоста.
Kubelet може використовувати власний діапазон ідентифікаторів користувачів та груп для Podʼів. Для налаштування власного діапазону вузол повинен мати:
Користувача kubelet в системі (ви не можете використовувати інше імʼя користувача тут)
Встановлений бінарний файл getsubids (частина shadow-utils), доступний у PATH для бінарного файлу kubelet.
Цей параметр лише збирає конфігурацію діапазону UID/GID та не змінює користувача, який виконує kubelet.
Вам потрібно дотримуватися деяких обмежень для допоміжного діапазону ID, який ви призначаєте користувачу kubelet:
Допоміжний ідентифікатор користувача, який визначає початок діапазону UID для Podʼів, має бути кратним 65536 і також повинен бути більшим або рівним 65536. Іншими словами, ви не можете використовувати жодний ідентифікатор з діапазону 0-65535 для Podʼів; kubelet накладає це обмеження, щоб ускладнити створення ненавмисно незахищеної конфігурації.
Кількість допоміжних ID повинна бути кратною 65536.
Кількість допоміжних ID повинна бути щонайменше 65536 x <maxPods>, де <maxPods> — максимальна кількість Podʼів, які можуть запускатися на вузлі.
Ви повинні призначити однаковий діапазон як для ідентифікаторів користувача, так і для ідентифікаторів груп. Не має значення, чи мають інші користувачі діапазони ідентифікаторів користувача, що не збігаються з діапазонами ідентифікаторів груп.
Жоден з призначених діапазонів не повинен перетинатися з жодним іншим призначенням.
Конфігурація допоміжних ID повинна бути лише одним рядком. Іншими словами, ви не можете мати кілька діапазонів.
Наприклад, ви можете визначити /etc/subuid та /etc/subgid, щоб обидва мали такі записи для користувача kubelet:
# Формат такий
# імʼя:firstID:кількість ідентифікаторів
# де
# - firstID дорівнює 65536 (мінімальне можливе значення)
# - кількість ідентифікаторів дорівнює 110 * 65536
# (110 — стандартне обмеження кількості Podʼів на вузлі)
kubelet:65536:7208960
Примітка, якщо ви переконфігуровуєте вузол
Якщо у вас є вузол, на якому працюють Podʼи з просторами імен користувачів, і ви хочете внести вищезазначені зміни конфігурації, ось кілька важливих приміток.
Конфігурацію слід змінювати, коли на вузлі не запущено жодного Podʼа, що використовує простори імен користувачів. Під час зміни на вузлі, де працюють будь-які Podʼи з просторами імен користувачів, вам потрібно спочатку очистити вузол перед застосуванням конфігурації та перезапуском kubelet. Під час очищення вузла памʼятайте, що Podʼи DaemonSet або інші Podʼи, що толерують taint unschedulable, не будуть виселені.
Причина, чому не може бути запущено жодного Podʼа, що використовує простори імен користувачів, полягає в тому, що вони можуть використовувати будь-який діапазон, потенційно поза новим налаштованим діапазоном. Kubelet не зможе запуститися, якщо він не зможе застосувати нову конфігурацію для наявних Podʼів на вузлі.
Кількість ID для кожного Podʼа
Починаючи з Kubernetes v1.33 можна встановити кількість ID для кожного Podʼа в KubeletConfiguration.
Значення idsPerPod (uint32) має бути кратним 65536. Стандартне значення — 65536. Це значення застосовується лише до контейнерів, створених після запуску kubelet з цією KubeletConfiguration. На запущені контейнери ця конфігурація не впливає.
У версіях Kubernetes до v1.33 кількість ID для кожного Podʼа була жорстко встановлена на рівні 65536.
Інтеграція з перевіркою допуску безпеки Podʼів
Для Podʼів Linux, які увімкнули простори імен користувачів, Kubernetes послаблює застосування Стандартів безпеки Podʼа контрольованим способом.
Якщо ви створите Pod, який використовує простори імен користувачів, такі поля не будуть обмежені навіть у контекстах, які застосовують стандарт безпеки Podʼів Baseline чи Restricted. Це не становить проблему безпеки, оскільки root всередині Podʼа з просторами імен користувачів фактично посилається на користувача всередині контейнера, який ніколи не зіставляється з привілейованим користувачем на хості. Ось список полів, які не перевіряються для Podʼів в цих обставинах:
Зі стандартом безпеки Podʼів Restricted Pod все одно повинен використовувати лише стандартний або порожній ProcMount.
Обмеження
Під час використання просторів імен користувачів для Podʼа заборонено використовувати інші простори імен хоста. Зокрема, якщо ви встановите hostUsers: false, ви не маєте права встановлювати жодне з такого:
hostNetwork: true
hostIPC: true
hostPID: true
Жоден контейнер також не може використовувати volumeDevices (блокові томи raw, такі як /dev/sda). Це стосується всіх масивів контейнерів у специфікації Podʼа:
containers
initContainers
ephemeralContainers
Підтримка файлової системи
Podʼи, які використовують простір імен користувачів, потребують, щоб файлова система підтримувала монтування idmap. Деякі файлові системи не підтримують монтування idmap, і тому не можуть використовуватися з просторами імен користувачів. У таких випадках будуть згенеровані такі події. Зверніть увагу, що деталі попередження залежать від середовища виконання контейнерів, яке ви використовуєте.
Warning Failed 1s kubelet Error: failed to create containerd task: failed to create shim task: OCI runtime create failed: runc create failed: unable to start container process: error during container init: failed to fulfil mount request: failed to set MOUNT_ATTR_IDMAP on ${your mount path} invalid argument (maybe the filesystem used doesn't support idmap mounts on this kernel?): unknown
Томи NFS не можуть бути змонтовані в Pod з простором імен користувачів, оскільки клієнт Linux NFS ще не підтримує монтування idmap. Для поточного списку підтримуваних файлових систем дивіться сторінку керівництва Linux mount_setattr(2).
Метрики та спостережуваність
Kubelet експортує дві метрики prometheus, специфічні для просторів імен користувачів:
started_user_namespaced_pods_total: лічильник, який відстежує кількість спроб створення Podʼів з просторами імен користувачів.
started_user_namespaced_pods_errors_total: лічильник, який відстежує кількість помилок під час створення Podʼів з просторами імен користувачів.
Є два способи надати поля Podʼа та контейнера запущеному контейнеру: змінні середовища та файли, які заповнюються спеціальним типом тому. Разом ці два способи надання полів Podʼа та контейнера називають downward API.
Іноді корисно, щоб контейнер мав інформацію про себе, не перебуваючи занадто повʼязаним із Kubernetes. Downward API дозволяє контейнерам використовувати інформацію про себе чи кластер, не використовуючи клієнт Kubernetes або API-сервер.
Прикладом є наявний застосунок, який передбачає, що певна добре відома змінна середовища містить унікальний ідентифікатор. Можна обгорнути застосунок, але це виснажливо, схильне до помилок і суперечить меті слабкого звʼязку. Кращий варіант — використовувати назву Podʼа як ідентифікатор і передати її в цю змінну середовища.
У Kubernetes є два способи надати поля Podʼа та контейнера запущеному контейнеру:
Разом ці два способи надання полів Podʼа та контейнера називають downward API.
Доступні поля
Через downward API доступні лише деякі поля API Kubernetes. У цьому розділі перелічено поля, які ви можете зробити доступними.
Ви можете передавати інформацію з доступних полів рівня Podʼа, використовуючи fieldRef. На рівні API spec для Podʼа завжди визначає принаймні один Container. Ви можете передавати інформацію з доступних полів рівня Container, використовуючи
resourceFieldRef.
Інформація, доступна за допомогою fieldRef
Деякі поля рівня Podʼа ви можете передати контейнеру як змінну середовища або через том downwardAPI. Через обидва механізми доступні такі поля:
IP-адреси — це версія подвійного стека status.hostIP, перша завжди така сама, як і status.hostIP.
status.podIP
основна IP-адреса Podʼа (зазвичай, його IPv4-адреса)
status.podIPs
IP-адреси — це версія подвійного стека status.podIP, перша завжди така сама, як і status.podIP
Така інформація доступна через fieldRef тому downwardAPI, але не як змінні середовища:
metadata.labels
всі мітки Podʼа у форматі label-key="escaped-label-value" з однією міткою на рядок
metadata.annotations
всі анотації Podʼа у форматі annotation-key="escaped-annotation-value" з однією анотацією на рядок
Інформація, доступна за допомогою resourceFieldRef
Ці поля рівня контейнера дозволяють надавати інформацію про запити та обмеження для ресурсів, таких як CPU та памʼять.
Примітка:
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate InPlacePodVerticalScaling, Kubernetes ignores it but does not report any error.
Ресурси CPU та памʼяті контейнера можуть бути змінені під час роботи контейнера. Якщо це станеться, буде оновлено том downward API, але змінні середовища не буде оновлено, доки контейнер не буде перезапущено. Докладніші відомості наведено у статті Зміна розміру ресурсів CPU та памʼяті, призначених контейнерам.
resource: limits.cpu
Обмеження CPU контейнера
resource: requests.cpu
Запит CPU контейнера
resource: limits.memory
Обмеження памʼяті контейнера
resource: requests.memory
Запит памʼяті контейнера
resource: limits.hugepages-*
Обмеження hugepages контейнера
resource: requests.hugepages-*
Запит hugepages контейнера
resource: limits.ephemeral-storage
Обмеження ефемерного сховища контейнера
resource: requests.ephemeral-storage
Запит ефемерного сховища контейнера
Резервна інформація для обмежень ресурсів
Якщо обмеження CPU та памʼяті не вказані для контейнера, і ви намагаєтеся надати цю інформацію через downward API, kubelet стандартно надає максимальне доступне для розподілу значення CPU та памʼяті на основі розрахунку ресурсів вузла, доступних для розподілу.
PriorityClasses дозволяють вам встановити важливість Podʼів відносно інших Podʼів. Якщо ви призначаєте клас пріоритету Podʼу, Kubernetes встановлює поле .spec.priority для цього Podʼа на основі PriorityClass, який ви вказали (ви не можете встановити .spec.priority безпосередньо). Якщо або коли Pod не може бути запланований, і проблема повʼязана з нестачею ресурсів, kube-scheduler намагається витіснити Podʼи з нижчим пріоритетом, щоб зробити можливим планування Podʼа з вищим пріоритетом.
PriorityClass — це обʼєкт API в межах кластера, який зіставляє назву класу пріоритету з цілочисельним значенням пріоритету. Більші числа вказують на вищий пріоритет.
Визначення PriorityClass
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priorityvalue:10000globalDefault:falsedescription:"Клас пріоритету для робочих навантажень із високим пріоритетом"
Вказування пріоритету Podʼа за допомогою PriorityClass
RuntimeClass дозволяє вказати низькорівневе середовище виконання контейнерів для Podʼа. Це корисно, коли потрібно вказати різні середовища виконання контейнерів для різних типів Podʼів, наприклад, коли потрібні різні рівні ізоляції або функції середовища виконання.
RuntimeClass — це обʼєкт у межах кластера, який представляє середовище виконання контейнерів, доступне на деяких або всіх ваших вузлах.
Адміністратор кластера встановлює та налаштовує конкретні середовища виконання, що підтримують RuntimeClass.
Адміністратор може налаштувати цю спеціальну конфігурацію середовища виконання контейнерів на всіх вузлах або лише на деяких з них.
Докладнішу інформацію див. у документації RuntimeClass.
Конфігурація контексту безпеки на рівні Podʼа та контейнера
Поле Security context у специфікації Podʼа забезпечує детальний контроль за налаштуваннями безпеки для Podʼів та контейнерів.
securityContext на рівні Podʼа
Деякі аспекти безпеки застосовуються до всього Podʼа; для інших аспектів ви можете встановити стандартне значення без будь-яких перевизначень на рівні контейнера.
Ось приклад використання securityContext на рівні Podʼа:
Приклад Podʼа
apiVersion:v1kind:Podmetadata:name:security-context-demospec:securityContext:# Це стосується всього PodʼаrunAsUser:1000runAsGroup:3000fsGroup:2000containers:- name:sec-ctx-demoimage:registry.k8s.io/e2e-test-images/agnhost:2.45command:["sh","-c","sleep 1h"]
Контекст безпеки на рівні контейнера
Ви можете вказати контекст безпеки тільки для конкретного контейнера. Ось приклад:
Ідентифікатори користувачів та груп: контроль того, під яким користувачем/групою працює контейнер
Capabilities: додавання або видалення можливостей Linux
Профілі Seccomp: налаштування профілів обчислювальної безпеки
Параметри SELinux: налаштування контексту SELinux
AppArmor: налаштування профілів AppArmor для додаткового контролю доступу
Параметри Windows: налаштування параметрів безпеки, специфічних для Windows
Увага:
Ви також можете використовувати securityContext Podʼа, щоб дозволити привілейований режим у контейнерах Linux. Привілейований режим перевизначає багато інших налаштувань безпеки в securityContext. Уникайте використання цього параметра, якщо ви не можете надати еквівалентні дозволи за допомогою інших полів у securityContext. Ви можете запускати контейнери Windows у подібному привілейованому режимі, встановивши прапорець windowsOptions.hostProcess у контексті безпеки на рівні Podʼа. Детальні відомості та інструкції див. у розділі Створення Windows HostProcess Podʼа.
Спорідненість вузлів дозволяє вам вказати правила, які обмежують, на яких вузлах може бути запланований ваш Pod. Ось приклад Podʼа, який віддає перевагу роботі на вузлах, позначених як такі, що розташовані на певному континенті, вибираючи на основі значення мітки topology.kubernetes.io/zone.
Окрім спорідненості вузлів, ви також можете обмежити, на яких вузлах може бути заплановано Pod, на основі міток інших Podʼів, які вже працюють на вузлах. Спорідненість Podʼів дозволяє вам вказати правила щодо розміщення Podʼів відносно інших Podʼів.
Kubernetes надає кілька вбудованих API для декларативного керування вашими робочими навантаженнями та їх компонентами.
У кінцевому підсумку ваші застосунки працюють як контейнери всередині Podʼів; однак керування окремими Podʼами вимагало б багато зусиль. Наприклад, якщо Pod зазнає збою, ви, ймовірно, захочете запустити новий Pod для його заміни. Kubernetes може зробити це за вас.
Ви використовуєте API Kubernetes для створення обʼєкта робочого навантаження, який представляє вищий рівень абстракції, ніж Pod, а потім панель управління Kubernetes автоматично керує обʼєктами Pod від вашого імені, відповідно до специфікації обʼєкта робочого навантаження, яку ви визначили.
Вбудовані API для керування робочими навантаженнями:
Deployment (і, опосередковано, ReplicaSet), найпоширеніший спосіб запуску застосунку у вашому кластері. Deployment є хорошим вибором для керування робочим навантаженням, яке не зберігає стану, де будь-який Pod у Deployment є взаємозамінним і може бути замінений, якщо це потрібно. (Deployments є заміною застарілого API ReplicationController).
StatefulSet дозволяє вам керувати одним або кількома Podʼами, які виконують один і той самий код застосунку, де Podʼи покладаються на наявність окремої ідентичності. Це відрізняється від Deployment, де очікується, що Podʼи будуть взаємозамінними. Найпоширеніше використання StatefulSet полягає в тому, щоб забезпечити звʼязок між Podʼами та їх постійним сховищем. Наприклад, ви можете запустити StatefulSet, який повʼязує кожен Pod із PersistentVolume. Якщо один з Podʼів у StatefulSet зазнає збою, Kubernetes створює Pod-замінник, підключений до того самого PersistentVolume.
DaemonSet визначає Podʼи, які надають можливості, що є локальними для конкретного вузла; наприклад, драйвер, який дозволяє контейнерам на цьому вузлі отримувати доступ до системи зберігання. Ви використовуєте DaemonSet, коли драйвер або інший сервіс рівня вузла має працювати на вузлі, де він корисний. Кожен Pod в DaemonSet виконує роль, схожу на системний демон на класичному сервері Unix/POSIX. DaemonSet може бути фундаментальним для роботи вашого кластера, наприклад, як втулок, який надає цьому вузлу доступ до мережі кластера, він може допомогти вам керувати вузлом, або надати менш важливі можливості, які покращують платформу контейнерів, яку ви використовуєте. Ви можете запускати DaemonSets (та їхні Podʼи) на кожному вузлі вашого кластера або лише на підмножині (наприклад, встановити драйвер прискорювача GPU лише на вузлах, де встановлено GPU).
Ви можете використовувати Job та/або CronJob для визначення завдань, які виконуються до завершення та зупиняються. Job представляє одноразове завдання, тоді як кожен CronJob повторюється згідно з розкладом.
Інші теми в цьому розділі:
6.4.2.1 - Deployments
Deployment керує набором Podʼів для запуску робочого навантаження застосунку, зазвичай такого, що не зберігає стан.
Deployment забезпечує декларативні оновлення для Podʼів та ReplicaSets.
Ви описуєте бажаний стан у Deployment, і контролер Deployment змінює фактичний стан на бажаний з контрольованою швидкістю. Ви можете визначити Deployments для створення нових ReplicaSets або для видалення наявних Deployments і перейняття всіх їхніх ресурсів новими Deployments.
Примітка:
Не керуйте ReplicaSets, що належать Deployment. Розгляньте можливість створення тікета в основному репозиторії Kubernetes, якщо ваш випадок використання не врахований нижче.
Оголошення нового стану Podʼів шляхом оновлення PodTemplateSpec в Deployment. Створюється новий ReplicaSet, і Deployment поступово нарощує кількість його елементів, водночас зменшуючи старий ReplicaSet, забезпечуючи контрольовану заміну Podʼів. Кожен новий ReplicaSet оновлює ревізію Deployment.
Створюється Deployment з назвою nginx-deployment, назва вказується в полі .metadata.name. Ця назва буде основою для ReplicaSets та Podʼів, які буде створено потім. Докладніше див. у розділі Написання специфікації Deployment.
Deployment створює ReplicaSet, який створює три реплікованих Podʼи, кількість зазначено у полі .spec.replicas.
Поле .spec.selector визначає, як створений ReplicaSet відшукує Podʼи для керування. У цьому випадку вибирається мітка, визначена в шаблоні Podʼа (app: nginx). Однак можливі складніші правила вибору, якщо сам шаблон Podʼа задовольняє це правило.
Примітка:
Поле .spec.selector.matchLabels є мапою пар {key,value}. Одна пара {key,value} у мапі matchLabels еквівалентна елементу matchExpressions, де поле key — "key", operator — "In", а масив values містить лише "value". Всі умови, як від matchLabels, так і від matchExpressions, повинні бути виконані для отримання збігу.
Поле .spec.template має такі вкладені поля:
Podʼи позначаються міткою app: nginx з поля .metadata.labels.
Специфікація шаблону Podʼа, або поле .spec, вказує на те, що Podʼи запускають один контейнер, nginx, який використовує образ nginx з Docker Hub версії 1.14.2.
Створюється один контейнер із назвою nginx, вказаною в полі .spec.containers[0].name.
Перш ніж почати, переконайтеся, що ваш кластер Kubernetes працює. Дотримуйтесь наведених нижче кроків для створення наведеного вище Deployment:
Виконайте kubectl get deployments для перевірки створення Deployment.
Якщо Deployment все ще створюється, ви побачите вивід, подібний до цього:
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-deployment 0/3 0 0 1s
Коли ви переглядаєте Deployments у вашому кластері, показуються такі поля:
NAME — містить назви Deployments у просторі імен.
READY — показує, скільки реплік застосунку доступно користувачам. Значення відповідає шаблону готово/бажано.
UP-TO-DATE — показує кількість реплік, які були оновлені для досягнення бажаного стану.
AVAILABLE — показує, скільки реплік застосунку доступно користувачам.
AGE — показує час впродовж якого застосунок працює.
Зверніть увагу, що бажана кількість реплік дорівнює 3 відповідно до поля .spec.replicas.
Для перевірки стану розгортання Deployment виконайте kubectl rollout status deployment/nginx-deployment.
Вивід буде подібний до цього:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
deployment "nginx-deployment" successfully rolled out
Запустіть kubectl get deployments знов через кілька секунд. Вивід буде подібний до цього:
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-deployment 3/3 3 3 18s
Зверніть увагу, що Deployment створив усі три репліки, і всі репліки актуальні (вони містять останній шаблон Podʼа) та доступні.
Для перевірки ReplicaSet (rs), створеного Deployment, виконайте kubectl get rs. Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-deployment-75675f5897 3 3 3 18s
Вивід ReplicaSet має такі поля:
NAME — перелік назв ReplicaSets в просторі імен.
DESIRED — показує бажану кількість реплік застосунку, яку ви вказали під час створення Deployment. Це бажаний стан.
CURRENT — показує, скільки реплік працює зараз.
READY — показує, скільки реплік застосунку доступно користувачам.
AGE — показує час впродовж якого застосунок працює.
Зверніть увагу, що назва ReplicaSet завжди складається як [DEPLOYMENT-NAME]-[HASH]. Ця назва буде основою для назв Podʼів, які буде створено потім.
Рядок HASH є відповідником мітки pod-template-hash в ReplicaSet.
Для ознайомлення з мітками, автоматично створеними для кожного Podʼа, виконайте kubectl get pods --show-labels.
Вивід буде схожим на це:
NAME READY STATUS RESTARTS AGE LABELS
nginx-deployment-75675f5897-7ci7o 1/1 Running 0 18s app=nginx,pod-template-hash=75675f5897
nginx-deployment-75675f5897-kzszj 1/1 Running 0 18s app=nginx,pod-template-hash=75675f5897
nginx-deployment-75675f5897-qqcnn 1/1 Running 0 18s app=nginx,pod-template-hash=75675f5897
Створений ReplicaSet гарантує наявність трьох Podʼів nginx.
Примітка:
Ви маєте зазначити відповідний селектор та мітки шаблону Podʼа в Deployment (у цьому випадку app: nginx).
Не допускайте перетину міток або селекторів з іншими контролерами (включаючи інші Deployments та StatefulSets). Kubernetes не завадить вам це зробити, і якщо кілька контролерів мають селектори, що перетинаються, ці контролери можуть конфліктувати та поводитись непередбачувано.
Мітка pod-template-hash
Увага:
Не змінюйте цю мітку.
Мітка pod-template-hash додається контролером Deployment до кожного ReplicaSet, який створює або переймає Deployment.
Ця мітка гарантує, що дочірні ReplicaSets Deployment не перетинаються. Вона генерується шляхом хешування PodTemplate ReplicaSet, і отриманий хеш використовується як значення мітки, яке додається до селектора ReplicaSet, міток шаблону Podʼа, а також до всіх наявних Podʼів, які можуть бути у ReplicaSet.
Оновлення Deployment
Примітка:
Розгортання Deployment запускається тоді й лише тоді, коли змінюється шаблон Podʼа Deployment (тобто .spec.template), наприклад, якщо оновлено мітки чи образи контейнерів шаблону. Інші оновлення, такі як масштабування Deployment, не запускають розгортання.
Дотримуйтеся поданих нижче кроків для оновлення вашого Deployment:
Оновіть Podʼи nginx, щоб використовувати образ nginx:1.16.1 замість nginx:1.14.2.
kubectl set image deployment.v1.apps/nginx-deployment nginx=nginx:1.16.1
або використовуйте таку команду:
kubectl set image deployment/nginx-deployment nginx=nginx:1.16.1
де deployment/nginx-deployment вказує на Deployment, nginx — на контейнер, який буде оновлено, і nginx:1.16.1 — на новий образ та його теґ.
Вивід буде подібний до цього:
deployment.apps/nginx-deployment image updated
Або ви можете відредагувати (edit) Deployment і змінити .spec.template.spec.containers[0].image з nginx:1.14.2 на nginx:1.16.1:
kubectl edit deployment/nginx-deployment
Вивід буде подібний до цього:
deployment.apps/nginx-deployment edited
Щоб перевірити статус розгортання, виконайте:
kubectl rollout status deployment/nginx-deployment
Вивід буде подібний до цього:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
або
deployment "nginx-deployment" successfully rolled out
Отримайте більше деталей про ваш оновлений Deployment:
Після успішного розгортання можна переглянути Deployment за допомогою kubectl get deployments. Вивід буде подібний до цього:
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-deployment 3/3 3 3 36s
Виконайте kubectl get rs, щоб перевірити, що Deployment оновив Podʼи, створивши новий ReplicaSet і масштабувавши його до 3 реплік, а також зменшивши розмір старого ReplicaSet до 0 реплік.
kubectl get rs
Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-deployment-1564180365 3 3 3 6s
nginx-deployment-2035384211 0 0 0 36s
Виклик get pods повинен тепер показати лише нові Podʼи:
kubectl get pods
Вивід буде подібний до цього:
NAME READY STATUS RESTARTS AGE
nginx-deployment-1564180365-khku8 1/1 Running 0 14s
nginx-deployment-1564180365-nacti 1/1 Running 0 14s
nginx-deployment-1564180365-z9gth 1/1 Running 0 14s
Наступного разу, коли вам потрібно буде оновити ці Podʼи, вам достатньо буде знову оновити шаблон Podʼа в Deployment.
Deployment гарантує, що під час оновлення недоступною буде лише певна кількість Podʼів. Типово він гарантує, що працюватимуть принаймні 75% бажаної кількості Podʼів (максимум 25% недоступних).
Deployment також гарантує, що понад бажану кількість Podʼів буде створено лише певну кількість. Типово він гарантує, що працюватимуть щонайбільше 125% бажаної кількості Podʼів (максимальне перевищення 25%).
Наприклад, якщо ви ретельно досліджуєте Deployment вище, ви побачите, що спочатку було створено новий Pod, потім видалено старий Pod і створено ще один новий. Старі Podʼи не прибираються допоки не зʼявиться достатня кількість нових, і не створюються нові Podʼи допоки не буде прибрано достатню кількість старих. Deployment гарантує, що доступні принаймні 3 Podʼи, а загалом доступно щонайбільше 4 Podʼи. У випадку розгортання з 4 репліками кількість Podʼів буде між 3 і 5.
Отримайте деталі вашого Deployment:
kubectl describe deployments
Вивід буде подібний до цього:
Name: nginx-deployment
Namespace: default
CreationTimestamp: Thu, 30 Nov 2017 10:56:25 +0000
Labels: app=nginx
Annotations: deployment.kubernetes.io/revision=2
Selector: app=nginx
Replicas: 3 desired | 3 updated | 3 total | 3 available | 0 unavailable
StrategyType: RollingUpdate
MinReadySeconds: 0
RollingUpdateStrategy: 25% max unavailable, 25% max surge
Pod Template:
Labels: app=nginx
Containers:
nginx:
Image: nginx:1.16.1
Port: 80/TCP
Environment: <none>
Mounts: <none>
Volumes: <none>
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing True NewReplicaSetAvailable
OldReplicaSets: <none>
NewReplicaSet: nginx-deployment-1564180365 (3/3 replicas created)
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal ScalingReplicaSet 2m deployment-controller Scaled up replica set nginx-deployment-2035384211 to 3
Normal ScalingReplicaSet 24s deployment-controller Scaled up replica set nginx-deployment-1564180365 to 1
Normal ScalingReplicaSet 22s deployment-controller Scaled down replica set nginx-deployment-2035384211 to 2
Normal ScalingReplicaSet 22s deployment-controller Scaled up replica set nginx-deployment-1564180365 to 2
Normal ScalingReplicaSet 19s deployment-controller Scaled down replica set nginx-deployment-2035384211 to 1
Normal ScalingReplicaSet 19s deployment-controller Scaled up replica set nginx-deployment-1564180365 to 3
Normal ScalingReplicaSet 14s deployment-controller Scaled down replica set nginx-deployment-2035384211 to 0
Тут ви бачите, що під час створення Deployment спочатку було створено ReplicaSet (nginx-deployment-2035384211) та масштабовано його до 3 реплік безпосередньо. Коли ви оновили Deployment, було створено новий ReplicaSet (nginx-deployment-1564180365) та масштабовано його до 1, потім Deployment дочекався, коли він запуститься. Потім було зменшено розмір старого ReplicaSet
до 2 і масштабовано новий ReplicaSet до 2, таким чином, щоб принаймні 3 Podʼи були доступні, і не більше 4 Podʼів в будь-який момент. Потім було продовжено масштабування нового та старого ReplicaSet, з однаковою стратегією поетапного оновлення. Зрештою у вас буде 3 доступні репліки в новому ReplicaSet, а старий ReplicaSet буде зменшено до 0.
Примітка:
Kubernetes не враховує Podʼи, які завершують роботу, коли розраховує кількість availableReplicas, яка повинна бути між replicas - maxUnavailable та replicas + maxSurge. Внаслідок цього ви можете помітити, що під час розгортання є більше Podʼів, ніж очікувалося, і що загальні ресурси, які використовує Deployment, перевищують replicas + maxSurge до того моменту, поки не мине terminationGracePeriodSeconds для Podʼів, що завершують роботу.
Rollover (або кілька одночасних оновлень)
Кожного разу, коли контролер Deployment виявляє новий Deployment, створюється ReplicaSet для запуску необхідних Podʼів. Якщо Deployment оновлюється, поточний ReplicaSet, який контролює Podʼи, мітки яких відповідають .spec.selector, але шаблон яких не відповідає .spec.template, зменшується. Врешті-решт новий ReplicaSet масштабується до .spec.replicas, а всі старі ReplicaSets масштабуються до 0.
Якщо ви оновите Deployment під час наявного процесу розгортання, Deployment створить новий ReplicaSet відповідно до оновлення, почне масштабувати його і перекине (roll over) ReplicaSet, який масштабував раніше: він додасть його до свого списку старих ReplicaSets і почне зменшувати його масштаб.
Наприклад, припустимо, ви створюєте Deployment для створення 5 реплік nginx:1.14.2, але потім оновлюєте Deployment для створення 5 реплік nginx:1.16.1, коли вже створено тільки 3 репліки nginx:1.14.2. У цьому випадку Deployment негайно починає
знищувати 3 Podʼи nginx:1.14.2, які вже створено, і починає створювати
Podʼи nginx:1.16.1. Deployment не чекає, доки буде створено 5 реплік nginx:1.14.2, перш ніж змінити напрямок.
Оновлення селектора міток
Зазвичай не рекомендується вносити оновлення до селектора міток, і рекомендується планувати ваші селектори наперед.
Селектор міток Deployment є незмінним після створення; його не можна оновити за допомогою kubectl patch, kubectl edit, kubectl apply або інструментів, таких як helm upgrade.
Якщо вам потрібно змінити селектор, вам доведеться видалити Deployment і створити його заново. Стандартно видалення Deployment також видаляє його запущені Podʼи, що призводить до простою; використовуйте --cascade=orphan, якщо вам потрібно, щоб ці Podʼи продовжували працювати під час повторного створення Deployment (див. наслідки нижче). Будьте дуже обережні та переконайтеся, що ви розумієте такі наслідки:
Додавання: Коли ви створюєте новий Deployment з більш вузьким селектором, новий Deployment повинен також мати відповідний шаблон Podʼа. Якщо у вас є наявний маніфест і ви редагуєте його, щоб звузити селектор, вам потрібно відредагувати метадані шаблону Podʼа всередині цього Deployment, додавши нові мітки для відповідності, інакше API-сервер поверне помилку валідації. Це зміна без перетину: новий Deployment не "побачить" старі Podʼи (які не мають нової мітки), тому старий ReplicaSet стане сирітським і буде створено абсолютно новий ReplicaSet.
Оновлення значень: Зміна наявного значення в ключі селектора (наприклад, з v1 на v2) призводить до тієї ж поведінки, що й додавання (сирітство та повторне створення).
Видалення: Видалення наявного ключа з селектора Deployment не вимагає жодних змін у мітках шаблону Podʼа. Це зміна з перетином: новий, ширший селектор відповідатиме старим Podʼам. Наявні ReplicaSets не стають сирітськими, і новий ReplicaSet не створюється, але зверніть увагу, що видалена мітка все ще існує в будь-яких наявних Podʼах та ReplicaSets. Ви можете прибрати її, запустивши розгортання Deployment.
Відкочування Deployment
Іноді вам може знадобитися відкотити Deployment, наприклад, коли Deployment нестабільний, зокрема зациклений на збоях (crash looping). Типово вся історія розгортань Deployment зберігається в системі, щоб ви могли відкотити його в будь-який час (ви можете змінити це, змінивши обмеження історії ревізій).
Примітка:
Ревізія Deployment створюється, коли запускається розгортання Deployment. Це означає, що нова ревізія створюється тільки тоді, коли змінюється шаблон Podʼа Deployment (.spec.template), наприклад, якщо ви оновлюєте мітки або образи контейнера в шаблоні. Інші оновлення, такі як масштабування Deployment, не створюють ревізію Deployment, щоб ви могли одночасно використовувати ручне або автоматичне масштабування. Це означає, що під час відкочування до попередньої ревізії повертається лише частина шаблону Podʼа Deployment.
Припустимо, ви припустилися помилки під час оновлення Deployment, вказавши назву образу як nginx:1.161 замість nginx:1.16.1:
kubectl set image deployment/nginx-deployment nginx=nginx:1.161
Вивід буде подібний до цього:
deployment.apps/nginx-deployment image updated
Розгортання застрягає. Ви можете перевірити це, перевіривши стан розгортання:
kubectl rollout status deployment/nginx-deployment
Вивід буде подібний до цього:
Waiting for rollout to finish: 1 out of 3 new replicas have been updated...
Натисніть Ctrl-C, щоб зупинити спостереження за станом розгортання. Докладніше про розгортання, що застрягли, читайте тут.
Ви бачите, що кількість старих реплік (додаючи кількість реплік від nginx-deployment-1564180365 та nginx-deployment-2035384211) — 3, а кількість нових реплік (від nginx-deployment-3066724191) — 1.
kubectl get rs
Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-deployment-1564180365 3 3 3 25s
nginx-deployment-2035384211 0 0 0 36s
nginx-deployment-3066724191 1 1 0 6s
При перегляді створених Podʼів ви бачите, що 1 Pod, створений новим ReplicaSet, застряг у циклі завантаження образу.
kubectl get pods
Вивід буде подібний до цього:
NAME READY STATUS RESTARTS AGE
nginx-deployment-1564180365-70iae 1/1 Running 0 25s
nginx-deployment-1564180365-jbqqo 1/1 Running 0 25s
nginx-deployment-1564180365-hysrc 1/1 Running 0 25s
nginx-deployment-3066724191-08mng 0/1 ImagePullBackOff 0 6s
Примітка:
Контролер Deployment автоматично зупиняє невдале розгортання та припиняє масштабування нового ReplicaSet. Це залежить від параметрів rollingUpdate (maxUnavailable), які ви вказали. Стандартно Kubernetes встановлює значення 25%.
Отримайте опис Deployment:
kubectl describe deployment
Вивід буде подібний до цього:
Name: nginx-deployment
Namespace: default
CreationTimestamp: Tue, 15 Mar 2016 14:48:04 -0700
Labels: app=nginx
Selector: app=nginx
Replicas: 3 desired | 1 updated | 4 total | 3 available | 1 unavailable
StrategyType: RollingUpdate
MinReadySeconds: 0
RollingUpdateStrategy: 25% max unavailable, 25% max surge
Pod Template:
Labels: app=nginx
Containers:
nginx:
Image: nginx:1.161
Port: 80/TCP
Host Port: 0/TCP
Environment: <none>
Mounts: <none>
Volumes: <none>
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing True ReplicaSetUpdated
OldReplicaSets: nginx-deployment-1564180365 (3/3 replicas created)
NewReplicaSet: nginx-deployment-3066724191 (1/1 replicas created)
Events:
FirstSeen LastSeen Count From SubObjectPath Type Reason Message
--------- -------- ----- ---- ------------- -------- ------ -------
1m 1m 1 {deployment-controller } Normal ScalingReplicaSet Scaled up replica set nginx-deployment-2035384211 to 3
22s 22s 1 {deployment-controller } Normal ScalingReplicaSet Scaled up replica set nginx-deployment-1564180365 to 1
22s 22s 1 {deployment-controller } Normal ScalingReplicaSet Scaled down replica set nginx-deployment-2035384211 to 2
22s 22s 1 {deployment-controller } Normal ScalingReplicaSet Scaled up replica set nginx-deployment-1564180365 to 2
21s 21s 1 {deployment-controller } Normal ScalingReplicaSet Scaled down replica set nginx-deployment-2035384211 to 1
21s 21s 1 {deployment-controller } Normal ScalingReplicaSet Scaled up replica set nginx-deployment-1564180365 to 3
13s 13s 1 {deployment-controller } Normal ScalingReplicaSet Scaled down replica set nginx-deployment-2035384211 to 0
13s 13s 1 {deployment-controller } Normal ScalingReplicaSet Scaled up replica set nginx-deployment-3066724191 to 1
Для виправлення цього вам потрібно відкотитися до попередньої ревізії Deployment, яка є стабільною.
Перевірка історії розгортання Deployment
Виконайте наведені нижче кроки, щоб перевірити історію розгортань:
По-перше, перевірте ревізії цього Deployment:
kubectl rollout history deployment/nginx-deployment
CHANGE-CAUSE копіюється з анотації Deployment kubernetes.io/change-cause до його ревізій під час створення. Ви можете вказати повідомлення CHANGE-CAUSE:
Анотуючи Deployment командою kubectl annotate deployment/nginx-deployment kubernetes.io/change-cause="image updated to 1.16.1"
Ручним редагуванням маніфесту ресурсу.
Використовуючи інструменти, які автоматично встановлюють анотації.
Примітка:
У старих версіях Kubernetes можна було використовувати прапорець --record з командами kubectl для автоматичного заповнення поля CHANGE-CAUSE. Цей прапорець є застарілим і буде видалений у майбутніх версіях.
Щоб переглянути деталі кожної ревізії, виконайте:
kubectl rollout history deployment/nginx-deployment --revision=2
Для отримання додаткових відомостей про команди, повʼязані з розгортаннями, читайте kubectl rollout.
Deployment тепер повернуто до попередньої стабільної ревізії. Як ви можете бачити, контролер Deployment генерує подію DeploymentRollback щодо відкочування до ревізії 2.
Перевірте, чи відкочування був успішним і Deployment працює як очікується, виконавши:
kubectl get deployment nginx-deployment
Вивід буде подібний до цього:
NAME READY UP-TO-DATE AVAILABLE AGE
nginx-deployment 3/3 3 3 30m
Отримайте опис Deployment:
kubectl describe deployment nginx-deployment
Вивід буде подібний до цього:
Name: nginx-deployment
Namespace: default
CreationTimestamp: Sun, 02 Sep 2018 18:17:55 -0500
Labels: app=nginx
Annotations: deployment.kubernetes.io/revision=4
Selector: app=nginx
Replicas: 3 desired | 3 updated | 3 total | 3 available | 0 unavailable
StrategyType: RollingUpdate
MinReadySeconds: 0
RollingUpdateStrategy: 25% max unavailable, 25% max surge
Pod Template:
Labels: app=nginx
Containers:
nginx:
Image: nginx:1.16.1
Port: 80/TCP
Host Port: 0/TCP
Environment: <none>
Mounts: <none>
Volumes: <none>
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing True NewReplicaSetAvailable
OldReplicaSets: <none>
NewReplicaSet: nginx-deployment-c4747d96c (3/3 replicas created)
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal ScalingReplicaSet 12m deployment-controller Scaled up replica set nginx-deployment-75675f5897 to 3
Normal ScalingReplicaSet 11m deployment-controller Scaled up replica set nginx-deployment-c4747d96c to 1
Normal ScalingReplicaSet 11m deployment-controller Scaled down replica set nginx-deployment-75675f5897 to 2
Normal ScalingReplicaSet 11m deployment-controller Scaled up replica set nginx-deployment-c4747d96c to 2
Normal ScalingReplicaSet 11m deployment-controller Scaled down replica set nginx-deployment-75675f5897 to 1
Normal ScalingReplicaSet 11m deployment-controller Scaled up replica set nginx-deployment-c4747d96c to 3
Normal ScalingReplicaSet 11m deployment-controller Scaled down replica set nginx-deployment-75675f5897 to 0
Normal ScalingReplicaSet 11m deployment-controller Scaled up replica set nginx-deployment-595696685f to 1
Normal DeploymentRollback 15s deployment-controller Rolled back deployment "nginx-deployment" to revision 2
Normal ScalingReplicaSet 15s deployment-controller Scaled down replica set nginx-deployment-595696685f to 0
Масштабування Deployment
Ви можете масштабувати Deployment за допомогою такої команди:
Припускаючи, що горизонтальне автомасштабування Podʼів увімкнено у вашому кластері, ви можете налаштувати автомасштабувальник для вашого Deployment і вибрати мінімальну та максимальну кількість Podʼів, які ви хочете запускати, на основі використання CPU вашими наявними Podʼами.
Deployments RollingUpdate підтримують виконання кількох версій застосунку одночасно. Коли ви або автомасштабувальник масштабуєте Deployment RollingUpdate, який перебуває посеред розгортання (у процесі або призупиненого), контролер Deployment балансує додаткові репліки в наявних активних ReplicaSets (ReplicaSets з Podʼами), щоб помʼякшити ризик. Це називається пропорційним масштабуванням.
Переконайтеся, що у вашому Deployment працює 10 реплік.
kubectl get deploy
Вивід буде подібний до цього:
NAME DESIRED CURRENT UP-TO-DATE AVAILABLE AGE
nginx-deployment 10 10 10 10 50s
Ви оновлюєте образ, який, як виявляється, неможливо знайти в межах кластера.
kubectl set image deployment/nginx-deployment nginx=nginx:sometag
Вивід буде подібний до цього:
deployment.apps/nginx-deployment image updated
Оновлення образу розпочинає нове розгортання з ReplicaSet nginx-deployment-1989198191, але воно блокується через вимогу maxUnavailable, згадану вище. Перевірте стан розгортання:
kubectl get rs
Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-deployment-1989198191 5 5 0 9s
nginx-deployment-618515232 8 8 8 1m
Потім надходить новий запит на масштабування для Deployment. Автомасштабувальник збільшує репліки Deployment до 15. Контролер Deployment повинен вирішити, куди додати цих нових 5 реплік. Якби ви не використовували пропорційне масштабування, всі 5 реплік були б додані в новий ReplicaSet. З пропорційним масштабуванням ви розподіляєте додаткові репліки між всіма ReplicaSets. Більші частки йдуть в ReplicaSets з найбільшою кількістю реплік, а менші частки йдуть в ReplicaSets з меншою кількістю реплік. Залишки додаються до ReplicaSet з найбільшою кількістю реплік. ReplicaSets з нульовою кількістю реплік не масштабуються.
У нашому прикладі вище 3 репліки додаються до старого ReplicaSet, а 2 репліки — до нового ReplicaSet. Процес розгортання повинен зрештою перемістити всі репліки в новий ReplicaSet, за умови, що нові репліки стають справними. Для підтвердження цього виконайте:
kubectl get deploy
Вивід буде подібний до цього:
NAME DESIRED CURRENT UP-TO-DATE AVAILABLE AGE
nginx-deployment 15 18 7 8 7m
Статус розгортання підтверджує, як репліки були додані до кожного ReplicaSet.
kubectl get rs
Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-deployment-1989198191 7 7 0 7m
nginx-deployment-618515232 11 11 11 7m
Призупинення та відновлення розгортання Deployment
Під час оновлення Deployment або планування оновлення ви можете призупинити розгортання для цього Deployment перед тим, як запустити одне чи кілька оновлень. Коли ви готові застосувати зміни, ви відновлюєте розгортання для Deployment. Цей підхід дозволяє вам застосовувати кілька виправлень між призупиненням та відновленням без зайвих розгортань.
Наприклад, для створеного Deployment:
Отримайте деталі Deployment:
kubectl get deploy
Вивід буде подібний до цього:
NAME DESIRED CURRENT UP-TO-DATE AVAILABLE AGE
nginx 3 3 3 3 1m
Отримайте стан розгортання:
kubectl get rs
Вивід буде подібний до цього:
NAME DESIRED CURRENT READY AGE
nginx-2142116321 3 3 3 1m
Призупиніть розгортання за допомогою такої команди:
kubectl rollout pause deployment/nginx-deployment
Вивід буде подібний до цього:
deployment.apps/nginx-deployment paused
Потім оновіть образ в Deployment:
kubectl set image deployment/nginx-deployment nginx=nginx:1.16.1
Вивід буде подібний до цього:
deployment.apps/nginx-deployment image updated
Зверніть увагу, що нове розгортання не розпочалося:
kubectl rollout history deployment/nginx-deployment
Початковий стан Deployment до призупинення його розгортання продовжить працювати, але нові оновлення до Deployment не матимуть жодного впливу, поки розгортання Deployment призупинено.
У кінці відновіть розгортання Deployment і спостерігайте, як новий ReplicaSet зʼявляється з усіма новими оновленнями:
NAME DESIRED CURRENT READY AGE
nginx-2142116321 0 0 0 2m
nginx-3926361531 3 3 3 28s
Примітка:
Ви не можете відкотити призупинене розгортання Deployment, доки ви його не відновите.
Статус Deployment
Deployment переходить через різні стани протягом свого життєвого циклу. Він може бути в процесі, коли виконується розгортання нового ReplicaSet, може бути завершеним або не зможе просуватися.
Deployment в процесі
Kubernetes позначає Deployment як в процесі (progressing), коли виконується одне з таких завдань:
Deployment створює новий ReplicaSet.
Deployment масштабує вгору свій новий ReplicaSet.
Deployment масштабує вниз свої старі ReplicaSets.
Нові Podʼи стають готовими або доступними (готові принаймні MinReadySeconds).
Коли розгортання стає "в процесі" (progressing), контролер Deployment додає стан з такими атрибутами до .status.conditions Deployment:
Ви можете відстежувати хід розгортання за допомогою kubectl rollout status.
Завершений Deployment
Kubernetes позначає Deployment як завершений (complete), коли він має такі характеристики:
Всі репліки, повʼязані з Deployment, були оновлені до останньої версії, яку ви вказали. Це означає, що всі запитані вами оновлення були завершені.
Всі репліки, повʼязані з Deployment, доступні.
Не працюють жодні старі репліки для Deployment.
Коли розгортання стає "завершеним" (complete), контролер Deployment встановлює стан з такими атрибутами в .status.conditions Deployment:
type: Progressing
status: "True"
reason: NewReplicaSetAvailable
Цей стан Progressing буде зберігати значення статусу "True" до тих пір, поки не буде запущено нове розгортання. Стан залишається незмінним навіть тоді, коли змінюється доступність реплік (що натомість впливає на стан Available).
Ви можете перевірити, чи завершено Deployment, використовуючи kubectl rollout status. Якщо розгортання завершилося успішно, kubectl rollout status повертає код виходу нуль (успіх).
kubectl rollout status deployment/nginx-deployment
Вивід буде подібний до цього:
Waiting for rollout to finish: 2 of 3 updated replicas are available...
deployment "nginx-deployment" successfully rolled out
і код виходу з kubectl rollout дорівнює 0 (успіх):
echo$?
0
Невдалий Deployment
Ваш Deployment може застрягти під час спроби розгорнути свій найновіший ReplicaSet і ніколи не завершитися. Це може статися через такі чинники:
Недостатні квоти
Збій проб readiness
Помилки завантаження образів
Недостатні дозволи
Діапазони обмежень (limit ranges)
Неправильна конфігурація середовища виконання застосунку
Один із способів виявлення цього стану — це вказати параметр крайнього терміну у специфікації вашого Deployment: (.spec.progressDeadlineSeconds). .spec.progressDeadlineSeconds вказує кількість секунд, протягом яких контролер Deployment чекатиме, перш ніж вказати (в статусі Deployment), що прогрес розгортання зупинився.
Ця команда kubectl встановлює специфікацію з progressDeadlineSeconds, щоб змусити контролер повідомляти про відсутність прогресу розгортання для Deployment після 10 хвилин:
Після того як крайній термін закінчився, контролер Deployment додає DeploymentCondition з такими атрибутами до .status.conditions Deployment:
type: Progressing
status: "False"
reason: ProgressDeadlineExceeded
Цей стан також може стати невдалим на ранніх етапах, і тоді він встановлюється в значення статусу "False" з причинами, такими як ReplicaSetCreateError. Крім того, після завершення розгортання крайній термін більше не враховується.
Kubernetes не вживає ніяких заходів щодо Deployment, що застряг, окрім повідомлення про стан у статусі з reason: ProgressDeadlineExceeded. Оркестратори вищого рівня можуть використовувати це і відповідним чином діяти, наприклад, відкотити Deployment до його попередньої версії.
Примітка:
Якщо ви призупините розгортання Deployment, Kubernetes не перевірятиме прогрес відносно вказаного вами крайнього терміну. Ви можете безпечно призупинити розгортання Deployment в середині процесу розгортання та відновити його, не активуючи стан перевищення крайнього терміну.
Ви можете зіткнутися з тимчасовими помилками у Deployment, або через низький таймаут, який ви встановили, або через будь-який інший вид помилок, який можна розглядати як тимчасовий. Наприклад, припустімо, що у вас недостатні квоти. Якщо ви
опишете Deployment, ви помітите такий розділ:
kubectl describe deployment nginx-deployment
Вивід буде подібний до цього:
<...>
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing True ReplicaSetUpdated
ReplicaFailure True FailedCreate
<...>
Якщо ви виконаєте kubectl get deployment nginx-deployment -o yaml, статус Deployment схожий на це:
Зрештою, коли крайній термін прогресу Deployment буде перевищений, Kubernetes оновить статус і причину стану Progressing:
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing False ProgressDeadlineExceeded
ReplicaFailure True FailedCreate
Ви можете вирішити проблему недостатньої квоти, зменшивши масштаб вашого Deployment, зменшивши масштаб інших контролерів, які ви можете виконувати, або збільшивши квоту у вашому просторі імен. Якщо ви задовольните умови квоти
і контролер Deployment завершить розгортання, ви побачите, що статус Deployment оновлюється успішним станом (status: "True" та reason: NewReplicaSetAvailable).
Conditions:
Type Status Reason
---- ------ ------
Available True MinimumReplicasAvailable
Progressing True NewReplicaSetAvailable
type: Available з status: "True" означає, що у вас є мінімальна доступність Deployment. Мінімальна доступність визначається параметрами, вказаними в стратегії розгортання. type: Progressing з status: "True" означає, що ваш Deployment або перебуває посеред розгортання і прогресує, або він успішно завершив свій прогрес, і доступна мінімально необхідна нова кількість реплік (див. причину стану для конкретики — у нашому випадку reason: NewReplicaSetAvailable означає, що Deployment завершено).
Ви можете перевірити, чи Deployment не зміг просуватися, за допомогою kubectl rollout status. kubectl rollout status повертає код виходу, відмінний від нуля, якщо Deployment перевищив крайній термін виконання.
kubectl rollout status deployment/nginx-deployment
Вивід буде подібний до цього:
Waiting for rollout to finish: 2 out of 3 new replicas have been updated...
error: deployment "nginx" exceeded its progress deadline
і код виходу з kubectl rollout дорівнює 1 (позначає помилку):
echo$?
1
Операції з невдалим Deployment
Всі дії, які застосовуються до завершеного Deployment, також застосовуються до невдалого Deployment. Ви можете масштабувати його вгору/вниз, відкотити на попередню ревізію або навіть призупинити, якщо вам потрібно застосувати кілька змін у шаблоні Podʼа Deployment.
Політика очищення
Ви можете встановити поле .spec.revisionHistoryLimit у Deployment, щоб вказати, скільки старих ReplicaSets для цього Deployment ви хочете зберегти. Решту прибере збір сміття у фоновому режимі. Типове значення становить 10.
Примітка:
Якщо явно встановити це поле на 0, буде виконано очищення всієї історії вашого Deployment, і цей Deployment не зможе виконати відкочування.
Очищення починається лише після того, як Deployment досягне завершеного стану. Якщо ви встановите .spec.revisionHistoryLimit у 0, будь-яке розгортання все одно спричинить створення нового ReplicaSet до того, як Kubernetes видалить старий.
Навіть з ненульовим обмеженням історії ревізій ви можете мати більше ReplicaSets, ніж ви налаштували. Наприклад, якщо Podʼи зациклені на збоях і з часом запускається кілька подій поетапного оновлення, ви можете мати більше ReplicaSets, ніж встановлено .spec.revisionHistoryLimit, оскільки Deployment ніколи не досягає завершеного стану.
Канаркові розгортання
Якщо ви хочете впроваджувати релізи для підмножини користувачів чи серверів, використовуючи Deployment, ви можете створити кілька Deployments, по одному для кожного релізу, дотримуючись канаркового шаблону, описаного в розділі керування ресурсами.
Як і з усіма іншими конфігураціями Kubernetes, у Deployment потрібні поля .apiVersion, .kind і .metadata. Для загальної інформації щодо роботи з файлами конфігурацій дивіться документи розгортання застосунків, налаштування контейнерів та використання kubectl для керування ресурсами.
Коли панель управління створює нові Podʼи для Deployment, .metadata.name Deployment є частиною основи для назв цих Podʼів. Назва Deployment повинна бути дійсним значенням DNS-піддомену, але це може призводити до неочікуваних результатів для імен хостів Podʼів. Для найкращої сумісності назва повинна відповідати суворішим правилам DNS-мітки.
.spec.template та .spec.selector — єдині обовʼязкові поля .spec.
.spec.template — це шаблон Podʼа. Він має точно таку саму схему, як і Pod, за винятком того, що він вкладений і не має apiVersion або kind.
Крім обовʼязкових полів для Podʼа, шаблон Podʼа в Deployment повинен вказувати відповідні мітки та відповідну політику перезапуску. Щодо міток, переконайтеся, що вони не перекриваються з іншими контролерами. Дивіться селектор.
.spec.replicas — це необовʼязкове поле, яке вказує кількість бажаних Podʼів. Стандартно встановлено значення 1.
Якщо ви вручну масштабуєте Deployment, наприклад, через kubectl scale deployment deployment --replicas=X, а потім ви оновлюєте цей Deployment на основі маніфесту (наприклад: виконуючи kubectl apply -f deployment.yaml), то застосування цього маніфесту перезаписує ручне масштабування, виконане раніше.
Якщо HorizontalPodAutoscaler (або будь-який аналогічний API для горизонтального масштабування) відповідає за масштабування Deployment, не встановлюйте значення в .spec.replicas.
Замість цього дозвольте панелі управління Kubernetes автоматично керувати полем .spec.replicas.
Селектор
.spec.selector — обовʼязкове поле, яке вказує селектор міток для Podʼів, на які спрямований цей Deployment.
.spec.selector повинен відповідати .spec.template.metadata.labels, інакше його відхилить API.
В API-версії apps/v1.spec.selector та .metadata.labels не набувають стандартно значення .spec.template.metadata.labels, якщо їх не задано. Тому їх слід задавати явно. Також слід зазначити, що .spec.selector неможливо змінити після створення Deployment в apps/v1.
Deployment може примусово завершити Podʼи, мітки яких відповідають селектору, якщо їх шаблон відмінний від .spec.template або якщо загальна кількість таких Podʼів перевищує .spec.replicas. Він запускає нові Podʼи з .spec.template, якщо кількість Podʼів менше, ніж бажана кількість.
Примітка:
Вам не слід створювати інші Podʼи, мітки яких відповідають цьому селектору, або безпосередньо, створюючи інший Deployment, або створюючи інший контролер, такий як ReplicaSet або ReplicationController. Якщо ви це зробите, перший Deployment вважатиме, що він створив ці інші Podʼи. Kubernetes не забороняє вам робити це.
Якщо у вас є кілька контролерів із селекторами, що перетинаються, контролери будуть конфліктувати між собою і не поводитимуться коректно.
Стратегія
.spec.strategy визначає стратегію, якою замінюються старі Podʼи новими. .spec.strategy.type може бути "Recreate" або "RollingUpdate". Типовим значенням є "RollingUpdate".
Перестворення Deployment
Всі поточні Podʼи примусово зупиняються та вилучаються, перш ніж створюються нові, коли .spec.strategy.type==Recreate.
Примітка:
Це гарантує завершення Podʼів перед створенням лише для оновлень. Якщо ви оновлюєте Deployment, всі Podʼи старої ревізії будуть негайно завершені. Успішне видалення очікується перед створенням будь-якого Podʼа нової ревізії. Якщо ви вручну видаляєте Pod, життєвим циклом керує ReplicaSet, і заміну буде створено негайно (навіть якщо старий Pod все ще перебуває в стані Terminating). Якщо вам потрібна гарантія "at most" для ваших Podʼів, вам слід розглянути використання StatefulSet.
Поетапне оновлення Deployment
Deployment оновлює Podʼи в режимі поетапного оновлення (поступово зменшуючи масштаб старих ReplicaSets і збільшуючи масштаб нового), коли .spec.strategy.type==RollingUpdate. Ви можете вказати maxUnavailable та maxSurge, щоб контролювати процес поетапного оновлення.
Максимум недоступних
.spec.strategy.rollingUpdate.maxUnavailable — це необовʼязкове поле, яке вказує максимальну кількість Podʼів, які можуть бути недоступні під час процесу оновлення. Значення може бути абсолютним числом (наприклад, 5) або відсотком від бажаної кількості Podʼів (наприклад, 10%). Абсолютне число обчислюється з відсотків округленням униз. Значення не може бути 0, якщо .spec.strategy.rollingUpdate.maxSurge дорівнює 0. Стандартне значення — 25%.
Наприклад, якщо це значення встановлено на 30%, старий ReplicaSet може бути зменшений до 70% від бажаної кількості Podʼів негайно, коли починається поетапне оновлення. Як тільки нові Podʼи готові, старий ReplicaSet може бути ще більше масштабований вниз, а після цього може бути збільшено масштаб нового ReplicaSet, забезпечуючи, що загальна кількість Podʼів, доступних у будь-який час під час оновлення, становить принаймні 70% від бажаної кількості Podʼів.
Максимальне перевищення
.spec.strategy.rollingUpdate.maxSurge — це необовʼязкове поле, яке вказує максимальну кількість Podʼів, які можуть бути створені понад бажану кількість Podʼів. Значення може бути абсолютним числом (наприклад, 5) або відсотком від бажаної кількості Podʼів (наприклад, 10%). Значення не може бути 0, якщо maxUnavailable дорівнює 0. Абсолютне число обчислюється з відсотків округленням угору. Стандартне значення - 25%.
Наприклад, якщо це значення встановлено на 30%, новий ReplicaSet може бути масштабований негайно, коли починається поетапне оновлення, таким чином, щоб загальна кількість старих і нових Podʼів не перевищувала 130% від бажаної кількості Podʼів. Щойно старі Podʼи буде завершено, новий ReplicaSet може бути масштабований ще більше, забезпечуючи, що загальна кількість Podʼів, які працюють в будь-який час під час оновлення, становить найбільше 130% від бажаної кількості Podʼів.
Ось кілька прикладів поетапного оновлення Deployment за допомогою maxUnavailable та maxSurge:
.spec.progressDeadlineSeconds — це необовʼязкове поле, яке вказує кількість секунд, протягом яких ви хочете чекати на просування вашого Deployment, перш ніж система повідомить, що Deployment не зміг просуватися, — це відображається як стан з type: Progressing, status: "False" та reason: ProgressDeadlineExceeded в статусі ресурсу. Контролер Deployment буде продовжувати повторювати спроби Deployment. Стандартно це значення становить 600.
Якщо вказано це поле, воно повинно бути більше, ніж значення .spec.minReadySeconds.
Min Ready Seconds
.spec.minReadySeconds — це необовʼязкове поле, яке вказує мінімальну кількість секунд, протягом яких новостворений Pod повинен бути готовим без збоїв будь-якого з його контейнерів, щоб вважатися доступним. Стандартно це значення становить 0 (Pod буде вважатися доступним, як тільки він буде готовий). Щоб дізнатися більше про те, коли Pod вважається готовим, див. Проби контейнерів.
Podʼи, що завершують роботу
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Podʼи, що завершують роботу через видалення або зменшення масштабу, можуть завершуватися тривалий час і впродовж цього періоду споживати додаткові ресурси. Як наслідок, загальна кількість усіх Podʼів може тимчасово перевищити .spec.replicas. Podʼи, що завершують роботу, можна відстежувати за допомогою поля .status.terminatingReplicas в Deployment.
Обмеження історії ревізій
Історія ревізій Deployment зберігається в ReplicaSets, якими він керує.
.spec.revisionHistoryLimit — це необовʼязкове поле, яке вказує кількість старих ReplicaSets, які слід зберігати для можливості відкочування. Ці старі ReplicaSets витрачають ресурси в etcd та захаращують вивід kubectl get rs. Конфігурація кожної ревізії Deployment зберігається в його ReplicaSets; отже, після видалення старого ReplicaSet ви втрачаєте можливість відкотитися до цієї ревізії Deployment. Стандартно буде збережено 10 старих ReplicaSets, але ідеальне значення залежить від частоти та стабільності нових Deployment.
Зокрема, встановлення цього поля рівним нулю означає, що всі старі ReplicaSets з 0 репліками буде очищено. У цьому випадку нове розгортання Deployment не може бути скасовано, оскільки його історія ревізій очищена.
Пауза
.spec.paused — це необовʼязкове булеве поле для призупинення та відновлення Deployment. Єдина відмінність між призупиненим Deployment і тим, який не призупинений, полягає в тому, що будь-які зміни в PodTemplateSpec призупиненого Deployment не викличуть нових розгортань, поки він призупинений. Deployment типово не призупинений під час створення.
Призначення ReplicaSet полягає в забезпеченні стабільного набору реплік Podʼів, які працюють у будь-який момент часу. Зазвичай ви визначаєте Deployment та дозволяєте цьому Deployment автоматично керувати ReplicaSets.
Призначення ReplicaSet полягає в забезпеченні стабільного набору реплік Podʼів, які працюють у будь-який момент часу. Тому ReplicaSet часто використовується для гарантування наявності вказаної кількості ідентичних Podʼів.
Як працює ReplicaSet
ReplicaSet визначається полями, включаючи селектор, який вказує, як ідентифікувати Podʼи, які він може отримати, кількість реплік, що вказує, скільки Podʼів він повинен підтримувати, і шаблон Podʼа, який вказує дані для нових Podʼів, які слід створити для відповідності критеріям кількості реплік. ReplicaSet виконує своє призначення, створюючи та видаляючи Podʼи за необхідності для досягнення їх бажаної кількості. Коли ReplicaSet потребує створення нових Podʼів, він використовує свій шаблон Podʼа.
ReplicaSet повʼязаний зі своїми Podʼами через поле metadata.ownerReferences Podʼа, яке вказує, якому ресурсу належить поточний обʼєкт. Усі Podʼи, які отримав ReplicaSet, мають у полі ownerReferences ідентифікаційну інформацію ReplicaSet, що ними володіє. Завдяки цим посиланням ReplicaSet знає про стан Podʼів, які він підтримує, і планує дії відповідно.
ReplicaSet визначає нові Podʼи для отримання за допомогою свого селектора. Якщо існує Pod, який не має OwnerReference або OwnerReference не є контролером, і він відповідає селектору ReplicaSet, цей ReplicaSet негайно його отримає.
Коли використовувати ReplicaSet
ReplicaSet забезпечує наявність вказаної кількості реплік Podʼів у будь-який момент часу. Проте Deployment є концепцією вищого рівня, яка керує ReplicaSets і надає декларативні оновлення для Podʼів разом із багатьма іншими корисними можливостями. Тому ми рекомендуємо використовувати Deployments замість безпосереднього використання ReplicaSets, хіба що вам потрібне власне оркестрування оновлень або оновлення взагалі не потрібні.
Це означає, що вам, можливо, ніколи не доведеться працювати з обʼєктами ReplicaSet: використовуйте Deployment та визначайте ваш застосунок у розділі spec.
apiVersion:apps/v1kind:ReplicaSetmetadata:name:frontendlabels:app:guestbooktier:frontendspec:# modify replicas according to your casereplicas:3selector:matchLabels:tier:frontendtemplate:metadata:labels:tier:frontendspec:containers:- name:php-redisimage:us-docker.pkg.dev/google-samples/containers/gke/gb-frontend:v5
Якщо зберегти цей маніфест у файл frontend.yaml та застосувати його до кластера Kubernetes, буде створено визначений ReplicaSet та Podʼи, якими він керує.
Хоча ви можете без проблем створювати окремі Podʼи, наполегливо рекомендується переконатися, що ці окремі Podʼи не мають міток, які відповідають селектору одного з ваших ReplicaSets. Причина цього полягає в тому, що ReplicaSet не обмежується володінням Podʼами, зазначеними в його шаблоні — він може отримати інші Podʼи у спосіб, визначений в попередніх розділах.
Візьмемо приклад попереднього ReplicaSet для фронтенду та Podʼів, визначених у цьому маніфесті:
Оскільки ці Podʼи не мають контролера (або будь-якого обʼєкта) як власника та відповідають селектору ReplicaSet для фронтенду, вони одразу перейдуть у його володіння.
Припустимо, ви створюєте Podʼи після того, як ReplicaSet для фронтенду було розгорнуто і він налаштував свої початкові репліки Podʼів для виконання вимог до кількості реплік:
Ви побачите, що ReplicaSet отримав Podʼи та створив нові лише відповідно до свого опису, доки кількість його нових Podʼів та оригінальних не відповідала його бажаній кількості. Якщо отримати Podʼи:
kubectl get pods
Вивід покаже, що:
NAME READY STATUS RESTARTS AGE
frontend-hmmj2 1/1 Running 0 9s
pod1 1/1 Running 0 36s
pod2 1/1 Running 0 36s
Таким чином, ReplicaSet може володіти неоднорідним набором Podʼів.
Написання маніфесту ReplicaSet
Як і усі інші обʼєкти API Kubernetes, ReplicaSet потребує полів apiVersion, kind та metadata. Для ReplicaSet kind завжди є ReplicaSet.
Коли панель управління створює нові Podʼи для ReplicaSet, .metadata.name ReplicaSet є частиною основи для назв цих Podʼів. Назва ReplicaSet повинна бути дійсним значенням DNS-піддомену, але це може призвести до неочікуваних результатів для імен хостів Podʼів. Для найкращої сумісності назва має відповідати суворішим правилам для DNS-мітки.
.spec.template — це шаблон Podʼа, який також повинен мати встановлені мітки. У нашому прикладі frontend.yaml ми мали одну мітку: tier: frontend. Будьте обережні, щоб селектори не перекривалися з селекторами інших контролерів, інакше вони можуть спробувати перейняти цей Pod.
Для поля політики перезапуску шаблону, .spec.template.spec.restartPolicy, допустимим є тільки значення Always, яке є стандартним.
Селектор Podʼа
Поле .spec.selector є селектором міток. Як обговорювалося раніше, це мітки, які використовуються для ідентифікації потенційних Podʼів для володіння. У нашому прикладі frontend.yaml селектор був:
matchLabels:tier:frontend
У ReplicaSet .spec.template.metadata.labels має відповідати spec.selector, інакше він буде відхилений API.
Примітка:
Для 2 ReplicaSets, які вказують однаковий .spec.selector, але різні поля .spec.template.metadata.labels та .spec.template.spec, кожен ReplicaSet ігнорує Podʼи, створені іншим ReplicaSet.
Репліки
Ви можете вказати, скільки Podʼів мають виконуватись одночасно, встановивши значення .spec.replicas. ReplicaSet буде створювати/видаляти свої Podʼи, щоб кількість Podʼів відповідала цьому числу.
Якщо ви не вказали .spec.replicas, то типово значення дорівнює 1.
Робота з ReplicaSets
Видалення ReplicaSet та його Podʼів
Щоб видалити ReplicaSet і всі його Podʼи, використовуйте kubectl delete. Збирач сміття стандартно автоматично видаляє всі залежні Podʼи.
Під час використання REST API або бібліотеки client-go вам потрібно встановити propagationPolicy в Background або Foreground в опції -d. Наприклад:
Ви можете видалити ReplicaSet, не впливаючи на його Podʼи, за допомогою kubectl delete з опцією --cascade=orphan. Під час використання REST API або бібліотеки client-go вам потрібно встановити propagationPolicy в Orphan. Наприклад:
Після видалення оригіналу ви можете створити новий ReplicaSet для заміни. Поки старий та новий .spec.selector однакові, новий перейме старі Podʼи. Однак він не намагатиметься привести наявні Podʼи у відповідність до нового, іншого шаблону Podʼа. Для оновлення Podʼів до нової специфікації у контрольований спосіб використовуйте Deployment, оскільки ReplicaSets безпосередньо не підтримують поетапне оновлення.
Podʼи, що завершують роботу
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Podʼи, що завершують роботу через видалення або зменшення масштабу, можуть завершуватися тривалий час і впродовж цього періоду споживати додаткові ресурси. Як наслідок, загальна кількість усіх Podʼів може тимчасово перевищити .spec.replicas. Podʼи, що завершують роботу, можна відстежувати за допомогою поля .status.terminatingReplicas в ReplicaSet.
Ізолювання Podʼів від ReplicaSet
Ви можете видалити Podʼи з ReplicaSet, змінивши їх мітки. Цей метод може бути використаний для вилучення Podʼів з обслуговування з метою налагодження, відновлення даних тощо. Podʼи, які вилучаються цим способом, будуть автоматично замінені (за умови, що кількість реплік також не змінюється).
Масштабування ReplicaSet
ReplicaSet можна легко масштабувати вгору або вниз, просто оновивши поле .spec.replicas. Контролер ReplicaSet гарантує, що бажана кількість Podʼів з відповідним селектором міток доступна та працює.
Під час зменшення масштабу контролер ReplicaSet вибирає Podʼи для видалення, сортуючи доступні Podʼи, щоб визначити, які Podʼи видаляти в першу чергу, за таким загальним алгоритмом:
Перш за все прибираються Podʼи, що перебувають в очікуванні (і непридатні для планування).
Якщо встановлено анотацію controller.kubernetes.io/pod-deletion-cost, то Pod із меншим значенням буде видалено першим.
Podʼи на вузлах з більшою кількістю реплік йдуть перед Podʼами на вузлах з меншою кількістю реплік.
Якщо часи створення Podʼів відрізняються, то Pod, створений пізніше, йде перед старішим Podʼом (часи створення групуються за цілочисельною логарифмічною шкалою).
Якщо все вище вказане збігається, вибір випадковий.
Вартість видалення Podʼа
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.22
За допомогою анотації controller.kubernetes.io/pod-deletion-cost користувачі можуть встановити уподобання щодо порядку видалення Podʼів під час зменшення масштабу ReplicaSet.
Анотація повинна бути встановлена на Podʼі, діапазон — [-2147483648, 2147483647]. Вона представляє вартість видалення Podʼа порівняно з іншими Podʼами, які належать тому ж ReplicaSet. Podʼи з меншою вартістю видалення видаляються раніше за Podʼи з більшою вартістю видалення.
Неявне значення для цієї анотації для Podʼів, які його не мають, — 0; допустимі відʼємні значення. Неприпустимі значення будуть відхилені API-сервером.
Ця функція перебуває на стадії бета та типово увімкнена. Ви можете вимкнути її, використовуючи функціональну можливістьPodDeletionCost як в kube-apiserver, так і в kube-controller-manager.
Примітка:
Це враховується за принципом best-effort, тому порядок видалення Podʼів не гарантується.
Користувачам слід уникати частого оновлення анотації, такого як оновлення її на основі значення метрики, оскільки це призведе до значного числа оновлень Podʼів на apiserver.
Приклад використання
Різні Podʼи застосунку можуть мати різний рівень використання. Під час зменшення масштабу застосунок може віддавати перевагу видаленню Podʼів з меншим використанням. Щоб уникнути частого оновлення Podʼів, застосунок повинен оновити controller.kubernetes.io/pod-deletion-cost один раз перед зменшенням масштабу (встановлення анотації в значення, пропорційне рівню використання Podʼа). Це працює, якщо сам застосунок контролює масштабування вниз; наприклад, Pod-драйвер розгортання Spark.
ReplicaSet як ціль горизонтального автомасштабування Podʼа
ReplicaSet також може бути ціллю для горизонтального автомасштабування Podʼа (HPA). Іншими словами, ReplicaSet може автоматично масштабуватися за допомогою HPA. Ось приклад HPA, який застосовується до ReplicaSet, створеного в попередньому прикладі.
Збереження цього маніфесту в hpa-rs.yaml та його застосування до кластера Kubernetes повинно створити визначене HPA, яке автоматично змінює масштаб цільового ReplicaSet залежно від використання CPU реплікованими Podʼами.
Deployment — це обʼєкт, який може володіти ReplicaSets і оновлювати їх та їхні Podʼи через декларативні поетапні оновлення на стороні сервера. Хоча ReplicaSets можуть використовуватися незалежно, на сьогодні вони головним чином використовуються Deployments як механізм для оркестрування створення, видалення та оновлення Podʼів. Коли ви використовуєте Deployments, вам не потрібно турбуватися про керування ReplicaSets, які вони створюють. Deployments володіють і керують своїми ReplicaSets. Таким чином, рекомендується використовувати Deployments, коли вам потрібні ReplicaSets.
Окремі Podʼи
На відміну від випадку, коли користувач безпосередньо створює Podʼи, ReplicaSet замінює Podʼи, які видаляються або завершуються з будь-якої причини, такої як відмова вузла чи обслуговування вузла з порушенням роботи, наприклад, оновлення ядра. З цієї причини ми рекомендуємо використовувати ReplicaSet, навіть якщо ваш застосунок вимагає лише одного Podʼа. Подібно до наглядача процесів, він наглядає за кількома Podʼами на різних вузлах замість окремих процесів на одному вузлі. ReplicaSet делегує перезапуск локальних контейнерів до агента на вузлі, такого як Kubelet.
Job
Використовуйте Job замість ReplicaSet для Podʼів, які повинні завершитися самостійно (тобто пакетні завдання).
DaemonSet
Використовуйте DaemonSet замість ReplicaSet для Podʼів, які надають функції на рівні машини, такі як моніторинг машини або логування машини. Ці Podʼи мають термін служби, який повʼязаний з терміном служби машини: Pod повинен працювати на машині перед тим, як інші Podʼи почнуть роботу, і їх можна безпечно завершити, коли машина готова до перезавантаження/вимкнення.
ReplicationController
ReplicaSets є наступниками ReplicationControllers. Обидва мають те саме призначення та поводяться схоже, за винятком того, що ReplicationController не підтримує вимоги селектора на основі множини, як описано в посібнику про мітки. Тому ReplicaSets мають перевагу над ReplicationControllers.
ReplicaSet — це ресурс верхнього рівня у REST API Kubernetes. Прочитайте визначення обʼєкта
ReplicaSet, щоб зрозуміти API для ReplicaSets.
Дізнайтеся про PodDisruptionBudget та як ви можете використовувати його для керування доступністю застосунку під час порушень.
6.4.2.3 - StatefulSets
StatefulSet запускає групу Podʼів і зберігає стійку ідентичність для кожного з цих Podʼів. Це корисно для керування застосунками, які потребують постійного сховища або стабільної, унікальної мережевої ідентичності.
StatefulSet — це обʼєкт API робочого навантаження, який використовується для керування застосунками зі збереженням стану.
StatefulSet керує розгортанням і масштабуванням групи Podʼів, і забезпечує гарантії щодо порядку та унікальності цих Podʼів.
Як і Deployment, StatefulSet керує Podʼами, які базуються на ідентичній специфікації контейнерів. На відміну від Deployment, StatefulSet зберігає постійну ідентичність для кожного свого Podʼа. Ці Podʼи створюються за однаковою специфікацією, але не є взаємозамінними: у кожного є постійний ідентифікатор, який він зберігає під час будь-якого перепланування.
Якщо ви хочете використовувати томи для забезпечення постійності вашого робочого навантаження, ви можете використовувати StatefulSet як частину рішення. Хоча окремі Podʼи в StatefulSet можуть вийти з ладу, постійні ідентифікатори Podʼів полегшують зіставлення наявних томів із новими Podʼами, які замінюють ті, що вийшли з ладу.
Використання StatefulSets
StatefulSets є цінним інструментом для застосунків, які потребують одного або кількох із таких елементів:
Стабільних, унікальних мережевих ідентифікаторів.
Стабільного, постійного сховища.
Упорядкованого, плавного розгортання та масштабування.
Тут «стабільний» означає збереження під час (пере)планування Podʼів. Якщо застосунок не потребує стабільних ідентифікаторів або упорядкованого розгортання, видалення чи масштабування, вам слід розгортати його за допомогою обʼєкта робочого навантаження, який забезпечує набір реплік без збереження стану (stateless). Deployment або ReplicaSet можуть краще підійти для ваших stateless-потреб.
Обмеження
Сховище для певного Podʼа має бути виділене PersistentVolume Provisioner на основі запитаного storage class або попередньо виділене адміністратором.
Видалення та/або масштабування StatefulSet вниз не призведе до видалення томів, повʼязаних з StatefulSet. Це зроблено для забезпечення безпеки даних, яка загалом є важливішою, ніж автоматичне очищення всіх повʼязаних ресурсів StatefulSet.
Наразі для StatefulSets обовʼязково потрібний Headless Service, щоб відповідати за мережеву ідентичність Podʼів. Ви відповідаєте за створення цього Service.
StatefulSets не надають жодних гарантій щодо завершення роботи Podʼів під час видалення StatefulSet. Для досягнення упорядкованого та плавного завершення роботи Podʼів у StatefulSet можна зменшити масштаб StatefulSet до 0 перед видаленням.
apiVersion:v1kind:Servicemetadata:name:nginxlabels:app:nginxspec:ports:- port:80name:webclusterIP:Noneselector:app:nginx---apiVersion:apps/v1kind:StatefulSetmetadata:name:webspec:selector:matchLabels:app:nginx# має збігатись з .spec.template.metadata.labelsserviceName:"nginx"replicas:3# by default is 1minReadySeconds:10# by default is 0template:metadata:labels:app:nginx# має збігатись з .spec.selector.matchLabelsspec:terminationGracePeriodSeconds:10containers:- name:nginximage:registry.k8s.io/nginx-slim:0.24ports:- containerPort:80name:webvolumeMounts:- name:wwwmountPath:/usr/share/nginx/htmlvolumeClaimTemplates:- metadata:name:wwwspec:accessModes:["ReadWriteOnce"]storageClassName:"my-storage-class"resources:requests:storage:1Gi
Примітка:
Цей приклад використовує режим доступу ReadWriteOnce для простоти. Для промислового використання проєкт Kubernetes рекомендує натомість використовувати режим доступу ReadWriteOncePod.
У вищенаведеному прикладі:
Headless Service із назвою nginx використовується для керування мережевим доменом.
StatefulSet із назвою web має Spec, який вказує на те, що буде запущено 3 репліки контейнера nginx в унікальних Podʼах.
volumeClaimTemplates забезпечуватиме стабільне сховище за допомогою PersistentVolumes, виділених PersistentVolume Provisioner.
Назва обʼєкта StatefulSet повинна бути дійсною DNS-міткою.
Селектор Podʼів
Ви повинні встановити поле .spec.selector StatefulSet так, щоб воно збігалося з мітками його .spec.template.metadata.labels. Якщо не вказати відповідний селектор Podʼів, під час створення StatefulSet виникне помилка валідації.
Шаблони заявок на томи
Ви можете встановити поле .spec.volumeClaimTemplates, щоб створити PersistentVolumeClaim. Це забезпечить стабільне сховище для StatefulSet, якщо:
StorageClass, вказаний для заявки на том, налаштовано на використання динамічного виділення.
Кластер вже містить PersistentVolume з правильним StorageClass та достатньою кількістю доступного місця для зберігання.
Мінімальний час готовності
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
.spec.minReadySeconds є необовʼязковим полем, яке вказує мінімальну кількість секунд, протягом яких новостворений Pod повинен працювати та бути готовим без збоїв будь-якого з його контейнерів, щоб вважатися доступним. Це використовується для перевірки прогресу розгортання під час використання стратегії поетапного оновлення. Це поле стандартно дорівнює 0 (Pod вважатиметься доступним одразу після готовності). Докладніше про те, коли Pod вважається готовим, див. Проби контейнера.
Ідентичність Podʼа
Podʼи StatefulSet мають унікальну ідентичність, яка складається з порядкового номера, стабільного мережевого ідентифікатора та стабільного сховища. Ця ідентичність залишається прикріпленою до Podʼа незалежно від того, на який вузол його (пере)заплановано.
Порядковий індекс
Для StatefulSet з N реплік кожному Podʼу в StatefulSet буде призначено цілочисельний порядковий номер, унікальний у наборі. Стандартно Podʼам буде призначено порядкові номери від 0 до N-1. Контролер StatefulSet також додасть мітку Podʼа з цим індексом: apps.kubernetes.io/pod-index.
Початковий порядковий номер
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.31; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.31. It was first available in the v1.26 release.
.spec.ordinals — це необовʼязкове поле, яке дозволяє налаштувати цілочисельні порядкові номери, призначені кожному Podʼу. Стандартно воно встановлено в nil. У межах цього поля ви можете налаштувати такі параметри:
.spec.ordinals.start: Якщо встановлено поле .spec.ordinals.start, Podʼам будуть призначені порядкові номери від .spec.ordinals.start до .spec.ordinals.start + .spec.replicas - 1.
Стабільний мережевий ідентифікатор
Кожен Pod у StatefulSet отримує імʼя хоста з назви StatefulSet та порядкового номера Podʼа. Шаблон для створеного імені хоста має вигляд $(назва statefulset)-$(порядковий номер). У наведеному вище прикладі буде створено три Podʼи з назвами web-0,web-1,web-2. StatefulSet може використовувати Headless Service для керування доменом своїх Podʼів. Домен, яким керує цей Service, має вигляд: $(назва сервісу).$(простір імен).svc.cluster.local, де "cluster.local" — це домен кластера. Під час створення кожен Pod отримує відповідний DNS-піддомен, який має вигляд: $(назва Podʼа).$(домен керівного сервісу), де керівний сервіс визначається полем serviceName у StatefulSet.
Залежно від того, як налаштований DNS у вашому кластері, ви, можливо, не зможете одразу знайти DNS-імʼя нового Podʼа. Це можливо, коли інші клієнти в кластері вже відправили запити на імʼя хоста Podʼа до його створення. Негативне кешування (звичайне для DNS) означає, що результати попередніх невдалих пошуків запамʼятовуються та використовуються повторно навіть після того, як Pod вже працює, принаймні кілька секунд.
Якщо вам потрібно виявити Podʼи негайно після їх створення, у вас є кілька варіантів:
Запитуйте API Kubernetes безпосередньо (наприклад, використовуючи watch), а не покладаючись на DNS-запити.
Зменште час кешування у вашому постачальнику DNS Kubernetes (зазвичай це означає редагування ConfigMap для CoreDNS, який зараз кешує протягом 30 секунд).
Як зазначено в розділі Обмеження, ви відповідаєте за створення Headless Service, відповідального за мережеву ідентичність Podʼів.
Ось деякі приклади варіантів вибору домену кластера, назви Service, назви StatefulSet та того, як це впливає на DNS-імена Podʼів StatefulSet.
Домен кластера
Service (ns/назва)
StatefulSet (ns/назва)
Домен StatefulSet
DNS Podʼа
Імʼя хоста Podʼа
cluster.local
default/nginx
default/web
nginx.default.svc.cluster.local
web-{0..N-1}.nginx.default.svc.cluster.local
web-{0..N-1}
cluster.local
foo/nginx
foo/web
nginx.foo.svc.cluster.local
web-{0..N-1}.nginx.foo.svc.cluster.local
web-{0..N-1}
kube.local
foo/nginx
foo/web
nginx.foo.svc.kube.local
web-{0..N-1}.nginx.foo.svc.kube.local
web-{0..N-1}
Примітка:
Домен кластера буде встановлено як cluster.local, якщо не буде інших налаштувань.
Стабільне сховище
Для кожного запису VolumeClaimTemplate, визначеного в StatefulSet, кожен Pod отримує один PersistentVolumeClaim. У прикладі з nginx кожен Pod отримує один PersistentVolume з StorageClass my-storage-class та 1 GiB виділеного сховища. Якщо StorageClass не вказано, використовуватиметься стандартний StorageClass. Коли Pod (пере)планується на вузол, його volumeMounts монтує PersistentVolumes, повʼязані із його PersistentVolume Claims. Зауважте, що PersistentVolumes, повʼязані із PersistentVolume Claims Podʼів, не видаляються під час видалення Podʼів чи StatefulSet. Це слід робити вручну.
Мітка назви Podʼа
Коли контролер StatefulSet створює Pod, він додає мітку statefulset.kubernetes.io/pod-name, яка дорівнює назві Podʼа. Ця мітка дозволяє прикріплювати Service до конкретного Podʼа в StatefulSet.
Мітка індексу Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.32; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.32. It was first available in the v1.28 release.
Коли контролер StatefulSet створює Pod, новий Pod отримує мітку apps.kubernetes.io/pod-index. Значення цієї мітки — це порядковий індекс Podʼа. Ця мітка дозволяє спрямовувати трафік до певного індексу Podʼа, фільтрувати логи/метрики за допомогою мітки індексу Podʼа тощо. Зверніть увагу, що функціональна можливість PodIndexLabel для цієї функції стандартно увімкнена та заблокована; щоб вимкнути її, користувачам доведеться використовувати емуляцію сервера версії v1.31.
Гарантії розгортання та масштабування
Для StatefulSet із N реплік під час розгортання Podʼи створюються послідовно, у порядку від {0..N-1}.
Під час видалення Podʼів вони завершуються у зворотному порядку, від {N-1..0}.
Перед тим як застосувати масштабування до Podʼа, всі його попередники повинні бути в стані Running та Ready. Якщо встановлено .spec.minReadySeconds, попередники повинні бути доступними (готовими принаймні протягом minReadySeconds).
Перед тим як Pod буде завершено, всі його наступники повинні бути повністю зупинені.
StatefulSet не повинен вказувати pod.Spec.TerminationGracePeriodSeconds рівним 0. Така практика небезпечна і настійно не рекомендується. Докладніше дивіться в розділі примусове видалення Podʼів StatefulSet.
Коли створюється наведений вище приклад nginx, три Podʼи будуть розгорнуті в порядку web-0, web-1, web-2. web-1 не буде розгорнуто, поки web-0 не буде в стані Running та Ready, і web-2 не буде розгорнуто, поки web-1 не буде в стані Running та Ready. Якщо web-0 зазнає збою після того, як web-1 перейде в стан Running та Ready, але до запуску web-2, web-2 не буде запущено, поки web-0 не буде успішно перезапущено і він не перейде в стан Running та Ready.
Якщо користувач масштабує розгорнутий приклад, застосовуючи патч до StatefulSet так, щоб replicas=1, спочатку буде завершено web-2. web-1 не буде завершено, поки web-2 повністю не зупиниться і не буде видалений. Якщо web-0 зазнає збою після того, як web-2 вже завершено і повністю зупинено, але перед завершенням web-1, web-1 не буде завершено, поки web-0 не перейде в стан Running та Ready.
Політики керування Podʼами
StatefulSet дозволяє послабити його гарантії послідовності, зберігаючи при цьому його гарантії унікальності та ідентичності за допомогою поля .spec.podManagementPolicy.
Політика керування Podʼами "OrderedReady"
OrderedReady є типовим значенням політики керування Podʼами для StatefulSet. Вона реалізує поведінку, описану в розділі Гарантії розгортання та масштабування.
Політика керування Podʼами "Parallel"
Parallel вказує контролеру StatefulSet запускати або завершувати всі Podʼи паралельно і не чекати, поки Podʼи перейдуть у стан Running та Ready або повністю завершаться, перед запуском або завершенням іншого Podʼа.
Для операцій масштабування це означає, що всі Podʼи створюються або завершуються одночасно.
Для поетапних оновлень, коли .spec.updateStrategy.rollingUpdate.maxUnavailable більше 1, контролер StatefulSet завершує і створює до maxUnavailable Podʼів одночасно (також відоме як «bursting»). Це може прискорити оновлення, але може призвести до того, що Podʼи стануть готовими в неправильному порядку, що може бути неприйнятним для застосунків, які вимагають суворого порядку.
Стратегії оновлення
Поле .spec.updateStrategy обʼєкта StatefulSet дозволяє налаштовувати та вимикати автоматизовані поетапні оновлення для контейнерів, міток, ресурсів (запити/обмеження) та анотацій для Podʼів у StatefulSet. Є три можливих значення:
OnDelete
Коли поле .spec.updateStrategy.type StatefulSet встановлено в OnDelete, контролер StatefulSet не буде автоматично оновлювати Podʼи в StatefulSet. Користувачам необхідно вручну видаляти Podʼи, щоб спричинити створення контролером нових Podʼів, які відображають зміни, внесені в .spec.template StatefulSet.
RollingUpdate
Стратегія оновлення RollingUpdate реалізує автоматизовані поетапні оновлення для Podʼів у StatefulSet. Це значення є стандартною стратегією оновлення.
Recreate
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the StatefulSetRecreateStrategy feature gate for all relevant components in your cluster.
Стратегія оновлення Recreate видаляє всі Podʼи StatefulSet перед створенням нових Podʼів, які відображають зміни, внесені в .spec.template StatefulSet. Використання цієї стратегії вимагає увімкнення функціональної можливості StatefulSetRecreateStrategy. Див. Recreate для деталей.
Поетапні оновлення
Коли поле .spec.updateStrategy.type StatefulSet встановлено на RollingUpdate, контролер StatefulSet буде видаляти та знову створювати кожен Pod у StatefulSet. Він буде продовжувати в тому ж порядку, як Podʼи завершують роботу (від найбільшого індексу до найменшого), оновлюючи кожен Pod по одному.
Панель управління Kubernetes чекає, доки оновлений Pod буде переведений в стан Running та Ready, перш ніж оновити його попередника. Якщо ви встановили .spec.minReadySeconds (див. Мінімальний час готовності), панель управління також чекає вказану кількість секунд після того, як Pod стане готовим, перш ніж перейти далі.
Поетапні оновлення частинами
Стратегію оновлення RollingUpdate можна поділити на частини, вказавши .spec.updateStrategy.rollingUpdate.partition. Якщо вказано розділ, всі Podʼи з індексом, який більший або рівний розділу, будуть оновлені при оновленні .spec.template StatefulSet. Усі Podʼи з індексом, який менший за розділ, не будуть оновлені та, навіть якщо вони будуть видалені, вони будуть створені заново з попередньою версією. Якщо .spec.updateStrategy.rollingUpdate.partition StatefulSet більше, ніж .spec.replicas, оновлення .spec.template не буде розповсюджуватися на його Podʼи. У більшості випадків вам не знадобиться використовувати розділ, але він корисний, якщо ви хочете підготувати оновлення, розгорнути канарку або виконати розгортання за фазами.
Максимальна кількість недоступних Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35
Ви можете контролювати максимальну кількість Podʼів, які можуть бути недоступні під час оновлення, вказавши поле .spec.updateStrategy.rollingUpdate.maxUnavailable. Значення може бути абсолютним числом (наприклад, 5) або відсотком від бажаних Podʼів (наприклад, 10%). Абсолютне число обчислюється з відсоткового значення заокругленням вгору. Це поле не може бути 0. Стандартне значення — 1.
Це поле застосовується до всіх Podʼів у діапазоні від 0 до replicas - 1. Якщо є будь-який недоступний Pod у діапазоні від 0 до replicas - 1, він буде враховуватися в maxUnavailable.
Примітка:
Поле maxUnavailable перебуває на стадії бета і є стандартно увімкненим.
Примусове відкочування
Під час використання поетапних оновлень зі стандартною політикою керування Podʼами (OrderedReady) можна потрапити в несправний стан, який вимагає ручного втручання для виправлення.
Якщо ви оновлюєте шаблон Podʼа до конфігурації, яка ніколи не досягає стану Running та Ready (наприклад, через поганий бінарний файл або помилку конфігурації на рівні застосунку), StatefulSet припинить розгортання і залишиться у стані очікування.
У цьому стані недостатньо повернути шаблон Podʼа до справної конфігурації. Через відомий дефект, StatefulSet продовжуватиме очікувати, доки неробочий Pod стане готовим (що ніколи не відбувається), перед тим як спробувати повернути його до робочої конфігурації.
Після повернення до шаблону вам також слід видалити будь-які Podʼи, які StatefulSet вже намагався запустити з поганою конфігурацією. Після цього StatefulSet почне перестворювати Podʼи, використовуючи відновлений шаблон.
Recreate
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the StatefulSetRecreateStrategy feature gate for all relevant components in your cluster.
Коли поле .spec.updateStrategy.type StatefulSet встановлено на Recreate, контролер StatefulSet видаляє всі Podʼи StatefulSet одночасно та чекає, доки вони повністю завершать роботу, перш ніж створювати будь-які нові Podʼи з оновленого .spec.template. На відміну від RollingUpdate, стара та нова ревізії Podʼа ніколи не працюють одночасно, тому ця стратегія призводить до простою протягом усього оновлення. Це дзеркально відображає стратегію Recreate для Deployment і є корисною для застосунків, які не можуть запускати дві версії одночасно, наприклад, для робочих навантажень, які потребують ексклюзивного доступу до спільного ресурсу або використовують формат на диску, несумісний між версіями.
Видалення завжди прибирає всі Podʼи разом, незалежно від політики керування Podʼами. Після того, як всі Podʼи завершать роботу, нові Podʼи створюються відповідно до цієї політики: з OrderedReady (стандартно) Podʼи перестворюються по одному, у порядку зростання індексів, чекаючи, доки кожен стане Running та Ready, перш ніж створювати наступний; з Parallel всі Podʼи перестворюються одночасно.
Оскільки це альфа-функція, ви повинні увімкнути функціональну можливість StatefulSetRecreateStrategy на kube-controller-manager та kube-apiserver, щоб використовувати цю стратегію.
Історія ревізій
ControllerRevision — це ресурс API Kubernetes, який використовується контролерами, такими як контролер StatefulSet, для відстеження історичних змін конфігурації.
StatefulSets використовують ControllerRevisions для ведення історії ревізій, що дозволяє виконувати відкочування і відстежувати версії.
Як StatefulSets відстежують зміни за допомогою ControllerRevisions
Коли ви оновлюєте шаблон Podʼа StatefulSet (spec.template), контролер StatefulSet:
Готує новий обʼєкт ControllerRevision
Зберігає знімок шаблону Podʼа і метаданих
Присвоює інкрементний номер ревізії
Ключові властивості
Дивіться ControllerRevision, щоб дізнатися більше про ключові властивості та інші деталі.
Керування історією ревізій
Керуйте збереженими ревізіями за допомогою .spec.revisionHistoryLimit:
apiVersion:apps/v1kind:StatefulSetmetadata:name:webappspec:revisionHistoryLimit:5# Зберігати останні 5 ревізій# ... інші поля spec ...
Стандартно: 10 ревізій зберігаються, якщо не вказано інше
Очищення: найстаріші ревізії прибирає збір сміття, коли перевищено обмеження
Виконання відкочування
Ви можете повернутися до попередньої конфігурації за допомогою:
# Переглянути історію ревізійkubectl rollout history statefulset/webapp
# Відкотитися до певної ревізіїkubectl rollout undo statefulset/webapp --to-revision=3
Це:
Застосує шаблон Podʼа з ревізії 3
Створить новий ControllerRevision з оновленим номером ревізії
Перевірка ControllerRevisions
Щоб переглянути повʼязані ControllerRevisions:
# Перелічити всі ревізії для StatefulSetkubectl get controllerrevisions -l app.kubernetes.io/name=webapp
# Переглянути детальну конфігурацію конкретної ревізіїkubectl get controllerrevision/webapp-3 -o yaml
Найкращі практики
Політика зберігання
Встановіть revisionHistoryLimit в діапазоні 5–10 для більшості робочих навантажень.
Збільшуйте значення тільки в разі потреби в глибокій історії відкочування.
Моніторинг
Регулярно перевіряйте ревізії за допомогою:
kubectl get controllerrevisions
Налаштуйте сповіщення про швидке зростання кількості ревізій.
Уникайте
Ручного редагування обʼєктів ControllerRevision.
Використання ревізій як механізму резервного копіювання (використовуйте справжні інструменти резервного копіювання).
Встановлення revisionHistoryLimit: 0 (вимикає можливість відкочування).
Збереження PersistentVolumeClaim
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.32; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.32. It was first available in the v1.23 release.
Необовʼязкове поле .spec.persistentVolumeClaimRetentionPolicy контролює, чи і як видаляються PVC під час життєвого циклу StatefulSet. Вам потрібно увімкнути функціональну можливістьStatefulSetAutoDeletePVC на API-сервері та controller manager, щоб використовувати це поле. Після увімкнення ви можете налаштувати дві політики для кожного StatefulSet:
whenDeleted
Налаштовує поведінку збереження томів, яка застосовується під час видалення StatefulSet.
whenScaled
Налаштовує поведінку збереження томів, яка застосовується під час зменшення кількості реплік у StatefulSet, наприклад, під час зменшення масштабу набору.
Для кожної політики, яку ви можете налаштувати, ви можете встановити значення Delete або Retain.
Delete
PVC, створені за допомогою volumeClaimTemplate StatefulSet, видаляються для кожного Podʼа, на який впливає політика. З політикою whenDeleted всі PVC від volumeClaimTemplate видаляються після того, як їхні Podʼи були видалені. З політикою whenScaled видаляються лише PVC, що відповідають реплікам Podʼа, які прибираються під час зменшення масштабу, після того, як їхні Podʼи були видалені.
Retain (стандартно)
PVC від volumeClaimTemplate не змінюються, коли їх Pod видаляється. Це поведінка до цієї нової функції.
Майте на увазі, що ці політики застосовуються лише тоді, коли Podʼи прибираються через видалення StatefulSet або зменшення його масштабу. Наприклад, якщо Pod, повʼязаний із StatefulSet, зазнає збою через відмову вузла, і панель управління створює Pod-замінник, StatefulSet зберігає наявний PVC. Наявний том не зазнає впливу, і кластер приєднає його до вузла, де має запуститися новий Pod.
Стандартно для політик встановлено Retain, відповідно до поведінки StatefulSet до цієї нової функції.
Контролер StatefulSet додає посилання на власника до своїх PVC, які потім видаляються збирачем сміття після завершення Podʼа. Це дозволяє Podʼу чисто демонтувати всі томи перед видаленням PVC (і перед видаленням PV і тому, що лежать в їх основі, залежно від політики збереження). Коли ви встановлюєте політику whenDeleted у Delete, посилання на власника на екземпляр StatefulSet додається до всіх PVC, повʼязані із цим StatefulSet.
Політика whenScaled повинна видаляти PVC тільки під час зменшення масштабу Podʼа, а не під час видалення Podʼа з іншої причини. Під час узгодження контролер StatefulSet порівнює очікувану кількість реплік із фактичними Podʼами, що присутні на кластері. Будь-який Pod StatefulSet, ідентифікатор якого більший за кількість реплік, засуджується та позначається для видалення. Якщо політика whenScaled є Delete, засуджені Podʼи спочатку встановлюються власниками відповідних PVC шаблону StatefulSet, перед видаленням Podʼа. Це призводить до того, що PVC видаляються збирачем сміття лише після завершення засуджених Podʼів.
Це означає, що якщо контролер виходить з ладу і перезапускається, жоден Pod не буде видалено до того моменту, поки його посилання на власника не буде відповідно оновлено згідно з політикою. Якщо засуджений Pod видаляється примусово, коли контролер вимкнено, посилання на власника може бути або встановлене, або ні, залежно від того, коли відбулася аварія контролера. Для оновлення посилань на власника може знадобитися кілька циклів узгодження, тому деякі засуджені Podʼи можуть мати встановлені посилання на власника, а інші — ні. З цієї причини ми рекомендуємо зачекати, поки контролер знову запуститься, що перевірить посилання на власника перед завершенням роботи Podʼів. Якщо це неможливо, оператор повинен перевірити посилання на власника на PVC, щоб забезпечити видалення очікуваних обʼєктів при примусовому видаленні Podʼів.
Репліки
.spec.replicas — це необовʼязкове поле, яке вказує кількість бажаних Podʼів. Стандартно воно дорівнює 1.
Якщо ви вручну масштабуєте StatefulSet через kubectl scale statefulset statefulset --replicas=X, а потім оновлюєте цей StatefulSet на основі маніфесту (наприклад, за допомогою kubectl apply -f statefulset.yaml), то застосування цього маніфесту перезапише попереднє ручне масштабування.
Якщо HorizontalPodAutoscaler (або будь-який подібний API для горизонтального масштабування) керує масштабуванням StatefulSet, не встановлюйте .spec.replicas. Замість цього дозвольте панелі управління Kubernetes автоматично керувати полем .spec.replicas.
StatefulSet є ресурсом верхнього рівня в REST API Kubernetes. Ознайомтесь із визначенням обʼєкта
StatefulSet, щоб зрозуміти API для StatefulSets.
Дізнайтеся про PodDisruptionBudget та як його можна використовувати для керування доступністю застосунків під час порушень.
6.4.2.4 - DaemonSet
DaemonSet визначає Podʼи, які надають локальні для вузлів можливості. Вони можуть бути фундаментальними для роботи вашого кластера, наприклад, допоміжним інструментом для роботи з мережею, або бути частиною надбудови.
DaemonSet гарантує, що всі (або деякі) вузли запускають копію Podʼа. Коли до кластера додаються вузли, на них додаються Podʼи. Коли вузли видаляються з кластера, ці Podʼи прибирає збір сміття. Видалення DaemonSet призведе до очищення створених ним Podʼів.
Типові варіанти використання DaemonSet:
запуск демона кластерного сховища на кожному вузлі
запуск демона збору логів на кожному вузлі
запуск демона моніторингу вузла на кожному вузлі
У простому випадку один DaemonSet, який охоплює всі вузли, може використовуватися для кожного типу демона. Складніше налаштування може використовувати кілька DaemonSets для одного типу демона, але з різними прапорцями та/або різними запитами памʼяті та CPU для різних типів обладнання.
Створення специфікації DaemonSet
Створення DaemonSet
Ви можете описати DaemonSet у файлі YAML. Наприклад, файл daemonset.yaml нижче описує DaemonSet, який запускає Docker-образ fluentd-elasticsearch:
apiVersion:apps/v1kind:DaemonSetmetadata:name:fluentd-elasticsearchnamespace:kube-systemlabels:k8s-app:fluentd-loggingspec:selector:matchLabels:name:fluentd-elasticsearchtemplate:metadata:labels:name:fluentd-elasticsearchspec:tolerations:# these tolerations are to have the daemonset runnable on control plane nodes# remove them if your control plane nodes should not run pods- key:node-role.kubernetes.io/control-planeoperator:Existseffect:NoSchedule- key:node-role.kubernetes.io/masteroperator:Existseffect:NoSchedulecontainers:- name:fluentd-elasticsearchimage:quay.io/fluentd_elasticsearch/fluentd:v5.0.1resources:limits:memory:200Mirequests:cpu:100mmemory:200MivolumeMounts:- name:varlogmountPath:/var/log# it may be desirable to set a high priority class to ensure that a DaemonSet Pod# preempts running Pods# priorityClassName: importantterminationGracePeriodSeconds:30volumes:- name:varloghostPath:path:/var/log
.spec.template — одне з обовʼязкових полів в .spec.
.spec.template — це шаблон Podʼа. Він має ту саму схему, що і Pod, за винятком того, що він вкладений і не має apiVersion або kind.
Окрім обовʼязкових полів для Podʼа, шаблон Podʼа в DaemonSet повинен вказувати відповідні мітки (див. селектор Podʼа).
Шаблон Podʼа в DaemonSet повинен мати RestartPolicy зі значенням Always або не вказувати її, тоді стандартним значенням буде Always.
Селектор Podʼа
Поле .spec.selector — це селектор Podʼа. Воно працює так само, як і .spec.selector в Job.
Ви повинні вказати селектор Podʼа, який відповідає міткам .spec.template. Крім того, після створення DaemonSet його .spec.selector не можна змінити. Зміна селектора Podʼа може призвести до ненавмисного залишення Podʼів сиротами, і це виявилося незрозумілим для користувачів.
.spec.selector — це обʼєкт, що складається з двох полів:
matchExpressions — дозволяє будувати складніші селектори, вказуючи ключ, список значень та оператор, який повʼязує ключ і значення.
Коли вказано обидва, результат обʼєднується логічною операцією AND.
.spec.selector повинен відповідати .spec.template.metadata.labels. Конфігурація, у якій ці два значення не збігаються, буде відхилена API.
Запуск Podʼів на вибраних вузлах
Якщо ви вказуєте .spec.template.spec.nodeSelector, тоді контролер DaemonSet буде створювати Podʼи на вузлах, які відповідають селектору вузла. Так само, якщо ви вказуєте .spec.template.spec.affinity, тоді контролер DaemonSet буде створювати Podʼи на вузлах, які відповідають цій спорідненості вузла. Якщо ви не вказали жодного з них, контролер DaemonSet буде створювати Podʼи на всіх вузлах.
Як плануються Daemon Podʼи
DaemonSet можна використовувати для того, щоб усі придатні вузли запускали копію Podʼа. Контролер DaemonSet створює Pod для кожного придатного вузла та додає поле spec.affinity.nodeAffinity Podʼа для відповідності цільовому хосту. Після створення Podʼа зазвичай у дію вступає стандартний планувальник і привʼязує Pod до цільового хоста, встановлюючи поле .spec.nodeName. Якщо новий Pod не може поміститися на вузлі, стандартний планувальник може витіснити (виселити) деякі наявні Podʼи на основі пріоритету нового Podʼа.
Примітка:
Якщо важливо, щоб Pod DaemonSet запускався на кожному вузлі, часто бажано встановити .spec.template.spec.priorityClassName DaemonSet на PriorityClass з вищим пріоритетом, щоб гарантувати таке виселення.
Користувач може вказати інший планувальник для Podʼів DaemonSet, встановивши поле .spec.template.spec.schedulerName DaemonSet.
Початкова спорідненість вузла, вказана в полі .spec.template.spec.affinity.nodeAffinity (якщо вказано), береться до уваги контролером DaemonSet під час оцінювання придатних вузлів, але замінюється на спорідненість вузла, що відповідає імені придатного вузла, на створеному Podʼі.
Podʼи DaemonSet можуть бути заплановані на вузли, які не є справними або готовими приймати Podʼи. Будь-які Podʼи DaemonSet, які працюють на таких вузлах, не будуть виселені.
Podʼи DaemonSet можуть бути заплановані на вузли, які недоступні з контролера вузла. Будь-які Podʼи DaemonSet, які працюють на таких вузлах, не будуть виселені.
Додається лише для Podʼів DaemonSet, які запитують мережу вузла, тобто для Podʼів із spec.hostNetwork: true. Такі Podʼи DaemonSet можуть бути заплановані на вузли із недоступною мережею.
Ви можете додавати власні tolerations до Podʼів DaemonSet, визначивши їх в шаблоні Podʼа DaemonSet.
Оскільки контролер DaemonSet автоматично встановлює toleration node.kubernetes.io/unschedulable:NoSchedule, Kubernetes може запускати Podʼи DaemonSet на вузлах, позначених як unschedulable.
Якщо ви використовуєте DaemonSet для надання важливої функції на рівні вузла, такої як мережа кластера, то корисно, що Kubernetes розміщує Podʼи DaemonSet на вузлах до того, як вони будуть готові. Наприклад, без цієї спеціальної toleration ви можете опинитися в тупиковій ситуації, коли вузол не позначений як готовий, тому що мережевий втулок не працює там, і в той самий час мережевий втулок не працює на цьому вузлі, оскільки вузол ще не готовий.
Взаємодія з Daemon Podʼами
Деякі можливі шаблони для взаємодії з Podʼами у DaemonSet:
Push: Podʼи в DaemonSet налаштовані надсилати оновлення до іншого сервісу, такого як база даних статистики. У них немає клієнтів.
NodeIP та відомий порт: Podʼи в DaemonSet можуть використовувати hostPort, щоб до них можна було звертатися за IP-адресами вузлів. Клієнти якимось чином знають список IP-адрес вузлів, а порт знають за домовленістю.
DNS: Створіть headless сервіс із тим самим селектором Podʼа, а потім виявіть DaemonSets, використовуючи ресурс endpoints або отримайте кілька записів A з DNS.
Service: Створіть Service із тим самим селектором Podʼа та використовуйте його для звернення до демона на випадковому вузлі. Використовуйте Політику внутрішнього трафіку Service, щоб обмежитися Podʼами на тому самому вузлі.
Оновлення DaemonSet
Якщо мітки вузлів змінюються, DaemonSet негайно додає Podʼи на вузли, які тепер відповідають умовам, і видаляє Podʼи з вузлів, які більше їм не відповідають.
Ви можете змінювати Podʼи, які створює DaemonSet. Проте Podʼи не дозволяють оновлювати всі поля. Крім того, контролер DaemonSet буде використовувати початковий шаблон під час наступного створення вузла (навіть з тим самим імʼям).
Ви можете видалити DaemonSet. Якщо ви вказали --cascade=orphan з kubectl, тоді Podʼи залишаться на вузлах. Якщо ви потім створите новий DaemonSet з тим самим селектором, новий DaemonSet перейме наявні Podʼи. Якщо потрібно замінити які-небудь Podʼи, DaemonSet їх замінює згідно з його updateStrategy.
Звичайно, можна запускати процеси демонів, безпосередньо стартуючи їх на вузлі (наприклад, за допомогою init, upstartd або systemd). Це абсолютно прийнятно. Однак є кілька переваг запуску таких процесів через DaemonSet:
Можливість моніторингу та управління логами для демонів так само як і для застосунків.
Однакова мова конфігурації та інструменти (наприклад, шаблони Podʼа, kubectl) для демонів та застосунків.
Запуск демонів у контейнерах з обмеженням ресурсів підвищує ізоляцію між демонами та контейнерами застосунків. Однак цього також можна досягти, запускаючи демонів у контейнері, але не в Podʼі.
Окремі Podʼи
Можна створювати Podʼи безпосередньо, вказуючи певний вузол для запуску. Проте DaemonSet замінює Podʼи, які видаляються або завершуються з будь-якої причини, такої як збій вузла або обслуговування вузла з порушенням роботи, наприклад, оновлення ядра. З цієї причини слід використовувати DaemonSet замість створення окремих Podʼів.
Статичні Podʼи
Можна створювати Podʼи, записавши файл у певну теку, за якою стежить kubelet. Їх називають статичними Podʼами. На відміну від DaemonSet, статичними Podʼами не можна управляти за допомогою kubectl або інших клієнтів API Kubernetes. Статичні Podʼи не залежать від apiserver, що робить їх корисними в разі початкового налаштування кластера. Також статичні Podʼи можуть бути визнані застарілими в майбутньому.
Deployments
DaemonSets схожі на Deployments тим, що обидва створюють Podʼи, і ці Podʼи мають процеси, завершення яких не очікується (наприклад, вебсервери, сервери зберігання).
Використовуйте Deployment для stateless-сервісів, таких як фронтенди, де збільшення та зменшення кількості реплік і розгортання оновлень важливіші за контроль над тим, на якому саме хості працює Pod. Використовуйте DaemonSet, коли важливо, щоб копія Podʼа завжди працювала на всіх або певних хостах, якщо DaemonSet надає функціональність рівня вузла, яка дозволяє іншим Podʼам правильно працювати на цьому конкретному вузлі.
Наприклад, мережеві втулки часто включають компонент, який працює як DaemonSet. Цей компонент DaemonSet гарантує, що вузол, де він працює, має справну мережу кластера.
DaemonSet — це ресурс верхнього рівня в REST API Kubernetes. Ознайомтесь з визначенням обʼєкта
DaemonSet, щоб зрозуміти API для DaemonSets.
6.4.2.5 - Jobs
Jobs представляють одноразові завдання, які виконуються до завершення, а потім зупиняються.
Job створює один або кілька Podʼів і продовжує повторювати виконання Podʼів, доки вказана їх кількість успішно не завершиться. Коли Podʼи успішно завершуються, Job відстежує ці успішні завершення. Коли досягнуто вказаної кількості успішних завершень, завдання (тобто Job) завершено. Видалення Job видаляє створені ним Podʼи. Призупинення Job видаляє його активні Podʼи, доки Job не буде знову відновлено.
У простому випадку можна створити один обʼєкт Job для надійного запуску одного Podʼа, який працюватиме доки не завершить виконання роботи. Обʼєкт Job буде запускати новий Pod, якщо перший Pod зазнає невдачі або видаляється (наприклад, через відмову апаратного забезпечення вузла або перезавантаження вузла).
Також можна використовувати Job для запуску кількох Podʼів паралельно.
Якщо ви хочете запускати Job (або одне завдання, або кілька паралельно) за розкладом, див. CronJob.
Запуск прикладу Job
Ось конфігурація прикладу Job. Тут обчислюється число π з точністю до 2000 знаків і виконується його вивід. Виконання зазвичай займає близько 10 секунд.
Як і з будь-якою іншою конфігурацією Kubernetes, у Job мають бути вказані поля apiVersion, kind та metadata.
Коли панель управління створює нові Podʼи для Job, .metadata.name Job є частиною основи для назв цих Podʼів. Назва Job повинна бути дійсним значенням DNS-піддомену, але це може призводити до неочікуваних результатів для імен хостів Podʼів. Для найкращої сумісності назва повинна відповідати суворішим правилам для DNS-мітки. Навіть якщо назва є DNS-піддоменом, вона повинна бути не довшою за 63 символи.
Існують три основних типи завдань, які підходять для виконання як Job:
Непаралельні Jobs
зазвичай запускається лише один Pod, якщо тільки він не зазнає збою.
Job завершується, як тільки робота його Podʼа завершується успішно.
Паралельні Jobs із фіксованою кількістю завершень:
вкажіть ненульове додатне значення для .spec.completions.
Job являє собою загальне завдання і є завершеним, коли є .spec.completions успішних Podʼів.
під час використання .spec.completionMode="Indexed", кожен Pod отримує різний індекс у діапазоні від 0 до .spec.completions-1.
Паралельні Jobs із чергою роботи:
не вказуйте .spec.completions, типово встановлюється .spec.parallelism.
Podʼи повинні координувати свої дії між собою або із зовнішнім сервісом, щоб визначити, над чим кожен з них має працювати. Наприклад, Pod може отримати пакет із не більш ніж N елементів з черги роботи.
кожен Pod може незалежно визначити, чи завершилися всі рівноправні з ним Podʼи, а отже, чи завершено весь Job.
коли будь-який Pod з Job завершується успішно, нові Podʼи не створюються.
як тільки хоча б один Pod завершився успішно і всі Podʼи завершені, тоді Job завершується успішно.
як тільки будь-який Pod завершився успішно, жоден інший Pod не повинен виконувати роботу для цього завдання чи записувати будь-який вивід. Вони всі мають бути в процесі завершення.
Для непаралельного Job ви можете залишити як .spec.completions, так і .spec.parallelism не встановленими. Коли обидва не встановлені, обидва типово встановлюються на 1.
Для Job із фіксованою кількістю завершень вам слід встановити .spec.completions на кількість необхідних завершень. Ви можете встановити .spec.parallelism чи залишити його не встановленим, тоді він стандартно дорівнюватиме 1.
Для Job із чергою роботи ви повинні залишити .spec.completions не встановленим і встановити .spec.parallelism у невідʼємне ціле число.
За докладною інформацією про використання різних типів Job, див. розділ патерни Job.
Контроль паралелізму
Запитаний паралелізм (.spec.parallelism) може бути встановлений у будь-яке невідʼємне значення. Якщо значення не вказано, стандартно воно дорівнює 1. Якщо вказано як 0, то Job фактично призупинено, доки значення не буде збільшено.
Фактичний паралелізм (кількість Podʼів, які працюють в будь-який момент) може бути більше чи менше, ніж запитаний паралелізм, з різних причин:
Для Job із фіксованою кількістю завершень, фактична кількість Podʼів, які працюють паралельно, не перевищуватиме кількість решти завершень. Вищі значення .spec.parallelism фактично ігноруються.
Для Job із чергою роботи жоден новий Pod не запускається після успішного завершення будь-якого Podʼа, однак решті Podʼів дозволено завершити роботу.
Якщо контролер Job не зміг створити Podʼи з будь-якої причини (нестача ResourceQuota, відсутність дозволу тощо), тоді може бути менше Podʼів, ніж запитано.
Контролер Job може обмежувати створення нових Podʼів через надмірну кількість збоїв попередніх Podʼів у тому самому Job.
Коли Pod коректно завершується, на його зупинку потрібен час.
Режим завершення
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Для Jobs із фіксованою кількістю завершень, тобто Jobs зі значенням .spec.completions, відмінним від null, може бути встановлено режим завершення, який вказується в .spec.completionMode:
NonIndexed (стандартно): Job вважається завершеним, коли є .spec.completions успішно завершених Podʼів. Іншими словами, завершення всіх Podʼів рівнозначні. Зверніть увагу, що Jobs, у яких .spec.completions дорівнює null, неявно є NonIndexed.
Indexed: Podʼи Job отримують повʼязаний індекс завершення від 0 до .spec.completions-1. Індекс доступний через чотири механізми:
Мітка Podʼа batch.kubernetes.io/job-completion-index (для v1.28 і новіших). Зверніть увагу, що для використання цієї мітки функціональна можливість PodIndexLabel повинна бути увімкнена, і вона типово увімкнена.
Як частина імені хоста Podʼа, за шаблоном $(job-name)-$(index). Коли ви використовуєте Indexed Job у поєднанні з Service, Podʼи всередині Job можуть використовувати детерміністичні імена хостів для адресації одне одного через DNS. Докладні відомості щодо того, як налаштувати це, див. Job із комунікацією між Podʼами.
З контейнера завдання, в змінній середовища JOB_COMPLETION_INDEX.
Хоча це трапляється рідко, може бути запущено більше одного Podʼа для одного і того ж індексу (з різних причин, таких як відмови вузла, перезапуски kubelet чи виселення Podʼа). У цьому випадку лише перший успішно завершений Pod буде враховуватися при підрахунку кількості завершень та оновленні статусу Job. Інші Podʼи, які працюють чи завершили роботу для того ж самого індексу, будуть видалені контролером Job, щойно їх буде виявлено.
Інтеграція з Workload API
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the WorkloadWithJob feature gate for all relevant components in your cluster.
Коли функціональну можливість WorkloadWithJob увімкнено, контролер Job компілює конфігурацію .spec.scheduling Job в обʼєкти Workload та PodGroup (scheduling.k8s.io/v1beta1) перед створенням будь-яких Podʼів. Це дозволяє вам виражати явний намір планування для Job, такий як групове планування (всі Podʼи плануються разом або жодного), спільне розташування за топологією та поведінку під час порушень.
Коли ви опускаєте .spec.scheduling, Job типово використовує політику планування Basic, яка зберігає стандартний результат планування Pod за Podʼом для звичайного Job. Контролер все одно створює Workload та PodGroup для кожного відповідного Job (включно з Basic), тому спостережувані обʼєкти є узгодженими незалежно від політики.
Конфігурація планування
Поле .spec.scheduling приймає такі поля:
schedulingPolicy: потрібно вказати рівно одне з basic або gang. З gang всі Podʼи мають бути запланованими разом, перш ніж будь-який з них буде привʼязаний. Опущене gang.minCount стандартно дорівнює .spec.parallelism Job. Див. Політики планування PodGroup.
disruptionMode: чи порушується робота Podʼів окремо (single), чи групою (all). Див. порушення та пріоритет.
resourceClaims: динамічні запити на ресурси, спільні для Podʼів Job.
Всі поля .spec.scheduling є незмінними після створення Job, окрім schedulingPolicy.gang.minCount, яке ви можете змінювати, щоб еластично масштабувати групу.
Групове планування
Цей Job запитує групове планування для своїх 8 Podʼів, розташованих в одній зоні, робота яких порушується разом:
apiVersion:batch/v1kind:Jobmetadata:name:distributed-trainingnamespace:trainingspec:parallelism:8completions:8completionMode:Indexedscheduling:schedulingPolicy:gang:{}# minCount пропущено -> стандартно дорівнює parallelism (8)schedulingConstraints:key:- level:topology.kubernetes.io/zonedisruptionMode:all:{}# робота всієї групи порушується разомtemplate:spec:restartPolicy:Nevercontainers:- name:trainerimage:training-image:latestresources:limits:nvidia.com/gpu:1
Коли контролер Job обробляє цей Job, він:
Створює обʼєкт Workload у тому самому просторі імен, що містить podGroupTemplate, скомпільований з .spec.scheduling (тут — політика групового планування з minCount: 8).
Створює обʼєкт PodGroup на основі цього шаблону. PodGroup є одиницею планування під час виконання і містить вбудовану копію політики.
Створює Podʼи з .spec.schedulingGroup.podGroupName, встановленим на імʼя PodGroup, звʼязуючи кожен Pod зі своєю групою планування.
Контролер виявляє ці обʼєкти через посилання у специфікації (Workload.spec.controllerRef та PodGroup.spec.workloadRef), а не за іменем. Обʼєкти, які створює контролер, містять запис ownerReferences, що вказує на Job, тому вони видаляються збирачем сміття, коли Job видаляється.
Типове (Basic) планування
Job, який опускає .spec.scheduling, типово використовує Basic, що діє як неявна відмова від групового планування. Його Podʼи плануються так само, як у звичайного Job, при цьому все одно створюються Workload та PodGroup типу Basic:
apiVersion:batch/v1kind:Jobmetadata:name:batch-processornamespace:batchspec:parallelism:10completions:10# .spec.scheduling пропущено -> типово використовується Basic scheduling.template:spec:restartPolicy:Nevercontainers:- name:processorimage:processor-image:v1
Контролери вищого рівня
Для автономного Job контролер Job володіє як Workload, так і PodGroup. Коли Job натомість містить ownerReference на батьківський контролер, який компілює Workload (наприклад, JobSet), контролер Job делегує володіння Workload цьому батьківському контролеру. Чи створює контролер Job все ще PodGroup під час виконання, залежить від того, що делегує батьківський контролер:
Якщо батьківський контролер встановлює анотацію scheduling.k8s.io/group-template-name на Job, контролер Job створює та володіє PodGroup, зіставленим з іменованим PodGroupTemplate батьківського контролера.
В іншому випадку батьківський контролер володіє обома обʼєктами, і контролер Job не створює жодного; він виявляє наявні обʼєкти та використовує їх під час створення Podʼів.
Якщо в шаблоні Podʼа Job вже задано .spec.template.spec.schedulingGroup, контролер Job не створює жодного обʼєкта, дозволяючи вам (або контролеру вищого рівня) самостійно керувати життєвим циклом Workload/PodGroup.
Поведінка CronJob
Jobs, створені за допомогою CronJob, є автономними; CronJob не створює та не керує обʼєктами Workload. Якщо jobTemplate CronJob встановлює .spec.scheduling, контролер Job створює окремі обʼєкти Workload та PodGroup для кожного екземпляра Job, скомпільовані з .spec.scheduling цього Job (типово Basic, якщо опущено). Ці обʼєкти видаляються збирачем сміття, коли кожен Job завершується або видаляється.
Обмеження для альфа-релізу
Кожен Job відповідає точно одному обʼєкту PodGroup; всі Podʼи в Job поділяють єдину політику планування.
Лише schedulingPolicy.gang.minCount є змінним; всі інші поля .spec.scheduling є незмінними після створення.
Призупинені Jobs зберігають свої обʼєкти Workload та PodGroup; вони не видаляються під час призупинення і не створюються заново під час відновлення.
Обробка збоїв Podʼа та контейнера
Контейнер у Podʼі може вийти з ладу з ряду причин, таких як завершення процесу з ненульовим кодом виходу або примусове припинення роботи контейнера через перевищення обмеження памʼяті тощо. Якщо це стається і .spec.template.spec.restartPolicy = "OnFailure", тоді Pod залишається на вузлі, але контейнер перезапускається. Отже, ваш застосунок повинен обробляти випадок, коли він перезапускається локально, або вказувати .spec.template.spec.restartPolicy = "Never". Докладні відомості про restartPolicy див. в розділі життєвий цикл Podʼа.
Весь Pod також може вийти з ладу з низки причин, таких як коли Pod виштовхується з вузла (вузол оновлюється, перезавантажується, видаляється тощо), або якщо контейнер Podʼа виходить з ладу і .spec.template.spec.restartPolicy = "Never". Коли Pod виходить з ладу, контролер Job запускає новий Pod. Це означає, що ваш застосунок повинен обробляти випадок, коли він перезапускається у новому Podʼі. Зокрема, він повинен обробляти тимчасові файли, блокування, неповний вивід та інше, викликане попередніми запусками.
Додатково ви можете вирішити враховувати збої Podʼа незалежно для кожного індексу в Indexed Job, встановлюючи поле .spec.backoffLimitPerIndex (докладні відомості див. обмеження backoff на індекс).
Зверніть увагу, що навіть якщо ви вказали .spec.parallelism = 1 і .spec.completions = 1 і .spec.template.spec.restartPolicy = "Never", та сама програма може іноді бути запущена двічі.
Якщо ви вказали як .spec.parallelism, так і .spec.completions більше ніж 1, то може бути запущено кілька Podʼів одночасно. Таким чином, ваші Podʼи також повинні бути стійкими до паралелізму.
Якщо ви вказуєте поле .spec.podFailurePolicy, контролер Job не вважає збоєм Pod, що завершується (Pod зі встановленим полем .metadata.deletionTimestamp), доки цей Pod не стане термінальним (його .status.phase є Failed або Succeeded). Однак контролер Job створює Pod-замінник, щойно стає очевидним, що Pod перебуває в процесі завершення. Після того як Pod завершиться, контролер Job оцінює .backoffLimit і .podFailurePolicy для відповідного Job, враховуючи тепер уже завершений Pod.
Якщо хоча б одна з цих вимог не виконана, контролер Job вважає Pod, що завершується, негайним збоєм, навіть якщо цей Pod пізніше завершиться з phase: "Succeeded".
Політика backoff для збоїв Podʼа
Трапляються ситуації, коли ви хочете, щоб Job зазнав збою після певної кількості спроб через логічну помилку в конфігурації тощо. Для цього встановіть .spec.backoffLimit, щоб вказати кількість повторних спроб, після яких Job вважатиметься невдалим.
Стандартне значення .spec.backoffLimit дорівнює 6, якщо не вказано обмеження backoff на індекс (тільки Індексовані Job). Якщо вказано .spec.backoffLimitPerIndex, то .spec.backoffLimit стандартно дорівнює 2147483647 (MaxInt32).
Повʼязані з Job невдалі Podʼи створюються заново контролером Job з експоненціальною затримкою (10s, 20s, 40s …), яка обмежена десятьма хвилинами.
Кількість спроб обчислюється двома способами:
Кількість Podʼів з .status.phase = "Failed".
Під час використання restartPolicy = "OnFailure" кількість спроб у всіх контейнерах Podʼів з .status.phase, що дорівнює Pending або Running.
Якщо хоча б один із розрахунків досягне значення .spec.backoffLimit, Job вважається невдалим.
Примітка:
Якщо ваш Job має restartPolicy = "OnFailure", майте на увазі, що Pod, який виконує Job, буде завершено, щойно буде досягнуто обмеження backoff Job. Це може ускладнити налагодження виконуваного файлу Job. Ми радимо встановлювати restartPolicy = "Never" під час налагодження Job або використовувати систему логування, щоб вивід невдалих Jobs не було випадково втрачено.
обмеження backoff на індекс
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate JobBackoffLimitPerIndex, Kubernetes ignores it but does not report any error.
Коли ви запускаєте Indexed Job, ви можете вибрати обробку спроб для збоїв Podʼа незалежно для кожного індексу. Для цього встановіть .spec.backoffLimitPerIndex, щоб вказати максимальну кількість невдалих спроб Podʼа для кожного індексу.
Коли обмеження backoff на індекс перевищується для певного індексу, Kubernetes вважає цей індекс невдалим і додає його до поля .status.failedIndexes. Індекси, які виконались успішно, реєструються в полі .status.completedIndexes, незалежно від того, чи ви встановили поле backoffLimitPerIndex.
Зауважте, що невдалий індекс не перериває виконання інших індексів. Щойно всі індекси завершаться для Job, в якому ви вказали обмеження backoff на індекс, якщо хоча б один з цих індексів виявився невдалим, контролер Job позначає весь Job як невдалий, встановлюючи стан Failed в статусі. Job отримує позначку "невдалий", навіть якщо деякі, можливо, майже всі індекси були оброблені успішно.
Ви також можете обмежити максимальну кількість позначених невдалих індексів, встановивши поле .spec.maxFailedIndexes. Коли кількість невдалих індексів перевищує значення поля maxFailedIndexes, контролер Job запускає завершення всіх Podʼів, що залишаються запущеними в цьому Job. Щойно всі Podʼи будуть завершені, контролер Job позначає весь Job як невдалий, встановлюючи стан Failed в статусі Job.
Ось приклад маніфесту для Job, який визначає backoffLimitPerIndex:
apiVersion:batch/v1kind:Jobmetadata:name:job-backoff-limit-per-index-examplespec:completions:10parallelism:3completionMode:Indexed # required for the featurebackoffLimitPerIndex:1# maximal number of failures per indexmaxFailedIndexes:5# maximal number of failed indexes before terminating the Job executiontemplate:spec:restartPolicy:Never# required for the featurecontainers:- name:exampleimage:pythoncommand:# The jobs fails as there is at least one failed index# (all even indexes fail in here), yet all indexes# are executed as maxFailedIndexes is not exceeded.- python3- -c- | import os, sys
print("Hello world")
if int(os.environ.get("JOB_COMPLETION_INDEX")) % 2 == 0:
sys.exit(1)
У вищенаведеному прикладі контролер Job дозволяє один перезапуск для кожного з індексів. Коли загальна кількість невдалих індексів перевищує 5, тоді весь Job завершується.
Після завершення Job його стан виглядає так:
kubectl get -o yaml job job-backoff-limit-per-index-example
status:completedIndexes:1,3,5,7,9failedIndexes:0,2,4,6,8succeeded:5# 1 succeeded pod for each of 5 succeeded indexesfailed:10# 2 failed pods (1 retry) for each of 5 failed indexesconditions:- message:Job has failed indexesreason:FailedIndexesstatus:"True"type:FailureTarget- message:Job has failed indexesreason:FailedIndexesstatus:"True"type:Failed
Контролер Job додає стан FailureTarget до Job для запуску завершення та очищення Job. Коли всі Podʼи Job завершуються, контролер Job додає стан Failed з тими ж значеннями для reason і message, що й у стану FailureTarget. Для деталей дивіться Завершення Podʼів Job.
Додатково ви можете використовувати обмеження backoff на індекс разом з політикою збоїв Podʼа. Коли використовується обмеження backoff на індекс, доступна нова дія FailIndex, яка дозволяє вам уникати непотрібних повторів всередині індексу.
Політика збоїв Podʼа
This is a stable feature in Kubernetes, and has been since the 1.31 release. You can no longer toggle this feature (the associated feature gate has been removed).
Політика збоїв Podʼа, визначена за допомогою поля .spec.podFailurePolicy, дозволяє вашому кластеру обробляти збої Podʼа на основі кодів виходу контейнера та станів Podʼа.
У деяких ситуаціях вам може знадобитися кращий контроль обробки збоїв Podʼа, ніж контроль, який надає Політика backoff для збоїв Podʼа, яка базується на .spec.backoffLimit Job. Ось деякі приклади використання:
Для оптимізації витрат на виконання робочих навантажень, уникнення непотрібних перезапусків Podʼа, ви можете завершити Job, як тільки один із його Podʼів відмовить із кодом виходу, що вказує на помилку програмного забезпечення.
Щоб гарантувати, що ваш Job завершиться, навіть якщо є порушення, ви можете ігнорувати збої Podʼів, спричинені порушеннями (такими як витіснення, виселення, ініційоване API або виселення на основі taint), щоб вони не враховувалися в обмеженні спроб .spec.backoffLimit.
Ви можете налаштувати політику збоїв Podʼа в полі .spec.podFailurePolicy, щоб задовольнити наведені вище сценарії використання. Ця політика може обробляти збої Podʼа на основі кодів виходу контейнера та станів Podʼа.
Ось маніфест для Job, який визначає podFailurePolicy:
apiVersion:batch/v1kind:Jobmetadata:name:job-pod-failure-policy-examplespec:completions:12parallelism:3template:spec:restartPolicy:Nevercontainers:- name:mainimage:docker.io/library/bash:5command:["bash"]# example command simulating a bug which triggers the FailJob actionargs:- -c- echo "Hello world!" && sleep 5 && exit 42backoffLimit:6podFailurePolicy:rules:- action:FailJobonExitCodes:containerName:main # optionaloperator: In # one of:In, NotInvalues:[42]- action: Ignore # one of:Ignore, FailJob, CountonPodConditions:- type:DisruptionTarget # indicates Pod disruption
У вищенаведеному прикладі перше правило політики збоїв Podʼа вказує, що Job слід позначити як невдалий, якщо контейнер main завершиться кодом виходу 42. Наступні правила стосуються саме контейнера main:
код виходу 0 означає, що контейнер виконався успішно
код виходу 42 означає, що весь Job завершився невдало
будь-який інший код виходу вказує, що контейнер, а отже, і весь Pod завершилися невдало. Pod буде створено заново, якщо загальна кількість перезапусків менша за backoffLimit. Якщо backoffLimit досягнуто, весь Job завершився невдало.
Примітка:
Оскільки в шаблоні Podʼа вказано restartPolicy: Never, kubelet не перезапускає контейнер main в тому конкретному Podʼі.
Друге правило політики збоїв Podʼа, що вказує дію Ignore для невдалих Podʼів зі станом DisruptionTarget, виключає порушення роботи Podʼів із підрахунку обмеження спроб .spec.backoffLimit.
Примітка:
Якщо Job виявився невдалим через політику збоїв Podʼа чи через політику backoff для збоїв Podʼа, і Job виконується кількома Podʼами, Kubernetes завершує всі Podʼи в цьому Job, які все ще перебувають у статусах Pending або Running.
Ось деякі вимоги та семантика API:
якщо ви хочете використовувати поле .spec.podFailurePolicy для Job, вам також слід визначити шаблон Podʼа цього Job з .spec.restartPolicy, встановленим на Never.
правила політики збоїв Podʼа, які ви визначаєте у spec.podFailurePolicy.rules, оцінюються послідовно. Якщо одне з правил відповідає збою Podʼа, інші правила ігноруються. Якщо жодне правило не відповідає збою Podʼа, застосовується типова обробка.
ви можете обмежити правило певним контейнером, вказавши його імʼя у spec.podFailurePolicy.rules[*].onExitCodes.containerName. Якщо не вказано, правило застосовується до всіх контейнерів. Якщо вказано, воно повинно відповідати імені одного з контейнерів або initContainer у шаблоні Podʼа.
ви можете вказати дію, яка виконується, коли спрацьовує політика збоїв Podʼа, у spec.podFailurePolicy.rules[*].action. Можливі значення:
FailJob: використовуйте це, щоб вказати, що Job цього Podʼа має бути позначений як Failed, а всі запущені Podʼи мають бути завершені.
Ignore: використовуйте це, щоб вказати, що значення лічильника, що рахує .spec.backoffLimit, не повинне збільшуватися, і має бути створений Pod-замінник.
Count: використовуйте це, щоб вказати, що Pod повинен бути оброблений типовим способом. Лічильник .spec.backoffLimit повинен збільшитися.
FailIndex: використовуйте цю дію разом із обмеження backoff на індекс для уникнення непотрібних повторних спроб в межах індексу невдалого Podʼа.
Примітка:
Коли використовується podFailurePolicy, контролер Job враховує лише Podʼи у фазі Failed. Podʼи з відміткою про видалення, які не знаходяться в термінальній фазі (Failed чи Succeeded), вважаються такими, що ще завершуються. Це означає, що такі Podʼи зберігають завершувачі відстеження доки не досягнуть термінальної фази. З Kubernetes 1.27 Kubelet переводить видалені Podʼи в термінальну фазу (див.: Фаза Podʼа). Це забезпечує видалення завершувачів контролером Job.
Примітка:
Починаючи з Kubernetes v1.28, коли використовується політика збоїв Podʼа, контролер Job створює заново Podʼи, що завершуються, лише тоді, коли ці Podʼи досягли термінальної фази Failed. Ця поведінка подібна до podReplacementPolicy: Failed. Докладніше див. Політика заміни Podʼів.
Коли ви використовуєте podFailurePolicy, і Job зазнає невдачі через Pod, що відповідає правилу з дією FailJob, контролер Job запускає процес завершення Job, додаючи стан FailureTarget. Для деталей дивіться Завершення та очищення Job.
Політика успіху
Під час створення Indexed Job ви можете визначити, коли Job може бути визнаний успішним, за допомогою .spec.successPolicy, на основі успішних Podʼів.
Типово Job вважається успішним, коли кількість успішних Podʼів дорівнює .spec.completions. Існують ситуації, коли вам може знадобитися додатковий контроль для визнання Job успішним:
Під час виконання симуляцій з різними параметрами, вам можуть не знадобитися всі симуляції для успішного завершення загального Job.
Під час використання шаблону лідер-виконавець, лише успіх лідера визначає успіх чи невдачу Job. Прикладами цього є фреймворки, такі як MPI та PyTorch тощо.
Ви можете налаштувати політику успіху у полі .spec.successPolicy, щоб задовольнити вищезазначені випадки використання. Ця політика може керувати успіхом Job на основі успішних Podʼів. Після того, як Job відповідає політиці успіху, контролер Job завершує решту Podʼів. Політика успіху визначається правилами. Кожне правило може мати одну з таких форм:
Коли ви вказуєте лише succeededIndexes, одразу після успішного завершення всіх індексів, вказаних у succeededIndexes, контролер Job позначає Job як успішний. succeededIndexes повинен бути списком інтервалів між 0 і .spec.completions-1.
Коли ви вказуєте лише succeededCount, як тільки кількість успішних індексів досягне succeededCount, контролер Job позначає Job як успішний.
Коли ви вказуєте як succeededIndexes, так і succeededCount, як тільки кількість успішних індексів з підмножини індексів, вказаних у succeededIndexes, досягне succeededCount, контролер Job позначає Job як успішний.
Зверніть увагу, що коли ви вказуєте кілька правил у .spec.successPolicy.rules, контролер Job оцінює правила послідовно. Після того, як Job задовольняє правило, контролер Job ігнорує решту правил.
apiVersion:batch/v1kind:Jobmetadata:name:job-successspec:parallelism:10completions:10completionMode:Indexed# Required for the success policysuccessPolicy:rules:- succeededIndexes:0,2-3succeededCount:1template:spec:containers:- name:mainimage:pythoncommand:# Provided that at least one of the Pods with 0, 2, and 3 indexes has succeeded,# the overall Job is a success.- python3- -c- | import os, sys
if os.environ.get("JOB_COMPLETION_INDEX") == "2":
sys.exit(0)
else:
sys.exit(1)restartPolicy:Never
У вищенаведеному прикладі були вказані як succeededIndexes, так і succeededCount. Тому контролер Job позначить Job як успішний і завершить залишкові Podʼи після успіху будь-яких зазначених індексів, 0, 2 або 3. Job, який відповідає політиці успіху, отримує стан SuccessCriteriaMet з причиною SuccessPolicy. Після видалення залишкових Podʼів, Job отримує стан Complete.
Зверніть увагу, що succeededIndexes представлено як інтервали, розділені дефісом. Номери перераховані у вигляді першого та останнього елементів серії, розділених дефісом.
Примітка:
Коли ви вказуєте як політику успіху, так і деякі політики завершення, такі як .spec.backoffLimit і .spec.podFailurePolicy, щойно Job задовольняє будь-яку з політик, контролер Job дотримується політики завершення і ігнорує політику успіху.
Завершення Job та очищення
Коли Job завершується, Podʼи більше не створюються, але Podʼи зазвичай також не видаляються. Якщо їх не видаляти, можна переглядати логи завершених Podʼів для перевірки наявності помилок, попереджень чи іншого діагностичного виводу. Обʼєкт Job також залишається після завершення, щоб ви могли переглядати його статус. Користувач сам видаляє старі Jobs, переглянувши їхній статус. Видаліть Job за допомогою kubectl (наприклад, kubectl delete jobs/pi або kubectl delete -f ./job.yaml). Коли ви видаляєте Job за допомогою kubectl, усі створені ним Podʼи також видаляються.
Стандартно Job буде виконуватися безперервно, якщо тільки Pod не вийде з ладу (restartPolicy=Never) або контейнер не вийде з ладу з помилкою (restartPolicy=OnFailure), після чого Job дотримується .spec.backoffLimit, описаного вище. Як тільки досягнуто .spec.backoffLimit, Job буде позначено як невдалий, і будь-які запущені Podʼи будуть завершені.
Іншим способом завершити Job є встановлення активного крайнього терміну. Це робиться шляхом встановлення в поле .spec.activeDeadlineSeconds Job кількості секунд. activeDeadlineSeconds застосовується до тривалості Job, незалежно від кількості створених Podʼів. Як тільки Job досягає activeDeadlineSeconds, всі його запущені Podʼи завершуються, і статус Job стане type: Failed з reason: DeadlineExceeded.
Зауважте, що .spec.activeDeadlineSeconds Job має пріоритет перед його .spec.backoffLimit. Отже, Job, який повторно запускає один або кілька невдалих Podʼів, не розпочне розгортання додаткових Podʼів, якщо activeDeadlineSeconds вже досягнуто, навіть якщо backoffLimit ще не досягнуто.
Зверніть увагу, що як саме специфікація Job, так і специфікація шаблону Podʼа у межах Job мають поле activeDeadlineSeconds. Переконайтеся, що ви встановлюєте це поле на відповідному рівні.
Памʼятайте, що restartPolicy застосовується до Podʼа, а не до самого Job: автоматичного перезапуску Job не відбудеться, якщо статус Job type: Failed. Тобто механізми завершення Job, активовані за допомогою .spec.activeDeadlineSeconds і .spec.backoffLimit, призводять до остаточного збою Job, який потребує ручного втручання.
Термінальні стани Job
Job має два можливих термінальних стани, кожному з яких відповідає стан Job (condition):
Успішне виконання: стан Job Complete
Невдача: стан Job Failed
Jobs зазнають невдачі з таких причин:
Кількість невдач Podʼа перевищила вказане .spec.backoffLimit у специфікації Job. Для деталей див. Політика backoff для збоїв Podʼа.
Час виконання Job перевищив вказане .spec.activeDeadlineSeconds.
Indexed Job, який використовує .spec.backoffLimitPerIndex, має збійні індекси. Для деталей див. обмеження backoff на індекс.
Кількість невдалих індексів у Job перевищила вказане значення spec.maxFailedIndexes. Для деталей див. обмеження backoff на індекс.
Невдалий Pod відповідає правилу у .spec.podFailurePolicy, яке має дію FailJob. Для деталей про те, як правила політики збоїв Podʼа можуть вплинути на оцінку невдачі, див. Політика збоїв Podʼа.
Jobs успішні з таких причин:
Кількість успішних Podʼів досягла вказаного .spec.completions.
Виконані критерії, зазначені у .spec.successPolicy. Для деталей див. Політика успіху.
У Kubernetes v1.31 та пізніших версіях контролер Job затримує додавання термінальних станів, Failed або Complete, поки всі Podʼи Job не будуть завершені.
У Kubernetes v1.30 та раніших версіях контролер Job додавав термінальні стани Complete або Failed відразу після того, як був запущений процес завершення Job та всі завершувачі Podʼа були видалені. Однак деякі Podʼи все ще могли працювати або завершуватися в момент додавання термінального стану.
У Kubernetes v1.31 та пізніших версіях контролер додає термінальні стани Job лише після завершення всіх Podʼів. Ви можете керувати цією поведінкою за допомогою функціональних можливостейJobManagedBy та JobPodReplacementPolicy (обидві стандартно увімкнені).
Завершення Podʼів Job
Контролер Job додає стан FailureTarget або стан SuccessCriteriaMet до Job, щоб запустити завершення Podʼів після того, як Job відповідає критеріям успіху або невдачі.
Фактори, такі як terminationGracePeriodSeconds, можуть збільшити час від моменту додавання контролером Job стану FailureTarget або стану SuccessCriteriaMet до моменту, коли всі Podʼи Job завершаться і контролер Job додасть термінальний стан (Failed або Complete).
Ви можете використовувати стан FailureTarget або стан SuccessCriteriaMet, щоб оцінити, чи Job зазнав невдачі чи досяг успіху, без необхідності чекати, поки контролер додасть термінальний стан.
Наприклад, ви можете захотіти вирішити, коли створити Job-замінник для невдалого Job. Якщо ви заміните невдалий Job, щойно зʼявиться стан FailureTarget, ваш Job-замінник запуститься раніше, але Podʼи невдалого Job і Job-замінника можуть працювати одночасно, використовуючи додаткові обчислювальні ресурси.
Або, якщо ваш кластер має обмежену місткість ресурсів, ви можете дочекатися появи стану Failed на Job, що затримає ваш Job-замінник, але збереже ресурси, оскільки ви дочекаєтеся видалення всіх невдалих Podʼів.
Автоматичне очищення завершених Jobs
Зазвичай завершені Jobs вже не потрібні в системі. Їх зберігання створює тиск на API-сервер. Якщо Jobs керуються безпосередньо контролером вищого рівня, таким як CronJobs, їх можуть очищати CronJobs на основі заданої політики очищення за місткістю.
Механізм TTL для завершених Jobs
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.23
Ще один спосіб автоматично очищати завершені Jobs (Complete або Failed) — це використовувати механізм TTL, наданий
контролером TTL для завершених ресурсів, вказуючи поле .spec.ttlSecondsAfterFinished у Job.
Коли контролер TTL очищує Job, він каскадно видаляє Job, тобто видаляє його залежні обʼєкти, такі як Podʼи, разом з Job. Зверніть увагу, що під час видалення Job будуть дотримані гарантії його життєвого циклу, такі як завершувачі.
Job pi-with-ttl стане придатним для автоматичного видалення через 100 секунд після завершення.
Якщо поле встановлено в 0, Job стане придатним для автоматичного видалення одразу після завершення. Якщо поле не вказане, Job не буде очищено контролером TTL після завершення.
Примітка:
Рекомендується встановлювати поле ttlSecondsAfterFinished, оскільки некеровані Jobs (Jobs, які ви створили безпосередньо, а не опосередковано через інші API робочого навантаження, такі як CronJob) мають стандартну політику видалення orphanDependents, що призводить до того, що Podʼи, створені некерованим Job, залишаються після того, як Job повністю видалено. Навіть якщо панель управління зрештою прибирає збором сміття Podʼи видаленого Job після їх збою або завершення, іноді ці залишкові Podʼи можуть погіршувати продуктивність кластера або в найгіршому випадку спричинити вихід кластера з ладу через це погіршення.
Ви можете використовувати LimitRanges та ResourceQuotas, щоб обмежити кількість ресурсів, які певний простір імен може споживати.
Патерни використання Job
Обʼєкт Job може використовуватися для обробки набору незалежних, але повʼязаних робочих одиниць. Це можуть бути електронні листи для надсилання, кадри для рендерингу, файли для перекодування, діапазони ключів у базі даних NoSQL для сканування і так далі.
У складній системі може бути кілька різних наборів робочих одиниць. Тут ми розглядаємо лише один набір робочих одиниць, якими користувач хоче керувати разом — пакетне завдання.
Існує кілька різних патернів для паралельних обчислень, кожен з власними перевагами та недоліками. Компроміси:
Один обʼєкт Job для кожної робочої одиниці або один обʼєкт Job для всіх робочих одиниць. Один Job на кожну робочу одиницю створює деяку накладну роботу для користувача та системи під час управління великою кількістю обʼєктів Job. Один Job для всіх робочих одиниць підходить краще для великої кількості одиниць.
Кількість створених Podʼів дорівнює кількості робочих одиниць або кожен Pod може обробляти кілька робочих одиниць. Коли кількість Podʼів дорівнює кількості робочих одиниць, Podʼи зазвичай вимагають менше змін у наявному коді та контейнерах. Кожен Pod, що обробляє кілька робочих одиниць, підходить краще для великої кількості одиниць.
Кілька підходів використовують чергу роботи. Це вимагає запуску сервісу черги та змін наявної програми чи контейнера, щоб вони використовували чергу роботи. Інші підходи легше адаптувати до наявного контейнеризованого застосунку.
Коли Job повʼязаний із headless Service, ви можете дозволити Podʼам у межах Job спілкуватися один з одним для спільних обчислень.
Переваги та недоліки узагальнено у таблиці нижче, де стовпці з 2 по 4 відповідають зазначеним вище питанням. Назви патернів також є посиланнями на приклади та більш детальний опис.
Коли ви вказуєте завершення з .spec.completions, кожний Pod, створений контролером Job, має ідентичний spec. Це означає, що всі Podʼи для завдання матимуть однаковий командний рядок, однаковий образ, однакові томи та (майже) однакові змінні середовища. Ці патерни — це різні способи організації Podʼів для роботи над різними завданнями.
Ця таблиця показує обовʼязкові налаштування для .spec.parallelism та .spec.completions для кожного з патернів. Тут W — це кількість робочих одиниць.
Коли створюється Job, контролер Job негайно починає створювати Podʼи, щоб відповідати вимогам Job і продовжує це робити, доки Job не завершиться. Однак іноді ви можете хотіти тимчасово призупинити виконання Job та відновити його пізніше, або запускати Jobs у призупиненому стані, щоб власний контролер пізніше вирішував, коли їх запустити.
Щоб призупинити Job, ви можете оновити поле .spec.suspend Job на значення true; пізніше, коли ви захочете відновити його, оновіть його на значення false. Створення Job з .spec.suspend встановленим в true створить його в призупиненому стані.
У Kubernetes 1.35 або новіших версіях поле .status.startTime очищується під час призупинення Job, коли увімкнено функціональну можливість MutableSchedulingDirectivesForSuspendedJobs.
Під час відновлення Job після призупинення його поле .status.startTime буде скинуто на поточний час. Це означає, що таймер .spec.activeDeadlineSeconds буде зупинений і перезапущений, коли Job буде призупинено та відновлено.
Коли ви призупиняєте Job, будь-які запущені Podʼи, які не мають статусу Completed, будуть завершені з сигналом SIGTERM. Період коректного завершення Podʼа буде дотримано, і ваш Pod має обробити цей сигнал протягом цього періоду. Це може включати в себе збереження прогресу на майбутнє або скасування змін. Podʼи, завершені у такий спосіб, не враховуватимуться при підрахунку completions Job.
Приклад визначення Job в призупиненому стані може виглядати так:
Статус Job може бути використаний для визначення того, чи Job призупинено чи його було призупинено раніше:
kubectl get jobs/myjob -o yaml
apiVersion:batch/v1kind:Job# .metadata та .spec опущеноstatus:conditions:- lastProbeTime:"2021-02-05T13:14:33Z"lastTransitionTime:"2021-02-05T13:14:33Z"status:"True"type:SuspendedstartTime:"2021-02-05T13:13:48Z"
Стан Job типу "Suspended" зі статусом "True" означає, що Job призупинено; поле lastTransitionTime може бути використане для визначення того, як довго Job було призупинено. Якщо статус цього стану є "False", то Job було раніше призупинено і зараз він працює. Якщо такого стану не існує в статусі Job, то Job ніколи не був зупинений.
Також створюються події, коли Job призупинено та відновлено:
kubectl describe jobs/myjob
Name: myjob
...
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal SuccessfulCreate 12m job-controller Created pod: myjob-hlrpl
Normal SuccessfulDelete 11m job-controller Deleted pod: myjob-hlrpl
Normal Suspended 11m job-controller Job suspended
Normal SuccessfulCreate 3s job-controller Created pod: myjob-jvb44
Normal Resumed 3s job-controller Job resumed
Останні чотири події, зокрема події "Suspended" та "Resumed", є прямим наслідком перемикання поля .spec.suspend. Протягом цього часу ми бачимо, що жоден Pod не був створений, але створення Podʼів розпочалося знову, як тільки Job було відновлено.
Змінні директиви планування
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.27
У більшості випадків паралельний Job потребуватиме, щоб його Podʼи запускалися з певними обмеженнями, типу "всі в одній зоні" або "всі на GPU моделі x або y", але не комбінація обох.
Поле призупинення є першим кроком до такої семантики. Призупинення дозволяє власному контролеру черги вирішувати, коли має початися Job; однак після зняття призупинення власний контролер черги не впливає на те, де насправді будуть розташовані Podʼи Job.
Ця функція дозволяє оновлювати директиви планування Job до запуску, що дає власному контролеру черги змогу впливати на розташування Podʼів, водночас залишаючи саме призначення Podʼів вузлам за kube-scheduler.
Поля в шаблоні Podʼа Job, які можна оновити, це спорідненість вузла, селектор вузла, tolerations, мітки, анотації та scheduling gates.
Змінні директиви планування для призупинених Jobs
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
У Kubernetes 1.34 та раніших версіях змінювати директиви планування Podʼа дозволяється лише для призупинених Jobs, які ніколи не відновлювалися раніше. Починаючи з Kubernetes 1.35, це дозволяється для будь-яких призупинених Jobs, коли увімкнено функціональну можливість MutableSchedulingDirectivesForSuspendedJobs.
Крім того, ця функціональна можливість дозволяє очищати поле .status.startTime при призупиненні Job.
Змінні ресурси Podʼа для призупинених Jobs
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Адміністратор кластера може визначити контроль допуску в Kubernetes, змінюючи запити на ресурси або обмеження для Job на основі правил політики.
За допомогою цієї функції Kubernetes також дозволяє змінювати шаблон Podʼа для призупиненого Job, щоб змінити вимоги до ресурсів Podʼів у Job. Це відрізняється від зміни розміру Podʼа на місці, яке дозволяє оновлювати ресурси по одному Podʼу за раз для Podʼів, які вже працюють.
Клієнт, який встановлює нові запити на ресурси або обмеження, може відрізнятися від клієнта, який спочатку створив Job, і не обовʼязково має бути адміністратором кластера.
Визначення власного селектора Podʼа
Зазвичай, коли ви створюєте обʼєкт Job, ви не вказуєте .spec.selector. Логіка системного визначення типових значень додає це поле під час створення Job. Вона обирає значення селектора, яке не перетинатиметься з жодним іншим Job.
Однак у деяких випадках вам може знадобитися перевизначити цей автоматично встановлений селектор. Для цього ви можете вказати .spec.selector Job.
Будьте дуже уважні при цьому. Якщо ви вказуєте селектор міток, який не є унікальним для Podʼів цього Job, і який відповідає неповʼязаним Podʼам, то Podʼи неповʼязаного Job можуть бути видалені, або цей Job може зарахувати інші Podʼи як свої завершення, або один чи обидва Jobs можуть відмовитися створювати Podʼи чи виконуватися до завершення. Якщо вибрано неунікальний селектор, інші контролери (наприклад, ReplicationController) та їхні Podʼи також можуть поводитися непередбачувано. Kubernetes не завадить вам помилитися під час вказування .spec.selector.
Ось приклад ситуації, коли вам може знадобитися використовувати цю функцію.
Скажімо, Job old вже запущений. Ви хочете, щоб наявні Podʼи продовжували працювати, але щоб решта Podʼів, які він створює, використовували інший шаблон Podʼа, а Job мав нову назву. Ви не можете оновити Job, оскільки ці поля не можна оновлювати. Отже, ви видаляєте Job old, але залишаєте його Podʼи запущеними, використовуючи kubectl delete jobs/old --cascade=orphan. Перед видаленням ви занотовуєте, який селектор він використовує:
Потім ви створюєте новий Job із назвою new і явно вказуєте той самий селектор. Оскільки наявні Podʼи мають мітку batch.kubernetes.io/controller-uid=a8f3d00d-c6d2-11e5-9f87-42010af00002, вони також контролюються Job new.
Вам потрібно вказати manualSelector: true у новому Job, оскільки ви не використовуєте селектор, який система зазвичай генерує автоматично.
Сам новий Job матиме uid, відмінний від a8f3d00d-c6d2-11e5-9f87-42010af00002. Встановлення manualSelector: true говорить системі, що ви розумієте, що робите, і дозволяє цю невідповідність.
Відстеження Job за допомогою завершувачів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Панель управління стежить за Podʼами, які належать до будь-якого Job, і виявляє, чи якийсь такий Pod видалено з API-сервера. Для цього контролер Job створює Podʼи з завершувачем batch.kubernetes.io/job-tracking. Контролер видаляє завершувач тільки після того, як Pod був врахований в стані Job, що дозволяє видалити Pod іншими контролерами або користувачами.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.31; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.31. It was first available in the v1.27 release.
Ви можете масштабувати Indexed Jobs вгору або вниз, змінюючи як .spec.parallelism, так і .spec.completions разом, так щоб .spec.parallelism == .spec.completions. Під час масштабування вниз Kubernetes видаляє Podʼи з вищими індексами.
Сценарії використання еластичних Indexed Jobs включають пакетні робочі навантаження, які вимагають масштабування Indexed Job, такі як завдання навчання MPI, Horovod, Ray та PyTorch.
Примітка:
Коли функціональна можливість WorkloadWithJob увімкнена і Job використовує групове планування, розмір групи слідує за змінним schedulingPolicy.gang.minCount (або .spec.parallelism, коли minCount не встановлено). Ви можете масштабувати групу одним із двох способів:
встановити .spec.scheduling.schedulingPolicy.gang.minCount безпосередньо, або
змінити .spec.parallelism, коли minCount не встановлено.
При будь-якій зміні контролер перекомпілює Workload та повторно синхронізує розмір PodGroup, масштабуючи групу на місці без перестворення Job. Оновлення застосовуються лише до Podʼів, які оцінюються в майбутніх циклах планування, і не впливають на вже заплановані Podʼи. gang.minCount, більше за .spec.parallelism, відхиляється, оскільки така група ніколи не може бути задоволена.
Відкладене створення Podʼів-замінників
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.34
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.34. It was first available in the v1.28 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate JobPodReplacementPolicy, Kubernetes ignores it but does not report any error.
Типово контролер Job створює Podʼи заново, щойно вони зазнають збою або почнуть завершуватися (матимуть відмітку видалення). Це означає, що в певний момент часу, коли деякі з Podʼів завершуються, кількість запущених Podʼів для Job може бути більшою, ніж parallelism або більше, ніж один Pod на індекс (якщо ви використовуєте Indexed Job).
Ви можете створювати Podʼи-замінники лише тоді, коли Podʼи, які знаходяться в стані завершення, повністю завершені (мають status.phase: Failed). Для цього встановіть .spec.podReplacementPolicy: Failed. Типова політика заміни залежить від того, чи Job має встановлену політику збоїв Podʼа. Якщо для Job не визначено політику збоїв Podʼа, відсутність поля podReplacementPolicy вибирає політику заміни TerminatingOrFailed: панель управління створює Podʼи-замінники негайно після видалення Podʼів (як тільки панель управління бачить, що Pod для цього Job має встановлене значення deletionTimestamp). Для Jobs із встановленою політикою збоїв Podʼа стандартне значення podReplacementPolicy — це Failed, інших значень не передбачено. Докладніше про політики збоїв Podʼа для Jobs можна дізнатися у розділі Політика збоїв Podʼа.
При увімкненій функціональній можливості у вашому кластері ви можете перевірити поле .status.terminating Job. Значення цього поля — це кількість Podʼів, якими володіє Job, які зараз перебувають у стані завершення.
kubectl get jobs/myjob -o yaml
apiVersion:batch/v1kind:Job# .metadata та .spec опущеноstatus:terminating:3# три Podʼи, які перебувають у стані завершення і ще не досягли стану Failed
Делегування керування обʼєктом Job зовнішньому контролеру
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.35. It was first available in the v1.30 release.
Ця функція дозволяє вам вимкнути вбудований контролер Job для конкретного Job і делегувати узгодження цього Job зовнішньому контролеру.
Ви вказуєте контролер, який узгоджує Job, встановлюючи власне значення для поля spec.managedBy — будь-яке значення окрім kubernetes.io/job-controller. Значення поля є незмінним.
Примітка:
Під час використання цієї функції переконайтеся, що контролер, вказаний у полі, встановлено, інакше Job може бути не узгоджений взагалі.
Примітка:
При розробці зовнішнього контролера Job, будьте уважні: ваш контролер повинен працювати відповідно до визначень специфікації API та полів статусу обʼєкта Job.
Докладно ознайомтесь з ними в API Job. Ми також рекомендуємо запустити наскрізні тести сумісності для обʼєкта Job, щоб перевірити вашу реалізацію.
Нарешті, при розробці зовнішнього контролера Job переконайтеся, що він не використовує завершувач batch.kubernetes.io/job-tracking, зарезервований для вбудованого контролера.
Альтернативи
Окремі Podʼи
Коли вузол, на якому працює Pod, перезавантажується або виходить з ладу, Pod завершується і не буде перезапущений. Однак Job створить нові Podʼи для заміни завершених. З цієї причини ми рекомендуємо використовувати Job замість окремого Podʼа, навіть якщо ваш застосунок вимагає тільки одного Podʼа.
Replication Controller
Jobs доповнюють Replication Controllers. Replication Controller керує Podʼами, завершення яких не очікується (наприклад, вебсервери), а Job керує Podʼами, завершення яких очікується (наприклад, пакетні завдання).
Як зазначено в розділі Життєвий цикл Podʼа, Job придатний лише для Podʼів з RestartPolicy, рівним OnFailure або Never.
Примітка:
Якщо RestartPolicy не встановлено, стандартне значення — Always.
Один Job запускає контролер Podʼів
Ще один патерн: один Job створює Pod, який своєю чергою створює інші Podʼи, виступаючи як свого роду власний контролер для цих Podʼів. Це дає найбільшу гнучкість, але може бути дещо складним для початку використання та пропонує меншу інтеграцію з Kubernetes.
Перевагою цього підходу є те, що загальний процес отримує гарантію завершення обʼєкта Job, але при цьому повністю контролюється те, які Podʼи створюються і як їм призначається робота.
Перейдіть за посиланнями в розділі Автоматичне очищення завершених Jobs, щоб дізнатися більше про те, як ваш кластер може очищати завершені та/або невдалі завдання.
Job є частиною REST API Kubernetes. Ознайомтесь з визначенням обʼєкта
Job, щоб зрозуміти API для Jobs.
Прочитайте про CronJob, який ви можете використовувати для визначення серії Jobs, які виконуватимуться за розкладом, подібно до інструмента UNIX cron.
Попрактикуйтесь в налаштуванні обробки відновлюваних і невідновлюваних збоїв Podʼів за допомогою podFailurePolicy на основі покрокових прикладів.
Дізнайтеся про групове планування
для планування паралельних Jobs за принципом "все або нічого".
6.4.2.6 - Автоматичне очищення завершених Jobs
Механізм часу життя (TTL) для очищення старих Jobs, які завершили виконання.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.23
Коли ваш Job завершився, корисно залишити цей Job в API (і не видаляти його відразу), щоб ви могли визначити, успішно він виконався чи зазнав невдачі.
Контролер TTL-after-finished у Kubernetes забезпечує механізм TTL (time to live), щоб обмежити час життя обʼєктів Job, які завершили виконання.
Очищення завершених Jobs
Контролер TTL-after-finished підтримується лише для Jobs. Ви можете використовувати цей механізм для автоматичного очищення завершених Jobs (як Complete, так і Failed), вказавши поле .spec.ttlSecondsAfterFinished Job, як у цьому прикладі.
Контролер TTL-after-finished вважає, що Job можна очистити через TTL секунд після його завершення. Відлік починається, коли умова статусу Job змінюється, показуючи, що Job є або Complete, або Failed; щойно TTL закінчується, цей Job стає придатним для каскадного видалення. Коли контролер TTL-after-finished очищає Job, він видаляє його каскадно, тобто разом із залежними обʼєктами.
Kubernetes дотримується гарантій життєвого циклу обʼєкта для Job, таких як очікування завершувачів.
Ви можете встановити TTL секунд у будь-який момент. Ось деякі приклади встановлення поля .spec.ttlSecondsAfterFinished Job:
Вкажіть це поле в маніфесті Job, щоб Job можна було автоматично очистити через певний час після його завершення.
Вручну встановіть це поле для наявних, уже завершених Jobs, щоб вони стали придатними для очищення.
Використовуйте змінювальний вебхук допуску для динамічного встановлення цього поля під час створення Job. Адміністратори кластера можуть використовувати це, щоб застосовувати політику TTL для завершених Jobs.
Використовуйте змінювальний вебхук допуску для динамічного встановлення цього поля після завершення Job та вибору різних значень TTL на основі статусу Job і міток. У цьому випадку вебхук повинен виявляти зміни в полі .status Job і встановлювати TTL лише тоді, коли Job позначається як завершений.
Напишіть власний контролер для керування TTL очищення для Jobs, які відповідають певному селектору.
Застереження
Оновлення TTL для завершених Jobs
Ви можете змінювати період TTL, наприклад, поле .spec.ttlSecondsAfterFinished Jobs, після створення або завершення Job. Якщо ви збільшуєте період TTL після закінчення наявного періоду ttlSecondsAfterFinished, Kubernetes не гарантує збереження цього Job, навіть якщо оновлення для збільшення TTL повертає успішну відповідь API.
Зсув часу
Оскільки контролер TTL-after-finished використовує мітки часу, збережені в Jobs Kubernetes, для визначення того, чи минув TTL, ця функція чутлива до зсуву часу в кластері, через що панель управління може очистити обʼєкти Job у неправильний час.
Годинники не завжди точні, але різниця повинна бути дуже малою. Майте на увазі цей ризик під час встановлення ненульового TTL.
CronJob призначений для виконання регулярних запланованих дій, таких як резервне копіювання, генерація звітів та інше. Один обʼєкт CronJob подібний до одного рядка файлу crontab (таблиця cron) у системі Unix. Він запускає Job періодично за заданим розкладом, записаним у форматі Cron.
У CronJob є обмеження та особливості. Наприклад, за певних обставин один CronJob може створювати кілька одночасних Jobs. Див. обмеження нижче.
Коли панель управління створює нові Jobs і (опосередковано) Podʼи для CronJob, .metadata.name CronJob є частиною основи для назв цих Podʼів. Назва CronJob повинна бути дійсним значенням DNS-піддомену, але це може призводити до неочікуваних результатів для імен хостів Podʼів. Для найкращої сумісності назва повинна відповідати суворішим правилам DNS-мітки. Навіть коли назва є DNS-піддоменом, вона не повинна бути довшою за 52 символи. Це тому, що контролер CronJob автоматично додає 11 символів до наданої вами назви, а довжина назви Job не повинна перевищувати 63 символи.
Приклад
Цей приклад маніфесту CronJob виводить поточний час та вітальне повідомлення щохвилини:
Наприклад, 0 3 * * 1 означає, що це завдання планується запускати щотижня в понеділок о 3 ранку.
Формат також включає розширені значення кроків "Vixie cron". Як пояснено в документації FreeBSD:
Значення кроків можна використовувати разом із діапазонами. Якщо після діапазону вказати /<number>, це задає крок із таким значенням у межах діапазону. Наприклад, 0-23/2 можна використовувати в полі годин для вказування виконання команди кожну другу годину (альтернативою в стандарті V7 є 0,2,4,6,8,10,12,14,16,18,20,22). Після зірочки також допускаються кроки, тому, якщо ви хочете сказати "кожні дві години", просто використовуйте */2.
Примітка:
Знак питання (?) у розкладі має той самий зміст, що й зірочка *, тобто позначає будь-яке доступне значення для даного поля.
Окрім стандартного синтаксису, також можна використовувати деякі макроси, такі як @monthly:
Запис
Опис
Еквівалентно
@yearly (або @annually)
Виконувати один раз на рік о півночі 1 січня
0 0 1 1 *
@monthly
Виконувати один раз на місяць о півночі першого дня місяця
0 0 1 * *
@weekly
Виконувати один раз на тиждень о півночі в неділю
0 0 * * 0
@daily (або @midnight)
Виконувати один раз на день о півночі
0 0 * * *
@hourly
Виконувати один раз на годину на початку години
0 * * * *
Для генерації виразів розкладу CronJob можна також використовувати вебінструменти, наприклад crontab.guru.
Шаблон Job
Поле .spec.jobTemplate визначає шаблон для Jobs, які створює CronJob, і воно обовʼязкове. Воно має точно таку саму схему, як Job, за винятком того, що воно вкладене і не має apiVersion або kind. Ви можете вказати спільні метадані для Jobs, створених за шаблоном, такі як мітки або анотації. Інформацію щодо написання .spec Job дивіться в розділі Написання специфікації Job.
Крайній термін для відкладеного запуску Job
Поле .spec.startingDeadlineSeconds є необовʼязковим. Це поле визначає крайній термін (у повних секундах) для запуску Job, якщо цей Job пропускає свій запланований час з будь-якої причини.
Після спливання крайнього терміну CronJob пропускає цей екземпляр Job (майбутні запуски все ще плануються). Наприклад, якщо у вас є Job резервного копіювання, який запускається двічі на день, ви можете дозволити йому запускатися із запізненням до 8 годин, але не пізніше, оскільки резервна копія, зроблена пізніше, не буде корисною: ви б натомість воліли дочекатися наступного запланованого запуску.
Jobs, які пропускають налаштований крайній термін, Kubernetes вважає невдалими. Якщо ви не вказали startingDeadlineSeconds для CronJob, екземпляри Job не мають крайнього терміну.
Якщо поле .spec.startingDeadlineSeconds встановлено (не є null), контролер CronJob вимірює час між тим, коли очікується створення Job, і поточним моментом. Якщо різниця перевищує цю межу, він пропускає це виконання.
Наприклад, якщо воно встановлене на 200, це дозволяє створити Job протягом 200 секунд після фактичного часу за розкладом.
Політика паралелізму
Поле .spec.concurrencyPolicy також є необовʼязковим. Воно визначає, як обробляти паралельні виконання Job, який створюється цим CronJob. Специфікація може вказувати лише одну з таких політик паралелізму:
Allow (стандартно): CronJob дозволяє паралельні запуски Jobs
Forbid: CronJob не дозволяє паралельні запуски; якщо настав час для нового запуску Job і попередній запуск Job ще не завершився, CronJob пропускає новий запуск Job. Також зауважте, що коли попередній запуск Job завершиться, .spec.startingDeadlineSeconds все одно враховується і може призвести до нового запуску Job.
Replace: Якщо настав час для нового запуску Job і попередній запуск Job ще не завершився, CronJob замінює поточний запуск Job новим запуском Job.
Зверніть увагу, що політика паралелізму застосовується лише до Jobs, створених тим самим CronJob. Якщо є кілька CronJobs, їхні відповідні Jobs завжди можуть виконуватися паралельно.
Призупинення розкладу
Ви можете призупинити виконання Jobs для CronJob, встановивши необовʼязкове поле .spec.suspend в значення true. Стандартно поле має значення false.
Це налаштування не впливає на Jobs, які CronJob вже розпочав.
Якщо ви встановите це поле в значення true, всі наступні виконання будуть призупинені (вони залишаються запланованими, але контролер CronJob не запускає Jobs для виконання задач), доки ви не скасуєте призупинення CronJob.
Увага:
Виконання, які призупинені під час запланованого часу, вважаються пропущеними Jobs. Коли .spec.suspend змінюється з true на false для наявного CronJob без крайнього терміну запуску, пропущені Jobs плануються негайно.
Обмеження історії Jobs
Поля .spec.successfulJobsHistoryLimit та .spec.failedJobsHistoryLimit вказують, скільки успішних та невдалих Jobs потрібно зберігати. Обидва поля є необовʼязковими.
.spec.successfulJobsHistoryLimit: Це поле вказує кількість успішно завершених Jobs, які слід зберігати. Стандартне значення — 3. Якщо встановити це поле в 0, успішні Jobs не зберігатимуться.
.spec.failedJobsHistoryLimit: Це поле вказує кількість невдало завершених Jobs, які слід зберігати. Стандартне значення — 1. Якщо встановити це поле в 0, невдалі Jobs не зберігатимуться.
Для CronJobs без вказаного часового поясу kube-controller-manager інтерпретує розклади відносно свого локального часового поясу.
Ви можете вказати часовий пояс для CronJob, встановивши .spec.timeZone на назву дійсного часового поясу. Наприклад, встановлення .spec.timeZone: "Etc/UTC" вказує Kubernetes інтерпретувати розклад відносно всесвітнього координованого часу.
База даних часових поясів зі стандартної бібліотеки Go включена до бінарних файлів і використовується як запасний варіант, якщо зовнішня база даних недоступна в системі.
Обмеження CronJob
Непідтримувані специфікації часових поясів
Зазначення часового поясу за допомогою змінних CRON_TZ або TZ всередині .spec.scheduleофіційно не підтримується (і ніколи не підтримувалося). Якщо ви намагаєтеся встановити розклад, який включає вказування часового поясу TZ або CRON_TZ, Kubernetes не зможе створити чи оновити ресурс через помилку валідації. Натомість слід вказувати часові пояси, використовуючи поле часового поясу.
Зміна CronJob
За задумом CronJob містить шаблон для нових Jobs. Якщо ви змінюєте наявний CronJob, зміни застосовуватимуться до нових Jobs, які почнуть виконуватися після завершення вашої зміни. Jobs (та їхні Podʼи), які вже почали виконуватися, продовжують працювати без змін. Тобто CronJob не оновлює наявні Jobs, навіть якщо вони ще виконуються.
Створення Job
CronJob створює обʼєкт Job приблизно один раз за час виконання свого розкладу. Планування є приблизним, оскільки за певних обставин може бути створено два Jobs або жодного. Kubernetes намагається уникати таких ситуацій, але не повністю запобігає їм. Тому Jobs, які ви визначаєте, повинні бути ідемпотентними.
Починаючи з Kubernetes v1.32, CronJobs застосовують анотацію batch.kubernetes.io/cronjob-scheduled-timestamp до створених ними Jobs. Ця анотація вказує початковий запланований час створення Job і має формат RFC3339.
Якщо startingDeadlineSeconds встановлено на велике значення або залишено не встановленим (типово), і якщо concurrencyPolicy встановлено на Allow, Jobs завжди запускатимуться принаймні один раз.
Увага:
Якщо startingDeadlineSeconds встановлено у значення менше ніж 10 секунд, CronJob може не бути заплановано. Це повʼязано з тим, що контролер CronJob виконує перевірки кожні 10 секунд.
Для кожного CronJob контролер CronJob перевіряє, скільки розкладів він пропустив протягом часу від його останнього запланованого часу до теперішнього часу. Якщо пропущено понад 100 розкладів, то він не запускає Job і записує помилку в лог.
too many missed start times. Set or decrease .spec.startingDeadlineSeconds or check clock skew
Ця поведінка застосовується для планування наздоганяння і не означає, що CronJob припинить роботу.
Наприклад, під час використання concurrencyPolicy: Forbid довготривалі Jobs можуть призвести до пропуску запланованих часів, але новий Job може бути створений після завершення попереднього Job.
Важливо відзначити, що якщо поле startingDeadlineSeconds встановлено (не є nil), контролер підраховує, скільки пропущених Jobs сталося від значення startingDeadlineSeconds до теперішнього часу, а не від останнього запланованого часу до теперішнього часу. Наприклад, якщо startingDeadlineSeconds дорівнює 200, контролер підраховує, скільки Jobs було пропущено за останні 200 секунд.
CronJob вважається пропущеним, якщо не вдалося створити Job в запланований час. Наприклад, якщо concurrencyPolicy встановлено на Forbid і CronJob було спробовано запланувати, коли попередній Job все ще працював, то це враховуватиметься як пропуск.
Наприклад, припустимо, що CronJob встановлено для запуску нового Job кожну хвилину, починаючи з 08:30:00, і його поле startingDeadlineSeconds не встановлено. Якщо контролер CronJob виявиться недоступним з 08:29:00 по 10:21:00, Job не буде запущено, оскільки кількість пропущених Jobs, які пропустили свій розклад, понад 100.
Щоб краще проілюструвати цю концепцію, припустимо, що CronJob встановлено для запуску нового Job кожну хвилину, починаючи з 08:30:00, і його поле startingDeadlineSeconds встановлено на 200 секунд. Якщо контролер CronJob виявиться недоступним протягом того самого періоду, що й у попередньому прикладі (08:29:00 до 10:21:00), Job все одно запуститься о 10:22:00. Це трапляється тому, що тепер контролер перевіряє, скільки пропущених розкладів сталося за останні 200 секунд (тобто 3 пропущені розклади), а не від останнього запланованого часу до теперішнього часу.
CronJob відповідає лише за створення Job, які відповідають його розкладу, а Job, зі свого боку, відповідає за керування Podʼами, які він представляє.
Що далі
Дізнайтесь про Podʼи та Jobs, дві концепції, на які спираються CronJobs.
Дізнайтеся більше про формат поля .spec.schedule в CronJob.
CronJob є частиною REST API Kubernetes. Дивіться довідку
CronJob API для отримання докладних деталей.
6.4.2.8 - ReplicationController
Застарілий API для керування робочими навантаженнями, які можуть горизонтально масштабуватися. Замінено API Deployment та ReplicaSet.
Примітка:
Deployment, який налаштовує ReplicaSet, тепер є рекомендованим способом налаштування реплікації.
ReplicationController гарантує, що завжди запущено зазначену кількість реплік Podʼів. Іншими словами, ReplicationController гарантує, що Pod або однорідний набір Podʼів завжди працює та доступний.
Як працює ReplicationController
Якщо є занадто багато Podʼів, ReplicationController завершує зайві Podʼи. Якщо Podʼів замало, ReplicationController запускає додаткові. На відміну від вручну створених Podʼів, Podʼи, якими керує ReplicationController, автоматично замінюються, якщо вони зазнають збою, видаляються або завершуються. Наприклад, ваші Podʼи створюються на вузлі заново після обслуговування з порушенням роботи, такого як оновлення ядра. З цієї причини ви повинні використовувати ReplicationController, навіть якщо ваш застосунок вимагає лише одного Podʼа. ReplicationController схожий на наглядача процесів, але замість того, щоб наглядати за окремими процесами на одному вузлі, ReplicationController наглядає за кількома Podʼами на різних вузлах.
ReplicationController часто скорочується до "rc" в обговореннях та як скорочення в командах kubectl.
Простим випадком є створення одного обʼєкта ReplicationController для надійного запуску одного екземпляра Podʼа протягом необмеженого часу. Складніший випадок — це запуск кількох ідентичних реплік реплікованого сервісу, наприклад, вебсерверів.
Запуск прикладу ReplicationController
Цей приклад конфігурації ReplicationController запускає три копії вебсервера nginx.
Щоб перелічити всі Podʼи, які належать ReplicationController у формі, придатній для машинного читання, можна використовувати команду на зразок:
pods=$(kubectl get pods --selector=app=nginx --output=jsonpath={.items..metadata.name})echo$pods
Вивід подібний до такого:
nginx-3ntk0 nginx-4ok8v nginx-qrm3m
Тут селектор такий самий, як і селектор для ReplicationController (бачимо у виводі kubectl describe), і в іншій формі у replication.yaml. Опція --output=jsonpath вказує вираз із назвою кожного Podʼа в отриманому списку.
Створення маніфесту ReplicationController
Як і з усіма іншими конфігураціями Kubernetes, для ReplicationController потрібні поля apiVersion, kind і metadata.
Коли панель управління створює нові Podʼи для ReplicationController, .metadata.name ReplicationController є частиною основи для назв цих Podʼів. Назва ReplicationController повинна бути дійсним значенням DNS-піддомену, але це може призводити до неочікуваних результатів для імен хостів Podʼів. Для забезпечення найкращої сумісності назва повинна відповідати суворішим правилам для DNS-мітки.
Для загальної інформації про роботу з файлами конфігурації дивіться управління обʼєктами.
ReplicationController також потребує розділу .spec.
Шаблон Podʼа
.spec.template — єдине обовʼязкове поле в розділі .spec.
.spec.template — це шаблон Podʼа. Він має точно таку саму схему, як і Pod, за винятком того, що він вкладений і не має apiVersion або kind.
Окрім обовʼязкових полів для Podʼа, шаблон Podʼа в ReplicationController повинен вказувати відповідні мітки та відповідну політику перезапуску. Щодо міток, переконайтеся, що вони не перекриваються з іншими контролерами. Див. селектор Podʼа.
Для локальних перезапусків контейнерів ReplicationControllers делегують агентові на вузлі, наприклад, Kubelet.
Мітки на ReplicationController
ReplicationController може мати власні мітки (.metadata.labels). Зазвичай ви встановлюєте їх так само, як і .spec.template.metadata.labels; якщо .metadata.labels не вказано, то вони стандартно встановлюються як .spec.template.metadata.labels. Однак вони можуть бути різними, і .metadata.labels не впливають на поведінку ReplicationController.
Селектор Podʼа
Поле .spec.selector є селектором міток. ReplicationController керує всіма Podʼами з мітками, які відповідають селектору. Він не робить різниці між Podʼами, які він створив чи видалив, і Podʼами, які створив чи видалив інший процес чи особа. Це дозволяє замінити ReplicationController без впливу на запущені Podʼи.
Якщо вказано, то .spec.template.metadata.labels повинні дорівнювати .spec.selector, інакше їх відхилить API. Якщо .spec.selector не вказано, він буде встановлений типово як .spec.template.metadata.labels.
Також, як правило, ви не повинні створювати жодних Podʼів, мітки яких відповідають цьому селектору, безпосередньо, з іншим ReplicationController або з іншим контролером, таким як Job. Якщо ви це зробите, то ReplicationController вважатиме, що він створив інші Podʼи. Kubernetes не забороняє вам це робити.
Якщо у вас все-таки виникає кілька контролерів із селекторами, що перетинаються, вам доведеться керувати видаленням самостійно (див. нижче).
Кілька реплік
Ви можете вказати, скільки Podʼів повинно працювати одночасно, встановивши .spec.replicas рівним кількості Podʼів, які ви хочете мати одночасно. Кількість, що працює в будь-який момент, може бути більшою або меншою, наприклад, якщо репліки тільки що були збільшені або зменшені, чи якщо Pod коректно зупинено, а його заміна запускається раніше.
Якщо ви не вказали .spec.replicas, то типово встановлюється 1.
Робота з ReplicationControllers
Видалення ReplicationController та його Podʼів
Щоб видалити ReplicationController та всі його Podʼи, використовуйте команду kubectl delete. Kubectl масштабує ReplicationController до нуля і чекає, доки кожний Pod буде видалено, перед видаленням самого ReplicationController. Якщо цю команду kubectl перервати, її можна перезапустити.
Під час використання REST API або бібліотеки клієнта вам потрібно виконати кроки явно (масштабування реплік до 0, очікування видалення Podʼів, а потім видалення самого ReplicationController).
Видалення лише ReplicationController
Ви можете видалити ReplicationController, не впливаючи на його Podʼи.
Під час використання kubectl вкажіть опцію --cascade=orphan команді kubectl delete.
Під час використання REST API або бібліотеки клієнта ви можете видалити обʼєкт ReplicationController.
Після видалення оригіналу ви можете створити новий ReplicationController, щоб замінити його. Поки старий та новий .spec.selector однакові, новий перейме старі Podʼи. Однак він не буде вживати жодних зусиль, щоб наявні Podʼи відповідали новому, відмінному від оригінального, шаблону Podʼа. Щоб оновити Podʼи за новою специфікацією у керований спосіб, використовуйте поетапне оновлення.
Ізолювання Podʼів від ReplicationController
Podʼи можуть бути вилучені із цільового набору ReplicationController зміною їхніх міток. Цей метод може бути використаний для виведення Podʼів з обслуговування для налагодження та відновлення даних. Podʼи, вилучені цим способом, будуть автоматично замінені (за умови, що кількість реплік також не змінюється).
Поширені шаблони використання
Перепланування
Як було зазначено вище, чи у вас є 1 Pod, який вам потрібно тримати в роботі, чи 1000, ReplicationController гарантує, що зазначена кількість Podʼів існує, навіть у випадку відмови вузла або завершення Podʼа (наприклад, через дію іншого агента управління).
Масштабування
ReplicationController дозволяє масштабувати кількість реплік вгору або вниз, як вручну, так і за допомогою агента автомасштабування, оновлюючи поле replicas.
Поетапні оновлення
ReplicationController призначений для полегшення поетапного оновлення сервісу за допомогою заміни Podʼів один за одним.
Як пояснено в #1353, рекомендований підхід — створити новий ReplicationController з 1 реплікою, масштабувати нові (+1) та старі (-1) контролери по одному, а потім видалити старий контролер після досягнення 0 реплік. Це передбачувано оновлює набір Podʼів незалежно від неочікуваних відмов.
В ідеалі контролер поетапного оновлення мав би враховувати готовність застосунку і гарантувати, що достатня кількість Podʼів у будь-який момент продуктивно обслуговує запити.
Обом ReplicationControllers потрібно створювати Podʼи із принаймні однією відмінною міткою, такою як теґ образу основного контейнера Podʼа, оскільки саме оновлення образів зазвичай спонукають до поетапних оновлень.
Кілька каналів випуску
Окрім запуску кількох випусків застосунку під час поетапного оновлення, часто запускають кілька випусків протягом тривалого часу або навіть постійно, використовуючи кілька каналів випуску. Канали розрізняються за допомогою міток.
Наприклад, сервіс може охоплювати всі Podʼи з tier in (frontend), environment in (prod). Тепер скажімо, у вас є 10 реплікованих Podʼів, які складають цей рівень. Але ви хочете мати можливість випробувати нову версію цього компонента як канарку (canary). Ви можете налаштувати ReplicationController із replicas, встановленим на 9 для більшості реплік, з мітками tier=frontend, environment=prod, track=stable, та інший ReplicationController із replicas, встановленим на 1 для канарки, з мітками tier=frontend, environment=prod, track=canary. Тепер сервіс охоплює як канаркові, так і не канаркові Podʼи. Але ви можете окремо працювати з ReplicationControllers, щоб щось перевіряти, відстежувати результати тощо.
Використання ReplicationControllers із Services
Кілька ReplicationControllers можуть працювати за одним сервісом, так що, наприклад, частина трафіку іде до старої версії, а частина до нової.
ReplicationController ніколи не завершиться самостійно, але не очікується, що він житиме так довго, як сервіси. Сервіси можуть складатися з Podʼів, контрольованих кількома ReplicationControllers, і передбачається, що протягом життя сервісу (наприклад, для виконання оновлення Podʼів, які забезпечують роботу сервісу) буде створено і знищено багато ReplicationControllers. І самі сервіси, і їхні клієнти не повинні нічого знати про ReplicationControllers, які підтримують Podʼи цих сервісів.
Написання програм для реплікації
Podʼи, створені ReplicationController, призначені бути взаємозамінними та семантично ідентичними, хоча їхні конфігурації з часом можуть ставати неоднорідними. Це очевидно підходить для реплікованих stateless-серверів, але ReplicationControllers також можна використовувати для забезпечення доступності застосунків із вибором master, шардованих застосунків і застосунків із пулом робочих процесів. Такі застосунки повинні використовувати механізми динамічного призначення роботи, такі як черги роботи RabbitMQ, на відміну від статичного / одноразового налаштування конфігурації кожного Podʼа, що вважається антипатерном. Будь-яке налаштування Podʼа, таке як вертикальне автоматичне визначення розміру ресурсів (наприклад, CPU чи памʼяті), повинно виконуватися іншим онлайн-процесом контролера, подібним до самого ReplicationController.
Обовʼязки ReplicationController
ReplicationController гарантує, що бажана кількість Podʼів відповідає його селектору міток і працює. Наразі з його підрахунку виключаються лише завершені Podʼи. У майбутньому можливо буде враховувати інформацію про готовність та інші дані, доступні від системи, можливо буде додано більше елементів керування політикою заміни, і планується генерація подій, які можуть використовуватися зовнішніми клієнтами для впровадження як завгодно складних політик заміни та / або зменшення масштабу.
ReplicationController назавжди обмежений цією вузькою відповідальністю. Він сам не виконуватиме проби готовності чи життєздатності. Замість автоматичного масштабування він призначений для управління зовнішнім автомасштабувальником (як обговорюється в #492), який буде змінювати його поле replicas. Ми не будемо додавати політик планування (наприклад, розподілення) до ReplicationController. Він також не повинен перевіряти, чи відповідають контрольовані Podʼи поточному зазначеному шаблону, оскільки це заважало б автоматичному визначенню розміру та іншим автоматизованим процесам. Так само крайні терміни завершення, залежності порядку, розширення конфігурації та інші функції мають бути в інших місцях. Навіть планується виділити механізм масового створення Podʼів (#170).
ReplicationController призначений бути компонованим базовим примітивом. Ми очікуємо, що на його основі та на основі інших доповнювальних примітивів у майбутньому буде побудовано високорівневі API та / або інструменти для зручності користувачів. "Макро" операції, які наразі підтримуються kubectl (run, scale), є прикладами перевірки цієї концепції. Наприклад, можемо уявити щось на зразок Asgard, що управляє ReplicationControllers, автомасштабувальниками, сервісами, політиками планування, канарковими розгортаннями та іншими аспектами.
Обʼєкт API
ReplicationController є ресурсом верхнього рівня в REST API Kubernetes. Докладніша інформація про обʼєкт API є за посиланням: Обʼєкт API ReplicationController.
Альтернативи ReplicationController
ReplicaSet
ReplicaSet — це ReplicationController нового покоління, який підтримує новий селектор міток на основі множини. Він використовується головним чином Deployment як механізм для оркестрування створення, видалення та оновлення Podʼів. Зауважте, що ми рекомендуємо використовувати Deployments замість безпосереднього використання ReplicaSets, хіба що вам потрібне власне оркестрування оновлень або оновлення взагалі не потрібні.
Deployment (Рекомендовано)
Deployment — це обʼєкт API вищого рівня, який оновлює свої базові ReplicaSets та їхні Podʼи. Deployments рекомендуються, якщо вам потрібна функціональність поетапного оновлення, оскільки вони є декларативними, виконуються на сервері та мають додаткові функції.
Окремі Podʼи
На відміну від випадку, коли користувач створює Podʼи безпосередньо, ReplicationController замінює Podʼи, які видаляються або завершуються з будь-якої причини, такої як відмова вузла або обслуговування вузла з порушенням роботи, наприклад, оновлення ядра. З цієї причини ми рекомендуємо використовувати ReplicationController, навіть якщо ваш застосунок вимагає лише одного Podʼа. Вважайте це подібним наглядачу процесів, тільки він наглядає за кількома Podʼами на кількох вузлах, а не за окремими процесами на одному вузлі. ReplicationController делегує локальні перезапуски контейнерів деякому агенту на вузлі, наприклад kubelet.
Job
Використовуйте Job замість ReplicationController для Podʼів, які мають завершуватись самі по собі (іншими словами, пакетні завдання).
DaemonSet
Використовуйте DaemonSet замість ReplicationController для Podʼів, які забезпечують функцію рівня машини, таку як моніторинг машини або логування машини. Ці Podʼи мають термін служби, який повʼязаний із терміном служби машини: Pod повинен працювати на машині перед тим, як інші Podʼи почнуть працювати, і може бути безпечно завершений, коли машина готова до перезавантаження або вимкнення.
Дізнайтеся більше про Deployment, альтернативу ReplicationController.
ReplicationController — це частина REST API Kubernetes. Ознайомтесь з визначенням обʼєкта
ReplicationController, щоб зрозуміти API для контролерів реплікації.
6.4.3 - Керування робочими навантаженнями
Ви розгорнули ваш застосунок та відкрили до нього доступ через Service. Що далі? Kubernetes надає низку інструментів, які допомагають керувати розгортанням вашого застосунку, зокрема масштабуванням та оновленням.
Організація конфігурацій ресурсів
Багато застосунків потребують створення кількох ресурсів, таких як Deployment разом із Service. Керування кількома ресурсами можна спростити, обʼєднавши їх в одному файлі (розділивши їх --- у YAML). Наприклад:
service/my-nginx-svc created
deployment.apps/my-nginx created
Ресурси будуть створені в порядку, в якому вони зʼявляються в маніфесті. Тому краще спочатку вказати Service, оскільки це забезпечить, що планувальник зможе розподілити повʼязані з Service Podʼи в процесі їх створення контролером(ами), такими як Deployment.
Рекомендовано розміщувати ресурси, повʼязані з одним мікросервісом або рівнем застосунку, в одному файлі та групувати всі файли, повʼязані з вашим застосунком, в одній теці. Якщо рівні вашого застосунку звʼязуються один з одним за допомогою DNS, ви можете розгорнути всі компоненти вашого стека разом.
Також можна вказати URL як джерело конфігурації, що зручно для розгортання безпосередньо з маніфестів у вашій системі контролю версій:
Якщо потрібно визначити більше маніфестів, наприклад, додати ConfigMap, це також можна зробити.
Зовнішні інструменти
У цьому розділі перераховані лише найпоширеніші інструменти, які використовуються для керування робочими навантаженнями в Kubernetes. Щоб переглянути більше інструментів, подивіться Application definition and image build в CNCF Landscape.
Helm
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
Helm — це інструмент для керування пакетами попередньо налаштованих ресурсів Kubernetes. Ці пакети відомі як Helm-чарти.
Kustomize
Kustomize проходить по маніфестах Kubernetes, щоб додати, видалити або оновити конфігураційні опції. Він доступний як окремий бінарний файл і як вбудована можливість kubectl.
Пакетні операції в kubectl
Створення ресурсів — не єдина операція, яку kubectl може виконувати в пакетному режимі. Він також може витягувати назви ресурсів з конфігураційних файлів для виконання інших операцій, зокрема для видалення тих же ресурсів, які ви створили:
Для більшої кількості ресурсів буде зручніше вказати селектор (запит за мітками), використовуючи -l або --selector, щоб відфільтрувати ресурси за їхніми мітками:
kubectl delete deployment,services -l app=nginx
deployment.apps "my-nginx" deleted
service "my-nginx-svc" deleted
Ланцюжки та фільтрація
Оскільки kubectl виводить назви ресурсів у тому ж синтаксисі, який він приймає, ви можете обʼєднувати операції в ланцюжки, використовуючи $() або xargs:
kubectl get $(kubectl create -f docs/concepts/cluster-administration/nginx/ -o name | grep service/ )kubectl create -f docs/concepts/cluster-administration/nginx/ -o name | grep service/ | xargs -i kubectl get '{}'
Вивід може бути подібний до:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
my-nginx-svc LoadBalancer 10.0.0.208 <pending> 80/TCP 0s
За допомогою наведених вище команд ви спочатку створюєте ресурси в docs/concepts/cluster-administration/nginx/ і виводите створені ресурси у форматі виводу -o name (виводите кожен ресурс як resource/name). Потім за допомогою grep ви вибираєте лише Service, а потім виводите його за допомогою kubectl get.
Рекурсивні операції з локальними файлами
Якщо ви організували ваші ресурси в кількох підтеках всередині певної теки, ви можете рекурсивно виконувати операції і з підтеками, вказавши --recursive або -R разом з аргументом --filename/-f.
Наприклад, припустимо, є тека project/k8s/development, яка містить усі маніфести, необхідні для середовища розробки, організовані за типом ресурсу:
Стандартно виконання пакетної операції для project/k8s/development зупиниться на першому рівні теки, не обробляючи жодних вкладених тек. Якщо ви спробували б створити ресурси з цієї теки, використовуючи наступну команду, ви б отримали помилку:
kubectl apply -f project/k8s/development
error: you must provide one or more resources by argument or filename (.json|.yaml|.yml|stdin)
Натомість вкажіть аргумент командного рядка --recursive або -R разом з аргументом --filename/-f:
configmap/my-config created
deployment.apps/my-deployment created
persistentvolumeclaim/my-pvc created
Аргумент --recursive працює з будь-якою операцією, яка приймає аргумент --filename/-f, такою як: kubectl create, kubectl get, kubectl delete, kubectl describe або навіть kubectl rollout.
Аргумент --recursive також працює, коли вказані кілька аргументів -f:
namespace/development created
namespace/staging created
configmap/my-config created
deployment.apps/my-deployment created
persistentvolumeclaim/my-pvc created
В якийсь момент вам, ймовірно, доведеться оновити ваш розгорнутий застосунок, зазвичай шляхом зазначення нового образу чи теґу образу. kubectl підтримує кілька операцій оновлення, кожна з яких застосовується до різних сценаріїв.
Ви можете запускати кілька копій вашого застосунку і використовувати розгортання (rollout) для поступового перенаправлення трафіку до нових справних Podʼів. З часом всі запущені Podʼи отримають нове програмне забезпечення.
У цьому розділі сторінки показано, як створювати та оновлювати застосунки за допомогою Deployments.
Щоб оновитись до версії 1.16.1, змініть .spec.template.spec.containers[0].image з nginx:1.14.2 на nginx:1.16.1, використовуючи kubectl edit:
kubectl edit deployment/my-nginx
# Змініть маніфест, щоб використовувати новіший образ контейнера, потім збережіть зміни
Ось і все! Deployment декларативно й поступово оновить розгорнутий застосунок nginx у фоновому режимі. Він забезпечує, що лише певна кількість старих реплік може бути недоступною під час оновлення, і лише певна кількість нових реплік може бути створена понад бажану кількість Podʼів. Щоб дізнатися більше про те, як це відбувається, перегляньте сторінку Deployment.
Ви можете використовувати розгортання з DaemonSets, Deployments або StatefulSets.
Керування розгортаннями
Ви можете використовувати kubectl rollout для керування поступовим оновленням наявного застосунку.
Наприклад:
kubectl apply -f my-deployment.yaml
# дочекайтеся завершення розгортанняkubectl rollout status deployment/my-deployment --timeout 10m # тайм-аут 10 хвилин
або
kubectl apply -f backing-stateful-component.yaml
# не чекайте завершення розгортання, просто перевірте статусkubectl rollout status statefulsets/backing-stateful-component --watch=false
Ви також можете призупиняти, відновлювати або скасовувати розгортання. Перегляньте kubectl rollout для отримання додаткової інформації.
Канаркові розгортання
Ще один сценарій, коли потрібні кілька міток, — розрізнення розгортань різних версій або конфігурацій одного й того ж компонента. Поширеною практикою є канаркове розгортання нової версії застосунку (зазначеної через теґ образу в шаблоні Podʼа) поруч з попередньою версією, щоб нова версія могла отримати реальний промисловий трафік перед повним розгортанням.
Наприклад, можна використовувати мітку track для розрізнення різних версій.
Основна, стабільна версія буде мати мітку track зі значенням stable:
А потім ви можете створити нову версію фронтенду для guestbook, яка має мітку track з іншим значенням (тобто canary), так що два набори Podʼів не перетинатимуться:
Service фронтенду охоплюватиме обидва набори реплік, вибираючи спільну підмножину їх міток (тобто пропускаючи мітку track), так що трафік буде перенаправлено на обидва застосунки:
selector:app:guestbooktier:frontend
Ви можете налаштувати кількість реплік стабільної та канаркової версій, щоб визначити частку реального промислового трафіку, яку отримає кожна з них (у цьому випадку 3:1). Коли ви будете впевнені в новій версії, ви можете оновити стабільний канал випуску до нової версії застосунку і видалити канаркову.
Іноді ви захочете додати анотації до ресурсів. Анотації — це довільні неідентифікувальні метадані, які можуть отримувати API-клієнти, такі як інструменти або бібліотеки. Це можна зробити за допомогою kubectl annotate. Наприклад:
Коли навантаження на ваш застосунок зростає або зменшується, використовуйте kubectl, щоб масштабувати ваш застосунок. Наприклад, щоб зменшити кількість реплік nginx з 3 до 1, виконайте:
kubectl scale deployment/my-nginx --replicas=1
deployment.apps/my-nginx scaled
Тепер у вас буде тільки один Pod, яким керує Deployment.
kubectl get pods -l app=my-nginx
NAME READY STATUS RESTARTS AGE
my-nginx-2035384211-j5fhi 1/1 Running 0 30m
Щоб система автоматично вибирала кількість реплік nginx в межах від 1 до 3, виконайте:
# Для цього потрібне наявне джерело метрик контейнерів і Podʼівkubectl autoscale deployment/my-nginx --min=1 --max=3
Іноді потрібно вносити до створених вами ресурсів вузькі оновлення, що не порушують роботу.
kubectl apply
Рекомендується підтримувати набір конфігураційних файлів у системі контролю версій (див. конфігурація як код), щоб їх можна було підтримувати та версіонувати разом з кодом для ресурсів, які вони конфігурують. Тоді ви можете використовувати kubectl apply для того, щоб надіслати зміни конфігурації в кластер.
Ця команда порівнює версію конфігурації, яку ви надсилаєте, з попередньою версією та застосовує внесені вами зміни, не перезаписуючи автоматичні зміни властивостей, які ви не вказали.
Щоб дізнатися більше про механізм, що лежить в основі, прочитайте server-side apply.
kubectl edit
Також ви можете оновлювати ресурси за допомогою kubectl edit:
kubectl edit deployment/my-nginx
Це еквівалентно тому, щоб спочатку виконати get для ресурсу, відредагувати його в текстовому редакторі, а потім виконати apply для ресурсу з оновленою версією:
kubectl get deployment my-nginx -o yaml > /tmp/nginx.yaml
vi /tmp/nginx.yaml
# зробіть деякі редагування, а потім збережіть файлkubectl apply -f /tmp/nginx.yaml
deployment.apps/my-nginx configured
rm /tmp/nginx.yaml
Це дозволяє легше вносити більш значні зміни. Зверніть увагу, що ви можете вказати редактор за допомогою змінних середовища EDITOR або KUBE_EDITOR.
Для отримання додаткової інформації дивіться kubectl edit.
kubectl patch
Ви можете використовувати kubectl patch для оновлення обʼєктів API на місці. Ця підкоманда підтримує JSON patch, JSON merge patch і strategic merge patch.
В деяких випадках може знадобитися оновити поля ресурсу, які не можна оновити після його ініціалізації, або може знадобитися зробити рекурсивну зміну негайно, наприклад, щоб виправити несправні Podʼи, створені Deployment. Для зміни таких полів використовуйте replace --force, що видаляє і повторно створює ресурс. У цьому випадку ви можете змінити ваш оригінальний конфігураційний файл:
З автомасштабуванням ви можете автоматично оновлювати ваші робочі навантаження різними способами. Це дозволяє вашому кластеру еластичніше та ефективніше реагувати на зміни попиту на ресурси.
У Kubernetes ви можете масштабувати робоче навантаження залежно від поточного попиту на ресурси. Це дозволяє вашому кластеру більш еластично та ефективно реагувати на зміни попиту на ресурси.
Під час масштабування робочого навантаження ви можете збільшувати або зменшувати кількість реплік, якими керує робоче навантаження, або налаштовувати ресурси, доступні реплікам, на місці.
Перший підхід називається горизонтальним масштабуванням, тоді як другий — вертикальним масштабуванням.
Є ручні та автоматичні способи масштабування робочих навантажень, залежно від вашого сценарію використання.
Ручне масштабування робочих навантажень
Kubernetes підтримує ручне масштабування робочих навантажень. Горизонтальне масштабування можна виконати за допомогою інтерфейсу командного рядка kubectl. Для вертикального масштабування вам потрібно застосувати патч до визначення ресурсів вашого робочого навантаження.
Kubernetes також підтримує автоматичне масштабування робочих навантажень, що є основною темою цієї сторінки.
Поняття автомасштабування в Kubernetes означає можливість автоматично оновлювати обʼєкт, який керує набором Podʼів (наприклад, Deployment).
Горизонтальне масштабування робочих навантажень
У Kubernetes ви можете автоматично масштабувати робоче навантаження горизонтально за допомогою HorizontalPodAutoscaler (HPA).
Він реалізований як ресурс API Kubernetes та контролер і періодично коригує кількість реплік в робочому навантаженні відповідно до спостережуваного використання ресурсів, наприклад, використання CPU чи памʼяті.
Ви можете автоматично масштабувати робоче навантаження вертикально за допомогою VerticalPodAutoscaler (VPA). На відміну від HPA, VPA стандартно не постачається з Kubernetes, але це надбудова, яку вам або адміністратору кластера може знадобитися розгорнути, перш ніж ви зможете нею користуватися.
Після встановлення він дозволяє створювати CustomResourceDefinitions (CRDs) для ваших робочих навантажень, які визначають як і коли масштабувати ресурси керованих реплік.
Примітка:
Для роботи VPA у вашому кластері має бути встановлений Metrics Server.
Вертикальне масштабування Podʼів на місці
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate InPlacePodVerticalScaling, Kubernetes ignores it but does not report any error.
Станом на Kubernetes 1.37 VPA не підтримує зміну розміру Podʼів на місці, але над цією інтеграцією працюють. Щоб вручну змінити розмір Podʼів на місці, див. Зміна розміру ресурсів контейнера на місці.
Автомасштабування на основі розміру кластера
Для робочих навантажень, які потрібно масштабувати залежно від розміру кластера (наприклад, cluster-dns чи інші системні компоненти), ви можете використовувати Cluster Proportional Autoscaler. Так само як і VPA, він не є частиною ядра Kubernetes, а розміщений як окремий проєкт на GitHub.
Cluster Proportional Autoscaler відстежує кількість придатних для планування вузлів та ядер і відповідно масштабує кількість реплік цільового робочого навантаження.
Якщо кількість реплік має залишитися незмінною, ви можете масштабувати свої робочі навантаження вертикально залежно від розміру кластера, використовуючи Cluster Proportional Vertical Autoscaler. Проєкт наразі перебуває у бета-версії та доступний на GitHub.
Тоді як Cluster Proportional Autoscaler масштабує кількість реплік робочого навантаження, Cluster Proportional Vertical Autoscaler коригує запити на ресурси для робочого навантаження (наприклад, Deployment або DaemonSet) залежно від кількості вузлів та/або ядер у кластері.
KEDA — це проєкт CNCF зі статусом graduated, що дозволяє масштабувати ваші робочі навантаження залежно від кількості подій, які потрібно обробити, наприклад, кількості повідомлень у черзі. Існує широкий спектр адаптерів для різних джерел подій на вибір.
Автомасштабування на основі розкладу
Ще одна стратегія масштабування ваших робочих навантажень — планувати операції масштабування за розкладом, наприклад, щоб зменшити споживання ресурсів у непікові години.
Як і у випадку автомасштабування на основі подій, такої поведінки можна досягти за допомогою KEDA разом з його Cron scaler. Cron scaler дозволяє вам визначати розклади (і часові пояси) для збільшення чи зменшення ваших робочих навантажень.
Масштабування інфраструктури кластера
Якщо масштабування робочих навантажень недостатньо для ваших потреб, ви також можете масштабувати саму інфраструктуру вашого кластера.
Масштабування інфраструктури кластера зазвичай передбачає додавання або видалення вузлів. Дивіться Автомасштабування вузлів для отримання додаткової інформації.
У Kubernetes HorizontalPodAutoscaler автоматично оновлює ресурс робочого навантаження (наприклад, Deployment або StatefulSet), щоб автоматично масштабувати потужності відповідно до попиту.
Горизонтальне масштабування означає, що реакція на збільшення навантаження полягає у розгортанні додаткових Podʼів. Це відрізняється від вертикального масштабування, що для Kubernetes означає призначення додаткових ресурсів (наприклад, памʼяті або CPU) для уже запущених Podʼів робочого навантаження.
Якщо навантаження зменшується, а кількість Podʼів перевищує налаштований мінімум, HorizontalPodAutoscaler дає вказівку ресурсу робочого навантаження (Deployment, StatefulSet або іншому схожому ресурсу) масштабуватися вниз.
Горизонтальне автомасштабування Podʼів не застосовується до обʼєктів, які не можна масштабувати (наприклад, DaemonSet).
HorizontalPodAutoscaler реалізований як ресурс API Kubernetes та контролер. Ресурс визначає поведінку контролера. Контролер горизонтального автомасштабування Podʼів, який працює в панелі управління Kubernetes, періодично коригує бажаний масштаб своєї цілі (наприклад, Deployment), щоб він відповідав спостережуваним метрикам, таким як середнє використання CPU, середнє використання памʼяті або будь-яка інша власна метрика, яку ви вказуєте.
Є покроковий приклад використання горизонтального автомасштабування Podʼів.
Як працює HorizontalPodAutoscaler?
graph BT
hpa[HorizontalPodAutoscaler] --> scale[Scale]
subgraph rc[Deployment]
scale
end
scale -.-> pod1[Pod 1]
scale -.-> pod2[Pod 2]
scale -.-> pod3[Pod N]
classDef hpa fill:#D5A6BD,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef rc fill:#F9CB9C,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef scale fill:#B6D7A8,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef pod fill:#9FC5E8,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
class hpa hpa;
class rc rc;
class scale scale;
class pod1,pod2,pod3 pod
Схема 1. HorizontalPodAutoscaler керує масштабуванням Deployment та його ReplicaSet
У Kubernetes горизонтальне автомасштабування Podʼів реалізовано як цикл керування, що працює періодично (це не безперервний процес). Інтервал встановлюється параметром --horizontal-pod-autoscaler-sync-period для kube-controller-manager (а стандартне значення — 15 секунд).
Один раз протягом кожного періоду менеджер контролерів запитує використання ресурсів відповідно до метрик, вказаних у визначенні кожного HorizontalPodAutoscaler. Менеджер контролерів знаходить цільовий ресурс, визначений за допомогою scaleTargetRef, потім вибирає Podʼи на основі міток .spec.selector цільового ресурсу та отримує метрики або з API метрик ресурсів (для метрик ресурсів на кожен Pod), або з API власних метрик (для всіх інших метрик).
Для метрик ресурсів на кожен Pod (наприклад, CPU) контролер отримує метрики з API метрик ресурсів для кожного Podʼа, на який спрямований HorizontalPodAutoscaler. Потім, якщо встановлено значення цільового використання, контролер обчислює значення використання як відсоток відповідного запиту на ресурс контейнерів у кожному Podʼі. Якщо встановлено сире цільове значення, безпосередньо використовуються сирі (необроблені) значення метрик. Потім контролер бере середнє значення використання або сире значення (залежно від типу вказаної цілі) для всіх цільових Podʼів і створює співвідношення, яке використовується для масштабування кількості бажаних реплік.
Зверніть увагу, що якщо для деяких контейнерів Podʼа не встановлено відповідний запит на ресурс, використання CPU для Podʼа не буде визначено, і автомасштабувальник не виконуватиме жодних дій для цієї метрики. Дивіться розділ подробиці алгоритму нижче для отримання додаткової інформації про те, як працює алгоритм автомасштабування.
Для власних метрик на кожен Pod контролер працює аналогічно метрикам ресурсів на кожен Pod, за винятком того, що він працює із сирими значеннями, а не значеннями використання.
Для метрик обʼєктів та зовнішніх метрик отримується одна метрика, яка описує обʼєкт. Цю метрику порівнюють з цільовим значенням, щоб отримати співвідношення, як вище. У версії API autoscaling/v2 це значення можна за необхідності розділити на кількість Podʼів до порівняння.
Звичайне використання HorizontalPodAutoscaler — налаштувати його на отримання метрик з агрегованих API (metrics.k8s.io, custom.metrics.k8s.io або external.metrics.k8s.io). API metrics.k8s.io зазвичай надається надбудовою Metrics Server, яку потрібно запускати окремо. Для отримання додаткової інформації про метрики ресурсів див. Metrics Server.
Підтримка API метрик пояснює гарантії стабільності та статус підтримки цих різних API.
Контролер HorizontalPodAutoscaler має доступ до відповідних ресурсів робочого навантаження, які підтримують масштабування (такі як Deployments та StatefulSet). Ці ресурси мають субресурс з назвою scale, інтерфейс, який дозволяє динамічно встановлювати кількість реплік і переглядати поточний стан кожного з них. Для загальної інформації про субресурси в API Kubernetes див. Поняття API Kubernetes.
Подробиці алгоритму
У найпростішому вигляді контролер HorizontalPodAutoscaler працює зі співвідношенням між бажаним значенням метрики та поточним значенням метрики:
Наприклад, якщо поточне значення метрики — 200m, а бажане значення — 100m, кількість реплік буде подвоєна, оскільки \( { 200.0 \div 100.0 } = 2.0 \). Якщо поточне значення натомість — 50m, кількість реплік буде зменшена вдвічі, оскільки \( { 50.0 \div 100.0 } = 0.5 \). Панель управління пропускає будь-яку дію масштабування, якщо співвідношення достатньо близьке до 1,0 (в межах налаштовуваного допуску, стандартно 0,1).
Якщо вказано targetAverageValue або targetAverageUtilization, поточне значення метрики обчислюється шляхом визначення середнього значення вказаної метрики для всіх Podʼів у цілі масштабування HorizontalPodAutoscaler.
Перед перевіркою допуску та визначенням кінцевих значень панель управління також перевіряє, чи не бракує якихось метрик і скільки Podʼів перебувають у стані Ready. Для метрик ресурсів на кожен Pod ігноруються всі Podʼи із заданою позначкою часу видалення (обʼєкти з такою позначкою перебувають у процесі вимкнення/видалення), а всі Podʼи, що зазнали збою, відкидаються. Для зовнішніх метрик та метрик обʼєктів кількість реплік розраховується на основі кількості Podʼів у станах Running та Ready; Podʼи, що завершують роботу, але все ще перебувають у стані Ready, продовжують враховуватися в цій загальній кількості.
Якщо для конкретного Podʼа бракує метрик, його відкладають на потім; Podʼи з відсутніми метриками буде використано для коригування кінцевої величини масштабування.
Під час масштабування за CPU, якщо будь-який Pod ще не став готовим (він все ще ініціалізується або, можливо, несправний) або остання точка метрики для Podʼа була до того, як він став готовим, цей Pod також відкладають.
Через технічні обмеження контролер HorizontalPodAutoscaler не може точно визначити, коли Pod уперше став готовим, вирішуючи, чи відкласти певні метрики CPU. Натомість він вважає Pod «ще не готовим», якщо той не готовий і перейшов у стан готовності протягом короткого налаштовуваного проміжку часу від свого запуску. Це значення налаштовується за допомогою параметра командного рядка --horizontal-pod-autoscaler-initial-readiness-delay, і стандартно воно становить 30 секунд. Після того, як Pod став готовим, будь-який перехід у стан готовності вважається першим, якщо він відбувся протягом довшого налаштовуваного часу від запуску. Це значення налаштовується за допомогою параметра командного рядка --horizontal-pod-autoscaler-cpu-initialization-period, і його стандартне значення — 5 хвилин.
Базове співвідношення масштабу \( \text{поточнеЗначенняМетрики} \over \text{бажанеЗначенняМетрики} \) потім обчислюється за Podʼами, що залишилися, тобто не були відкладені або відкинуті вище.
Якщо були відсутні метрики, панель управління перераховує середнє значення більш консервативно, припускаючи, що ці Podʼи споживають 100% бажаного значення у випадку масштабування вниз і 0% у випадку масштабування вгору. Це зменшує величину можливого масштабування.
Крім того, якщо присутні будь-які ще не готові Podʼи, і робоче навантаження мало б масштабуватися вгору без врахування відсутніх метрик або ще не готових Podʼів, контролер консервативно припускає, що ще не готові Podʼи споживають 0% бажаної метрики, ще більше зменшуючи величину масштабування вгору.
Після врахування ще не готових Podʼів та відсутніх метрик контролер повторно обчислює співвідношення використання. Якщо нове співвідношення змінює напрямок масштабування або перебуває в межах допуску, контролер не вживає жодних дій щодо масштабування. В інших випадках нове співвідношення використовується для визначення будь-яких змін кількості Podʼів.
Зверніть увагу, що початкове значення для середнього використання повертається через статус HorizontalPodAutoscaler, без врахування ще не готових Podʼів або відсутніх метрик, навіть коли використовується нове співвідношення використання.
Якщо в HorizontalPodAutoscaler вказано кілька метрик, цей розрахунок виконується для кожної метрики, а потім обирається найбільше з бажаних кількостей реплік. Якщо будь-яка з цих метрик не може бути переведена у бажану кількість реплік (наприклад, через помилку отримання метрик з API метрик) і запропоновано масштабування вниз за метриками, які можна отримати, масштабування пропускається. Це означає, що HPA все ще може масштабуватися вгору, якщо одна або кілька метрик дають значення desiredReplicas, більше, ніж поточне значення.
Нарешті, прямо перед тим, як HPA масштабує ціль, рекомендація масштабування записується. Контролер розглядає всі рекомендації в налаштованому вікні та обирає найвищу рекомендацію в межах цього вікна. Це значення можна налаштувати за допомогою параметра командного рядка --horizontal-pod-autoscaler-downscale-stabilization, стандартне значення якого — 5 хвилин. Це означає, що зменшення масштабу відбуватиметься поступово, згладжуючи вплив метрик, що швидко змінюються.
Готовність Podʼа та метрики автомасштабування
Контролер HorizontalPodAutoscaler (HPA) містить два параметри командного рядка, які впливають на те, як збираються метрики CPU з Podʼів під час запуску:
Цей параметр визначає часовий проміжок після запуску Podʼа, протягом якого використання CPU ігнорується, крім випадків, коли:
- Pod перебуває у стані Readyта
- Зразок метрики було взято повністю протягом періоду, коли він перебував у стані Ready.
Цей параметр командного рядка допомагає виключити оманливо високе споживання CPU Podʼами, що ініціалізуються (наприклад, Java-застосунками, що прогріваються), з рішень HPA щодо масштабування.
Цей параметр командного рядка визначає короткий період затримки після запуску Podʼа, протягом якого контролер HPA розглядає Podʼи, що перебувають у стані Unready, як такі, що все ще ініціалізуються, навіть якщо вони раніше ненадовго перейшли у стан Ready.
Він призначений для того, щоб:
- Уникнути включення Podʼів, які швидко коливаються між Ready та Unready під час запуску.
- Забезпечити стабільність початкового сигналу готовності до того, як HPA вважатиме їх метрики дійсними.
Ви можете встановити ці параметри командного рядка тільки для всього кластера.
Ключова поведінка для готовності Podʼа
Якщо Pod перебуває в стані Ready і залишається в цьому стані, він може бути зарахований як такий, що надає метрики навіть протягом затримки.
Якщо Pod швидко перемикається між станом Ready та Unready, метрики ігноруються, поки він не стане стабільно Ready.
Поради стосовно готовності Podʼа
Налаштуйте startupProbe, який не проходить, поки високе використання CPU не мине, або
Переконайтеся, що ваш readinessProbe повідомляє про Ready тільки після того, як пік використання CPU спаде, використовуючи initialDelaySeconds.
А в ідеалі також встановіть --horizontal-pod-autoscaler-cpu-initialization-period, щоб покрити тривалість запуску.
Обʼєкт API
HorizontalPodAutoscaler є типом API в групі API Kubernetes autoscaling. Поточну стабільну версію можна знайти у версії API autoscaling/v2, яка включає підтримку масштабування за памʼяттю та власними метриками. Нові поля, введені в autoscaling/v2, зберігаються як анотації під час роботи з autoscaling/v1.
Під час створення обʼєкта API HorizontalPodAutoscaler переконайтеся, що вказана назва є дійсною назвою піддомену DNS. Більше деталей про обʼєкт API можна знайти на сторінці Обʼєкт HorizontalPodAutoscaler.
Стабільність масштабування робочого навантаження
Під час керування масштабом групи реплік за допомогою HorizontalPodAutoscaler можливі часті коливання кількості реплік через динамічний характер оцінюваних метрик. Це іноді називають thrashing або flapping (коливання). Це схоже на концепцію гістерезису в кібернетиці.
Автомасштабування під час поетапного оновлення
Kubernetes дозволяє виконувати поетапне оновлення для Deployment. У цьому випадку Deployment керує підлеглими ReplicaSets за вас. Коли ви налаштовуєте автомасштабування для Deployment, ви звʼязуєте HorizontalPodAutoscaler з одним Deployment. HorizontalPodAutoscaler керує полем replicas Deployment. Контролер Deployment відповідає за встановлення replicas підлеглих ReplicaSets так, щоб вони складали відповідну кількість під час розгортання, а також після його завершення.
Якщо ви виконуєте поетапне оновлення StatefulSet, у якого є автомасштабована кількість реплік, StatefulSet безпосередньо керує своїм набором Podʼів (немає проміжного ресурсу, аналогічного ReplicaSet).
Підтримка метрик ресурсів
Будь-яку ціль HPA можна масштабувати на основі використання ресурсів Podʼами в цілі масштабування. Під час визначення специфікації Podʼа слід вказувати запити на ресурси, такі як cpu та memory. Вони використовуються для визначення використання ресурсів, а контролер HPA використовує це для масштабування цілі вгору або вниз. Щоб використовувати масштабування на основі використання ресурсів, вкажіть джерело метрики так:
З цією метрикою контролер HPA буде підтримувати середнє використання ресурсів Podʼами в цілі масштабування на рівні 60%. Використання — це співвідношення між поточним використанням ресурсу та запитаними ресурсами Podʼа. Дивіться Алгоритм для отримання додаткової інформації про те, як обчислюється та усереднюється використання.
Примітка:
Оскільки використання ресурсів всіх контейнерів сумується, загальне використання Podʼа може не точно відображати використання ресурсів окремих контейнерів. Це може призвести до ситуацій, коли один контейнер може працювати з високим використанням, а HPA не збільшуватиме кількість реплік, оскільки загальне використання Podʼа все ще перебуває в прийнятних межах.
Метрики ресурсів контейнера
This is a stable feature in Kubernetes, and has been since the 1.30 release. You can no longer toggle this feature (the associated feature gate has been removed).
API HorizontalPodAutoscaler також підтримує джерело метрик контейнера, де HPA може відстежувати використання ресурсів окремих контейнерів у наборі Podʼів, щоб масштабувати цільовий ресурс. Це дозволяє налаштовувати пороги масштабування для контейнерів, які мають найбільше значення в конкретному Podʼі. Наприклад, якщо у вас є вебзастосунок і sidecar-контейнер, який надає логування, ви можете масштабувати на основі використання ресурсів вебзастосунка, ігноруючи sidecar-контейнер та його використання ресурсів.
Якщо ви оновите цільовий ресурс, щоб він мав нову специфікацію Podʼа з іншим набором контейнерів, вам слід оновити специфікацію HPA, якщо щойно доданий контейнер також має використовуватися для масштабування. Якщо вказаний контейнер у джерелі метрики відсутній або присутній лише в підмножині Podʼів, то ці Podʼи ігноруються, і рекомендація перераховується. Дивіться Алгоритм для отримання додаткової інформації про обчислення. Щоб використовувати ресурси контейнера для автомасштабування, визначте джерело метрики таким чином:
У наведеному вище прикладі контролер HPA масштабує ціль так, що середнє використання CPU у контейнері application в усіх Podʼах становить 60%.
Примітка:
Якщо ви зміните назву контейнера, який відстежує HorizontalPodAutoscaler, ви можете зробити цю зміну у певному порядку, щоб забезпечити доступність та ефективність масштабування під час застосування змін. Перед тим, як ви оновите ресурс, який визначає контейнер (наприклад, Deployment), вам слід оновити повʼязаний HPA, щоб він відстежував як нову, так і стару назву контейнера. Таким чином, HPA може розраховувати рекомендацію масштабування протягом усього процесу оновлення.
Після того, як ви розгорнули зміну назви контейнера в ресурсі робочого навантаження, приберіть зайве, видаливши стару назву контейнера зі специфікації HPA.
Масштабування на основі власних метрик
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.23
(версія API autoscaling/v2beta2 раніше надавала цю можливість як бета-можливість)
За умови використання версії API autoscaling/v2 ви можете налаштувати HorizontalPodAutoscaler на масштабування на основі власної метрики (яка не є вбудованою в Kubernetes або будь-який компонент Kubernetes). Потім контролер HorizontalPodAutoscaler запитує ці власні метрики з API Kubernetes.
(версія API autoscaling/v2beta2 раніше надавала цю можливість як бета-можливість)
За умови використання версії API autoscaling/v2 ви можете вказати кілька метрик, на основі яких масштабуватиме HorizontalPodAutoscaler. Потім контролер HorizontalPodAutoscaler оцінює кожну метрику і пропонує новий масштаб на основі цієї метрики. HorizontalPodAutoscaler бере максимальний масштаб, рекомендований для кожної метрики, і встановлює робоче навантаження на такий розмір (за умови, що це не більше загального максимуму, який ви налаштували).
Підтримка API метрик
Стандартно контролер HorizontalPodAutoscaler отримує метрики з низки API. Щоб він мав доступ до цих API, адміністратори кластера повинні переконатися, що:
Для метрик ресурсів це metrics.k8s.ioAPI, яке зазвичай надає metrics-server. Його можна запустити як надбудову кластера.
Примітка:
HorizontalPodAutoscaler наразі підтримує API `metrics.k8s.io/v1beta1` для метрик ресурсів. Він ще не підтримує `metrics.k8s.io/v1`.
Для власних метрик це custom.metrics.k8s.ioAPI. Його надають API-сервери «адаптера», які постачають розробники рішень для метрик. Перевірте у своєму конвеєрі метрик, чи доступний адаптер метрик Kubernetes.
Для зовнішніх метрик це external.metrics.k8s.ioAPI. Він може бути наданий адаптерами власних метрик, які наведено вище.
(версія API autoscaling/v2beta2 раніше надавала цю можливість як бета-можливість)
Якщо ви використовуєте API HorizontalPodAutoscaler v2, ви можете використовувати поле behavior (див. довідку API) для налаштування окремих поведінок масштабування вгору та вниз. Ви вказуєте ці поведінки, встановлюючи scaleUp та/або scaleDown
у полі behavior.
Політики масштабування дозволяють контролювати швидкість зміни кількості реплік під час масштабування. Також можна використати два параметри для запобігання коливанням: ви можете вказати вікно стабілізації для згладжування кількості реплік та допуск для ігнорування незначних коливань метрик нижче вказаного порогового значення.
Політики масштабування
Одну або декілька політик масштабування можна вказати у розділі behavior специфікації. Коли вказано кілька політик, стандартно вибирається та політика, яка дозволяє найбільше змін. Наступний приклад показує цю поведінку під час зменшення масштабу:
periodSeconds вказує на проміжок часу в минулому, протягом якого політика має бути істинною. Максимальне значення, яке можна встановити для periodSeconds, — 1800 (пів години). Перша політика (Pods) дозволяє зменшити щонайбільше 4 репліки за одну хвилину. Друга політика (Percent) дозволяє зменшити щонайбільше 10% поточних реплік за одну хвилину.
Оскільки стандартно вибирається політика, яка дозволяє найбільше змін, друга політика буде використовуватися лише тоді, коли кількість реплік буде більше ніж 40. За 40 або менше реплік буде застосована перша політика. Наприклад, якщо є 80 реплік, і ціль потрібно зменшити до 10 реплік, то під час першого кроку буде скорочено 8 реплік. На наступній ітерації, коли кількість реплік становить 72, 10% від Podʼів — 7,2, але число заокруглюється вгору до 8. На кожному циклі контролера автомасштабування кількість Podʼів, які мають бути змінені, перераховується на основі поточної кількості реплік. Коли кількість реплік падає нижче 40, застосовується перша політика (Pods) і зменшується по 4 репліки за раз.
Вибір політики можна змінити, вказавши поле selectPolicy для напрямку масштабування. Встановлення значення Min вибере політику, яка дозволяє найменшу зміну кількості реплік. Встановлення значення Disabled повністю вимикає масштабування в цьому напрямку.
Вікно стабілізації
Вікно стабілізації використовується для обмеження коливань кількості реплік, коли метрики, які використовуються для масштабування, постійно коливаються. Алгоритм автомасштабування використовує це вікно, щоб виявити попередній бажаний стан та уникнути небажаних змін у масштабі робочого навантаження.
Наприклад, у наступному фрагменті коду вказано вікно стабілізації для scaleDown.
behavior:scaleDown:stabilizationWindowSeconds:300
Коли метрики показують, що потрібно зменшити ціль, алгоритм дивиться на раніше розраховані бажані стани і використовує найвище значення з вказаного інтервалу. У наведеному вище прикладі всі попередні бажані стани за останні 5 хвилин будуть враховані.
Це наближено відповідає ковзному максимуму і дає змогу уникнути ситуації, коли алгоритм масштабування часто видаляє Podʼи лише для того, щоб за мить знову створити еквівалентний Pod.
Допуск
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate HPAConfigurableTolerance, Kubernetes ignores it but does not report any error.
Поле tolerance налаштовує порогове значення для мінливості метрики, не даючи автомасштабувальнику масштабувати через зміни, менші за це значення.
Цей допуск визначається як величина відхилення навколо бажаного значення метрики, нижче якої масштабування не відбуватиметься. Наприклад, розглянемо HorizontalPodAutoscaler, налаштований з цільовим споживанням памʼяті 100MiB та допуском масштабування вгору 5%:
behavior:scaleUp:tolerance:0.05# допуск 5% для масштабування вгору
За такої конфігурації алгоритм HPA розглядатиме масштабування вгору лише в тому випадку, якщо споживання памʼяті перевищує 105MiB (тобто на 5% вище цільового значення).
Якщо це поле не встановлено, HPA застосовуватиме стандартний допуск кластера — 10%. Це стандартне значення може бути оновлено як для масштабування вгору, так і вниз, використовуючи kube-controller-manager з аргументом командного рядка --horizontal-pod-autoscaler-tolerance. (Ви не можете використовувати API Kubernetes для налаштування цього стандартного значення.)
Стандартна поведінка
Для використання власного масштабування не всі поля повинні бути вказані. Можна вказати лише значення, які потрібно налаштувати. Ці власні значення обʼєднуються зі стандартними значеннями. Стандартні значення відповідають наявній поведінці в алгоритмі HPA.
Для зменшення масштабу вікно стабілізації становить 300 секунд (або значення параметра командного рядка --horizontal-pod-autoscaler-downscale-stabilization, якщо воно вказане). Є лише одна політика для зменшення масштабу, яка дозволяє видалити 100% поточно запущених реплік, що означає, що ціль масштабування може бути зменшена до мінімально допустимих реплік. Для збільшення масштабу вікно стабілізації відсутнє. Коли метрики показують, що ціль повинна бути збільшена, ціль збільшується негайно. Є 2 політики, за якими кожні 15 секунд можна додати не більше 4 Podʼів або 100% поточно запущених реплік до тих пір, поки HPA не досягне стабільного стану.
Приклад: зміна вікна стабілізації для зменшення масштабу
Щоб вказати власне значення вікна стабілізації для зменшення масштабу тривалістю в 1 хвилину, до HPA слід додати таку поведінку:
behavior:scaleDown:stabilizationWindowSeconds:60
Приклад: обмеження швидкості зменшення масштабу
Щоб обмежити швидкість, з якою HPA видаляє Podʼи, до 10% за хвилину, до HPA слід додати таку поведінку:
Щоб переконатися, що за хвилину видаляється не більше 5 Podʼів, можна додати другу політику зменшення масштабу з фіксованим розміром 5 та встановити selectPolicy на значення Min. Встановлення selectPolicy на Min означає, що автомасштабувальник вибирає політику, яка впливає на найменшу кількість Podʼів:
Значення selectPolicyDisabled вимикає масштабування у вказаному напрямку. Щоб запобігти зменшенню масштабу, буде використана наступна політика:
behavior:scaleDown:selectPolicy:Disabled
Підтримка HorizontalPodAutoscaler в kubectl
HorizontalPodAutoscaler, як і кожний ресурс API, підтримується стандартним чином у kubectl. Ви можете створити новий автомасштабувальник за допомогою команди kubectl create. Ви можете переглянути список автомасштабувальників за допомогою kubectl get hpa або отримати детальний опис за допомогою kubectl describe hpa. Нарешті, ви можете видалити автомасштабувальник за допомогою kubectl delete hpa.
Крім того, є спеціальна команда kubectl autoscale для створення обʼєкта HorizontalPodAutoscaler. Наприклад, виконання kubectl autoscale rs foo --min=2 --max=5 --cpu=80% створить автомасштабувальник для ReplicaSet foo, з цільовим використанням CPU, встановленим на 80% і кількістю реплік від 2 до 5.
Масштабування до нуля та з нуля
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
Для HorizontalPodAutoscaler, які масштабуються на основі власних (обʼєктних) або зовнішніх метрик, ви можете встановити spec.minReplicas у 0. Тоді робоче навантаження масштабується повністю до нуля реплік, коли немає навантаження, і масштабується назад, коли метрика вказує, що потрібна принаймні одна репліка. Це корисно для робочих навантажень, які простоюють протягом тривалого часу і дорогі в утриманні, наприклад, споживачі черги, якою користуються час від часу, або завдання, що потребують спеціального обладнання, як-от GPU.
Масштабування до нуля підтримується лише для обʼєктних та зовнішніх метрик. Воно недоступне для метрик ресурсів (таких як використання CPU або памʼяті), оскільки їх можна виміряти лише на запущених Podʼах. Встановлення minReplicas: 0 вимагає наявності принаймні однієї обʼєктної або зовнішньої метрики; інакше API-сервер відхиляє HorizontalPodAutoscaler.
Ця поведінка контролюється функціональною можливістю HPAScaleToZero, яка стандартно увімкнена. Функціональна можливість має бути увімкнена як на kube-apiserver (який дозволяє minReplicas: 0), так і на kube-controller-manager (який виконує масштабування).
Поки HPA утримує робоче навантаження на нулі реплік, він записує стан ScaledToZero зі значенням True у статус HorizontalPodAutoscaler. HPA використовує цей стан, щоб відрізнити робоче навантаження, яке він масштабував до нуля (і масштабує назад, коли метрика повертається), від того, яке було деактивовано вручну шляхом встановлення кількості його реплік у 0. Після того, як робоче навантаження масштабовано назад, стан встановлюється в False з причиною NotScaledToZero.
Неявна деактивація в режимі обслуговування
Ви можете неявно деактивувати HPA для цільового обʼєкта без необхідності змінювати саму конфігурацію HPA. Якщо бажана кількість реплік цільового обʼєкта встановлена на 0, а мінімальна кількість реплік HPA більше 0, HPA припиняє коригування цільового обʼєкта (і встановлює для себе стан ScalingActive у false), доки ви знову не активуєте його вручну, змінивши бажану кількість реплік цільового обʼєкта або мінімальну кількість реплік HPA.
Перехід Deployments та StatefulSets на горизонтальне автомасштабування
Під час увімкнення HPA рекомендується видалити значення spec.replicas з Deployment та/або StatefulSet в їхніх маніфестах. Якщо цього не зробити, щоразу, коли до цього обʼєкта застосовується зміна, наприклад, за допомогою kubectl apply -f deployment.yaml, Kubernetes отримуватиме вказівку масштабувати поточну кількість Podʼів до значення ключа spec.replicas. Це може бути небажаним і спричиняти проблеми, коли HPA активний, призводячи до коливань (thrashing або flapping).
Майте на увазі, що видалення spec.replicas може спричинити одноразове зниження кількості Podʼів, оскільки стандартне значення цього ключа — 1 (див. Репліки Deployment). Після оновлення всі Podʼи, крім одного, розпочнуть процедуру завершення. Після цього будь-яке подальше застосування Deployment працюватиме як звичайно і дотримуватиметься конфігурації поетапного оновлення, як і очікується. Ви можете уникнути цього зниження, обравши один із двох наступних методів залежно від того, як ви змінюєте свої Deployments:
У редакторі видаліть spec.replicas. Після збереження та виходу з редактора kubectl застосовує оновлення. На цьому етапі не відбувається змін кількості Podʼів.
Тепер ви можете видалити spec.replicas з маніфеста. Якщо ви використовуєте систему керування вихідним кодом, також зафіксуйте ваші зміни або виконайте будь-які інші кроки для перегляду вихідного коду, які відповідають вашому способу відстеження оновлень.
Відтепер ви можете запускати kubectl apply -f deployment.yaml
Якщо ви налаштовуєте автомасштабування у вашому кластері, вам також може бути корисно розглянути використання автомасштабування вузлів щоб забезпечити запуск потрібної кількості вузлів. Ви також можете дізнатися більше про вертикальне автомасштабування Podʼів.
Для отримання додаткової інформації про HorizontalPodAutoscaler:
Якщо ви бажаєте написати свій адаптер власних метрик, перегляньте шаблонний код, щоб почати.
Ознайомтесь з Довідкою API для HorizontalPodAutoscaler.
6.4.6 - Вертикальне автомасштабування Podʼів
У Kubernetes VerticalPodAutoscaler автоматично оновлює ресурс керування робочим навантаженням (такий як Deployment або StatefulSet), щоб автоматично коригувати запити й обмеженняресурсів інфраструктури відповідно до фактичного використання.
Вертикальне масштабування означає, що відповіддю на збільшення попиту на ресурси є виділення більшої кількості ресурсів (наприклад, памʼяті або CPU) для Podʼів, які вже працюють для цього робочого навантаження. Це також відомо як rightsizing, або іноді autopilot. Це відрізняється від горизонтального масштабування, яке для Kubernetes означало б розгортання більшої кількості Podʼів для розподілу навантаження.
Якщо використання ресурсів зменшується, а запити на ресурси від Podʼа перевищують оптимальний рівень, VerticalPodAutoscaler дає вказівку ресурсу робочого навантаження (Deployment, StatefulSet або іншому подібному ресурсу) скоригувати запити на ресурси назад у бік зменшення, запобігаючи марнуванню ресурсів.
VerticalPodAutoscaler реалізовано як ресурс API Kubernetes і контролер. Ресурс визначає поведінку контролера. Контролер вертикального автомасштабування Podʼів, що працює в площині даних Kubernetes, періодично коригує запити на ресурси та обмеження для свого обʼєкта (наприклад, Deployment) на основі аналізу історичного використання ресурсів, кількості доступних ресурсів у кластері та подій у реальному часі, таких як ситуації нестачі памʼяті (OOM).
Обʼєкт API
VerticalPodAutoscaler визначається як Custom Resource Definition (CRD) в Kubernetes. На відміну від HorizontalPodAutoscaler, який є частиною основного API Kubernetes, VPA необхідно встановлювати окремо у вашому кластері.
Поточна стабільна версія API — autoscaling.k8s.io/v1. Більш детальну інформацію про встановлення VPA та API можна знайти в репозиторії VPA на GitHub.
Як працює VerticalPodAutoscaler?
graph BT
metrics[Metrics Server]
api[API Server]
admission[VPA Admission Controller]
vpa_cr[VerticalPodAutoscaler CRD]
recommender[VPA recommender]
updater[VPA updater]
metrics --> recommender
recommender -->|Зберігає рекомендації| vpa_cr
subgraph Робоче навантаження застосунку
controller[Deployment / RC / StatefulSet]
pod[Pod / Container]
end
vpa_cr -->|Перевірка на наявність змін| updater
updater -->|Виселяє або оновлює Pod на місці| controller
controller -->|Запит на новий Pod| api
api -->|Створення нового Podʼа| admission
admission -->|Отримує останні рекомендації| vpa_cr
admission -->|Інʼєкція нових значень ресурсів| api
api -->|Створює Pod| controller
controller -->|Новий Pod з оптимальними ресурсами| pod
classDef vpa fill:#9FC5E8,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef crd fill:#D5A6BD,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef metrics fill:#FFD966,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
classDef app fill:#B6D7A8,stroke:#1E1E1D,stroke-width:1px,color:#1E1E1D;
class recommender,updater,admission vpa;
class vpa_cr crd;
class metrics metrics;
class controller,pod app;
Схема 1. VerticalPodAutoscaler контролює запити на ресурси та обмеження Podʼів у Deployment.
Kubernetes реалізує вертикальне автомасштабування Podʼів за допомогою кількох взаємодіючих компонентів, які працюють з перервами (це не безперервний процес). VPA складається з трьох основних компонентів:
recommender, який аналізує використання ресурсів і надає рекомендації.
updater, який оновлює запити Podʼів на ресурси, виселяючи Podʼи або змінюючи їх на місці.
І вебхук VPA admission controller, який застосовує рекомендації щодо ресурсів до нових або створених заново Podʼів.
Один раз протягом кожного періоду Recommender запитує використання ресурсів для Podʼів, на які спрямовано кожне визначення VerticalPodAutoscaler. Recommender знаходить цільовий ресурс, визначений targetRef, потім вибирає Podʼи на основі міток .spec.selector цільового ресурсу та отримує метрики з API метрик ресурсів для аналізу фактичного споживання CPU та памʼяті.
Recommender аналізує поточні та історичні дані про використання ресурсів (CPU та памʼять) для кожного Podʼа, на який націлений VerticalPodAutoscaler. Він перевіряє:
Історичні моделі споживання з часом для виявлення тенденцій
Пікове використання та відхилення для забезпечення достатнього запасу
Події вичерпання памʼяті (OOM) та інші інциденти, повʼязані з ресурсами
На основі цього аналізу Recommender обчислює три типи рекомендацій:
Рекомендація щодо цільового значення (оптимальні ресурси для типового використання)
Нижня межа (мінімально необхідні ресурси)
Верхня межа (максимально доцільні ресурси).
Ці рекомендації зберігаються в полі .status.recommendation ресурсу VerticalPodAutoscaler.
Компонент updater відстежує ресурси VerticalPodAutoscaler і порівнює поточні запити на ресурси Podʼів з рекомендаціями. Коли різниця перевищує налаштовані порогові значення і політика оновлення дозволяє це, updater може:
Виселити Podʼи, ініціюючи їх повторне створення з новими запитами на ресурси (традиційний підхід)
Оновити ресурси Podʼа на місці без виселення, якщо кластер підтримує оновлення ресурсів Podʼів на місці
Вибраний метод залежить від налаштованого режиму оновлення, можливостей кластера та типу необхідних змін ресурсів. Оновлення на місці, якщо вони доступні, дозволяють уникнути порушення роботи Podʼа, але можуть мати обмеження щодо ресурсів, які можна модифікувати. Updater дотримується PodDisruptionBudgets, щоб мінімізувати вплив на роботу сервісу.
Контролер допуску працює як змінювальний вебхук, який перехоплює запити на створення Podʼів. Він перевіряє, чи є Pod ціллю VerticalPodAutoscaler, і, якщо так, застосовує рекомендовані запити на ресурси та обмеження перед створенням Podʼа. Конкретніше, контролер допуску використовує рекомендацію Target у розділі .status.recommendation ресурсу VerticalPodAutoscaler як нові запити на ресурси. Контролер допуску гарантує, що нові Podʼи запускаються з належними виділеними ресурсами, незалежно від того, чи вони створені під час початкового розгортання, після виселення компонентом updater або внаслідок операцій масштабування.
VerticalPodAutoscaler вимагає, щоб у кластері було встановлено джерело метрик, таке як надбудова Metrics Server від Kubernetes. Компоненти VPA отримують метрики з API metrics.k8s.io. Metrics Server потрібно запускати окремо, оскільки в більшості кластерів він стандартно не розгортається. Докладнішу інформацію про метрики ресурсів дивіться у розділі Metrics Server.
Режими оновлення
VerticalPodAutoscaler підтримує різні режими оновлення, які контролюють, як і коли рекомендації щодо ресурсів застосовуються до ваших Podʼів. Ви налаштовуєте режим оновлення за допомогою поля updateMode у специфікації VPA в розділі updatePolicy:
У режимі оновлення Off recommender VPA все одно аналізує використання ресурсів і генерує рекомендації, але ці рекомендації не застосовуються до Podʼів автоматично. Рекомендації зберігаються лише в полі .status обʼєкта VPA.
Ви можете використовувати такий інструмент, як kubectl, щоб переглянути .status і рекомендації, що містяться в ньому.
Initial
У режимі Initial VPA встановлює запити на ресурси тільки під час першого створення Podʼа. Він не оновлює ресурси для вже запущених Podʼів, навіть якщо рекомендації змінюються з часом. Рекомендації застосовуються тільки під час створення Podʼа.
Recreate
У режимі Recreate VPA активно керує ресурсами Podʼів, виселяючи Podʼи, коли їхні поточні запити на ресурси значно відрізняються від рекомендацій. Коли Pod виселяється, контролер робочого навантаження (який керує Deployment, StatefulSet тощо) створює Pod-замінник, а контролер допуску VPA застосовує оновлені запити на ресурси до нового Podʼа.
InPlaceOrRecreate
У режимі InPlaceOrRecreate VPA намагається оновити запити та обмеження ресурсів Podʼа без перезапуску Podʼа, якщо це можливо. Однак, якщо оновлення на місці не можуть бути виконані для певної зміни ресурсу, VPA повертається до виселення Podʼа (аналогічно режиму Recreate) і дозволяє контролеру робочого навантаження створити Pod-замінник з оновленими ресурсами.
Цей режим доступний як альфа-можливість у VPA 1.7.0 і вимагає Kubernetes 1.33 або новішої версії з увімкненою функціональною можливістю кластера InPlacePodVerticalScaling, а також увімкненою функціональною можливістю InPlace для updater VPA та контролера допуску. Він використовує можливість зміни розміру Podʼа на місці, щоб застосовувати оновлення без порушення роботи Podʼа.
У режимі InPlace VPA намагається оновити запити та обмеження ресурсів Podʼа без перезапуску або виселення Podʼа. На відміну від InPlaceOrRecreate, цей режим ніколи не повертається до виселення. Якщо оновлення на місці не може бути застосоване (наприклад, через недостатню місткість вузла), VPA відкладає оновлення та повторює спробу в наступному циклі узгодження.
Щоб використовувати режим InPlace, увімкніть функціональну можливість InPlace як для updater VPA, так і для контролера допуску:
--feature-gates=InPlace=true
Потім встановіть updateMode в "InPlace" у вашій специфікації VPA:
Ключова відмінність від InPlaceOrRecreate: Коли зміна розміру відкладається, виконується або є неможливою, режим InPlace завжди чекає та повторює спробу — він ніколи не виселяє Pod, незалежно від того, як довго оновлення очікує.
Auto (застаріло)
Примітка:
Режим оновлення Autoвизнано застарілим починаючи з версії VPA 1.4.0. Використовуйте Recreate для оновлень на основі виселення або InPlaceOrRecreate для оновлень на місці з резервним варіантом виселення.
Режим Auto наразі є синонімом режиму Recreate і працює ідентично. Він був введений для забезпечення можливості майбутнього розширення стратегій автоматичного оновлення.
Політики ресурсів
Політики ресурсів дозволяють точно налаштувати спосіб, у який VerticalPodAutoscaler генерує рекомендації та застосовує оновлення. Ви можете встановити межі для рекомендацій щодо ресурсів, вказати, якими ресурсами керувати, та налаштувати різні політики для окремих контейнерів у Podʼі.
Політики ресурсів визначаються у полі resourcePolicy специфікації VPA:
Ці поля встановлюють межі для рекомендацій VPA. VPA ніколи не рекомендуватиме ресурси нижче minAllowed або вище maxAllowed, навіть якщо фактичні дані про використання вказують на інші значення.
controlledResources
Поле controlledResources визначає, якими типами ресурсів VPA повинен керувати для контейнера в Podʼі. Якщо не вказано, VPA стандартно керує як CPU, так і памʼяттю. Ви можете обмежити VPA, щоб він керував лише певними ресурсами. Допустимі назви ресурсів: cpu та memory.
controlledValues
Поле controlledValues визначає, чи контролює VPA запити на ресурси, обмеження або і те, і інше:
RequestsAndLimits
VPA встановлює як запити, так і обмеження. Обмеження масштабується пропорційно до запиту на основі співвідношення запиту до обмеження, визначеного в специфікації Podʼа. Це стандартний режим.
RequestsOnly
VPA встановлює лише запити, залишаючи обмеження без змін. Обмеження враховуються і можуть спричиняти тротлінг або завершення процесів за нестачі памʼяті (OOM kills), якщо використання їх перевищує.
Компоненти VPA, контролер допуску та updater, додатково обробляють рекомендації, щоб вони відповідали обмеженням, визначеним у LimitRanges. Ресурси LimitRange з type Pod та Container перевіряються в кластері Kubernetes.
Наприклад, якщо поле max у ресурсі Container LimitRange перевищено, обидва компоненти VPA знижують обмеження до значення, визначеного в полі max, і запит пропорційно зменшується, щоб зберегти співвідношення запиту до обмеження в специфікації Podʼа.
Що далі
Якщо ви налаштовуєте автомасштабування у своєму кластері, ви також можете розглянути можливість використання автомасштабування вузлів, щоб переконатися, що ви використовуєте потрібну кількість вузлів. Ви також можете дізнатися більше про горизонтальне автомасштабування Podʼів.
6.4.7 - Workload API
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Ресурс API Workload визначає вимоги до планування та структуру застосунку з кількох Podʼів. У той час як контролери робочого навантаження, такі як Job, керують станом виконання застосунку, Workload визначає, як слід планувати групи Pods. Контролер Job є єдиним вбудованим контролером, який створює обʼєкти PodGroup з PodGroupTemplates ресурсу Workload під час виконання.
Що таке Workload?
Ресурс API Workload є частиною групи APIscheduling.k8s.io/v1beta1, і ваш кластер повинен мати цю групу API увімкненою, а також функціональну можливість GenericWorkload, перш ніж ви зможете скористатися цим API.
Workload є статичним, довгоживучим шаблоном політики. Він визначає, які політики планування слід застосовувати до груп Podʼів, але самостійно не відстежує стан виконання. Стан виконання планування підтримується обʼєктами PodGroup, які контролери створюють з PodGroupTemplates ресурсу Workload.
Структура API
Workload складається з двох полів: списку PodGroupTemplates та необовʼязкового посилання на контролер. Вся специфікація Workload є незмінною після створення: ви не можете змінювати наявні шаблони, додавати нові шаблони або видаляти шаблони з podGroupTemplates.
PodGroupTemplates
Список spec.podGroupTemplates визначає окремі компоненти вашого робочого навантаження. Наприклад, завдання машинного навчання може мати шаблон driver та шаблон worker.
Кожен елемент у podGroupTemplates повинен мати:
Унікальне поле name, яке буде використовуватися для посилання на шаблон у spec.podGroupTemplateRef обʼєкта PodGroup.
Максимальна кількість PodGroupTemplates в одному Workload становить 8.
apiVersion:scheduling.k8s.io/v1beta1kind:Workloadmetadata:name:training-job-workloadnamespace:some-nsspec:controllerRef:apiGroup:batchkind:Jobname:training-jobpodGroupTemplates:- name:workersschedulingPolicy:gang:# gang придатна для планування лише тоді, коли одночасно можуть працювати 4 PodʼиminCount:4priorityClassName:high-prioritydisruptionMode:all:{}
Коли контролер робочого навантаження створює PodGroup з одного з цих шаблонів, він копіює schedulingPolicy у власну специфікацію PodGroup. Зміни в Workload впливають лише на новостворені PodGroups, а не на наявні.
Посилання на обʼєкт керування робочим навантаженням
Поле controllerRef звʼязує Workload з конкретним обʼєктом вищого рівня, що визначає застосунок, наприклад Job або власний CRD. Це корисно для спостереження та інструментів. Ці дані не використовуються для планування або керування Workload.
CompositePodGroupTemplates
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3, ви можете використовувати CompositePodGroupTemplates для визначення багаторівневих ієрархічних вимог до планування у Workload. Ці вимоги можуть включати забезпечення вкладених топологічних обмежень на різних рівнях інфраструктури кластера (багаторівневе топологічно орієнтоване планування), планування «все або нічого» для дочірніх груп (багаторівневе групове планування) або політики порушення на рівні групи.
CompositePodGroupTemplates можна визначити за допомогою поля spec.compositePodGroupTemplates в API Workload. Під час виконання контролери робочого навантаження створюють обʼєкти CompositePodGroup та PodGroup з цих шаблонів для підтримки стану планування ієрархії під час виконання. У той час як обʼєкти PodGroup керують групами Podʼів на кінцевих рівнях, обʼєкти CompositePodGroup представляють проміжні групи, які забезпечують виконання політик планування для дочірніх груп.
Примітка:
У специфікації Workload поля spec.compositePodGroupTemplates та spec.podGroupTemplates утворюють обʼєднання: Workload повинен визначати або spec.podGroupTemplates (для пласких робочих навантажень), або spec.compositePodGroupTemplates (для ієрархічних робочих навантажень), але не може визначати обидва.
Структура та обмеження
Поле spec.compositePodGroupTemplates визначає проміжні шаблони в дереві ієрархії шаблонів груп. Кожен елемент представляє шаблон для CompositePodGroup і може містити:
Дочірні шаблони: вкладені CompositePodGroupTemplates (для проміжних груп) або PodGroupTemplates (для кінцевих груп, що містять Podʼи).
Політику планування: визначає, як плануються дочірні групи в межах цієї складеної групи:
basic: дочірні групи приймаються та плануються незалежно.
gang: забезпечує багаторівневе планування «все або нічого» для дочірніх груп. Вимагає minGroupCount, який визначає мінімальну кількість дочірніх груп, які мають бути придатними для планування одночасно, щоб складена група була здійсненною.
Обмеження планування: необовʼязкові топологічні обмеження для багаторівневого топологічно орієнтованого планування.
Пріоритет, політика витіснення та режим порушення: необовʼязкові priorityClassName, disruptionMode (Single або All) та preemptionPolicy для витіснення з урахуванням робочого навантаження.
Щоб забезпечити стабільність кластера та ефективність панелі управління, ієрархія шаблонів груп застосовує такі обмеження:
Максимальна глибина вкладеності: ієрархія шаблонів груп підтримує максимальну глибину 4 рівні.
Обмеження списку: кожен список compositePodGroupTemplates та podGroupTemplates суворо обмежений максимум 8 елементами.
Примітка:
Наразі ви не можете додавати нові або видаляти наявні CompositePodGroupTemplates. Ви можете лише змінювати значення minCount у політиці групового планування, визначеній у кінцевих PodGroupTemplates.
Приклад
Наступний приклад визначає ієрархічний Workload з шаблоном CompositePodGroup, який забезпечує групове планування для двох дочірніх шаблонів PodGroup (minGroupCount: 2), кожен з яких визначає власну політику групового планування:
apiVersion:scheduling.k8s.io/v1alpha3kind:Workloadmetadata:name:gang-of-gangs-workloadnamespace:defaultspec:compositePodGroupTemplates:- name:rootschedulingPolicy:gang:# Вимагає, щоб обидва дочірні PodGroups були придатними для планування разомminGroupCount:2podGroupTemplates:- name:workers-aschedulingPolicy:gang:# Вимагає, щоб 4 Podʼи в цій групі були придатними для плануванняminCount:4- name:workers-bschedulingPolicy:gang:# Вимагає, щоб 4 Podʼи в цій групі були придатними для плануванняminCount:4
Групове планування з Job
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the WorkloadWithJob feature gate for all relevant components in your cluster.
Коли функціональна можливість WorkloadWithJob увімкнена, контролер Job компілює конфігурацію .spec.scheduling обʼєкта Job в обʼєкти Workload та PodGroup перед тим, як створити будь-які Podʼи. Ви вмикаєте групове планування, встановивши .spec.scheduling.schedulingPolicy.gang у Job; пропущений gang.minCount стандартно дорівнює .spec.parallelism обʼєкта Job, тому всі Podʼи мають бути придатними для планування одночасно, перш ніж будь-який з них буде привʼязаний до вузлів.
Коли .spec.scheduling пропущено, Job стандартно використовує політику basic, яка зберігає звичайне планування Pod за Podʼом. У будь-якому випадку контролер Job створює Workload та PodGroup за вас, тому вам не потрібно створювати їх самостійно. Інші контролери робочих навантажень (наприклад, JobSet) можуть самостійно керувати своїми обʼєктами Workload та PodGroup.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Кожен PodGroup повинен оголосити політику планування у своєму полі spec.schedulingPolicy. Ця політика визначає, як планувальник обробляє набір Podʼів у групі.
Типи політик
Поле schedulingPolicy підтримує два типи політик: basic та gang. Ви повинні вказати рівно одну.
Політика basic
Політика basic вказує планувальнику оцінювати всі Podʼи за принципом best-effort. На відміну від політики gang, PodGroup, що використовує політику basic, вважається здійсненним незалежно від того, скільки його Podʼів наразі придатні для планування.
Основною причиною використання політики basic є організація Podʼів у групу для кращої спостережуваності та керування, водночас вони все одно оцінюються разом у рамках єдиного атомарного циклу планування PodGroup.
Ця політика підходить для груп, які не потребують одночасного запуску, але логічно належать до одного цілого, або для створення можливості для обмежень на рівні групи, які не передбачають розміщення за принципом «все або нічого».
schedulingPolicy:basic:{}
Політика gang
Політика gang забезпечує планування «все або нічого». Це необхідно для тісно повʼязаних робочих навантажень, де частковий запуск призводить до взаємних блокувань або марнування ресурсів.
Цю політику можна використовувати для Jobs або будь-якого іншого пакетного процесу, де всі робочі процеси повинні працювати одночасно, щоб просуватися в роботі.
Політика gang вимагає поля minCount, яке визначає мінімальну кількість Podʼів, які мають бути придатними для планування одночасно, щоб група була здійсненною:
schedulingPolicy:gang:# Кількість Podʼів, які повинні бути заплановані одночасно# для того, щоб група була прийнята.minCount:4
Встановлення політик через PodGroupTemplates
Під час використання Workload API ви визначаєте політики планування всередині PodGroupTemplates. Контролер робочого навантаження копіює політику з шаблону в кожен створений PodGroup, роблячи PodGroup самодостатнім. Зміни в шаблонах Workload впливають лише на новостворені PodGroups, а не на наявні.
Для автономних PodGroups (створених без Workload) ви встановлюєте spec.schedulingPolicy безпосередньо на самому PodGroup.
Політики в CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3, CompositePodGroupTemplates у Workload та обʼєкти CompositePodGroup також оголошують політику планування.
У той час як політика планування в PodGroup керує колекцією окремих Podʼів, політика планування CompositePodGroup керує його безпосередніми дочірніми групами (які можуть бути як обʼєктами CompositePodGroup, так і PodGroup).
Типи політик для CompositePodGroups
Подібно до PodGroups, поле spec.schedulingPolicy обʼєкта CompositePodGroup підтримує два типи:
basic: дочірні групи в межах CompositePodGroup оцінюються та приймаються незалежно.
gang: забезпечує багаторівневе планування «все або нічого» для дочірніх груп. CompositePodGroup придатний для планування, лише якщо принаймні minGroupCount дочірніх груп можуть бути заплановані одночасно.
schedulingPolicy:gang:# Мінімальна кількість дочірніх груп, які повинні бути заплановані# одночасно, щоб ця складова група була прийнята.minGroupCount:2
Встановлення складених політик через шаблони
Під час використання Workload API політики планування для CompositePodGroups визначаються всередині CompositePodGroupTemplates. Контролери робочого навантаження копіюють schedulingPolicy, вказану в шаблонах, у кожен CompositePodGroup, створений під час виконання. На відміну від кінцевих PodGroupTemplates, де minCount можна оновлювати, minGroupCount у CompositePodGroupTemplate є незмінним.
Що далі
Дізнайтеся про PodGroup API щоб зрозуміти, як політики застосовуються під час виконання.
Дізнайтеся про Workload API, який визначає PodGroupTemplates.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
PodGroup може оголосити режим порушення. Цей режим визначає, як планувальник може порушувати роботу запущеного PodGroup, наприклад, щоб розмістити PodGroup з вищим пріоритетом. PodGroup також має пріоритет, який перевизначає пріоритет окремих Podʼів з групи для подій витіснення з урахуванням робочого навантаження.
Типи режимів порушення
Примітка:
У v1.36 поля priority або disruptionMode обʼєкта PodGroup враховуються лише під час витіснення з урахуванням робочого навантаження. Під час фази планування Podʼів планувальник не враховує поля priority або disruptionMode обʼєкта PodGroup. Це обмеження більше не застосовується у v1.37.
API підтримує два режими порушення: Single та All. Стандартний режим — Single.
Single
Режим Single вказує планувальнику розглядати всі Podʼи в групі як окремі сутності, дозволяючи незалежно порушувати роботу окремого Podʼа з PodGroup.
All
Режим All передбачає семантику «все або нічого» для порушення. Він вказує планувальнику, що роботу всіх Podʼів з PodGroup потрібно порушувати разом.
CompositePodGroup
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
CompositePodGroup також може оголосити disruptionMode у своїй специфікації, який визначає, як планувальник порушує роботу дочірніх груп у межах складеної групи під час подій витіснення.
API підтримує два режими порушення для CompositePodGroups:
Single: дозволяє незалежно порушувати роботу окремих дочірніх груп у межах CompositePodGroup під час витіснення.
All: забезпечує семантику порушення «все або нічого» для всієї ієрархії CompositePodGroup. Якщо будь-який Pod, що міститься в ієрархії нижче цього CompositePodGroup, має бути витіснений, усі Podʼи з усієї ієрархії мають бути витіснені.
Якщо не вказано, стандартний режим — Single.
Примітка:
У v1.37 група може встановити свій режим порушення в All і мати дочірні групи з режимом Single. У такому випадку режим All верхнього рівня перевизначає режими Single нащадків.
Така конфігурація не рекомендується через неоднозначну семантику.
Пріоритет групи Podʼів
PodGroup використовує ту ж концепцію PriorityClass, що й окремі Podʼи. Після створення одного або кількох PriorityClasses ви можете створити PodGroup, який вказує одну з цих назв PriorityClass у своїй специфікації. Контролер допуску пріоритету використовує поле priorityClassName і заповнює ціле значення пріоритету. Якщо клас пріоритету не знайдено, PodGroup відхиляється. Коли priorityClassName не встановлено для PodGroup, Kubernetes шукає стандартне значення (PriorityClass з globalDefault, встановленим у true). Якщо немає PriorityClass з globalDefault, встановленим у true, PodGroup без priorityClassName має пріоритет нуль.
Пріоритет PodGroup є авторитетним пріоритетом для всіх Podʼів у групі під час подій витіснення з урахуванням робочого навантаження. Це значення також використовується для впорядкування PodGroup у черзі планування. Якщо пріоритети окремих Podʼів, що формують цей PodGroup, відрізняються від пріоритету PodGroup, PodGroup не буде заплановано з помилкою all pods in a single pod group should have the same priority as the pod group (усі Podʼи в одній групі Podʼів повинні мати такий самий пріоритет, як і сама група Podʼів).
Коли увімкнено функціональну можливість PodGroupPreemptionPolicy, PodGroup також має поле preemptionPolicy. Це поле також береться з PriorityClass. Воно є авторитетним полем для всіх Podʼів у групі та визначає, чи може PodGroup виконувати витіснення Podʼів і груп Podʼів з нижчим пріоритетом, щоб звільнити місце для себе. Коли функціональну можливість увімкнено, усі Podʼи в PodGroup повинні мати той самий preemptionPolicy, що й PodGroup. Інакше PodGroup не буде заплановано з помилкою all pods in a single pod group should have the same preemption policy as the pod group's preemption policy (усі Podʼи в одній групі Podʼів повинні мати ту саму політику витіснення, що й політика витіснення цієї групи Podʼів). Коли PodGroup має preemptionPolicy: Never, він не виконуватиме витіснення з урахуванням робочого навантаження. Якщо функціональну можливість вимкнено, усі Podʼи, що формують PodGroup, повинні мати однаковий preemptionPolicy. Інакше PodGroup не буде заплановано з помилкою all pods in a single pod group should have the same preemption policy (усі Podʼи в одній групі Podʼів повинні мати однакову політику витіснення).
Наступний YAML є прикладом конфігурації PodGroup, який використовує PriorityClass high-priority, що відповідає цілому значенню пріоритету 1000000. Контролер допуску пріоритету перевіряє специфікацію та визначає пріоритет PodGroup як 1000000.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
API CompositePodGroup також має поля priorityClassName та priority, і їх визначення виконується так само, як і для PodGroups, через контролер допуску пріоритету.
Пріоритет кореневого CompositePodGroup діє як авторитетний пріоритет для всіх дочірніх груп і Podʼів у межах його ієрархії під час подій витіснення з урахуванням робочого навантаження. Усі Podʼи в межах однієї ієрархії груп повинні мати точно такий самий пріоритет, який має дорівнювати пріоритету кореневого CompositePodGroup.
Значення пріоритету також використовується для впорядкування кореневих CompositePodGroups в активній черзі планування.
Примітка:
У v1.37 планувальник не перевіряє, чи мають некореневі групи значення пріоритету, що дорівнює пріоритету кореневого CompositePodGroup.
PreemptionPolicy у CompositePodGroup
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the PodGroupPreemptionPolicy feature gate for all relevant components in your cluster.
API CompositePodGroup також має поле preemptionPolicy, і його визначення виконується точно так само, як і для API PodGroup.
Значення preemptionPolicy кореневого CompositePodGroup визначає, чи може бути викликане витіснення з урахуванням робочого навантаження для розміщення його Podʼів під час планування, якщо це необхідно:
політика PreemptLowerPriority дозволяє витісняти жертв з нижчим пріоритетом;
політика Never вимикає витіснення з урахуванням робочого навантаження для цього кореневого CompositePodGroup.
Усі Podʼи в межах однієї ієрархії груп повинні мати точно таку саму політику витіснення, яка має дорівнювати політиці витіснення кореневого CompositePodGroup.
Якщо функціональну можливість вимкнено, кореневому CompositePodGroup буде дозволено виконувати витіснення, якщо жоден з Podʼів, що належить до ієрархії групи, не має preemptionPolicy зі значенням Never.
Примітка:
У v1.37, коли функціональну можливість увімкнено, планувальник не перевіряє, чи мають некореневі групи політику витіснення, що дорівнює політиці витіснення кореневого CompositePodGroup.
6.4.7.3 - Топологічно орієнтоване планування робочих навантажень
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TopologyAwareWorkloadScheduling feature gate for all relevant components in your cluster.
Топологічно орієнтоване планування робочих навантажень (Topology-Aware Scheduling, TAS) є можливістю Workload API, яка оптимізує розміщення Podʼів у межах кластера.
TAS забезпечує, щоб усі Podʼи в межах PodGroup були розміщені в одному топологічному домені, наприклад, в одній серверній стійці або в одній зоні. Це мінімізує затримки між Podʼами та запобігає фрагментації робочого навантаження по інфраструктурі кластера.
Топологічно орієнтоване планування з політикою gang
Під час застосування до PodGroups з політикою планування gang TAS симулює потенційне призначення (placement, розміщення) всієї групи Podʼів одразу. Він гарантує, що принаймні вказана кількість minCount Podʼів може розміститися разом в одному топологічному домені, перш ніж виділяти ресурси. Якщо жодного здійсненного розміщення не знайдено, весь PodGroup стає непридатним для планування.
Цей підхід рекомендується для робочих навантажень, таких як розподілене навчання AI та ML, які суворо потребують близькості для мінімізації затримок між Podʼами.
Якщо нові Podʼи додаються до PodGroup, у якому деякі Podʼи вже заплановані (наприклад, якщо Podʼи створюються повторно), планувальник змусить усі нові Podʼи розміститися саме в тому топологічному домені, де наразі перебувають наявні Podʼи. Якщо в цьому конкретному домені недостатньо ресурсів для нових Podʼів, вони залишаться в стані очікування — навіть якщо це означає, що на даний момент буде заплановано менше ніж minCount Podʼів.
Примітка:
Станом на v1.36 топологічно орієнтоване планування не ініціює витіснення робочих навантажень або Podʼів. Якщо жодного здійсненного розміщення не вдається знайти без витіснення, PodGroup стає непридатним для планування.
Топологічно орієнтоване планування з політикою basic
Використання TAS з політикою планування basic може призводити до непослідовної поведінки. Планувальник може спостерігати лише підмножину Podʼів під час входу в цикл планування PodGroup — тому здійсненність розміщення оцінюється лише для спостережуваних Podʼів, а не для всього PodGroup. Щоб частково помʼякшити це обмеження, можна використовувати шлюзи планування, щоб затримати планування PodGroup до тих пір, поки всі Podʼи в PodGroup не будуть у черзі планування.
Якщо жодного здійсненного розміщення для всього PodGroup не знайдено, може бути запланована лише підмножина Podʼів, і вони гарантовано відповідатимуть обмеженням планування.
Якщо нові Podʼи додаються до PodGroup, у якому деякі Podʼи вже заплановані, планувальник діятиме так само, як у випадку політики gang — змушуючи нові Podʼи розміститися в тому ж домені, якщо є достатньо ресурсів (у протилежному випадку нові Podʼи залишаться в стані очікування).
Налаштування API: обмеження планування
Кожен PodGroup (або PodGroupTemplate) може за бажанням оголосити поле schedulingConstraints, яке інтерпретується алгоритмом планування PodGroup на основі розміщення. Якщо обмеження визначені в PodGroupTemplate, вони будуть скопійовані до PodGroups, що на нього посилаються.
Станом на Kubernetes v1.36 API підтримує топологічні обмеження.
Примітка:
Станом на Kubernetes v1.36 ви можете вказати лише одне топологічне обмеження для кожного PodGroup.
Топологічне обмеження
Щоб визначити топологічне обмеження для PodGroup, потрібно встановити key, який відповідає мітці вузла Kubernetes, що представляє цільовий топологічний домен (наприклад, стійку або зону). Планувальник суворо забезпечує, щоб усі Podʼи в межах PodGroup були розміщені на вузлах, які мають точно однакове значення для цієї мітки.
Ось приклад PodGroup, налаштованого з топологічним обмеженням:
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Складні робочі навантаження можуть вимагати спільного розміщення їхніх Podʼів на різних рівнях інфраструктури кластера. Наприклад, усе робоче навантаження може потребувати запуску в межах однієї зони доступності, тоді як різні частини цього робочого навантаження можуть вимагати суворого спільного розміщення в межах конкретних серверних стійок.
Такі багаторівневі вимоги до спільного розміщення можна виразити за допомогою API CompositePodGroup та вказуючи топологічні обмеження на різних рівнях ієрархії груп.
Використання API CompositePodGroup вимагає увімкнення функціональної можливості CompositePodGroup та групи APIscheduling.k8s.io/v1alpha3.
Визначення багаторівневих топологічних обмежень
Кожна група в ієрархії CompositePodGroup може вказати топологічне обмеження, яке гарантує, що всі нащадкові Podʼи цієї групи будуть заплановані в тому самому топологічному домені, що відповідає обмеженню цієї групи.
Під час ієрархічного планування планувальник визначає ці обмеження зверху вниз. Зокрема, топологічні домени, які розглядаються під час планування дочірньої групи, обмежені топологічним доменом, що відповідає розміщенню, прийнятому батьківською групою.
Kubernetes не накладає жодних суворих вимог на фізичну ієрархію топологічних міток — топологічні ключі є довільними мітками вузлів. Однак порядок, у якому ви вказуєте топологічні обмеження від батьківської до дочірньої групи, визначає порядок, у якому планувальник поділяє топологічні домени.
Примітка:
Станом на Kubernetes v1.37 ви можете вказати лише одне топологічне обмеження в кожному CompositePodGroup.
Приклад
Наступний приклад налаштовує Workload, у якому батьківський CompositePodGroupTemplate обмежує все робоче навантаження однією зоною доступності (topology.example.com/zone), тоді як два дочірні елементи PodGroupTemplate (workers та driver) обмежують свої відповідні Podʼи серверними стійками (topology.example.com/rack) у межах цієї зони:
Під час планування планувальник спочатку обирає зону доступності для workload-root. Потім він поділяє вузли в цій зоні за стійками, щоб знайти здійсненні розміщення на стійках для workload-workers та workload-driver у межах обраної зони.
Наприклад, розглянемо кластер із пʼятьма вузлами, позначеними таким чином:
Вузол
topology.example.com/zone
topology.example.com/rack
node-a
zone-1
rack-1
node-b
zone-1
rack-1
node-c
zone-1
rack-2
node-d
zone-2
rack-1
node-e
zone-2
rack-3
Під час обробки workload-root планувальник оцінює можливі розміщення на всіх вузлах кластера на основі топологічного ключа topology.example.com/zone:
Оцінене можливе розміщення
Вузли в можливому розміщенні
zone-1
node-a, node-b, node-c
zone-2
node-d, node-e
Під час оцінки можливих розміщень для workload-workers планувальник поділяє лише вузли в межах розміщення, прийнятого workload-root, на основі топологічного ключа topology.example.com/rack:
Батьківське розміщення
Оцінене можливе розміщення
Вузли в можливому розміщенні
zone-1
rack-1
node-a, node-b
zone-1
rack-2
node-c
zone-2
rack-1
node-d
zone-2
rack-3
node-e
Можливі розміщення, згенеровані для сусіднього PodGroup workload-driver, ідентичні тим, що згенеровані для workload-workers, оскільки обидві групи вказують той самий топологічний ключ (topology.example.com/rack).
6.4.7.4 - API будівельних блоків планування та бібліотека workloadbuilder
Примітиви API планування багаторазового використання, які контролери робочих навантажень, як вбудовані, так і сторонні, вбудовують у свої власні API, а також спільна бібліотека workloadbuilder, яка компілює їх в обʼєкти Workload, PodGroup та CompositePodGroup.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Планування з урахуванням робочого навантаження (Workload-aware Scheduling) визначає набір будівельних блоків API багаторазового використання у групі APIscheduling.k8s.io. Автори контролерів вбудовують ці примітиви у свої власні API, щоб користувачі виражали намір щодо планування (групове планування, топологія, поведінка під час порушення) з узгодженою схемою в усій екосистемі, а спільна бібліотека workloadbuilder компілює цей намір в орієнтовані на планувальник обʼєкти Workload, PodGroup та CompositePodGroup.
Вбудованим споживачем цих будівельних блоків наразі є контролер Job, який вмикається функціональною можливістю WorkloadWithJob.
Будівельні блоки багаторазового використання
Будівельні блоки — це строго типізовані структури Go у групі API scheduling.k8s.io/v1alpha3. Вони призначені для авторів контролерів: контролер вбудовує ці структури у свій власний тип API як поля, а бібліотека workloadbuilder компілює їх. Назви типів дотримуються двох конвенцій: типи кінцевого рівня мають префікс WorkloadPodGroup... (наприклад, WorkloadPodGroupSchedulingPolicy), а багаторівневі варіанти — WorkloadCompositePodGroup....
Кожен контролер обирає назви полів та структуру, які є ідіоматичними для його власного API, тому ці блоки не навʼязують фіксованої форми верхнього рівня. Хоча це не є суворо обовʼязковим, рекомендується використовувати стандартні назви полів та структуру, щоб користувач, який налаштував групове планування на ресурсі одного контролера, впізнавав ті самі опції на ресурсі іншого.
Щоб перейняти будівельні блоки, контролер додає ті з них, які хоче підтримувати, як поля у своїх власних типах. Наприклад, API Job групує всі чотири з них в один тип, доступний у spec.scheduling:
Інший контролер може вкладати ті самі блоки для кожного компонента багаточастинного робочого навантаження або підтримувати лише їх підмножину.
Політика планування
Блок політики планування містить ті самі політики basic та gang, що й spec.schedulingPolicy PodGroup. Див. політики планування PodGroup для пояснення, що означає кожна політика та як планувальник її застосовує.
Єдина відмінність полягає в тому, що мінімальна кількість для gang у блоці є необовʼязковою. Користувачі можуть залишити minCount невстановленим, і в цьому випадку контролер надає стандартне значення, яке має сенс для його предметної області; контролер Job, наприклад, використовує паралелізм Job.
Обмеження планування
Блок обмежень планування містить топологічні обмеження, задокументовані в топологічно орієнтованому плануванні робочих навантажень: ключ мітки вузла, що називає домен (наприклад, стійку або зону), який повинен бути спільним для кожного Podʼа в групі, з не більш ніж одним топологічним обмеженням на групу. Контролери повинні заморожувати поле після створення, оскільки обмеження є незмінними в скомпільованому Workload.
Режим порушення
Блок режиму порушення визначає, чи можна порушувати роботу Podʼів групи окремо (single) або лише як єдиного цілого (all), що відповідає режимам порушення Pod та PodGroup, задокументованим у розділі Порушення та пріоритет групи Podʼів.
Бібліотека відхиляє комбінації, які не мають сенсу. Наприклад, вона забороняє режим порушення all для PodGroups з BasicSchedulingPolicy, оскільки одиниця витіснення не повинна бути більшою за одиницю планування — група, запланована Pod за Podʼом, не має одиниці на рівні групи для витіснення або порушення.
Заявки на ресурси
Блок заявок на ресурси виражає, які заявки динамічного виділення ресурсів є спільними для кожного Podʼа в групі, а не виділяються на кожен Pod окремо. Кожен запис називає заявку в межах групи та вказує або на наявний ResourceClaim, або на ResourceClaimTemplate, з якого вона генерується. Група може оголосити не більше чотирьох заявок.
Podʼи споживають пристрої, виділені групі, оголошуючи відповідну заявку у власній специфікації, використовуючи ту саму назву та посилаючись на той самий обʼєкт.
Складені будівельні блоки
Багаторівневі контролери, які оркеструють інші контролери (наприклад, JobSet, що створює Jobs), координують групу груп. Для цього рівня API надає аналогічний набір примітивів з префіксом WorkloadCompositePodGroup... (наприклад, WorkloadCompositePodGroupSchedulingPolicy). Вони мають таку саму форму, що й блоки кінцевого рівня, за винятком того, що складена політика gang використовує minGroupCount (мінімальну кількість дочірніх груп, які мають бути придатними для планування разом) замість minCount кінцевого рівня. Збереження окремих типів кінцевого та складеного рівнів дозволяє кожному рівню ієрархії розвиватися незалежно.
Приклад: інтеграція з Job
Контролер Job є вбудованим прикладом використання цих блоків. Користувач заповнює spec.scheduling Job, а контролер компілює його в Workload та PodGroup. Див. інтеграцію з Workload API для повного маніфесту Job, стандартних значень, які застосовуються, коли spec.scheduling пропущено, та які поля ви можете змінювати після створення.
Бібліотека workloadbuilder
workloadbuilder — це спільна бібліотека Go, яка перетворює намір контролера щодо планування в орієнтовані на планувальник Workload та його обʼєкти PodGroup/CompositePodGroup під час виконання, тож контролерам не потрібно заново реалізовувати застосування стандартних значень, перевірку та компіляцію шаблонів. Вона розроблена як для вбудованих контролерів (таких як контролер Job), так і для сторонніх контролерів (таких як JobSet або Kubeflow TrainJob), які підключають її через vendor, як будь-яку іншу залежність Go. Вона постачається з k8s.io/component-helpers/scheduling/schedulingv1/workloadbuilder.
Бібліотека споживає будівельні блоки scheduling.k8s.io/v1alpha3 та компілює їх в обʼєкти Workload та PodGroup scheduling.k8s.io/v1beta1, тоді як обʼєкти CompositePodGroup залишаються scheduling.k8s.io/v1alpha3.
Як контролер її використовує
Контролер описує своє робоче навантаження як дерево вузлів WorkloadItem, по одному на кожен логічний компонент. Вузол без дочірніх елементів стає одним PodGroupTemplate, тоді як вузол з дочірніми елементами стає CompositePodGroupTemplate над ними — саме так багаторівневий контролер представляє групу груп. Кожен вузол містить:
стандартну конфігурацію — власні стандартні значення контролера для всього, що користувач залишає невстановленим. Саме тут контролер вирішує, наприклад, що неналаштований Job залишається на плануванні basic.
вхідні дані — намір користувача, взятий з API контролера. Контролер записує кожен будівельний блок разом із шляхом до поля, на якому він розташований, щоб помилки перевірки вказували на точне поле, яке встановив користувач.
необовʼязкові зворотні виклики, які коригують обʼєднану конфігурацію. Саме так контролер надає контекстно-залежне стандартне значення, наприклад, заповнює невстановлену мінімальну кількість gang з паралелізму Job.
Потім контролер передає це дерево до Builder і виконує чотири виклики:
NewBuilder створює builder із дерева разом із назвою, простором імен та посиланням на власника для обʼєкта, який буде створено. Власник стає посиланням на контролер Workload, яке використовується для виявлення та збору сміття.
Validate розвʼязує дерево та повідомляє про будь-які проблеми як список помилок полів, які контролер повертає з власної перевірки API.
BuildWorkload компілює дерево в Workload. Результат кешується, тому з одного скомпільованого результату можна створити кілька PodGroups.
NewPodGroup створює PodGroup під час виконання з одного зі скомпільованих шаблонів, називаючи шаблон, з якого він повинен бути створений.
builder:=workloadbuilder.NewBuilder(item,opts)iferrs:=builder.Validate(ctx,workloadbuilder.ValidationInput{});len(errs)>0{// reject the request}workload,err:=builder.BuildWorkload()podGroup,err:=builder.NewPodGroup("trainer-pg",item.Name)
Повні робочі версії цього процесу, включаючи те, як контролер Job його підключає, дивіться в прикладах у довіднику пакета.
Перевірка конфігурації планування
Validate перевіряє конфігурацію на двох рівнях:
Структурна перевірка самих будівельних блоків: обовʼязкові поля, діапазони значень, правило, що рівно один член обʼєднання встановлений, та незмінність. Ці перевірки походять з правил декларативної перевірки, згенерованих з типів API.
Перевірки політики контролера, які декларативна перевірка не може виразити: списки дозволених значень, описані нижче, та міжпольові правила, такі як відхилення режиму порушення all разом з політикою basic.
Перевірка також відрізняється між створенням та оновленням обʼєкта. Під час оновлення бібліотека додатково забезпечує незмінність полів, заморожених після створення, що означає, що контролер повинен надати раніше збережену конфігурацію разом з новою. Під час створення немає з чим порівнювати, тому ці перевірки не застосовуються.
Відмова від декларативної перевірки
Чи потрібен вам перший рівень, залежить від того, де працює ваш контролер, і одна опція керує ним:
Сторонні контролери залишають декларативну перевірку увімкненою, що є стандартною поведінкою. Ніщо інше не застосовує ці структурні правила до власного ресурсу, тому один виклик Validate покриває обидва рівні.
Вбудовані контролери встановлюють DisableDeclarativeValidation, оскільки API-сервер вже виконує декларативну перевірку вбудованих блоків під час перевірки батьківського обʼєкта. Пропуск першого рівня дозволяє уникнути перевірки тих самих полів двічі, залишаючи Validate виконувати лише перевірки політики контролера.
Вибір опцій планування
Оскільки типи будівельних блоків є спільними для контролерів, майбутні випуски можуть додавати опції планування, які не мають сенсу для кожного контролера. Щоб нові опції не просочувалися непомітно, workloadbuilder використовує модель списку дозволених значень: контролер оголошує політики та режими порушення, які він підтримує, а Validate відхиляє все, що виходить за межі цього набору, повідомляючи про помилку за шляхом до поля блоку, що порушує правила.
Тому опції стандартно заборонені. Коли вводиться нова політика, наявний контролер продовжує її відхиляти, доки його супроводжувачі не розширять список дозволених значень, що для стороннього контролера означає також оновлення його копії бібліотеки у vendor.
Коли Workload вже існує, незалежно від того, чи він скомпільований батьківським контролером, чи створений вручну, дочірній контролер, який керує лише PodGroup під час виконання, використовує натомість NewBuilderFromExistingWorkload. Цей builder створює обʼєкти PodGroup з наданого Workload, використовуючи власне посилання на власника. Він нічого не перевіряє та не компілює, тому наявний Workload ніколи не перекомпілюється.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
PodGroup — це обʼєкт часу виконання, який представляє групу Podʼів, запланованих разом як єдине ціле. У той час як Workload API визначає шаблони політик планування, PodGroups є їхніми аналогами часу виконання, які містять як саму політику, так і статус планування для конкретного екземпляра цієї групи.
Що таке PodGroup?
Ресурс API PodGroup є частиною групи APIscheduling.k8s.io/v1beta1, і ваш кластер повинен мати цю групу API увімкненою, а також функціональну можливість GenericWorkload, перш ніж ви зможете використовувати цей API.
PodGroup — це самостійна одиниця планування. Він визначає групу Podʼів, які мають бути заплановані разом, містить політику планування, що регулює розміщення, і фіксує статус часу виконання цього рішення про планування.
Структура API
PodGroup складається з розділів spec, який визначає бажану поведінку планування, та status, який відображає поточний стан планування.
Політика планування
Кожен PodGroup містить політику планування (basic або gang) у spec.schedulingPolicy. Коли контролер робочого навантаження створює PodGroup, ця політика копіюється з PodGroupTemplate обʼєкта Workload під час створення. Для автономних PodGroups ви встановлюєте політику безпосередньо.
spec:schedulingPolicy:gang:minCount:4
Посилання на шаблон
Необовʼязкове поле spec.podGroupTemplateRef повʼязує PodGroup з PodGroupTemplate у Workload, з якого його було створено. Це корисно для спостереження та інструментів.
Кожен PodGroup також може визначати власні spec.priority, spec.preemptionPolicy та spec.disruptionMode. Пріоритет і політика витіснення встановлюються за допомогою поля spec.priorityClassName, яке вказує на ресурс PriorityClass. Див. Порушення та пріоритет групи Podʼів для детального опису цих полів.
Коли контролер робочого навантаження створює PodGroup, ці поля копіюються з PodGroupTemplate обʼєкта Workload під час створення. Для автономних PodGroups ви встановлюєте поля безпосередньо.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRAWorkloadResourceClaims feature gate for all relevant components in your cluster.
ResourceClaims, повʼязані з PodGroups, можуть бути спільно використані всіма Podʼами, що належать до групи. Замість того, щоб мати посилання на кожен окремий Pod у status.reservedFor ResourceClaim, достатньо посилання на PodGroup, і будь-яка кількість Podʼів у тому самому PodGroup може спільно використовувати ResourceClaim. ResourceClaims також можуть бути створені з ResourceClaimTemplates для кожного PodGroup, що дозволяє пристроям, виділеним для кожного створеного ResourceClaim, бути спільно використаними Podʼами в кожному PodGroup.
За докладною інформацією та більш повним прикладом звертайтесь до документації DRA.
Статус
Планувальник оновлює status.conditions, щоб повідомити, чи група була успішно запланована. Основним станом є PodGroupInitiallyScheduled, який є True, коли всі необхідні Podʼи були розміщені, і False, коли планування не вдається.
Примітка:
Стан PodGroupInitiallyScheduled відображає лише початкове рішення планувальника. Планувальник не оновлює її, якщо Podʼи пізніше зазнають збою або будуть виселені. Детальніше див. у розділі Обмеження.
Ресурс API PodGroup є частиною групи APIscheduling.k8s.io/v1beta1 (і ваш кластер повинен мати цю групу API увімкненою, а також функціональну можливість GenericWorkload, перш ніж ви зможете використовувати цей API).
Наступний маніфест створює PodGroup з політикою планування gang, яка вимагає, щоб щонайменше 4 Podʼи були придатними для планування одночасно:
Ви можете переглянути PodGroups у вашому кластері:
kubectl get podgroups
Щоб побачити повний статус, включаючи стани планування:
kubectl describe podgroup training-worker-0
Як це все поєднується
Взаємозвʼязок між контролерами, Workloads, PodGroups та Podʼами побудовано за такою схемою:
Контролер робочого навантаження створює Workload, який визначає PodGroupTemplates з політиками планування.
Для кожного екземпляра часу виконання контролер створює PodGroup з одного з PodGroupTemplates обʼєкта Workload.
Контролер створює Podʼи, які посилаються на PodGroup через поле spec.schedulingGroup.podGroupName.
Контролер Job є єдиним вбудованим контролером робочого навантаження, який наразі дотримується цієї схеми. Власні контролери можуть реалізувати той самий процес для своїх власних типів робочих навантажень.
Workload виступає як довговічне визначення політики, тоді як PodGroups обробляють тимчасовий стан часу виконання для кожного екземпляра. Це розділення означає, що оновлення статусу окремих PodGroups не конкурують за спільний обʼєкт Workload.
Батьківська група
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup увімкнено, PodGroup може діяти як кінцевий вузол у багаторівневій ієрархії груп, що складається з PodGroups та CompositePodGroups. PodGroup може вказати свою батьківську групу за допомогою поля spec.parentCompositePodGroupName. Організація робочого навантаження в ієрархію груп може використовуватися для вираження багаторівневих вимог групового планування, багаторівневих обмежень топології та спільної долі під час порушення для частин робочого навантаження.
Для отримання додаткових відомостей про ієрархічні структури груп та багаторівневе групове планування див. огляд CompositePodGroup API.
Примітка:
PodGroup, який вказує spec.parentCompositePodGroupName, також повинен вказувати spec.workloadRef, повʼязуючи PodGroup з його шаблоном у Workload. Автономним обʼєктам PodGroup (створеним без spec.workloadRef) не дозволяється вказувати батьківський CompositePodGroup.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
PodGroup планується як єдине ціле і захищений від передчасного видалення, поки його Podʼи все ще працюють.
Володіння та життєвий цикл
PodGroups належать контролеру робочого навантаження, який їх створив (наприклад, Job), через стандартні ownerReferences. Коли обʼєкт-власник видаляється, PodGroups автоматично видаляються збирачем сміття.
Назви PodGroup повинні бути унікальними в межах простору імен і бути дійсними DNS-піддоменами.
Порядок створення
Контролери повинні створювати обʼєкти в такому порядку:
Workload — шаблон політики планування.
PodGroup — екземпляр під час виконання.
Pods — з spec.schedulingGroup.podGroupName, що вказує на PodGroup.
Якщо PodGroup включає podGroupTemplateRef, який вказує на Workload, що не існує (або видаляється), API-сервер відхиляє запит на створення PodGroup. Вказаний Workload повинен існувати перед створенням PodGroup.
Якщо Pod посилається на PodGroup, який ще не існує, Pod залишається в стані очікування. Планувальник автоматично ставить Pod у чергу для планування, як тільки PodGroup буде створено.
Захист від видалення
PodGroup не може бути повністю видалено, поки будь-які його Podʼи все ще працюють. Спеціальний завершувач забезпечує блокування видалення, поки всі Pods, що посилаються на PodGroup, не досягнуть термінальної фази (Succeeded або Failed).
PodGroups, керовані контролером та користувачем
У більшості випадків контролери робочих навантажень (наприклад, Job) створюють PodGroups автоматично (керовані контролером). Контролер визначає podGroupName для кожного Podʼа під час створення, аналогічно тому, як DaemonSet встановлює спорідненість вузлів для кожного Podʼа.
Якщо вам потрібно більше контролю над іменуванням та життєвим циклом, ви можете безпосередньо створювати обʼєкти PodGroup та самостійно встановлювати spec.schedulingGroup.podGroupName у своїх шаблонах Podʼів (керовані користувачем). Це надає вам повний контроль над створенням та іменуванням PodGroup.
Обмеження
Всі Podʼи в PodGroup повинні використовувати той самий .spec.schedulerName. Якщо виявлено невідповідність, планувальник відхиляє всі Podʼи в групі як такі, що не можуть бути заплановані.
Всі Podʼи в PodGroup повинні використовувати той самий .spec.priority. Якщо виявлено невідповідність, планувальник відхиляє всі Podʼи в групі як такі, що не можуть бути заплановані.
Всі Podʼи в PodGroup повинні використовувати той самий .spec.preemptionPolicy. Якщо виявлено невідповідність, планувальник відхиляє всі Podʼи в групі як такі, що не можуть бути заплановані.
Поле spec.schedulingGroup у Podʼа є незмінним. Після встановлення Pod не може перейти до іншого PodGroup.
Максимальна кількість PodGroupTemplates в одному Workload становить 8.
Планувальник не оновлює інформацію про статус щодо поточного робочого стану PodGroup або подальших спроб планування після початкового розміщення. Отже, статус PodGroup не оновлюється, коли наявні Podʼи зазнають збою, виселяються або завершуються, або коли нововиявлені Podʼи не можуть бути заплановані.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
CompositePodGroup — це обʼєкт часу виконання, який представляє некінцевий вузол у багаторівневій ієрархії робочого навантаження. У той час як Workload API визначає статичні шаблони політик планування, обʼєкти CompositePodGroup та PodGroup є їхніми аналогами часу виконання, які містять політики та посилання на ієрархію для конкретного екземпляра робочого навантаження.
Що таке CompositePodGroup?
Ресурс API CompositePodGroup є частиною групи APIscheduling.k8s.io/v1alpha3. Ваш кластер повинен мати цю групу API увімкненою, а також функціональну можливість CompositePodGroup, перш ніж ви зможете використовувати цей API.
CompositePodGroup представляє групування дочірніх груп (які можуть бути обʼєктами CompositePodGroup або PodGroup). Він містить політики планування, режими порушення, налаштування пріоритету та необовʼязкові топологічні обмеження, які застосовуються колективно до його дочірніх груп.
Структура API
CompositePodGroup складається з розділу spec, який визначає бажану поведінку планування для його дочірніх груп, та субресурсу status.
Політика планування
Кожен CompositePodGroup містить політику планування (basic або gang) у spec.schedulingPolicy. Коли контролер робочого навантаження створює CompositePodGroup, ця політика копіюється з CompositePodGroupTemplate обʼєкта Workload під час створення.
Для політики gang на CompositePodGroup поле minGroupCount визначає мінімальну кількість дочірніх груп, які мають бути придатними для планування одночасно:
spec:schedulingPolicy:gang:minGroupCount:2
Посилання на батьківську групу
Некореневі ресурси CompositePodGroup вказують свою батьківську групу за допомогою spec.parentCompositePodGroupName. Кореневі обʼєкти CompositePodGroup залишають це поле невстановленим.
spec:parentCompositePodGroupName:root-group-0
Посилання на робоче навантаження
Поле spec.workloadRef повʼязує CompositePodGroup з CompositePodGroupTemplate в обʼєкті Workload, з якого він був створений.
Схема API CompositePodGroup включає субресурс status. В альфа-версії поле status присутнє в типі API, але kube-scheduler не оновлює та не заповнює стани статусу для обʼєктів CompositePodGroup. Відстеження статусу для складених груп буде реалізовано в майбутніх випусках.
Створення CompositePodGroup
Контролери робочого навантаження створюють обʼєкти CompositePodGroup автоматично з шаблонів Workload під час виконання.
Наступний маніфест створює кореневий CompositePodGroup з політикою планування gang, яка вимагає, щоб щонайменше 2 дочірні групи були придатними для планування одночасно:
Ви можете переглянути ресурси CompositePodGroup у вашому кластері:
kubectl get compositepodgroups
Щоб переглянути деталі конкретної складеної групи:
kubectl describe compositepodgroup root-group-0
Як це все поєднується
Взаємозвʼязок між контролерами, Workloads, CompositePodGroups, PodGroups та Podʼами побудовано за такою схемою:
Контролер робочого навантаження створює Workload, який визначає дерево CompositePodGroupTemplates та кінцевих PodGroupTemplates.
Для кожного екземпляра часу виконання контролер створює кореневий CompositePodGroup, дочірні обʼєкти CompositePodGroup та кінцеві обʼєкти PodGroup у порядку зверху вниз.
Контролер створює Pods, які посилаються на свій кінцевий PodGroup через spec.schedulingGroup.podGroupName.
Наступний приклад ілюструє повну ієрархію маніфестів для дворівневого робочого навантаження:
Workload виступає як довговічний шаблон політики, тоді як ресурси CompositePodGroup та PodGroup обробляють стан планування під час виконання для кожного екземпляра.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
CompositePodGroup представляє некінцевий вузол у багаторівневій ієрархії PodGroup. На відміну від ресурсів PodGroup, ресурси CompositePodGroup не містять Podʼів безпосередньо. Натомість вони підтримують ієрархію дочірніх обʼєктів CompositePodGroup та PodGroup і містять політики планування, які застосовуються до їхніх дочірніх груп.
Володіння та збір сміття
Обʼєкт CompositePodGroup разом зі своїми дочірніми ресурсами CompositePodGroup та PodGroup належить контролеру робочого навантаження, який його створив, через ownerReferences Kubernetes. Коли обʼєкт-власник робочого навантаження видаляється, каскадний збір сміття автоматично видаляє повʼязану ієрархію груп.
Назви CompositePodGroup повинні бути унікальними в межах простору імен і бути дійсними DNS-піддоменами.
Порядок створення
Щоб забезпечити правильне розвʼязання ієрархії та планування, контролери робочого навантаження створюють ресурси в порядку зверху вниз:
Workload: визначає статичні шаблони (CompositePodGroupTemplates та PodGroupTemplates).
Кореневий CompositePodGroup: створюється з spec.workloadRef, що вказує на кореневий шаблон у Workload.
Дочірні CompositePodGroups та PodGroups: створюються зверху вниз. Кожна дочірня група вказує свого батька за допомогою spec.parentCompositePodGroupName, а свій шаблон — за допомогою spec.workloadRef.
Pods: створюються з spec.schedulingGroup.podGroupName, що вказує на їхній кінцевий PodGroup.
Якщо група посилається на батьківський CompositePodGroup, який не існує, або якщо Pod посилається на PodGroup, який ще не створено, планувальник відкладає планування, доки всі батьківські ресурси в ієрархії не існуватимуть.
Обмеження та правила перевірки
Узгоджена назва планувальника: всі Podʼи в усій ієрархії CompositePodGroup повинні використовувати той самий spec.schedulerName. Якщо виявлено невідповідність, планувальник відхиляє ієрархію як непридатну для планування.
Узгоджений пріоритет: всі Podʼи в усій ієрархії CompositePodGroup повинні вказувати те саме значення spec.priority, яке має дорівнювати пріоритету, вказаному кореневою групою. Якщо виявлено невідповідність, планувальник відхиляє ієрархію як непридатну для планування.
Узгоджена політика витіснення: всі Podʼи в усій ієрархії CompositePodGroup повинні використовувати той самий spec.preemptionPolicy. Крім того, коли функціональну можливість PodGroupPreemptionPolicy увімкнено, політика витіснення кореневої групи повинна дорівнювати політиці, вказаній Podʼами. Якщо виявлено невідповідність, планувальник відхиляє ієрархію як непридатну для планування.
Максимальна глибина вкладеності: ієрархія шаблонів груп підтримує максимальну глибину 4 рівні.
Обмеження списку: максимальна кількість дочірніх CompositePodGroupTemplates та PodGroupTemplates на будь-якому рівні Workload становить 8.
Незмінна кількість груп gang: поле spec.schedulingPolicy.gang.minGroupCount на CompositePodGroup є незмінним після створення.
Незмінні посилання на ієрархію: spec.parentCompositePodGroupName на групах та spec.schedulingGroup на Podʼах є незмінними після встановлення.
6.5 - Services, балансування навантаження та мережа
Концепції та ресурси, що лежать в основі мережі в Kubernetes.
Мережева модель Kubernetes
Мережева модель Kubernetes складається з кількох частин:
Кожен Pod у кластері отримує власну унікальну в межах кластера IP-адресу.
Pod має власний приватний мережевий простір імен, який спільно використовують усі контейнери в цьому Podʼі. Процеси, що працюють у різних контейнерах одного Podʼа, можуть взаємодіяти між собою через localhost.
Мережа Podʼів (також називається мережею кластера) забезпечує взаємодію між Podʼами. Вона гарантує, що (за відсутності навмисної сегментації мережі):
Усі Podʼи можуть взаємодіяти з усіма іншими Podʼами, незалежно від того, чи перебувають вони на одному вузлі, чи на різних. Podʼи можуть взаємодіяти безпосередньо, без використання проксі-серверів чи трансляції адрес (NAT).
У Windows це правило не застосовується до Podʼів із мережею хоста.
Агенти на вузлі (такі як системні демони чи kubelet) можуть взаємодіяти з усіма Podʼами на цьому вузлі.
API Service дозволяє надати стабільну (довговічну) IP-адресу або імʼя хоста для сервісу, реалізованого одним або кількома Podʼами-бекендами, при цьому окремі Podʼи, що складають сервіс, можуть змінюватися з часом.
Kubernetes автоматично керує обʼєктами EndpointSlice, щоб надавати інформацію про Podʼи, які наразі обслуговують Service.
Реалізація проксі сервісів відстежує набір обʼєктів Service та EndpointSlice і програмує площину даних для маршрутизації трафіку сервісу до його бекендів, використовуючи API операційної системи або хмарного провайдера для перехоплення чи переписування пакетів.
API Gateway (або його попередник Ingress) дозволяє зробити Services доступними для клієнтів поза кластером.
Простіший, але менш гнучкий механізм вхідного трафіку кластера доступний через type: LoadBalancer в API Service, якщо ви використовуєте підтримуваного хмарного провайдера.
NetworkPolicy — це вбудований API Kubernetes, який дозволяє контролювати трафік між Podʼами або між Podʼами та зовнішнім світом.
У старіших контейнерних системах не було автоматичного звʼязку між контейнерами на різних хостах, тому часто доводилося явно створювати посилання між контейнерами або зіставляти порти контейнерів із портами хоста, щоб контейнери на інших хостах могли до них звертатися. У Kubernetes це не потрібно: модель Kubernetes передбачає, що Podʼи можна розглядати подібно до віртуальних машин або фізичних хостів з погляду виділення портів, іменування, виявлення сервісів, балансування навантаження, налаштування застосунків та міграції.
Лише кілька частин цієї моделі реалізовані безпосередньо в Kubernetes. Для решти Kubernetes визначає API, але відповідну функціональність надають зовнішні компоненти, деякі з яких є необовʼязковими:
Налаштування мережевого простору імен Podʼа виконує системне програмне забезпечення, яке реалізує Container Runtime Interface.
Мережею Podʼів керує реалізація мережі Podʼів. У Linux більшість середовищ виконання контейнерів використовують Container Networking Interface (CNI), щоб взаємодіяти з реалізацією мережі Podʼів, тому ці реалізації часто називають втулками CNI.
Kubernetes надає стандартну реалізацію проксіювання сервісів, яка називається kube-proxy, але деякі реалізації мережі Podʼів використовують власний проксі сервісів, тісніше інтегрований з рештою реалізації.
NetworkPolicy зазвичай також реалізується реалізацією мережі Podʼів. (Деякі простіші реалізації мережі Podʼів не реалізують NetworkPolicy, або адміністратор може налаштувати мережу Podʼів без підтримки NetworkPolicy. У таких випадках API буде присутній, але не матиме жодного ефекту.)
Існує багато реалізацій Gateway API: деякі специфічні для певних хмарних середовищ, деякі більше орієнтовані на середовища bare metal, а інші є більш універсальними.
Відкрийте доступ до застосунку, що працює у вашому кластері, через єдину зовнішню точку доступу, навіть якщо робоче навантаження розподілене між кількома бекендами.
У Kubernetes Service — це метод надання доступу ззовні до мережевого застосунку, який працює як один чи кілька Podʼів у вашому кластері.
Ключова мета Services у Kubernetes полягає в тому, що вам не потрібно змінювати наявний застосунок, щоб використовувати незнайомий механізм виявлення сервісів. Ви можете запускати код у Podʼах, незалежно від того, чи розроблений він для світу cloud native, чи це старіший застосунок, який ви контейнеризували. Ви використовуєте Service, щоб зробити цей набір Podʼів доступним у мережі, щоб клієнти могли з ним взаємодіяти.
Якщо ви використовуєте Deployment для запуску застосунку, цей Deployment може динамічно створювати та знищувати Podʼи. У будь-який момент ви не знаєте, скільки з цих Podʼів працюють і є справними; ви навіть можете не знати, як називаються ці справні Podʼи. Podʼи Kubernetes створюються та знищуються відповідно до бажаного стану вашого кластера. Podʼи є ефемерними ресурсами (не варто очікувати, що окремий Pod буде надійним і довговічним).
Кожен Pod отримує власну IP-адресу (Kubernetes очікує, що це забезпечать мережеві втулки). Для певного Deployment у вашому кластері набір Podʼів, що працює в один момент часу, може відрізнятися від набору Podʼів, що виконує цей застосунок мить потому.
Це призводить до проблеми: якщо певний набір Podʼів (назвемо їх «бекендами») надає функціональність іншим Podʼам (назвемо їх «фронтендами») всередині вашого кластера, як фронтенди дізнаються та відстежують, до якої IP-адреси підключатися, щоб фронтенд міг використовувати бекенд-частину робочого навантаження?
Тут на допомогу приходять Services.
Services у Kubernetes
API Service, що є частиною Kubernetes, — це абстракція, яка допомагає відкривати доступ до груп Podʼів через мережу. Кожен обʼєкт Service визначає логічний набір точок доступу (зазвичай ці точки доступу є Podʼами) разом із політикою того, як зробити ці Podʼи доступними.
Наприклад, розгляньмо stateless-бекенд для обробки зображень, який працює з 3 репліками. Ці репліки взаємозамінні: фронтендам не важливо, який бекенд вони використовують. Хоча конкретні Podʼи, що утворюють набір бекендів, можуть змінюватися, клієнтам-фронтендам не потрібно про це знати чи самостійно відстежувати набір бекендів.
Абстракція Service робить можливим таке відокремлення.
Набір Podʼів, на які спрямований Service, зазвичай визначається селектором, який ви задаєте. Щоб дізнатися про інші способи визначення точок доступу Service, дивіться Services без селекторів.
Якщо ваше робоче навантаження використовує HTTP, ви можете скористатися Ingress, щоб контролювати, як вебтрафік досягає цього навантаження. Ingress не є типом Service, але він діє як точка входу до вашого кластера. Ingress дозволяє обʼєднати правила маршрутизації в одному ресурсі, щоб відкрити доступ до кількох компонентів вашого робочого навантаження, які працюють у кластері окремо, через одного слухача.
API Gateway для Kubernetes надає додаткові можливості порівняно з Ingress і Service. Ви можете додати Gateway до свого кластера — це сімейство API розширення, реалізованих за допомогою CustomResourceDefinitions, — а потім використовувати їх для налаштування доступу до мережевих сервісів, що працюють у вашому кластері.
Виявлення сервісів у стилі cloud native
Якщо ви можете використовувати API Kubernetes для виявлення сервісів у своєму застосунку, ви можете надсилати запити до API-сервера щодо відповідних EndpointSlices. Kubernetes оновлює EndpointSlices для Service щоразу, коли змінюється набір Podʼів у цьому Service.
Для ненативних застосунків Kubernetes пропонує способи розмістити мережевий порт або балансувальник навантаження між вашим застосунком і бекенд-Podʼами.
У будь-якому разі ваше робоче навантаження може використовувати ці механізми виявлення сервісів, щоб знайти ціль, до якої воно хоче підʼєднатися.
Визначення Service
Service — це обʼєкт (так само, як Pod чи ConfigMap). Ви можете створювати, переглядати або змінювати визначення Service за допомогою API Kubernetes. Зазвичай для цих викликів API ви використовуєте інструмент, такий як kubectl.
Наприклад, припустимо, що у вас є набір Podʼів, кожен з яких слухає TCP-порт 9376 і має мітку app.kubernetes.io/name=MyApp. Ви можете визначити Service, щоб опублікувати цього слухача TCP:
Застосування цього маніфесту створює новий Service з назвою "my-service" зі стандартним типом Service ClusterIP. Service спрямовує трафік на TCP-порт 9376 будь-якого Podʼа з міткою app.kubernetes.io/name: MyApp.
Kubernetes призначає цьому Service IP-адресу (кластерний IP), яка використовується механізмом віртуальних IP-адрес. Докладніше про цей механізм читайте у Віртуальні IP та проксі для Service.
Контролер цього Service постійно шукає Podʼи, що відповідають його селектору, а потім вносить необхідні оновлення до набору EndpointSlices цього Service.
Service може зіставляти будь-який вхідний port із targetPort. Стандартно та для зручності targetPort має те саме значення, що й поле port.
Визначення портів
Визначення портів у Podʼах мають назви, і ви можете посилатися на ці назви в атрибуті targetPort Service. Наприклад, ми можемо привʼязати targetPort Service до порту Podʼа таким чином:
Це працює, навіть якщо в Service є суміш Podʼів, що використовують одну налаштовану назву, а той самий мережевий протокол доступний на різних номерах портів. Це дає багато гнучкості для розгортання та розвитку ваших Services. Наприклад, ви можете змінити номери портів, які відкривають Podʼи, у наступній версії програмного забезпечення вашого бекенду, не порушуючи роботу клієнтів.
Стандартним протоколом для Services є TCP; ви також можете використовувати будь-який інший підтримуваний протокол.
Оскільки багатьом Services потрібно відкривати більше ніж один порт, Kubernetes підтримує кілька визначень портів для одного Service. Кожне визначення порту може мати той самий protocol або інший.
Services без селекторів
Services найчастіше абстрагують доступ до Podʼів Kubernetes завдяки селектору, але коли вони використовуються з відповідним набором обʼєктів EndpointSlices без селектора, Service може абстрагувати інші види бекендів, зокрема ті, що працюють поза кластером.
Наприклад:
Ви хочете мати зовнішній кластер баз даних у промисловому середовищі, але в тестовому середовищі використовуєте власні бази даних.
Ви хочете спрямувати свій Service на Service в іншому просторі імен або в іншому кластері.
Ви мігруєте робоче навантаження до Kubernetes. Під час оцінювання цього підходу ви запускаєте в Kubernetes лише частину своїх бекендів.
У будь-якому з цих сценаріїв ви можете визначити Service без зазначення селектора для вибору Podʼів. Наприклад:
Оскільки цей Service не має селектора, відповідні обʼєкти EndpointSlice не створюються автоматично. Ви можете зіставити Service з мережевою адресою та портом, де він працює, додавши обʼєкт EndpointSlice вручну. Наприклад:
apiVersion:discovery.k8s.io/v1kind:EndpointSlicemetadata:name:my-service-1# за домовленістю використовуйте назву Service# як префікс для назви EndpointSlicelabels:# Ви повинні встановити мітку "kubernetes.io/service-name".# Встановіть її значення відповідно до назви Servicekubernetes.io/service-name:my-serviceaddressType:IPv4ports:- name:http# має збігатися з назвою порту Service, визначеного вищеappProtocol:httpprotocol:TCPport:9376endpoints:- addresses:- "10.4.5.6"- addresses:- "10.1.2.3"
Власні EndpointSlices
Коли ви створюєте обʼєкт EndpointSlice для Service, ви можете використовувати будь-яку назву для EndpointSlice. Кожен EndpointSlice у просторі імен повинен мати унікальну назву. Ви повʼязуєте EndpointSlice із Service, встановлюючи на цьому EndpointSlice міткуkubernetes.io/service-name.
Примітка:
IP-адреси точок доступу не повинні бути: loopback-адресами (127.0.0.0/8 для IPv4, ::1/128 для IPv6) або link-local-адресами (169.254.0.0/16 та 224.0.0.0/24 для IPv4, fe80::/64 для IPv6).
IP-адреси точок доступу не можуть бути кластерними IP-адресами інших Services Kubernetes, оскільки kube-proxy не підтримує віртуальні IP-адреси як призначення.
Для EndpointSlice, який ви створюєте самостійно або у власному коді, також слід вибрати значення для мітки endpointslice.kubernetes.io/managed-by. Якщо ви створюєте власний код контролера для керування EndpointSlices, розгляньте можливість використання значення на кшталт "my-domain.example/name-of-controller". Якщо ви використовуєте сторонній інструмент, використовуйте назву інструмента в нижньому регістрі, замінивши пробіли та інші знаки пунктуації дефісами (-). Якщо люди безпосередньо використовують інструмент, такий як kubectl, для керування EndpointSlices, використовуйте назву, яка описує це ручне керування, наприклад, "staff" або "cluster-admins". Уникайте використання зарезервованого значення "controller", яке позначає EndpointSlices, керовані власною панеллю управління Kubernetes.
Доступ до Service без селектора
Доступ до Service без селектора працює так само, як якби він мав селектор. У прикладі Service без селектора трафік спрямовується до однієї з двох точок доступу, визначених у маніфесті EndpointSlice: TCP-зʼєднання до 10.1.2.3 або 10.4.5.6 на порт 9376.
Примітка:
API-сервер Kubernetes не дозволяє проксіювання до точок доступу, не повʼязаних із Podʼами. Дії на кшталт kubectl port-forward service/<service-name> forwardedPort:servicePort, де Service не має селектора, завершаться збоєм через це обмеження. Це запобігає використанню API-сервера Kubernetes як проксі до точок доступу, до яких викликач може не мати дозволу на доступ.
Service ExternalName — це особливий випадок Service, який не має селекторів і натомість використовує DNS-імена. Докладнішу інформацію дивіться в розділі ExternalName.
EndpointSlices
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
EndpointSlices — це обʼєкти, які представляють підмножину (зріз) мережевих точок доступу, що стоять за Service.
Ваш кластер Kubernetes відстежує, скільки точок доступу представляє кожен EndpointSlice. Якщо для Service стільки точок доступу, що досягається поріг, Kubernetes додає ще один порожній EndpointSlice і зберігає там інформацію про нові точки доступу. Стандартно Kubernetes створює новий EndpointSlice, коли всі наявні EndpointSlices містять щонайменше 100 точок доступу. Kubernetes не створює новий EndpointSlice, доки не потрібно додати ще одну точку доступу.
Докладнішу інформацію про цей API дивіться в EndpointSlices.
Endpoints (застаріло)
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.33
API EndpointSlice є розвитком старішого API Endpoints. Застарілий API Endpoints має кілька проблем порівняно з EndpointSlice:
Він не підтримує двостекові кластери.
Він не містить інформації, потрібної для підтримки новіших можливостей, таких як trafficDistribution.
Він обрізає список точок доступу, якщо той надто довгий, щоб уміститися в одному обʼєкті.
Через це рекомендується, щоб усі клієнти використовували API EndpointSlice, а не Endpoints.
Точки доступу понад місткість
Kubernetes обмежує кількість точок доступу, які можуть уміститися в одному обʼєкті Endpoints. Коли в Service понад 1000 точок доступу, Kubernetes обрізає дані в обʼєкті Endpoints. Оскільки Service можна повʼязати з кількома EndpointSlices, обмеження в 1000 точок доступу стосується лише застарілого API Endpoints.
У цьому випадку Kubernetes вибирає не більше 1000 можливих точок доступу бекенда для збереження в обʼєкті Endpoints і встановлює на Endpoints анотаціюendpoints.kubernetes.io/over-capacity: truncated. Панель управління також вилучає цю анотацію, якщо кількість бекенд-Podʼів падає нижче 1000.
Трафік і далі надсилається на бекенди, але будь-який механізм балансування навантаження, який покладається на застарілий API Endpoints, надсилає трафік щонайбільше до 1000 доступних точок доступу.
Те саме обмеження API означає, що ви не можете вручну оновити Endpoints так, щоб він мав понад 1000 точок доступу.
Протокол застосунку
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.20
Поле appProtocol дає змогу вказати протокол застосунку для кожного порту Service. Воно використовується як підказка для реалізацій, щоб вони могли запропонувати розширену поведінку для протоколів, які розуміють. Значення цього поля дзеркально відтворюється у відповідних обʼєктах Endpoints та EndpointSlice.
Це поле відповідає стандартному синтаксису міток Kubernetes. Дійсні значення — одне з:
Для деяких Services вам потрібно відкрити більше одного порту. Kubernetes дозволяє налаштувати кілька визначень портів в обʼєкті Service. Під час використання кількох портів для Service ви повинні надати назви всім портам, щоб вони були однозначними. Наприклад:
Як і назви в Kubernetes загалом, назви портів мають містити лише буквено-цифрові символи в нижньому регістрі та -. Назви портів також мають починатися й закінчуватися буквено-цифровим символом.
Наприклад, назви 123-abc та web є допустимими, а 123_abc та -web — ні.
Тип Service
Для деяких частин вашого застосунку (наприклад, фронтендів) вам може знадобитися відкрити доступ до Service на зовнішній IP-адресі, яка доступна поза вашим кластером.
Типи Service у Kubernetes дозволяють вказати, який саме Service вам потрібен.
Відкриває доступ до Service на внутрішній IP-адресі кластера. Вибір цього значення робить Service доступним лише зсередини кластера. Це стандартне значення, яке використовується, якщо ви явно не вказали type для Service. Ви можете відкрити доступ до Service із загальнодоступного інтернету за допомогою Ingress або Gateway.
Відкриває доступ до Service на IP-адресі кожного вузла на статичному порту (NodePort). Щоб зробити порт вузла доступним, Kubernetes налаштовує кластерну IP-адресу так само, як якби ви запросили Service з type: ClusterIP.
Відкриває зовнішній доступ до Service за допомогою зовнішнього балансувальника навантаження. Kubernetes не надає компонент балансування навантаження безпосередньо; ви повинні надати його самі або інтегрувати свій кластер Kubernetes із хмарним провайдером.
Зіставляє Service із вмістом поля externalName (наприклад, з іменем хоста api.foo.bar.example). Це зіставлення налаштовує DNS-сервер вашого кластера на повернення запису CNAME із цим зовнішнім іменем хоста. Жодне проксіювання не налаштовується.
Поле type в API Service розроблено як вкладену функціональність: кожен рівень доповнює попередній. Однак із цього вкладеного дизайну є виняток. Ви можете визначити Service LoadBalancer, вимкнувши виділення NodePort для балансувальника навантаження.
type: ClusterIP
Цей стандартний тип Service призначає IP-адресу з пулу IP-адрес, який ваш кластер зарезервував для цієї мети.
Кілька інших типів Service базуються на типі ClusterIP.
Якщо ви визначаєте Service, у якому .spec.clusterIP має значення "None", Kubernetes не призначає IP-адресу. Докладнішу інформацію дивіться в розділі headless Services.
Вибір власної IP-адреси
Ви можете вказати власну кластерну IP-адресу в запиті на створення Service. Для цього встановіть поле .spec.clusterIP. Наприклад, це корисно, якщо у вас уже є запис DNS, який ви хочете використовувати повторно, або застарілі системи, налаштовані на певну IP-адресу, які важко переналаштувати.
Вибрана вами IP-адреса має бути дійсною адресою IPv4 або IPv6 із діапазону CIDR service-cluster-ip-range, налаштованого для API-сервера. Якщо ви спробуєте створити Service з недійсним значенням clusterIP, API-сервер поверне код стану HTTP 422, щоб вказати на проблему.
Читайте уникнення конфліктів, щоб дізнатися, як Kubernetes допомагає зменшити ризик і наслідки спроб двох різних Services використовувати ту саму IP-адресу.
type: NodePort
Якщо ви встановлюєте поле type у NodePort, панель управління Kubernetes виділяє порт із діапазону, вказаного прапорцем --service-node-port-range (стандартно: 30000-32767). Кожен вузол проксіює цей порт (той самий номер порту на кожному вузлі) у ваш Service. Ваш Service повідомляє виділений порт у своєму полі .spec.ports[*].nodePort.
Використання NodePort дає вам свободу налаштувати власне рішення для балансування навантаження, конфігурувати середовища, які не повністю підтримуються Kubernetes, або навіть безпосередньо відкрити IP-адреси одного чи кількох вузлів.
Для Service з портом вузла Kubernetes додатково виділяє порт (TCP, UDP або SCTP відповідно до протоколу Service). Кожен вузол кластера налаштовується на прослуховування цього призначеного порту та пересилання трафіку до однієї з готових точок доступу, повʼязаних із цим Service. Ви зможете звернутися до Service type: NodePort ззовні кластера, підʼєднавшись до будь-якого вузла за відповідним протоколом (наприклад, TCP) та відповідним портом (призначеним цьому Service).
Вибір власного порту
Якщо вам потрібен певний номер порту, ви можете вказати значення в полі nodePort. Панель управління або виділить вам цей порт, або повідомить, що транзакція API не вдалася. Це означає, що вам потрібно самостійно подбати про можливі конфлікти портів. Ви також повинні використовувати дійсний номер порту, що входить до діапазону, налаштованого для використання NodePort.
Ось приклад маніфесту для Service з type: NodePort, який вказує значення NodePort (у цьому прикладі 30007):
apiVersion:v1kind:Servicemetadata:name:my-servicespec:type:NodePortselector:app.kubernetes.io/name:MyAppports:- port:80# Стандартно та для зручності `targetPort` встановлено# у те саме значення, що й поле `port`.targetPort:80# Необовʼязкове поле# Стандартно та для зручності панель управління Kubernetes# виділить порт із діапазону (стандартно: 30000-32767)nodePort:30007
Резервування діапазонів NodePort для уникнення конфліктів
Політика призначення портів Services NodePort застосовується як до автоматичного, так і до ручного призначення. Коли користувач хоче створити Service NodePort, який використовує певний порт, цей цільовий порт може конфліктувати з іншим, уже призначеним портом.
Щоб уникнути цієї проблеми, діапазон портів для Services NodePort поділено на дві смуги. Динамічне призначення портів стандартно використовує верхню смугу, а коли її вичерпано, може використовувати нижню. Користувачі можуть виділяти порти з нижньої смуги з меншим ризиком конфлікту портів.
Під час використання стандартного діапазону NodePort 30000-32767 смуги розподіляються так:
Під час використання kube-proxy у режимі iptables Services NodePort стандартно доступні на всіх IP-адресах вузла. Під час використання режиму nftables вони стандартно доступні лише на основній IP-адресі вузла (або основних IP-адресах у разі подвійного стека).
Ви можете змінити набір IP-адрес вузла, на яких доступні Services NodePort, за допомогою прапорця kube-proxy --nodeport-addresses або еквівалентного поля nodePortAddresses у файлі конфігурації kube-proxy. Він приймає розділений комами список IP-блоків (наприклад, 10.0.0.0/8, 192.0.2.0/25) або одне чи кілька з таких ключових слів:
primary — основна адреса IPv4 та/або IPv6 вузла згідно з обʼєктом Node. (Це стандартне значення для режиму nftables.)
all — усі адреси. (Це стандартне значення для режимів iptables та ipvs.)
Наприклад, якщо ви запускаєте kube-proxy з прапорцем --nodeport-addresses=192.168.0.0/24, kube-proxy спробує знайти локальну IP-адресу в цій підмережі на кожному вузлі та обслуговуватиме Services NodePort лише через цю IP-адресу.
Services type: NodePort через localhost
Механізми, які проксі сервісів використовують для реалізації Services NodePort, не завжди підтримують надання Services NodePort на localhost. Для kube-proxy:
Під час використання режиму iptables зі значенням --nodeport-addresses, яке містить 127.0.0.1, Services NodePort будуть доступні на 127.0.0.1. Однак це вимагає ввімкнення sysctl ядра (route_localnet), який у деяких кластерах може мати небезпечні побічні ефекти. NodePort на localhost для IPTables можна вимкнути, передавши kube-proxy --iptables-localhost-nodeports false або встановивши для --nodeport-addresses діапазон, який не містить 127.0.0.1.
Під час використання режиму ipvs або режиму iptables в одностекових кластерах IPv6 Services NodePort недоступні на localhost.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the KubeProxyNFTablesLocalhostNodePorts feature gate for all relevant components in your cluster.
Під час використання режиму nftables Services NodePort будуть доступні на localhost, коли ввімкнено функціональну можливість KubeProxyNFTablesLocalhostNodePorts, а --nodeport-addresses має значення, яке явно містить localhost. (Значення лише allне ввімкне Services NodePort на localhost.) Це реалізовано перенаправленням зʼєднань NodePort на localhost через проксі в просторі користувача, тому це не так ефективно, як звичайне проксіювання сервісів.
Сторонні мережеві втулки, які мають власні реалізації проксі сервісів, можуть підтримувати NodePort на localhost, а можуть і не підтримувати; зверніться до документації цих втулків.
type: LoadBalancer
У хмарних провайдерів, які підтримують зовнішні балансувальники навантаження, встановлення поля type у LoadBalancer створює балансувальник навантаження для вашого Service. Фактичне створення балансувальника навантаження відбувається асинхронно, а інформація про створений балансувальник публікується в полі .status.loadBalancer Service. Наприклад:
Трафік від зовнішнього балансувальника навантаження спрямовується на бекенд-Podʼи. Хмарний провайдер вирішує, як він балансується.
Щоб реалізувати Service з type: LoadBalancer, Kubernetes зазвичай починає зі змін, еквівалентних вашому запиту на Service з type: NodePort. Потім компонент cloud-controller-manager налаштовує зовнішній балансувальник навантаження на пересилання трафіку на цей призначений порт вузла.
Ви можете налаштувати Service із балансуванням навантаження так, щоб не призначати порт вузла, якщо реалізація хмарного провайдера це підтримує.
Деякі хмарні провайдери дозволяють вказати loadBalancerIP. У таких випадках балансувальник навантаження створюється із вказаною користувачем loadBalancerIP. Якщо поле loadBalancerIP не вказано, балансувальник навантаження налаштовується з ефемерною IP-адресою. Якщо ви вказали loadBalancerIP, але ваш хмарний провайдер не підтримує цю можливість, вказане вами поле loadbalancerIP ігнорується.
Примітка:
Поле .spec.loadBalancerIP для Service визнано застарілим у Kubernetes v1.24.
Це поле було недостатньо визначене, і його значення відрізняється в різних реалізаціях. Воно також не підтримує мережі з подвійним стеком. Це поле може бути вилучено в майбутній версії API.
Якщо ви інтегруєтеся з провайдером, який підтримує вказання IP-адрес балансувальника навантаження для Service через анотацію (специфічну для провайдера), вам слід перейти на цей спосіб.
Якщо ви пишете код для інтеграції балансувальника навантаження з Kubernetes, уникайте використання цього поля. Ви можете інтегруватися з Gateway замість Service або визначити власні анотації (специфічні для провайдера) на Service, які задають еквівалентні дані.
Вплив життєздатності вузла на трафік балансувальника навантаження
Перевірки справності балансувальника навантаження є критично важливими для сучасних застосунків. Вони використовуються для визначення того, на який сервер (віртуальну машину або IP-адресу) балансувальник навантаження має спрямовувати трафік. API Kubernetes не визначають, як мають бути реалізовані перевірки справності для балансувальників навантаження, керованих Kubernetes; поведінку визначають хмарні провайдери (і ті, хто пише код інтеграції). Перевірки справності балансувальника навантаження широко використовуються для підтримки поля externalTrafficPolicy у Services.
Балансувальники навантаження зі змішаними типами протоколів
This is a stable feature in Kubernetes, and has been since the 1.26 release. You can no longer toggle this feature (the associated feature gate has been removed).
Стандартно для Services типу LoadBalancer, коли визначено більше одного порту, усі порти повинні мати той самий протокол, і цей протокол має підтримуватися хмарним провайдером.
Функціональна можливість MixedProtocolLBService (стандартно ввімкнена для kube-apiserver починаючи з v1.24) дозволяє використовувати різні протоколи для Services типу LoadBalancer, коли визначено більше одного порту.
Примітка:
Набір протоколів, які можна використовувати для Services із балансуванням навантаження, визначає ваш хмарний провайдер; він може накладати обмеження понад ті, що застосовує API Kubernetes.
Вимкнення виділення NodePort для балансувальника навантаження
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
За бажанням ви можете вимкнути виділення портів вузла для Service з type: LoadBalancer, встановивши поле spec.allocateLoadBalancerNodePorts у false. Це слід використовувати лише для реалізацій балансувальників навантаження, які спрямовують трафік безпосередньо до Podʼів, а не через порти вузла. Стандартно spec.allocateLoadBalancerNodePorts має значення true, і Services типу LoadBalancer продовжуватимуть виділяти порти вузла. Якщо встановити spec.allocateLoadBalancerNodePorts у false для наявного Service з виділеними портами вузла, ці порти вузла не будуть звільнені автоматично. Щоб звільнити ці порти вузла, ви повинні явно вилучити запис nodePorts у кожному порту Service.
Вказання класу реалізації балансувальника навантаження
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Для Service із type, встановленим у LoadBalancer, поле .spec.loadBalancerClass дозволяє використовувати реалізацію балансувальника навантаження, відмінну від стандартної реалізації хмарного провайдера.
Стандартно .spec.loadBalancerClass не встановлено, і Service типу LoadBalancer використовує стандартну реалізацію балансувальника навантаження хмарного провайдера, якщо кластер налаштовано з хмарним провайдером за допомогою прапорця компонента --cloud-provider.
Якщо ви вказуєте .spec.loadBalancerClass, вважається, що за Services стежить реалізація балансувальника навантаження, яка відповідає вказаному класу. Будь-яка стандартна реалізація балансувальника навантаження (наприклад, та, яку надає хмарний провайдер) ігноруватиме Services, у яких встановлено це поле. spec.loadBalancerClass можна встановити лише для Service типу LoadBalancer. Після встановлення його не можна змінити. Значення spec.loadBalancerClass має бути ідентифікатором у стилі мітки з необовʼязковим префіксом, наприклад, "internal-vip" або "example.com/internal-vip". Назви без префікса зарезервовані для кінцевих користувачів.
Режим IP-адреси балансувальника навантаження
Для Service з type: LoadBalancer контролер може встановити .status.loadBalancer.ingress.ipMode. .status.loadBalancer.ingress.ipMode вказує, як поводиться IP-адреса балансувальника навантаження. Його можна вказати лише тоді, коли вказано також поле .status.loadBalancer.ingress.ip.
Є два можливі значення для .status.loadBalancer.ingress.ipMode: "VIP" та "Proxy". Стандартне значення — "VIP", що означає, що трафік доставляється на вузол із призначенням, встановленим на IP-адресу та порт балансувальника навантаження. Є два випадки, коли встановлюється значення "Proxy", залежно від того, як балансувальник навантаження хмарного провайдера доставляє трафік:
Якщо трафік доставляється на вузол, а потім через DNAT до Podʼа, призначенням буде IP-адреса вузла та порт вузла;
Якщо трафік доставляється безпосередньо до Podʼа, призначенням буде IP-адреса та порт Podʼа.
Реалізації Service можуть використовувати цю інформацію для коригування маршрутизації трафіку.
Внутрішній балансувальник навантаження
У змішаному середовищі іноді необхідно маршрутизувати трафік від Services всередині того самого (віртуального) блоку мережевих адрес.
У середовищі DNS із розділеним горизонтом вам знадобляться два Services, щоб маршрутизувати і зовнішній, і внутрішній трафік до ваших точок доступу.
Щоб налаштувати внутрішній балансувальник навантаження, додайте до свого Service одну з наведених нижче анотацій залежно від хмарного провайдера, який ви використовуєте:
Services типу ExternalName зіставляють Service з DNS-іменем, а не зі звичайним селектором, таким як my-service або cassandra. Ви вказуєте такі Services за допомогою параметра spec.externalName.
Наприклад, це визначення Service зіставляє Service my-service у просторі імен prod з my.database.example.com:
Service з type: ExternalName приймає рядок з адресою IPv4, але трактує цей рядок як DNS-імʼя, що складається з цифр, а не як IP-адресу (однак інтернет не дозволяє таких імен у DNS). DNS-сервери не розвʼязують Services із зовнішніми іменами, схожими на адреси IPv4.
Якщо ви хочете зіставити Service безпосередньо з певною IP-адресою, розгляньте можливість використання headless Services.
Під час пошуку хоста my-service.prod.svc.cluster.local DNS Service кластера повертає запис CNAME зі значенням my.database.example.com. Доступ до my-service працює так само, як і для інших Services, але з важливою відмінністю: перенаправлення відбувається на рівні DNS, а не через проксіювання чи пересилання. Якщо пізніше ви вирішите перенести базу даних у кластер, ви зможете запустити її Podʼи, додати відповідні селектори чи точки доступу та змінити type цього Service.
Увага:
Під час використання ExternalName з деякими поширеними протоколами, зокрема HTTP та HTTPS, можуть виникати проблеми. Якщо ви використовуєте ExternalName, імʼя хоста, яке використовують клієнти всередині вашого кластера, відрізняється від імені, на яке посилається ExternalName.
Для протоколів, які використовують імена хостів, ця різниця може призвести до помилок або неочікуваних відповідей. HTTP-запити матимуть заголовок Host:, який вихідний сервер не розпізнає; сервери TLS не зможуть надати сертифікат, що відповідає імені хоста, до якого підʼєднався клієнт.
Headless Services
Іноді вам не потрібні балансування навантаження та одна IP-адреса Service. У цьому випадку ви можете створити так звані headless Services, явно вказавши "None" для кластерної IP-адреси (.spec.clusterIP).
Ви можете використовувати headless Service для взаємодії з іншими механізмами виявлення сервісів, не привʼязуючись до реалізації Kubernetes.
Для headless Services кластерна IP-адреса не виділяється, kube-proxy не обробляє ці Services, а платформа не виконує для них балансування навантаження чи проксіювання.
Headless Service дозволяє клієнту підʼєднуватися безпосередньо до будь-якого Podʼа, якому він віддає перевагу. Services, що є headless, не налаштовують маршрути та пересилання пакетів за допомогою віртуальних IP-адрес і проксі; натомість headless Services повідомляють IP-адреси точок доступу окремих Podʼів через внутрішні записи DNS, які обслуговує DNS-сервіс кластера. Щоб визначити headless Service, ви створюєте Service із .spec.type, встановленим у ClusterIP (що також є стандартним значенням type), і додатково встановлюєте .spec.clusterIP у None.
Рядкове значення None є особливим випадком і не тотожне тому, що поле .spec.clusterIP не встановлено.
Те, як автоматично налаштовується DNS, залежить від того, чи визначено для Service селектори:
З селекторами
Для headless Services, які визначають селектори, контролер точок доступу створює EndpointSlices в API Kubernetes і змінює конфігурацію DNS так, щоб повертати записи A або AAAA (адреси IPv4 або IPv6), які вказують безпосередньо на Podʼи, що стоять за Service.
Без селекторів
Для headless Services, які не визначають селектори, панель управління не створює обʼєкти EndpointSlice. Однак система DNS шукає та налаштовує одне з такого:
DNS-записи A / AAAA для всіх IP-адрес готових точок доступу Service, для всіх типів Service, крім ExternalName.
Для точок доступу IPv4 система DNS створює записи A.
Для точок доступу IPv6 система DNS створює записи AAAA.
Коли ви визначаєте headless Service без селектора, port має збігатися з targetPort.
Виявлення сервісів
Для клієнтів, що працюють всередині вашого кластера, Kubernetes підтримує два основні способи виявлення Service: змінні середовища та DNS.
Змінні середовища
Коли Pod запускається на вузлі, kubelet додає набір змінних середовища для кожного активного Service. Він додає змінні {SVCNAME}_SERVICE_HOST та {SVCNAME}_SERVICE_PORT, де назва Service записується у верхньому регістрі, а дефіси перетворюються на підкреслення.
Наприклад, Service redis-primary, який відкриває TCP-порт 6379 і якому виділено кластерну IP-адресу 10.0.0.11, створює такі змінні середовища:
Коли у вас є Pod, якому потрібен доступ до Service, і ви використовуєте метод змінних середовища для публікації порту та кластерного IP для клієнтських Podʼів, ви повинні створити Service до появи клієнтських Podʼів. Інакше змінні середовища цих клієнтських Podʼів не будуть заповнені.
Якщо ви використовуєте лише DNS для виявлення кластерного IP для Service, вам не потрібно турбуватися про цю проблему порядку.
Kubernetes також підтримує та надає змінні, сумісні з можливістю Docker Engine "legacy container links". Ви можете переглянути makeLinkVariables, щоб побачити, як це реалізовано в Kubernetes.
DNS
Ви можете (і майже завжди повинні) налаштувати DNS-сервіс для свого кластера Kubernetes за допомогою надбудови.
DNS-сервер, обізнаний із кластером, такий як CoreDNS, стежить за появою нових Services в API Kubernetes і створює набір записів DNS для кожного з них. Якщо DNS увімкнено в усьому кластері, всі Podʼи повинні автоматично мати змогу розвʼязувати Services за їхніми DNS-іменами.
Наприклад, якщо у вас є Service з назвою my-service у просторі імен Kubernetes my-ns, панель управління та DNS Service разом створюють запис DNS для my-service.my-ns. Podʼи у просторі імен my-ns повинні мати змогу знайти цей Service, виконавши пошук за іменем my-service (my-service.my-ns також працюватиме).
Podʼи в інших просторах імен повинні вказувати імʼя як my-service.my-ns. Ці імена розвʼязуватимуться в кластерний IP, призначений для Service.
Kubernetes також підтримує записи DNS SRV (Service) для іменованих портів. Якщо Service my-service.my-ns має порт з назвою http із протоколом TCP, ви можете виконати запит DNS SRV для _http._tcp.my-service.my-ns, щоб дізнатися номер порту для http, а також IP-адресу.
DNS-сервер Kubernetes — єдиний спосіб доступу до Services ExternalName. Докладніше про розвʼязання ExternalName читайте в DNS для Services та Podʼів.
Механізм віртуальних IP-адрес
Прочитайте Віртуальні IP та проксі для Service, де пояснено механізм, який Kubernetes надає, щоб відкрити доступ до Service на віртуальній IP-адресі.
Політики трафіку
Ви можете встановити поля .spec.internalTrafficPolicy та .spec.externalTrafficPolicy, щоб контролювати, як Kubernetes маршрутизує трафік до справних («готових») бекендів.
Поле .spec.trafficDistribution надає ще один спосіб впливати на маршрутизацію трафіку в межах Service Kubernetes. Якщо політики трафіку зосереджені на суворих семантичних гарантіях, то розподіл трафіку дозволяє виражати уподобання (наприклад, маршрутизацію до топологічно ближчих точок доступу). Це може допомогти оптимізувати продуктивність, вартість або надійність. У Kubernetes 1.37 підтримуються такі значення:
PreferSameZone
Вказує на перевагу маршрутизації трафіку до точок доступу, які перебувають у тій самій зоні, що й клієнт.
PreferSameNode
Вказує на перевагу маршрутизації трафіку до точок доступу, які перебувають на тому самому вузлі, що й клієнт.
PreferClose (застаріло)
Це старіший псевдонім для PreferSameZone, менш зрозумілий щодо семантики.
Якщо поле не встановлено, реалізація застосує свою стандартну стратегію маршрутизації.
Якщо ви хочете, щоб зʼєднання від певного клієнта щоразу передавалися до того самого Podʼа, ви можете налаштувати спорідненість сесії на основі IP-адреси клієнта. Докладніше читайте в розділі спорідненість сесії.
Зовнішні IP-адреси
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.36
Усі користувачі мають розпочати перехід від externalIPs. Натомість розгляньте можливість використання контролера зовнішнього балансувальника навантаження або реалізації Gateway API.
Якщо є зовнішні IP-адреси, які маршрутизуються до одного чи кількох вузлів кластера, до Services Kubernetes можна відкрити доступ на цих externalIPs. Коли мережевий трафік надходить до кластера із зовнішньою IP-адресою (як IP-адресою призначення) та портом, що відповідають цьому Service, правила й маршрути, налаштовані Kubernetes, забезпечують маршрутизацію трафіку до однієї з точок доступу цього Service.
Під час визначення Service ви можете вказати externalIPs для будь-якого типу Service. У наведеному нижче прикладі клієнти можуть отримати доступ до Service з назвою "my-service" через TCP за адресою "198.51.100.32:80" (обчисленою з .spec.externalIPs[] та .spec.ports[].port).
Щоб Ingress працював у вашому кластері, у ньому має працювати контролер Ingress. Вам потрібно вибрати принаймні один контролер Ingress і переконатися, що його налаштовано у вашому кластері. На цій сторінці перелічено поширені контролери Ingress, які ви можете розгорнути.
Примітка:
Проєкт Kubernetes рекомендує використовувати Gateway замість Ingress. API Ingress заморожено.
Це означає, що:
API Ingress є загальнодоступним, і на нього поширюються гарантії стабільності для загальнодоступних API. Проєкт Kubernetes не планує вилучати Ingress із Kubernetes.
API Ingress більше не розробляється, і до нього не вноситимуть змін чи оновлень.
Контролери Ingress
Як проєкт, Kubernetes підтримує та супроводжує контролери Ingress AWS та GCE.
Контролери Ingress сторонніх розробників
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
ngrok-operator — це контролер для ngrok, який підтримує як Ingress, так і Gateway API для додавання безпечного публічного доступу до ваших Services K8s.
Контролер Ingress OCI Native — це контролер Ingress для Oracle Cloud Infrastructure, який дозволяє керувати OCI Load Balancer.
Контролер Ingress Pomerium — це контролер Ingress на основі Pomerium, який пропонує політику доступу з урахуванням контексту.
Skipper — HTTP-маршрутизатор і зворотний проксі для композиції сервісів, зокрема для таких випадків, як Kubernetes Ingress, спроєктований як бібліотека для створення власного проксі.
Tyk Operator розширює Ingress власними ресурсами, щоб додати до Ingress можливості керування API. Tyk Operator працює з Tyk Gateway з відкритим кодом і панеллю управління Tyk Cloud.
Контролер Ingress Wallarm — це контролер Ingress, який надає можливості WAAP (WAF) та захисту API.
Використання кількох контролерів Ingress
Ви можете розгортати будь-яку кількість контролерів Ingress, використовуючи клас Ingress у межах кластера. Зверніть увагу на значення .metadata.name вашого ресурсу класу Ingress. Під час створення Ingress ця назва знадобиться вам, щоб вказати поле ingressClassName в обʼєкті Ingress (див. довідник IngressSpec v1). ingressClassName є заміною застарілого методу анотації.
Якщо ви не вказуєте IngressClass для Ingress, а у вашому кластері рівно один IngressClass позначено як стандартний, Kubernetes застосовує до Ingress стандартний IngressClass кластера. Щоб позначити IngressClass як стандартний, встановіть для нього анотацію ingressclass.kubernetes.io/is-default-class зі строковим значенням "true".
В ідеалі всі контролери Ingress мають відповідати цій специфікації, але різні контролери Ingress працюють дещо по-різному.
Примітка:
Обовʼязково ознайомтеся з документацією вашого контролера Ingress, щоб зрозуміти особливості його вибору.
Gateway API — це сімейство видів API, які забезпечують динамічне надання інфраструктури та розширену маршрутизацію трафіку.
Зробіть мережеві сервіси доступними за допомогою розширюваного, орієнтованого на ролі механізму конфігурації з урахуванням протоколу. Gateway API — це надбудова, що містить види API, які забезпечують динамічне надання інфраструктури та розширену маршрутизацію трафіку.
Принципи дизайну
Наведені нижче принципи визначили дизайн та архітектуру Gateway API:
Орієнтований на ролі: Види Gateway API побудовано за організаційними ролями, відповідальними за керування мережевою взаємодією сервісів Kubernetes:
Провайдер інфраструктури: Керує інфраструктурою, яка дозволяє кільком ізольованим кластерам обслуговувати кількох орендарів, наприклад, хмарний провайдер.
Оператор кластера: Керує кластерами та зазвичай займається політиками, мережевим доступом, дозволами застосунків тощо.
Розробник застосунків: Керує застосунком, що працює в кластері, і зазвичай займається конфігурацією на рівні застосунку та композицією Service.
Переносний: Специфікації Gateway API визначено як власні ресурси, і їх підтримують багато реалізацій.
Виразний: Види Gateway API підтримують функціональність для поширених сценаріїв маршрутизації трафіку, як-от зіставлення за заголовками, розподіл трафіку за вагою та інші, які в Ingress були можливі лише за допомогою власних анотацій.
Розширюваний: Gateway дозволяє повʼязувати власні ресурси на різних рівнях API. Це робить можливим детальне налаштування у відповідних місцях структури API.
Модель ресурсів
Gateway API має чотири стабільні види API:
GatewayClass: Визначає набір шлюзів зі спільною конфігурацією, якими керує контролер, що реалізує цей клас.
Gateway: Визначає екземпляр інфраструктури обробки трафіку, наприклад, хмарний балансувальник навантаження.
HTTPRoute: Визначає специфічні для HTTP правила зіставлення трафіку від слухача (listener) Gateway із поданням мережевих точок доступу бекенду. Ці точки доступу часто подаються як Service.
GRPCRoute: Визначає специфічні для gRPC правила зіставлення трафіку від слухача (listener) Gateway із поданням мережевих точок доступу бекенду. Ці точки доступу часто подаються як Service.
Gateway API організовано у різні види API, повʼязані взаємозалежними відносинами, що відображає рольову природу організацій. Обʼєкт Gateway повʼязаний рівно з одним GatewayClass; GatewayClass описує контролер шлюзу, відповідальний за керування Gateways цього класу. Потім із Gateways повʼязуються один або кілька видів маршрутів, наприклад, HTTPRoute. Gateway може фільтрувати маршрути, які можна прикріпити до його listeners, утворюючи з маршрутами модель двосторонньої довіри.
Наведена нижче схема ілюструє звʼязки між трьома стабільними видами Gateway API:
graph LR;
subgraph cluster["Кластер"]
direction LR
HTTPRoute --> Gateway;
Gateway --> GatewayClass;
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class HTTPRoute,Gateway,GatewayClass k8s;
class cluster cluster;
GatewayClass
Gateways можуть бути реалізовані різними контролерами, часто з різними конфігураціями. Gateway має посилатися на GatewayClass, який містить назву контролера, що реалізує цей клас.
У цьому прикладі контролер, який реалізує Gateway API, налаштовано на керування GatewayClasses із назвою контролера example.com/gateway-controller. Gateways цього класу керуватиме контролер реалізації.
Повне визначення цього виду API дивіться в довіднику GatewayClass.
Gateway
Gateway описує екземпляр інфраструктури обробки трафіку. Він визначає мережеву точку доступу, яку можна використовувати для обробки трафіку, тобто фільтрування, балансування, розділення тощо, для таких бекендів, як Service. Наприклад, Gateway може представляти хмарний балансувальник навантаження або проксі-сервер у кластері, налаштований на приймання HTTP-трафіку.
У цьому прикладі екземпляр інфраструктури обробки трафіку запрограмовано на прослуховування HTTP-трафіку на порту 80. Оскільки поле addresses не вказано, адресу або імʼя хоста для Gateway призначає контролер реалізації. Ця адреса використовується як мережева точка доступу для обробки трафіку мережевих точок доступу бекенду, визначених у маршрутах.
Повне визначення цього виду API дивіться в довіднику Gateway. Вказівки щодо налаштування слухачів HTTPS/TLS дивіться в посібнику Gateway API з TLS.
Примітка:
Стандартно Gateway приймає маршрути лише з того самого простору імен. Для маршрутів з інших просторів імен потрібно налаштувати allowedRoutes.
HTTPRoute
Вид HTTPRoute визначає поведінку маршрутизації HTTP-запитів від слухача Gateway до мережевих точок доступу бекенду. Для бекенду Service реалізація може подавати мережеву точку доступу бекенду як IP-адресу Service або як EndpointSlices, що стоять за цим Service. HTTPRoute подає конфігурацію, яка застосовується до базової реалізації Gateway. Наприклад, визначення нового HTTPRoute може призвести до налаштування додаткових маршрутів трафіку в хмарному балансувальнику навантаження або проксі-сервері в кластері.
У цьому прикладі HTTP-трафік від Gateway example-gateway із заголовком Host: зі значенням www.example.com і шляхом запиту /login буде спрямовано до Service example-svc на порт 8080.
Повне визначення цього виду API дивіться в довіднику HTTPRoute.
GRPCRoute
Вид GRPCRoute визначає поведінку маршрутизації запитів gRPC від слухача Gateway до мережевих точок доступу бекенду. Для бекенду Service реалізація може подавати мережеву точку доступу бекенду як IP-адресу Service або як EndpointSlices, що стоять за цим Service. GRPCRoute подає конфігурацію, яка застосовується до базової реалізації Gateway. Наприклад, визначення нового GRPCRoute може призвести до налаштування додаткових маршрутів трафіку в хмарному балансувальнику навантаження або проксі-сервері в кластері.
Gateways, що підтримують GRPCRoute, повинні підтримувати HTTP/2 без початкового оновлення з HTTP/1, тому трафік gRPC гарантовано проходить належним чином.
У цьому прикладі трафік gRPC від Gateway example-gateway із хостом svc.example.com буде спрямовано до Service example-svc на порт 50051 з того самого простору імен.
GRPCRoute дозволяє зіставляти конкретні сервіси gRPC, як показано в наведеному нижче прикладі:
У цьому випадку GRPCRoute зіставлятиме будь-який трафік для svc.example.com і застосовуватиме свої правила маршрутизації, щоб переспрямувати трафік до правильного бекенду. Оскільки вказано лише одне зіставлення, переспрямовуватимуться тільки запити до методу com.example.User.Login на svc.example.com. RPC будь-якого іншого методу цей маршрут не зіставлятиме.
Повне визначення цього виду API дивіться в довіднику GRPCRoute.
Потік запитів
Ось простий приклад маршрутизації HTTP-трафіку до Service за допомогою Gateway та HTTPRoute:
У цьому прикладі потік запиту для Gateway, реалізованого як зворотний проксі, такий:
Клієнт починає готувати HTTP-запит для URL http://www.example.com
DNS-резолвер клієнта запитує імʼя призначення та дізнається про його відповідність одній або кільком IP-адресам, повʼязаним із Gateway.
Клієнт надсилає запит на IP-адресу Gateway; зворотний проксі отримує HTTP-запит і використовує заголовок Host:, щоб зіставити його з конфігурацією, отриманою з Gateway і прикріпленого HTTPRoute.
За потреби зворотний проксі може виконати зіставлення заголовків запиту та/або шляху на основі правил зіставлення HTTPRoute.
За потреби зворотний проксі може змінити запит, наприклад, додати або вилучити заголовки, на основі правил фільтрації HTTPRoute.
Насамкінець зворотний проксі пересилає запит до одного або кількох бекендів.
Відповідність
Gateway API охоплює широкий набір можливостей і має багато реалізацій. Таке поєднання вимагає чітких визначень відповідності та тестів, щоб API забезпечував узгоджений досвід, де б він не використовувався.
Дивіться документацію щодо відповідності, щоб дізнатися про такі деталі, як канали випусків, рівні підтримки та запуск тестів на відповідність.
Міграція з Ingress
Gateway API є наступником API Ingress. Однак він не містить виду Ingress. Тому потрібне одноразове перетворення наявних ресурсів Ingress на ресурси Gateway API.
Ресурси Gateway API не реалізовані в Kubernetes нативно: специфікації визначено як власні ресурси, що підтримуються широким спектром реалізацій.
Встановіть CRD Gateway API або виконайте інструкції зі встановлення обраної реалізації. Після встановлення реалізації скористайтеся посібником Початок роботи, щоб швидко почати роботу з Gateway API.
Примітка:
Обовʼязково ознайомтеся з документацією обраної вами реалізації, щоб розуміти можливі застереження.
Додаткові відомості про всі види Gateway API дивіться в специфікації API.
6.5.4 - EndpointSlices
API EndpointSlice — це механізм, який Kubernetes використовує, щоб ваш Service масштабувався для обробки великої кількості бекендів і дозволяє кластеру ефективно оновлювати свій список справних бекендів.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
EndpointSlices відстежують IP-адреси точок доступу бекенду. EndpointSlices зазвичай повʼязані з Service, а точки доступу бекенду зазвичай представляють Podʼи.
EndpointSlice API
У Kubernetes, EndpointSlice містить посилання на набір мережевих точок доступу. Панель управління автоматично створює EndpointSlices для будь-якого Service Kubernetes, який має вказаний селектор. Ці EndpointSlices містять посилання на всі Podʼи, які відповідають селектору Service. EndpointSlices групують мережеві точки доступу за унікальними комбінаціями сімейства IP, протоколу, номера порту та імені Service. Імʼя обʼєкта EndpointSlice повинно бути дійсним імʼям піддомену DNS.
Наприклад, ось приклад обʼєкта EndpointSlice, яким володіє Service Kubernetes з імʼям example.
Типово, панель управління створює та керує EndpointSlices так, щоб в кожному з них було не більше 100 мережевих точок доступу. Це можна налаштувати за допомогою прапорця --max-endpoints-per-slicekube-controller-manager, до максимуму 1000.
EndpointSlices виступають джерелом правди для kube-proxy щодо того, як маршрутизувати внутрішній трафік.
Типи адрес
EndpointSlices підтримують два типи адрес:
IPv4
IPv6
Кожен обʼєкт EndpointSlice представляє конкретний тип IP-адреси. Якщо у вас
є Service, який доступний через IPv4 та IPv6, буде принаймні два обʼєкти EndpointSlice (один для IPv4 та один для IPv6).
Стани
API EndpointSlice зберігає стани точок доступу, які можуть бути корисні для споживачів. Три стани: serving, terminating та ready.
Serving
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Стан serving вказує на те, що точка доступу наразі обслуговує відповіді, і тому вона повинна використовуватися як призначення для трафіку Service. Для точок доступу, що підтримуються Podʼом, це відповідає стану Podʼа Ready.
Terminating
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Стан terminating вказує на те, що точка доступу завершує свою роботу. Для точок доступу, які підтримуються Podʼом, цей стан встановлюється, коли Pod вперше видаляється (тобто, коли він отримує мітку часу видалення, але, швидше за все, до того, як контейнери Podʼа завершать свою роботу).
Сервісні проксі зазвичай ігнорують точки доступу, які є в стані terminating, але вони можуть перенаправляти трафік на точки доступу, які є одночасно serving та terminating, якщо всі доступні точки доступу є в стані terminating. (Це допомагає гарантувати, що трафік Service не буде втрачено під час поступових оновлень відповідних Podʼів.)
Ready
Стан ready — це по суті скорочення для перевірки "serving та не terminating" (хоча він також завжди матиме значення true для Service, у яких spec.publishNotReadyAddresses встановлено в true).
Інформація про топологію
Кожна точка доступу в межах EndpointSlice може містити відповідну інформацію про топологію. Інформація про топологію включає місцезнаходження точки доступу та інформацію про відповідний вузол та зону. Ця інформація доступна в таких полях кожної точки доступу в EndpointSlices:
nodeName — імʼя вузла, на якому знаходиться ця точка доступу.
zone — зона, в якій знаходиться ця точка доступу.
Управління
Здебільшого обʼєкти EndpointSlice створює панель управління і вона ж ними керує (а саме контролер EndpointSlice). Є різноманітні інші випадки використання EndpointSlices, як-от реалізації service mesh, через які додатковими наборами EndpointSlices можуть керувати інші сутності або контролери.
Щоб забезпечити можливість кількох сутностей керувати EndpointSlices, не заважаючи одна одній, Kubernetes визначає міткуendpointslice.kubernetes.io/managed-by, яка вказує на сутність, що керує EndpointSlice. Контролер EndpointSlice встановлює значення endpointslice-controller.k8s.io для цієї мітки на всіх EndpointSlices, якими він керує. Інші сутності, які керують EndpointSlices, також повинні встановити унікальне значення для цієї мітки.
Власність
У більшості випадків EndpointSlices належать Service, точки доступу якого відстежує обʼєкт EndpointSlice. На володіння вказує посилання на власника в кожному EndpointSlice, а також мітка kubernetes.io/service-name, що спрощує пошук усіх EndpointSlices, які належать Service.
Розподіл EndpointSlices
Кожен EndpointSlice має набір портів, які застосовуються до всіх точок доступу ресурсу. При використанні іменованих портів для Service, Podʼи можуть мати різні номери цільового порту для того самого іменованого порту, що вимагає різних EndpointSlices.
Панель управління намагається заповнити EndpointSlices так повно, як це можливо, але не активно перерозподіляє їх. Логіка досить проста:
Перебрати наявні EndpointSlices, вилучити точки доступу, які вже не потрібні, і оновити відповідні точки, які змінилися.
Перебрати EndpointSlices, які були змінені на першому етапі, і заповнити їх новими точками доступу, які потрібно додати.
Якщо ще залишилися нові точки доступу для додавання, спробувати додати їх у раніше не змінений EndpointSlice та/або створити нові.
Важливо, що третій крок надає пріоритет обмеженню оновлень EndpointSlice над ідеально повним розподілом EndpointSlices. Наприклад, якщо є 10 нових точок доступу для додавання та 2 EndpointSlices з простором для ще 5 точок доступу кожна, цей підхід створить новий EndpointSlice замість заповнення 2 наявних EndpointSlices. Іншими словами, одне створення EndpointSlice краще, ніж кілька оновлень EndpointSlice.
З kube-proxy, який працює на кожному вузлі та слідкує за EndpointSlices, кожна зміна EndpointSlice стає відносно дорогою, оскільки вона буде передана кожному вузлу в кластері. Цей підхід призначений для обмеження кількості змін, які потрібно надіслати кожному вузлу, навіть якщо це може призвести до декількох EndpointSlices, які не є повністю заповненими.
На практиці такий не зовсім ідеальний розподіл має траплятися рідко. Більшість змін, які опрацьовує контролер EndpointSlice, будуть достатньо малими, щоб поміститися в наявний EndpointSlice, а якщо ні, новий EndpointSlice, імовірно, однаково невдовзі знадобиться. Поступові оновлення Deploymentʼів також забезпечують природне перепакування EndpointSlices, оскільки всі Podʼи та відповідні їм точки доступу замінюються.
Дублікати точок доступу
Через характер змін EndpointSlice точки доступу можуть бути представлені в більш ніж одному EndpointSlice одночасно. Це, природно, відбувається, оскільки зміни до різних обʼєктів EndpointSlice можуть надходити до watch / кешу клієнта Kubernetes у різний час.
Примітка:
Клієнти API EndpointSlice повинні переглянути всі наявні EndpointSlices, повʼязані з Service, та побудувати повний список унікальних мережевих точок доступу. Важливо зазначити, що мережеві точки доступу можуть бути дубльовані в різних EndpointSlices.
Еталонну реалізацію того, як виконати це агрегування точок доступу та вилучення дублікатів, можна знайти в коді EndpointSliceCache у kube-proxy.
Віддзеркалення EndpointSlice
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.33
API EndpointSlice є заміною старого API Endpoints. Щоб зберегти сумісність зі старими контролерами та робочими навантаженнями користувачів, які очікують від kube-proxy маршрутизації трафіку на основі ресурсів Endpoints, панель управління кластера віддзеркалює більшість створених користувачем ресурсів Endpoints до відповідних EndpointSlices.
(Втім, ця функція, як і решта API Endpoints, є застарілою. Користувачі, які вручну вказують точки доступу для Service без селектора, повинні робити це, створюючи ресурси EndpointSlice безпосередньо, а не створювати ресурси Endpoints і дозволяти їхнє віддзеркалення).
Панель управління віддзеркалює ресурси Endpoints, крім випадків, коли:
ресурс Endpoints має мітку endpointslice.kubernetes.io/skip-mirror, встановлену у значення true.
ресурс Endpoints має анотацію control-plane.alpha.kubernetes.io/leader.
відповідний ресурс Service не існує.
відповідний ресурс Service має селектор, відмінний від nil.
Окремі ресурси Endpoints можуть транслюватися у декілька EndpointSlices. Це станеться, якщо ресурс Endpoints має декілька підмножин або включає точки доступу з декількома сімействами IP-адрес (IPv4 і IPv6). Максимум 1000 адрес на підмножину буде віддзеркалено в EndpointSlices.
Якщо ви хочете контролювати потік трафіку на рівні IP-адреси чи порту (рівень 3 або 4 моделі OSI), NetworkPolicies дозволяють визначати правила потоку трафіку всередині вашого кластера, а також між Podʼами та зовнішнім світом. Ваш кластер повинен використовувати мережевий втулок, який підтримує застосування NetworkPolicy.
Якщо ви хочете контролювати потік трафіку на рівні IP-адреси чи порту для протоколів TCP, UDP та SCTP, вам варто розглянути використання NetworkPolicies Kubernetes для окремих застосунків у вашому кластері. NetworkPolicies — це конструкція, орієнтована на застосунки, яка дозволяє визначити, як Pod може взаємодіяти через мережу з різними мережевими «сутностями» (ми вживаємо тут слово «сутність», щоб не перевантажувати поширеніші терміни, як-от «точки доступу» та «Services», які мають у Kubernetes особливі значення). NetworkPolicies застосовуються до зʼєднання, на одному або обох кінцях якого є Pod, і не стосуються інших зʼєднань.
Сутності, з якими може взаємодіяти Pod, визначаються за допомогою комбінації таких трьох ідентифікаторів:
Інші дозволені Podʼи (виняток: Pod не може заблокувати доступ до самого себе)
Дозволені простори імен
IP-блоки (виняток: трафік до вузла і від вузла, де працює Pod, завжди дозволений, незалежно від IP-адреси Podʼа чи вузла)
Під час визначення NetworkPolicy на основі Podʼів або просторів імен ви використовуєте селектор, щоб вказати, який трафік дозволений до Podʼів і від Podʼів, що відповідають цьому селектору.
Натомість під час створення NetworkPolicies на основі IP ми визначаємо політики на основі IP-блоків (діапазонів CIDR).
Передумови
Мережеві політики реалізуються мережевим втулком. Щоб використовувати мережеві політики, вам потрібне мережеве рішення, яке підтримує NetworkPolicy. Створення ресурсу NetworkPolicy без контролера, який його реалізує, не матиме ефекту.
Два види ізоляції Podʼів
Існує два види ізоляції для Podʼа: ізоляція для вихідного трафіку (egress) та ізоляція для вхідного трафіку (ingress). Вони стосуються того, які зʼєднання можуть бути встановлені. «Ізоляція» тут не є абсолютною, а означає «застосовуються певні обмеження». Альтернатива, «неізольований для $direction», означає, що в зазначеному напрямку обмежень немає. Обидва види ізоляції (або її відсутності) оголошуються незалежно, і обидва мають значення для зʼєднання від одного Podʼа до іншого.
Стандартно Pod не є ізольованим для вихідного трафіку: усі вихідні зʼєднання дозволені. Pod є ізольованим для вихідного трафіку, якщо існує будь-яка NetworkPolicy, яка одночасно вибирає цей Pod і має "Egress" у своєму policyTypes; ми кажемо, що така політика застосовується до Podʼа для вихідного трафіку. Коли Pod ізольований для вихідного трафіку, єдині дозволені зʼєднання з Podʼа — це ті, що дозволені списком egress якоїсь NetworkPolicy, яка застосовується до Podʼа для вихідного трафіку. Трафік відповідей для цих дозволених зʼєднань також буде неявно дозволений. Дія цих списків egress обʼєднується адитивно.
Стандартно Pod не є ізольованим для вхідного трафіку: усі вхідні зʼєднання дозволені. Pod є ізольованим для вхідного трафіку, якщо існує будь-яка NetworkPolicy, яка одночасно вибирає цей Pod і має "Ingress" у своєму policyTypes; ми кажемо, що така політика застосовується до Podʼа для вхідного трафіку. Коли Pod ізольований для вхідного трафіку, єдині дозволені зʼєднання до Podʼа — це зʼєднання з вузла Podʼа та ті, що дозволені списком ingress якоїсь NetworkPolicy, яка застосовується до Podʼа для вхідного трафіку. Трафік відповідей для цих дозволених зʼєднань також буде неявно дозволений. Дія цих списків ingress обʼєднується адитивно.
Мережеві політики не конфліктують, вони адитивні. Якщо одна чи кілька політик застосовуються до певного Podʼа в певному напрямку, то дозволені в цьому напрямку зʼєднання цього Podʼа — це обʼєднання того, що дозволяють застосовні політики. Тому порядок обчислення не впливає на результат політики.
Щоб зʼєднання від Podʼа-джерела до Podʼа-призначення було дозволене, його мають дозволяти і політика вихідного трафіку на Podʼі-джерелі, і політика вхідного трафіку на Podʼі-призначенні. Якщо хоча б одна сторона не дозволяє зʼєднання, воно не відбудеться.
Ресурс NetworkPolicy
Повне визначення ресурсу дивіться в довіднику NetworkPolicy.
Надсилання цього маніфесту (POST) до API-сервера вашого кластера не матиме жодного ефекту, якщо обране вами мережеве рішення не підтримує мережеві політики.
spec: Специфікація NetworkPolicy містить усю інформацію, необхідну для визначення конкретної мережевої політики в заданому просторі імен.
podSelector: Кожна NetworkPolicy містить podSelector, який вибирає групу Podʼів, до яких застосовується політика. Політика з прикладу вибирає Podʼи з міткою "role=db". Порожній podSelector вибирає всі Podʼи в просторі імен.
policyTypes: Кожна NetworkPolicy містить список policyTypes, який може включати Ingress, Egress або обидва значення. Поле policyTypes вказує, чи застосовується ця політика до вхідного трафіку до вибраних Podʼів, до вихідного трафіку від вибраних Podʼів чи до обох. Якщо в NetworkPolicy не вказано жодного policyTypes, то стандартно завжди буде встановлено Ingress, а Egress буде встановлено, якщо NetworkPolicy має хоча б одне правило вихідного трафіку.
ingress: Кожна NetworkPolicy може містити список дозволених правил ingress. Кожне правило дозволяє трафік, який відповідає обом секціям: from і ports. Політика з прикладу містить одне правило, яке відповідає трафіку на одному порту від одного з трьох джерел: перше вказано через ipBlock, друге через namespaceSelector, а третє через podSelector.
egress: Кожна NetworkPolicy може містити список дозволених правил egress. Кожне правило дозволяє трафік, який відповідає обом секціям: to і ports. Політика з прикладу містить одне правило, яке відповідає трафіку на одному порту до будь-якого призначення в 10.0.0.0/24.
Отже, NetworkPolicy з прикладу:
ізолює Podʼи role=db у просторі імен default як для вхідного, так і для вихідного трафіку (якщо вони ще не були ізольовані)
(правила Ingress) дозволяє зʼєднання до всіх Podʼів у просторі імен default з міткою role=db на TCP-порт 6379 від:
будь-якого Podʼа в просторі імен default з міткою role=frontend
будь-якого Podʼа в просторі імен з міткою project=myproject
IP-адрес у діапазонах 172.17.0.0–172.17.0.255 та 172.17.2.0–172.17.255.255 (тобто всіх адрес 172.17.0.0/16, крім 172.17.1.0/24)
(правила Egress) дозволяє зʼєднання від будь-якого Podʼа в просторі імен default з міткою role=db до CIDR 10.0.0.0/24 на TCP-порт 5978
Існує чотири види селекторів, які можна вказати в секції from правила ingress або в секції to правила egress:
podSelector: Вибирає певні Podʼи в тому самому просторі імен, що й NetworkPolicy, які мають бути дозволені як джерела вхідного трафіку або призначення вихідного трафіку.
namespaceSelector: Вибирає певні простори імен, усі Podʼи яких мають бути дозволені як джерела вхідного трафіку або призначення вихідного трафіку.
namespaceSelectorтаpodSelector: Один запис to/from, який вказує і namespaceSelector, і podSelector, вибирає певні Podʼи в певних просторах імен. Будьте уважні й використовуйте правильний синтаксис YAML. Наприклад:
Ця політика містить один елемент from, який дозволяє зʼєднання від Podʼів з міткою role=client у просторах імен з міткою user=alice. Але наведена далі політика відрізняється:
Вона містить два елементи в масиві from і дозволяє зʼєднання від Podʼів у локальному просторі імен з міткою role=clientабо від будь-якого Podʼа в будь-якому просторі імен з міткою user=alice.
Якщо є сумніви, скористайтеся kubectl describe, щоб побачити, як Kubernetes інтерпретував політику.
ipBlock: Вибирає певні діапазони IP CIDR, дозволені як джерела вхідного трафіку або призначення вихідного трафіку. Це мають бути IP-адреси поза кластером, оскільки IP-адреси Podʼів є ефемерними та непередбачуваними.
Механізми вхідного та вихідного трафіку кластера часто вимагають переписування IP-адреси джерела або призначення пакетів. У таких випадках не визначено, чи відбувається це до обробки NetworkPolicy, чи після неї, і поведінка може відрізнятися для різних комбінацій мережевого втулка, хмарного провайдера, реалізації Service тощо.
Для вхідного трафіку це означає, що в одних випадках ви можете фільтрувати вхідні пакети за фактичною початковою IP-адресою джерела, а в інших «IP-адреса джерела», за якою працює NetworkPolicy, може бути IP-адресою LoadBalancer, вузла Podʼа тощо.
Для вихідного трафіку це означає, що на зʼєднання від Podʼів до IP-адрес Service, які переписуються на зовнішні для кластера IP-адреси, політики на основі ipBlock можуть поширюватися, а можуть і не поширюватися.
Стандартні політики
Стандартно, якщо в просторі імен немає жодної політики, весь вхідний і вихідний трафік до Podʼів і від Podʼів у цьому просторі імен дозволений. Наведені нижче приклади дозволяють змінити стандартну поведінку в цьому просторі імен.
Стандартна заборона всього вхідного трафіку
Ви можете створити «стандартну» політику ізоляції вхідного трафіку для простору імен, створивши NetworkPolicy, яка вибирає всі Podʼи, але не дозволяє жодного вхідного трафіку до цих Podʼів.
Це гарантує, що навіть Podʼи, не вибрані жодною іншою NetworkPolicy, залишатимуться ізольованими для вхідного трафіку. Ця політика не впливає на ізоляцію вихідного трафіку будь-якого Podʼа.
Дозвіл на весь вхідний трафік
Якщо ви хочете дозволити всі вхідні зʼєднання до всіх Podʼів у просторі імен, ви можете створити політику, яка явно це дозволяє.
За наявності цієї політики жодна додаткова політика чи політики не можуть призвести до відмови у вхідному зʼєднанні до цих Podʼів. Ця політика не впливає на ізоляцію вихідного трафіку будь-якого Podʼа.
Стандартна заборона всього вихідного трафіку
Ви можете створити «стандартну» політику ізоляції вихідного трафіку для простору імен, створивши NetworkPolicy, яка вибирає всі Podʼи, але не дозволяє жодного вихідного трафіку від цих Podʼів.
Це гарантує, що навіть Podʼам, не вибраним жодною іншою NetworkPolicy, не буде дозволено вихідний трафік. Ця політика не змінює поведінку ізоляції вхідного трафіку будь-якого Podʼа.
Увага:
Стандартна політика заборони всього вихідного трафіку також блокує DNS-трафік. Якщо вашим робочим навантаженням потрібне розвʼязання DNS-імен, ви повинні додати окрему NetworkPolicy, яка дозволяє вихідний трафік до DNS-сервісу вашого кластера.
Дозвіл на весь вихідний трафік
Якщо ви хочете дозволити всі зʼєднання від усіх Podʼів у просторі імен, ви можете створити політику, яка явно дозволяє всі вихідні зʼєднання від Podʼів у цьому просторі імен.
За наявності цієї політики жодна додаткова політика чи політики не можуть призвести до відмови у вихідному зʼєднанні від цих Podʼів. Ця політика не впливає на ізоляцію вхідного трафіку будь-якого Podʼа.
Стандартна заборона всього вхідного та всього вихідного трафіку
Ви можете створити «стандартну» політику для простору імен, яка забороняє весь вхідний І вихідний трафік, створивши в цьому просторі імен наведену нижче NetworkPolicy.
Це гарантує, що навіть Podʼам, не вибраним жодною іншою NetworkPolicy, не буде дозволено вхідний або вихідний трафік.
Фільтрація мережевого трафіку
NetworkPolicy визначена для зʼєднань рівня 4 (TCP, UDP та, за потреби, SCTP). Для всіх інших протоколів поведінка може відрізнятися залежно від мережевого втулка.
Примітка:
Ви повинні використовувати втулок CNI, який підтримує NetworkPolicies для протоколу SCTP.
Коли визначено мережеву політику deny all, гарантовано забороняються лише зʼєднання TCP, UDP та SCTP. Для інших протоколів, таких як ARP чи ICMP, поведінка не визначена. Те саме стосується дозвільних правил: коли певний Pod дозволений як джерело вхідного трафіку або призначення вихідного трафіку, не визначено, що відбувається (наприклад) з пакетами ICMP. Такі протоколи, як ICMP, можуть бути дозволені одними мережевими втулками та заборонені іншими.
Націлювання на діапазон портів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Під час написання NetworkPolicy ви можете націлитися на діапазон портів, а не на один порт.
Це можна зробити за допомогою поля endPort, як показано в наведеному нижче прикладі:
Наведене вище правило дозволяє будь-якому Podʼу з міткою role=db у просторі імен default взаємодіяти з будь-якою IP-адресою в діапазоні 10.0.0.0/24 через TCP за умови, що цільовий порт перебуває в діапазоні від 32000 до 32768.
Під час використання цього поля застосовуються такі обмеження:
Поле endPort має бути рівним полю port або більшим за нього.
endPort можна визначити, лише якщо також визначено port.
Обидва порти мають бути числовими.
Примітка:
Ваш кластер повинен використовувати втулок CNI, який підтримує поле endPort у специфікаціях NetworkPolicy. Якщо ваш мережевий втулок не підтримує поле endPort, а ви вкажете NetworkPolicy із цим полем, політика буде застосована лише для одного поля port.
Націлювання на кілька просторів імен за міткою
У цьому сценарії ваша NetworkPolicy типу Egress націлена на кілька просторів імен за назвами їхніх міток. Щоб це працювало, потрібно додати мітки до цільових просторів імен. Наприклад:
Неможливо безпосередньо вказати назви просторів імен у NetworkPolicy. Ви повинні використовувати namespaceSelector із matchLabels або matchExpressions, щоб вибрати простори імен за їхніми мітками.
Націлювання на простір імен за його назвою
Панель управління Kubernetes встановлює незмінну мітку kubernetes.io/metadata.name на всі простори імен, значенням мітки є назва простору імен.
Хоча NetworkPolicy не може націлитися на простір імен за його назвою через якесь поле обʼєкта, ви можете використати стандартизовану мітку, щоб націлитися на конкретний простір імен.
Життєвий цикл Podʼа
Примітка:
Наведене нижче стосується кластерів із сумісним мережевим втулком та сумісною реалізацією NetworkPolicy.
Коли створюється новий обʼєкт NetworkPolicy, мережевому втулку може знадобитися певний час, щоб обробити цей новий обʼєкт. Якщо Pod, на який впливає NetworkPolicy, створено до того, як мережевий втулок завершив обробку NetworkPolicy, цей Pod може бути запущений незахищеним, а правила ізоляції будуть застосовані, коли обробку NetworkPolicy буде завершено.
Щойно NetworkPolicy оброблено мережевим втулком,
Усі новостворені Podʼи, на які впливає певна NetworkPolicy, будуть ізольовані до їхнього запуску. Реалізації NetworkPolicy повинні гарантувати, що фільтрація діє протягом усього життєвого циклу Podʼа, починаючи з першої миті запуску будь-якого контейнера в цьому Podʼі. Оскільки NetworkPolicies застосовуються на рівні Podʼа, вони однаково застосовуються до init-контейнерів, sidecar-контейнерів і звичайних контейнерів.
Дозвільні правила будуть зрештою застосовані після правил ізоляції (або можуть бути застосовані одночасно з ними). У найгіршому випадку новостворений Pod може взагалі не мати мережевого звʼязку під час першого запуску, якщо правила ізоляції вже застосовані, а дозвільні правила ще ні.
Кожна створена NetworkPolicy рано чи пізно буде оброблена мережевим втулком, але через API Kubernetes неможливо дізнатися, коли саме це станеться.
Тому Podʼи мають бути стійкими до запуску з іншим мережевим звʼязком, ніж очікувалося. Якщо вам потрібно переконатися, що Pod може досягти певних призначень до запуску, ви можете використати init-контейнер, щоб дочекатися доступності цих призначень, перш ніж kubelet запустить контейнери застосунків.
Кожна NetworkPolicy рано чи пізно буде застосована до всіх вибраних Podʼів. Оскільки мережевий втулок може реалізовувати NetworkPolicy розподілено, Podʼи можуть бачити дещо неузгоджене подання мережевих політик під час першого створення Podʼа або коли змінюються Podʼи чи політики. Наприклад, новостворений Pod, який має мати доступ і до Podʼа A на вузлі 1, і до Podʼа B на вузлі 2, може виявити, що Pod A доступний йому одразу, а Pod B — лише через кілька секунд.
NetworkPolicy та Podʼи з hostNetwork
Поведінка NetworkPolicy для Podʼів із hostNetwork не визначена, але вона має обмежуватися двома можливостями:
Мережевий втулок може відрізняти трафік Podʼів із hostNetwork від усього іншого трафіку (зокрема, відрізняти трафік різних Podʼів із hostNetwork на тому самому вузлі) і застосовує NetworkPolicy до Podʼів із hostNetwork так само, як і до Podʼів у мережі Podʼів.
Мережевий втулок не може належним чином відрізнити трафік Podʼів із hostNetwork, тому він ігнорує такі Podʼи під час зіставлення podSelector та namespaceSelector. Трафік до Podʼів і від Podʼів із hostNetwork обробляється так само, як і весь інший трафік до IP-адреси вузла та від неї. (Це найпоширеніша реалізація.)
Це стосується випадків, коли
Pod із hostNetwork вибирається за допомогою spec.podSelector.
...spec:podSelector:matchLabels:role:client...
Pod із hostNetwork вибирається за допомогою podSelector чи namespaceSelector у правилі ingress чи egress.
Водночас, оскільки Podʼи з hostNetwork мають ті самі IP-адреси, що й вузли, на яких вони розміщені, їхні зʼєднання вважатимуться зʼєднаннями вузла. Наприклад, ви можете дозволити трафік від Podʼа з hostNetwork за допомогою правила ipBlock.
Що не можна зробити за допомогою мережевих політик (принаймні поки що)
У Kubernetes 1.37 наведена нижче функціональність відсутня в API NetworkPolicy, але ви можете реалізувати обхідні рішення за допомогою компонентів операційної системи (таких як SELinux, OpenVSwitch, IPTables тощо), технологій рівня 7 (контролери Ingress, реалізації Service Mesh) або контролерів допуску. Якщо ви лише починаєте знайомитися з мережевою безпекою в Kubernetes, варто зазначити, що наведені нижче сценарії користувачів поки що не можна реалізувати за допомогою API NetworkPolicy.
Примусове проходження внутрішньокластерного трафіку через спільний шлюз (для цього, ймовірно, найкраще підійде service mesh або інший проксі).
Будь-що, повʼязане з TLS (для цього використовуйте service mesh або контролер Ingress).
Політики для окремих вузлів (для цього можна використовувати нотацію CIDR, але не можна націлитися на вузли саме за їхніми ідентифікаторами в Kubernetes).
Націлювання на Services за назвою (проте ви можете націлюватися на Podʼи чи простори імен за їхніми мітками, що часто є прийнятним обхідним рішенням).
Створення запитів на політики («Policy requests»), які виконує третя сторона, або керування ними.
Стандартні політики, які застосовуються до всіх просторів імен чи Podʼів (деякі сторонні дистрибутиви Kubernetes і проєкти можуть це робити).
Розширені запити до політик та інструменти перевірки досяжності.
Можливість логування подій мережевої безпеки (наприклад, заблокованих чи прийнятих зʼєднань).
Можливість явно забороняти політиками (наразі модель NetworkPolicies — стандартна заборона з можливістю додавати лише дозвільні правила).
Можливість заборонити loopback-трафік або вхідний трафік від хоста (Podʼи наразі не можуть блокувати доступ через localhost, а також не можуть блокувати доступ від вузла, на якому вони розміщені).
Вплив NetworkPolicy на наявні зʼєднання
Коли змінюється набір NetworkPolicies, що застосовуються до наявного зʼєднання, — через зміну самих NetworkPolicies або через зміну відповідних міток просторів імен чи Podʼів, вибраних політикою (і субʼєкта, і його співрозмовників (peers)), посеред наявного зʼєднання, — те, чи вплине ця зміна на це наявне зʼєднання, визначається реалізацією. Приклад: створено політику, яка призводить до заборони раніше дозволеного зʼєднання; реалізація базового мережевого втулка відповідає за визначення того, чи закриє ця нова політика наявні зʼєднання. Рекомендується не змінювати політики, Podʼи чи простори імен у спосіб, який може вплинути на наявні зʼєднання.
Дивіться інші рецепти для поширених сценаріїв, які підтримує ресурс NetworkPolicy.
6.5.6 - DNS для Services та Podʼів
Ваше робоче навантаження може виявляти Services у вашому кластері за допомогою DNS; на цій сторінці пояснено, як це працює.
Kubernetes створює DNS-записи для Services та Podʼів. Ви можете звертатися до Services за стабільними DNS-іменами замість IP-адрес.
Kubernetes публікує інформацію про Podʼи та Services, яка використовується для програмування DNS. kubelet налаштовує DNS Podʼів так, щоб запущені контейнери могли знаходити Services за іменем, а не за IP.
Services, визначеним у кластері, призначаються DNS-імена. Стандартно список пошуку DNS клієнтського Podʼа містить власний простір імен Podʼа та стандартний домен кластера.
Простори імен Services
DNS-запит може повертати різні результати залежно від простору імен Podʼа, який його робить. DNS-запити, які не вказують простір імен, обмежуються простором імен Podʼа. Щоб отримати доступ до Services в інших просторах імен, вказуйте простір імен у DNS-запиті.
Наприклад, розгляньмо Pod у просторі імен test. Service data міститься в просторі імен prod.
Запит data не повертає результатів, оскільки використовує простір імен Podʼа test.
Запит data.prod повертає очікуваний результат, оскільки вказує простір імен.
DNS-запити можуть бути розширені за допомогою /etc/resolv.conf Podʼа. kubelet налаштовує цей файл для кожного Podʼа. Наприклад, запит лише data може бути розширено до data.test.svc.cluster.local. Для розширення запитів використовуються значення параметра search. Щоб дізнатися більше про DNS-запити, див. сторінку довідки resolv.conf.
Отже, Pod у просторі імен test може успішно розвʼязувати як data.prod, так і data.prod.svc.cluster.local.
DNS-записи
Для яких обʼєктів створюються DNS-записи?
Services
Podʼи
У розділах нижче докладно описано підтримувані типи DNS-записів та їхню структуру. Будь-яка інша структура, імена чи запити, які випадково працюють, вважаються деталями реалізації й можуть змінитися без попередження. Актуальнішу специфікацію див. у Kubernetes DNS-Based Service Discovery.
Services
Записи A/AAAA
«Звичайні» (не headless) Services отримують DNS-записи A та/або AAAA залежно від сімейства або сімейств IP цього Service, з іменем у вигляді my-svc.my-namespace.svc.cluster-domain.example. Це імʼя розвʼязується в кластерний IP Service.
Headless Services
(без кластерного IP) теж отримують DNS-записи A та/або AAAA, з іменем у вигляді my-svc.my-namespace.svc.cluster-domain.example. На відміну від звичайних Services, це імʼя розвʼязується в набір IP-адрес усіх Podʼів, вибраних Service. Очікується, що клієнти використовуватимуть увесь набір або стандартний вибір round-robin із нього.
Записи SRV
Записи SRV створюються для іменованих портів, які є частиною звичайних або headless Services.
Для кожного іменованого порту SRV-запис має вигляд _port-name._port-protocol.my-svc.my-namespace.svc.cluster-domain.example.
Для звичайного Service він розвʼязується в номер порту та доменне імʼя: my-svc.my-namespace.svc.cluster-domain.example.
Для headless Service він розвʼязується в кілька відповідей, по одній для кожного Podʼа, що обслуговує Service, і містить номер порту та доменне імʼя Podʼа у вигляді hostname.my-svc.my-namespace.svc.cluster-domain.example.
Podʼи
Записи A/AAAA
Версії Kube-DNS до впровадження специфікації DNS мали таке розвʼязання DNS:
Наприклад, якщо Pod у просторі імен cafe має IP-адресу 172.17.0.3, є точкою доступу Service з назвою barista, а доменне імʼя вашого кластера — cluster.local, то Pod матиме такий запис DNS A в межах Service.
172-17-0-3.barista.cafe.svc.cluster.local
Поля hostname та subdomain Podʼа
Наразі під час створення Podʼа його імʼя хоста (як його видно зсередини Podʼа) — це значення metadata.name Podʼа.
У специфікації Podʼа є необовʼязкове поле hostname, яке можна використовувати, щоб вказати інше імʼя хоста. Якщо його вказано, воно має пріоритет над назвою Podʼа й стає іменем хоста Podʼа (знову ж таки, як його видно зсередини Podʼа). Наприклад, Pod зі spec.hostname, встановленим у "my-host", матиме імʼя хоста "my-host".
У специфікації Podʼа також є необовʼязкове поле subdomain, яким можна вказати, що Pod є частиною підгрупи простору імен. Наприклад, Pod зі spec.hostname, встановленим у "foo", і spec.subdomain, встановленим у "bar", у просторі імен "my-namespace" матиме імʼя хоста "foo" та повне доменне імʼя (FQDN) "foo.bar.my-namespace.svc.cluster.local" (знову ж таки, як його видно зсередини Podʼа).
Якщо в тому самому просторі імен, що й Pod, існує headless Service із такою самою назвою, як піддомен, DNS-сервер кластера також повертає записи A та/або AAAA для повного імені хоста Podʼа.
Приклад:
apiVersion:v1kind:Servicemetadata:name:busybox-subdomainspec:selector:name:busyboxclusterIP:Noneports:- name:foo# name не є обовʼязковим для Services з одним портомport:1234---apiVersion:v1kind:Podmetadata:name:busybox1labels:name:busyboxspec:hostname:busybox-1subdomain:busybox-subdomaincontainers:- image:busybox:1.28command:- sleep- "3600"name:busybox---apiVersion:v1kind:Podmetadata:name:busybox2labels:name:busyboxspec:hostname:busybox-2subdomain:busybox-subdomaincontainers:- image:busybox:1.28command:- sleep- "3600"name:busybox
Для наведеного вище Service "busybox-subdomain" і Podʼів, які встановлюють spec.subdomain у "busybox-subdomain", перший Pod бачитиме своє FQDN як "busybox-1.busybox-subdomain.my-namespace.svc.cluster-domain.example". DNS обслуговує за цим іменем записи A та/або AAAA, що вказують на IP-адресу Podʼа. Обидва Podʼи, "busybox1" та "busybox2", матимуть власні адресні записи.
EndpointSlice може вказувати DNS-імʼя хоста для будь-яких адрес точок доступу разом з їхнім IP.
Примітка:
Записи A та AAAA не створюються для назв Podʼів, оскільки для Podʼа відсутній hostname. Pod без hostname, але з subdomain створить запис A або AAAA лише для headless Service (busybox-subdomain.my-namespace.svc.cluster-domain.example), що вказує на IP-адреси Podʼів. Крім того, Pod має бути готовим, щоб мати запис, якщо для Service не встановлено publishNotReadyAddresses=True.
Поле setHostnameAsFQDN Podʼа
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.22
Коли Pod налаштовано так, що він має повне доменне імʼя (FQDN), його імʼя хоста — це коротке імʼя хоста. Наприклад, якщо у вас є Pod із повним доменним імʼям busybox-1.busybox-subdomain.my-namespace.svc.cluster-domain.example, то стандартно команда hostname в цьому Podʼі повертає busybox-1, а команда hostname --fqdn повертає FQDN.
Коли ви встановлюєте setHostnameAsFQDN: true у специфікації Podʼа, kubelet записує FQDN Podʼа в імʼя хоста для простору імен цього Podʼа. У цьому випадку як hostname, так і hostname --fqdn повертають FQDN Podʼа.
Примітка:
У Linux поле hostname ядра (поле nodename структури struct utsname) обмежено 64 символами.
Якщо Pod вмикає цю можливість, а його FQDN довше за 64 символи, він не запуститься. Pod залишиться у статусі Pending (ContainerCreating, як показує kubectl), генеруючи події помилок, такі як Failed to construct FQDN from Pod hostname and cluster domain, FQDN long-FQDN is too long (64 characters is the max, 70 characters requested). Один зі способів покращити досвід користувача в цьому сценарії — створити контролер вебхука допуску, щоб контролювати розмір FQDN під час створення користувачами обʼєктів верхнього рівня, наприклад Deployment.
Політика DNS Podʼа
Політику DNS можна встановлювати для кожного Podʼа окремо. Наразі Kubernetes підтримує такі політики DNS для Podʼів. Ці політики вказуються в полі dnsPolicy специфікації Podʼа.
"Default": Pod успадковує конфігурацію розвʼязання імен від вузла, на якому він працює. Докладніше дивіться в повʼязаному обговоренні.
"ClusterFirst": Будь-який DNS-запит, який не відповідає налаштованому суфіксу домену кластера, наприклад "www.kubernetes.io", DNS-сервер пересилає до вищестоящого сервера імен. Адміністратори кластера можуть налаштувати додаткові stub-домени та вищестоящі DNS-сервери. Як у цих випадках обробляються DNS-запити, дивіться в повʼязаному обговоренні.
"ClusterFirstWithHostNet": Для Podʼів, що працюють із hostNetwork, слід явно встановити політику DNS "ClusterFirstWithHostNet". Інакше Podʼи, що працюють із hostNetwork і "ClusterFirst", повернуться до поведінки політики "Default".
Примітка:
Це не підтримується в Windows. Деталі дивіться нижче.
"None": Дозволяє Podʼу ігнорувати налаштування DNS із середовища Kubernetes. Усі налаштування DNS мають надаватися за допомогою поля dnsConfig у специфікації Podʼа. Див. підрозділ Конфігурація DNS Podʼа нижче.
Примітка:
"Default" — це не стандартна політика DNS. Якщо dnsPolicy не вказано явно, використовується "ClusterFirst".
У прикладі нижче показано Pod із політикою DNS "ClusterFirstWithHostNet", оскільки hostNetwork встановлено в true.
Конфігурація DNS Podʼа дає користувачам більше контролю над налаштуваннями DNS Podʼа.
Поле dnsConfig є необовʼязковим і може працювати з будь-якими налаштуваннями dnsPolicy. Однак коли dnsPolicy Podʼа встановлено в "None", поле dnsConfig потрібно вказати обовʼязково.
Нижче наведено властивості, які користувач може вказати в полі dnsConfig:
nameservers: список IP-адрес, які використовуватимуться як DNS-сервери для Podʼа. Можна вказати не більше 3 IP-адрес. Коли dnsPolicy Podʼа встановлено в "None", список повинен містити принаймні одну IP-адресу, інакше ця властивість є необовʼязковою. Указані сервери буде обʼєднано з базовими серверами імен, згенерованими із зазначеної політики DNS, а дубльовані адреси вилучено.
searches: список доменів пошуку DNS для пошуку імен хостів у Podʼі. Ця властивість є необовʼязковою. Якщо її вказано, цей список буде обʼєднано з базовими доменами пошуку, згенерованими з вибраної політики DNS. Дубльовані доменні імена вилучаються. Kubernetes дозволяє до 32 доменів пошуку.
options: необовʼязковий список обʼєктів, де кожний обʼєкт може мати властивість name (обовʼязкова) і властивість value (необовʼязкова). Вміст цієї властивості буде обʼєднано з параметрами, згенерованими із зазначеної політики DNS. Дубльовані записи вилучаються.
apiVersion:v1kind:Podmetadata:namespace:defaultname:dns-examplespec:containers:- name:testimage:nginxdnsPolicy:"None"dnsConfig:nameservers:- 192.0.2.1# this is an examplesearches:- ns1.svc.cluster-domain.example- my.dns.search.suffixoptions:- name:ndotsvalue:"2"- name:edns0
Коли наведений вище Pod створено, контейнер test отримує такий вміст у своєму файлі /etc/resolv.conf:
Kubernetes сам не обмежує конфігурацію DNS, доки довжина списку доменів пошуку не перевищить 32 або загальна довжина всіх доменів пошуку не перевищить 2048. Це обмеження стосується файлу конфігурації резолвера вузла, конфігурації DNS Podʼа та обʼєднаної конфігурації DNS відповідно.
Примітка:
Деякі середовища виконання контейнерів раніших версій можуть мати власні обмеження щодо кількості доменів пошуку DNS. Залежно від середовища виконання контейнерів,
Podʼи з великою кількістю доменів пошуку DNS можуть залишатися в стані очікування.
Відомо, що цю проблему мають containerd v1.5.5 або раніші та CRI-O v1.21 або раніші.
Розвʼязання DNS на вузлах Windows
ClusterFirstWithHostNet не підтримується для Podʼів, що працюють на вузлах Windows. Windows вважає всі імена з крапкою . повними доменними іменами (FQDN) і пропускає розвʼязання FQDN.
У Windows можна використовувати кілька резолверів DNS. Оскільки їхня поведінка дещо відрізняється, для розвʼязання імен рекомендовано використовувати командлет PowerShell Resolve-DNSName.
У Linux є список суфіксів DNS, який використовується після невдалого розвʼязання імені як повного. У Windows можна мати лише 1 суфікс DNS — суфікс, повʼязаний із простором імен цього Podʼа (наприклад, mydns.svc.cluster.local). Windows може розвʼязувати FQDN, Services або мережеві імена, які можна розвʼязати за допомогою цього єдиного суфікса. Наприклад, Pod, запущений у просторі імен default, матиме суфікс DNS default.svc.cluster.local. Усередині Podʼа Windows можна розвʼязувати і kubernetes.default.svc.cluster.local, і kubernetes, але не частково кваліфіковані імена (kubernetes.default або kubernetes.default.svc).
Kubernetes дозволяє налаштувати мережу з одним стеком IPv4, мережу з одним стеком IPv6 або мережу з подвійним стеком, де активні обидва мережеві сімейства. На цій сторінці пояснено, як це зробити.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.23
Двостекова мережа IPv4/IPv6 дозволяє виділяти адреси IPv4 та IPv6 для Podʼів та Services.
Двостекова мережа IPv4/IPv6 стандартно увімкнена у вашому кластері Kubernetes починаючи з версії 1.21, що дозволяє одночасно призначати адреси IPv4 та IPv6.
Підтримувані можливості
Двостекова мережа IPv4/IPv6 у вашому кластері Kubernetes надає такі можливості:
Двостекова мережа Podʼів (одна адреса IPv4 та одна адреса IPv6 на Pod)
Services з підтримкою IPv4 та IPv6
Маршрутизація вихідного трафіку Podʼів за межі кластера (наприклад, в Інтернет) через інтерфейси IPv4 та IPv6
Передумови
Щоб використовувати двостекові кластери Kubernetes IPv4/IPv6, потрібно виконати такі передумови:
Kubernetes 1.20 або новіше
Інформацію про використання двостекових Services із попередніми версіями Kubernetes дивіться в документації відповідної версії Kubernetes.
Підтримка двостекової мережі провайдером (хмарний чи інший провайдер має надати вузлам Kubernetes маршрутизовані мережеві інтерфейси IPv4/IPv6)
--node-cidr-mask-size-ipv4|--node-cidr-mask-size-ipv6 стандартно /24 для IPv4 та /64 для IPv6
kube-proxy:
--cluster-cidr=<CIDR IPv4>,<CIDR IPv6>
kubelet:
--node-ip=<IP IPv4>,<IP IPv6>
Цей параметр є обовʼязковим для двостекових вузлів bare metal (вузлів, які не визначають хмарного провайдера прапорцем --cloud-provider). Якщо ви використовуєте хмарного провайдера й вирішили перевизначити IP-адреси вузлів, вибрані ним, встановіть параметр --node-ip.
(Застарілі вбудовані хмарні провайдери не підтримують двостековий --node-ip.)
Примітка:
Приклад CIDR IPv4: 10.244.0.0/16 (хоча ви вказуватимете власний діапазон адрес)
Приклад CIDR IPv6: fdXY:IJKL:MNOP:15::/64 (це показує формат, але не є дійсною адресою — дивіться RFC 4193)
Services
Ви можете створювати Services, які можуть використовувати IPv4, IPv6 або обидва.
Сімейство адрес Service стандартно відповідає сімейству адрес першого діапазону кластерних IP Services (налаштованого через прапорець --service-cluster-ip-range для kube-apiserver).
Під час визначення Service ви можете за бажанням налаштувати його як двостековий. Щоб вказати потрібну поведінку, встановіть у полі .spec.ipFamilyPolicy одне з таких значень:
SingleStack: одностековий Service. Панель управління виділяє кластерний IP для Service, використовуючи перший налаштований діапазон кластерних IP Services.
PreferDualStack: виділяє кластерні IP IPv4 та IPv6 для Service, коли подвійний стек увімкнено. Якщо подвійний стек не увімкнено або він не підтримується, застосовується одностекова поведінка.
RequireDualStack: виділяє .spec.clusterIPs Service з діапазонів адрес IPv4 та IPv6, коли подвійний стек увімкнено. Якщо подвійний стек не увімкнено або він не підтримується, створення обʼєкта API Service завершиться невдачею.
Вибирає .spec.clusterIP зі списку .spec.clusterIPs на основі сімейства адрес першого елемента у масиві .spec.ipFamilies.
Якщо ви хочете визначити, яке сімейство IP використовувати для одного стека, або задати порядок сімейств IP для подвійного стека, ви можете вибрати сімейства адрес, встановивши необовʼязкове поле .spec.ipFamilies у Service.
Примітка:
Поле .spec.ipFamilies умовно змінюване: ви можете додавати або видаляти вторинне
сімейство IP-адрес, але не можете змінювати основне сімейство IP-адрес наявного Service.
Ви можете встановити .spec.ipFamilies в будь-яке з таких значень масиву:
["IPv4"]
["IPv6"]
["IPv4","IPv6"] (подвійний стек)
["IPv6","IPv4"] (подвійний стек)
Перше вказане вами сімейство використовується для застарілого поля .spec.clusterIP.
Сценарії конфігурації двостекового Service
Ці приклади демонструють поведінку різних сценаріїв конфігурації двостекового Service.
Параметри подвійного стека в нових Services
Специфікація цього Service явно не визначає .spec.ipFamilyPolicy. Коли ви створюєте цей Service, Kubernetes призначає кластерний IP для Service з першого налаштованого service-cluster-ip-range і встановлює .spec.ipFamilyPolicy у SingleStack. (Services без селекторів та headless Services із селекторами поводитимуться так само.)
Специфікація цього Service явно визначає PreferDualStack в .spec.ipFamilyPolicy. Коли ви створюєте цей Service у двостековому кластері, Kubernetes призначає адреси IPv4 та IPv6 для Service. Панель управління оновлює .spec Service, щоб зафіксувати призначені IP-адреси. Поле .spec.clusterIPs є основним і містить обидві призначені IP-адреси; .spec.clusterIP є вторинним полем, значення якого обчислюється з .spec.clusterIPs.
Для поля .spec.clusterIP панель управління записує IP-адресу з того самого сімейства адрес, що й перший діапазон кластерних IP Services.
В одностековому кластері обидва поля .spec.clusterIPs та .spec.clusterIP містять лише одну адресу.
У кластері з увімкненим подвійним стеком вказання RequireDualStack в .spec.ipFamilyPolicy працює так само, як і PreferDualStack.
Специфікація цього Service явно визначає IPv6 та IPv4 в .spec.ipFamilies, а також PreferDualStack в .spec.ipFamilyPolicy. Коли Kubernetes призначає адреси IPv6 та IPv4 у .spec.clusterIPs, .spec.clusterIP встановлюється на адресу IPv6, оскільки це перший елемент масиву .spec.clusterIPs, що перевизначає стандартну поведінку.
Стандартні значення подвійного стека в наявних Services
Ці приклади демонструють стандартну поведінку, коли подвійний стек щойно увімкнено в кластері, де вже існують Services. (Оновлення наявного кластера до версії 1.21 або новішої вмикає подвійний стек.)
Коли в кластері увімкнено подвійний стек, панель управління налаштовує наявні Services (чи то IPv4, чи IPv6), встановлюючи .spec.ipFamilyPolicy у SingleStack, а .spec.ipFamilies — у сімейство адрес наявного Service. Кластерний IP наявного Service зберігається в .spec.clusterIPs.
Коли в кластері увімкнено подвійний стек, панель управління налаштовує наявні headless Services із селекторами, встановлюючи .spec.ipFamilyPolicy у SingleStack, а .spec.ipFamilies — у сімейство адрес першого діапазону кластерних IP Services (налаштованого через прапорець --service-cluster-ip-range для kube-apiserver), навіть якщо .spec.clusterIP встановлено в None.
Перемикання Services між одностековим та двостековим режимами
Services можна перемикати з одностекового режиму на двостековий і навпаки.
Щоб перемкнути Service з одностекового режиму на двостековий, змініть .spec.ipFamilyPolicy з SingleStack на PreferDualStack або RequireDualStack, залежно від потреби. Коли ви переводите цей Service з одностекового режиму на двостековий, Kubernetes призначає відсутнє сімейство адрес, тож Service тепер має адреси IPv4 та IPv6.
Відредагуйте специфікацію Service, оновивши .spec.ipFamilyPolicy з SingleStack на PreferDualStack.
До:
spec:ipFamilyPolicy:SingleStack
Після:
spec:ipFamilyPolicy:PreferDualStack
Щоб перемкнути Service з двостекового режиму на одностековий, змініть .spec.ipFamilyPolicy з PreferDualStack або RequireDualStack на SingleStack. Коли ви переводите цей Service з двостекового режиму на одностековий, Kubernetes залишає лише перший елемент масиву .spec.clusterIPs, встановлює .spec.clusterIP на цю IP-адресу, а .spec.ipFamilies — на сімейство адрес .spec.clusterIPs.
Headless Services без селектора
Для Headless Services без селекторів і без явно вказаного .spec.ipFamilyPolicy стандартним значенням поля .spec.ipFamilyPolicy є RequireDualStack.
Service типу LoadBalancer
Щоб створити двостековий балансувальник навантаження для вашого Service:
Встановіть значення поля .spec.type в LoadBalancer
Встановіть значення поля .spec.ipFamilyPolicy в PreferDualStack або RequireDualStack
Примітка:
Щоб використовувати двостековий Service типу LoadBalancer, ваш хмарний провайдер має підтримувати балансувальники навантаження IPv4 та IPv6.
Вихідний трафік
Якщо ви хочете увімкнути вихідний трафік, щоб досягати призначень за межами кластера (наприклад, публічного Інтернету) з Podʼа, який використовує адреси IPv6, що не маршрутизуються публічно, вам потрібно дати Podʼу змогу використовувати публічно маршрутизовану адресу IPv6 за допомогою такого механізму, як прозоре проксіювання або IP-маскування. Проєкт ip-masq-agent підтримує IP-маскування у двостекових кластерах.
Примітка:
Переконайтеся, що ваш провайдер CNI підтримує IPv6.
Підтримка Windows
Kubernetes у Windows не підтримує одностекову мережу «лише IPv6». Однак підтримується двостекова мережа IPv4/IPv6 для Podʼів і вузлів з одностековими Services.
Ви можете використовувати двостекову мережу IPv4/IPv6 з мережами l2bridge.
Примітка:
Оверлейні мережі (VXLAN) у Windows не підтримують двостекову мережу.
Докладніше про різні режими мережі у Windows читайте в розділі Мережа у Windows.
Маршрутизація з урахуванням топології надає механізм, який допомагає утримувати мережевий трафік у межах зони, з якої він надійшов. Надання переваги трафіку в межах однієї зони між Podʼами у вашому кластері може допомогти з надійністю, продуктивністю (затримкою мережі та пропускною здатністю) або вартістю.
Маршрутизація з урахуванням топології налаштовує поведінку маршрутизації так, щоб трафік по можливості залишався в зоні, з якої він надійшов. У деяких випадках це може допомогти зменшити витрати або покращити продуктивність мережі.
Мотивація
Кластери Kubernetes дедалі частіше розгортаються в багатозональних середовищах. Маршрутизація з урахуванням топології надає механізм, який допомагає утримувати трафік у межах зони, з якої він надійшов. Під час обчислення точок доступу для Service контролер EndpointSlice враховує топологію (регіон і зону) кожної точки доступу та заповнює поле hints, щоб призначити її зоні. Компоненти кластера, такі як kube-proxy, можуть використовувати ці підказки, щоб впливати на маршрутизацію трафіку (надаючи перевагу топологічно ближчим точкам доступу).
Увімкнення маршрутизації з урахуванням топології
Ви можете увімкнути маршрутизацію з урахуванням топології для Service, встановивши анотацію service.kubernetes.io/topology-mode у значення Auto. Коли в кожній зоні є достатньо точок доступу, в EndpointSlices заповнюються підказки топології (Topology Hints), що призначають окремі точки доступу конкретним зонам, і трафік маршрутизується ближче до місця, звідки він надійшов.
Коли це працює найкраще
Ця можливість працює найкраще, коли:
1. Вхідний трафік рівномірно розподілений
Якщо значна частина трафіку надходить з однієї зони, цей трафік може перевантажити підмножину точок доступу, призначених цій зоні. Цю можливість не рекомендується використовувати, коли очікується, що вхідний трафік надходитиме з однієї зони.
2. У Service є 3 чи більше точок доступу на зону
У кластері з трьома зонами це означає 9 чи більше точок доступу. Якщо точок доступу менше ніж 3 на зону, існує висока (≈50%) ймовірність, що контролер EndpointSlice не зможе рівномірно розподілити точки доступу й натомість повернеться до стандартного підходу до маршрутизації в межах кластера.
Як це працює
Евристика "Auto" намагається пропорційно розподілити кількість точок доступу між зонами. Зверніть увагу, що ця евристика працює найкраще для Services зі значною кількістю точок доступу.
Контролер EndpointSlice
Контролер EndpointSlice відповідає за встановлення підказок в EndpointSlices, коли цю евристику увімкнено. Контролер призначає кожній зоні пропорційну кількість точок доступу. Ця пропорція ґрунтується на доступних для розподілу ядрах CPU вузлів, що працюють у цій зоні. Наприклад, якщо в одній зоні є 2 ядра CPU, а в іншій лише 1 ядро CPU, контролер призначить удвічі більше точок доступу зоні з 2 ядрами CPU.
У цьому прикладі показано, як виглядає EndpointSlice із заповненими підказками:
Компонент kube-proxy фільтрує точки доступу, до яких він маршрутизує трафік, на основі підказок, встановлених контролером EndpointSlice. У більшості випадків це означає, що kube-proxy може маршрутизувати трафік до точок доступу в тій самій зоні. Іноді контролер призначає точки доступу з іншої зони, щоб забезпечити рівномірніший розподіл точок доступу між зонами. Через це частина трафіку маршрутизуватиметься до інших зон.
Запобіжники
Панель управління Kubernetes та kube-proxy на кожному вузлі застосовують деякі запобіжні правила перед використанням Topology Aware Hints. Якщо ці перевірки не проходять, kube-proxy вибирає точки доступу з будь-якої частини вашого кластера, незалежно від зони.
Недостатня кількість точок доступу: Якщо точок доступу менше, ніж зон у кластері, контролер не призначатиме жодних підказок.
Неможливо досягти збалансованого розподілу: У деяких випадках досягти збалансованого розподілу точок доступу між зонами неможливо. Наприклад, якщо zone-a удвічі більша за zone-b, але є лише 2 точки доступу, точка доступу, призначена zone-a, може отримувати вдвічі більше трафіку, ніж точка доступу zone-b. Контролер не призначає підказок, якщо не може знизити це значення «очікуваного перевантаження» нижче прийнятного порогу для кожної зони. Важливо, що це не ґрунтується на зворотному звʼязку в реальному часі. Окремі точки доступу все ще можуть бути перевантажені.
Один чи кілька вузлів мають недостатньо інформації: Якщо будь-який вузол не має мітки topology.kubernetes.io/zone або не повідомляє значення CPU, доступного для розподілу, панель управління не встановлює жодних топологічних підказок для точок доступу, тож kube-proxy не фільтрує точки доступу за зоною.
Одна чи кілька точок доступу не мають підказки щодо зони: У такому разі kube-proxy вважає, що відбувається перехід до Topology Aware Hints або від них. Фільтрувати точки доступу для Service в такому стані було б небезпечно, тому kube-proxy повертається до використання всіх точок доступу.
Зону не представлено в підказках: Якщо kube-proxy не може знайти принаймні одну точку доступу з підказкою для зони, в якій він працює, він повертається до використання точок доступу з усіх зон. Найімовірніше це трапиться, коли ви додаєте нову зону до наявного кластера.
Обмеження
Topology Aware Hints не використовуються, коли для Service internalTrafficPolicy встановлено в Local. Обидві можливості можна використовувати в одному кластері для різних Services, але не для одного Service.
Цей підхід погано працюватиме для Services, у яких значна частина трафіку надходить із підмножини зон. Він передбачає, що вхідний трафік буде приблизно пропорційним місткості вузлів у кожній зоні.
Контролер EndpointSlice ігнорує неготові вузли під час обчислення пропорцій для кожної зони. Це може мати небажані наслідки, якщо значна частина вузлів неготова.
Контролер EndpointSlice ігнорує вузли з мітками node-role.kubernetes.io/control-plane або node-role.kubernetes.io/master. Це може бути проблемою, якщо на цих вузлах також працюють робочі навантаження.
Контролер EndpointSlice не враховує tolerations під час розгортання або обчислення пропорцій для кожної зони. Якщо Podʼи, що обслуговують Service, обмежені підмножиною вузлів кластера, це не враховуватиметься.
Це може погано працювати з автомасштабуванням. Наприклад, якщо багато трафіку надходить з однієї зони, цей трафік оброблятимуть лише точки доступу, призначені цій зоні. Через це Horizontal Pod Autoscaler може або не помітити цю подію, або нові Podʼи запускатимуться в іншій зоні.
Власні евристики
Kubernetes розгортається багатьма різними способами, і немає єдиної евристики розподілу точок доступу між зонами, яка підходила б для кожного випадку. Ключова мета цієї можливості — дозволити розробку власних евристик, якщо вбудована евристика не підходить для вашого випадку. Перші кроки для увімкнення власних евристик увійшли до випуску 1.27. Це обмежена реалізація, яка може ще не охоплювати деякі актуальні та ймовірні ситуації.
Дізнайтесь про поле trafficDistribution, що тісно повʼязане з анотацією service.kubernetes.io/topology-mode і надає гнучкі варіанти маршрутизації трафіку в Kubernetes.
6.5.9 - Мережа у Windows
Kubernetes підтримує роботу вузлів як на Linux, так і на Windows. Ви можете поєднувати обидва види вузлів в одному кластері. На цій сторінці наведено огляд мережевих аспектів, специфічних для операційної системи Windows.
Мережа контейнерів у Windows
Мережа для контейнерів Windows надається через втулки CNI. Контейнери Windows працюють подібно до віртуальних машин з погляду мережі. Кожен контейнер має віртуальний мережевий адаптер (vNIC), підключений до віртуального комутатора Hyper-V (vSwitch). Host Networking Service (HNS) та Host Compute Service (HCS) спільно створюють контейнери й підключають vNIC контейнерів до мереж. HCS відповідає за керування контейнерами, а HNS — за керування мережевими ресурсами, такими як:
Віртуальні мережі (зокрема створення vSwitches)
Точки доступу / vNIC
Namespaces
Політики, зокрема інкапсуляція пакетів, правила балансування навантаження, ACL та правила NAT.
HNS та vSwitch у Windows реалізують простори імен і можуть за потреби створювати віртуальні NIC для Podʼа чи контейнера. Однак багато конфігурацій, таких як DNS, маршрути та метрики, зберігаються в базі даних реєстру Windows, а не у файлах в /etc, як у Linux. Реєстр Windows контейнера відокремлений від реєстру хоста, тому такі прийоми, як зіставлення /etc/resolv.conf з хоста в контейнер, не дають того ефекту, що в Linux. Це потрібно налаштовувати за допомогою API Windows, що виконуються в контексті цього контейнера. Тому реалізації CNI повинні викликати HNS, а не покладатися на зіставлення файлів, щоб передавати мережеві дані в Pod чи контейнер.
Режими мережі
Windows підтримує пʼять різних мережевих драйверів/режимів: L2bridge, L2tunnel, Overlay (Beta), Transparent та NAT. У гетерогенному кластері з робочими вузлами Windows і Linux потрібно вибрати мережеве рішення, сумісне і з Windows, і з Linux. У таблиці нижче наведено зовнішні (out-of-tree) втулки, які підтримуються у Windows, з рекомендаціями щодо використання кожного CNI:
Мережевий драйвер
Опис
Зміни пакетів контейнерів
Мережеві втулки
Характеристики мережевих втулків
L2bridge
Контейнери підключені до зовнішнього vSwitch. Контейнери підключені до базової мережі (underlay), хоча фізичній мережі не потрібно знати MAC-адреси контейнерів, оскільки вони переписуються на вході та виході.
MAC переписується на MAC хоста, IP може бути переписаний на IP хоста за допомогою політики HNS OutboundNAT.
win-bridge використовує режим мережі L2bridge, підключає контейнери до базової мережі хостів і забезпечує найкращу продуктивність. Потребує маршрутів, визначених користувачем (UDR), для звʼязку між вузлами.
L2Tunnel
Це особливий випадок l2bridge, який використовується лише в Azure. Усі пакети надсилаються на хост віртуалізації, де застосовується політика SDN.
Azure-CNI дозволяє інтегрувати контейнери з Azure vNET і дає їм змогу використовувати набір можливостей, які надає Azure Virtual Network. Наприклад, безпечно підключатися до сервісів Azure або використовувати NSG Azure. Див. azure-cni, де є кілька прикладів
Overlay
Контейнерам надається vNIC, підключений до зовнішнього vSwitch. Кожна оверлейна мережа отримує власну IP-підмережу, визначену власним IP-префіксом. Драйвер оверлейної мережі використовує інкапсуляцію VXLAN.
win-overlay слід використовувати, коли віртуальні мережі контейнерів потрібно ізолювати від базової мережі хостів (наприклад, з міркувань безпеки). Дозволяє повторно використовувати IP-адреси для різних оверлейних мереж (які мають різні теґи VNID), якщо у вашому центрі обробки даних обмаль IP-адрес. Цей варіант потребує KB4489899 у Windows Server 2019.
Потребує зовнішнього vSwitch. Контейнери підключені до зовнішнього vSwitch, що забезпечує взаємодію всередині Podʼа через логічні мережі (логічні комутатори та маршрутизатори).
Пакет інкапсулюється через тунелювання GENEVE або STT, щоб досягти Podʼів, які не перебувають на тому самому хості. Пакети пересилаються або відкидаються на основі метаданих тунелю, які надає мережевий контролер ovn. NAT виконується для трафіку північ-південь.
Розгортається за допомогою ansible. Розподілені ACL можна застосовувати за допомогою політик Kubernetes. Підтримка IPAM. Балансування навантаження можливе без kube-proxy. NAT виконується без використання iptables/netsh.
NAT (не використовується в Kubernetes)
Контейнерам надається vNIC, підключений до внутрішнього vSwitch. DNS/DHCP надається внутрішнім компонентом, який називається WinNAT
Цей втулок підтримує делегування одному з еталонних втулків CNI (win-overlay, win-bridge) для спільної роботи з демоном Flannel у Windows (Flanneld), щоб автоматично призначати оренду підмережі вузла та створювати мережу HNS. Цей втулок читає власний файл конфігурації (cni.conf) і обʼєднує його зі змінними середовища з файлу subnet.env, згенерованого FlannelD. Потім він делегує налаштування мережі одному з еталонних втулків CNI й надсилає правильну конфігурацію з призначеною вузлу підмережею до втулка IPAM (наприклад, host-local).
Для обʼєктів Node, Pod та Service підтримуються такі мережеві потоки для трафіку TCP/UDP:
This is a stable feature in Kubernetes, and has been since version v1.34. It was first available in the v1.14 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate WinDSR, Kubernetes ignores it but does not report any error.
Режим балансування навантаження, у якому виправлення IP-адрес і LBNAT відбуваються безпосередньо на порту vSwitch контейнера; трафік сервісу надходить з IP-адресою джерела, що дорівнює IP-адресі вихідного Podʼа. Це оптимізує продуктивність, дозволяючи зворотному трафіку, що маршрутизується через балансувальники навантаження, оминати балансувальник і відповідати безпосередньо клієнту; це зменшує навантаження на балансувальник і загальну затримку. Докладніше читайте в Direct Server Return (DSR) in a nutshell.
Балансування навантаження та Services
Service Kubernetes — це абстракція, яка визначає логічний набір Podʼів і спосіб доступу до них мережею. У кластері з вузлами Windows можна використовувати такі типи Service:
Встановіть такий аргумент командного рядка (для версії 1.37): --enable-dsr=true
Preserve-Destination
Пропускає DNAT трафіку сервісу, зберігаючи віртуальну IP-адресу цільового сервісу в пакетах, що досягають Podʼа-бекенда. Також вимикає пересилання між вузлами.
Windows Server, версія 1903
Встановіть "preserve-destination": "true" в анотаціях сервісу та увімкніть DSR у kube-proxy.
Двостекова мережа IPv4/IPv6
Нативний звʼязок IPv4-IPv4 паралельно зі звʼязком IPv6-IPv6 до кластера, з нього та всередині нього
Гарантує збереження IP-адреси джерела вхідного трафіку. Також вимикає пересилання між вузлами.
Windows Server 2019
Встановіть service.spec.externalTrafficPolicy у "Local" та увімкніть DSR у kube-proxy
Обмеження
Така мережева функціональність не підтримується на вузлах Windows:
Режим мережі хоста
Локальний доступ до NodePort із самого вузла (працює для інших вузлів або зовнішніх клієнтів)
Понад 64 Podʼи-бекенди (або унікальні адреси призначення) для одного Service
Звʼязок IPv6 між Podʼами Windows, підключеними до оверлейних мереж
Local Traffic Policy в режимі без DSR
Вихідний звʼязок за протоколом ICMP через win-overlay, win-bridge або за допомогою втулка Azure-CNI. Зокрема, площина даних Windows (VFP) не підтримує транспозицію пакетів ICMP, і це означає:
Пакети ICMP, спрямовані до призначень у тій самій мережі (наприклад, звʼязок між Podʼами через ping), працюють як очікується;
TCP/UDP-пакети працюють, як очікується;
Пакети ICMP, спрямовані через віддалену мережу (наприклад, звʼязок Podʼа із зовнішнім інтернетом через ping), не можуть бути транспоновані, тому не маршрутизуються назад до свого джерела;
Оскільки TCP/UDP-пакети все ще можуть бути транспоновані, під час налагодження звʼязку із зовнішнім світом ви можете замінити ping <destination> на curl <destination>.
Інші обмеження:
Еталонні мережеві втулки Windows win-bridge та win-overlay не реалізують специфікацію CNI v0.4.0 через відсутність реалізації CHECK.
Втулок CNI Flannel VXLAN має такі обмеження у Windows:
Звʼязок між вузлом і Podʼом можливий лише для локальних Podʼів із Flannel v0.12.0 (або новішим).
Flannel обмежений використанням VNI 4096 та UDP-порту 4789. Докладніше про ці параметри див. в офіційній документації бекенда Flannel VXLAN.
6.5.10 - Виділення ClusterIP для Service
У Kubernetes Services — це абстрактний спосіб надати доступ до застосунку, що працює на наборі Podʼів. Services можуть мати віртуальну IP-адресу в межах кластера (за допомогою Service з type: ClusterIP). Клієнти можуть підключатися за цією віртуальною IP-адресою, а Kubernetes балансує трафік до цього Service між різними Podʼами, що його обслуговують.
Як виділяються ClusterIP для Services?
Коли Kubernetes потрібно призначити віртуальну IP-адресу для Service, це відбувається одним із двох способів:
динамічно
панель управління кластера автоматично вибирає вільну IP-адресу з налаштованого діапазону IP для Services із type: ClusterIP.
статично
ви вказуєте IP-адресу на свій вибір із налаштованого діапазону IP для Services.
У всьому вашому кластері ClusterIP кожного Service має бути унікальним. Спроба створити Service із конкретним ClusterIP, який уже виділено, поверне помилку.
Навіщо резервувати Cluster IP для Services?
Іноді вам може знадобитися, щоб Services працювали на добре відомих IP-адресах, аби інші компоненти та користувачі в кластері могли ними користуватися.
Найкращий приклад — DNS Service для кластера. За неформальною домовленістю деякі інсталятори Kubernetes призначають DNS Service 10-ту IP-адресу з діапазону IP для Services. Припустимо, ви налаштували кластер із діапазоном IP для Services 10.96.0.0/16 і хочете, щоб IP-адресою вашого DNS Service була 10.96.0.10; тоді вам доведеться створити такий Service:
Але, як уже пояснювалося, IP-адресу 10.96.0.10 не зарезервовано. Якщо інші Services буде створено раніше або паралельно з динамічним виділенням, є ймовірність, що їм буде виділено цю IP-адресу. Тоді ви не зможете створити DNS Service, оскільки це завершиться помилкою конфлікту.
Як уникнути конфліктів ClusterIP для Services?
Стратегія виділення ClusterIP для Services, реалізована в Kubernetes, зменшує ризик колізій.
Діапазон ClusterIP поділено на основі формули min(max(16, cidrSize / 16), 256), яку можна описати так: ніколи не менше ніж 16 і не більше ніж 256, з поступовим кроком між ними.
Динамічне призначення IP стандартно використовує верхню смугу, а коли її вичерпано, використовує нижній діапазон. Це дає користувачам змогу робити статичні виділення в нижній смузі з низьким ризиком колізій.
Приклади
Приклад 1
У цьому прикладі використовується діапазон IP-адрес: 10.96.0.0/24 (нотація CIDR) для IP-адрес Services.
Розмір діапазону: 28 - 2 = 254
Зсув смуги: min(max(16, 256/16), 256) = min(16, 256) = 16
Початок статичної смуги: 10.96.0.1
Кінець статичної смуги: 10.96.0.16
Кінець діапазону: 10.96.0.254
pie showData
title 10.96.0.0/24
"Статичний" : 16
"Динамічний" : 238
Приклад 2
У цьому прикладі використовується діапазон IP-адрес: 10.96.0.0/20 (нотація CIDR) для IP-адрес Services.
Розмір діапазону: 212 - 2 = 4094
Зсув смуги: min(max(16, 4096/16), 256) = min(256, 256) = 256
Початок статичної смуги: 10.96.0.1
Кінець статичної смуги: 10.96.1.0
Кінець діапазону: 10.96.15.254
pie showData
title 10.96.0.0/20
"Статичний" : 256
"Динамічний" : 3838
Приклад 3
У цьому прикладі використовується діапазон IP-адрес: 10.96.0.0/16 (нотація CIDR) для IP-адрес Services.
Розмір діапазону: 216 - 2 = 65534
Зсув смуги: min(max(16, 65536/16), 256) = min(4096, 256) = 256
Початок статичної смуги: 10.96.0.1
Кінець статичної смуги: 10.96.1.0
Кінець діапазону: 10.96.255.254
pie showData
title 10.96.0.0/16
"Статичний" : 256
"Динамічний" : 65278
Якщо два Podʼи у вашому кластері хочуть взаємодіяти, і обидва Podʼи фактично працюють на одному вузлі, використовуйте політику внутрішнього трафіку Service, щоб утримувати мережевий трафік у межах цього вузла. Якщо уникнути проходження трафіку туди й назад через мережу кластера, це може допомогти з надійністю, продуктивністю (затримкою мережі та пропускною здатністю) або вартістю.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Політика внутрішнього трафіку Service дозволяє обмежити внутрішній трафік, маршрутизуючи його лише до точок доступу в межах вузла, з якого надійшов трафік. Тут «внутрішній» трафік означає трафік, який надходить від Podʼів у поточному кластері. Це може допомогти зменшити витрати та покращити продуктивність.
Використання політики внутрішнього трафіку Service
Ви можете увімкнути політику лише для внутрішнього трафіку для Service, встановивши його .spec.internalTrafficPolicy у Local. Це вказує kube-proxy використовувати для внутрішнього трафіку кластера лише локальні для вузла точки доступу.
Примітка:
Для Podʼів на вузлах без точок доступу для певного Service цей Service поводиться так, ніби в нього немає точок доступу (для Podʼів на цьому вузлі), навіть якщо він має точки доступу на інших вузлах.
У цьому прикладі показано, як виглядає Service, коли ви встановлюєте .spec.internalTrafficPolicy у Local:
kube-proxy фільтрує точки доступу, до яких він маршрутизує трафік, на основі параметра spec.internalTrafficPolicy. Коли встановлено Local, враховуються лише локальні для вузла точки доступу. Коли встановлено Cluster (стандартно) або параметр не встановлено, Kubernetes враховує всі точки доступу.
Томи Kubernetes дають контейнерам у Podʼі змогу отримувати доступ до даних і обмінюватися ними через файлову систему. Існують різні види томів, які можна використовувати для різних цілей, зокрема:
заповнення файлу конфігурації на основі ConfigMap або Secret
надання Podʼу тимчасового робочого простору
спільне використання файлової системи двома різними контейнерами в одному Podʼі
спільне використання файлової системи двома різними Podʼами (навіть якщо ці Podʼи працюють на різних вузлах)
надійне зберігання даних, щоб вони залишалися доступними, навіть якщо Pod перезапускається або замінюється
передавання конфігураційної інформації застосунку, що працює в контейнері, на основі відомостей про Pod, у якому перебуває контейнер (наприклад, повідомлення sidecar-контейнеру, у якому просторі імен працює Pod)
надання доступу лише для читання до даних в іншому образі контейнера
Обмін даними може відбуватися між різними локальними процесами всередині контейнера, або між різними контейнерами, або між Podʼами.
Чому томи важливі
Збереження даних: Файли на диску в контейнері є ефемерними, що створює певні проблеми для нетривіальних застосунків, які працюють у контейнерах. Одна з проблем виникає, коли контейнер аварійно завершує роботу або зупиняється: стан контейнера не зберігається, тому всі файли, створені або змінені протягом життя контейнера, втрачаються. Після аварійного завершення kubelet перезапускає контейнер із чистим станом.
Спільне сховище: Ще одна проблема виникає, коли в Pod працює кілька контейнерів, яким потрібно спільно використовувати файли. Налаштувати спільну файлову систему для всіх контейнерів і отримати до неї доступ може бути складно.
Абстракція тому в Kubernetes може допомогти розвʼязати обидві ці проблеми.
Перш ніж дізнатися про томи, PersistentVolumes та PersistentVolumeClaims, вам слід прочитати про Podʼи і переконатися, що ви розумієте, як Kubernetes використовує Podʼи для запуску контейнерів.
Як томи працюють
Kubernetes підтримує багато типів томів. Pod може використовувати будь-яку кількість типів томів одночасно. Типи ефемерних томів мають життєвий цикл, повʼязаний із конкретним Podʼом, а постійні томи існують довше за будь-який окремий Pod. Коли Pod припиняє існування, Kubernetes знищує ефемерні томи; однак Kubernetes не знищує постійні томи. Для будь-якого виду тому в певному Podʼі дані зберігаються під час перезапусків контейнерів.
По суті, том — це тека, можливо, з деякими даними, доступна контейнерам у Podʼі. Те, як ця тека зʼявляється, який носій її підтримує і який вона має вміст, визначається конкретним типом тому.
Щоб використати том, вкажіть томи, які потрібно надати Podʼу, у .spec.volumes і вкажіть, куди монтувати ці томи в контейнерах, у .spec.containers[*].volumeMounts.
Коли Pod запускається, процес у контейнері бачить файлову систему, складену з початкового вмісту образу контейнера і томів (якщо їх визначено), змонтованих усередині контейнера. Процес бачить кореневу файлову систему, яка спочатку відповідає вмісту образу контейнера. Будь-які записи в цій ієрархії файлової системи, якщо їх дозволено, впливають на те, що процес бачить під час наступного доступу до файлової системи. Томи монтуються за вказаними шляхами у файловій системі контейнера. Для кожного контейнера, визначеного в Podʼі, потрібно окремо вказати, куди монтувати кожен том, який він використовує.
Томи не можуть монтуватися всередині інших томів (але дивіться Використання subPath про споріднений механізм). Також том не може містити жорстке посилання на щось в іншому томі.
Типи томів
Kubernetes підтримує кілька типів томів.
configMap
ConfigMap надає спосіб вставляти конфігураційні дані в Podʼи. На дані, збережені в ConfigMap, можна посилатися в томі типу configMap, а потім їх використовуватимуть контейнеризовані застосунки, що працюють у Podʼі.
Посилаючись на ConfigMap, ви вказуєте в томі назву ConfigMap. Ви можете налаштувати шлях для конкретного запису в ConfigMap. Наведена нижче конфігурація показує, як змонтувати ConfigMap log-config у Pod з назвою configmap-pod:
apiVersion:v1kind:Podmetadata:name:configmap-podspec:containers:- name:testimage:busybox:1.28command:['sh','-c','echo "The app is running!" && tail -f /dev/null']volumeMounts:- name:config-volmountPath:/etc/configvolumes:- name:config-volconfigMap:name:log-configitems:- key:log_levelpath:log_level.conf
ConfigMap log-config монтується як том, і весь вміст, збережений у його записі log_level, монтується в Pod за шляхом /etc/config/log_level.conf. Зверніть увагу, що цей шлях утворюється з mountPath тому та path із ключем log_level.
Примітка:
Ви повинні створити ConfigMap, перш ніж ви зможете його використовувати.
ConfigMap завжди монтується як readOnly.
Контейнер, який використовує ConfigMap як монтування тому subPath, не отримуватиме оновлень, коли ConfigMap змінюється.
Текстові дані надаються у вигляді файлів у кодуванні UTF-8. Для інших кодувань символів використовуйте binaryData.
downwardAPI
Том downwardAPI робить дані downward API доступними для застосунків. У томі ви можете знайти надані дані у вигляді файлів лише для читання у форматі звичайного тексту.
Примітка:
Контейнер, який використовує downward API як монтування тому subPath, не отримує оновлень, коли значення полів змінюються.
Для Podʼа, який визначає том emptyDir, том створюється, коли Pod призначається вузлу. Як випливає з назви, том emptyDir спочатку порожній. Усі контейнери в Podʼі можуть читати й записувати ті самі файли в томі emptyDir, хоча цей том може бути змонтований за однаковими або різними шляхами в кожному контейнері. Коли Pod вилучається з вузла з будь-якої причини, дані в emptyDir видаляються назавжди.
Примітка:
Аварійне завершення контейнера не вилучає Pod із вузла. Дані в томі emptyDir зберігаються під час аварійних завершень контейнера.
Деякі способи використання emptyDir:
робочий простір, наприклад, для сортування злиттям на диску
контрольні точки тривалих обчислень для відновлення після збоїв
зберігання файлів, які отримує контейнер менеджера вмісту, поки контейнер вебсервера обслуговує ці дані
Поле emptyDir.medium визначає, де зберігаються томи emptyDir. Стандартно томи emptyDir зберігаються на носії вузла, наприклад, на диску, SSD або в мережевому сховищі, залежно від вашого середовища. Якщо встановити поле emptyDir.medium у "Memory", Kubernetes натомість монтує tmpfs (файлову систему в оперативній памʼяті). Хоча tmpfs дуже швидкий, памʼятайте, що, на відміну від дисків, файли, які ви записуєте, враховуються в обмеженні памʼяті контейнера, який їх записав.
Для стандартного носія можна вказати обмеження розміру, яке обмежує місткість тому emptyDir. Простір виділяється з тимчасового сховища вузла. Якщо воно заповниться з іншого джерела (наприклад, файлами логів або накладеннями образів), місце в emptyDir може закінчитися раніше, ніж буде досягнуто цього обмеження. Якщо розмір не вказано, томи в памʼяті отримують розмір, що дорівнює памʼяті вузла, доступній для розподілу.
Увага:
Перегляньте тут моменти, які слід врахувати щодо керування ресурсами під час використання emptyDir у памʼяті.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the EmptyDirVolumeMode feature gate for all relevant components in your cluster.
Поле emptyDir.mode дозволяє встановити біти дозволів Unix на теці emptyDir, вказавши значення від 0000 до 01777 (у вісімковій системі). Це відповідає тому самому шаблону, що й поле defaultMode у томах Secret і ConfigMap. Якщо mode не вказано, тека створюється зі стандартними дозволами 0777.
Встановлення власного режиму корисне, коли ви хочете обмежити доступ лише власником і групою (наприклад, 0750) або встановити sticky bit на спільній теці, щоб лише власники файлів могли видаляти свої файли (наприклад, 01777).
Примітка:
Якщо fsGroup встановлено в контексті безпеки Podʼа, групові дозволи, застосовані fsGroup, перевизначають mode, вказаний тут. Поле mode не впливає на Windows.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the InPlacePodVerticalScalingMemoryBackedVolumes feature gate for all relevant components in your cluster.
Коли функціональну можливість InPlacePodVerticalScalingMemoryBackedVolumes ввімкнено, ви можете динамічно змінювати sizeLimit томів emptyDir у памʼяті (medium: Memory) без перезапуску Podʼа або його контейнерів.
Тип тому fc дозволяє монтувати в Pod наявний блоковий том сховища Fibre Channel. Ви можете вказати одне чи кілька цільових всесвітніх імен (world wide names, WWN) за допомогою параметра targetWWNs у конфігурації тому. Якщо вказано кілька WWN, targetWWNs очікує, що ці WWN належать до багатошляхових зʼєднань.
Примітка:
Ви повинні заздалегідь налаштувати зонування FC SAN, щоб виділити та маскувати ці LUN (томи) для цільових WWN, щоб хости Kubernetes могли отримати до них доступ.
gcePersistentDisk (застаріло)
У Kubernetes 1.37 усі операції для вбудованого типу gcePersistentDisk перенаправляються на драйвер CSIpd.csi.storage.gke.io.
Вбудований драйвер сховища gcePersistentDisk визнано застарілим у випуску Kubernetes v1.17, а потім повністю вилучено у випуску v1.28.
Kubernetes 1.37 не містить драйвера томів gitRepo. Останньою версією, яка надавала можливість використовувати цей драйвер, була Kubernetes v1.35, а застарілим він став із мінорного випуску v1.11.
Щоб надати Pod зі змонтованим репозиторієм Git, ви можете змонтувати том emptyDir в init-контейнер, який клонує репозиторій за допомогою Git, а потім змонтувати EmptyDir у контейнер Podʼа.
Ви можете обмежити використання томів gitRepo у своєму кластері за допомогою політик, таких як ValidatingAdmissionPolicy. Ви можете використати наведений нижче вираз Common Expression Language (CEL) як частину політики, щоб відхиляти використання томів gitRepo:
Том hostPath монтує файл або теку з файлової системи вузла-хоста у ваш Pod. Більшості Podʼів це не потрібно, але це потужний запасний вихід для деяких застосунків.
Попередження:
Використання типу тому hostPath створює багато ризиків для безпеки. Якщо можете уникнути використання тому hostPath, зробіть це. Наприклад, натомість визначте й використовуйте local PersistentVolume.
Якщо ви обмежуєте доступ до певних тек на вузлі за допомогою перевірки під час допуску, це обмеження є ефективним лише тоді, коли ви додатково вимагаєте, щоб усі монтування цього тому hostPath були лише для читання. Якщо ви дозволяєте ненадійному Podʼу монтувати будь-який шлях хоста для читання й запису, контейнери цього Podʼа можуть зловжити цим монтуванням хоста для читання й запису.
Будьте обережні, використовуючи томи hostPath, незалежно від того, чи монтуються вони лише для читання, чи для читання й запису, оскільки:
Доступ до файлової системи хоста може розкрити привілейовані системні облікові дані (наприклад, для kubelet) або привілейовані API (наприклад, сокет середовища виконання контейнерів), які можна використати для виходу з контейнера або для атаки на інші частини кластера.
Podʼи з однаковою конфігурацією (наприклад, створені з PodTemplate) можуть поводитися по-різному на різних вузлах через різні файли на вузлах.
Використання тому hostPath не вважається використанням ефемерного сховища. Ви маєте самостійно стежити за використанням диска, оскільки надмірне використання диска томами hostPath призведе до тиску на диск вузла.
Деякі способи використання hostPath:
запуск контейнера, якому потрібен доступ до системних компонентів рівня вузла (наприклад, контейнера, який передає системні логи до центрального місця, отримуючи доступ до цих логів через монтування /var/log лише для читання)
надання конфігураційного файлу, що зберігається на хост-системі, у режимі лише для читання статичному Podʼу; на відміну від звичайних Podʼів, статичні Podʼи не можуть отримувати доступ до ConfigMaps
Типи томів hostPath
Крім обовʼязкової властивості path, ви можете за потреби вказати type для тому hostPath.
Доступні значення для type:
Значення
Поведінка
""
Порожній рядок (стандартно) призначений для зворотної сумісності й означає, що перед монтуванням тому hostPath перевірки не виконуватимуться.
DirectoryOrCreate
Якщо за вказаним шляхом нічого немає, там за потреби буде створено порожню теку з дозволами 0755, з тією самою групою та власником, що й у kubelet.
Directory
Тека має існувати за вказаним шляхом.
FileOrCreate
Якщо за вказаним шляхом нічого немає, там за потреби буде створено порожній файл із дозволами 0644, з тією самою групою та власником, що й у kubelet.
File
Повинен існувати файл за вказаним шляхом.
Socket
Має існувати UNIX-сокет за вказаним шляхом.
CharDevice
(Лише вузли Linux) Має існувати символьний пристрій за вказаним шляхом.
BlockDevice
(Лише вузли Linux) Має існувати блоковий пристрій за вказаним шляхом.
Увага:
Режим FileOrCreateне створює батьківську теку файлу. Якщо батьківської теки змонтованого файлу не існує, Podʼу не вдасться запуститися. Щоб забезпечити роботу цього режиму, можна спробувати монтувати теки та файли окремо, як показано в прикладі FileOrCreate для hostPath.
Деякі файли або теки, створені на базових хостах, можуть бути доступні лише користувачу root. Тоді вам потрібно або запускати процес як root у привілейованому контейнері, або змінити дозволи файлів на хості, щоб читати з тому hostPath або записувати в нього.
Приклад конфігурації hostPath
---# Цей маніфест монтує /data/foo на вузлі як /foo всередині# єдиного контейнера, який працює в межах Podʼа hostpath-example-linux## Монтування в контейнер тільки для читанняapiVersion:v1kind:Podmetadata:name:hostpath-example-linuxspec:os:{name:linux }nodeSelector:kubernetes.io/os:linuxcontainers:- name:example-containerimage:registry.k8s.io/test-webservervolumeMounts:- mountPath:/fooname:example-volumereadOnly:truevolumes:- name:example-volume# монтувати /data/foo, але тільки якщо ця тека вже існуєhostPath:path:/data/foo# розташування теки на вузліtype:Directory# це поле є необовʼязковим
---# Цей маніфест монтує C:\Data\foo на вузлі як C:\foo всередині# єдиного контейнера, який працює в межах Podʼа hostpath-example-windows## Монтування в контейнер тільки для читанняapiVersion:v1kind:Podmetadata:name:hostpath-example-windowsspec:os:{name:windows }nodeSelector:kubernetes.io/os:windowscontainers:- name:example-containerimage:microsoft/windowsservercore:1709volumeMounts:- name:example-volumemountPath:"C:\\foo"readOnly:truevolumes:# монтувати C:\Data\foo з вузла, але тільки якщо ця тека вже існує- name:example-volumehostPath:path:"C:\\Data\\foo"# розташування теки на вузліtype:Directory # це поле є необовʼязковим
Приклад конфігурації hostPath для FileOrCreate
У наведеному нижче маніфесті визначено Pod, який монтує /var/local/aaa всередині єдиного контейнера Podʼа. Якщо на вузлі ще немає шляху /var/local/aaa, kubelet створює його як теку, а потім монтує в Pod.
Якщо /var/local/aaa вже існує, але не є текою, Pod завершується збоєм. Крім того, kubelet намагається створити файл /var/local/aaa/1.txt усередині цієї теки (з погляду хоста); якщо за цим шляхом уже щось існує і це не звичайний файл, Pod завершується збоєм.
Том розвʼязується під час запуску Podʼа залежно від значення pullPolicy:
Always
kubelet завжди намагається завантажити посилання. Якщо завантаження не вдається, kubelet переводить Pod у стан Failed.
Never
kubelet ніколи не завантажує посилання й використовує лише локальний образ або артефакт. Pod переходить у стан Failed, якщо будь-які шари образу ще не присутні локально або якщо маніфест цього образу ще не закешовано.
IfNotPresent
kubelet завантажує посилання, якщо його ще немає на диску. Pod переходить у стан Failed, якщо посилання немає й завантаження не вдається.
Том розвʼязується повторно, якщо Pod видаляють і створюють заново, тобто новий віддалений вміст стане доступним після повторного створення Podʼа. Збій розвʼязання або завантаження образу під час запуску Podʼа заблокує запуск контейнерів і може додати значну затримку. Спроби після збоїв повторюватимуться за звичайним механізмом backoff для томів, а про збої буде повідомлено в полях reason і message Podʼа.
Типи обʼєктів, які може монтувати цей том, визначаються реалізацією середовища виконання контейнерів на хост-машині. Вони мають включати щонайменше всі дійсні типи, які підтримує поле образу контейнера. Обʼєкт OCI монтується в одну теку (spec.containers[*].volumeMounts[*].mountPath) і лише для читання.
Крім того:
Монтування subPath або subPathExpr для контейнерів (spec.containers[*].volumeMounts[*].subPath, spec.containers[*].volumeMounts[*].subPathExpr) підтримуються лише починаючи з Kubernetes v1.33.
Поле spec.securityContext.fsGroupChangePolicy не має жодного ефекту для цього типу тому.
Посилання на артефакт, який слід використовувати. Наприклад, ви можете вказати registry.k8s.io/conformance:v1.37.0, щоб завантажити файли з образу тестів на відповідність Kubernetes. Працює так само, як pod.spec.containers[*].image. Секрети завантаження образів збираються так само, як для образу контейнера: шляхом пошуку облікових даних вузла, секретів завантаження образів ServiceAccount і секретів завантаження образів зі специфікації Podʼа. Це поле є необовʼязковим, щоб керування конфігурацією вищого рівня могло задавати стандартні значення або перевизначати образи контейнерів у контролерах робочих навантажень, таких як Deployments і StatefulSets. Докладніше про образи контейнерів.
pullPolicy
Політика завантаження обʼєктів OCI. Можливі значення: Always, Never або IfNotPresent. Стандартно Always, якщо вказано теґ :latest, інакше IfNotPresent.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.35; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the ImageVolumeWithDigest feature gate for all relevant components in your cluster.
Якщо у вашому кластері ввімкнено функціональну можливість ImageVolumeWithDigest, то щоразу, коли ви вказуєте том image для Podʼа, kubelet оновлює статус Podʼа, щоб записати digest образу контейнера, який використовується як джерело тому.
Ось спрощений приклад запущеного Podʼа у вигляді YAML, зокрема з оновленням статусу. Зверніть увагу на нове поле ImageRef у volumeMounts у статусі контейнера.
Том iscsi дозволяє монтувати наявний том iSCSI (SCSI через IP) у ваш Pod. На відміну від emptyDir, який стирається, коли Pod вилучається, вміст тому iscsi зберігається, а том лише розмонтовується. Це означає, що том iSCSI можна попередньо заповнити даними, і ці дані можна спільно використовувати між Podʼами.
Примітка:
Вам потрібно мати власний сервер iSCSI, на якому створено том, перш ніж ви зможете його використовувати.
Особливість iSCSI полягає в тому, що його можуть одночасно монтувати кілька споживачів лише для читання. Це означає, що ви можете попередньо заповнити том своїм набором даних, а потім паралельно надавати його зі стількох Podʼів, скільки потрібно. На жаль, томи iSCSI може монтувати лише один споживач у режимі читання й запису. Одночасний запис не дозволений.
local
Том local представляє змонтований локальний пристрій зберігання, такий як диск, розділ або тека.
Локальні томи можна використовувати лише як статично створені PersistentVolume. Динамічне надання не підтримується.
Порівняно з томами hostPath, томи local використовуються довговічно й переносно, без ручного планування Podʼів на вузли. Система знає про обмеження вузла для тому, переглядаючи спорідненість вузла в PersistentVolume.
Однак томи local залежать від доступності базового вузла й підходять не для всіх застосунків. Якщо вузол стає несправним, том local стає недоступним для Podʼа. Pod, який використовує цей том, не може працювати. Застосунки, що використовують томи local, мають бути здатні витримувати таку знижену доступність, а також потенційну втрату даних, залежно від характеристик надійності базового диска.
У наведеному нижче прикладі показано PersistentVolume, що використовує том local і nodeAffinity:
Під час використання томів local потрібно встановити nodeAffinity у PersistentVolume. Планувальник Kubernetes використовує nodeAffinity PersistentVolume, щоб планувати ці Podʼи на правильний вузол.
volumeMode PersistentVolume можна встановити в "Block" (замість стандартного значення "Filesystem"), щоб надати локальний том як необроблений блоковий пристрій.
Під час використання локальних томів рекомендується створити StorageClass із volumeBindingMode, встановленим у WaitForFirstConsumer. Докладніше дивіться в прикладі StorageClass для локальних томів. Відкладена привʼязка томів гарантує, що рішення про привʼязку PersistentVolumeClaim також враховуватиме інші обмеження вузла, які може мати Pod, такі як вимоги до ресурсів вузла, селектори вузлів, спорідненість і антиспорідненість Podʼів.
Для кращого керування життєвим циклом локального тому можна окремо запустити зовнішній статичний provisioner. Зверніть увагу, що цей provisioner поки не підтримує динамічне надання. Приклад запуску зовнішнього локального provisioner дивіться в посібнику користувача local volume provisioner.
Примітка:
Локальний PersistentVolume потребує ручного очищення й видалення користувачем, якщо для керування життєвим циклом тому не використовується зовнішній статичний provisioner.
nfs
Том nfs дозволяє монтувати наявний спільний ресурс NFS (Network File System) у Pod. На відміну від emptyDir, який стирається, коли Pod вилучається, вміст тому nfs зберігається, а том лише розмонтовується. Це означає, що том NFS можна попередньо заповнити даними, і ці дані можна спільно використовувати між Podʼами. NFS можуть одночасно монтувати кілька записувачів.
Щоб використовувати NFS, потрібно мати власний запущений сервер NFS з експортованим спільним ресурсом.
Також зверніть увагу, що ви не можете вказувати параметри монтування NFS у специфікації Podʼа. Ви можете встановити параметри монтування на боці сервера або використовувати /etc/nfsmount.conf. Ви також можете монтувати томи NFS через PersistentVolumes, які дозволяють встановлювати параметри монтування.
persistentVolumeClaim
Том persistentVolumeClaim використовується для монтування PersistentVolume у Pod. PersistentVolumeClaims — це спосіб для користувачів «запросити» надійне сховище (наприклад, том iSCSI), не знаючи деталей конкретного хмарного середовища.
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.25
portworxVolume — це еластичний рівень блокового сховища, який працює в гіперконвергентному режимі з Kubernetes. Portworx визначає відбитки сховища на сервері, розподіляє його за рівнями на основі можливостей і агрегує місткість на кількох серверах. Portworx працює в гостьовій системі віртуальних машин або на вузлах Linux без віртуалізації (bare metal).
portworxVolume можна створити динамічно через Kubernetes або попередньо надати й послатися на нього в Podʼі. Ось приклад Podʼа, який посилається на попередньо наданий том Portworx:
apiVersion:v1kind:Podmetadata:name:test-portworx-volume-podspec:containers:- image:registry.k8s.io/test-webservername:test-containervolumeMounts:- mountPath:/mntname:pxvolvolumes:- name:pxvol# Цей том Portworx повинен вже існувати.portworxVolume:volumeID:"pxvol"fsType:"<fs-type>"
Примітка:
Переконайтеся, що у вас є наявний PortworxVolume з назвою pxvol, перш ніж використовувати його в Podʼі.
Міграція на Portworx CSI
This is a stable feature in Kubernetes, and has been since the 1.33 release. You can no longer toggle this feature (the associated feature gate has been removed).
У Kubernetes 1.37 усі операції для вбудованих томів Portworx стандартно перенаправляються на драйвер Container Storage Interface (CSI) pxd.portworx.com. Portworx CSI Driver має бути встановлений у кластері.
projected
Проєкційний том зіставляє кілька наявних джерел томів з однією текою. Докладніше дивіться проєкційні томи.
secret
Том secret використовується для передавання конфіденційної інформації, такої як паролі, у Podʼи. Ви можете зберігати Secrets в API Kubernetes і монтувати їх як файли для використання Podʼами без прямої привʼязки до Kubernetes. Томи secret підтримуються tmpfs (файловою системою в оперативній памʼяті), тому вони ніколи не записуються на енергонезалежне сховище.
Примітка:
Ви повинні створити Secret в API Kubernetes, перш ніж ви зможете його використовувати.
Secret завжди монтується як readOnly.
Контейнер, який використовує Secret як монтування тому subPath, не отримуватиме оновлень Secret.
Іноді корисно спільно використовувати один том для кількох цілей в одному Podʼі. Властивість volumeMounts[*].subPath задає підшлях усередині вказаного тому замість його кореня.
У наведеному нижче прикладі показано, як налаштувати Pod зі стеком LAMP (Linux, Apache, MySQL, PHP) за допомогою одного спільного тому. Цю конфігурацію subPath не рекомендується використовувати в промисловому середовищі.
Код і ресурси PHP-застосунку зіставляються з текою html тому, а база даних MySQL зберігається в теці mysql тому. Наприклад:
Використання subPath із розширеними змінними середовища
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.17
Використовуйте поле subPathExpr, щоб будувати назви тек subPath зі змінних середовища downward API. Властивості subPath та subPathExpr є взаємовиключними.
У цьому прикладі Pod використовує subPathExpr, щоб створити теку pod1 усередині тому hostPath/var/log/pods. Том hostPath отримує назву Pod із downwardAPI. Тека хоста /var/log/pods/pod1 монтується в /logs у контейнері.
apiVersion:v1kind:Podmetadata:name:pod1spec:containers:- name:container1env:- name:POD_NAMEvalueFrom:fieldRef:apiVersion:v1fieldPath:metadata.nameimage:busybox:1.28command:["sh","-c","while [ true ]; do echo 'Hello'; sleep 10; done | tee -a /logs/hello.txt"]volumeMounts:- name:workdir1mountPath:/logs# Для змінних використовуються круглі дужки (не фігурні).subPathExpr:$(POD_NAME)restartPolicy:Nevervolumes:- name:workdir1hostPath:path:/var/log/pods
Ресурси
Носій (наприклад, диск або SSD) тому emptyDir визначається носієм файлової системи, на якій розташована коренева тека kubelet (зазвичай /var/lib/kubelet). Немає обмежень на те, скільки місця може використовувати том emptyDir або hostPath, і немає ізоляції між контейнерами або Podʼами.
Щоб дізнатися про запит місця за допомогою специфікації ресурсів, дивіться як керувати ресурсами.
Зовнішні втулки томів
До зовнішніх втулків томів належать Container Storage Interface (CSI), а також FlexVolume (застарілий). Ці втулки дозволяють постачальникам сховищ створювати власні втулки сховища, не додаючи їхній вихідний код до репозиторію Kubernetes.
Раніше всі втулки томів були «вбудованими». «Вбудовані» втулки збиралися, компонувалися, компілювалися й постачалися разом з основними бінарними файлами Kubernetes. Це означало, що додавання нової системи зберігання до Kubernetes (втулка томів) вимагало внесення коду в основний репозиторій коду Kubernetes.
І CSI, і FlexVolume дозволяють розробляти втулки томів незалежно від кодової бази Kubernetes і розгортати (встановлювати) їх у кластерах Kubernetes як розширення.
Постачальникам сховищ, які хочуть створити зовнішній втулок томів, варто звернутися до FAQ про втулки томів.
csi
Container Storage Interface (CSI) визначає стандартний інтерфейс для систем оркестрування контейнерів (таких як Kubernetes), щоб надавати довільні системи зберігання своїм контейнерним робочим навантаженням.
Підтримку версій специфікації CSI 0.2 та 0.3 визнано застарілою в Kubernetes v1.13, і її буде вилучено в майбутньому випуску.
Примітка:
Драйвери CSI можуть бути сумісними не з усіма випусками Kubernetes. Перевірте в документації конкретного драйвера CSI підтримувані кроки розгортання для кожного випуску Kubernetes і матрицю сумісності.
Після розгортання сумісного з CSI драйвера томів у кластері Kubernetes користувачі можуть використовувати тип тому csi, щоб підʼєднувати або монтувати томи, які надає драйвер CSI.
Том csi можна використовувати в Podʼі трьома різними способами:
Адміністратори сховища можуть використовувати такі поля для налаштування постійного тому CSI:
driver: Рядкове значення, яке задає назву драйвера томів. Це значення має відповідати значенню, яке драйвер CSI повертає в GetPluginInfoResponse, як визначено в специфікації CSI. Kubernetes використовує його, щоб визначити, який драйвер CSI викликати, а компоненти драйвера CSI — щоб визначити, які обʼєкти PV належать цьому драйверу CSI.
volumeHandle: Рядкове значення, яке унікально ідентифікує том. Це значення має відповідати значенню, яке драйвер CSI повертає в полі volume.id відповіді CreateVolumeResponse, як визначено в специфікації CSI. Значення передається як volume_id в усіх викликах драйвера томів CSI під час посилання на том.
readOnly: Необовʼязкове булеве значення, яке вказує, чи має том бути "ControllerPublished" (підʼєднаний) лише для читання. Стандартно false. Це значення передається драйверу CSI через поле readonly у ControllerPublishVolumeRequest.
fsType: Якщо VolumeMode PV має значення Filesystem, це поле можна використати для вказання файлової системи, яку слід використовувати для монтування тому. Якщо том не відформатовано й форматування підтримується, це значення буде використано для форматування тому. Це значення передається драйверу CSI через поле VolumeCapability у ControllerPublishVolumeRequest, NodeStageVolumeRequest та NodePublishVolumeRequest.
volumeAttributes: Мапа рядків на рядки, яка задає статичні властивості тому. Ця мапа має відповідати мапі, яку драйвер CSI повертає в полі volume.attributes відповіді CreateVolumeResponse, як визначено в специфікації CSI. Мапа передається драйверу CSI через поле volume_context у ControllerPublishVolumeRequest, NodeStageVolumeRequest та NodePublishVolumeRequest.
controllerPublishSecretRef: Посилання на обʼєкт Secret, що містить конфіденційну інформацію, яку слід передати драйверу CSI для завершення викликів CSI ControllerPublishVolume та ControllerUnpublishVolume. Це поле є необовʼязковим і може бути порожнім, якщо Secret не потрібен. Якщо Secret містить більше одного секрету, передаються всі секрети.
nodeExpandSecretRef: Посилання на Secret, що містить конфіденційну інформацію, яку слід передати драйверу CSI для завершення виклику CSI NodeExpandVolume. Це поле є необовʼязковим і може бути порожнім, якщо Secret не потрібен. Якщо обʼєкт містить більше одного секрету, передаються всі секрети. Коли ви налаштували секретні дані для розширення тому, ініційованого вузлом, kubelet передає ці дані драйверу CSI через виклик NodeExpandVolume(). Усі підтримувані версії Kubernetes пропонують поле nodeExpandSecretRef і стандартно роблять його доступним. Випуски Kubernetes до v1.25 не мали цієї підтримки.
Увімкніть функціональну можливість CSINodeExpandSecret для кожного kube-apiserver і для kubelet на кожному вузлі. Починаючи з Kubernetes 1.27, цю можливість стандартно ввімкнено, і явно вмикати функціональну можливість не потрібно. Ви також повинні використовувати драйвер CSI, який підтримує або потребує секретних даних під час операцій зміни розміру сховища, ініційованих вузлом.
nodePublishSecretRef: Посилання на обʼєкт Secret, що містить конфіденційну інформацію, яку слід передати драйверу CSI для завершення виклику CSI NodePublishVolume. Це поле є необовʼязковим і може бути порожнім, якщо Secret не потрібен. Якщо обʼєкт Secret містить більше одного секрету, передаються всі секрети.
nodeStageSecretRef: Посилання на обʼєкт Secret, що містить конфіденційну інформацію, яку слід передати драйверу CSI для завершення виклику CSI NodeStageVolume. Це поле є необовʼязковим і може бути порожнім, якщо Secret не потрібен. Якщо Secret містить більше одного секрету, передаються всі секрети.
Підтримка необроблених блокових томів CSI
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.18
Постачальники зовнішніх драйверів CSI можуть реалізувати підтримку необроблених блокових томів у робочих навантаженнях Kubernetes.
Ви можете безпосередньо налаштувати томи CSI у специфікації Podʼа. Томи, вказані таким способом, є ефемерними й не зберігаються після перезапуску Podʼа. Докладніше дивіться в Ефемерні томи.
Втулки вузла CSI мають виконувати різні привілейовані операції, такі як сканування дискових пристроїв і монтування файлових систем. Ці операції відрізняються для кожної операційної системи хоста. На робочих вузлах Linux контейнеризовані втулки вузла CSI зазвичай розгортаються як привілейовані контейнери. На робочих вузлах Windows привілейовані операції для контейнеризованих втулків вузла CSI підтримуються за допомогою csi-proxy — автономного бінарного файлу, що підтримується спільнотою й має бути попередньо встановлений на кожному вузлі Windows.
Докладніше дивіться в посібнику з розгортання втулка CSI, який ви хочете розгорнути.
Міграція на драйвери CSI з вбудованих втулків
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Можливість CSIMigration спрямовує операції щодо наявних вбудованих втулків до відповідних втулків CSI (які мають бути встановлені й налаштовані). Завдяки цьому операторам не потрібно змінювати конфігурацію наявних класів сховища, PersistentVolumes або PersistentVolumeClaims (які посилаються на вбудовані втулки) під час переходу на драйвер CSI, що замінює вбудований втулок.
Примітка:
Наявні PV, створені вбудованим втулком томів, можна й надалі використовувати без будь-яких змін конфігурації, навіть після завершення міграції на CSI для цього типу тому і навіть після оновлення до версії Kubernetes, у якій немає вкомпільованої підтримки цього типу сховища.
У межах цієї міграції ви або інший адміністратор кластера повинні встановити й налаштувати відповідний драйвер CSI для цього сховища. Ядро Kubernetes не встановлює це програмне забезпечення за вас.
Після цієї міграції ви також можете визначати нові PVC і PV, які посилаються на застарілі вбудовані інтеграції сховищ. Якщо відповідний драйвер CSI встановлено й налаштовано, створення PV і далі працює, навіть для зовсім нових томів. Фактичне керування сховищем тепер відбувається через драйвер CSI.
Підтримувані операції та можливості включають: надання/видалення, підʼєднання/відʼєднання, монтування/розмонтування та зміну розміру томів.
Вбудовані втулки, які підтримують CSIMigration і мають відповідний реалізований драйвер CSI, перелічено в розділі Типи томів.
flexVolume (застаріло)
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.23
FlexVolume — це інтерфейс зовнішніх втулків, який використовує модель на основі exec для взаємодії з драйверами сховища. Бінарні файли драйверів FlexVolume мають бути встановлені в попередньо визначеному шляху втулків томів на кожному вузлі, а в деяких випадках і на вузлах панелі управління.
Podʼи взаємодіють із драйверами FlexVolume через вбудований втулок томів flexVolume.
Такі втулки FlexVolume, розгорнуті як сценарії PowerShell на хості, підтримують вузли Windows:
FlexVolume застарів. Рекомендований спосіб інтеграції зовнішнього сховища з Kubernetes — використовувати зовнішній драйвер CSI.
Супровідники драйвера FlexVolume мають реалізувати драйвер CSI й допомогти користувачам драйверів FlexVolume перейти на CSI. Користувачі FlexVolume мають перевести свої робочі навантаження на еквівалентний драйвер CSI.
Поширення монтування
Увага:
Поширення монтування — це низькорівнева можливість, яка не працює однаково на всіх типах томів. Проєкт Kubernetes рекомендує використовувати поширення монтування лише з томами hostPath або emptyDir у памʼяті. Докладніше дивіться в issue Kubernetes #95049.
Поширення монтування дозволяє надавати томи, змонтовані контейнером, іншим контейнерам у тому самому Podʼі або навіть іншим Podʼам на тому самому вузлі.
Поширення монтування тому контролюється полем mountPropagation у containers[*].volumeMounts. Його значення:
None — Це монтування тому не отримуватиме жодних подальших монтувань, які хост монтує в цей том або будь-яку його підтеку. Так само жодні монтування, створені контейнером, не будуть видимі на хості. Це стандартний режим.
Цей режим еквівалентний поширенню монтування rprivate, як описано в mount(8)
Однак середовище виконання CRI може вибрати поширення монтування rslave (тобто HostToContainer), коли поширення rprivate незастосовне. Відомо, що cri-dockerd (Docker) вибирає поширення монтування rslave, коли джерело монтування містить кореневу теку демона Docker (/var/lib/docker).
HostToContainer — Це монтування тому отримуватиме всі подальші монтування, які монтуються в цей том або будь-яку його підтеку.
Іншими словами, якщо хост монтує щось усередині монтування тому, контейнер побачить, що це там змонтовано.
Так само, якщо будь-який Pod із поширенням монтування Bidirectional на той самий том монтує туди щось, контейнер із поширенням монтування HostToContainer це побачить.
Цей режим еквівалентний поширенню монтування rslave, як описано в mount(8)
Bidirectional — Це монтування тому поводиться так само, як монтування HostToContainer. Крім того, усі монтування томів, створені контейнером, поширюватимуться назад на хост і на всі контейнери всіх Podʼів, які використовують той самий том.
Звичайний випадок використання цього режиму — Pod із драйвером FlexVolume або CSI чи Pod, якому потрібно щось змонтувати на хості за допомогою тому hostPath.
Цей режим еквівалентний поширенню монтування rshared, як описано в mount(8)
Попередження:
Поширення монтування Bidirectional може бути небезпечним. Воно може пошкодити операційну систему хоста, тому дозволене лише в привілейованих контейнерах. Наполегливо рекомендується знати поведінку ядра Linux. Крім того, усі монтування томів, створені контейнерами в Podʼах, мають бути знищені (розмонтовані) контейнерами під час завершення роботи.
Монтування лише для читання
Монтування можна зробити лише для читання, встановивши поле .spec.containers[*].volumeMounts[*].readOnly у true. Це не робить сам том доступним лише для читання, але конкретний контейнер не зможе записувати в нього. Інші контейнери в Podʼі можуть монтувати той самий том для читання й запису.
У Linux монтування лише для читання стандартно не є рекурсивними. Наприклад, розгляньмо Pod, який монтує /mnt хоста як том hostPath. Якщо в /mnt/<SUBMOUNT> змонтовано для читання й запису іншу файлову систему (таку як tmpfs, NFS або USB-сховище), том, змонтований у контейнері(ах), також матиме /mnt/<SUBMOUNT> із можливістю запису, навіть якщо саме монтування вказано як лише для читання.
Рекурсивні монтування лише для читання
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.30 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate RecursiveReadOnlyMounts, Kubernetes ignores it but does not report any error.
Рекурсивні монтування лише для читання можна ввімкнути, встановивши функціональну можливість RecursiveReadOnlyMounts для kubelet і kube-apiserver та встановивши поле .spec.containers[*].volumeMounts[*].recursiveReadOnly для Podʼа.
Допустимі значення:
Disabled (стандартно): без ефекту.
Enabled: робить монтування рекурсивно лише для читання. Потрібно виконати всі такі вимоги:
readOnly встановлено в true
mountPropagation не встановлено або встановлено в None
Хост працює з ядром Linux v5.12 або новіше
Середовище виконання контейнерів рівня CRI підтримує рекурсивні монтування лише для читання
Середовище виконання контейнерів рівня OCI підтримує рекурсивні монтування лише для читання.
Якщо хоча б одна з цих умов не виконується, монтування завершиться збоєм.
IfPossible: намагається застосувати Enabled і повертається до Disabled, якщо можливість не підтримується ядром або класом середовища виконання.
apiVersion:v1kind:Podmetadata:name:rrospec:volumes:- name:mnthostPath:# tmpfs is mounted on /mnt/tmpfspath:/mntcontainers:- name:busyboximage:busyboxargs:["sleep","infinity"]volumeMounts:# /mnt-rro/tmpfs is not writable- name:mntmountPath:/mnt-rroreadOnly:truemountPropagation:NonerecursiveReadOnly:Enabled# /mnt-ro/tmpfs is writable- name:mntmountPath:/mnt-roreadOnly:true# /mnt-rw/tmpfs is writable- name:mntmountPath:/mnt-rw
Коли цю властивість розпізнають kubelet і kube-apiserver, поле .status.containerStatuses[*].volumeMounts[*].recursiveReadOnly встановлюється в Enabled або Disabled.
Власник файлу
Групова власність (GID)
Групова власність файлів тому (GID) контролюється полем spec.securityContext.fsGroup Podʼа.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the AtomicWriteVolumeUserFields feature gate for all relevant components in your cluster.
Встановлення функціональної можливості AtomicWriteVolumeUserFields вмикає поля власності користувача файлів (UID) томів configMap, secret, downwardAPI та projected.
Коли defaultUser вказано на рівні тому, він встановлює UID власника для всіх його файлів даних під час створення. На рівні елемента поле user контролює UID власника окремого файлу та має перевагу над defaultUser.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Відомо, що такі середовища виконання контейнерів підтримують рекурсивні монтування лише для читання.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the VolumeBindMountOptions feature gate for all relevant components in your cluster.
Поле .spec.containers[*].volumeMounts[*].bindMountOptions дозволяє вам застосовувати повʼязані з безпекою прапорці bind mount Linux до будь-якого монтування тому. Допустимі значення:
noexec — запобігає виконанню бінарних файлів на змонтованому томі
nodev — ігнорує спеціальні файли пристроїв на змонтованому томі
nosuid — ігнорує біти set-user-identifier або set-group-identifier на змонтованому томі
Ці параметри застосовуються для кожного контейнера, тому різні контейнери в одному Podʼі можуть монтувати той самий том із різними параметрами bind mount. Поле не підтримується з томами образів.
Примітка:
Середовище виконання контейнерів (таке як containerd або CRI-O) повинно підтримувати поле mount_options у повідомленні CRI Mount. Якщо середовище виконання не повідомляє про підтримку, kubelet відхиляє Podʼи, які використовують bindMountOptions. Це поле не впливає на вузли Windows.
Керування сховищем — це окреме завдання, відмінне від керування обчислювальними екземплярами. Підсистема PersistentVolume надає користувачам та адміністраторам API, який абстрагує деталі того, як сховище надається, від того, як воно споживається. Для цього ми запроваджуємо два нові ресурси API: PersistentVolume і PersistentVolumeClaim.
PersistentVolume (PV) — це частина сховища в кластері, надана адміністратором або динамічно за допомогою класів сховищ. Це ресурс у кластері, так само як вузол є ресурсом кластера. PV — це втулки томів, як і Volumes, але їхній життєвий цикл не залежить від будь-якого окремого Podʼа, який використовує PV. Цей обʼєкт API містить деталі реалізації сховища, чи то NFS, iSCSI, чи специфічна для хмарного провайдера система зберігання.
PersistentVolumeClaim (PVC) — це запит користувача на сховище. Він схожий на Pod. Podʼи споживають ресурси вузла, а PVC споживають ресурси PV. Podʼи можуть запитувати певні обсяги ресурсів (CPU та памʼять). PVC можуть запитувати певний розмір і режими доступу (наприклад, їх можна монтувати як ReadWriteOnce, ReadOnlyMany, ReadWriteMany або ReadWriteOncePod, дивіться AccessModes).
Хоча PersistentVolumeClaims дозволяють користувачам споживати абстрактні ресурси сховища, для різних завдань користувачам часто потрібні PersistentVolumes із різними властивостями, наприклад, продуктивністю. Адміністратори кластера мають бути здатні пропонувати різноманітні PersistentVolumes, які відрізняються не лише розміром і режимами доступу, не розкриваючи користувачам деталей реалізації цих томів. Для цих потреб існує ресурс StorageClass.
PV — це ресурси в кластері. PVC — це запити на ці ресурси, які також діють як квитанції на ресурс. Взаємодія між PV та PVC відбувається за таким життєвим циклом:
Надання
Існує два способи надання PV: статично або динамічно.
Статичне
Адміністратор кластера створює певну кількість PV. Вони містять відомості про реальне сховище, доступне для використання користувачами кластера. Вони існують в API Kubernetes і доступні для споживання.
Динамічне
Коли жоден зі статичних PV, створених адміністратором, не відповідає PersistentVolumeClaim користувача, кластер може спробувати динамічно надати том спеціально для цього PVC. Це надання ґрунтується на StorageClasses: PVC має запитати клас сховища, а адміністратор має створити й налаштувати цей клас, щоб динамічне надання могло відбутися. PVC, які запитують клас "", фактично вимикають для себе динамічне надання.
Щоб увімкнути динамічне надання сховища на основі класу сховища, адміністратор кластера має ввімкнути DefaultStorageClassконтролер допуску на API-сервері. Це можна зробити, наприклад, переконавшись, що DefaultStorageClass є серед значень упорядкованого списку, розділеного комами, у прапорці --enable-admission-plugins компонента API-сервера. Докладніше про прапорці командного рядка API-сервера дивіться в документації kube-apiserver.
Привʼязка
Користувач створює або, у разі динамічного надання, уже створив PersistentVolumeClaim із певним запитаним обсягом сховища та певними режимами доступу. Цикл управління в панелі управління стежить за новими PVC, знаходить відповідний PV (якщо це можливо) і привʼязує їх один до одного. Якщо PV було динамічно надано для нового PVC, цикл завжди привʼязуватиме цей PV до PVC. Інакше користувач завжди отримає принаймні те, що запитував, але том може перевищувати запитаний обсяг. Після привʼязки PersistentVolumeClaim є ексклюзивними, незалежно від того, як їх було привʼязано. Привʼязка PVC до PV — це зіставлення один до одного за допомогою ClaimRef, який є двоспрямованою привʼязкою між PersistentVolume і PersistentVolumeClaim.
PVC залишатимуться непривʼязаними необмежено довго, якщо відповідного тому не існує. PVC будуть привʼязані, коли відповідні томи стануть доступними. Наприклад, кластер, забезпечений багатьма PV розміром 50Gi, не відповідатиме PVC, який запитує 100Gi. PVC можна буде привʼязати, коли до кластера буде додано PV розміром 100Gi.
Використання
Podʼи використовують PVC як томи. Кластер перевіряє PVC, щоб знайти привʼязаний том, і монтує цей том для Podʼа. Для томів, які підтримують кілька режимів доступу, користувач вказує бажаний режим, коли використовує свій PVC як том у Podʼі.
Щойно користувач має PVC і цей PVC привʼязано, привʼязаний PV належить користувачеві стільки, скільки потрібно. Користувачі планують Podʼи та отримують доступ до своїх PV, додаючи розділ persistentVolumeClaim у блок volumes Podʼа. Докладніше дивіться в розділі PVC як томи.
Захист обʼєктів сховища, що використовуються
Мета можливості захисту обʼєктів сховища, що використовуються, — гарантувати, що PersistentVolumeClaims (PVC), які активно використовуються Podʼом, і PersistentVolume (PV), привʼязані до PVC, не вилучаються із системи, оскільки це може призвести до втрати даних.
Примітка:
PVC активно використовується Podʼом, коли існує обʼєкт Pod, який використовує PVC.
Якщо користувач видаляє PVC, який активно використовується Podʼом, PVC вилучається не одразу. Вилучення PVC відкладається, доки PVC більше не використовуватиметься активно жодним Podʼом. Так само, якщо адміністратор видаляє PV, привʼязаний до PVC, PV вилучається не одразу. Вилучення PV відкладається, доки PV більше не буде привʼязаний до PVC.
Ви можете побачити, що PVC захищено, коли статус PVC — Terminating, а список Finalizers містить kubernetes.io/pvc-protection:
Коли користувач закінчує роботу зі своїм томом, він може видалити обʼєкти PVC з API, що дозволяє повторно використати ресурс. Політика повторного використання PersistentVolume вказує кластеру, що робити з томом після того, як його звільнено від PVC. Наразі томи можна зберегти (Retain), переробити (Recycle) або видалити (Delete).
Retain
Політика повторного використання Retain дозволяє повторно використати ресурс вручну. Коли PersistentVolumeClaim видаляють, PersistentVolume все ще існує, і том вважається «звільненим». Але він ще не доступний для іншого PVC, оскільки на томі залишаються дані попереднього власника PVC. Адміністратор може вручну повторно використати том, виконавши такі кроки.
Видаліть PersistentVolume. Повʼязаний ресурс сховища в зовнішній інфраструктурі все ще існує після видалення PV.
Вручну очистіть дані на повʼязаному ресурсі сховища.
Вручну видаліть повʼязаний ресурс сховища.
Якщо ви хочете повторно використати той самий ресурс сховища, створіть новий PersistentVolume із таким самим визначенням ресурсу сховища.
Delete
Для втулків томів, які підтримують політику повторного використання Delete, видалення вилучає і обʼєкт PersistentVolume з Kubernetes, і повʼязаний ресурс сховища в зовнішній інфраструктурі. Томи, надані динамічно, успадковують політику повторного використання свого StorageClass, стандартним значенням якої є Delete. Адміністратор має налаштувати StorageClass відповідно до очікувань користувачів; інакше PV потрібно відредагувати або змінити за допомогою patch після створення. Дивіться Зміна політики повторного використання PersistentVolume.
Recycle
Попередження:
Політика повторного використання Recycle застаріла. Натомість рекомендовано використовувати динамічне надання.
Якщо це підтримує базовий втулок томів, політика повторного використання Recycle виконує базове очищення (rm -rf /thevolume/*) тому й знову робить його доступним для нового PVC.
Однак адміністратор може налаштувати власний шаблон Podʼа recycler за допомогою аргументів командного рядка менеджера контролерів Kubernetes, як описано в довіднику. Власний шаблон Podʼа recycler має містити специфікацію volumes, як показано в наведеному нижче прикладі:
Однак конкретний шлях, вказаний у частині volumes власного шаблону Podʼа recycler, замінюється конкретним шляхом тому, що переробляється.
Завершувач захисту від видалення PersistentVolume
This is a stable feature in Kubernetes, and has been since the 1.33 release. You can no longer toggle this feature (the associated feature gate has been removed).
До PersistentVolume можна додавати завершувачі, щоб PersistentVolumes із політикою повторного використання Delete видалялися лише після видалення базового сховища.
Завершувач external-provisioner.volume.kubernetes.io/finalizer (запроваджений у v1.31) додається як до динамічно, так і до статично наданих томів CSI.
Завершувач kubernetes.io/pv-controller (запроваджений у v1.31) додається до динамічно наданих томів вбудованих втулків і пропускається для статично наданих томів вбудованих втулків.
Ось приклад динамічно наданого тому вбудованого втулка:
Коли для конкретного вбудованого втулка томів увімкнено прапорець можливості CSIMigration{provider}, завершувач kubernetes.io/pv-controller замінюється завершувачем external-provisioner.volume.kubernetes.io/finalizer.
Завершувачі гарантують, що обʼєкт PV вилучається лише після видалення тому з бекенду сховища, якщо політика повторного використання PV — Delete. Це також гарантує, що том буде видалено з бекенду сховища незалежно від порядку видалення PV і PVC.
Вказавши PersistentVolume у PersistentVolumeClaim, ви оголошуєте привʼязку між цими конкретними PV та PVC. Якщо PersistentVolume існує і не зарезервував PersistentVolumeClaims через своє поле claimRef, PersistentVolume і PersistentVolumeClaim буде привʼязано.
Привʼязка відбувається незалежно від деяких критеріїв зіставлення томів, зокрема спорідненості вузла. Панель управління все ще перевіряє, що клас сховища, режими доступу та запитаний розмір сховища є дійсними.
apiVersion:v1kind:PersistentVolumeClaimmetadata:name:foo-pvcnamespace:foospec:storageClassName:""# Порожній рядок потрібно вказати явно, інакше буде встановлено стандартний StorageClassvolumeName:foo-pv...
Цей метод не гарантує жодних привілеїв привʼязки для PersistentVolume. Якщо інші PersistentVolumeClaims можуть використовувати вказаний вами PV, спочатку потрібно зарезервувати цей том сховища. Вкажіть відповідний PersistentVolumeClaim у полі claimRef PV, щоб інші PVC не могли до нього привʼязатися.
Це корисно, якщо ви хочете використовувати PersistentVolumes, у яких persistentVolumeReclaimPolicy має значення Retain, зокрема у випадках, коли ви повторно використовуєте наявний PV.
Розширення PersistentVolumeClaims
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Підтримку розширення PersistentVolumeClaims (PVC) стандартно ввімкнено. Ви можете розширювати такі типи томів:
Щоб запросити більший том для PVC, відредагуйте обʼєкт PVC і вкажіть більший розмір. Це запускає розширення тому, що стоїть за базовим PersistentVolume. Новий PersistentVolume для задоволення PVC ніколи не створюється. Натомість змінюється розмір наявного тому.
Попередження:
Пряме редагування розміру PersistentVolume може завадити автоматичній зміні розміру цього тому. Якщо ви редагуєте місткість PersistentVolume, а потім редагуєте .spec відповідного PersistentVolumeClaim, щоб розмір PersistentVolumeClaim збігався з PersistentVolume, зміна розміру сховища не відбудеться. Панель управління Kubernetes побачить, що бажаний стан обох ресурсів збігається, і зробить висновок, що розмір базового тому було збільшено вручну й зміна розміру не потрібна.
Розширення томів CSI
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Підтримку розширення томів CSI стандартно ввімкнено, але вона також вимагає, щоб конкретний драйвер CSI підтримував розширення томів. Докладніше дивіться в документації конкретного драйвера CSI.
Зміна розміру тому, що містить файлову систему
Ви можете змінювати розмір томів, що містять файлову систему, лише якщо це XFS, Ext3 або Ext4.
Коли том містить файлову систему, її розмір змінюється лише тоді, коли новий Pod використовує PersistentVolumeClaim у режимі ReadWrite. Розширення файлової системи виконується або під час запуску Podʼа, або коли Pod працює і базова файлова система підтримує онлайн-розширення.
FlexVolumes (застаріли з Kubernetes v1.23) дозволяють змінювати розмір, якщо драйвер налаштовано з можливістю RequiresFSResize, встановленою в true. Розмір FlexVolume можна змінити під час перезапуску Podʼа.
Зміна розміру PersistentVolumeClaim, що використовується
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
У цьому випадку вам не потрібно видаляти й повторно створювати Pod або Deployment, який використовує наявний PVC. Будь-який PVC, що використовується, автоматично стає доступним для свого Podʼа, щойно його файлову систему буде розширено. Ця можливість не впливає на PVC, які не використовуються Podʼом або Deployment. Ви повинні створити Pod, який використовує PVC, щоб розширення могло завершитися.
Як і інші типи томів, томи FlexVolume також можна розширювати, коли їх використовує Pod.
Примітка:
Змінити розмір FlexVolume можна лише тоді, коли це підтримує базовий драйвер.
Відновлення після збою під час розширення томів
Якщо користувач вказує новий розмір, надто великий для базової системи зберігання, розширення PVC повторюватиметься постійно, доки користувач або адміністратор кластера не вживе заходів. Це може бути небажаним, тому Kubernetes надає такі методи відновлення після таких збоїв.
Якщо розширення базового сховища не вдається, адміністратор кластера може вручну відновити стан PersistentVolumeClaim (PVC) і скасувати запити на зміну розміру. Інакше контролер постійно повторюватиме запити на зміну розміру без втручання адміністратора.
Позначте PersistentVolume (PV), привʼязаний до PersistentVolumeClaim (PVC), політикою повторного використання Retain.
Видаліть PVC. Оскільки PV має політику повторного використання Retain, ми не втратимо жодних даних під час повторного створення PVC.
Видаліть запис claimRef зі специфікації PV, щоб новий PVC міг до нього привʼязатися. Це має зробити PV Available.
Створіть PVC заново з меншим розміром, ніж у PV, і встановіть у поле volumeName PVC назву PV. Це має привʼязати новий PVC до наявного PV.
Не забудьте відновити політику повторного використання PV.
Якщо розширення PVC не вдалося, ви можете повторити його з меншим розміром, ніж запитане раніше значення. Щоб запросити нову спробу розширення з меншим запропонованим розміром, відредагуйте .spec.resources цього PVC і виберіть значення, менше за попереднє. Це корисно, якщо розширення до більшого значення не вдалося через обмеження місткості. Якщо це сталося або ви підозрюєте, що могло статися, ви можете повторити розширення, вказавши розмір у межах місткості базового провайдера сховища. Ви можете стежити за статусом операції зміни розміру через .status.allocatedResourceStatuses та Events на PVC.
Зверніть увагу, що, хоча ви можете вказати менший обсяг сховища, ніж запитували раніше, нове значення все одно має бути більшим за .status.capacity. Kubernetes не підтримує зменшення PVC до розміру, меншого за поточний.
Типи постійних томів
Типи PersistentVolume реалізовано як втулки. Наразі Kubernetes підтримує такі втулки:
hostPath — том HostPath (лише для тестування на одному вузлі; НЕ ПРАЦЮВАТИМЕ в кластері з кількома вузлами; натомість розгляньте використання тому local)
Такі типи PersistentVolume застаріли, але все ще доступні. Якщо ви використовуєте ці типи томів, крім flexVolume, cephfs та rbd, встановіть відповідні драйвери CSI.
awsElasticBlockStore — AWS Elastic Block Store (EBS) (міграцію стандартно ввімкнено починаючи з v1.23)
azureDisk — Azure Disk (міграцію стандартно ввімкнено починаючи з v1.23)
azureFile — Azure File (міграцію стандартно ввімкнено починаючи з v1.24)
cinder — Cinder (блочне сховище OpenStack) (міграцію стандартно ввімкнено починаючи з v1.21)
flexVolume — FlexVolume (застаріло починаючи з версії v1.23, план міграції відсутній, планів припинення підтримки немає)
gcePersistentDisk — GCE Persistent Disk (міграцію стандартно ввімкнено починаючи з v1.23)
portworxVolume — Том Portworx (міграцію стандартно ввімкнено починаючи з v1.31)
vsphereVolume — том vSphere VMDK (міграцію стандартно ввімкнено починаючи з v1.25)
Старіші версії Kubernetes також підтримували такі типи вбудованих PersistentVolume:
Для використання PersistentVolume у кластері можуть знадобитися допоміжні програми, повʼязані з типом тому. У цьому прикладі PersistentVolume має тип NFS, і для підтримки монтування файлових систем NFS потрібна допоміжна програма /sbin/mount.nfs.
Місткість
Зазвичай PV має певну місткість сховища. Вона задається атрибутом capacity PV, який є значенням Quantity.
Наразі розмір сховища — єдиний ресурс, який можна встановити або запитати. Майбутні атрибути можуть включати IOPS, пропускну здатність тощо.
Режим тому
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.18
Kubernetes підтримує два значення volumeModes для PersistentVolumes: Filesystem та Block.
volumeMode є необовʼязковим параметром API. Filesystem — стандартний режим, який використовується, коли параметр volumeMode пропущено.
Том із volumeMode: Filesystemмонтується в Podʼи в теку. Якщо том підкріплений блоковим пристроєм і пристрій порожній, Kubernetes створює на ньому файлову систему перед першим монтуванням.
Ви можете встановити volumeMode у Block, щоб використовувати том як необроблений блоковий пристрій. Такий том подається в Pod як блоковий пристрій без файлової системи. Цей режим корисний, щоб надати Podʼу найшвидший можливий доступ до тому без будь-якого шару файлової системи між Podʼом і томом. З іншого боку, застосунок, що працює в Podʼі, має знати, як працювати з необробленим блоковим пристроєм. Приклад використання тому з volumeMode: Block у Podʼі дивіться в розділі Підтримка необроблених блокових томів.
Режими доступу
PersistentVolume можна змонтувати на хості будь-яким способом, який підтримує провайдер ресурсу. Як показано в таблиці нижче, провайдери мають різні можливості, а режими доступу кожного PV встановлюються відповідно до режимів, які підтримує цей конкретний том. Наприклад, NFS може підтримувати кількох клієнтів для читання й запису, але конкретний PV NFS може бути експортований на сервері лише для читання. Кожен PV отримує власний набір режимів доступу, що описує можливості саме цього PV.
Режими доступу такі:
ReadWriteOnce
том можна змонтувати для читання й запису на одному вузлі. Режим доступу ReadWriteOnce все ще може дозволяти кільком Podʼам доступ до цього тому (читання з нього або запис у нього), якщо ці Podʼи працюють на одному вузлі. Про доступ для одного Podʼа дивіться ReadWriteOncePod.
ReadOnlyMany
том можна змонтувати лише для читання на багатьох вузлах.
ReadWriteMany
том можна змонтувати для читання й запису на багатьох вузлах.
ReadWriteOncePod
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.29
том можна змонтувати для читання й запису одним Podʼом. Використовуйте режим доступу ReadWriteOncePod, якщо хочете гарантувати, що лише один Pod у всьому кластері може читати цей PVC або записувати в нього.
Примітка:
Режим доступу ReadWriteOncePod підтримується лише для томів CSI і Kubernetes версії 1.22+. Щоб використовувати цю можливість, вам потрібно оновити такі sidecar-контейнери CSI до цих або новіших версій:
У командному рядку режими доступу скорочуються так:
RWO — ReadWriteOnce
ROX — ReadOnlyMany
RWX — ReadWriteMany
RWOP — ReadWriteOncePod
Примітка:
Kubernetes використовує режими доступу до томів для зіставлення PersistentVolumeClaims і PersistentVolumes. У деяких випадках режими доступу до томів також обмежують, де можна змонтувати PersistentVolume. Режими доступу до томів не забезпечують захист від запису після монтування сховища. Навіть якщо вказано режими доступу ReadWriteOnce, ReadOnlyMany або ReadWriteMany, вони не встановлюють жодних обмежень на том. Наприклад, навіть якщо PersistentVolume створено як ReadOnlyMany, це не гарантує, що він буде доступний лише для читання. Якщо вказано режим доступу ReadWriteOncePod, том обмежений і може бути змонтований лише одним Podʼом.
Важливо! Том можна монтувати одночасно лише в одному режимі доступу, навіть якщо він підтримує кілька.
Втулок томів
ReadWriteOnce
ReadOnlyMany
ReadWriteMany
ReadWriteOncePod
AzureFile
✓
✓
✓
-
CephFS
✓
✓
✓
-
CSI
залежить від драйвера
залежить від драйвера
залежить від драйвера
залежить від драйвера
FC
✓
✓
-
-
FlexVolume
✓
✓
залежить від драйвера
-
HostPath
✓
-
-
-
iSCSI
✓
✓
-
-
NFS
✓
✓
✓
-
RBD
✓
✓
-
-
VsphereVolume
✓
-
- (працює, коли Podʼи розташовані разом)
-
PortworxVolume
✓
-
✓
-
Клас
PV може мати клас, який задається встановленням атрибута storageClassName на назву StorageClass. PV певного класу можна привʼязати лише до PVC, які запитують цей клас. PV без storageClassName не має класу, і його можна привʼязати лише до PVC, які не запитують жодного конкретного класу.
У минулому замість атрибута storageClassName використовувалася анотація volume.beta.kubernetes.io/storage-class. Ця анотація все ще працює; однак у майбутньому випуску Kubernetes вона стане повністю застарілою.
Політика повторного використання
Поточні політики повторного використання:
Retain — ручне повторне використання
Recycle — базове очищення (rm -rf /thevolume/*)
Delete — видалити том
У Kubernetes 1.37 переробку підтримують лише типи томів nfs та hostPath.
Параметри монтування
Адміністратор Kubernetes може вказати додаткові параметри монтування для випадку, коли постійний том монтується на вузлі.
Примітка:
Не всі типи постійних томів підтримують параметри монтування.
Такі типи томів підтримують параметри монтування:
csi (зокрема типи томів, перенесені на CSI)
iscsi
nfs
Параметри монтування не перевіряються. Якщо параметр монтування недійсний, монтування завершиться невдачею.
У минулому замість атрибута mountOptions використовувалася анотація volume.beta.kubernetes.io/mount-options. Ця анотація все ще працює; однак у майбутньому випуску Kubernetes вона стане повністю застарілою.
Спорідненість вузла
Примітка:
Для більшості типів томів вам не потрібно встановлювати це поле. Вам слід явно встановити його для томів local.
PV може вказувати спорідненість вузла, щоб визначити обмеження, з яких вузлів можна отримати доступ до цього тому. Podʼи, які використовують PV, плануватимуться лише на вузли, вибрані спорідненістю вузла. Щоб вказати спорідненість вузла, встановіть nodeAffinity у .spec PV. Докладніше про це поле дивіться в довіднику API PersistentVolume.
Оновлення спорідненості вузла
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.35; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the MutablePVNodeAffinity feature gate for all relevant components in your cluster.
Якщо у вашому кластері ввімкнено функціональну можливість MutablePVNodeAffinity, поле .spec.nodeAffinity PersistentVolume можна змінювати. Це дозволяє адміністраторам кластера або зовнішньому контролеру сховища оновлювати спорідненість вузла PersistentVolume під час міграції даних, не перериваючи роботу запущених Podʼів.
Під час оновлення спорідненості вузла переконайтеся, що нова спорідненість вузла все ще відповідає вузлам, на яких том наразі використовується. Podʼи, що порушують нову спорідненість, якщо вони вже працюють, можуть продовжувати працювати. Але Kubernetes не підтримує таку конфігурацію. Слід якнайшвидше завершити Podʼи, що її порушують. Через кешування в памʼяті Podʼи, створені після оновлення, протягом короткого часу все ще можуть плануватися за старою спорідненістю вузла.
Щоб скористатися цією можливістю, увімкніть функціональну можливість MutablePVNodeAffinity у таких компонентах:
kube-apiserver
kubelet
Фаза
PersistentVolume перебуватиме в одній із таких фаз:
Available
вільний ресурс, ще не привʼязаний до PVC
Bound
том привʼязано до PVC
Released
PVC видалено, але кластер ще не повторно використав повʼязаний ресурс сховища
Failed
автоматичне повторне використання тому завершилося збоєм
Ви можете побачити назву PVC, привʼязаного до PV, за допомогою kubectl describe persistentvolume <name>.
Час переходу фази
This is a stable feature in Kubernetes, and has been since the 1.31 release. You can no longer toggle this feature (the associated feature gate has been removed).
Поле .status PersistentVolume може містити альфа-поле lastPhaseTransitionTime. Це поле фіксує час останнього переходу тому між фазами. Для новостворених томів фаза встановлюється в Pending, а lastPhaseTransitionTime — на поточний час.
PersistentVolumeClaims
Кожен PVC містить spec і status, тобто специфікацію та статус PVC. Назва обʼєкта PersistentVolumeClaim має бути дійсним іменем DNS-піддомену.
apiVersion:v1kind:PersistentVolumeClaimmetadata:name:myclaimspec:accessModes:- ReadWriteOncevolumeMode:Filesystemresources:requests:storage:8GistorageClassName:slowselector:matchLabels:release:"stable"matchExpressions:- {key: environment, operator: In, values:[dev]}
PVC можуть використовувати поле volumeName, щоб явно привʼязатися до певного PersistentVolume. Ви також можете залишити volumeName невстановленим, вказавши, що хочете, щоб Kubernetes налаштував новий PersistentVolume, який відповідає PVC. Якщо вказаний PV уже привʼязаний до іншого PVC, привʼязка застрягне в стані очікування.
Ресурси
PVC, як і Podʼи, можуть запитувати певні кількості ресурсу. У цьому випадку запит стосується сховища. До томів і PVC застосовується та сама модель ресурсів.
Примітка:
Для томів Filesystem запит сховища стосується «зовнішнього» розміру тому (тобто розміру, виділеного бекендом сховища). Це означає, що розмір, доступний для запису, може бути дещо меншим у провайдерів, які будують файлову систему поверх блокового пристрою, через накладні витрати файлової системи. Це особливо помітно з XFS, де стандартно ввімкнено багато можливостей метаданих.
Селектор
PVC можуть вказати селектор міток, щоб додатково відфільтрувати набір томів. До PVC можна привʼязати лише томи, мітки яких відповідають селектору. Селектор може складатися з двох полів:
matchLabels — том повинен мати мітку з таким значенням
matchExpressions — список вимог, які визначаються за допомогою ключа, списку значень та оператора, який повʼязує ключ і значення. Допустимі оператори включають In, NotIn, Exists та DoesNotExist.
Усі вимоги з matchLabels і matchExpressions обʼєднуються логічним «І» — для збігу всі вони мають бути виконані.
Клас
PVC може запитати певний клас, вказавши назву StorageClass в атрибуті storageClassName. До PVC можна привʼязати лише PV запитаного класу, тобто ті, що мають такий самий storageClassName, як і PVC.
PVC не обовʼязково мають запитувати клас. PVC зі storageClassName, встановленим у "", завжди інтерпретується як такий, що запитує PV без класу, тому його можна привʼязати лише до PV без класу (без анотації або з анотацією, встановленою в ""). PVC без storageClassName — це не зовсім те саме, і кластер обробляє його по-різному залежно від того, чи ввімкнено втулок допуску DefaultStorageClass.
Якщо втулок допуску ввімкнено, адміністратор може вказати стандартний StorageClass. Усі PVC без storageClassName можна привʼязати лише до PV цього стандартного класу. Стандартний StorageClass задається встановленням анотації storageclass.kubernetes.io/is-default-class у true в обʼєкті StorageClass. Якщо адміністратор не вказав стандартний клас, кластер реагує на створення PVC так, ніби втулок допуску вимкнено. Якщо вказано кілька стандартних StorageClass, під час динамічного надання PVC використовується найновіший.
Якщо втулок допуску вимкнено, поняття стандартного StorageClass немає. Усі PVC зі storageClassName, встановленим у "", можна привʼязати лише до PV, у яких storageClassName також встановлено в "". Однак PVC без storageClassName можна оновити пізніше, коли стандартний StorageClass стане доступним. Якщо PVC оновлено, він більше не привʼязуватиметься до PV, у яких storageClassName також встановлено в "".
Залежно від способу встановлення, менеджер надбудов може розгорнути стандартний StorageClass у кластері Kubernetes під час встановлення.
Коли PVC вказує selector на додаток до запиту StorageClass, вимоги обʼєднуються логічним «І»: до PVC можна привʼязати лише PV запитаного класу із запитаними мітками.
Примітка:
Наразі для PVC з непорожнім selector не можна динамічно надати PV.
У минулому замість атрибута storageClassName використовувалася анотація volume.beta.kubernetes.io/storage-class. Ця анотація все ще працює; однак у майбутньому випуску Kubernetes вона більше не підтримуватиметься.
Ретроактивне призначення стандартного StorageClass
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.28
Ви можете створити PersistentVolumeClaim, не вказуючи storageClassName для нового PVC, навіть якщо у вашому кластері немає стандартного StorageClass. У цьому випадку новий PVC створюється так, як ви його визначили, а storageClassName цього PVC залишається невстановленим, доки не стане доступним стандартний клас.
Коли стандартний StorageClass стає доступним, панель управління визначає всі наявні PVC без storageClassName. Для PVC, які мають порожнє значення storageClassName або не мають цього ключа, панель управління оновлює storageClassName відповідно до нового стандартного StorageClass. Якщо у вас є наявний PVC, де storageClassName має значення "", і ви налаштовуєте стандартний StorageClass, цей PVC не буде оновлено.
Щоб і надалі привʼязуватися до PV із storageClassName, встановленим у "" (за наявності стандартного StorageClass), вам потрібно встановити storageClassName повʼязаного PVC у "".
Така поведінка допомагає адміністраторам змінювати стандартний StorageClass: спочатку вилучити старий, а потім створити або встановити інший. Через це коротке вікно без стандартного класу PVC без storageClassName, створені в цей час, не матимуть стандартного класу, але завдяки ретроактивному призначенню стандартного StorageClass такий спосіб зміни стандартних значень безпечний.
Відстеження невикористаних PVC
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
Коли цю можливість увімкнено, контролер захисту PVC додає до кожного PersistentVolumeClaim станUnused, щоб показати, чи посилається на нього зараз якийсь нетермінальний Pod.
Цей стан має два значення:
Unused зі статусом "True" (причина NoPodsUsingPVC)
Жоден нетермінальний Pod не посилається на цей PVC. lastTransitionTime фіксує час, коли PVC перестав використовуватися.
Unused зі статусом "False" (причина PodUsingPVC)
Принаймні один нетермінальний Pod наразі посилається на цей PVC. lastTransitionTime фіксує час, коли PVC почав використовуватися.
Pod вважається нетермінальним, якщо його фаза не Succeeded і не Failed. Це означає, що Pod в очікуванні (навіть ще не запланований) вважається таким, що використовує PVC.
lastTransitionTime стану Unused можуть використовувати адміністратори кластера, інструменти моніторингу та зовнішні контролери, щоб визначати PVC, які не використовуються тривалий час. Наприклад, щоб знайти всі PVC, які не використовуються понад 30 днів, можна вибрати PVC, у яких стан Unused має status: "True", а lastTransitionTime старший за 30 днів.
Примітка:
Тривалість невикористання, показана цим станом, може бути коротшою за фактичний час невикористання через затримки обробки в контролері або через те, що можливість було ввімкнено, коли PVC уже не використовувався. Стан не оновлюється, коли в PVC встановлено deletionTimestamp (тобто для PVC, що видаляються).
PVC як томи
Podʼи отримують доступ до сховища, використовуючи PVC як том. PVC має існувати в тому самому просторі імен, що й Pod, який його використовує. Кластер знаходить PVC у просторі імен Podʼа і використовує його, щоб отримати PersistentVolume, що стоїть за PVC. Потім том монтується на хост і в Pod.
Привʼязки PersistentVolumes є ексклюзивними, а оскільки PersistentVolumeClaims є обʼєктами в просторі імен, монтування PVC у режимах "Many" (ROX, RWX) можливе лише в межах одного простору імен.
PersistentVolumes типу hostPath
PersistentVolume типу hostPath використовує файл або теку на вузлі для емуляції мережевого сховища. Дивіться приклад тому типу hostPath.
Підтримка необроблених блокових томів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.18
Такі втулки томів підтримують необроблені блокові томи, зокрема динамічне надання, де це застосовно:
CSI (зокрема деякі типи томів, перенесені на CSI)
FC (Fibre Channel)
iSCSI
Локальний том
PersistentVolume, що використовує необроблений блоковий том
Під час додавання необробленого блокового пристрою для Podʼа ви вказуєте шлях до пристрою в контейнері замість шляху монтування.
Привʼязка блокових томів
Якщо користувач запитує необроблений блоковий том, вказавши це в полі volumeMode у специфікації PersistentVolumeClaim, правила привʼязки дещо відрізняються від попередніх випусків, які не враховували цей режим як частину специфікації. Нижче наведено таблицю можливих комбінацій, які користувач і адміністратор можуть вказати для запиту необробленого блокового пристрою. Таблиця показує, чи буде том привʼязано за цих комбінацій: Матриця привʼязки томів для статично наданих томів:
PV volumeMode
PVC volumeMode
Результат
не вказано
не вказано
ПРИВʼЯЗАНИЙ
не вказано
Block
НЕ ПРИВʼЯЗАНИЙ
не вказано
Filesystem
ПРИВʼЯЗАНИЙ
Block
не вказано
НЕ ПРИВʼЯЗАНИЙ
Block
Block
ПРИВʼЯЗАНИЙ
Block
Filesystem
НЕ ПРИВʼЯЗАНИЙ
Filesystem
Filesystem
ПРИВʼЯЗАНИЙ
Filesystem
Block
НЕ ПРИВʼЯЗАНИЙ
Filesystem
не вказано
ПРИВʼЯЗАНИЙ
Примітка:
Для альфа-випуску підтримуються лише статично надані томи. Адміністратори мають враховувати ці значення під час роботи з необробленими блоковими пристроями.
Підтримка знімків томів та відновлення тому зі знімка
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.20
Знімки томів підтримують лише зовнішні втулки томів CSI. Докладніше дивіться в Знімки томів. Вбудовані втулки томів застаріли. Про застарілі втулки томів читайте в FAQ про втулки томів.
Клонування томів та відновлення зі знімка попередньо заповнюють новий том із вбудованого джерела даних. Наповнювачі томів розширюють цей механізм, щоб PersistentVolumeClaim можна було попередньо заповнити з інших видів джерел (власного ресурсу), на які він посилається через поле dataSourceRef:
Якщо ви пишете шаблони конфігурації або приклади, які працюють на широкому спектрі кластерів і потребують постійного сховища, рекомендується використовувати такий підхід:
Додавайте обʼєкти PersistentVolumeClaim до свого набору конфігурації (поряд із Deployments, ConfigMaps тощо).
Не додавайте обʼєкти PersistentVolume до конфігурації, оскільки користувач, який застосовує конфігурацію, може не мати дозволу на створення PersistentVolumes.
Дайте користувачеві можливість вказати назву класу сховища під час застосування шаблону.
Якщо користувач вказує назву класу сховища, запишіть це значення в поле persistentVolumeClaim.storageClassName. Це приведе до зіставлення PVC з правильним класом сховища, якщо адміністратор увімкнув StorageClasses у кластері.
Якщо користувач не вказує назву класу сховища, залиште поле persistentVolumeClaim.storageClassName зі значенням nil. Це призведе до автоматичного надання PV для користувача зі стандартним StorageClass кластера. Багато кластерних середовищ мають встановлений стандартний StorageClass, або адміністратори можуть створити власний стандартний StorageClass.
У своїх інструментах стежте за PVC, які не привʼязуються протягом певного часу, і показуйте це користувачеві, оскільки це може означати, що кластер не має підтримки динамічного сховища (у цьому випадку користувач має створити відповідний PV) або не має системи зберігання (у цьому випадку користувач не може розгорнути конфігурацію, яка потребує PVC).
Кожне джерело проєкційного тому перелічено в специфікації в розділі sources. Параметри майже такі самі, за двома винятками:
Для secrets поле secretName змінено на name, щоб узгодити його з іменуванням ConfigMap.
defaultMode можна вказати лише на рівні projected, а не для кожного джерела тому. Однак, як показано вище, ви можете явно встановити mode для кожної окремої проєкції.
Проєкційні томи serviceAccountToken
Ви можете вставити токен поточного ServiceAccount у Pod за вказаним шляхом. Наприклад:
Pod із прикладу має проєкційний том, що містить вставлений токен ServiceAccount. Контейнери в цьому Podʼі можуть використовувати цей токен для доступу до API-сервера Kubernetes, автентифікуючись від імені ServiceAccount цього Podʼа. Поле audience містить цільову аудиторію токена. Отримувач токена повинен ідентифікувати себе ідентифікатором, вказаним в аудиторії токена, інакше він має відхилити токен. Це поле є необовʼязковим, і його стандартним значенням є ідентифікатор API-сервера.
Поле expirationSeconds містить очікуваний термін дії токена ServiceAccount. Стандартно він становить 1 годину і має бути не меншим за 10 хвилин (600 секунд). Адміністратор також може обмежити його максимальне значення, вказавши параметр --service-account-max-token-expiration для API-сервера. Поле path задає шлях відносно точки монтування проєкційного тому.
Примітка:
Контейнер, що використовує джерело проєкційного тому як монтування тому subPath, не отримуватиме оновлень для цих джерел томів.
Проєкційні томи clusterTrustBundle
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.37. It was first available in the v1.29 release.
Джерело проєкційного тому clusterTrustBundle вставляє вміст одного або кількох обʼєктів ClusterTrustBundle як файл, що автоматично оновлюється, у файлову систему контейнера.
Щоб вибрати за назвою, використовуйте поле name, щоб вказати один обʼєкт ClusterTrustBundle.
Щоб вибрати за назвою підписувача, використовуйте поле signerName (і, за потреби, поле labelSelector), щоб вказати набір обʼєктів ClusterTrustBundle, які використовують задану назву підписувача. Якщо labelSelector відсутній, вибираються всі ClusterTrustBundles цього підписувача.
kubelet вилучає дублікати сертифікатів у вибраних обʼєктах ClusterTrustBundle, нормалізує подання PEM (відкидаючи коментарі та заголовки), змінює порядок сертифікатів і записує їх у файл, вказаний у path. Коли змінюється набір вибраних ClusterTrustBundles або їхній вміст, kubelet підтримує файл в актуальному стані.
Стандартно kubelet не дає Podʼу запуститися, якщо вказаний ClusterTrustBundle не знайдено або якщо signerName / labelSelector не відповідають жодному ClusterTrustBundle. Якщо така поведінка вам не підходить, встановіть поле optional у true, і Pod запуститься з порожнім файлом за шляхом path.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.37. It was first available in the v1.34 release.
Джерело проєкційного тому podCertificate безпечно надає приватний ключ і ланцюжок сертифікатів X.509, які Pod використовує як клієнтські або серверні облікові дані. Потім kubelet оновлює приватний ключ і ланцюжок сертифікатів, коли наближається завершення їхнього терміну дії. Застосунку потрібно лише своєчасно перезавантажувати файл, коли він змінюється, за допомогою механізму на кшталт inotify або опитування.
Кожна проєкція podCertificate підтримує такі конфігураційні поля:
signerName: підписувач, який має видати сертифікат. Зверніть увагу, що підписувачі можуть мати власні вимоги до доступу та можуть відмовитися видавати сертифікати вашому Podʼу.
keyType: Тип приватного ключа, який повинен бути згенерований. Дійсні значення: ED25519, ECDSAP256, ECDSAP384, ECDSAP521, RSA3072 і RSA4096.
maxExpirationSeconds: Максимальний термін дії сертифіката, виданого Podʼу, який ви приймете. Якщо не вказано, стандартно використовується 86400 (24 години). Має бути не менше 3600 (1 година) і не більше 7862400 (91 день). Вбудовані підписувачі Kubernetes обмежені максимальним терміном дії 86400 (1 день). Підписувач може видати сертифікат із терміном дії, коротшим за вказаний вами.
credentialBundlePath: Відносний шлях у межах проєкції, куди слід записати пакет облікових даних. Пакет облікових даних — це файл у форматі PEM, де перший блок — це блок "PRIVATE KEY", що містить приватний ключ, серіалізований у PKCS#8, а решта блоків — це блоки "CERTIFICATE", які утворюють ланцюжок сертифікатів (кінцевий сертифікат і всі проміжні).
keyPath і certificateChainPath: Окремі шляхи, куди kubelet має записати лише приватний ключ або ланцюжок сертифікатів.
userAnnotations: мапа, яка дозволяє передавати додаткову інформацію до реалізації підписувача. Вона дослівно копіюється в поле spec.unverifiedUserAnnotations обʼєктів PodCertificateRequest, які створює kubelet. Записи проходять ту саму перевірку, що й анотації метаданих обʼєкта, але додатково всі ключі повинні мати доменний префікс. На значення не накладаються жодні обмеження, крім загального обмеження розміру всього поля. Окрім цих базових перевірок, API-сервер не виконує жодних додаткових. Реалізації підписувача мають бути дуже обережними під час використання цих даних. Підписувачі не повинні довіряти цим даним без попереднього виконання відповідних кроків перевірки. Підписувачі мають документувати ключі та значення, які вони підтримують. Підписувачі мають відхиляти запити з ключами, які вони не розпізнають.
Примітка:
Більшість застосунків мають віддавати перевагу credentialBundlePath, якщо їм не потрібні ключ і сертифікати в окремих файлах з міркувань сумісності. kubelet використовує стратегію атомарного запису на основі символічних посилань, щоб під час відкриття файлів, які він проєцює, ви читали або старий, або новий вміст. Однак якщо ви читаєте ключ і ланцюжок сертифікатів з окремих файлів, kubelet може змінити облікові дані після першого читання й до другого, і ваш застосунок завантажить ключ і сертифікат, що не збігаються.
# Sample Pod spec that uses a podCertificate projection to request an ED25519# private key, a certificate from the `coolcert.example.com/foo` signer, and# write the results to `/var/run/my-x509-credentials/credentialbundle.pem`.apiVersion:v1kind:Podmetadata:namespace:defaultname:podcertificate-podspec:serviceAccountName:defaultcontainers:- image:debianname:maincommand:["sleep","infinity"]volumeMounts:- name:my-x509-credentialsmountPath:/var/run/my-x509-credentialsvolumes:- name:my-x509-credentialsprojected:defaultMode:0644sources:- podCertificate:keyType:ED25519signerName:coolcert.example.com/foocredentialBundlePath:credentialbundle.pemuserAnnotations:example.com/annotation1:"value1"example.com/annotation2:"value2"
Взаємодія із SecurityContext
Пропозиція щодо обробки дозволів файлів у вдосконаленні проєкційних томів ServiceAccount запровадила встановлення правильних дозволів власника для спроєцьованих файлів.
Linux
У Podʼах Linux, які мають проєкційний том і RunAsUser, встановлений у Pod SecurityContext, спроєцьовані файли мають правильно встановленого власника, зокрема власника-користувача контейнера.
Коли всі контейнери в Podʼі мають однакове значення runAsUser у своєму PodSecurityContext або SecurityContext контейнера, kubelet гарантує, що вміст тому serviceAccountToken належить цьому користувачеві, а файл токена має режим дозволів 0600.
Примітка:
Ефемерні контейнери, додані до Podʼа після його створення, не змінюють дозволи томів, встановлені під час створення Podʼа.
Якщо дозволи тому serviceAccountToken Podʼа було встановлено на 0600, оскільки всі інші контейнери в Podʼі мають однакове значення runAsUser, ефемерні контейнери повинні використовувати той самий runAsUser, щоб мати змогу прочитати токен.
Windows
У Podʼах Windows, які мають проєкційний том і RunAsUsername, встановлений у Pod SecurityContext, власність не застосовується через те, як у Windows керуються облікові записи користувачів. Windows зберігає локальні облікові записи користувачів і груп у файлі бази даних Security Account Manager (SAM) і керує ними. Кожен контейнер має власний екземпляр бази даних SAM, який хост не бачить під час роботи контейнера. Контейнери Windows призначені для запуску частини ОС у режимі користувача ізольовано від хоста, тому вони підтримують віртуальну базу даних SAM. Як наслідок, kubelet, що працює на хості, не може динамічно налаштовувати власність файлів хоста для віртуалізованих облікових записів контейнерів. Якщо файли на хост-машині потрібно спільно використовувати з контейнером, рекомендується розмістити їх у власному монтуванні тому поза C:\.
Стандартно спроєцьовані файли матимуть такого власника, як показано для прикладу файлу проєкційного тому:
Це означає, що всі користувачі-адміністратори, такі як ContainerAdministrator, матимуть доступ на читання, запис і виконання, а користувачі, які не є адміністраторами, — на читання й виконання.
Примітка:
Загалом не рекомендується надавати контейнеру доступ до хоста, оскільки це може відкрити двері для потенційних експлойтів безпеки.
Створення Podʼа Windows із RunAsUser у його SecurityContext призведе до того, що Pod назавжди застрягне на ContainerCreating. Тому не рекомендується використовувати параметр RunAsUser, призначений лише для Linux, з Podʼами Windows.
6.6.4 - Ефемерні томи
У цьому документі описано ефемерні томи в Kubernetes. Рекомендується ознайомитися з томами, зокрема з PersistentVolumeClaim та PersistentVolume.
Деяким застосункам потрібне додаткове сховище, але їм не важливо, чи зберігаються ці дані постійно між перезапусками. Наприклад, сервіси кешування часто обмежені обсягом памʼяті й можуть переміщувати рідко використовувані дані в сховище, повільніше за памʼять, майже не впливаючи на загальну продуктивність.
Інші застосунки очікують, що у файлах будуть певні вхідні дані лише для читання, наприклад, конфігураційні дані або секретні ключі.
Ефемерні томи призначені для таких сценаріїв використання. Оскільки томи живуть стільки ж, скільки Pod, і створюються та видаляються разом із ним, Podʼи можна зупиняти й перезапускати, не обмежуючись місцем, де доступний певний постійний том.
Ефемерні томи вказуються inline у специфікації Podʼа, що спрощує розгортання застосунків і керування ними.
Типи ефемерних томів
Kubernetes підтримує кілька різновидів ефемерних томів для різних цілей:
emptyDir: порожній під час запуску Podʼа, сховище надається локально з базової теки kubelet (зазвичай кореневий диск) або з оперативної памʼяті
загальні ефемерні томи, які можуть надавати всі драйвери сховища, що також підтримують постійні томи
emptyDir, configMap, downwardAPI, secret надаються як локальне тимчасове сховище. Ними керує kubelet на кожному вузлі.
Ефемерні томи CSI повинні надаватися сторонніми драйверами сховища CSI.
Загальні ефемерні томи можуть надаватися сторонніми драйверами сховища CSI, а також будь-яким іншим драйвером сховища, який підтримує динамічне надання. Деякі драйвери CSI написані спеціально для ефемерних томів CSI і не підтримують динамічне надання: їх не можна використовувати для загальних ефемерних томів.
Перевага сторонніх драйверів полягає в тому, що вони можуть пропонувати функціональність, яку сам Kubernetes не підтримує, наприклад, сховище з іншими характеристиками продуктивності, ніж диск, яким керує kubelet, або вставлення інших даних.
Ефемерні томи CSI
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Примітка:
Ефемерні томи CSI підтримує лише частина драйверів CSI. Список драйверів Kubernetes CSI показує, які драйвери підтримують ефемерні томи.
Концептуально ефемерні томи CSI схожі на типи томів configMap, downwardAPI та secret: сховище керується локально на кожному вузлі й створюється разом з іншими локальними ресурсами після того, як Pod заплановано на вузол. На цьому етапі Kubernetes уже не має поняття про перепланування Podʼів. Створення тому має бути таким, щоб збій був малоймовірним, інакше запуск Podʼа застрягне. Зокрема, планування Podʼів з урахуванням місткості сховища для цих томів не підтримується. Наразі на них також не поширюються обмеження використання ресурсів сховища Podʼа, оскільки kubelet може застосовувати їх лише до сховища, яким керує сам.
Ось приклад маніфесту для Podʼа, який використовує ефемерне сховище CSI:
volumeAttributes визначають, який том готує драйвер. Ці атрибути специфічні для кожного драйвера й не стандартизовані. Додаткові інструкції дивіться в документації кожного драйвера CSI.
Обмеження драйверів CSI
Ефемерні томи CSI дозволяють користувачам передавати volumeAttributes безпосередньо драйверу CSI як частину специфікації Podʼа. Драйвер CSI, який дозволяє volumeAttributes, що зазвичай доступні лише адміністраторам, НЕ підходить для використання в inline-ефемерному томі. Наприклад, параметри, які зазвичай визначаються в StorageClass, не слід відкривати користувачам через inline-ефемерні томи.
Адміністратори кластера, яким потрібно обмежити драйвери CSI, дозволені для використання як inline-томи у специфікації Podʼа, можуть зробити це так:
Вилучити Ephemeral із volumeLifecycleModes у специфікації CSIDriver, що не дасть використовувати драйвер як inline-ефемерний том.
Використати вебхук допуску, щоб обмежити використання цього драйвера.
Загальні ефемерні томи
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.23
Загальні ефемерні томи схожі на томи emptyDir у тому сенсі, що надають кожному Podʼу теку для робочих даних, яка зазвичай порожня після надання. Але вони також можуть мати додаткові можливості:
Сховище може бути локальним або мережевим.
Томи можуть мати фіксований розмір, який Podʼи не можуть перевищити.
Томи можуть мати певні початкові дані, залежно від драйвера та параметрів.
Ключова ідея дизайну полягає в тому, що параметри для PersistentVolumeClaim дозволені всередині джерела тому Podʼа. Підтримуються мітки, анотації та весь набір полів PersistentVolumeClaim. Коли такий Pod створюється, контролер ефемерних томів створює фактичний обʼєкт PersistentVolumeClaim у тому самому просторі імен, що й Pod, і забезпечує видалення PersistentVolumeClaim під час видалення Podʼа.
Це запускає привʼязку та/або надання тому: або негайно, якщо StorageClass використовує негайну привʼязку томів, або коли Pod попередньо заплановано на вузол (режим привʼязки томів WaitForFirstConsumer). Другий варіант рекомендовано для загальних ефемерних томів, оскільки тоді планувальник може вільно вибрати придатний вузол для Podʼа. За негайної привʼязки планувальник змушений вибрати вузол, який має доступ до тому, щойно том стає доступним.
З погляду власності на ресурси Pod, який має загальне ефемерне сховище, є власником PersistentVolumeClaim(ів), що надають це ефемерне сховище. Коли Pod видаляють, збирач сміття Kubernetes видаляє PVC, що зазвичай спричиняє видалення тому, оскільки стандартна політика повторного використання класів сховища — видаляти томи. Ви можете створити квазіефемерне локальне сховище за допомогою StorageClass із політикою повторного використання retain: сховище переживає Pod, і в цьому випадку потрібно подбати про окреме очищення тому.
Поки ці PVC існують, їх можна використовувати, як будь-який інший PVC. Зокрема, на них можна посилатися як на джерело даних під час клонування томів або створення знімків. Обʼєкт PVC також містить поточний статус тому.
Іменування PersistentVolumeClaim
Назви автоматично створених PVC є детермінованими: назва є комбінацією назви Podʼа та назви тому з дефісом (-) посередині. У наведеному вище прикладі назва PVC буде my-app-scratch-volume. Таке детерміноване іменування полегшує взаємодію з PVC, оскільки його не потрібно шукати, якщо відомі назва Podʼа та назва тому.
Детерміноване іменування також створює потенційний конфлікт між різними Podʼами (Pod "pod-a" з томом "scratch" та інший Pod з назвою "pod" і томом "a-scratch" отримають однакову назву PVC "pod-a-scratch"), а також між Podʼами та PVC, створеними вручну.
Такі конфлікти виявляються: PVC використовується для ефемерного тому, лише якщо його створено для цього Podʼа. Ця перевірка базується на відносинах власності. Наявний PVC не перезаписується і не змінюється. Але це не розвʼязує конфлікт, оскільки без правильного PVC Pod не може запуститися.
Увага:
Будьте обережні, називаючи Podʼи й томи в тому самому просторі імен, щоб таких конфліктів не виникало.
Безпека
Використання загальних ефемерних томів дозволяє користувачам створювати PVC опосередковано, якщо вони можуть створювати Podʼи, навіть якщо в них немає дозволу створювати PVC безпосередньо. Адміністратори кластера мають про це знати. Якщо це не відповідає їхній моделі безпеки, вони повинні використовувати вебхук допуску, який відхиляє обʼєкти, такі як Podʼи, що мають загальний ефемерний том.
Звичайна квота простору імен для PVC однаково застосовується, тому навіть якщо користувачам дозволено використовувати цей новий механізм, вони не можуть обходити з його допомогою інші політики.
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate VolumeAttributesClass, Kubernetes ignores it but does not report any error.
VolumeAttributesClass надає адміністраторам можливість описати змінні «класи» сховища, які вони пропонують. Різні класи можуть відповідати різним рівням якості обслуговування. Сам Kubernetes не має власної думки щодо того, що представляють ці класи.
Ця можливість загальнодоступна (GA) з версії 1.34, і користувачі можуть вимкнути її.
Крім того, VolumeAttributesClasses можна використовувати лише зі сховищем на основі Container Storage Interface і лише там, де відповідний драйвер CSI реалізує API ModifyVolume.
API VolumeAttributesClass
Кожен VolumeAttributesClass містить driverName та parameters, які використовуються, коли PersistentVolume (PV), що належить до цього класу, потрібно динамічно надати або змінити.
Назва обʼєкта VolumeAttributesClass є важливою: саме за нею користувачі можуть запитати певний клас. Адміністратори встановлюють назву та інші параметри класу під час першого створення обʼєктів VolumeAttributesClass. Хоча назву обʼєкта VolumeAttributesClass у PersistentVolumeClaim можна змінювати, параметри наявного класу є незмінними.
Ви не обмежені вказанням kubernetes-csi/external-provisioner. Ви також можете запускати та вказувати зовнішні provisioners — незалежні програми, які відповідають специфікації, визначеній Kubernetes. Автори зовнішніх provisioners мають повну свободу щодо того, де розміщено їхній код, як постачається provisioner, як його потрібно запускати, який втулок томів він використовує тощо.
VolumeAttributeClasses мають параметри, які описують томи, що до них належать. Залежно від provisioner або resizer можуть прийматися різні параметри. Наприклад, значення 4000 для параметра iops і параметр throughput є специфічними для GCE PD. Якщо параметр пропущено, під час надання тому використовується стандартне значення. Якщо користувач застосовує PVC з іншим VolumeAttributesClass із пропущеними параметрами, стандартне значення параметрів може використовуватися залежно від реалізації драйвера CSI. Докладніше дивіться в документації відповідного драйвера CSI.
Для VolumeAttributesClass можна визначити не більше 512 параметрів. Загальна довжина обʼєкта параметрів, включно з ключами та значеннями, не може перевищувати 256 KiB.
6.6.6 - Класи сховищ
У цьому документі описано концепцію StorageClass у Kubernetes. Рекомендується ознайомитися з томами та постійними томами.
StorageClass надає адміністраторам можливість описати класи сховища, які вони пропонують. Різні класи можуть відповідати рівням якості обслуговування, політикам резервного копіювання або довільним політикам, визначеним адміністраторами кластера. Сам Kubernetes не має власної думки щодо того, що представляють класи.
Концепція класу сховища в Kubernetes схожа на «профілі» в дизайні деяких інших систем зберігання.
Обʼєкти StorageClass
Кожен StorageClass містить поля provisioner, parameters та reclaimPolicy, які використовуються, коли PersistentVolume, що належить до цього класу, потрібно надати динамічно, щоб задовольнити PersistentVolumeClaim (PVC).
Назва обʼєкта StorageClass є важливою: саме за нею користувачі можуть запитати певний клас. Адміністратори встановлюють назву та інші параметри класу під час першого створення обʼєктів StorageClass.
Як адміністратор, ви можете вказати стандартний StorageClass, який застосовується до будь-яких PVC, що не запитують конкретний клас. Докладніше дивіться концепцію PersistentVolumeClaim.
apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:low-latencyannotations:storageclass.kubernetes.io/is-default-class:"false"provisioner:csi-driver.example-vendor.examplereclaimPolicy:Retain# типове значення — DeleteallowVolumeExpansion:truemountOptions:- discard# це може увімкнути UNMAP / TRIM на рівні блокового сховищаvolumeBindingMode:WaitForFirstConsumerparameters:guaranteedReadWriteLatency:"true"# залежить від провайдера
Стандартний StorageClass
Ви можете позначити StorageClass як стандартний для свого кластера. Інструкції щодо встановлення стандартного StorageClass дивіться в Зміна стандартного StorageClass.
Якщо PVC не вказує storageClassName, використовується стандартний StorageClass.
Якщо ви встановите анотацію storageclass.kubernetes.io/is-default-class у true для кількох StorageClass у своєму кластері, а потім створите PersistentVolumeClaim без встановленого storageClassName, Kubernetes використає найновіший стандартний StorageClass.
Примітка:
Намагайтеся мати у своєму кластері лише один StorageClass, позначений як стандартний. Kubernetes дозволяє мати кілька стандартних StorageClasses, щоб забезпечити безшовну міграцію.
Ви можете створити PersistentVolumeClaim, не вказуючи storageClassName для нового PVC, навіть якщо у вашому кластері немає стандартного StorageClass. У цьому випадку новий PVC створюється так, як ви його визначили, а storageClassName цього PVC залишається невстановленим, доки не стане доступним стандартний клас.
Ви можете мати кластер без стандартного StorageClass. Якщо ви не позначите жоден StorageClass як стандартний (і його не встановлено для вас, наприклад, хмарним провайдером), Kubernetes не зможе застосувати це стандартне значення до PersistentVolumeClaims, яким воно потрібне.
Якщо або коли стандартний StorageClass стає доступним, панель управління визначає всі наявні PVC без storageClassName. Для PVC, які мають порожнє значення storageClassName або не мають цього ключа, панель управління оновлює storageClassName відповідно до нового стандартного StorageClass. Якщо у вас є наявний PVC, де storageClassName має значення "", і ви налаштовуєте стандартний StorageClass, цей PVC не буде оновлено.
Щоб і надалі привʼязуватися до PV із storageClassName, встановленим у "" (за наявності стандартного StorageClass), вам потрібно встановити storageClassName повʼязаного PVC у "".
Provisioner
Кожен StorageClass має provisioner, який визначає, який втулок томів використовується для надання PV. Це поле є обовʼязковим.
Ви не обмежені вказанням перелічених тут «внутрішніх» provisioners (назви яких мають префікс "kubernetes.io" і які постачаються разом із Kubernetes). Ви також можете запускати та вказувати зовнішні provisioners — незалежні програми, які відповідають специфікації, визначеній Kubernetes. Автори зовнішніх provisioners мають повну свободу щодо того, де розміщено їхній код, як постачається provisioner, як його потрібно запускати, який втулок томів він використовує (зокрема Flex) тощо. У репозиторії kubernetes-sigs/sig-storage-lib-external-provisioner розміщено бібліотеку для написання зовнішніх provisioners, яка реалізує більшу частину специфікації. Деякі зовнішні provisioners перелічено в репозиторії kubernetes-sigs/sig-storage-lib-external-provisioner.
Наприклад, NFS не надає внутрішнього provisioner, але можна використовувати зовнішній. Також трапляється, що сторонні постачальники сховищ надають власний зовнішній provisioner.
Політика повторного використання
PersistentVolumes, які динамічно створюються за допомогою StorageClass, матимуть політику повторного використання, вказану в полі reclaimPolicy класу, яка може бути Delete або Retain. Якщо reclaimPolicy не вказано під час створення обʼєкта StorageClass, стандартним значенням буде Delete.
PersistentVolumes, створені вручну та керовані за допомогою StorageClass, матимуть ту політику повторного використання, яку їм було призначено під час створення.
Розширення томів
PersistentVolumes можна налаштувати як розширювані. Це дозволяє змінювати розмір тому, редагуючи відповідний обʼєкт PVC і запитуючи новий, більший обсяг сховища.
Такі типи томів підтримують розширення, коли базовий StorageClass має поле allowVolumeExpansion зі значенням true.
Таблиця типів томів і версій Kubernetes, яких вони потребують
Тип тому
Потрібна версія Kubernetes для розширення тому
Azure File
1.11
CSI
1.24
FlexVolume
1.13
Portworx
1.11
rbd
1.11
Примітка:
Можливість розширення томів можна використовувати лише для збільшення тому, але не для його зменшення.
Параметри монтування
PersistentVolumes, які динамічно створюються за допомогою StorageClass, матимуть параметри монтування, вказані в полі mountOptions класу.
Якщо втулок томів не підтримує параметри монтування, але їх вказано, надання завершиться невдачею. Параметри монтування не перевіряються ні на рівні класу, ні на рівні PV. Якщо параметр монтування недійсний, монтування PV завершиться невдачею.
Режим привʼязки тому
Поле volumeBindingMode визначає, коли мають відбуватися привʼязка томів і динамічне надання. Якщо його не встановлено, стандартно використовується режим Immediate.
Режим Immediate означає, що привʼязка томів і динамічне надання відбуваються одразу після створення PersistentVolumeClaim. Для бекендів сховища, які обмежені топологією й не доступні глобально з усіх вузлів кластера, PersistentVolumes будуть привʼязані або надані без урахування вимог планування Podʼа. Це може призвести до Podʼів, не придатних для планування.
Адміністратор кластера може розвʼязати цю проблему, вказавши режим WaitForFirstConsumer, який відкладає привʼязку та надання PersistentVolume до створення Podʼа, що використовує PersistentVolumeClaim. PersistentVolumes будуть вибрані або надані відповідно до топології, заданої обмеженнями планування Podʼа. Це, зокрема, вимоги до ресурсів, селектори вузлів, спорідненість та антиспорідненість Podʼів, а також taints і tolerations.
Такі втулки підтримують WaitForFirstConsumer із динамічним наданням:
Томи CSI, за умови, що конкретний драйвер CSI це підтримує
Такі втулки підтримують WaitForFirstConsumer із привʼязкою попередньо створених PersistentVolume:
Томи CSI, за умови, що конкретний драйвер CSI це підтримує
Якщо ви вирішили використовувати WaitForFirstConsumer, не використовуйте nodeName у специфікації Podʼа для задання спорідненості вузла. Якщо в цьому випадку використати nodeName, планувальник буде оминуто, а PVC залишиться в стані pending.
Натомість ви можете використати селектор вузла для kubernetes.io/hostname:
Коли оператор кластера вказує режим привʼязки томів WaitForFirstConsumer, у більшості випадків більше не потрібно обмежувати надання конкретними топологіями. Однак, якщо це все ще потрібно, можна вказати allowedTopologies.
У цьому прикладі показано, як обмежити топологію наданих томів конкретними зонами; це слід використовувати як заміну параметрам zone та zones для підтримуваних втулків.
StorageClasses мають параметри, які описують томи, що належать до класу сховища. Залежно від provisioner можуть прийматися різні параметри. Якщо параметр пропущено, використовується певне стандартне значення.
Для StorageClass можна визначити не більше 512 параметрів. Загальна довжина обʼєкта параметрів, включно з ключами та значеннями, не може перевищувати 256 KiB.
AWS EBS
Kubernetes 1.37 не містить типу тому awsElasticBlockStore.
Вбудований драйвер сховища AWSElasticBlockStore визнано застарілим у випуску Kubernetes v1.19, а потім повністю вилучено у випуску v1.27.
Проєкт Kubernetes пропонує натомість використовувати зовнішній драйвер сховища AWS EBS.
Ось приклад StorageClass для драйвера CSI AWS EBS:
server: Server — це імʼя хоста або IP-адреса сервера NFS.
path: Шлях, який експортується сервером NFS.
readOnly: Прапорець, який вказує, чи буде сховище змонтовано лише для читання (стандартно false).
Kubernetes не містить внутрішнього provisioner для NFS. Щоб створити StorageClass для NFS, потрібно використовувати зовнішній provisioner. Ось кілька прикладів:
datastore: Користувач також може вказати datastore у StorageClass. Том буде створено в datastore, вказаному в StorageClass, у цьому випадку — VSANDatastore. Це поле є необовʼязковим. Якщо datastore не вказано, том буде створено в datastore, вказаному у файлі конфігурації vSphere, який використовується для ініціалізації хмарного провайдера vSphere.
Керування політикою сховища в Kubernetes
Використання наявної політики SPBM vCenter
Однією з найважливіших можливостей vSphere для керування сховищем є керування на основі політик. Керування сховищем на основі політик (Storage Policy Based Management, SPBM) — це фреймворк політик сховища, який надає єдину уніфіковану панель управління для широкого спектра сервісів даних і рішень зберігання. SPBM дозволяє адміністраторам vSphere долати початкові проблеми надання сховища, такі як планування місткості, диференційовані рівні обслуговування та керування запасом місткості.
Політики SPBM можна вказати в StorageClass за допомогою параметра storagePolicyName.
Підтримка політики Virtual SAN всередині Kubernetes
Адміністратори Vsphere Infrastructure (VI) матимуть змогу вказувати власні можливості сховища Virtual SAN під час динамічного надання томів. Тепер ви можете визначати вимоги до сховища, такі як продуктивність і доступність, у вигляді можливостей сховища під час динамічного надання томів. Вимоги до можливостей сховища перетворюються на політику Virtual SAN, яка потім передається на рівень Virtual SAN під час створення постійного тому (віртуального диска). Віртуальний диск розподіляється по сховищу даних Virtual SAN відповідно до вимог.
apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:fastprovisioner:kubernetes.io/rbd# This provisioner is deprecatedparameters:monitors:198.19.254.105:6789adminId:kubeadminSecretName:ceph-secretadminSecretNamespace:kube-systempool:kubeuserId:kubeuserSecretName:ceph-secret-useruserSecretNamespace:defaultfsType:ext4imageFormat:"2"imageFeatures:"layering"
monitors: Монітори Ceph, розділені комою. Цей параметр є обовʼязковим.
adminId: Ідентифікатор клієнта Ceph, який може створювати образи в пулі. Стандартно "admin".
adminSecretName: Назва Secret для adminId. Цей параметр є обовʼязковим. Наданий Secret повинен мати тип "kubernetes.io/rbd".
adminSecretNamespace: Простір імен для adminSecretName. Стандартно "default".
pool: Пул Ceph RBD. Стандартно "rbd".
userId: Ідентифікатор клієнта Ceph, який використовується для зіставлення образу RBD. Стандартно такий самий, як adminId.
userSecretName: Назва Ceph Secret для userId для зіставлення образу RBD. Він має існувати в тому самому просторі імен, що й PVC. Цей параметр є обовʼязковим. Наданий Secret повинен мати тип "kubernetes.io/rbd", наприклад, створений таким чином:
userSecretNamespace: Простір імен для userSecretName.
fsType: fsType, який підтримує Kubernetes. Стандартно: "ext4".
imageFormat: Формат образу Ceph RBD, "1" або "2". Стандартно "2".
imageFeatures: Цей параметр є необовʼязковим, і його слід використовувати лише тоді, коли ви встановили imageFormat у "2". Наразі підтримується лише можливість layering. Стандартно "", і жодну можливість не ввімкнено.
Azure Disk
Kubernetes 1.37 не містить типу тому azureDisk.
Вбудований драйвер сховища azureDisk визнано застарілим у випуску Kubernetes v1.19, а потім повністю вилучено у випуску v1.27.
Проєкт Kubernetes пропонує натомість використовувати сторонній драйвер сховища Azure Disk.
apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:azurefileprovisioner:kubernetes.io/azure-fileparameters:skuName:Standard_LRSlocation:eastusstorageAccount:azure_storage_account_name# example value
skuName: Рівень SKU облікового запису Azure Storage. Стандартно порожній.
location: Розташування облікового запису Azure Storage. Стандартно порожнє.
storageAccount: Назва облікового запису Azure Storage. Стандартно порожня. Якщо обліковий запис сховища не вказано, серед усіх облікових записів сховища, повʼязаних із групою ресурсів, шукається той, що відповідає skuName та location. Якщо обліковий запис сховища вказано, він має бути в тій самій групі ресурсів, що й кластер, а skuName та location ігноруються.
secretNamespace: Простір імен Secret, що містить назву та ключ облікового запису Azure Storage. Стандартно той самий, що й у Podʼа.
secretName: Назва Secret, що містить назву та ключ облікового запису Azure Storage. Стандартно azure-storage-account-<accountName>-secret.
readOnly: Прапорець, який вказує, чи буде сховище змонтовано лише для читання. Стандартно false, що означає монтування для читання й запису. Це налаштування також впливає на налаштування ReadOnly у VolumeMounts.
Під час надання сховища для облікових даних монтування створюється Secret із назвою secretName. Якщо в кластері ввімкнено і RBAC, і ролі контролерів, додайте дозвіл create на ресурс secret для clusterrole system:controller:persistent-volume-binder.
У контексті багатоорендності наполегливо рекомендується явно встановлювати значення secretNamespace, інакше облікові дані облікового запису сховища можуть прочитати інші користувачі.
apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:portworx-io-priority-highprovisioner:kubernetes.io/portworx-volume# This provisioner is deprecatedparameters:repl:"1"snap_interval:"70"priority_io:"high"
fs: файлова система для створення: none/xfs/ext4 (стандартно: ext4).
block_size: розмір блоку в кілобайтах (стандартно: 32).
repl: кількість синхронних реплік у формі коефіцієнта реплікації 1..3 (стандартно: 1). Тут очікується рядок, тобто "1", а не 1.
priority_io: визначає, чи буде том створено зі сховища вищої продуктивності чи нижчого пріоритету: high/medium/low (стандартно: low).
snap_interval: інтервал у хвилинах для запуску знімків. Знімки є інкрементними на основі різниці з попереднім знімком, 0 вимикає знімки (стандартно: 0). Тут очікується рядок, тобто "70", а не 70.
aggregation_level: вказує кількість частин, на які буде розподілено том, 0 означає неагрегований том (стандартно: 0). Тут очікується рядок, тобто "0", а не 0.
ephemeral: вказує, чи слід очищати том після відмонтування, чи він має бути постійним. Для випадку використання emptyDir це значення можна встановити в true, а для випадку persistent volumes, наприклад, для баз даних на кшталт Cassandra, слід установити false: true/false (стандартно false). Тут очікується рядок, тобто "true", а не true.
apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:local-storageprovisioner:kubernetes.io/no-provisioner# indicates that this StorageClass does not support automatic provisioningvolumeBindingMode:WaitForFirstConsumer
Локальні томи не підтримують динамічне надання в Kubernetes 1.37; однак StorageClass однаково слід створити, щоб відкласти привʼязку тому до фактичного планування Podʼа на відповідний вузол. Це задається режимом привʼязки томів WaitForFirstConsumer.
Відкладення привʼязки тому дозволяє планувальнику враховувати всі обмеження планування Podʼа під час вибору відповідного PersistentVolume для PersistentVolumeClaim.
6.6.7 - Динамічне надання томів
Динамічне надання томів дозволяє створювати томи сховища на вимогу. Без динамічного надання адміністратори кластера змушені вручну звертатися до свого хмарного провайдера або постачальника сховища, щоб створити нові томи сховища, а потім створювати обʼєкти PersistentVolume, які представляють їх у Kubernetes. Можливість динамічного надання усуває потребу адміністраторів кластера заздалегідь надавати сховище. Натомість сховище надається автоматично, коли користувачі створюють обʼєкти PersistentVolumeClaim.
Загальні відомості
Реалізація динамічного надання томів базується на обʼєкті API StorageClass із групи API storage.k8s.io. Адміністратор кластера може визначити стільки обʼєктів StorageClass, скільки потрібно, і кожен із них вказує втулок томів (також відомий як provisioner), який надає том, і набір параметрів, які слід передати цьому provisioner під час надання. Адміністратор кластера може визначити та зробити доступними кілька різновидів сховища (з однієї або різних систем зберігання) у межах кластера, кожен із власним набором параметрів. Така архітектура також гарантує, що кінцевим користувачам не потрібно перейматися складністю та нюансами надання сховища, але вони все одно можуть вибирати з кількох варіантів сховища.
Щоб увімкнути динамічне надання, адміністратор кластера має заздалегідь створити для користувачів один або кілька обʼєктів StorageClass. Обʼєкти StorageClass визначають, який provisioner слід використовувати та які параметри потрібно передати цьому provisioner під час виклику динамічного надання. Назва обʼєкта StorageClass має бути дійсним іменем DNS-піддомену.
Наведений нижче маніфест створює клас сховища "slow", який надає стандартні постійні диски, подібні до звичайних дисків.
Користувачі запитують динамічно надане сховище, вказуючи клас сховища у своєму PersistentVolumeClaim. До Kubernetes v1.6 це робилося за допомогою анотації volume.beta.kubernetes.io/storage-class. Однак ця анотація застаріла з версії v1.9. Тепер користувачі можуть і повинні використовувати натомість поле storageClassName обʼєкта PersistentVolumeClaim. Значення цього поля має збігатися з назвою StorageClass, налаштованого адміністратором (дивіться Увімкнення динамічного надання).
Наприклад, щоб вибрати клас сховища "fast", користувач створює такий PersistentVolumeClaim:
Цей PersistentVolumeClaim призводить до автоматичного надання постійного диска, подібного до SSD. Коли PersistentVolumeClaim видаляють, том знищується.
Стандартна поведінка
Динамічне надання можна ввімкнути в кластері так, щоб усі PersistentVolumeClaims надавалися динамічно, якщо клас сховища не вказано. Адміністратор кластера може ввімкнути таку поведінку таким чином:
Позначити один обʼєкт StorageClass як стандартний.
Адміністратор може позначити певний StorageClass як стандартний, додавши до нього анотацію storageclass.kubernetes.io/is-default-class. Коли в кластері є стандартний StorageClass і користувач створює PersistentVolumeClaim без вказаного storageClassName, контролер допуску DefaultStorageClass автоматично додає поле storageClassName, що вказує на стандартний клас сховища.
Зверніть увагу, що якщо ви встановите анотацію storageclass.kubernetes.io/is-default-class у true для кількох StorageClass у своєму кластері, а потім створите PersistentVolumeClaim без встановленого storageClassName, Kubernetes використає найновіший стандартний StorageClass.
Урахування топології
У кластерах із кількома зонами Podʼи можуть бути розподілені між зонами регіону. Однозонні бекенди сховища слід надавати в тих зонах, де заплановано Podʼи. Цього можна досягти, встановивши режим привʼязки тому.
6.6.8 - Знімки томів
У Kubernetes VolumeSnapshot представляє знімок тому в системі зберігання. У цьому документі передбачається, що ви вже знайомі з постійними томами Kubernetes.
Вступ
Подібно до того, як ресурси API PersistentVolume та PersistentVolumeClaim використовуються для надання томів користувачам і адміністраторам, ресурси API VolumeSnapshotContent та VolumeSnapshot призначені для створення знімків томів для користувачів і адміністраторів.
VolumeSnapshotContent — це знімок, зроблений із тому в кластері, наданого адміністратором. Це ресурс у кластері, так само як PersistentVolume є ресурсом кластера.
VolumeSnapshot — це запит на знімок тому від користувача. Він схожий на PersistentVolumeClaim.
VolumeSnapshotClass дозволяє вказати різні атрибути, що належать до VolumeSnapshot. Ці атрибути можуть відрізнятися для знімків, зроблених з одного й того самого тому в системі зберігання, і тому їх не можна виразити за допомогою того самого StorageClass у PersistentVolumeClaim.
Знімки томів надають користувачам Kubernetes стандартизований спосіб копіювання вмісту тому на певний момент часу без створення цілком нового тому. Ця функціональність дозволяє, наприклад, адміністраторам баз даних створювати резервні копії баз даних перед внесенням змін або видаленням.
Під час використання цієї можливості користувачі повинні знати таке:
API-обʼєкти VolumeSnapshot, VolumeSnapshotContent та VolumeSnapshotClass є CRDs, а не частиною основного API.
Підтримка VolumeSnapshot доступна лише для драйверів CSI.
У межах процесу розгортання VolumeSnapshot команда Kubernetes надає контролер знімків, який розгортається в панелі управління, і допоміжний sidecar-контейнер csi-snapshotter, який розгортається разом із драйвером CSI. Контролер знімків стежить за обʼєктами VolumeSnapshot та VolumeSnapshotContent і відповідає за створення та видалення обʼєкта VolumeSnapshotContent. Sidecar-контейнер csi-snapshotter стежить за обʼєктами VolumeSnapshotContent і запускає операції CreateSnapshot та DeleteSnapshot для точки доступу CSI.
Також існує сервер валідаційного вебхука, який забезпечує посилену валідацію обʼєктів знімків. Його мають встановлювати дистрибутиви Kubernetes разом із контролером знімків і CRDs, а не драйвери CSI. Його слід встановити в усіх кластерах Kubernetes, де ввімкнено можливість знімків.
Драйвери CSI можуть реалізовувати функціональність знімків томів, а можуть і не реалізовувати. Драйвери CSI, які надають підтримку знімків томів, імовірно, використовуватимуть csi-snapshotter. Докладніше дивіться в документації драйверів CSI.
За встановлення CRDs та контролера знімків відповідає дистрибутив Kubernetes.
У кластерах, де знімок можна використовувати лише з частини кластера (наприклад, знімок тому в одній зоні багатозонового кластера без спільного сховища), топологію знімка можна записати та враховувати під час відновлення з нього. Докладніше дивіться у зовнішній документації CSI.
Життєвий цикл знімка тому та вмісту знімка тому
VolumeSnapshotContents — це ресурси в кластері. VolumeSnapshots — це запити на ці ресурси. Взаємодія між VolumeSnapshotContents та VolumeSnapshots відбувається за таким життєвим циклом:
Надання знімків томів
Знімки можна надавати двома способами: попередньо або динамічно.
Попереднє надання
Адміністратор кластера створює певну кількість VolumeSnapshotContents. Вони містять відомості про реальний знімок тому в системі зберігання, доступний для використання користувачами кластера. Вони існують в API Kubernetes і доступні для використання.
Динамічне надання
Замість використання наявного знімка ви можете запросити динамічне створення знімка з PersistentVolumeClaim. VolumeSnapshotClass вказує специфічні для постачальника сховища параметри, які слід використовувати під час створення знімка.
Привʼязка
Контролер знімків відповідає за привʼязку обʼєкта VolumeSnapshot до відповідного обʼєкта VolumeSnapshotContent як за попереднього, так і за динамічного надання. Привʼязка є зіставленням один до одного.
У випадку попереднього надання VolumeSnapshot залишається непривʼязаним, доки не буде створено запитаний обʼєкт VolumeSnapshotContent.
Захист PersistentVolumeClaim як джерела знімка
Мета цього захисту — гарантувати, що обʼєкти API PersistentVolumeClaim, які використовуються, не вилучаються із системи, поки з них робиться знімок (оскільки це може призвести до втрати даних).
Поки з PersistentVolumeClaim робиться знімок, цей PersistentVolumeClaim вважається таким, що використовується. Якщо ви видалите обʼєкт API PersistentVolumeClaim, який активно використовується як джерело знімка, обʼєкт PersistentVolumeClaim вилучається не одразу. Натомість його вилучення відкладається, доки знімок не стане readyToUse або не буде перерваний.
Видалення
Видалення запускається видаленням обʼєкта VolumeSnapshot, і далі діє DeletionPolicy. Якщо DeletionPolicy має значення Delete, базовий знімок сховища буде видалено разом з обʼєктом VolumeSnapshotContent. Якщо DeletionPolicy має значення Retain, то і базовий знімок, і VolumeSnapshotContent залишаються.
persistentVolumeClaimName — це назва обʼєкта PersistentVolumeClaim, який є джерелом даних для знімка. Це поле є обовʼязковим для динамічного створення знімка.
Знімок тому може запитати певний клас, вказавши назву VolumeSnapshotClass в атрибуті volumeSnapshotClassName. Якщо нічого не вказано, використовується стандартний клас, якщо він доступний.
Для попередньо наданих знімків потрібно вказати volumeSnapshotContentName як джерело знімка, як показано в наведеному нижче прикладі. Поле джерела volumeSnapshotContentName є обовʼязковим для попередньо наданих знімків.
Кожен VolumeSnapshotContent містить spec і status. Під час динамічного надання загальний контролер знімків створює обʼєкти VolumeSnapshotContent. Ось приклад:
volumeHandle — це унікальний ідентифікатор тому, створеного в бекенді сховища й повернутого драйвером CSI під час створення тому. Це поле є обовʼязковим для динамічного надання знімка. Воно вказує том-джерело знімка.
Для попередньо наданих знімків ви (як адміністратор кластера) відповідаєте за створення обʼєкта VolumeSnapshotContent, як показано нижче.
snapshotHandle — це унікальний ідентифікатор знімка тому, створеного в бекенді сховища. Це поле є обовʼязковим для попередньо наданих знімків. Воно вказує ідентифікатор знімка CSI в системі зберігання, який представляє цей VolumeSnapshotContent.
sourceVolumeMode — це режим тому, з якого зроблено знімок. Значенням поля sourceVolumeMode може бути Filesystem або Block. Якщо режим вихідного тому не вказано, Kubernetes вважає, що режим вихідного тому невідомий.
volumeSnapshotRef — це посилання на відповідний VolumeSnapshot. Зверніть увагу, що коли VolumeSnapshotContent створюється як попередньо наданий знімок, VolumeSnapshot, на який посилається volumeSnapshotRef, може ще не існувати.
Зміна режиму тому знімка
Якщо API VolumeSnapshots, встановлений у вашому кластері, підтримує поле sourceVolumeMode, то API може не давати неавторизованим користувачам змінювати режим тому.
Щоб перевірити, чи підтримує ваш кластер цю можливість, виконайте таку команду:
$ kubectl get crd volumesnapshotcontent -o yaml
Якщо ви хочете дозволити користувачам створювати PersistentVolumeClaim з наявного VolumeSnapshot, але з іншим режимом тому, ніж у джерела, слід додати анотацію snapshot.storage.kubernetes.io/allow-volume-mode-change: "true" до VolumeSnapshotContent, який відповідає VolumeSnapshot.
Для попередньо наданих знімків spec.sourceVolumeMode має заповнити адміністратор кластера.
Приклад ресурсу VolumeSnapshotContent із увімкненою цією можливістю виглядатиме так:
У деяких кластерах знімок можна використовувати лише з частини кластера. Наприклад, у багатозоновому кластері, де сховище не є спільним між зонами, знімок тому в одній зоні можна використовувати лише з цієї зони: томи, відновлені зі знімка, можна створювати лише там, де розташовані дані знімка.
Коли ввімкнено можливість VolumeSnapshotTopology, ця топологія записується та враховується:
Адміністратор кластера може встановити allowedTopologies у VolumeSnapshotClass, щоб вказати, звідки мають бути доступні динамічно створені знімки.
Драйвер CSI повідомляє, звідки можна використовувати знімок, а sidecar-контейнер csi-snapshotter записує це в VolumeSnapshotContent.spec.nodeAffinity.
Коли ви надаєте том зі знімка, ця топологія використовується для розміщення відновленого тому там, де доступні дані знімка.
Це альфа-можливість sidecar-контейнерів CSI, яка вмикається функціональною можливістю VolumeSnapshotTopology у csi-snapshotter та external-provisioner. Докладніше дивіться у зовнішній документації CSI.
Надання томів зі знімків
Ви можете надати новий том, попередньо заповнений даними зі знімка, за допомогою поля dataSource в обʼєкті PersistentVolumeClaim.
У цьому документі описано концепцію VolumeSnapshotClass у Kubernetes. Рекомендується ознайомитися зі знімками томів та класами сховищ.
Вступ
Так само як StorageClass надає адміністраторам можливість описувати «класи» сховища, які вони пропонують під час надання тому, VolumeSnapshotClass надає можливість описувати «класи» сховища під час надання знімка тому.
Ресурс VolumeSnapshotClass
Кожен VolumeSnapshotClass містить поля driver, deletionPolicy та parameters, які використовуються, коли VolumeSnapshot, що належить до цього класу, потрібно надати динамічно.
Назва обʼєкта VolumeSnapshotClass є важливою: саме за нею користувачі можуть запитати певний клас. Адміністратори встановлюють назву та інші параметри класу під час першого створення обʼєктів VolumeSnapshotClass, і ці обʼєкти не можна оновлювати після створення.
Примітка:
За встановлення CRD відповідає дистрибутив Kubernetes. Якщо потрібних CRD немає, створення VolumeSnapshotClass завершиться невдачею.
Адміністратори можуть вказати стандартний VolumeSnapshotClass для VolumeSnapshots, які не запитують привʼязки до певного класу, додавши анотацію snapshot.storage.kubernetes.io/is-default-class: "true":
Якщо існує кілька драйверів CSI, для кожного з них можна вказати стандартний VolumeSnapshotClass.
Залежності VolumeSnapshotClass
Коли ви створюєте VolumeSnapshot без зазначення VolumeSnapshotClass, Kubernetes автоматично вибирає стандартний VolumeSnapshotClass, драйвер CSI якого збігається з драйвером CSI StorageClass цього PVC.
Така поведінка дозволяє кільком стандартним обʼєктам VolumeSnapshotClass співіснувати в кластері, якщо кожен із них повʼязаний з унікальним драйвером CSI.
Завжди переконуйтеся, що для кожного драйвера CSI існує лише один стандартний VolumeSnapshotClass. Якщо з одним драйвером CSI створено кілька стандартних обʼєктів VolumeSnapshotClass, створення VolumeSnapshot завершиться невдачею, оскільки Kubernetes не зможе визначити, який із них використати.
Driver
Класи знімків томів мають драйвер, який визначає, який втулок томів CSI використовується для надання VolumeSnapshots. Це поле є обовʼязковим.
DeletionPolicy
Класи знімків томів мають deletionPolicy. Вона дозволяє налаштувати, що станеться з VolumeSnapshotContent, коли обʼєкт VolumeSnapshot, до якого він привʼязаний, буде видалено. Значення deletionPolicy класу знімків томів може бути Retain або Delete. Це поле є обовʼязковим.
Якщо deletionPolicy має значення Delete, базовий знімок сховища буде видалено разом з обʼєктом VolumeSnapshotContent. Якщо deletionPolicy має значення Retain, то і базовий знімок, і VolumeSnapshotContent залишаються.
Параметри
Класи знімків томів мають параметри, які описують знімки томів, що належать до цього класу. Залежно від driver можуть прийматися різні параметри.
6.6.10 - Клонування томів CSI
У цьому документі описано концепцію клонування наявних томів CSI у Kubernetes. Рекомендується ознайомитися з томами.
Вступ
Можливість клонування томів CSI додає підтримку вказання наявних PVC у полі dataSource, щоб позначити, що користувач хоче клонувати том.
Клон — це дублікат наявного тому Kubernetes, який можна використовувати так само, як будь-який стандартний том. Єдина відмінність полягає в тому, що під час надання, замість створення «нового» порожнього тому, бекенд-пристрій створює точний дублікат вказаного тому.
З погляду API Kubernetes реалізація клонування додає можливість вказати наявний PVC як dataSource під час створення нового PVC. Вихідний PVC має бути привʼязаним і доступним (не використовуватися).
Під час використання цієї можливості користувачі повинні знати таке:
Підтримка клонування (VolumePVCDataSource) доступна лише для драйверів CSI.
Підтримка клонування доступна лише для динамічних provisioners.
Драйвери CSI можуть реалізовувати функціональність клонування томів, а можуть і не реалізовувати.
Ви можете клонувати PVC лише тоді, коли він існує в тому самому просторі імен, що й цільовий PVC (джерело та призначення мають бути в одному просторі імен).
Клонування підтримується з іншим Storage Class.
Цільовий том може мати той самий або інший клас сховища, ніж джерело.
Можна використовувати стандартний клас сховища, пропустивши storageClassName у специфікації.
Клонування можна виконати лише між двома томами, які використовують однакове значення VolumeMode (якщо ви запитуєте том у блоковому режимі, джерело ТАКОЖ ПОВИННО бути в блоковому режимі)
Надання
Клони надаються так само, як і будь-який інший PVC, за винятком додавання dataSource, який посилається на наявний PVC у тому самому просторі імен.
Ви повинні вказати значення місткості для spec.resources.requests.storage, і воно має бути таким самим або більшим за місткість вихідного тому.
Результатом є новий PVC із назвою clone-of-pvc-1, який має точно такий самий вміст, як і вказане джерело pvc-1.
Використання
Коли новий PVC стає доступним, клонований PVC використовується так само, як і інші PVC. На цьому етапі також очікується, що новостворений PVC є незалежним обʼєктом. Його можна використовувати, клонувати, створювати його знімки чи видаляти незалежно й без огляду на вихідний PVC з dataSource. Це також означає, що джерело ніяк не повʼязане з новоствореним клоном і його також можна змінити чи видалити, не впливаючи на новостворений клон.
6.6.11 - Наповнювачі томів та джерела даних
У цьому документі описано наповнювачі томів (volume populators) та джерела даних (data sources) у Kubernetes. Рекомендується ознайомитися з постійними томами.
Коли ви створюєте PersistentVolumeClaim, том, який Kubernetes надає для нього, зазвичай спочатку порожній. Джерело даних дозволяє натомість запитати, щоб новий том було попередньо заповнено наявними даними. Наповнювачі томів — це контролери, які виконують це заповнення на основі джерела даних, на яке посилається PersistentVolumeClaim.
Kubernetes має вбудовану підтримку джерел даних, які клонують наявний том або відновлюють знімок тому. Власні наповнювачі томів розширюють цей механізм. Джерело даних — це власний ресурс, тобто обʼєкт, тип якого визначено за допомогою CustomResourceDefinition. Контролер-наповнювач стежить за PersistentVolumeClaims, які посилаються на такий ресурс, і заповнює з нього новий том.
Наповнювачі томів та джерела даних
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.24
Kubernetes підтримує власні наповнювачі томів. Щоб використовувати власні наповнювачі томів, ви повинні ввімкнути функціональну можливість AnyVolumeDataSource для kube-apiserver та kube-controller-manager.
Наповнювачі томів використовують поле специфікації PVC з назвою dataSourceRef. На відміну від поля dataSource, яке може містити лише посилання на інший PersistentVolumeClaim або на VolumeSnapshot, поле dataSourceRef може містити посилання на будь-який обʼєкт у тому самому просторі імен, за винятком основних обʼєктів, відмінних від PVC. Для кластерів, у яких увімкнено цю функціональну можливість, слід надавати перевагу dataSourceRef, а не dataSource.
Посилання на джерела даних
Поле dataSourceRef поводиться майже так само, як поле dataSource. Якщо вказано одне з них, а інше ні, API-сервер надасть обом полям однакове значення. Жодне з полів не можна змінити після створення, а спроба вказати різні значення для цих двох полів призведе до помилки валідації. Тому обидва поля завжди матимуть однаковий вміст.
Існують дві відмінності між полями dataSourceRef та dataSource, про які користувачі повинні знати:
Поле dataSource ігнорує недійсні значення (ніби поле було порожнім), тоді як dataSourceRef ніколи не ігнорує значення і спричинить помилку, якщо використано недійсне значення. Недійсними значеннями є будь-які основні обʼєкти (обʼєкти без apiGroup), крім PVC.
Поле dataSourceRef може містити різні типи обʼєктів, тоді як поле dataSource дозволяє лише PVC та VolumeSnapshots.
Коли ввімкнено можливість CrossNamespaceVolumeDataSource, зʼявляються додаткові відмінності:
Поле dataSource дозволяє лише локальні обʼєкти, тоді як поле dataSourceRef дозволяє обʼєкти в будь-яких просторах імен.
Коли вказано простір імен, dataSource та dataSourceRef не синхронізуються.
Користувачі завжди повинні використовувати dataSourceRef у кластерах, де ввімкнено цю функціональну можливість, і повертатися до dataSource у кластерах, де її не ввімкнено. За жодних обставин не потрібно переглядати обидва поля. Дубльовані значення з дещо різною семантикою існують лише для зворотної сумісності. Зокрема, суміш старіших і новіших контролерів може взаємодіяти, оскільки поля однакові.
Використання наповнювачів томів
Наповнювачі томів — це контролери, які можуть створювати непорожні томи, вміст яких визначається власним ресурсом. Користувачі створюють заповнений том, посилаючись на власний ресурс за допомогою поля dataSourceRef:
Оскільки наповнювачі томів є зовнішніми компонентами, спроби створити PVC, який використовує один із них, можуть завершитися невдачею, якщо встановлено не всі потрібні компоненти. Зовнішні контролери повинні генерувати Events на PVC, щоб надавати зворотний звʼязок про статус створення, зокрема попередження, якщо PVC неможливо створити через відсутність певного компонента.
Ви можете встановити у свій кластер alpha-контролер volume data source validator. Цей контролер генерує попереджувальні Events на PVC, якщо жоден наповнювач не зареєстровано для обробки такого виду джерела даних. Коли для PVC встановлено відповідний наповнювач, саме цей контролер-наповнювач відповідає за створення Events, повʼязаних зі створенням тому та проблемами під час цього процесу.
Джерела даних між просторами імен
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.26
Kubernetes підтримує джерела даних томів між просторами імен. Щоб використовувати їх, ви повинні ввімкнути функціональні можливості AnyVolumeDataSource та CrossNamespaceVolumeDataSource для kube-apiserver та kube-controller-manager. Крім того, ви повинні ввімкнути функціональну можливість CrossNamespaceVolumeDataSource для csi-provisioner.
Увімкнення функціональної можливості CrossNamespaceVolumeDataSource дозволяє вказати простір імен у полі dataSourceRef.
Примітка:
Коли ви вказуєте простір імен для джерела даних тому, Kubernetes перевіряє наявність ReferenceGrant в іншому просторі імен, перш ніж прийняти посилання. ReferenceGrant є частиною API розширення gateway.networking.k8s.io. Докладніше дивіться в розділі ReferenceGrant документації Gateway API. Це означає, що перед використанням цього механізму ви повинні розширити свій кластер Kubernetes принаймні ресурсом ReferenceGrant із Gateway API.
Використання джерела даних тому між просторами імен
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.26
Створіть ReferenceGrant, щоб дозволити власнику простору імен прийняти посилання. Ви визначаєте заповнений том, вказуючи джерело даних тому між просторами імен за допомогою поля dataSourceRef. У вихідному просторі імен уже повинен існувати дійсний ReferenceGrant:
Місткість сховища обмежена і може відрізнятися залежно від вузла, на якому працює Pod: мережеве сховище може бути доступним не всім вузлам, а сховище може бути локальним для вузла від самого початку.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
На цій сторінці описано, як Kubernetes відстежує місткість сховища та як планувальник використовує цю інформацію, щоб планувати Podʼи на вузли, які мають доступ до достатньої місткості сховища для томів, яких ще бракує. Без відстеження місткості сховища планувальник може вибрати вузол, який не має достатньо місткості для надання тому, і знадобиться кілька повторних спроб планування.
Перш ніж ви розпочнете
Kubernetes v1.37 містить підтримку API на рівні кластера для відстеження місткості сховища. Щоб скористатися нею, ви також повинні використовувати драйвер CSI, який підтримує відстеження місткості. Зверніться до документації драйверів CSI, які ви використовуєте, щоб дізнатися, чи доступна ця підтримка і, якщо так, як її використовувати. Якщо ви не використовуєте Kubernetes v1.37, перегляньте документацію для своєї версії Kubernetes.
API
Для цієї можливості існує два розширення API:
Обʼєкти CSIStorageCapacity: їх створює драйвер CSI у просторі імен, де його встановлено. Кожен обʼєкт містить інформацію про місткість для одного класу сховища і визначає, які вузли мають доступ до цього сховища.
Поле CSIDriverSpec.StorageCapacity: якщо встановлено значення true, планувальник Kubernetes враховуватиме місткість сховища для томів, які використовують драйвер CSI.
Планування
Планувальник Kubernetes використовує інформацію про місткість сховища, якщо:
обʼєкт CSIDriver для цього драйвера має StorageCapacity зі значенням true.
У цьому випадку планувальник розглядає для Podʼа лише ті вузли, яким доступно достатньо сховища. Ця перевірка дуже спрощена і лише порівнює розмір тому з місткістю, вказаною в обʼєктах CSIStorageCapacity з топологією, що включає цей вузол.
Для томів із режимом привʼязки Immediate драйвер сховища вирішує, де створити том, незалежно від Podʼів, які використовуватимуть цей том. Потім планувальник планує Podʼи на вузли, де том доступний після його створення.
Для ефемерних томів CSI планування завжди відбувається без урахування місткості сховища. Це ґрунтується на припущенні, що цей тип тому використовують лише спеціальні драйвери CSI, які є локальними для вузла й не потребують там значних ресурсів.
Перепланування
Коли вузол вибрано для Podʼа з томами WaitForFirstConsumer, це рішення все ще є попереднім. Наступним кроком драйверу сховища CSI надсилається запит створити том із підказкою, що том має бути доступний на вибраному вузлі.
Оскільки Kubernetes міг вибрати вузол на підставі застарілої інформації про місткість, може статися, що том не вдасться створити. Тоді вибір вузла скидається, і планувальник Kubernetes знову намагається знайти вузол для Podʼа.
Обмеження
Відстеження місткості сховища збільшує ймовірність того, що планування спрацює з першої спроби, але не може цього гарантувати, оскільки планувальник має приймати рішення на підставі потенційно застарілої інформації. Зазвичай збої планування обробляє той самий механізм повторних спроб, що й для планування без інформації про місткість сховища.
Одна із ситуацій, коли планування може остаточно зазнати невдачі, — коли Pod використовує кілька томів: один том уже може бути створений у сегменті топології, де потім бракує місткості для іншого тому. Щоб це виправити, потрібне ручне втручання, наприклад, збільшення місткості або видалення вже створеного тому.
На цій сторінці описано максимальну кількість томів, які можна підʼєднати до вузла, для різних хмарних провайдерів.
Хмарні провайдери, такі як Google, Amazon і Microsoft, зазвичай обмежують кількість томів, які можна підʼєднати до вузла. Важливо, щоб Kubernetes дотримувався цих обмежень. Інакше Podʼи, заплановані на вузол, можуть застрягти в очікуванні підʼєднання томів.
Стандартні обмеження Kubernetes
Планувальник Kubernetes має стандартні обмеження на кількість томів, які можна підʼєднати до вузла:
Обмеження динамічних томів підтримуються для таких типів томів.
Amazon EBS
Google Persistent Disk
Azure Disk
CSI
Для томів, керованих вбудованими втулками томів, Kubernetes автоматично визначає тип вузла і застосовує відповідну максимальну кількість томів для вузла. Наприклад:
Для дисків Amazon EBS на типах екземплярів M5,C5,R5,T3 та Z1D Kubernetes дозволяє підʼєднувати до вузла лише 25 томів. Для інших типів екземплярів в Amazon Elastic Compute Cloud (EC2) Kubernetes дозволяє підʼєднувати до вузла 39 томів.
Якщо драйвер сховища CSI оголошує максимальну кількість томів для вузла (за допомогою NodeGetInfo), kube-scheduler дотримується цього обмеження. Докладніше дивіться в специфікаціях CSI.
Для томів, керованих вбудованими втулками, які було перенесено на драйвер CSI, максимальною кількістю томів буде та, про яку повідомляє драйвер CSI.
Mutable CSI Node Allocatable Count
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.36. It was first available in the v1.33 release.
Драйвери CSI можуть динамічно змінювати максимальну кількість томів, які можна підʼєднати до вузла, під час роботи. Це підвищує точність планування та зменшує кількість збоїв планування Podʼів через зміни в доступності ресурсів.
Щоб скористатися цією можливістю, ви повинні ввімкнути функціональну можливість MutableCSINodeAllocatableCount у таких компонентах:
kube-apiserver
kubelet
Періодичні оновлення
Якщо цю можливість увімкнено, драйвери CSI можуть запитувати періодичні оновлення своїх обмежень томів, встановивши поле nodeAllocatableUpdatePeriodSeconds у специфікації CSIDriver. Наприклад:
kubelet періодично викликатиме точку доступу NodeGetInfo відповідного драйвера CSI, щоб оновити максимальну кількість томів, які можна підʼєднати, використовуючи інтервал, вказаний у полі nodeAllocatableUpdatePeriodSeconds. Мінімально допустиме значення цього поля — 10 секунд.
Якщо операція підʼєднання тому завершується помилкою ResourceExhausted (код gRPC 8), Kubernetes негайно оновлює кількість доступних для розподілу томів цього вузла. Крім того, kubelet позначає уражені Podʼи як Failed, що дозволяє їхнім контролерам обробити повторне створення. Це запобігає безстроковому застряганню Podʼів у стані ContainerCreating.
Запобігання розміщенню Podʼа без драйвера CSI
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
Функціональна можливість VolumeLimitScaling стандартно ввімкнена в Kubernetes v1.37.
Однак запобігання розміщенню Podʼів на вузлах без драйвера CSI вимагає явної згоди через поле spec.preventPodSchedulingIfMissing обʼєкта CSIDriver.
Поле preventPodSchedulingIfMissing стандартно має значення false, і його потрібно встановити в true, якщо ви не хочете, щоб Podʼи планувалися на вузлах без драйвера CSI. Стандартне значення false вибрано з міркувань зворотної сумісності та сумісності з Cluster AutoScaler, який може не враховувати обмеження томів CSI під час автомасштабування (дивіться розділ нижче).
Обмеження підʼєднання томів CSI та cluster autoscaler
Cluster autoscaler може враховувати обмеження томів CSI, коли встановлено --enable-csi-node-aware-scheduling=true. Цей параметр не залежить від функціональної можливості VolumeLimitScaling.
Якщо ви використовуєте cluster autoscaler, встановлюйте spec.preventPodSchedulingIfMissing у true лише тоді, коли cluster autoscaler налаштовано з --enable-csi-node-aware-scheduling=true. Інакше його симуляції планування не включатимуть потрібну інформацію CSINode для нових вузлів, і cluster autoscaler може не масштабуватися вгору для Podʼів в очікуванні, які використовують томи CSI.
6.6.14 - Локальне тимчасове сховище
Вузли мають локальне тимчасове сховище, яке підтримується локально підключеними пристроями з можливістю запису або, інколи, оперативною памʼяттю. «Тимчасове» означає, що немає довгострокової гарантії щодо довговічності.
Podʼи використовують тимчасове локальне сховище як робочий простір, для кешування та для логів. kubelet може надавати Podʼам робочий простір, використовуючи локальне тимчасове сховище для монтування томівemptyDir у контейнери.
kubelet також використовує цей тип сховища для зберігання логів контейнерів на рівні вузла, образів контейнерів і шарів запущених контейнерів, доступних для запису.
Увага:
Якщо вузол виходить з ладу, дані в його тимчасовому сховищі можуть бути втрачені. Ваші застосунки не можуть очікувати жодних SLA щодо продуктивності (наприклад, дискових IOPS) від локального тимчасового сховища.
Примітка:
Щоб квота ресурсів працювала для ephemeral-storage, потрібно виконати дві дії:
Адміністратор встановлює квоту ресурсів для ephemeral-storage в просторі імен.
Користувач повинен вказати обмеження для ресурсу ephemeral-storage у специфікації Podʼа.
Якщо користувач не вказав обмеження ресурсу ephemeral-storage у специфікації Podʼа, квота ресурсів не застосовується до ephemeral-storage.
Kubernetes дозволяє відстежувати, резервувати та обмежувати обсяг тимчасового локального сховища, яке може використовувати Pod.
Конфігурації для локального тимчасового сховища
Kubernetes підтримує такі способи налаштування локального тимчасового сховища на вузлі:
У цій конфігурації ви розміщуєте всі різні типи тимчасових локальних даних (томи emptyDir, шари, доступні для запису, образи контейнерів, логи) в одній файловій системі.
kubelet записує логи у файли всередині налаштованої теки логів (стандартно /var/log) і має базову теку для інших локально збережених даних (стандартно /var/lib/kubelet).
Зазвичай і /var/lib/kubelet, і /var/log розташовані в кореневій файловій системі, і kubelet розроблено з урахуванням такого розташування.
Ваш вузол може мати скільки завгодно інших файлових систем, які не використовуються для Kubernetes.
Ви використовуєте на вузлі одну файлову систему для тимчасових даних запущених Podʼів, таких як логи та томи emptyDir. Цю файлову систему також можна використовувати для інших даних, наприклад, для системних логів, не повʼязаних із Kubernetes; вона може бути навіть кореневою файловою системою.
kubelet також записує логи контейнерів на рівні вузла у першу файлову систему і обробляє їх аналогічно тимчасовому локальному сховищу.
Ви також використовуєте окрему файлову систему на іншому логічному пристрої зберігання. У цій конфігурації середовище виконання контейнерів зберігає і шари образів контейнерів, і шари, доступні для запису, у цій другій файловій системі. Налаштуйте це місце зберігання в середовищі виконання контейнерів, а не в kubelet.
Перша файлова система не містить жодних шарів образів або шарів, доступних для запису.
Ваш вузол може мати скільки завгодно інших файлових систем, які не використовуються для Kubernetes.
У цій конфігурації шари образів контейнерів розташовані в окремій файловій системі, а шари контейнерів, доступні для запису, — у тій самій файловій системі, що й тимчасові дані kubelet, такі як логи та томи emptyDir.
Ця конфігурація вимагає підтримки сигналів виселення containerfs. Докладніше про функціональну можливість і середовища виконання контейнерів, які підтримують цю конфігурацію, дивіться у виселенні внаслідок тиску на вузол.
На сторінці Виселення внаслідок тиску на вузол ці файлові системи, за якими ведеться спостереження, позначаються як nodefs, imagefs та containerfs. Ці назви не завжди означають окремі точки монтування.
kubelet може вимірювати використання локального сховища, якщо ви налаштовуєте вузол за однією з підтримуваних конфігурацій локального тимчасового сховища.
Якщо у вас інша конфігурація, kubelet не застосовує обмеження ресурсів для тимчасового локального сховища.
Примітка:
kubelet відстежує томи emptyDir типу tmpfs як використання памʼяті контейнера, а не як локальне тимчасове сховище.
Примітка:
kubelet може відстежувати тимчасове сховище лише у файлових системах, які він спостерігає через підтримувані схеми розташування. Якщо ви монтуєте додаткові файлові системи за такими шляхами, як /var/lib/kubelet, /var/log або тека сховища середовища виконання контейнерів, поза цими схемами, kubelet може неправильно повідомляти про тимчасове сховище.
Встановлення запитів та обмежень для локального тимчасового сховища
Ви можете вказати ephemeral-storage для керування локальним тимчасовим сховищем. Кожен контейнер Podʼа може вказати одне або обидва з такого:
Обмеження та запити для ephemeral-storage вимірюються в байтах. Ви можете виразити обсяг сховища як просте ціле число або як число з фіксованою комою, використовуючи один із таких суфіксів: E, P, T, G, M, k. Ви також можете використовувати еквіваленти степеня двійки: Ei, Pi, Ti, Gi, Mi, Ki. Наприклад, усі наведені нижче величини мають приблизно однакове значення:
128974848
129e6
129M
123Mi
Зверніть увагу на регістр суфіксів. Якщо ви запитуєте 400m тимчасового сховища, це запит на 0,4 байта. Той, хто це ввів, мабуть, мав на увазі 400 мебібайтів (400Mi) або 400 мегабайтів (400M).
У наведеному нижче прикладі Pod має два контейнери. Кожен контейнер має запит на 2GiB локального тимчасового сховища. Кожен контейнер має обмеження в 4GiB локального тимчасового сховища. Отже, Pod має запит на 4GiB локального тимчасового сховища та обмеження у 8GiB локального тимчасового сховища. 500Mi цього обмеження може використати том emptyDir.
Коли ви створюєте Pod, планувальник Kubernetes вибирає вузол, на якому працюватиме Pod. Кожен вузол має максимальний обсяг локального тимчасового сховища, який він може надати для Podʼів. Докладнішу інформацію дивіться в розділі Node Allocatable.
Планувальник гарантує, що сума запитів на ресурси запланованих контейнерів буде меншою за місткість вузла.
Керування споживанням тимчасового сховища
Якщо kubelet керує локальним тимчасовим сховищем як ресурсом, то kubelet вимірює використання сховища в:
томах emptyDir, за винятком томів tmpfsemptyDir
теках, що містять логи на рівні вузла
шарах контейнерів, доступних для запису
Якщо Pod використовує більше тимчасового сховища, ніж ви дозволяєте, kubelet встановлює сигнал виселення, який запускає виселення Podʼа.
Для ізоляції на рівні контейнера, якщо використання шару контейнера, доступного для запису, та логів перевищує його обмеження сховища, kubelet позначає Pod для виселення.
Для ізоляції на рівні Podʼа kubelet обчислює загальне обмеження сховища Podʼа, підсумовуючи обмеження контейнерів цього Podʼа. У цьому випадку, якщо сума використання локального тимчасового сховища всіма контейнерами, а також томами emptyDir Podʼа перевищує загальне обмеження сховища Podʼа, kubelet також позначає Pod для виселення.
Увага:
Якщо kubelet не вимірює локальне тимчасове сховище, то Pod, який перевищує своє обмеження локального сховища, не буде виселений за порушення обмежень ресурсів локального сховища.
Однак, якщо місця у файловій системі для шарів контейнерів, доступних для запису, логів на рівні вузла або томів emptyDir стає мало, вузол позначає себе taint про нестачу локального сховища, і цей taint запускає виселення всіх Podʼів, які спеціально не толерують цей taint.
Дивіться підтримувані конфігурації для тимчасового локального сховища.
kubelet підтримує різні способи вимірювання використання сховища Podʼа:
kubelet виконує регулярні заплановані перевірки, які сканують кожен том emptyDir, теку логів контейнера та шар контейнера, доступний для запису.
Сканування вимірює, скільки місця використовується.
Примітка:
У цьому режимі kubelet не відстежує відкриті дескриптори видалених файлів.
Якщо ви (або контейнер) створюєте файл у томі emptyDir, щось потім відкриває цей файл, а ви видаляєте файл, поки він ще відкритий, то inode видаленого файлу залишається, доки ви не закриєте цей файл, але kubelet не вважає це місце використаним.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.31; (стандартно вимкнено)
Квоти проєктів — це можливість на рівні операційної системи для керування використанням сховища у файлових системах. У Kubernetes ви можете ввімкнути квоти проєктів для моніторингу використання сховища. Переконайтеся, що файлова система, на якій розміщено томи emptyDir на вузлі, підтримує квоти проєктів. Наприклад, XFS та ext4fs пропонують квоти проєктів.
Примітка:
Квоти проєктів дозволяють моніторити використання сховища; вони не застосовують обмеження.
Kubernetes використовує ідентифікатори проєктів, починаючи з 1048576. Використовувані ідентифікатори зареєстровані в /etc/projects та /etc/projid. Якщо ідентифікатори проєктів у цьому діапазоні використовуються в системі для інших цілей, їх необхідно зареєструвати в /etc/projects та /etc/projid, щоб Kubernetes не використовував їх.
Квоти є швидшими та точнішими, ніж сканування тек. Коли тека призначається проєкту, всі файли, створені в цій теці, створюються в цьому проєкті, і ядро має лише відстежувати, скільки блоків використовується файлами в цьому проєкті. Якщо файл створено та видалено, але він має відкритий дескриптор файлу, він продовжує споживати простір. Відстеження квот точно фіксує цей простір, тоді як сканування тек пропускає простір, який використовують видалені файли.
Щоб використовувати квоти для відстеження використання ресурсів Podʼом, Pod повинен бути в просторі імен користувача. У просторах імен користувачів ядро обмежує зміни projectID у файловій системі, забезпечуючи надійність метрик сховища, обчислених за допомогою квот.
Якщо ви хочете використовувати квоти проєктів, вам слід:
Переконатися, що функціональну можливість UserNamespacesSupport увімкнено, а ядро, реалізація CRI та середовище виконання OCI підтримують простори імен користувачів.
Переконатися, що в кореневій файловій системі (або необовʼязковій файловій системі середовища виконання) увімкнено квоти проєктів. Усі файлові системи XFS підтримують квоти проєктів. Для файлових систем ext4 потрібно ввімкнути можливість відстеження квот проєктів, поки файлова система не змонтована.
# For ext4, with /dev/block-device not mountedsudo tune2fs -O project -Q prjquota /dev/block-device
Переконатися, що коренева файлова система (або необовʼязкова файлова система середовища виконання) змонтована з увімкненими квотами проєктів. Для XFS і ext4fs параметр монтування називається prjquota.
Якщо ви не хочете використовувати квоти проєктів, вам слід:
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.21; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CSIVolumeHealth feature gate for all relevant components in your cluster.
Моніторинг справності томів CSI дозволяє драйверу CSI повідомляти Kubernetes про проблеми зі справністю тому або бекенду його сховища безпосередньо. Драйвер звітує через RPC CSI, а Kubernetes показує ці звіти у трьох полях статусу: PersistentVolumeClaim.status.healthStatus, Pod.status.volumeHealth та CSINode.status.storageHealth. Автоматизація може стежити за цими стійкими полями статусу, а не відтворювати справність томів з ефемерних Events чи зі специфічних для постачальника dashboards.
Примітка:
Функціональна можливість CSIVolumeHealth існує з Kubernetes v1.21, але механізм, описаний на цій сторінці, є переробкою, яка замінює початкову альфа-реалізацію. Що змінилося, дивіться в розділі Обмеження.
Як це працює
Специфікація CSI визначає чотири RPC для звітування про справність:
На втулку контролера CSI: ControllerListVolumeHealth та ControllerGetVolumeHealth, для справності кожного тому, яку спостерігає контролер.
На втулку вузла CSI: NodeGetVolumeHealth, для справності кожного тому, яку спостерігає вузол, та NodeGetStorageHealth, для справності бекенду сховища, як її видно з цього вузла.
Драйверу потрібно реалізувати лише ті RPC, які він хоче підтримувати, і оголосити їхню підтримку через можливості втулка CSI. Драйвер, який не реалізує жодного з цих RPC, ніколи не опитується, і звітування для нього залишається неактивним. Драйвер, який оголошує можливість контролера LIST_VOLUME_HEALTH, також повинен оголосити GET_VOLUME_HEALTH; цю вимогу забезпечує sidecar-контейнер csi-external-health-monitor-controller.
Кожен звіт про справність містить status із невеликого набору значень, придатних для машинного аналізу, разом із визначеним драйвером reason та необовʼязковим зрозумілим людині message:
Значення статусу на рівні тому (використовуються для PersistentVolumeClaim.status.healthStatus та Pod.status.volumeHealth): Inaccessible, DataLoss, Degraded.
Значення статусу бекенду сховища (використовуються для CSINode.status.storageHealth): StorageUnreachable, StorageDegraded.
Звіти зі сторони вузла та зі сторони контролера незалежні: том може бути Inaccessible з одного вузла, який втратив шлях до даних бекенду, тоді як втулок контролера все ще повідомляє, що том справний, і навпаки.
Справність, про яку повідомляється в Podʼах
Для томів, які використовують драйвер CSI з підтримкою RPC NodeGetVolumeHealth зі сторони вузла, kubelet періодично викликає цей RPC для кожного тому CSI, який він змонтував для Podʼа, і записує результат у pod.status.volumeHealth, використовуючи як ключ назву тому з pod.spec.volumes. Інтервал опитування — це налаштування kubelet volumeStatsAggPeriod (прапорець командного рядка --volume-stats-agg-period).
apiVersion:v1kind:Pod# ...status:volumeHealth:- name:my-volumehealthConditions:- status:Inaccessiblereason:VolumeNotFoundmessage:"volume not found on the storage backend"lastTransitionTime:"2026-07-20T12:00:00Z"
kubelet записує лише pods/status, субресурс, який він уже має право оновлювати для Podʼів, привʼязаних до його власного вузла, тому для цього поля не потрібна нова авторизація.
Справність, про яку повідомляється в CSINode
Для кожного зареєстрованого на вузлі драйвера CSI, який підтримує NodeGetStorageHealth, kubelet періодично викликає цей RPC і записує результат у csinode.status.storageHealth, використовуючи як ключ назву драйвера.
apiVersion:storage.k8s.io/v1kind:CSINode# ...status:storageHealth:- name:csi.example.comhealthConditions:- status:StorageUnreachablereason:NetworkPartitionmessage:"data path to the storage backend is unreachable from this node"
Запис StorageHealthCondition може за потреби обмежувати свою дію конкретним accessMode або volumeMode для бекендів, які деградують асиметрично (наприклад, мережева проблема, яка впливає на доступ ReadWriteMany, але не на ReadWriteOnce).
Запис у csinodes/status — це нова можливість, додана цією функціональністю: режим авторизації Node та втулок допуску NodeRestriction дозволяють kubelet змінювати лише обʼєкт CSINode, який відповідає його власному вузлу, і лише поки ввімкнено функціональну можливість CSIVolumeHealth.
Справність, про яку повідомляється в PersistentVolumeClaims
Справність томів, яку спостерігає контролер, записує в persistentvolumeclaim.status.healthStatus sidecar-контейнер csi-external-health-monitor-controller, що працює поряд із втулком контролера драйвера CSI. Sidecar-контейнер викликає ControllerListVolumeHealth (або переходить на ControllerGetVolumeHealth для кожного тому) і записує результат:
apiVersion:v1kind:PersistentVolumeClaim# ...status:healthStatus:healthConditions:- status:Inaccessiblereason:VolumeNotFoundmessage:"volume not found on the storage backend"lastTransitionTime:"2026-07-20T12:00:00Z"
Жоден вузол ніколи не записує це поле; це робить лише sidecar-контейнер, що працює в панелі управління. Це не дає скомпрометованому або несправному вузлу впливати на те, що інші користувачі кластера бачать у PVC.
Чи доступний цей шлях для конкретного драйвера, залежить від того, чи цей драйвер і його розгортання sidecar-контейнера csi-external-health-monitor-controller перейшли на нові RPC контролера.
Увімкнення моніторингу справності томів
Моніторингом справності томів керує одна функціональна можливість CSIVolumeHealth на kube-apiserver та kubelet:
На kube-apiserver увімкнення функціональної можливості дозволяє записувати та читати нові поля статусу; вимкнення вилучає ці поля під час наступного запису в обʼєкт, але зберігає вже збережені значення.
На kubelet увімкнення функціональної можливості запускає періодичне опитування зі сторони вузла, описане вище.
Моніторинг зі сторони контролера, який заповнює persistentvolumeclaim.status.healthStatus, не має власної функціональної можливості. Розгортання sidecar-контейнера csi-external-health-monitor-controller поряд із втулком контролера вашого драйвера CSI саме по собі є ввімкненням цього моніторингу.
Увімкнення функціональної можливості саме по собі не призводить до появи інформації про справність: драйвер CSI також повинен оголосити та реалізувати відповідні RPC. Перегляньте документацію свого драйвера CSI, щоб дізнатися, які з чотирьох RPC він підтримує, якщо підтримує.
Моніторинг
kubelet надає метрику типу gauge csi_node_storage_health_status з мітками driver_name, status та reason і значенням 1 для кожного стану бекенду сховища, про який наразі повідомляється для драйвера на цьому вузлі.
Обмеження
Kubernetes лише показує ці звіти про справність, але не діє на їх основі. Ніщо в Kubernetes не переплановує Podʼи, не перемикає томи на резерв і не реагує якось інакше на повідомлений стан самостійно. Створення контролера виправлення на основі цих полів статусу залишається за операторами кластерів і постачальниками.
Старіша альфа-реалізація тієї самої функціональної можливості CSIVolumeHealth (доступна з Kubernetes v1.21) повідомляла про ненормальні стани томів за допомогою Events Kubernetes та метрики kubelet_volume_stats_health_status_abnormal. Цей механізм замінено полями статусу та RPC, описаними на цій сторінці, і його більше не існує.
Що далі
Прочитайте KEP-1432, щоб ознайомитися з повним дизайном.
Дивіться документацію драйверів CSI, щоб дізнатися, які драйвери CSI реалізують моніторинг справності томів.
6.6.16 - Сховище у Windows
На цій сторінці наведено огляд сховища, специфічного для операційної системи Windows.
Постійне сховище
У Windows є багатошаровий драйвер файлової системи для монтування шарів контейнера та створення копії файлової системи на основі NTFS. Усі шляхи файлів у контейнері розвʼязуються лише в контексті цього контейнера.
У Docker монтування томів може бути спрямоване лише на теку в контейнері, а не на окремий файл. Це обмеження не стосується containerd.
Монтування томів не може проєктувати файли або теки назад на файлову систему хоста.
Файлові системи лише для читання не підтримуються, оскільки завжди потрібен доступ для запису до реєстру Windows та бази даних SAM. Однак томи лише для читання підтримуються.
Маски користувача та дозволи для томів недоступні. Оскільки SAM не є спільним для хоста й контейнера, між ними немає зіставлення. Усі дозволи розвʼязуються в контексті контейнера.
Як наслідок, на вузлах Windows не підтримуються такі можливості сховища:
Монтування підшляхів тому: у контейнері Windows можна змонтувати лише весь том
Монтування підшляхів тому для Secrets
Проєкція монтування хоста
Коренева файлова система лише для читання (зіставлені томи все ще підтримують readOnly)
Зіставлення блокових пристроїв
Памʼять як носій сховища (наприклад, emptyDir.medium зі значенням Memory)
Можливості файлової системи, такі як uid/gid; дозволи файлової системи Linux для кожного користувача
Томи Kubernetes дозволяють розгортати в Kubernetes складні застосунки, яким потрібне збереження даних і спільне використання томів Podʼами. Керування постійними томами, повʼязаними з конкретним бекендом сховища або протоколом, включає такі дії, як надання, скасування надання та зміна розміру томів, підʼєднання тому до вузла Kubernetes і відʼєднання від нього, а також монтування тому в окремих контейнерах Podʼа, якому потрібно зберігати дані, і його розмонтування.
Компоненти керування томами постачаються як втулки томів Kubernetes. У Windows підтримуються такі широкі класи втулків томів Kubernetes:
Kubernetes надає способи відокремлення конфігурації від коду. Це поширена практика, яка узгоджується з принципами DevOps та з архітектурою cloud native.
Якщо у вас є образ контейнера, який підтримує окрему конфігурацію, ви можете розгортати той самий код застосунку в різних контекстах. Наприклад, ви можете запускати тести для зібраного образу, а потім запускати той самий образ у промисловому контексті. Це дає вам більше впевненості у вашому тестуванні порівняно з розгортанням застосунку одним способом для тестів та іншим у промисловій експлуатації.
Kubernetes надає два основні види API, які ви можете використовувати для зберігання конфігурації, готової для завантаження та використання Podʼом (або іншим компонентом): ConfigMap та Secret.
Види API спеціального призначення CertificateSigningRequest та ClusterTrustBundle також містять дані конфігурації, що стосуються деяких конкретних випадків, таких як конфігурація TLS.
Усі ці механізми конфігурації, навіть для сертифікатів, розроблені так, щоб конфігурацію можна було повторно та спільно використовувати кількома Podʼами. Зазвичай вам не потрібно записувати конфігурацію окремо для кожного Podʼа, і ви маєте проєктувати застосунки, де це можливо, так, щоб вони могли працювати зі спільною конфігурацією.
Щоб дізнатися про використання конфігурації у ваших застосунках, прочитайте про інʼєкцію даних у застосунки.
ConfigMaps
ConfigMap — це обʼєкт API, призначений для зберігання неконфіденційних даних у вигляді пар ключ-значення. Podʼи можуть використовувати ConfigMap як змінні середовища, аргументи командного рядка чи файли конфігурації у томі.
ConfigMap дозволяє відділити конфігурацію, специфічну для середовища, від образів контейнерів, щоб ваші застосунки були легко переносимими.
Secrets
Secret — це обʼєкт, який містить певний обсяг конфіденційних даних, таких як пароль, токен або ключ.
Secrets схожі на ConfigMaps, але спеціально призначені для зберігання конфіденційних даних. Прочитайте сторінку про Secrets, щоб дізнатися про переваги (та обмеження) щодо інформаційної безпеки та Secrets.
Конфігурація через sidecar-контейнери або init-контейнери
Це корисно, якщо у вас уже є певний спосіб, поза межами Kubernetes, для зберігання конфігурації, ключів безпеки або іншої інформації, яку ваші контейнери мають використовувати і яка не повинна зберігатися в образах контейнерів.
Sidecar-контейнер як помічник
Помічник конфігурації у вигляді sidecar працює в тому самому Podʼі, що й контейнер застосунку, тому кожен Pod має власний sidecar. Типовий sidecar конфігурації отримує дані конфігурації через мережу Podʼа, а потім записує їх у том, який змонтовано в обидва контейнери.
Існує багато варіацій цього базового шаблону, у яких все ще є контейнер-помічник, що записує конфігурацію для використання контейнером застосунку.
Init-контейнер як помічник
Podʼи можуть мати init-контейнери, які запускаються перед головним застосунком. На відміну від sidecar-контейнерів, init-контейнери завершуються до того, як запустяться головні контейнери Podʼа (з основним застосунком), тому конфігурація встановлюється тільки один раз.
У вас є два основні варіанти конфігурації за допомогою init-контейнерів:
Конфігурація через файлову систему
За цього варіанту init-контейнер отримує конфігурацію та записує її у файл або кілька файлів, зазвичай у локальний для Podʼа том.
Конфігурація через змінні середовища
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Це робиться за допомогою локального тому, але лише init-контейнер монтує цей том. Потім kubelet читає з цього тому перед запуском контейнера застосунку.
У межах цього розділу документації ви можете прочитати про:
6.7.1 - ConfigMaps
ConfigMap — це обʼєкт API, призначений для зберігання неконфіденційних даних у вигляді пар ключ-значення. Podʼи можуть використовувати ConfigMap як змінні середовища, аргументи командного рядка чи файли конфігурації у томі.
ConfigMap дозволяє відділити конфігурацію, специфічну для середовища, від образів контейнерів, щоб ваші застосунки були легко переносимими.
Увага:
ConfigMap не забезпечує конфіденційності або шифрування. Якщо дані, які ви хочете зберегти, конфіденційні, використовуйте Secret замість ConfigMap або використовуйте додаткові (сторонні) інструменти для збереження ваших даних в таємниці.
Мотивація
Використовуйте ConfigMap для визначення конфігураційних даних окремо від коду застосунку.
Наприклад, уявіть, що ви розробляєте застосунок, який ви можете запускати на власному компʼютері (для розробки) і в хмарі (для обробки реального трафіку). Ви пишете код, який читає змінну середовища з назвою DATABASE_HOST. Локально ви встановлюєте цю змінну в значення localhost. У хмарі ви встановлюєте її так, щоб вона посилалася на Service, який надає доступ до компонента бази даних вашому кластеру. Це дозволяє вам отримати образ контейнера, який працює в хмарі, і у разі потреби налагоджувати той самий код локально.
Примітка:
ConfigMap не призначено для зберігання великих обсягів даних. Дані, збережені в ConfigMap, не можуть перевищувати 1 MiB. Якщо потрібно зберегти налаштування, які перевищують це обмеження, варто розглянути можливість монтування тому або використання окремої бази даних або файлового сервісу.
Обʼєкт ConfigMap
ConfigMap — це обʼєкт API, який дозволяє зберігати конфігураційні дані для використання іншими обʼєктами. На відміну від більшості обʼєктів Kubernetes, у яких є spec, ConfigMap має поля data та binaryData. Ці поля приймають пари ключ-значення як свої значення. Обидва поля data і binaryData є необовʼязковими. Поле data призначене для зберігання рядків UTF-8, тоді як поле binaryData призначене для зберігання бінарних даних у вигляді рядків, закодованих у base64.
Кожний ключ у полі data або binaryData повинен складатися з буквено-цифрових символів, -, _ або .. Ключі, збережені в data, не повинні перетинатися з ключами у полі binaryData.
Починаючи з версії v1.19, ви можете додати поле immutable до визначення ConfigMap, щоб створити незмінний ConfigMap.
ConfigMaps та Podʼи
Ви можете написати spec Podʼа, який посилається на ConfigMap і конфігурує контейнер(и) в цьому Podʼі на основі даних з ConfigMap. Pod і ConfigMap повинні бути в тому самому просторі імен.
Примітка:
specстатичного Podʼа не може посилатися на ConfigMap або на інші обʼєкти API.
Ось приклад ConfigMap, який має деякі ключі з окремими значеннями, а також інші ключі, де значення виглядає як фрагмент формату конфігурації.
apiVersion:v1kind:ConfigMapmetadata:name:game-demodata:# ключі у вигляді властивостей; кожен ключ зіставляється з простим значеннямplayer_initial_lives:"3"ui_properties_file_name:"user-interface.properties"# ключі у формі файлівgame.properties:| enemy.types=aliens,monsters
player.maximum-lives=5user-interface.properties:| color.good=purple
color.bad=yellow
allow.textmode=true
Є чотири різних способи використання ConfigMap для конфігурації контейнера всередині Podʼа:
В команді та аргументах контейнера
У змінних середовища для контейнера
Додайте файл до тому тільки для читання, щоб застосунок міг його читати
Напишіть код для виконання всередині Podʼа, який використовує API Kubernetes для читання ConfigMap
Ці різні методи підходять для різних способів моделювання даних, які використовуються. Для перших трьох методів kubelet використовує дані з ConfigMap під час запуску контейнера(ів) для Podʼа.
Четвертий метод означає, що вам потрібно написати код для читання ConfigMap та його даних. Однак, оскільки ви використовуєте прямий доступ до API Kubernetes, ваш застосунок може підписатися на отримання оновлень, коли змінюється ConfigMap, і реагувати на це. Завдяки прямому доступу до API Kubernetes цей підхід також дозволяє вам отримувати доступ до ConfigMap в іншому просторі імен.
Ось приклад Podʼа, який використовує значення з game-demo для конфігурації Podʼа:
apiVersion:v1kind:Podmetadata:name:configmap-demo-podspec:containers:- name:demoimage:alpinecommand:["sleep","3600"]env:# Define the environment variable- name:PLAYER_INITIAL_LIVES# Notice that the case is different here# from the key name in the ConfigMap.valueFrom:configMapKeyRef:name:game-demo # The ConfigMap this value comes from.key:player_initial_lives# The key to fetch.- name:UI_PROPERTIES_FILE_NAMEvalueFrom:configMapKeyRef:name:game-demokey:ui_properties_file_namevolumeMounts:- name:configmountPath:"/config"readOnly:truevolumes:# You set volumes at the Pod level, then mount them into containers inside that Pod- name:configconfigMap:# Provide the name of the ConfigMap you want to mount.name:game-demo# An array of keys from the ConfigMap to create as filesitems:- key:"game.properties"path:"game.properties"- key:"user-interface.properties"path:"user-interface.properties"
ConfigMap не розрізняє однорядкові значення властивостей та багаторядкові файлоподібні значення. Важливо, як Podʼи та інші обʼєкти використовують ці значення.
У цьому прикладі визначення тому та монтування його всередину контейнера demo як /config створює два файли, /config/game.properties та /config/user-interface.properties, хоча в ConfigMap є чотири ключі. Це тому, що визначення Podʼа містить масив items в розділі volumes. Якщо ви взагалі опустите масив items, кожен ключ у ConfigMap стане файлом із такою самою назвою, що й ключ, і ви отримаєте 4 файли.
Використання ConfigMap
ConfigMap можуть бути змонтовані як томи даних. ConfigMap також можуть бути використані іншими частинами системи без безпосереднього надання Podʼу. Наприклад, ConfigMap можуть містити дані, які повинні використовуватися іншими частинами системи для конфігурації.
Найпоширеніший спосіб використання ConfigMap — це налаштування контейнерів, які працюють у Podʼі в тому самому просторі імен. Ви також можете використовувати ConfigMap окремо.
Наприклад, ви можете зустріти надбудови або оператори, які налаштовують свою поведінку на основі ConfigMap.
Використання ConfigMaps як файлів у Podʼі
Щоб використовувати ConfigMap в томі в Podʼі:
Створіть ConfigMap або використовуйте наявний. Декілька Podʼів можуть посилатися на один ConfigMap.
Змініть ваше визначення Podʼа, щоб додати том в .spec.volumes[]. Дайте тому будь-яку назву та встановіть поле .spec.volumes[].configMap.name для посилання на ваш обʼєкт ConfigMap.
Додайте .spec.containers[].volumeMounts[] до кожного контейнера, який потребує ConfigMap. Вкажіть .spec.containers[].volumeMounts[].readOnly = true та задайте в .spec.containers[].volumeMounts[].mountPath назву невикористаної теки, де ви хочете, щоб зʼявився ConfigMap.
Змініть ваш образ або командний рядок так, щоб програма шукала файли у цій теці. Кожен ключ у мапі data ConfigMap стає імʼям файлу в mountPath.
Кожен ConfigMap, який ви хочете використовувати, слід зазначити в .spec.volumes.
Якщо в Podʼі є кілька контейнерів, то кожен контейнер потребує свого власного блоку volumeMounts, але потрібно лише одне поле .spec.volumes на ConfigMap.
Змонтовані ConfigMaps оновлюються автоматично
Коли ConfigMap, що наразі використовується в томі, оновлюється, спроєцьовані ключі згодом також оновлюються. Kubelet перевіряє, чи змонтований ConfigMap є актуальним під час кожної періодичної синхронізації. Однак kubelet використовує свій локальний кеш для отримання поточного значення ConfigMap. Тип кешу налаштовується за допомогою поля configMapAndSecretChangeDetectionStrategy в структурі KubeletConfiguration. ConfigMap можна поширити за допомогою watch (типово), на основі ttl або шляхом перенаправлення всіх запитів безпосередньо до API-сервера. Отже, загальна затримка від моменту оновлення ConfigMap до моменту, коли нові ключі буде спроєцьовано в Pod, може дорівнювати періоду синхронізації kubelet + затримці поширення кешу, де затримка поширення кешу залежить від обраного типу кешу (вона дорівнює затримці поширення watch, ttl кешу або нулю відповідно).
ConfigMap, що використовуються як змінні середовища, не оновлюються автоматично і потребують перезапуску Podʼа.
Примітка:
Контейнер, який використовує ConfigMap як том з монтуванням subPath, не отримує оновлення ConfigMap.
Для кожного контейнера у вашій специфікації Podʼа додайте змінну середовища для кожного ключа ConfigMap, який ви хочете використовувати, до поля env[].valueFrom.configMapKeyRef.
Змініть ваш образ та/або командний рядок так, щоб програма шукала значення у вказаних змінних середовища.
Ось приклад визначення ConfigMap як змінної середовища Podʼа:
Цей ConfigMap (myconfigmap.yaml) містить дві властивості: username та access_level:
Поле envFrom вказує Kubernetes створити змінні середовища з джерел, вкладених у нього. Внутрішній configMapRef посилається на ConfigMap за його назвою і вибирає всі його пари ключ-значення. Додайте Pod до свого кластера, а потім перегляньте його логи, щоб побачити виведення команди printenv. Це має підтвердити, що дві пари ключ-значення з ConfigMap були встановлені як змінні середовища:
kubectl apply -f env-configmap.yaml
kubectl logs pod/env-configmap
Вивід буде подібний до цього:
...
username: "k8s-admin"
access_level: "1"
...
Іноді Pod не потребуватиме доступу до всіх значень у ConfigMap. Наприклад, можна мати інший Pod, який використовує тільки значення username з ConfigMap. Для цього випадку можна використовувати синтаксис env.valueFrom, який дозволяє вибирати окремі ключі в ConfigMap. Імʼя змінної середовища також може відрізнятися від ключа в ConfigMap. Наприклад:
У Podʼі, створеному з цього маніфесту, ви побачите, що змінна середовища CONFIGMAP_USERNAME встановлена на значення username з ConfigMap. Інші ключі з даних ConfigMap не будуть скопійовані у середовище.
Важливо зауважити, що набір символів, дозволених для назв змінних середовища в Podʼах, обмежений. Якщо будь-які ключі не відповідають правилам, ці ключі не будуть доступні вашому контейнеру, хоча Pod може бути запущений.
Незмінні ConfigMap
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
Функція Kubernetes Immutable Secrets та ConfigMaps надає можливість зробити окремі Secrets та ConfigMaps незмінними. Для кластерів, що інтенсивно використовують ConfigMap (принаймні десятки тисяч унікальних монтувань ConfigMap до Podʼів), запобігання змінам їх даних має такі переваги:
захищає від випадкових (або небажаних) оновлень, які можуть призвести до відмов застосунків
покращує продуктивність кластера шляхом значного зниження навантаження на kube-apiserver, завдяки закриттю спостережень за ConfigMap, позначеними як незмінні.
Ви можете створити незмінний ConfigMap, встановивши поле immutable в true. Наприклад:
Після того, як ConfigMap позначено як незмінний, відмінити цю зміну або змінити вміст поля data або binaryData неможливо. Ви можете лише видалити та створити ConfigMap знову. Оскільки поточні Podʼи підтримують точку монтування для видаленого ConfigMap, рекомендується створити заново ці Podʼи.
Прочитайте про 12-факторні застосунки, щоб зрозуміти мотивацію для відокремлення коду від конфігурації.
6.7.2 - Secrets
Secret — це обʼєкт, який містить невелику кількість конфіденційних даних, таких як пароль, токен або ключ. Інакше така інформація могла б потрапити до специфікації Pod або до образу контейнера. Використання Secret означає, що вам не потрібно включати конфіденційні дані в код застосунку.
Оскільки Secrets можна створювати незалежно від Podʼів, які їх використовують, існує менше ризику того, що Secret (і його дані) буде розкрито під час створення, перегляду та редагування Podʼів. Kubernetes та застосунки, які працюють у вашому кластері, також можуть вживати додаткових заходів безпеки щодо Secrets, наприклад, уникати запису конфіденційних даних в енергонезалежне сховище.
Secrets схожі на ConfigMaps, але спеціально призначені для зберігання конфіденційних даних.
Увага:
Kubernetes Secrets стандартно зберігаються незашифрованими в базовому сховищі даних API-сервера (etcd). Будь-хто з доступом до API може отримати або змінити Secret, так само як будь-хто з доступом до etcd. Крім того, будь-хто, хто має дозвіл на створення Podʼа у просторі імен, може використовувати цей доступ для читання будь-якого Secret у цьому просторі імен; це включає і непрямий доступ, такий як можливість створення Deployment.
Щоб безпечно використовувати Secrets, виконайте принаймні такі кроки:
Панель управління Kubernetes також використовує Secrets; наприклад, Secrets bootstrap-токенів — це механізм, що допомагає автоматизувати реєстрацію вузлів.
Сценарій використання: dotfiles у томі Secret
Ви можете зробити ваші дані "прихованими", визначивши ключ, який починається з крапки. Цей ключ являє собою dotfile або "прихований" файл. Наприклад, коли цей Secret монтується в том secret-volume, том міститиме один файл із назвою .secret-file, а контейнер dotfile-test-container матиме цей файл за шляхом /etc/secret-volume/.secret-file.
Примітка:
Файли, які починаються з крапок, приховані від виводу ls -l; щоб побачити їх під час перегляду вмісту теки, використовуйте ls -la.
Сценарій використання: Secret, видимий для одного контейнера в Podʼі
Припустимо, що у вас є програма, яка потребує обробки HTTP-запитів, виконання складної бізнес-логіки та підписування деяких повідомлень за допомогою HMAC. Оскільки у неї складна логіка застосунку, на сервері може бути непомічена вразливість віддаленого читання файлів, яка може розкрити приватний ключ зловмиснику.
Це можна розділити на два процеси у двох контейнерах: фронтенд-контейнер, який обробляє взаємодію з користувачем та бізнес-логіку, але не може бачити приватний ключ; і контейнер-підписувач, який може бачити приватний ключ та відповідає на прості запити на підпис від фронтенду (наприклад, через мережу localhost).
З цим розділеним підходом зловмиснику тепер потрібно змусити сервер застосунку зробити щось досить довільне, що може бути складніше, ніж змусити його прочитати файл.
Альтернативи Secrets
Замість використання Secret для захисту конфіденційних даних ви можете скористатися альтернативами.
Ось деякі з варіантів:
Якщо ваш компонент cloud native має автентифікуватися в іншому застосунку, який, як ви знаєте, працює в тому самому кластері Kubernetes, ви можете використовувати ServiceAccount та його токени, щоб ідентифікувати вашого клієнта.
Існують сторонні інструменти, які ви можете запускати, як в межах, так і поза вашим кластером, які керують чутливими даними. Наприклад, сервіс, до якого Podʼи звертаються через HTTPS і який розкриває Secret, якщо клієнт правильно автентифікується (наприклад, з токеном ServiceAccount).
Для автентифікації ви можете реалізувати власний підписувач для сертифікатів X.509 і використовувати CertificateSigningRequests, щоб дозволити цьому власному підписувачу видавати сертифікати Podʼам, які їх потребують.
Ви можете використовувати втулок пристрою, щоб надати певному Podʼу доступ до локального для вузла апаратного забезпечення шифрування. Наприклад, ви можете планувати довірені Podʼи на вузли, які надають Trusted Platform Module, налаштований окремо (out-of-band).
Ви також можете комбінувати два або більше з цих варіантів, включаючи використання самих обʼєктів Secret.
Наприклад: реалізуйте (або розгорніть) оператор, що отримує короткострокові токени сеансів від зовнішнього сервісу, а потім створює Secrets на основі цих короткострокових токенів. Podʼи, що працюють у вашому кластері, можуть використовувати токени сеансів, а оператор забезпечує їхню дійсність. Такий розподіл означає, що ви можете запускати Podʼи, які не знають точних механізмів видачі та оновлення цих токенів сеансів.
Типи Secret
Під час створення Secret ви можете вказати його тип, використовуючи поле type ресурсу Secret, або певні еквівалентні прапорці командного рядка kubectl (якщо вони доступні). Тип Secret використовується для полегшення програмної обробки даних Secret.
Kubernetes надає кілька вбудованих типів для деяких типових сценаріїв використання. Ці типи відрізняються за умовами перевірки та обмеженнями, які Kubernetes накладає на них.
Вбудований тип
Використання
Opaque
довільні користувацькі дані
kubernetes.io/service-account-token
токен ServiceAccount
kubernetes.io/dockercfg
серіалізований файл ~/.dockercfg
kubernetes.io/dockerconfigjson
серіалізований файл ~/.docker/config.json
kubernetes.io/basic-auth
облікові дані для базової автентифікації
kubernetes.io/ssh-auth
облікові дані для SSH-автентифікації
kubernetes.io/tls
дані для клієнта або сервера TLS
bootstrap.kubernetes.io/token
дані bootstrap-токена
Ви можете визначити та використовувати власний тип Secret, присвоївши непорожній рядок як значення type обʼєкта Secret (порожній рядок розглядається як тип Opaque).
Kubernetes не накладає жодних обмежень на назву типу. Однак якщо ви використовуєте один з вбудованих типів, ви повинні задовольнити всі вимоги, визначені для цього типу.
Якщо ви визначаєте тип Secret, призначений для загального використання, дотримуйтесь домовленостей та структуруйте тип Secret так, щоб він мав назву вашого домену перед назвою типу, відокремлену символом /. Наприклад: cloud-hosting.example.net/cloud-api-credentials.
Opaque Secrets
Opaque — це стандартний тип Secret, якщо ви не вказуєте явно тип у маніфесті Secret. Під час створення Secret за допомогою kubectl вам потрібно використовувати підкоманду generic, щоб вказати тип Secret Opaque. Наприклад, ця команда створює порожній Secret типу Opaque:
kubectl create secret generic empty-secret
kubectl get secret empty-secret
Вивід виглядає так:
NAME TYPE DATA AGE
empty-secret Opaque 0 2m6s
У стовпчику DATA показується кількість елементів даних, збережених у Secret. У цьому випадку 0 означає, що ви створили порожній Secret.
Secrets токенів ServiceAccount
Тип Secret kubernetes.io/service-account-token використовується для зберігання токена, який ідентифікує ServiceAccount. Це застарілий механізм, який забезпечує довгострокові облікові дані ServiceAccount для Podʼів.
У Kubernetes v1.22 та пізніших рекомендований підхід полягає в тому, щоб натомість отримувати короткостроковий токен ServiceAccount з автоматичною ротацією за допомогою API TokenRequest. Ви можете отримати ці короткострокові токени такими методами:
Викликайте API TokenRequest безпосередньо або через клієнт API, такий як kubectl. Наприклад, ви можете використовувати команду kubectl create token.
Запитуйте змонтований токен у проєкційному томі у вашому маніфесті Podʼа. Kubernetes створює токен і монтує його в Pod. Токен автоматично анулюється, коли Pod, в якому він монтується, видаляється. Докладні відомості див. в розділі Запуск Podʼа з проєкцією токена ServiceAccount.
Примітка:
Ви повинні створювати Secret токена ServiceAccount лише в тому випадку, якщо ви не можете використовувати API TokenRequest для отримання токена, і вам прийнятно з погляду безпеки зберігання безстрокового токена доступу в доступному для читання обʼєкті API. Для інструкцій див. Створення довгострокового API-токена для ServiceAccount вручну.
Під час використання цього типу Secret вам потрібно переконатися, що анотація kubernetes.io/service-account.name містить назву наявного ServiceAccount. Якщо ви створюєте як Secret, так і обʼєкти ServiceAccount, ви повинні спочатку створити обʼєкт ServiceAccount.
Після створення Secret контролер Kubernetes заповнює деякі інші поля, такі як анотація kubernetes.io/service-account.uid, та ключ token в полі data, який заповнюється токеном автентифікації.
У цьому прикладі конфігурації оголошується Secret токена ServiceAccount:
Після створення Secret дочекайтеся, коли Kubernetes заповнить ключ token в полі data.
Для отримання додаткової інформації про роботу ServiceAccounts перегляньте документацію про ServiceAccount. Ви також можете перевірити поле automountServiceAccountToken та поле serviceAccountName у Pod для отримання інформації про посилання на облікові дані ServiceAccount з Podʼів.
Secrets конфігурації Docker
Якщо ви створюєте Secret для зберігання облікових даних для доступу до реєстру образів контейнерів, ви повинні використовувати одне з таких значень type для цього Secret:
kubernetes.io/dockercfg: зберігає серіалізований ~/.dockercfg, який є застарілим форматом налаштування командного рядка Docker. У полі data Secret міститься ключ .dockercfg, значення якого — це вміст файлу ~/.dockercfg, закодованого у форматі base64.
kubernetes.io/dockerconfigjson: зберігає серіалізований JSON, який відповідає тим самим правилам формату, що й файл ~/.docker/config.json, який є новим форматом для ~/.dockercfg. У полі data Secret має міститися ключ .dockerconfigjson, значення якого — це вміст файлу ~/.docker/config.json, закодованого у форматі base64.
Нижче наведено приклад для Secret типу kubernetes.io/dockercfg:
Якщо ви не хочете виконувати кодування у формат base64, ви можете натомість використати поле stringData.
Під час створення Secrets конфігурації Docker за допомогою маніфесту API-сервер перевіряє, чи існує очікуваний ключ у полі data, і чи надане значення можна розібрати як дійсний JSON. API-сервер не перевіряє, чи є цей JSON фактично файлом конфігурації Docker.
Ви також можете використовувати kubectl для створення Secret для доступу до реєстру контейнерів, наприклад, коли у вас немає файлу конфігурації Docker:
Значення auth закодовано у формат base64; воно приховане, але не є секретним. Будь-хто, хто може прочитати цей Secret, може дізнатися токен доступу (bearer) до реєстру.
Рекомендується використовувати постачальників облікових даних для динамічного й безпечного надання Secrets для завантаження образів на запит.
Secret базової автентифікації
Тип kubernetes.io/basic-auth наданий для зберігання облікових даних, необхідних для базової автентифікації. Під час використання цього типу Secret поле data Secret повинно містити один із двох таких ключів:
username: імʼя користувача для автентифікації
password: пароль або токен для автентифікації
Обидва значення для цих ключів є рядками, закодованими в base64. Ви також можете надати відкритий текст, використовуючи поле stringData у маніфесті Secret.
Цей маніфест є прикладом Secret для базової автентифікації:
apiVersion:v1kind:Secretmetadata:name:secret-basic-authtype:kubernetes.io/basic-authstringData:username:admin# required field for kubernetes.io/basic-authpassword:t0p-Secret# required field for kubernetes.io/basic-auth
Примітка:
Поле stringData для Secret погано працює із застосуванням на боці сервера (server-side apply).
Тип Secret для базової автентифікації наданий лише для зручності. Ви можете створити тип Opaque для облікових даних, які використовуються для базової автентифікації. Однак використання визначеного та публічного типу Secret (kubernetes.io/basic-auth) допомагає іншим людям зрозуміти призначення вашого Secret та встановлює домовленості для очікуваних назв ключів.
Secret для автентифікації SSH
Вбудований тип kubernetes.io/ssh-auth наданий для зберігання даних, що використовуються в автентифікації SSH. Під час використання цього типу Secret вам потрібно вказати пару ключ-значення ssh-privatekey в полі data (або stringData) як SSH-автентифікаційні дані для використання.
Цей маніфест є прикладом Secret, який використовується для автентифікації SSH з використанням пари публічного/приватного ключів:
apiVersion:v1kind:Secretmetadata:name:secret-ssh-authtype:kubernetes.io/ssh-authdata:# the data is abbreviated in this examplessh-privatekey:| UG91cmluZzYlRW1vdGljb24lU2N1YmE=
Тип Secret для автентифікації SSH наданий лише для зручності. Ви можете створити тип Opaque для облікових даних, які використовуються для автентифікації SSH. Однак використання визначеного та публічного типу Secret (kubernetes.io/ssh-auth) допомагає іншим людям зрозуміти призначення вашого Secret та встановлює домовленості для очікуваних назв ключів. API Kubernetes перевіряє, чи встановлені необхідні ключі для Secret цього типу.
Увага:
Приватні ключі SSH не встановлюють довіру між клієнтом SSH та хост-сервером самі по собі. Для зменшення ризику атак "man-in-the-middle" потрібен додатковий спосіб встановлення довіри, наприклад, файл known_hosts, доданий до ConfigMap.
TLS Secrets
Тип Secret kubernetes.io/tls призначений для зберігання сертифіката та повʼязаного з ним ключа, які зазвичай використовуються для TLS.
Одним з поширених використань TLS Secret є налаштування шифрування під час передачі для Ingress, але ви також можете використовувати його з іншими ресурсами або безпосередньо у вашому навантаженні. Під час використання цього типу Secret ключі tls.key та tls.crt повинні бути надані в полі data (або stringData) конфігурації Secret, хоча API-сервер фактично не перевіряє значення кожного ключа.
Як альтернативу використанню stringData, ви можете використовувати поле data для надання сертифіката та приватного ключа у вигляді base64-кодованого тексту. Докладніше див. Обмеження щодо назв і даних Secret.
apiVersion:v1kind:Secretmetadata:name:secret-tlstype:kubernetes.io/tlsdata:# values are base64 encoded, which obscures them but does NOT provide# any useful level of confidentiality# Replace the following values with your own base64-encoded certificate and key.tls.crt:"REPLACE_WITH_BASE64_CERT"tls.key:"REPLACE_WITH_BASE64_KEY"
Тип TLS Secret наданий лише для зручності. Ви можете створити тип Opaque для облікових даних, які використовуються для TLS-автентифікації. Однак використання визначеного та публічного типу Secret (kubernetes.io/tls) допомагає забезпечити однорідність формату Secret у вашому проєкті. API-сервер перевіряє, чи встановлені необхідні ключі для Secret цього типу.
Для створення TLS Secret за допомогою kubectl використовуйте підкоманду tls:
Пара публічного та приватного ключів повинна існувати заздалегідь. Сертифікат публічного ключа для --cert повинен бути закодований у форматі .PEM і повинен відповідати наданому приватному ключу для --key.
Secrets bootstrap-токенів
Тип Secret bootstrap.kubernetes.io/token призначений для токенів, що використовуються під час процесу ініціалізації вузла. Він зберігає токени, які використовуються для підпису відомих ConfigMaps.
Secret bootstrap-токена зазвичай створюється в просторі імен kube-system і називається у формі bootstrap-token-<token-id>, де <token-id> — це 6-символьний рядок ідентифікатора токена.
Як маніфест Kubernetes, Secret bootstrap-токена може виглядати так:
apiVersion:v1kind:Secretmetadata:# Зверніть увагу, як названо Secretname:bootstrap-token-5emitj# Secret bootstrap-токена зазвичай розміщується в просторі імен kube-systemnamespace:kube-systemtype:bootstrap.kubernetes.io/tokenstringData:auth-extra-groups:"system:bootstrappers:kubeadm:default-node-token"expiration:"2020-09-13T04:39:10Z"# Цей ідентифікатор токена використовується в назвіtoken-id:"5emitj"token-secret:"kq4gihvszzgn1p0r"# Цей токен може бути використаний для автентифікаціїusage-bootstrap-authentication:"true"# і він може бути використаний для підписуusage-bootstrap-signing:"true"
Примітка:
Поле stringData для Secret погано працює із застосуванням на боці сервера (server-side apply).
Ви можете вказати поля data і/або stringData під час створення файлу конфігурації для Secret. Поля data і stringData є необовʼязковими. Значення для всіх ключів у полі data повинні бути base64-кодованими рядками. Якщо перетворення у рядок base64 не є бажаним, ви можете вибрати поле stringData, яке приймає довільні рядки як значення.
Ключі data і stringData повинні складатися з буквено-цифрових символів, -, _ або .. Усі пари ключ-значення в полі stringData внутрішньо обʼєднуються в поле data. Якщо ключ зустрічається як у полі data, так і у полі stringData, значення, вказане у полі stringData, має пріоритет.
Обмеження розміру
Розмір окремих Secrets обмежено 1MiB. Це зроблено для того, щоб уникнути створення дуже великих Secrets, які можуть вичерпати памʼять API-сервера та kubelet. Однак створення багатьох менших Secrets також може вичерпати памʼять. Ви можете використовувати квоту ресурсів для обмеження кількості Secrets (або інших ресурсів) у просторі імен.
Редагування Secret
Ви можете редагувати наявний Secret, якщо він не є незмінним. Для редагування Secret скористайтеся одним із таких методів:
Ви також можете редагувати дані у Secret за допомогою інструменту Kustomize. Проте цей метод створює новий обʼєкт Secret з відредагованими даними.
Залежно від того, як ви створили Secret, а також від того, як Secret використовується у ваших Podʼах, оновлення наявних обʼєктів Secret автоматично поширюються на Podʼи, які використовують ці дані. Для отримання додаткової інформації звертайтеся до розділу Використання Secrets як файлів у Podʼі.
Використання Secret
Secrets можна монтувати як томи даних або надавати як змінні середовища для використання контейнером у Podʼі. Secrets також можуть використовуватися іншими частинами системи без безпосереднього надання Podʼу. Наприклад, Secrets можуть містити автентифікаційні дані, які інші частини системи повинні використовувати для взаємодії із зовнішніми системами від вашого імені.
Джерела томів Secret перевіряються, щоб переконатися, що вказане посилання на обʼєкт дійсно вказує на обʼєкт типу Secret. Тому Secret повинен бути створений перед будь-якими Podʼами, які залежать від нього.
Якщо Secret не може бути отриманий (можливо, через те, що він не існує, або через тимчасову відсутність зʼєднання з API-сервером), kubelet періодично повторює спробу запуску цього Podʼа. Kubelet також повідомляє про подію (Event) для цього Podʼа, включаючи деталі проблеми отримання Secret.
Необовʼязкові Secrets
Коли ви посилаєтеся на Secret у Podʼі, ви можете позначити Secret як необовʼязковий, як у цьому прикладі. Якщо необовʼязковий Secret не існує, Kubernetes ігнорує його.
Типово Secrets є обовʼязковими. Жоден з контейнерів Podʼа не розпочне роботу, доки всі обовʼязкові Secrets не будуть доступні.
Якщо Pod посилається на певний ключ у обовʼязковому Secret і цей Secret існує, але в ньому немає зазначеного ключа, Pod завершується невдачею під час запуску.
Використання Secrets як файлів у Podʼі
Якщо ви хочете отримати доступ до даних з Secret у Podʼі, один зі способів це зробити — щоб Kubernetes зробив значення цього Secret доступним як файл у файловій системі одного або декількох контейнерів Podʼа.
Коли том містить дані з Secret, а цей Secret оновлюється, Kubernetes відстежує це і оновлює дані в томі, використовуючи підхід кінцевої узгодженості (eventually consistent).
Примітка:
Контейнер, який використовує Secret як том з монтуванням subPath, не отримує автоматичних оновлень Secret.
Kubelet зберігає кеш поточних ключів та значень для Secrets, які використовуються у томах для Podʼів на цьому вузлі. Ви можете налаштувати спосіб, яким kubelet виявляє зміни від кешованих значень. Поле configMapAndSecretChangeDetectionStrategy в конфігурації kubelet контролює стратегію, яку використовує kubelet. Стандартною стратегією є Watch.
Оновлення Secrets можуть передаватися за допомогою механізму watch API (стандартно), на основі кешу з визначеним часом життя або шляхом опитування API-сервера кластера на кожному циклі синхронізації kubelet.
Як результат, загальна затримка від моменту оновлення Secret до моменту, коли нові ключі буде спроєцьовано в Pod, може дорівнювати періоду синхронізації kubelet + затримці поширення кешу, де затримка поширення кешу залежить від обраного типу кешу (у тому самому порядку, що й у попередньому абзаці: затримка поширення watch, налаштований TTL кешу або нуль для прямого опитування).
Для кожного контейнера у вашій специфікації Podʼа додайте змінну середовища для кожного ключа Secret, який ви хочете використовувати, у поле env[].valueFrom.secretKeyRef.
Змініть свій образ і/або командний рядок так, щоб програма шукала значення у вказаних змінних середовища.
Важливо зауважити, що діапазон символів, дозволених для назв змінних середовища в Podʼах, обмежений. Якщо будь-які ключі не відповідають правилам, ці ключі не будуть доступні вашому контейнеру, хоча Pod може бути запущений.
Secrets для завантаження образів контейнерів
Якщо ви хочете отримувати образи контейнерів з приватного репозиторію, вам потрібен спосіб автентифікації для kubelet на кожному вузлі для доступу до цього репозиторію. Ви можете налаштувати Secrets для завантаження образів для досягнення цієї мети. Ці Secrets налаштовуються на рівні Podʼа.
Використання imagePullSecrets
Поле imagePullSecrets є списком посилань на Secrets у тому самому просторі імен. Ви можете використовувати imagePullSecrets, щоб передати Secret, який містить пароль Docker (або іншого) репозиторію образів, в kubelet. Kubelet використовує цю інформацію для завантаження приватного образу від імені вашого Podʼа. Для отримання додаткової інформації про поле imagePullSecrets дивіться PodSpec API.
Вказування imagePullSecret вручну
Ви можете дізнатися, як вказати imagePullSecrets, переглянувши документацію про образи контейнерів.
Організація автоматичного приєднання imagePullSecrets
Ви можете вручну створити imagePullSecrets та посилатися на них з ServiceAccount. Будь-які Podʼи, створені з цим ServiceAccount або типово з ним, отримають поле imagePullSecrets, встановлене відповідно до цього ServiceAccount. Дивіться Додавання ImagePullSecrets до ServiceAccount для детального пояснення цього процесу.
Використання Secrets зі статичними Podʼами
Ви не можете використовувати ConfigMaps або Secrets зі статичними Podʼами.
Незмінні Secrets
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
Kubernetes дозволяє вам позначати певні Secrets (і ConfigMaps) як незмінні. Запобігання змінам даних наявного Secret має такі переваги:
захищає вас від випадкових (або небажаних) оновлень, які можуть призвести до відмов застосунків
(для кластерів, що широко використовують Secrets, — щонайменше десятки тисяч унікальних монтувань Secret у Podʼи) перехід до незмінних Secrets покращує продуктивність вашого кластера завдяки значному зменшенню навантаження на kube-apiserver. Kubelet не потрібно підтримувати [watch] для будь-яких Secrets, позначених як незмінні.
Позначення Secret як незмінного
Ви можете створити незмінний Secret, встановивши поле immutable в true. Наприклад,
Ви також можете оновити будь-який наявний змінний Secret, щоб зробити його незмінним.
Примітка:
Як тільки Secret або ConfigMap позначений як незмінний, цю зміну неможливо скасувати чи змінити зміст поля data. Ви можете тільки видалити і знову створити Secret. Наявні Podʼи зберігають точку монтування для видаленого Secret — рекомендується створити ці Podʼи заново.
Інформаційна безпека для Secrets
Хоча ConfigMap і Secret працюють схоже, Kubernetes застосовує додаткові заходи захисту для обʼєктів Secret.
Secrets часто містять значення різного ступеня важливості, багато з яких можуть спричинити ескалацію привілеїв у Kubernetes (наприклад, токени ServiceAccount) та у зовнішніх системах. Навіть якщо окремий застосунок може оцінити можливості Secrets, з якими очікує взаємодіяти, інші застосунки в тому самому просторі імен можуть зробити ці припущення недійсними.
Налаштування авторизації впливає на те, як можна отримати доступ до даних Secret у межах простору імен. Наприклад, надання дозволів list або watch для Secrets дозволяє субʼєкту читати всі дані Secret у цьому просторі імен, а не лише ті Secrets, на які явно посилаються його Podʼи. Обмежте доступ до мінімального набору дозволів, необхідних для роботи навантаження, і уникайте надання широких ролей, таких як cluster-admin, якщо це не потрібно для адміністративних цілей.
Secret буде відправлений на вузол тільки у випадку, якщо на цьому вузлі є Pod, якому він потрібен. Для монтування Secrets у Podʼи kubelet зберігає копію даних у tmpfs, щоб конфіденційні дані не записувалися на постійний носій. Коли Pod, який залежить від Secret, видаляється, kubelet видаляє свою локальну копію конфіденційних даних з Secret.
У Podʼі може бути кілька контейнерів. Типово контейнери, які ви визначаєте, мають доступ тільки до стандартного ServiceAccount та повʼязаного з ним Secret. Вам потрібно явно визначити змінні середовища або відобразити том у контейнері, щоб надати доступ до будь-якого іншого Secret.
На одному вузлі можуть бути Secrets для кількох Podʼів. Проте лише ті Secrets, які запитує Pod, потенційно видимі всередині його контейнерів. Таким чином, один Pod не має доступу до Secrets іншого Podʼа.
Налаштування доступу до Secrets за принципом найменших привілеїв
Щоб посилити заходи безпеки навколо Secrets, використовуйте окремі простори імен для ізоляції доступу до змонтованих Secrets.
Попередження:
Будь-які контейнери, які працюють з параметром privileged: true на вузлі, можуть отримати доступ до всіх Secrets, що використовуються на цьому вузлі.
Коли ви визначаєте Pod, ви можете додатково вказати, скільки кожного ресурсу потребує контейнер. Найпоширеніші ресурси, які вказують, — це CPU та памʼять (RAM); є й інші.
Коли ви вказуєте запит ресурсів для контейнерів в Podʼі, kube-scheduler використовує цю інформацію для вибору вузла, на який розмістити Pod. Коли ви вказуєте обмеження ресурсів для контейнера, kubelet забезпечує виконання цих обмежень, щоб запущений контейнер не міг використовувати більше цього ресурсу, ніж обмеження, яке ви встановили. Kubelet також резервує принаймні запитану кількість цього системного ресурсу спеціально для використання цим контейнером.
Запити та обмеження
Якщо вузол, на якому запущений Pod, має достатньо вільного ресурсу, то контейнер може (і має право) використовувати більше ресурсу, ніж зазначено в його request для цього ресурсу.
Наприклад, якщо ви встановите запит memory 256 MiB для контейнера, і цей контейнер буде в Podʼі, запланованому на вузол із 8GiB памʼяті та без інших Podʼів, то контейнер може спробувати використати більше оперативної памʼяті.
Обмеження — то вже інша справа. Обидва обмеження cpu та memory застосовуються kubeletʼом (та середовищем виконання контейнерів), і, зрештою, забезпечуються ядром. На вузлах Linux ядро Linux застосовує обмеження за допомогою cgroups. Поведінка застосування обмежень cpu та memory дещо відрізняється.
Обмеження cpu застосовуються через тротлінг CPU (CPU throttling). Коли контейнер наближається до свого обмеження cpu, ядро обмежує доступ до CPU відповідно до обмеження контейнера. Тож обмеження cpu є жорстким обмеженням, що застосовує ядро. Контейнери не можуть використовувати більше CPU, ніж зазначено в їх обмеженні cpu.
Обмеження memory застосовуються ядром через завершення процесів за нестачі памʼяті (OOM kills). Якщо контейнер використовує більше памʼяті, ніж його обмеження memory, ядро може його завершити. Однак завершення відбувається тільки тоді, коли ядро виявляє тиск на памʼять. Тому контейнер, який виділяє забагато памʼяті, може бути завершений не одразу. Це означає, що обмеження memory застосовуються реактивно. Контейнер може використовувати більше памʼяті, ніж його обмеження memory, але в такому разі його може бути завершено.
Примітка:
Існує функція MemoryQoS, яка додає тротлінг памʼяті та необовʼязкове багаторівневе резервування памʼяті на вузлах Linux за допомогою cgroup v2. Докладніше дивіться Memory QoS з cgroup v2.
Примітка:
Якщо ви вказали обмеження для ресурсу, але не вказали жодного запиту, і жодний механізм допуску не застосував стандартного значення запиту для цього ресурсу, то Kubernetes скопіює обмеження, яке ви вказали, та використовує його як запитане значення для ресурсу.
Типи ресурсів
Тип ресурсу має базову одиницю вимірювання, і його можна запитувати, обмежувати або і те, й інше. Kubernetes має такі вбудовані типи ресурсів:
Кластери також можуть надавати розширені ресурси (ресурси з власною назвою, які зазвичай надають втулки пристроїв).
Великі сторінки
Для робочих навантажень на Linux ви можете вказати ресурси великих сторінок (huge pages). Великі сторінки є функцією, специфічною для Linux, де ядро вузла виділяє блоки памʼяті, значно більші за стандартний розмір сторінки.
Наприклад, у системі, де розмір стандартної сторінки становить 4KiB, ви можете вказати обмеження hugepages-2Mi: 80Mi. Якщо контейнер намагається виділити понад 40 великих сторінок по 2MiB (загалом 80 MiB), це виділення завершиться невдачею.
Примітка:
Ресурси hugepages-* не можна виділяти понад наявні (overcommit). Це відрізняється від ресурсів memory та cpu.
CPU та памʼять спільно називаються обчислювальними ресурсами або ресурсами. Обчислювальні ресурси — це вимірювані величини, які можна запитувати, виділяти та використовувати. Вони відрізняються від ресурсів API. Ресурси API, такі як Podʼи та Services, є обʼєктами, які можна читати та змінювати через API-сервер Kubernetes.
Запити та обмеження ресурсів для Podʼа та контейнера
Для кожного контейнера ви можете вказати обмеження та запити ресурсів, зокрема такі:
Хоча ви можете вказувати запити та обмеження тільки для окремих контейнерів, також корисно думати про загальні запити та обмеження ресурсів для Podʼа. Для певного ресурсу запит/обмеження ресурсів Podʼа — це сума запитів/обмежень цього типу для кожного контейнера в Podʼі.
Специфікація ресурсів на рівні Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34; (стандартно увімкнено)
За умови, що у вашому кластері увімкнено функціональну можливістьPodLevelResources, ви можете вказувати запити та обмеження ресурсів на рівні Podʼа. На рівні Podʼа Kubernetes 1.37 підтримує запити або обмеження ресурсів лише для певних типів ресурсів: cpu та/або memory, та/або hugepages. Завдяки цій функції Kubernetes дозволяє вам декларувати загальний бюджет ресурсів для Podʼа, що є особливо корисним під час роботи з великою кількістю контейнерів, де може бути важко точно визначити індивідуальні потреби у ресурсах. Крім того, це дає змогу контейнерам у межах Podʼа ділитися один з одним ресурсами, що простоюють, покращуючи використання ресурсів.
Для Podʼа ви можете вказати обмеження та запити ресурсів для CPU і памʼяті, включивши таке:
spec.resources.limits.cpu
spec.resources.limits.memory
spec.resources.limits.hugepages-<size>
spec.resources.requests.cpu
spec.resources.requests.memory
spec.resources.requests.hugepages-<size>
Одиниці виміру ресурсів в Kubernetes
Одиниці виміру ресурсів CPU
Обмеження та запити ресурсів CPU вимірюються в одиницях cpu. У Kubernetes 1 одиниця CPU еквівалентна 1 фізичному ядру CPU або 1 віртуальному ядру, залежно від того, чи є вузол фізичним хостом або віртуальною машиною, яка працює всередині фізичної машини.
Допускаються дробові запити. Коли ви визначаєте контейнер зі значенням 0.5 у spec.containers[].resources.requests.cpu, ви запитуєте вдвічі менше часу CPU, ніж якби запросили 1.0 CPU. Для одиниць ресурсів CPU вираз кількості0.1 еквівалентний виразу 100m, що можна прочитати як "сто millicpu". Деякі люди кажуть "сто міліядер", і це розуміється так само.
Ресурс CPU завжди вказується як абсолютна кількість ресурсу, ніколи як відносна кількість. Наприклад, 500m CPU представляє приблизно ту саму обчислювальну потужність незалежно від того, чи працює цей контейнер на одноядерній, двоядерній або 48-ядерній машині.
Примітка:
Kubernetes не дозволяє вказувати ресурси CPU з точністю вище 1m або 0.001 CPU. Щоб уникнути випадкового використання неприпустимої кількості CPU, корисно вказувати одиниці CPU, використовуючи форму milliCPU замість десяткової форми, коли використовується менше ніж 1 одиниця CPU.
Наприклад, у вас є Pod, який використовує 5m або 0.005 CPU, і ви хочете зменшити його ресурси CPU. Використовуючи десяткову форму, важко помітити, що 0.0005 CPU є неприпустимим значенням, тоді як використовуючи форму milliCPU, легше помітити, що 0.5m є неприпустимим значенням.
Одиниці виміру ресурсів памʼяті
Обмеження та запити для memory вимірюються в байтах. Ви можете вказувати памʼять як звичайне ціле число або як число з фіксованою комою, використовуючи один із таких суфіксів кількості: E, P, T, G, M, k. Ви також можете використовувати еквіваленти степенів двійки: Ei, Pi, Ti, Gi, Mi, Ki. API Kubernetes також дозволяє використовувати суфікс m (для мілібайтів: 1/1000 байта), але вказувати його немає сенсу: завжди потрібно призначати цілі числа байтів або іноді більші блоки, такі як кратні 1 гібібайту.
Ось кілька прикладів визначення обсягу памʼяті, які приблизно представляють те саме значення:
128974848, 129e6, 129M, 128974848000m, 123Mi
Звертайте увагу на регістр суфіксів. "M" означає мегабайти, тоді як "m" означає мілібайти. Якщо ви запитуєте 400m памʼяті, це запит на 0,4 байта. Той, хто вводить це, ймовірно, мав на увазі запросити 400 мебібайтів (400Mi) або 400 мегабайтів (400M).
Приклад ресурсів контейнера
У цьому Podʼі є два контейнери. Обидва контейнери визначені із запитом на 0,25 CPU і 64MiB (226 байт) памʼяті. Кожен контейнер має обмеження в 0,5 CPU та 128MiB памʼяті. Можна сказати, що Pod має запит на 0,5 CPU та 128 MiB памʼяті й обмеження в 1 CPU та 256MiB памʼяті.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34; (стандартно увімкнено)
Цю можливість можна увімкнути за допомогою функціональної можливостіPodLevelResources. Цей Pod має явний запит на 1 CPU та 100 MiB памʼяті, а також явне обмеження в 1 CPU та 200 MiB памʼяті. Контейнер pod-resources-demo-ctr-1 має явні запити та обмеження. Однак контейнер pod-resources-demo-ctr-2 просто спільно використовуватиме ресурси, доступні в межах ресурсів Podʼа, оскільки він не має явних запитів і обмежень.
Коли ви створюєте Pod, планувальник Kubernetes вибирає вузол, на якому Pod буде запущено. Кожен вузол має максимальну місткість для кожного з типів ресурсів: кількість CPU та обсяг памʼяті, які він може надати для Podʼів. Планувальник гарантує, що для кожного типу ресурсів сума запитів ресурсів запланованих контейнерів буде менше, ніж місткість вузла. Зверніть увагу, що навіть якщо фактичне використання ресурсів CPU або памʼяті на вузлі дуже низьке, планувальник все одно відмовляється розміщувати Pod на вузлі, якщо перевірка місткості не пройшла успішно. Це захищає від нестачі ресурсів на вузлі, коли пізніше збільшується використання ресурсів, наприклад, під час щоденного піку кількості запитів.
Як Kubernetes застосовує запити на ресурси та обмеження
Коли kubelet запускає контейнер як частину Podʼа, він передає запити та обмеження для памʼяті та CPU цього контейнера до середовища виконання контейнерів.
У Linux середовище виконання контейнерів зазвичай налаштовує cgroups ядра, які застосовують і забезпечують виконання визначених вами обмежень.
Обмеження CPU встановлює жорстку верхню межу часу CPU, який може використовувати контейнер. Протягом кожного інтервалу планування (часового відрізка) ядро Linux перевіряє, чи перевищується це обмеження; якщо так, ядро чекає, перш ніж дозволити цій cgroup продовжити виконання.
Запит CPU зазвичай визначає вагу. Якщо кілька різних контейнерів (cgroups) хочуть працювати на системі з конкуренцією за ресурси, робочі навантаження з більшими запитами CPU отримують більше часу CPU, ніж робочі навантаження з малими запитами.
Запит памʼяті в основному використовується під час планування Podʼа (Kubernetes). На вузлі, що використовує cgroups v2, середовище виконання контейнерів може використовувати запит памʼяті як підказку для встановлення memory.min та memory.low.
Обмеження памʼяті встановлює обмеження памʼяті для цієї контрольної групи. Якщо контейнер намагається виділити більше памʼяті, ніж це обмеження, підсистема обробки нестачі памʼяті (out-of-memory) ядра Linux активується і, зазвичай, втручається, зупиняючи один з процесів у контейнері, який намагався виділити памʼять. Якщо цей процес є PID 1 контейнера, і контейнер позначений як такий, що може перезапускатися, Kubernetes перезапускає контейнер.
Обмеження памʼяті для Podʼа або контейнера також може застосовуватися до сторінок у томах, що зберігаються в памʼяті, таких як emptyDir. Kubelet відстежує томи emptyDir типу tmpfs як використання памʼяті контейнера, а не як локальне тимчасове сховище. Під час використання emptyDir у памʼяті обовʼязково ознайомтеся з примітками нижче.
Якщо контейнер перевищує свій запит на памʼять і вузол, на якому він працює, загалом стикається з нестачею памʼяті, ймовірно, що Pod, якому належить цей контейнер, буде виселено.
Контейнеру може бути дозволено або не дозволено перевищувати своє обмеження CPU протягом тривалого часу. Однак середовища виконання контейнерів не завершують Podʼи або контейнери через надмірне використання CPU.
Щоб визначити, чи контейнер неможливо запланувати або чи його завершують через обмеження ресурсів, див. розділ Усунення несправностей.
Зміна розміру ресурсів контейнера
Після створення Podʼа може знадобитися налаштувати його ресурси CPU або памʼяті відповідно до фактичних моделей використання. Kubernetes пропонує два підходи до зміни розміру ресурсів Podʼа:
Зміна розміру на місці
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate InPlacePodVerticalScaling, Kubernetes ignores it but does not report any error.
Ви можете змінити requests та limits CPU та памʼяті контейнерів у запущеному Podʼі без його повторного створення. Це називається вертикальним масштабуванням Podʼа на місці або зміною розміру Podʼа на місці. Щоб виконати зміну розміру на місці, оновіть специфікації ресурсів контейнера за допомогою субресурсу Podʼа /resize. Ви можете контролювати, чи потрібно перезапускати контейнер, встановивши поле resizePolicy у специфікації контейнера.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the InPlacePodVerticalScalingSchedulerPreemption feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість InPlacePodVerticalScalingSchedulerPreemption, відкладені запити на зміну розміру на місці можуть спонукати kube-scheduler витіснити Podʼи з нижчим пріоритетом на призначеному вузлі, щоб звільнити місце для зміни розміру. Для отримання додаткових відомостей див. Витіснення для зміни розміру Podʼа на місці.
Зміна розміру шляхом запуску Podʼів-замінників
Підхід cloud native до зміни ресурсів Podʼа полягає в оновленні шаблону Podʼа в обʼєкті робочого навантаження (такому як Deployment або StatefulSet) і дозволі контролеру робочого навантаження замінити Podʼи новими, що мають оновлені ресурси. Цей підхід працює з будь-якою версією Kubernetes і дозволяє змінювати будь-які специфікації Podʼів.
Моніторинг використання обчислювальних ресурсів та ресурсів памʼяті
Kubelet повідомляє про використання ресурсів Podʼа як частину status Podʼа.
Якщо у вашому кластері доступні інструменти для моніторингу, то використання ресурсів Podʼа можна отримати або безпосередньо з Metrics API, або з ваших інструментів моніторингу.
Міркування щодо томів emptyDir, що зберігаються в памʼяті
Примітка:
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the InPlacePodVerticalScalingMemoryBackedVolumes feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість InPlacePodVerticalScalingMemoryBackedVolumes, ви можете динамічно змінювати sizeLimit тому emptyDir, що зберігається в памʼяті (medium: Memory), на запущеному Podʼі без повторного створення Podʼа або перезапуску контейнерів. Покрокові інструкції див. у розділі Зміна розміру ресурсів CPU та памʼяті, призначених контейнерам.
Увага:
Якщо ви не вказуєте sizeLimit для тому emptyDir, цей том може використовувати памʼять до обмеження памʼяті цього Podʼа (Pod.spec.containers[].resources.limits.memory). Якщо ви не встановлюєте обмеження памʼяті, Pod не має верхньої межі на споживання памʼяті і може використовувати всю доступну памʼять на вузлі. Kubernetes планує Podʼи на основі запитів на ресурси (Pod.spec.containers[].resources.requests) і не враховує використання памʼяті понад запит під час вирішення, чи може інший Pod розміститися на даному вузлі. Це може призвести до відмови в обслуговуванні та змусити ОС виконати обробку нестачі памʼяті (OOM). Можна створити будь-яку кількість emptyDir, які потенційно можуть використовувати всю доступну памʼять на вузлі, що робить OOM більш ймовірним.
З точки зору управління памʼяттю, є деякі подібності між використанням памʼяті як робочої області процесу і використанням памʼяті для emptyDir, що зберігається в памʼяті. Але під час використання памʼяті як тому, як у випадку з emptyDir, що зберігається в памʼяті, є додаткові моменти, на які слід звернути увагу:
Файли, збережені в томі, що зберігається в памʼяті, майже повністю управляються застосунком користувача. На відміну від використання памʼяті як робочої області процесу, ви не можете покладатися на такі речі, як збір сміття на рівні мови програмування.
Мета запису файлів в том полягає в збереженні даних або їх передачі між застосунками. Ні Kubernetes, ні ОС не можуть автоматично видаляти файли з тому, тому памʼять, яку займають ці файли, не може бути звільнена, коли система або Pod відчувають тиск на памʼять.
Томи emptyDir, що зберігаються в памʼяті, корисні через свою продуктивність, але памʼять зазвичай набагато менша за розміром і набагато дорожча за інші носії, такі як диски або SSD. Використання великої кількості памʼяті для томів emptyDir може вплинути на нормальну роботу вашого Podʼа або всього вузла, тому їх слід використовувати обережно.
Якщо ви адмініструєте кластер або простір імен, ви також можете встановити ResourceQuota, що обмежує використання памʼяті; також може бути корисно визначити LimitRange для додаткового забезпечення обмежень. Якщо ви вказуєте spec.containers[].resources.limits.memory для кожного Podʼа, то максимальний розмір тому emptyDir буде дорівнювати обмеженню памʼяті Podʼа.
Як альтернатива, адміністратор кластера може забезпечити дотримання обмежень на розмір томів emptyDir в нових Podʼах, використовуючи механізм політики, такий як ValidatingAdmissionPolicy.
Локальне тимчасове сховище
Щодо загальних концепцій про локальне тимчасове сховище та порад щодо налаштування запитів і/або обмежень локального тимчасового сховища для контейнера, дивіться сторінку локальне тимчасове сховище.
Моніторинг ресурсів для локального тимчасового сховища
Kubelet може вимірювати, скільки локального тимчасового сховища використовується. Він робить це, якщо ви ввімкнули ізоляцію ємності локального тимчасового сховища.
Kubernetes відстежує обсяг тимчасового сховища, яке використовує Pod, із таких джерел:
Запис у шар контейнера, доступний для запису (rootfs), в образи контейнерів або і туди, й туди.
Запис у локальні томи emptyDir.
Власні логи Podʼа (зазвичай зберігаються в /var/log/pods).
Системні файли, керовані Kubernetes, які відображаються в Pod, наприклад /etc/hosts.
Розширені ресурси
Розширені ресурси — це повністю кваліфіковані назви ресурсів поза доменом kubernetes.io. Вони дозволяють операторам кластера оголошувати, а користувачам використовувати ресурси, які не вбудовані в Kubernetes.
Щоб скористатися розширеними ресурсами, потрібно виконати два кроки. По-перше, оператор кластера повинен оголосити розширений ресурс. По-друге, користувачі повинні запитати розширений ресурс у Podʼах.
Керування розширеними ресурсами
Розширені ресурси на рівні вузла
Розширені ресурси на рівні вузла повʼязані з вузлами.
Ресурси, керовані втулками пристроїв
Дивіться Втулок пристроїв щодо того, як оголошувати ресурси, що керуються втулком пристроїв на кожному вузлі.
Інші ресурси
Щоб оголосити новий розширений ресурс на рівні вузла, оператор кластера може надіслати HTTP-запит типу PATCH до API-сервера, щоб вказати доступну кількість в полі status.capacity для вузла у кластері. Після цієї операції поле status.capacity вузла буде містити новий ресурс. Kubelet автоматично й асинхронно оновлює поле status.allocatable, додаючи новий ресурс.
Оскільки планувальник використовує значення status.allocatable вузла під час оцінювання придатності Podʼа, планувальник враховує нове значення лише після цього асинхронного оновлення. Між моментом зміни місткості вузла новим ресурсом і часом, коли перший Pod, який запитує ресурс, може бути запланований на цьому вузлі, може відбуватися коротка затримка.
Приклад:
Нижче наведено приклад використання curl для формування HTTP-запиту, який оголошує пʼять ресурсів "example.com/foo" на вузлі k8s-node-1, master якого — k8s-master.
У наведеному вище запиті ~1 — це кодування символу / у шляху патча. Значення шляху операції у JSON-Patch інтерпретується як JSON-Pointer. Докладніше дивіться IETF RFC 6901, розділ 3.
Розширені ресурси на рівні кластера
Розширені ресурси на рівні кластера не повʼязані з вузлами. Зазвичай ними керують розширювачі планувальника, які відповідають за споживання ресурсів і квоту ресурсів.
Ви можете вказати розширені ресурси, які обробляються розширювачами планувальника, в конфігурації планувальника.
Приклад:
Ця конфігурація для політики планувальника вказує на те, що розширений ресурс на рівні кластера "example.com/foo" обробляється розширювачем планувальника.
Планувальник відправляє Pod до розширювача планувальника тільки у випадку, якщо Pod запитує "example.com/foo".
Поле ignoredByScheduler вказує, що планувальник не перевіряє ресурс "example.com/foo" в своєму предикаті PodFitsResources.
Розподілення розширених ресурсів за допомогою DRA дозволяє адміністраторам кластерів вказувати extendedResourceName у DeviceClass, після чого пристрої, що відповідають DeviceClass, можуть бути запитані з розширених запитів ресурсів Podʼа. Читайте більше про Розподілення розширених ресурсів за допомогою DRA.
Використання розширених ресурсів
Користувачі можуть використовувати розширені ресурси у специфікаціях Podʼа, подібно до CPU та памʼяті. Планувальник відповідає за облік ресурсів, щоб одночасно не виділялося більше доступної кількості ресурсів для Podʼів.
API-сервер обмежує кількість розширених ресурсів цілими числами. Приклади дійсних значень: 3, 3000m та 3Ki. Приклади недійсних значень: 0.5 та 1500m (тому що 1500m буде давати в результаті 1.5).
Примітка:
Розширені ресурси замінюють Opaque Integer Resources. Користувачі можуть використовувати будь-який префікс доменного імені, крім kubernetes.io, який зарезервований.
Щоб використовувати розширений ресурс у Podʼі, включіть назву ресурсу як ключ у мапу spec.containers[].resources.limits у специфікації контейнера.
Примітка:
Розширені ресурси не можна виділяти понад наявні (overcommit), тому запит і обмеження мають бути рівними, якщо обидва присутні у специфікації контейнера.
Pod планується лише тоді, коли задоволено всі запити ресурсів, включаючи CPU, памʼять та будь-які розширені ресурси. Pod залишається у стані PENDING, доки запит ресурсу неможливо задовольнити.
Приклад:
Нижче наведено Pod, який запитує 2 CPU та 1 "example.com/foo" (розширений ресурс).
Обмеження ідентифікаторів процесів (PID) дозволяють налаштувати kubelet для обмеження кількості PID, яку може використовувати певний Pod. Див. Обмеження PID для отримання інформації.
Усунення несправностей
Мої Podʼи знаходяться в стані очікування з повідомленням події FailedScheduling
Якщо планувальник не може знайти жодного вузла, де може розміститися Pod, Pod залишається незапланованим, поки не буде знайдено місце. Кожного разу, коли планувальник не може знайти місце для Podʼа, створюється подія. Ви можете використовувати kubectl для перегляду подій Podʼа; наприклад:
kubectl describe pod frontend | grep -A 9999999999 Events
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Warning FailedScheduling 23s default-scheduler 0/42 nodes available: insufficient cpu
У наведеному вище прикладі Pod із назвою "frontend" не вдалося запланувати через нестачу ресурсу CPU на будь-якому вузлі. Схожі повідомлення про помилку також можуть вказувати на невдачу через недостатню памʼять (PodExceedsFreeMemory). Загалом, якщо Pod знаходиться в стані очікування з таким типом повідомлення, є кілька речей, які варто спробувати:
Додайте більше вузлів у кластер.
Завершіть непотрібні Podʼи, щоб звільнити місце для очікуваних Podʼів.
Перевірте, що Pod не є більшим, ніж усі вузли. Наприклад, якщо всі вузли мають місткість cpu: 1, то Pod з запитом cpu: 1.1 ніколи не буде запланованим.
Перевірте наявність taints на вузлах. Якщо більшість ваших вузлів мають taint, і новий Pod не толерує цей taint, планувальник розглядає розміщення лише на решті вузлів, які не мають цього taint.
Ви можете перевірити місткості вузлів та виділені обсяги ресурсів за допомогою команди kubectl describe nodes. Наприклад:
У наведеному вище виводі ви можете побачити, що якщо Pod запитує більше 1,120 CPU або більше 6,23Gi памʼяті, то цей Pod не поміститься на вузлі.
Подивившись на розділ "Pods", ви можете побачити, які Podʼи займають місце на вузлі.
Обсяг ресурсів, доступних для Podʼів, менший за місткість вузла, оскільки системні демони використовують частину доступних ресурсів. В API Kubernetes кожен вузол має поле .status.allocatable (див. NodeStatus для деталей).
Поле .status.allocatable описує обсяг ресурсів, доступних для Podʼів на цьому вузлі (наприклад: 15 віртуальних CPU та 7538 MiB памʼяті). Для отримання додаткової інформації про доступні для розподілу (allocatable) ресурси вузла в Kubernetes дивіться Резервування обчислювальних ресурсів для системних демонів.
Ви можете налаштувати квоти ресурсів для обмеження загального обсягу ресурсів, який може споживати простір імен. Kubernetes забезпечує дотримання квот для обʼєктів в конкретному просторі імен, коли існує ResourceQuota в цьому просторі імен. Наприклад, якщо ви призначаєте конкретні простори імен різним командам, ви можете додавати ResourceQuotas в ці простори імен. Встановлення квот ресурсів допомагає запобігти використанню однією командою так багато будь-якого ресурсу, що це впливає на інші команди.
Вам також варто розглянути, який доступ ви надаєте до цього простору імен: повний дозвіл на запис у простір імен дозволяє тому, хто має такий доступ, видаляти будь-який ресурс, включаючи налаштований ResourceQuota.
Робота мого контейнера завершується примусово
Робота вашого контейнера може бути завершена через нестачу ресурсів. Щоб перевірити, чи контейнер був завершений через досягнення обмеження ресурсів, викличте kubectl describe pod для потрібного Podʼа:
kubectl describe pod simmemleak-hra99
Вивід буде схожий на:
Name: simmemleak-hra99
Namespace: default
Image(s): saadali/simmemleak
Node: kubernetes-node-tf0f/10.240.216.66
Labels: name=simmemleak
Status: Running
Reason:
Message:
IP: 10.244.2.75
Containers:
simmemleak:
Image: saadali/simmemleak:latest
Limits:
cpu: 100m
memory: 50Mi
State: Running
Started: Tue, 07 Jul 2019 12:54:41 -0700
Last State: Terminated
Reason: OOMKilled
Exit Code: 137
Started: Fri, 07 Jul 2019 12:54:30 -0700
Finished: Fri, 07 Jul 2019 12:54:33 -0700
Ready: False
Restart Count: 5
Conditions:
Type Status
Ready False
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 42s default-scheduler Successfully assigned simmemleak-hra99 to kubernetes-node-tf0f
Normal Pulled 41s kubelet Container image "saadali/simmemleak:latest" already present on machine
Normal Created 41s kubelet Created container simmemleak
Normal Started 40s kubelet Started container simmemleak
Normal Killing 32s kubelet Killing container with id ead3fb35-5cf5-44ed-9ae1-488115be66c6: Need to kill Pod
У наведеному вище прикладі Restart Count: 5 вказує на те, що контейнер simmemleak у Podʼі був завершений та перезапущений пʼять разів (до цього моменту). Причина OOMKilled показує, що контейнер намагався використовувати більше памʼяті, ніж встановлене йому обмеження.
Наступним кроком може бути перевірка коду застосунку на витік памʼяті. Якщо ви виявите, що застосунок працює так, як очікувалося, розгляньте встановлення вищого обмеження памʼяті (і, можливо, запиту) для цього контейнера.
6.7.4 - Організація доступу до кластера за допомогою файлів kubeconfig
Використовуйте файли kubeconfig для організації інформації про кластери, користувачів, простори імен та механізми автентифікації. Інструмент командного рядка kubectl використовує файли kubeconfig, щоб знайти інформацію, необхідну для вибору кластера та звʼязку з API-сервером кластера.
Примітка:
Файл, який використовується для налаштування доступу до кластерів, називається файлом kubeconfig. Це загальний спосіб посилання на файли конфігурації. Це не означає, що існує файл із назвою kubeconfig.
Попередження:
Використовуйте файли kubeconfig лише з надійних джерел. Використання спеціально створеного файлу kubeconfig може призвести до виконання зловмисного коду або розкриття файлів. Якщо вам все ж потрібно використовувати ненадійний файл kubeconfig, уважно перевірте його, так само як ви це зробили б з файлом скрипту оболонки.
Типово kubectl шукає файл із назвою config у теці $HOME/.kube. Ви можете вказати інші файли kubeconfig, встановивши змінну середовища KUBECONFIG або встановивши прапорець --kubeconfig.
Підтримка кількох кластерів, користувачів та механізмів автентифікації
Припустимо, у вас є декілька кластерів, і ваші користувачі та компоненти автентифікуються різними способами. Наприклад:
Запущений kubelet може автентифікуватися за допомогою сертифікатів.
Користувач може автентифікуватися за допомогою токенів.
Адміністратори можуть мати набори сертифікатів, які вони надають окремим користувачам.
За допомогою файлів kubeconfig ви можете організувати ваші кластери, користувачів та простори імен. Ви також можете визначити контексти, щоб швидко та легко перемикатися між кластерами та просторами імен.
Контекст
Елемент context у файлі kubeconfig використовується для групування параметрів доступу під зручною назвою. Кожен контекст має три параметри: кластер, простір імен та користувач. Типово інструмент командного рядка kubectl використовує параметри з поточного контексту для звʼязку з кластером.
Щоб обрати поточний контекст:
kubectl config use-context
Змінна середовища KUBECONFIG
Змінна середовища KUBECONFIG містить список файлів kubeconfig. Для Linux та Mac список розділяється двокрапкою. Для Windows список розділяється крапкою з комою. Змінна середовища KUBECONFIG не є обовʼязковою. Якщо змінна середовища KUBECONFIG не існує, kubectl використовує стандартний файл kubeconfig, $HOME/.kube/config.
Якщо змінна середовища KUBECONFIG існує, kubectl використовує підсумкову конфігурацію, яка є результатом обʼєднання файлів, перелічених у змінній середовища KUBECONFIG.
Обʼєднання файлів kubeconfig
Щоб переглянути вашу конфігурацію, введіть цю команду:
kubectl config view
Як описано раніше, вивід може бути з одного файлу kubeconfig або бути результатом обʼєднання кількох файлів kubeconfig.
Ось правила, які використовує kubectl під час обʼєднання файлів kubeconfig:
Якщо встановлено прапорець --kubeconfig, використовуйте лише вказаний файл. Обʼєднання не здійснюється. Дозволяється лише один екземпляр цього прапорця.
В іншому випадку, якщо встановлена змінна середовища KUBECONFIG, використовуйте її як список файлів, які потрібно обʼєднати. Обʼєднайте файли, перелічені у змінній середовища KUBECONFIG, за такими правилами:
Ігноруйте порожні імена файлів.
Виводьте помилки для файлів з вмістом, який не може бути десеріалізований.
Перший файл, що встановлює певне значення або ключ мапи, має перевагу.
Ніколи не змінюйте значення або ключ мапи. Приклад: зберігайте контекст першого файлу, який встановлює current-context. Приклад: якщо два файли вказують red-user, використовуйте лише значення з red-user першого файлу. Навіть якщо другий файл має неконфліктні записи в red-user, відкиньте їх.
В іншому випадку використовуйте стандартний файл kubeconfig, $HOME/.kube/config, без обʼєднання.
Визначте контекст, який буде використовуватися, на основі першого збігу в цьому ланцюжку:
Використовуйте прапорець командного рядка --context, якщо він існує.
Використовуйте current-context з обʼєднаних файлів kubeconfig.
Порожній контекст допускається на цьому етапі.
Визначте кластер та користувача. На цьому етапі може бути або не бути контексту. Визначте кластер та користувача на основі першого збігу в цьому ланцюжку, який запускається двічі: один раз для користувача та один раз для кластера:
Використовуйте прапорці командного рядка, якщо вони існують: --user або --cluster.
Якщо контекст не порожній, беріть користувача або кластер з контексту.
Користувач та кластер можуть бути порожніми на цьому етапі.
Визначте фактичну інформацію про кластер, яку слід використовувати. На цьому етапі може бути або не бути інформації про кластер. Побудуйте кожен елемент інформації про кластер на основі цього ланцюжка; перший збіг перемагає:
Використовуйте прапорці командного рядка, якщо вони існують: --server, --certificate-authority, --insecure-skip-tls-verify.
Якщо існують будь-які атрибути інформації про кластер з обʼєднаних файлів kubeconfig, використовуйте їх.
Якщо немає розташування сервера, завершіть роботу з помилкою.
Визначте фактичну інформацію про користувача, яку слід використовувати. Побудуйте інформацію про користувача, використовуючи ті самі правила, що і для інформації про кластер, за винятком того, що дозволяється лише одна техніка автентифікації для кожного користувача:
Використовуйте прапорці командного рядка, якщо вони існують: --client-certificate, --client-key, --username, --password, --token.
Використовуйте поля user з обʼєднаних файлів kubeconfig.
Якщо є дві суперечливі техніки, завершіть роботу з помилкою.
Для будь-якої інформації, що все ще відсутня, використовуйте стандартні значення і, можливо, запитайте інформацію для автентифікації.
Посилання на файли
Посилання на файли та шляхи в файлі kubeconfig є відносними до місця розташування файлу kubeconfig. Посилання на файли в командному рядку є відносними до поточної робочої теки. У файлі $HOME/.kube/config відносні шляхи зберігаються як відносні, а абсолютні — як абсолютні.
Проксі
Ви можете налаштувати kubectl на використання проксі для кожного кластера за допомогою proxy-url у вашому файлі kubeconfig, на зразок такого:
Ця сторінка описує відмінності у способах управління ресурсами між Linux та Windows.
На Linux-вузлах використовуються cgroups як межа Podʼа для керування ресурсами. Контейнери створюються всередині цієї межі для ізоляції мережі, процесів та файлової системи. API cgroup для Linux може використовуватися для збору статистики використання CPU, введення/виведення та памʼяті.
Натомість у Windows використовується job object на кожен контейнер з фільтром системного простору імен, щоб обмежити всі процеси в контейнері та забезпечити логічну ізоляцію від хоста. (Обʼєкти завдань є механізмом ізоляції процесів Windows і відрізняються від того, що Kubernetes називає Job).
Не існує можливості запуску контейнера Windows без фільтрації простору імен. Це означає, що системні привілеї не можна отримати в контексті хоста, і, отже, привілейовані контейнери недоступні в Windows. Контейнери не можуть набувати ідентичності хоста, оскільки менеджер облікових записів безпеки (Security Account Manager, SAM) є окремим.
Управління памʼяттю
Windows не має OOM-завершувача процесів (out-of-memory process killer), як у Linux. Windows завжди розглядає всі виділення памʼяті в режимі користувача як віртуальні, і файли підкачки є обовʼязковими.
Вузли Windows не виділяють процесам памʼять понад наявну (overcommit). У підсумку Windows не доходить до стану нестачі памʼяті так, як Linux, і процеси вивантажуються на диск замість завершення через нестачу памʼяті (OOM). Якщо памʼять надмірно виділена і всю фізичну памʼять вичерпано, підкачка може знизити продуктивність.
Управління CPU
Windows може обмежувати кількість часу CPU, виділеного для різних процесів, але не може гарантувати мінімальну кількість часу CPU.
У Windows kubelet підтримує прапорець командного рядка для встановлення пріоритету планування процесу kubelet: --windows-priorityclass. Цей прапорець дозволяє процесу kubelet отримувати більше часових квантів CPU порівняно з іншими процесами, які виконуються на хості Windows. Додаткову інформацію про допустимі значення та їхнє тлумачення можна знайти за посиланням Класи пріоритетів Windows. Щоб гарантувати, що запущені Podʼи не позбавлять kubelet циклів CPU, встановіть цей прапорець у значення ABOVE_NORMAL_PRIORITY_CLASS або вище.
Резервування ресурсів
Щоб врахувати памʼять і CPU, які використовуються операційною системою, середовищем виконання контейнерів і процесами хоста Kubernetes, такими як kubelet, ви можете (і повинні) зарезервувати ресурси памʼяті та CPU за допомогою прапорців kubelet --kube-reserved та/або --system-reserved. У Windows ці значення використовуються лише для розрахунку доступних для розподілу (allocatable) ресурсів вузла.
Увага:
Під час розгортання навантажень встановлюйте обмеження ресурсів памʼяті та CPU для контейнерів. Це також зменшує NodeAllocatable та допомагає загальнокластерному планувальнику визначити, які Podʼи розмістити на яких вузлах.
Планування Podʼів без обмежень може надмірно виділити ресурси на вузлах Windows, і в крайніх випадках може призвести до того, що вузли стануть несправними.
У Windows доброю практикою є резервування принаймні 2GiB памʼяті.
Щоб визначити, скільки CPU резервувати, визначте максимальну щільність Podʼів для кожного вузла та відстежуйте використання CPU системними сервісами, що працюють там, а потім виберіть значення, яке відповідає потребам вашого робочого навантаження.
6.8 - Безпека
Концепції для захисту ваших робочих навантажень cloud native.
Цей розділ документації Kubernetes допоможе вам навчитися запускати робочі навантаження безпечніше й дізнатися про основні аспекти забезпечення безпеки кластера Kubernetes.
Kubernetes базується на архітектурі cloud native і спирається на поради CNCF щодо рекомендованих практик інформаційної безпеки cloud native.
Ширший контекст щодо того, як захистити ваш кластер і застосунки, які ви на ньому запускаєте, дивіться в розділі Безпека cloud native та Kubernetes.
Механізми безпеки Kubernetes
Kubernetes містить кілька API та засобів контролю безпеки, а також способи визначення політик, які можуть бути частиною вашого керування інформаційною безпекою.
Kubernetes очікує, що ви налаштуєте та використовуватимете TLS для шифрування даних під час передавання в межах панелі управління та між панеллю управління і її клієнтами. Ви також можете ввімкнути шифрування даних у стані спокою для даних, що зберігаються в панелі управління Kubernetes; це окремо від шифрування в стані спокою для даних ваших власних робочих навантажень, що також може бути доброю ідеєю.
Secrets
API Secret надає базовий захист для конфіденційних значень конфігурації.
Захист робочих навантажень
Застосовуйте стандарти безпеки Podʼів, щоб Podʼи та їхні контейнери були належно ізольовані. Якщо потрібно, ви також можете використовувати RuntimeClasses для визначення власної ізоляції.
Мережеві політики дозволяють вам контролювати мережевий трафік між Podʼами або між Podʼами та мережею поза вашим кластером.
Ви можете розгортати засоби безпеки з ширшої екосистеми, щоб реалізувати превентивний або детективний контроль для Podʼів, їхніх контейнерів та образів, що в них працюють.
Контроль допуску
Контролери допуску — це втулки, які перехоплюють запити до API Kubernetes і можуть перевіряти або змінювати їх на основі певних полів запиту. Продумане проєктування цих контролерів допомагає уникнути ненавмисних порушень, коли API Kubernetes змінюється з оновленнями версій. Міркування щодо проєктування дивіться в розділі Рекомендації щодо використання вебхуків допуску.
Аудит
Логування аудиту Kubernetes забезпечує важливий для безпеки хронологічний набір записів, що документують послідовність дій у кластері. Кластер проводить аудит дій користувачів, застосунків, які використовують API Kubernetes, і самої панелі управління.
Безпека хмарних провайдерів
Примітка: На цій сторінці є посилання на постачальників, які не належать до Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці сторонні продукти або проєкти. Для додавання постачальника, продукта або проєкта до цього списку, ознайомтеся з настановами щодо вмісту перед додаванням змін. Додаткова інформація.
Якщо ви запускаєте кластер Kubernetes на власному обладнанні або в іншого хмарного провайдера, ознайомтеся з рекомендаціями щодо безпеки у вашій документації. Ось посилання на документацію з безпеки деяких популярних хмарних провайдерів:
Ви можете визначати політики безпеки за допомогою вбудованих механізмів Kubernetes, таких як NetworkPolicy (декларативний контроль фільтрації мережевих пакетів) або ValidatingAdmissionPolicy (декларативні обмеження на те, які зміни можна вносити через API Kubernetes).
Однак ви також можете покладатися на реалізації політик із ширшої екосистеми навколо Kubernetes. Kubernetes надає механізми розширення, завдяки яким проєкти екосистеми можуть реалізовувати власні засоби контролю політик щодо перевірки вихідного коду, схвалення образів контейнерів, контролю доступу до API, мережі тощо.
Докладніше про механізми політик у Kubernetes читайте в розділі Політики.
Концепції захисту ваших робочих навантажень cloud native.
Kubernetes базується на архітектурі cloud native і спирається на поради CNCF щодо рекомендованих практик інформаційної безпеки cloud native.
Нижче наведено огляд того, як Kubernetes допомагає розгорнути безпечну платформу cloud native.
Інформаційна безпека cloud native
У white paper CNCF про безпеку cloud native визначено засоби контролю та практики безпеки для різних фаз життєвого циклу.
Фаза життєвого циклу Розробка
Забезпечте цілісність середовищ розробки.
Проєктуйте застосунки відповідно до рекомендованих практик інформаційної безпеки, що підходять для вашого контексту.
Враховуйте безпеку кінцевого користувача як частину проєктного рішення.
Для цього:
Використовуйте архітектуру, таку як нульова довіра, що мінімізує поверхню атаки навіть для внутрішніх загроз.
Визначте процес перевірки коду, який враховує питання безпеки.
Створіть модель загроз вашої системи або застосунку, яка визначає межі довіри. Використовуйте цю модель, щоб виявляти ризики й визначати, як із ними працювати.
Там, де це виправдано, впроваджуйте передову автоматизацію безпеки, таку як fuzzing та security chaos engineering.
Фаза життєвого циклу Розповсюдження
Забезпечте безпеку ланцюга постачання образів контейнерів, які ви запускаєте.
Забезпечте безпеку ланцюга постачання кластера та інших компонентів, які запускають ваш застосунок. Наприклад, це може бути зовнішня база даних, яку ваш застосунок cloud native використовує для зберігання даних.
Для цього:
Скануйте образи контейнерів та інші артефакти на наявність відомих вразливостей.
Переконайтеся, що розповсюдження програмного забезпечення використовує шифрування під час передавання з ланцюгом довіри до джерела програмного забезпечення.
Запровадьте процеси оновлення залежностей, коли стають доступні оновлення, особливо у відповідь на оголошення про безпеку, і дотримуйтеся їх.
Використовуйте механізми перевірки, такі як цифрові сертифікати, для гарантії безпеки ланцюга постачання.
Підписуйтесь на стрічки (feeds) та інші механізми, щоб отримувати сповіщення про безпекові ризики.
Обмежуйте доступ до артефактів. Розміщуйте образи контейнерів у приватному реєстрі, який дозволяє завантажувати образи лише авторизованим клієнтам.
Фаза життєвого циклу Розгортання
Забезпечте відповідні обмеження на те, що можна розгортати, хто може це робити й куди це можна розгорнути. Ви можете застосовувати заходи з фази розповсюдження, такі як перевірка криптографічної ідентичності артефактів образів контейнерів.
Ви можете розгортати різні застосунки та компоненти кластера в різних просторах імен. Контейнери та простори імен забезпечують механізми ізоляції, що є важливими для інформаційної безпеки.
Під час розгортання Kubernetes ви також закладаєте основу для середовища виконання ваших застосунків: кластер Kubernetes (або кілька кластерів). Ця інфраструктура має забезпечувати гарантії безпеки, яких очікують вищі рівні.
API Kubernetes — це те, завдяки чому працює ваш кластер. Захист цього API є ключовим для ефективної безпеки кластера.
Інші сторінки документації Kubernetes докладніше описують, як налаштувати окремі аспекти контролю доступу. Список перевірки безпеки містить рекомендовані базові перевірки для вашого кластера.
Крім того, захист кластера означає впровадження ефективної автентифікації та авторизації для доступу до API. Використовуйте ServiceAccounts, щоб надавати ідентичності безпеки робочим навантаженням і компонентам кластера та керувати ними.
Kubernetes використовує TLS для захисту трафіку API; переконайтеся, що кластер розгорнуто з TLS (зокрема для трафіку між вузлами та панеллю управління), і захистіть ключі шифрування. Якщо ви використовуєте власний API Kubernetes для CertificateSigningRequests, приділіть особливу увагу обмеженню зловживань ним.
Захист під час виконання: обчислення
Контейнери забезпечують дві речі: ізоляцію між застосунками та механізм обʼєднання цих ізольованих застосунків для роботи на одному хост-компʼютері. Ці два аспекти — ізоляція та агрегація — означають, що безпека під час виконання передбачає пошук компромісів і відповідного балансу.
Kubernetes покладається на середовище виконання контейнерів для налаштування та запуску контейнерів. Проєкт Kubernetes не рекомендує конкретне середовище виконання контейнерів, і вам слід переконатися, що вибране середовище відповідає вашим потребам в інформаційній безпеці.
Для захисту обчислень під час виконання ви можете:
Застосовувати до застосунків стандарти безпеки Podʼів, щоб вони працювали лише з потрібними привілеями.
Запускати на вузлах спеціалізовану операційну систему, призначену саме для контейнеризованих робочих навантажень. Зазвичай вона базується на операційній системі лише для читання (незмінний образ), яка надає тільки сервіси, необхідні для запуску контейнерів.
Операційні системи для контейнерів допомагають ізолювати системні компоненти та зменшують поверхню атаки в разі виходу за межі контейнера.
Визначати ResourceQuotas для справедливого розподілу спільних ресурсів і використовувати механізми, такі як LimitRanges, щоб Podʼи вказували свої вимоги до ресурсів.
Розподіляти робочі навантаження між різними вузлами для кращої ізоляції. Використовувати механізми ізоляції вузлів із самого Kubernetes або з екосистеми, щоб Podʼи з різними контекстами довіри працювали на окремих наборах вузлів.
Захистіть стійкість даних за допомогою резервних копій і перевіряйте, що можете відновити їх, коли це потрібно.
Автентифікуйте зʼєднання між вузлами кластера та будь-яким мережевим сховищем, на яке вони спираються.
Впровадьте шифрування даних у межах вашого власного застосунку.
Генерація ключів шифрування на спеціалізованому обладнанні забезпечує найкращий захист від ризиків розголошення. Апаратний модуль безпеки дозволяє виконувати криптографічні операції без можливості копіювання ключа безпеки в інше місце.
Мережа та безпека
Також варто врахувати заходи мережевої безпеки, такі як NetworkPolicy або service mesh. Деякі мережеві втулки для Kubernetes шифрують мережу кластера за допомогою таких технологій, як оверлей віртуальної приватної мережі (VPN). За задумом Kubernetes дозволяє використовувати власний мережевий втулок для кластера. Якщо ви використовуєте керований Kubernetes, провайдер міг уже вибрати мережевий втулок за вас.
Мережевий втулок, який ви виберете, і спосіб його інтеграції можуть суттєво вплинути на безпеку інформації під час передавання.
Спостережуваність та безпека виконання
Kubernetes дозволяє розширювати кластер додатковими інструментами. Ви можете налаштувати сторонні рішення для моніторингу або усунення несправностей ваших застосунків і кластерів, у яких вони працюють. Ви також отримуєте деякі базові можливості спостережуваності, вбудовані в сам Kubernetes. Ваш код у контейнерах може генерувати логи, публікувати метрики або надавати інші дані спостережуваності; під час розгортання потрібно переконатися, що ваш кластер забезпечує для них відповідний рівень захисту.
Якщо ви налаштовуєте dashboard метрик або щось подібне, перегляньте ланцюжок компонентів, які передають дані до цього dashboard, а також сам dashboard. Переконайтеся, що весь ланцюжок має достатню стійкість і захист цілісності, щоб на нього можна було покластися навіть під час інциденту, коли робота вашого кластера може погіршитися.
За потреби розгортайте заходи безпеки нижче рівня Kubernetes, такі як криптографічно вимірюване завантаження або автентифікований розподіл часу (що допомагає забезпечити точність логів і записів аудиту).
Для середовищ із високим рівнем гарантій розгортайте криптографічний захист, щоб логи були захищені від підробки й конфіденційні.
Докладний огляд різних рівнів політики, визначених у стандартах безпеки Podʼів.
Стандарти безпеки Podʼів визначають три різні політики, щоб широко охопити спектр безпеки. Ці політики є кумулятивними й охоплюють діапазон від дуже дозвільних до дуже обмежувальних. У цьому посібнику наведено вимоги кожної політики.
Профіль
Опис
Privileged
Необмежена політика, яка забезпечує найширший можливий рівень дозволів. Ця політика дозволяє відомі підвищення привілеїв.
Baseline
Мінімально обмежувальна політика, яка запобігає відомим підвищенням привілеїв. Дозволяє стандартну (мінімально визначену) конфігурацію Podʼа.
Restricted
Дуже обмежувальна політика, що відповідає поточним рекомендаціям зі зміцнення Podʼів.
Докладно про профілі
Privileged
Політика Privileged навмисно відкрита й повністю необмежена. Цей тип політики зазвичай призначений для робочих навантажень системного та інфраструктурного рівня, якими керують привілейовані, довірені користувачі.
Політика Privileged визначається відсутністю обмежень. Якщо ви визначаєте Pod, до якого застосовується політика безпеки Privileged, цей Pod може обходити типові механізми ізоляції контейнерів. Наприклад, ви можете визначити Pod, який має доступ до мережі хоста вузла.
Baseline
Політика Baseline спрямована на легке впровадження для поширених контейнеризованих робочих навантажень із запобіганням відомим підвищенням привілеїв. Ця політика призначена для операторів застосунків і розробників некритичних застосунків. Наведені нижче засоби контролю слід застосовувати або забороняти:
Примітка:
У цій таблиці символи підстановки (*) позначають усі елементи списку. Наприклад, spec.containers[*].securityContext стосується обʼєкта контексту безпеки для усіх визначених контейнерів. Якщо будь-який із перелічених контейнерів не відповідає вимогам, весь Pod не пройде перевірку.
Специфікація політики Baseline
Засіб контролю
Політика
HostProcess
Podʼи Windows дають змогу запускати контейнери HostProcess, що надають привілейований доступ до хост-машини Windows. Привілейований доступ до хоста заборонено в політиці Baseline.
На підтримуваних хостах стандартно застосовується профіль AppArmor RuntimeDefault. Політика Baseline має запобігати перевизначенню або вимкненню стандартного профілю AppArmor чи обмежувати перевизначення дозволеним набором профілів.
Sysctls можуть вимикати механізми безпеки або впливати на всі контейнери на хості, тому їх слід заборонити, крім дозволеної «безпечної» підмножини. Sysctl вважається безпечним, якщо він обмежений простором імен контейнера або Podʼа й ізольований від інших Podʼів або процесів на тому самому вузлі.
Обмежені поля
spec.securityContext.sysctls[*].name
Дозволені значення
Undefined/nil
kernel.shm_rmid_forced
net.ipv4.ip_local_port_range
net.ipv4.ip_unprivileged_port_start
net.ipv4.tcp_syncookies
net.ipv4.ping_group_range
net.ipv4.ip_local_reserved_ports (з Kubernetes 1.27)
net.ipv4.tcp_keepalive_time (з Kubernetes 1.29)
net.ipv4.tcp_fin_timeout (з Kubernetes 1.29)
net.ipv4.tcp_keepalive_intvl (з Kubernetes 1.29)
net.ipv4.tcp_keepalive_probes (з Kubernetes 1.29)
net.ipv4.tcp_rmem (з Kubernetes 1.32)
net.ipv4.tcp_wmem (з Kubernetes 1.32)
net.ipv4.tcp_slow_start_after_idle (з Kubernetes 1.37)
net.ipv4.tcp_notsent_lowat (з Kubernetes 1.37)
Restricted
Політика Restricted спрямована на застосування поточних рекомендацій зі зміцнення Podʼів ціною певної втрати сумісності. Вона призначена для операторів і розробників критичних для безпеки застосунків, а також для користувачів із нижчим рівнем довіри. Наведені нижче засоби контролю слід застосовувати або забороняти:
Примітка:
У цій таблиці символи підстановки (*) позначають усі елементи списку. Наприклад, spec.containers[*].securityContext стосується обʼєкта контексту безпеки для усіх визначених контейнерів. Якщо будь-який із перелічених контейнерів не відповідає вимогам, весь Pod не пройде перевірку.
Специфікація політики Restricted
Засіб контролю
Політика
Усе з політики Baseline
Типи томів
Політика Restricted дозволяє лише такі типи томів.
Обмежені поля
spec.volumes[*]
Дозволені значення
Кожен елемент списку spec.volumes[*] повинен встановлювати одне з наведених нижче полів у значення, відмінне від null:
spec.volumes[*].configMap
spec.volumes[*].csi
spec.volumes[*].downwardAPI
spec.volumes[*].emptyDir
spec.volumes[*].ephemeral
spec.volumes[*].persistentVolumeClaim
spec.volumes[*].projected
spec.volumes[*].secret
Підвищення привілеїв (v1.8+)
Підвищення привілеїв (наприклад, через режим файлів set-user-ID або set-group-ID) не слід дозволяти. Це політика лише для Linux у v1.25+ (spec.os.name != windows)
Профіль Seccomp має бути явно встановлений в одне з дозволених значень. Заборонено як профіль Unconfined, так і відсутність профілю. Це політика лише для Linux у v1.25+ (spec.os.name != windows)
Поля контейнера можуть бути undefined/nil, якщо на рівні Podʼа spec.securityContext.seccompProfile.type встановлено відповідне значення. Навпаки, поле на рівні Podʼа може бути undefined/nil, якщо встановлено _всі_ поля на рівні контейнера.
Capabilities (v1.22+)
Контейнери повинні скидати всі capabilities (ALL), і їм дозволено додавати назад лише capability NET_BIND_SERVICE. Це політика лише для Linux у v1.25+ (.spec.os.name != "windows")
Відокремлення визначення політики від її втілення дає змогу мати спільне розуміння й узгоджену мову політик у всіх кластерах незалежно від базового механізму застосування.
Коли механізми стануть зрілішими, їх буде описано нижче окремо для кожної політики. Способи застосування окремих політик тут не визначено.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Інші альтернативи застосування політик розробляються в екосистемі Kubernetes, зокрема:
Kubernetes дозволяє використовувати вузли, що працюють під керуванням Linux або Windows. Ви можете поєднувати обидва типи вузлів в одному кластері. Windows у Kubernetes має певні обмеження й відмінності від робочих навантажень на базі Linux. Зокрема, багато полів securityContext Podʼа не діють у Windows.
Примітка:
kubelet версій до v1.24 не застосовує поле OS Podʼа, і якщо в кластері є вузли з версіями до v1.24, політики Restricted слід закріпити на версії до v1.25.
Зміни в стандарті безпеки Podʼів Restricted
Ще одна важлива зміна, внесена в Kubernetes v1.25, полягає в тому, що політику Restricted оновлено для використання поля pod.spec.os.name. Залежно від назви ОС певні політики, специфічні для конкретної ОС, можна послабити для іншої ОС.
Засоби контролю політики, специфічні для ОС
Обмеження на наведені нижче засоби контролю потрібні лише тоді, коли .spec.os.name не дорівнює windows:
Підвищення привілеїв
Seccomp
Linux Capabilities
Простори імен користувачів
Простори імен користувачів — це можливість лише для Linux, що дозволяє запускати робочі навантаження з підвищеною ізоляцією. Як вони працюють разом зі стандартами безпеки Podʼів, описано в документації для Podʼів, що використовують простори імен користувачів.
ЧаП
Чому немає профілю між Privileged та Baseline?
Три визначені тут профілі мають чітку лінійну прогресію від найбезпечнішого (Restricted) до найменш безпечного (Privileged) і охоплюють широкий набір робочих навантажень. Привілеї, потрібні понад політику Baseline, зазвичай дуже специфічні для застосунку, тому ми не пропонуємо стандартного профілю в цій ніші. Це не означає, що в такому разі завжди слід використовувати профіль Privileged, але політики в цій області потрібно визначати окремо для кожного випадку.
SIG Auth може переглянути цю позицію в майбутньому, якщо зʼявиться чітка потреба в інших профілях.
У чому різниця між профілем безпеки та контекстом безпеки?
Контексти безпеки налаштовують Podʼи та контейнери під час виконання. Контексти безпеки визначаються як частина специфікацій Podʼа й контейнера в маніфесті Podʼа та є параметрами для середовища виконання контейнерів.
Профілі безпеки — це механізми панелі управління для застосування певних налаштувань у контексті безпеки, а також інших повʼязаних параметрів поза контекстом безпеки. Станом на липень 2021 року політики безпеки Podʼів визнано застарілими на користь вбудованого контролера Pod Security Admission.
А як щодо Podʼів у пісочниці?
Наразі немає стандарту API, який визначає, чи вважається Pod ізольованим у пісочниці. Podʼи в пісочниці можна визначити за використанням середовища виконання в пісочниці (такого як gVisor або Kata Containers), але стандартного визначення такого середовища немає.
Захист, потрібний робочим навантаженням у пісочниці, може відрізнятися від інших. Наприклад, потреба обмежувати привілейовані дозволи менша, коли робоче навантаження ізольоване від базового ядра. Це дозволяє ізолювати робочі навантаження, яким потрібні підвищені дозволи.
Крім того, захист робочих навантажень у пісочниці значною мірою залежить від методу ізоляції в пісочниці. Тому немає єдиного профілю, рекомендованого для всіх робочих навантажень у пісочниці.
6.8.3 - Pod Security Admission
Огляд контролера Pod Security Admission, який може застосовувати стандарти безпеки Podʼів.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.25
Стандарти безпеки Podʼів Kubernetes визначають різні рівні ізоляції для Podʼів. Ці стандарти дозволяють чітко й послідовно визначити, як ви хочете обмежувати поведінку Podʼів.
Kubernetes пропонує вбудований контролер допускуPod Security для застосування стандартів безпеки Podʼів. Обмеження безпеки Podʼів застосовуються на рівні простору імен під час створення Podʼів.
Вбудоване застосування Pod Security admission
Ця сторінка є частиною документації Kubernetes v1.37. Якщо ви використовуєте іншу версію Kubernetes, перегляньте документацію для цієї версії.
Після ввімкнення можливості або встановлення вебхука ви можете налаштувати простори імен, щоб визначити режим контролю допуску, який використовуватиметься для безпеки Podʼів у кожному просторі імен. Kubernetes визначає набір міток, які можна встановити, щоб вибрати попередньо визначений рівень стандарту безпеки Podʼів для простору імен. Вибрана мітка визначає, яку дію виконає панель управління, якщо виявлено потенційне порушення:
Режими Pod Security Admission
Режим
Опис
enforce
Порушення політики призводить до відхилення Podʼа.
audit
Порушення політики спричиняє додавання анотації аудиту до події, записаної в лог аудиту, але в іншому Pod дозволяється.
warn
Порушення політики спричиняє попередження для користувача, але в іншому Pod дозволяється.
Простір імен може налаштувати будь-який або всі режими, або навіть встановити різний рівень для різних режимів.
Для кожного режиму існують дві мітки, які визначають використовувану політику:
# Мітка рівня режиму вказує, який рівень політики застосовується для режиму.## РЕЖИМ повинен бути одним з `enforce`, `audit` або `warn`.# РІВЕНЬ повинен бути одним з `privileged`, `baseline` або `restricted`.pod-security.kubernetes.io/<РЕЖИМ>:<РІВЕНЬ># Необовʼязково: мітка версії режиму, яку можна використовувати для привʼязки політики до# версії, що поставляється з певною мінорною версією Kubernetes (наприклад, v1.37).## РЕЖИМ повинен бути одним з `enforce`, `audit` або `warn`.# ВЕРСІЯ повинна бути дійсною мінорною версією Kubernetes або `latest`.pod-security.kubernetes.io/<РЕЖИМ>-version:<ВЕРСІЯ>
Podʼи часто створюються опосередковано, через створення обʼєкта робочого навантаження, такого як Deployment або Job. Обʼєкт робочого навантаження визначає шаблон Podʼа, а контролер ресурсу робочого навантаження створює Podʼи на основі цього шаблону. Щоб вчасно виявляти порушення, режими audit та warn застосовуються до ресурсів робочих навантажень. Однак режим enforce не застосовується до ресурсів робочих навантажень, а лише до створених обʼєктів Pod.
Винятки
Ви можете визначити винятки із застосування безпеки Podʼів, щоб дозволити створення Podʼів, які інакше були б заборонені політикою відповідного простору імен. Винятки можна статично налаштувати в конфігурації контролера допуску.
Винятки мають бути явно перелічені. Запити, що відповідають критеріям винятків, контролер допуску ігнорує (уся поведінка enforce, audit та warn пропускається). Виміри винятків:
Usernames: запити від користувачів з автентифікованим (або імперсонованим) іменем, внесеним до винятків, ігноруються.
RuntimeClassNames: Podʼи та ресурси робочих навантажень, що вказують назву класу виконання, внесену до винятків, ігноруються.
Більшість Podʼів створює контролер у відповідь на ресурс робочого навантаження, тому виняток для кінцевого користувача звільнить його від застосування політики лише під час безпосереднього створення Podʼів, але не під час створення ресурсу робочого навантаження. ServiceAccount контролерів (наприклад, system:serviceaccount:kube-system:replicaset-controller) зазвичай не слід вносити до винятків, оскільки це неявно звільнить будь-якого користувача, який може створити відповідний ресурс робочого навантаження.
Оновлення таких полів Podʼа звільнені від перевірок політики, тобто якщо запит на оновлення Podʼа змінює лише ці поля, його не буде відхилено, навіть якщо Pod порушує поточний рівень політики:
Будь-які оновлення метаданих, крім змін анотацій seccomp або AppArmor:
pod_security_errors_total: Ця метрика показує кількість помилок, що перешкоджають звичайному оцінюванню. Нефатальні помилки можуть призвести до застосування останнього профілю restricted.
pod_security_evaluations_total: Ця метрика показує кількість виконаних оцінювань політики, не враховуючи проігноровані запити або запити-винятки під час експорту.
pod_security_exemptions_total: Ця метрика показує кількість запитів-винятків, не враховуючи проігноровані запити або запити поза областю дії.
Дізнайтеся про обʼєкти ServiceAccount в Kubernetes.
На цій сторінці описано обʼєкт ServiceAccount у Kubernetes: як працюють ServiceAccount, сценарії використання, обмеження, альтернативи та посилання на ресурси з додатковими настановами.
Що таке ServiceAccount?
ServiceAccount — це тип облікового запису не для людей, який у Kubernetes надає окрему ідентичність у кластері. Podʼи застосунків, системні компоненти та сутності всередині й поза кластером можуть використовувати облікові дані певного ServiceAccount, щоб ідентифікуватися як цей ServiceAccount. Така ідентичність корисна в різних ситуаціях, зокрема для автентифікації на API-сервері або реалізації політик безпеки на основі ідентичності.
ServiceAccount існують як обʼєкти ServiceAccount на API-сервері. Вони мають такі властивості:
Привʼязані до простору імен: Кожен ServiceAccount привʼязаний до простору імен Kubernetes. Кожен простір імен під час створення отримує ServiceAccount default.
Легкі: ServiceAccount існують у кластері й визначені в API Kubernetes. Ви можете швидко створювати ServiceAccount для виконання певних завдань.
Переносні: Набір конфігурацій для складного контейнеризованого робочого навантаження може містити визначення ServiceAccount для компонентів системи. Легкість ServiceAccount та ідентичності в межах простору імен роблять конфігурації переносними.
ServiceAccount відрізняються від облікових записів користувачів, які є автентифікованими людьми в кластері. Стандартно облікові записи користувачів не існують на API-сервері Kubernetes; натомість API-сервер розглядає ідентичності користувачів як непрозорі дані. Автентифікуватися як обліковий запис користувача можна кількома способами. Деякі дистрибутиви Kubernetes можуть додавати власні API розширення для представлення облікових записів користувачів на API-сервері.
RBAC Kubernetes або інші механізми керування ідентичністю та доступом
Призначення
Робочі навантаження, автоматизація
Люди
Стандартні ServiceAccount
Під час створення кластера Kubernetes автоматично створює обʼєкт ServiceAccount з назвою default для кожного простору імен у вашому кластері. ServiceAccount default у кожному просторі імен стандартно не мають дозволів, окрім стандартних дозволів на виявлення API, які Kubernetes надає всім автентифікованим субʼєктам, якщо ввімкнено контроль доступу на основі ролей (RBAC). Якщо ви видалите обʼєкт ServiceAccount default у просторі імен, панель управління замінить його новим.
Загалом ви можете використовувати ServiceAccount для надання ідентичностей у таких сценаріях:
Вашим Podʼам потрібно взаємодіяти з API-сервером Kubernetes, наприклад у таких ситуаціях:
Надання доступу лише для читання до конфіденційної інформації, що зберігається в Secrets.
Надання доступу між просторами імен, наприклад дозвіл Podʼу в просторі імен example читати, перелічувати й відстежувати обʼєкти Lease у просторі імен kube-node-lease.
Вашим Podʼам потрібно взаємодіяти із зовнішнім сервісом. Наприклад, Pod робочого навантаження потребує ідентичності для комерційного хмарного API, а комерційний постачальник дозволяє налаштувати відповідні довірчі стосунки.
Зовнішньому сервісу потрібно взаємодіяти з API-сервером Kubernetes. Наприклад, автентифікація в кластері як частина конвеєра CI/CD.
Ви використовуєте у своєму кластері стороннє програмне забезпечення безпеки, яке покладається на ідентичність ServiceAccount різних Podʼів, щоб групувати ці Podʼи в різні контексти.
Як використовувати ServiceAccount
Щоб скористатися ServiceAccount у Kubernetes, виконайте такі дії:
Створіть обʼєкт ServiceAccount за допомогою клієнта Kubernetes, такого як kubectl, або за допомогою маніфесту, який визначає обʼєкт.
Надайте дозволи обʼєкту ServiceAccount за допомогою механізму авторизації, такого як RBAC.
Призначте обʼєкт ServiceAccount Podʼам під час створення Podʼа.
Якщо ви використовуєте ідентичність із зовнішнього сервісу, отримайте токен ServiceAccount і використовуйте його з цього сервісу.
Ви можете використовувати вбудований у Kubernetes механізм контролю доступу на основі ролей (RBAC), щоб надавати кожному ServiceAccount мінімально потрібні дозволи. Ви створюєте роль, яка надає доступ, а потім привʼязуєте її до свого ServiceAccount. RBAC дозволяє визначити мінімальний набір дозволів, щоб дозволи ServiceAccount відповідали принципу найменших привілеїв. Podʼи, що використовують цей ServiceAccount, не отримують більше дозволів, ніж потрібно для правильної роботи.
Доступ між просторами імен за допомогою ServiceAccount
За допомогою RBAC можна дозволити ServiceAccount в одному просторі імен виконувати дії з ресурсами в іншому просторі імен кластера. Наприклад, у вас є ServiceAccount і Pod у просторі імен dev, і ви хочете, щоб ваш Pod бачив Jobs, що виконуються в просторі імен maintenance. Ви можете створити обʼєкт Role, який надає дозволи на перелік обʼєктів Job. Потім створіть обʼєкт RoleBinding у просторі імен maintenance, щоб привʼязати Role до обʼєкта ServiceAccount. Тепер Podʼи у просторі імен dev можуть отримувати перелік обʼєктів Job у просторі імен maintenance, використовуючи цей ServiceAccount.
Призначення ServiceAccount Podʼу
Щоб призначити ServiceAccount Podʼу, встановіть поле spec.serviceAccountName у специфікації Podʼа. Після цього Kubernetes автоматично надає Podʼу облікові дані цього ServiceAccount. У v1.22 і новіших Kubernetes отримує короткостроковий токен з автоматичною ротацією через API TokenRequest і монтує його як проєкційний том.
Стандартно Kubernetes надає Podʼу облікові дані призначеного ServiceAccount, будь то ServiceAccount default чи вказаний вами власний ServiceAccount.
Щоб Kubernetes не додавав автоматично облікові дані вказаного ServiceAccount або ServiceAccount default, встановіть поле automountServiceAccountToken у специфікації Podʼа в false.
У версіях до 1.22 Kubernetes надає Podʼу довгостроковий статичний токен як Secret.
Отримання облікових даних ServiceAccount вручну
Якщо облікові дані ServiceAccount потрібно змонтувати в нестандартне місце або вони потрібні для аудиторії, відмінної від API-сервера, скористайтеся одним із таких методів:
TokenRequest API (рекомендовано): Запитуйте короткостроковий токен ServiceAccount безпосередньо з коду вашого застосунку. Строк дії токена спливає автоматично, і після цього токен можна ротувати. Якщо у вас є застарілий застосунок, який не знає про Kubernetes, ви можете використати sidecar-контейнер у тому самому Podʼі, щоб отримувати ці токени й надавати їх робочому навантаженню застосунку.
Token Volume Projection (також рекомендовано): У Kubernetes v1.20 і новіших вкажіть у специфікації Podʼа, щоб kubelet додав токен ServiceAccount до Podʼа як проєкційний том. Строк дії спроєцьованих токенів спливає автоматично, а kubelet ротує токен до завершення строку дії.
Service Account Token Secrets (не рекомендовано): Ви можете монтувати токени ServiceAccount як Secrets Kubernetes у Podʼах. Ці токени не мають строку дії й не ротуються. У версіях до v1.24 для кожного ServiceAccount автоматично створювався постійний токен. Цей метод більше не рекомендується, особливо у великому масштабі, через ризики, повʼязані зі статичними довгостроковими обліковими даними. Функціональна можливість LegacyServiceAccountTokenNoAutoGeneration (стандартно ввімкнена в Kubernetes з v1.24 до v1.26) не давала Kubernetes автоматично створювати ці токени для ServiceAccount. Її вилучено у v1.27, оскільки вона перейшла на стадію GA; ви все ще можете вручну створювати безстрокові токени ServiceAccount, але маєте враховувати наслідки для безпеки.
Обмеження аудиторій вузлів для токенів ServiceAccount
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.33; (стандартно увімкнено)
Коли ввімкнено функціональну можливість ServiceAccountNodeAudienceRestriction, втулок допуску NodeRestriction обмежує аудиторії, які kubelet може запитувати під час створення токенів ServiceAccount через API TokenRequest. Стандартно kubelet може запитувати токени лише для аудиторій, на які вже посилаються Podʼи на цьому вузлі (через проєкційні томи токенів ServiceAccount або запити токенів драйвера CSI). Адміністратори можуть надати kubelet доступ до додаткових аудиторій за допомогою правил RBAC із дієсловом request-serviceaccounts-token-audience.
Це обмеження застосовується лише до kubelet (ідентичностей вузлів) і не впливає на інших клієнтів API TokenRequest. Подробиці та приклади RBAC дивіться в розділі Обмеження аудиторії токенів ServiceAccount.
Примітка:
Для застосунків, що працюють поза вашим кластером Kubernetes, ви можете розглядати створення довгострокового токена ServiceAccount, який зберігається в Secret. Це дозволяє автентифікацію, але проєкт Kubernetes рекомендує уникати такого підходу. Довгострокові токени-предʼявники є ризиком для безпеки, оскільки після розкриття токен можна використати зловмисно. Натомість розгляньте альтернативу. Наприклад, ваш зовнішній застосунок може автентифікуватися за допомогою добре захищеного приватного ключа та сертифіката або власного механізму, такого як вебхук автентифікації, який ви реалізуєте самостійно.
Ви також можете використовувати TokenRequest для отримання короткострокових токенів для вашого зовнішнього застосунку.
Обмеження доступу до Secrets (застаріло)
СТАН ФУНКЦІОНАЛУ:Deprecated since Kubernetes v1.32
Примітка:
kubernetes.io/enforce-mountable-secrets застаріло, починаючи з Kubernetes v1.32. Використовуйте окремі простори імен, щоб ізолювати доступ до змонтованих Secrets.
Kubernetes надає анотацію kubernetes.io/enforce-mountable-secrets, яку можна додати до ваших ServiceAccounts. Коли цю анотацію застосовано, Secrets цього ServiceAccount можна монтувати лише на вказані типи ресурсів, що покращує безпеку кластера.
Ви можете додати анотацію до ServiceAccount за допомогою маніфесту:
Коли цю анотацію встановлено в "true", панель управління Kubernetes гарантує, що на Secrets цього ServiceAccount поширюються певні обмеження монтування.
Назва кожного Secret, змонтованого як том у Podʼі, має бути в полі secrets ServiceAccount цього Podʼа.
Назва кожного Secret, на який посилається envFrom у Podʼі, також має бути в полі secrets ServiceAccount цього Podʼа.
Назва кожного Secret, на який посилається imagePullSecrets у Podʼі, також має бути в полі secrets ServiceAccount цього Podʼа.
Розуміючи та застосовуючи ці обмеження, адміністратори кластера можуть посилити захист і забезпечити доступ до Secrets лише для відповідних ресурсів.
Автентифікація облікових даних ServiceAccount
ServiceAccounts використовують підписані JSON Web Tokens (JWT) для автентифікації на API-сервері Kubernetes та в будь-якій іншій системі, де є довірчі стосунки. Залежно від того, як видано токен (обмежений у часі через TokenRequest чи застарілим механізмом із Secret), токен ServiceAccount може також мати час завершення дії, аудиторію та час, з якого токен починає діяти. Коли клієнт, що діє як ServiceAccount, звертається до API-сервера Kubernetes, він додає до HTTP-запиту заголовок Authorization: Bearer <token>. API-сервер перевіряє чинність цього токена так:
Перевіряє підпис токена.
Перевіряє, чи не закінчився строк дії токена.
Перевіряє, чи чинні наразі посилання на обʼєкти в твердженнях токена.
Перевіряє, чи чинний наразі токен.
Перевіряє твердження про аудиторію.
TokenRequest API створює привʼязані токени для ServiceAccount. Ця привʼязка повʼязана з часом життя клієнта, такого як Pod, що діє як цей ServiceAccount. Приклад схеми JWT та вмісту привʼязаного токена ServiceAccount Podʼа дивіться в розділі Token Volume Projection.
Для токенів, виданих через API TokenRequest, API-сервер також перевіряє, що обʼєкт, який використовує ServiceAccount, все ще існує, зіставляючи його за унікальним ідентифікатором. Для застарілих токенів, змонтованих як Secrets у Podʼах, API-сервер звіряє токен із Secret.
Докладніше про процес автентифікації дивіться в розділі Автентифікація.
Автентифікація облікових даних ServiceAccount у власному коді
Якщо у вас є власні сервіси, яким потрібно перевіряти облікові дані ServiceAccount Kubernetes, можна скористатися такими методами:
Проєкт Kubernetes рекомендує використовувати TokenReview API, оскільки цей метод анулює токени, привʼязані до обʼєктів API, таких як Secrets, ServiceAccounts, Podʼи або вузли, коли ці обʼєкти видаляються. Наприклад, якщо ви видалите Pod, що містить спроєцьований токен ServiceAccount, кластер негайно анулює цей токен, і TokenReview одразу завершиться невдачею. Якщо натомість використовувати перевірку OIDC, ваші клієнти й надалі вважатимуть токен дійсним, доки не настане час завершення його дії.
Ваш застосунок завжди має визначати аудиторію, яку він приймає, і перевіряти, що аудиторії токена відповідають очікуваним. Це допомагає звузити область дії токена, щоб його можна було використовувати лише у вашому застосунку й ніде більше.
Альтернативи
Видавайте власні токени за допомогою іншого механізму, а потім використовуйте автентифікацію за токеном через вебхук, щоб перевіряти токени-предʼявники власним сервісом перевірки.
Використовуйте ServiceAccount або облікові записи користувачів, створені у зовнішньому сервісі керування ідентичністю та доступом (IAM), наприклад у хмарного провайдера, для автентифікації у вашому кластері.
Використовуйте втулок пристроїв, щоб отримати доступ до віртуального Trusted Platform Module (TPM), який дозволяє автентифікуватися за допомогою приватного ключа.
Якщо ви не використовуєте Kubernetes v1.37, перевірте документацію для вашої версії Kubernetes.
6.8.6 - Безпека для вузлів Linux
На цій сторінці описано міркування щодо безпеки та рекомендації, специфічні для операційної системи Linux.
Захист даних Secret на вузлах
На вузлах Linux томи в памʼяті (наприклад, монтування томів secret або emptyDir з medium: Memory) реалізовано за допомогою файлової системи tmpfs.
Якщо у вас налаштовано своп і ви використовуєте старе ядро Linux (або поточне ядро та непідтримувану конфігурацію Kubernetes), дані з томів у памʼяті можуть записуватися в постійне сховище.
Ядро Linux офіційно підтримує параметр noswap з версії 6.3, тому, якщо на вузлі ввімкнено своп, рекомендується використовувати ядро версії 6.3 або новіше чи ядро з підтримкою параметра noswap через бекпорт.
На цій сторінці описано міркування щодо безпеки та рекомендації, специфічні для операційної системи Windows.
Захист даних Secret на вузлах
У Windows дані з Secrets записуються у відкритому вигляді в локальне сховище вузла (на відміну від tmpfs / файлових систем у памʼяті в Linux). Як оператору кластера вам слід вжити обох наведених нижче додаткових заходів:
Використовуйте ACL файлів, щоб захистити розташування файлів Secrets.
Застосовуйте шифрування на рівні тому за допомогою BitLocker.
Користувачі контейнерів
RunAsUsername можна вказати для Podʼів або контейнерів Windows, щоб виконувати процеси контейнера від імені конкретного користувача. Це приблизний еквівалент RunAsUser.
Контейнери Windows мають два стандартні облікові записи користувачів: ContainerUser та ContainerAdministrator. Різницю між цими обліковими записами описано в розділі When to use ContainerAdmin and ContainerUser user accounts документації Microsoft Secure Windows containers.
Локальних користувачів можна додавати до образів контейнерів під час їх збирання.
Примітка:
Образи на основі Nano Server стандартно запускаються як ContainerUser
Образи на основі Server Core стандартно запускаються як ContainerAdministrator
Специфічні для Linux механізми контексту безпеки Podʼів (такі як SELinux, AppArmor, Seccomp або власні POSIX capabilities) не підтримуються на вузлах Windows.
Привілейовані контейнери не підтримуються у Windows. Натомість у Windows можна використовувати контейнери HostProcess для виконання багатьох завдань, які в Linux виконують привілейовані контейнери.
6.8.8 - Контроль доступу до API Kubernetes
На цій сторінці наведено огляд контролю доступу до API Kubernetes.
Користувачі отримують доступ до API Kubernetes за допомогою kubectl, клієнтських бібліотек або запитів REST. Авторизувати доступ до API можна як для людей, так і для ServiceAccount Kubernetes. Коли запит досягає API, він проходить кілька етапів, показаних на цій схемі:
Транспортна безпека
Стандартно API-сервер Kubernetes прослуховує порт 6443 на першому мережевому інтерфейсі, відмінному від localhost, із захистом TLS. У типовому промисловому кластері Kubernetes API працює на порту 443. Порт можна змінити за допомогою прапорця --secure-port, а IP-адресу прослуховування — за допомогою прапорця --bind-address.
API-сервер надає сертифікат. Цей сертифікат може бути підписаний приватним центром сертифікації (CA) або базуватися на інфраструктурі відкритих ключів, повʼязаній із загальновизнаним CA. Сертифікат і відповідний приватний ключ можна задати за допомогою прапорців --tls-cert-file та --tls-private-key-file.
Якщо ваш кластер використовує приватний центр сертифікації, вам потрібна копія сертифіката цього CA, налаштована у вашому ~/.kube/config на клієнті, щоб ви могли довіряти зʼєднанню та бути впевненими, що його не було перехоплено.
На цьому етапі ваш клієнт може надати клієнтський сертифікат TLS.
Автентифікація
Після встановлення TLS HTTP-запит переходить до кроку автентифікації. На схемі це крок 1. Сценарій створення кластера або адміністратор кластера налаштовує API-сервер на використання одного або кількох модулів автентифікації. Автентифікатори докладніше описані в розділі Автентифікація.
Вхідними даними для кроку автентифікації є весь HTTP-запит; однак зазвичай перевіряються заголовки та/або клієнтський сертифікат.
Модулі автентифікації охоплюють клієнтські сертифікати, паролі та прості токени, токени bootstrap і JSON Web Tokens (використовуються для ServiceAccount).
Можна вказати кілька модулів автентифікації; у такому разі кожен із них пробується послідовно, доки один не спрацює успішно.
Якщо запит не може бути автентифікований, його буде відхилено з кодом статусу HTTP 401. В іншому разі користувач автентифікується як конкретний username, і це імʼя користувача доступне наступним крокам для прийняття рішень. Деякі автентифікатори також надають членство користувача в групах, а інші ні.
Хоча Kubernetes використовує імена користувачів для рішень щодо контролю доступу та в логах запитів, він не має обʼєкта User і не зберігає імена користувачів чи іншу інформацію про них у своєму API.
Авторизація
Після того як запит автентифіковано як такий, що надійшов від певного користувача, його потрібно авторизувати. На схемі це крок 2.
Запит має містити імʼя користувача, який його надсилає, запитану дію та обʼєкт, якого стосується дія. Запит авторизується, якщо наявна політика визначає, що користувач має дозвіл на виконання запитаної дії.
Наприклад, якщо у Боба є наведена нижче політика, він може читати Podʼи лише у просторі імен projectCaribou:
Якщо Боб зробить запит на запис (create або update) обʼєктів у просторі імен projectCaribou, йому буде відмовлено в авторизації. Якщо Боб зробить запит на читання (get) обʼєктів в іншому просторі імен, наприклад projectFish, йому також буде відмовлено в авторизації.
Авторизація в Kubernetes потребує використання загальних атрибутів REST для взаємодії з наявними системами контролю доступу на рівні всієї організації або хмарного провайдера. Важливо використовувати форматування REST, оскільки ці системи контролю можуть взаємодіяти з іншими API, крім API Kubernetes.
Kubernetes підтримує кілька модулів авторизації, таких як режим ABAC, режим RBAC та режим Webhook. Коли адміністратор створює кластер, він налаштовує модулі авторизації, які використовуватиме API-сервер. Якщо налаштовано більше одного модуля авторизації, Kubernetes перевіряє кожен модуль, і якщо будь-який модуль авторизує запит, запит може виконуватися. Якщо всі модулі відхиляють запит, його буде відхилено (код статусу HTTP 403).
Докладніше про авторизацію в Kubernetes, зокрема про створення політик за допомогою підтримуваних модулів авторизації, дивіться в розділі Авторизація.
Контроль допуску
Модулі контролю допуску — це програмні модулі, які можуть змінювати або відхиляти запити. Крім атрибутів, доступних модулям авторизації, модулі контролю допуску можуть отримувати доступ до вмісту обʼєкта, який створюється або змінюється.
Контролери допуску обробляють запити на створення, зміну, видалення обʼєкта або підключення до нього (проксі). Контролери допуску не обробляють запити, які лише читають обʼєкти. Коли налаштовано кілька контролерів допуску, вони викликаються по черзі.
На схемі це крок 3.
На відміну від модулів автентифікації та авторизації, якщо будь-який модуль контролю допуску відхиляє запит, то запит негайно відхиляється.
Крім відхилення обʼєктів, контролери допуску також можуть встановлювати складні стандартні значення для полів.
Після того як запит пройде всі контролери допуску, його перевіряють за допомогою процедур валідації відповідного обʼєкта API, а потім записують у сховище обʼєктів (на схемі це крок 4).
Аудит
Аудит Kubernetes забезпечує важливий для безпеки хронологічний набір записів, що документують послідовність дій у кластері. Кластер проводить аудит дій користувачів, застосунків, які використовують API Kubernetes, і самої панелі управління.
те, як Podʼи можуть використовувати Secrets для отримання облікових даних API.
6.8.9 - Рекомендації щодо контролю доступу на основі ролей
Принципи та практики для належного проєктування RBAC для операторів кластерів.
RBAC у Kubernetes — ключовий засіб контролю безпеки, який гарантує, що користувачі й робочі навантаження кластера мають доступ лише до ресурсів, потрібних для виконання їхніх ролей. Проєктуючи дозволи для користувачів кластера, адміністратор має розуміти, де може статися підвищення привілеїв, щоб зменшити ризик надмірного доступу, який може призвести до інцидентів безпеки.
Рекомендації, викладені тут, слід читати разом із загальною документацією з RBAC.
Загальні рекомендації
Принцип найменших привілеїв
В ідеалі користувачам і ServiceAccount слід призначати мінімальні права RBAC. Слід використовувати лише дозволи, явно потрібні для їхньої роботи. Хоча кожен кластер відрізняється, ось деякі загальні правила, які можна застосувати:
Надавайте дозволи на рівні простору імен, де це можливо. Використовуйте RoleBindings замість ClusterRoleBindings, щоб дати користувачам права лише в межах конкретного простору імен.
За можливості уникайте надання дозволів із шаблонами (wildcard), особливо для всіх ресурсів. Оскільки Kubernetes є розширюваною системою, доступ із шаблоном надає права не лише на всі типи обʼєктів, які наразі існують у кластері, а й на всі типи обʼєктів, які буде створено в майбутньому.
Адміністратори не повинні використовувати облікові записи cluster-admin, окрім випадків, коли це справді потрібно. Обліковий запис із низькими привілеями та правами імперсонації може запобігти випадковій зміні ресурсів кластера.
Уникайте додавання користувачів до групи system:masters. Будь-який член цієї групи оминає всі перевірки прав RBAC і завжди матиме необмежений доступ суперкористувача, який не можна скасувати видаленням RoleBindings або ClusterRoleBindings. До речі, якщо кластер використовує вебхук авторизації, членство в цій групі також оминає цей вебхук (запити від членів цієї групи ніколи не надсилаються до вебхука).
Мінімізація розповсюдження привілейованих токенів
В ідеалі Podʼам не слід призначати ServiceAccount із потужними дозволами (наприклад, будь-якими з прав, перелічених у розділі ризики підвищення привілеїв). Якщо робочому навантаженню потрібні потужні дозволи, розгляньте такі практики:
Обмежте кількість вузлів, на яких працюють потужні Podʼи. Переконайтеся, що всі DaemonSets, які ви запускаєте, справді потрібні та працюють із найменшими привілеями, щоб обмежити радіус ураження в разі виходу за межі контейнера.
Уникайте запуску потужних Podʼів поруч із ненадійними або публічно доступними. Розгляньте використання Taints and Toleration, NodeAffinity або PodAntiAffinity, щоб Podʼи не працювали поруч із ненадійними або менш надійними Podʼами. Особливу увагу приділіть ситуаціям, коли менш надійні Podʼи не відповідають стандарту безпеки Podʼів Restricted.
Зміцнення безпеки
Стандартно Kubernetes надає доступ, який може бути не потрібен у кожному кластері. Перегляд стандартних прав RBAC може дати можливості для зміцнення безпеки. Загалом не слід змінювати права облікових записів system:, але є деякі варіанти зміцнення прав кластера:
Перегляньте привʼязки групи system:unauthenticated і за можливості видаліть їх, оскільки вони надають доступ будь-кому, хто може звернутися до API-сервера на мережевому рівні.
Уникайте стандартного автоматичного монтування токенів ServiceAccount, встановивши automountServiceAccountToken: false. Докладніше дивіться в розділі використання стандартного токена ServiceAccount. Встановлення цього значення для Podʼа перевизначить налаштування ServiceAccount; робочі навантаження, яким потрібні токени ServiceAccount, усе ще можуть їх монтувати.
Періодичний огляд
Важливо періодично переглядати налаштування RBAC у Kubernetes на наявність зайвих записів і можливих підвищень привілеїв. Якщо зловмисник може створити обліковий запис користувача з такою самою назвою, як у видаленого користувача, він може автоматично успадкувати всі права видаленого користувача, зокрема права, призначені цьому користувачу.
Ризики підвищення привілеїв у RBAC Kubernetes
У RBAC Kubernetes є низка привілеїв, які в разі надання можуть дозволити користувачу або ServiceAccount підвищити свої привілеї в кластері або вплинути на системи поза кластером.
У цьому розділі показано області, де операторам кластерів слід бути уважними, щоб ненавмисно не надати більше доступу до кластерів, ніж передбачалося.
Перелік Secrets
Зазвичай зрозуміло, що доступ get до Secrets дозволяє користувачу читати їхній вміст. Також важливо зазначити, що доступ list і watch фактично теж дозволяє користувачам розкривати вміст Secrets. Наприклад, відповідь на запит List (наприклад, через kubectl get secrets -A -o yaml) містить вміст усіх Secrets.
Створення робочих навантажень
Дозвіл на створення робочих навантажень (Podʼів або ресурсів робочих навантажень, що керують Podʼами) у просторі імен неявно надає доступ до багатьох інших ресурсів у цьому просторі імен, таких як Secrets, ConfigMaps і PersistentVolumes, які можна монтувати в Podʼах. Крім того, оскільки Podʼи можуть працювати від імені будь-якого ServiceAccount, дозвіл на створення робочих навантажень також неявно надає рівні доступу до API будь-якого ServiceAccount у цьому просторі імен.
Користувачі, які можуть запускати привілейовані Podʼи, можуть використати цей доступ, щоб отримати доступ до вузла й, можливо, ще більше підвищити свої привілеї. Якщо ви не повністю довіряєте користувачу чи іншому принципалу створювати належно захищені та ізольовані Podʼи, застосовуйте стандарт безпеки Podʼів Baseline або Restricted. Для цього можна використовувати Pod Security admission або інші (сторонні) механізми.
Тому простори імен слід використовувати для розділення ресурсів, що потребують різних рівнів довіри або орендарів. Дотримуватися принципів найменших привілеїв і призначати мінімальний набір дозволів усе ще вважається рекомендованою практикою, але межі всередині простору імен слід вважати слабкими.
Створення PersistentVolume
Якщо комусь (людині чи застосунку) дозволено створювати довільні PersistentVolumes, цей доступ включає створення томів hostPath, а отже, Pod отримає доступ до файлової системи (або файлових систем) хоста на відповідному вузлі. Надання такої можливості є ризиком для безпеки.
Контейнер із необмеженим доступом до файлової системи хоста може підвищити привілеї багатьма способами, зокрема читаючи дані інших контейнерів і зловживаючи обліковими даними системних сервісів, таких як kubelet.
Дозволяйте створювати обʼєкти PersistentVolume лише:
Користувачам (операторам кластера), яким цей доступ потрібен для роботи і яким ви довіряєте.
Компонентам панелі управління Kubernetes, які створюють PersistentVolumes на основі PersistentVolumeClaims, налаштованих на автоматичне надання. Зазвичай це налаштовує провайдер Kubernetes або оператор під час встановлення драйвера CSI.
Якщо потрібен доступ до постійного сховища, довірені адміністратори мають створювати PersistentVolumes, а обмежені користувачі мають використовувати PersistentVolumeClaims для доступу до цього сховища.
Доступ до субресурсу proxy обʼєктів Node
Користувачі з доступом до субресурсу nodes/proxy мають права на API kubelet, що дозволяє виконувати команди в кожному Podʼі на вузлах, до яких вони мають права. Цей доступ оминає логування аудиту й контроль допуску, тому будьте обережні, надаючи будь-які права на цей ресурс. Ці API можна викликати через HTTP-запити websocket GET, які потребують лише авторизації дієслова get. Це означає, що дозвіл get на nodes/proxy не є дозволом лише для читання. Наприклад, дозвіл get на nodes/proxy надає доступ до привілейованих API kubelet, які можуть отримувати логи контейнерів, виконувати процеси в Podʼах і підключатися до них, навіть якщо викликач не має еквівалентних дозволів через API Kubernetes.
Загалом система RBAC не дозволяє користувачам створювати clusterroles із ширшими правами, ніж мають вони самі. Виняток — дієслово escalate. Як зазначено в документації RBAC, користувачі з цим правом можуть фактично підвищувати свої привілеї.
Дієслово bind
Як і дієслово escalate, це право дозволяє оминати вбудований захист Kubernetes від підвищення привілеїв, завдяки чому користувачі можуть створювати привʼязки до ролей із правами, яких вони ще не мають.
Дієслово impersonate
Це дієслово дозволяє користувачам імперсонувати інших користувачів кластера й отримувати їхні права. Надаючи його, будьте обережні, щоб через імперсоновані облікові записи не можна було отримати надмірні дозволи.
CSR і видача сертифікатів
API CSR дозволяє користувачам із правами create на CSR і update на certificatesigningrequests/approval, де підписувачем є kubernetes.io/kube-apiserver-client, створювати нові клієнтські сертифікати для автентифікації в кластері. Ці клієнтські сертифікати можуть мати довільні назви, зокрема дублювати назви системних компонентів Kubernetes. Це фактично дозволяє підвищити привілеї.
Запити токенів
Користувачі з правами create на serviceaccounts/token можуть створювати TokenRequests, щоб видавати токени для наявних ServiceAccount.
Керування вебхуками допуску
Користувачі, які контролюють validatingwebhookconfigurations або mutatingwebhookconfigurations, можуть керувати вебхуками, які можуть читати будь-який обʼєкт, допущений до кластера, а у випадку змінювальних вебхуків також змінювати допущені обʼєкти.
Зміна Namespace
Користувачі, які можуть виконувати операції patch над обʼєктами Namespace (через RoleBinding у просторі імен до Role з таким доступом), можуть змінювати мітки цього простору імен. У кластерах із Pod Security Admission це може дозволити користувачу налаштувати для простору імен менш сувору політику, ніж передбачили адміністратори. У кластерах із NetworkPolicy користувачі можуть встановити мітки, які опосередковано надають доступ до сервісів, доступ до яких адміністратор не планував дозволяти. У кластерах із динамічним виділенням ресурсів додавання до простору імен мітки resource.kubernetes.io/admin-access: "true" дозволяє будь-якому користувачу, який може створювати ResourceClaims у цьому просторі імен, запитувати адміністративний доступ до пристроїв, уже виділених будь-якій іншій заявці в будь-якому просторі імен.
Ризики відмови в обслуговуванні в RBAC Kubernetes
Відмова в обслуговуванні через створення обʼєктів
Користувачі з правами на створення обʼєктів у кластері можуть створити достатньо великі обʼєкти або достатню їх кількість, щоб спричинити відмову в обслуговуванні, як описано в etcd used by Kubernetes is vulnerable to OOM attack. Це особливо актуально для багатоорендних кластерів, якщо користувачі з частковою довірою або без довіри мають обмежений доступ до системи.
Один зі способів помʼякшити цю проблему — використовувати квоти ресурсів для обмеження кількості обʼєктів, які можна створити.
Принципи та практики належного керування Secrets для адміністраторів кластера та розробників застосунків.
У Kubernetes Secret — це обʼєкт, який зберігає конфіденційну інформацію, таку як паролі, токени OAuth та ключі SSH.
Секрети дають вам більше контролю над тим, як використовується конфіденційна інформація і зменшують ризик випадкового її розголошення. Значення Secret кодуються як рядки base64 і зазвичай зберігаються в незашифрованому вигляді, але можуть бути налаштовані для шифрування в стані покою.
Pod може посилатися на Secret різними способами, такими як монтування тому, чи як змінна середовища. Secretʼи призначені для конфіденційних даних, а ConfigMaps призначені для неконфіденційних даних.
Наведені нижче рекомендації призначені як для адміністраторів кластера, так і для розробників застосунків. Використовуйте їх, щоб підвищити безпеку конфіденційної інформації в обʼєктах Secret і ефективніше керувати своїми Secrets.
Адміністратори кластера
У цьому розділі наведено рекомендації, які адміністратори кластера можуть використовувати для покращення безпеки конфіденційної інформації в кластері.
Налаштування шифрування даних у стані спокою
Стандартно обʼєкти Secret зберігаються в etcd у незашифрованому вигляді. Вам слід налаштувати шифрування даних Secret в etcd. Інструкції дивіться в розділі Шифрування даних Secret у стані спокою.
Налаштування доступу з мінімальними привілеями до Secret
Компоненти: Обмежте доступ watch або list лише для найпривілейованіших системних компонентів. Надавайте доступ get до Secrets, лише якщо цього потребує звичайна робота компонента.
Люди: Обмежте доступ get, watch або list до Secrets. Дозволяйте доступ до etcd лише адміністраторам кластера. Це стосується й доступу лише для читання. Для складнішого контролю доступу, наприклад обмеження доступу до Secrets із певними анотаціями, розгляньте сторонні механізми авторизації.
Увага:
Надання доступу list до Secrets неявно дозволяє субʼєкту отримувати вміст Secrets.
Користувач, який може створити Pod, що використовує Secret, також може побачити значення цього Secret. Навіть якщо політики кластера не дозволяють користувачу читати Secret безпосередньо, той самий користувач може мати доступ до запуску Podʼа, який потім розкриє Secret. Ви можете виявляти або обмежувати вплив навмисного чи ненавмисного розкриття даних Secret користувачем із таким доступом. Ось деякі рекомендації:
Використовуйте Secrets із коротким терміном дії
Реалізуйте правила аудиту, які сповіщають про певні події, такі як одночасне читання кількох Secrets одним користувачем
Обмеження доступу до Secrets
Використовуйте окремі простори імен, щоб ізолювати доступ до змонтованих Secrets.
Покращення політик керування etcd
Розгляньте очищення або знищення постійного сховища, яке використовував etcd, коли воно більше не потрібне.
Якщо є кілька екземплярів etcd, налаштуйте зашифрований звʼязок SSL/TLS між ними, щоб захистити дані Secret під час передавання.
Налаштування доступу до зовнішніх Secrets
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Ви можете використовувати сторонні сховища Secrets, щоб зберігати конфіденційні дані поза кластером, а потім налаштувати Podʼи на доступ до цієї інформації. Kubernetes Secrets Store CSI Driver — це DaemonSet, який дозволяє kubelet отримувати Secrets із зовнішніх сховищ і монтувати їх як томи в певні Podʼи, яким ви надали доступ до цих даних.
Рекомендації щодо налаштування своп-памʼяті для вузлів Linux дивіться в розділі Керування своп-памʼяттю.
Розробники
У цьому розділі наведено рекомендації для розробників щодо покращення безпеки конфіденційних даних під час створення та розгортання ресурсів Kubernetes.
Обмежте доступ до Secret певними контейнерами
Якщо ви визначаєте кілька контейнерів у Podʼі, і лише одному з них потрібен доступ до Secret, налаштуйте монтування тому або змінні середовища так, щоб інші контейнери не мали доступу до цього Secret.
Захист даних Secret після їх зчитування
Застосунки все ще мають захищати значення конфіденційної інформації після її зчитування зі змінної середовища або тому. Наприклад, ваш застосунок не повинен записувати конфіденційні дані в логи у відкритому вигляді або передавати їх ненадійній стороні.
Уникайте спільного використання маніфестів Secret
Якщо ви налаштовуєте Secret через маніфест, у якому конфіденційні дані закодовані в base64, то поширення цього файлу або його додавання до репозиторію коду означає, що Secret доступний усім, хто може читати маніфест.
Увага:
Кодування у base64 — це не метод шифрування, воно не надає додаткової конфіденційності порівняно зі звичайним текстом.
6.8.11 - Багатоорендність
На цій сторінці наведено огляд доступних параметрів конфігурації та рекомендацій щодо багатоорендності кластера.
Спільне використання кластерів зменшує витрати й спрощує адміністрування. Однак воно також створює проблеми, такі як безпека, справедливість і керування шумними сусідами.
Кластери можна використовувати спільно багатьма способами. У деяких випадках у тому самому кластері можуть працювати різні застосунки. В інших випадках у тому самому кластері може працювати кілька екземплярів одного застосунку, по одному для кожного кінцевого користувача. Усі ці типи спільного використання часто описують загальним терміном багатоорендність (multi-tenancy).
Хоча в Kubernetes немає повноцінних понять кінцевих користувачів або орендарів, він надає кілька можливостей для керування різними вимогами до багатоорендності. Їх описано нижче.
Сценарії використання
Перший крок до визначення способу спільного використання кластера — зрозуміти ваш сценарій використання, щоб оцінити доступні шаблони та інструменти. Загалом багатоорендність у кластерах Kubernetes поділяється на дві широкі категорії, хоча можливо також багато варіантів і гібридів.
Кілька команд
Поширена форма багатоорендності — спільне використання кластера кількома командами в межах організації, кожна з яких може експлуатувати одне або кілька робочих навантажень. Ці робочі навантаження часто мають взаємодіяти між собою та з іншими робочими навантаженнями в тому самому або інших кластерах.
У цьому сценарії учасники команд часто мають прямий доступ до ресурсів Kubernetes через інструменти на кшталт kubectl або опосередкований доступ через контролери GitOps чи інші інструменти автоматизації випусків. Між учасниками різних команд часто є певний рівень довіри, але політики Kubernetes, такі як RBAC, квоти та мережеві політики, необхідні для безпечного й справедливого спільного використання кластерів.
Кілька клієнтів
Інша основна форма багатоорендності часто стосується постачальника програмного забезпечення як сервісу (SaaS), який запускає кілька екземплярів робочого навантаження для клієнтів. Ця бізнес-модель настільки тісно повʼязана з таким способом розгортання, що багато хто називає його «SaaS tenancy». Однак кращим терміном може бути «багатоклієнтська оренда» (multi-customer tenancy), оскільки постачальники SaaS можуть використовувати й інші моделі розгортання, а цю модель розгортання можна використовувати й поза SaaS.
У цьому сценарії клієнти не мають доступу до кластера; з їхнього погляду Kubernetes невидимий, і його використовує лише постачальник для керування робочими навантаженнями. Оптимізація витрат часто є критично важливою, а політики Kubernetes використовуються для надійної ізоляції робочих навантажень одне від одного.
Термінологія
Орендарі
Під час обговорення багатоорендності в Kubernetes немає єдиного визначення «орендаря» (tenant). Воно залежить від того, про яку оренду йдеться: багатокомандну чи багатоклієнтську.
У багатокомандному використанні орендарем зазвичай є команда, і кожна команда зазвичай розгортає невелику кількість робочих навантажень, яка зростає разом зі складністю сервісу. Однак саме визначення «команди» може бути нечітким, оскільки команди можуть обʼєднуватися в підрозділи вищого рівня або ділитися на менші команди.
Натомість якщо кожна команда розгортає окремі робочі навантаження для кожного нового клієнта, вона використовує багатоклієнтську модель оренди. У цьому випадку «орендар» — це просто група користувачів, які спільно використовують одне робоче навантаження. Це може бути ціла компанія або лише одна команда в цій компанії.
У багатьох випадках одна й та сама організація може використовувати обидва визначення «орендарів» у різних контекстах. Наприклад, команда платформи може пропонувати спільні сервіси, такі як інструменти безпеки й бази даних, кільком внутрішнім «клієнтам», а постачальник SaaS може мати кілька команд, які спільно використовують кластер для розробки. Нарешті, можливі й гібридні архітектури, наприклад постачальник SaaS, який поєднує окремі для кожного клієнта робочі навантаження для конфіденційних даних зі спільними багатоорендними сервісами.
Кластер, на якому співіснують різні моделі оренди
Ізоляція
Існує кілька способів проєктування й побудови багатоорендних рішень у Kubernetes. Кожен із цих методів має власний набір компромісів, що впливають на рівень ізоляції, зусилля на реалізацію, операційну складність і вартість обслуговування.
Кластер Kubernetes складається з панелі управління, на якій працює програмне забезпечення Kubernetes, і панелі даних, що складається з робочих вузлів, де робочі навантаження орендарів виконуються як Podʼи. Ізоляцію орендарів можна застосовувати і в панелі управління, і в панелі даних залежно від вимог організації.
Рівень ізоляції іноді описують термінами на кшталт «жорстка» багатоорендність, що передбачає сильну ізоляцію, і «мʼяка» багатоорендність, що передбачає слабшу ізоляцію. Зокрема, «жорстка» багатоорендність часто описує випадки, коли орендарі не довіряють одне одному, переважно з погляду безпеки та спільного використання ресурсів (наприклад, захист від атак на кшталт викрадення даних або DoS). Оскільки панелі даних зазвичай мають значно більшу поверхню атаки, «жорстка» багатоорендність часто потребує додаткової уваги до ізоляції панелі даних, хоча ізоляція панелі управління також залишається критично важливою.
Однак терміни «жорстка» і «мʼяка» часто можуть заплутувати, оскільки немає єдиного визначення, що підходило б усім користувачам. Краще розглядати «жорсткість» чи «мʼякість» як широкий спектр із багатьма різними техніками, які можна використовувати для підтримання різних типів ізоляції у ваших кластерах залежно від ваших вимог.
У більш екстремальних випадках може бути простіше або необхідно повністю відмовитися від спільного використання на рівні кластера й виділити кожному орендарю власний кластер, можливо, навіть на виділеному обладнанні, якщо віртуальні машини не вважаються достатньою межею безпеки. Це може бути простіше з керованими кластерами Kubernetes, де накладні витрати на створення й експлуатацію кластерів принаймні частково бере на себе хмарний провайдер. Перевагу сильнішої ізоляції орендарів слід зважувати проти вартості та складності керування кількома кластерами. За такі сценарії використання відповідає Multi-cluster SIG.
Решта цієї сторінки присвячена технікам ізоляції для спільних кластерів Kubernetes. Однак навіть якщо ви розглядаєте виділені кластери, варто переглянути ці рекомендації, оскільки вони дадуть вам гнучкість для переходу на спільні кластери в майбутньому, якщо ваші потреби чи можливості зміняться.
Ізоляція панелі управління
Ізоляція панелі управління гарантує, що різні орендарі не можуть отримувати доступ до ресурсів API Kubernetes одне одного або впливати на них.
Простори імен
У Kubernetes простір імен надає механізм ізоляції груп ресурсів API в межах одного кластера. Ця ізоляція має два ключові виміри:
Назви обʼєктів у межах простору імен можуть збігатися з назвами в інших просторах імен, подібно до файлів у теках. Це дозволяє орендарям називати свої ресурси, не зважаючи на те, що роблять інші орендарі.
Багато політик безпеки Kubernetes діють у межах просторів імен. Наприклад, RBAC Roles і Network Policies є ресурсами в межах простору імен. За допомогою RBAC користувачів і ServiceAccounts можна обмежити простором імен.
У багатоорендному середовищі простір імен допомагає виділити робоче навантаження орендаря в логічну й окрему одиницю керування. Поширеною практикою є ізоляція кожного робочого навантаження у власному просторі імен, навіть якщо кількома робочими навантаженнями керує той самий орендар. Це гарантує, що кожне робоче навантаження має власну ідентичність і може бути налаштоване з відповідною політикою безпеки.
Модель ізоляції на основі просторів імен потребує налаштування кількох інших ресурсів Kubernetes, мережевих втулків і дотримання рекомендацій з безпеки для належної ізоляції робочих навантажень орендарів. Ці міркування описано нижче.
Контроль доступу
Найважливіший тип ізоляції для панелі управління — авторизація. Якщо команди або їхні робочі навантаження можуть отримувати доступ до ресурсів API одне одного або змінювати їх, вони можуть змінювати або вимикати всі інші типи політик, зводячи нанівець будь-який захист, який ці політики можуть надавати. Тому критично важливо забезпечити, щоб кожен орендар мав відповідний доступ лише до потрібних йому просторів імен і не більше. Це називають «принципом найменших привілеїв».
Контроль доступу на основі ролей (RBAC) зазвичай використовується для забезпечення авторизації в панелі управління Kubernetes як для користувачів, так і для робочих навантажень (ServiceAccounts). Roles і RoleBindings — це обʼєкти Kubernetes, які використовуються на рівні простору імен для забезпечення контролю доступу у вашому застосунку; подібні обʼєкти існують і для авторизації доступу до обʼєктів на рівні кластера, хоча вони менш корисні для багатоорендних кластерів.
У багатокомандному середовищі RBAC слід використовувати, щоб обмежити доступ орендарів відповідними просторами імен і гарантувати, що до ресурсів на рівні кластера можуть отримувати доступ або змінювати їх лише привілейовані користувачі, такі як адміністратори кластера.
Якщо політика зрештою надає користувачеві більше дозволів, ніж йому потрібно, це, ймовірно, сигнал, що простір імен із відповідними ресурсами слід розділити на дрібніші простори імен. Інструменти керування просторами імен можуть спростити керування цими дрібнішими просторами імен, застосовуючи спільні політики RBAC до різних просторів імен і водночас дозволяючи за потреби детальніші політики.
Квоти
Робочі навантаження Kubernetes споживають ресурси вузлів, такі як CPU і памʼять. У багатоорендному середовищі ви можете використовувати квоти ресурсів для керування використанням ресурсів робочими навантаженнями орендарів. У сценарії з кількома командами, де орендарі мають доступ до API Kubernetes, ви можете використовувати квоти ресурсів, щоб обмежити кількість ресурсів API (наприклад, кількість Podʼів або ConfigMaps), які може створити орендар. Обмеження кількості обʼєктів забезпечують справедливість і допомагають уникнути проблем із шумними сусідами, що впливають на інших орендарів, які використовують спільну панель управління.
Квоти ресурсів — це обʼєкти в межах простору імен. Зіставляючи орендарів із просторами імен, адміністратори кластера можуть використовувати квоти, щоб орендар не міг монополізувати ресурси кластера або перевантажити його панель управління. Інструменти керування просторами імен спрощують адміністрування квот. Крім того, хоча квоти Kubernetes застосовуються лише в межах одного простору імен, деякі інструменти керування просторами імен дозволяють групам просторів імен спільно використовувати квоти, що дає адміністраторам значно більше гнучкості за менших зусиль, ніж вбудовані квоти.
Квоти не дають одному орендарю споживати більше виділеної йому частки ресурсів, мінімізуючи таким чином проблему «шумного сусіда», коли один орендар негативно впливає на продуктивність робочих навантажень інших орендарів.
Коли ви застосовуєте квоту до простору імен, Kubernetes вимагає також вказати запити й обмеження ресурсів для кожного контейнера. Обмеження — це верхня межа кількості ресурсів, яку може споживати контейнер. Контейнери, які намагаються спожити більше ресурсів, ніж дозволяють налаштовані обмеження, зазнають тротлінгу або примусово завершуються залежно від типу ресурсу. Якщо запити ресурсів встановлено нижче за обмеження, кожному контейнеру гарантовано запитану кількість, але певний вплив між робочими навантаженнями все ще можливий.
Квоти не можуть захистити від усіх видів спільного використання ресурсів, наприклад мережевого трафіку. Кращим рішенням цієї проблеми може бути ізоляція вузлів (описана нижче).
Ізоляція панелі даних
Ізоляція панелі даних гарантує, що Podʼи та робочі навантаження різних орендарів достатньо ізольовані.
Мережева ізоляція
Стандартно всі Podʼи в кластері Kubernetes можуть взаємодіяти між собою, а весь мережевий трафік не зашифрований. Це може призвести до вразливостей безпеки, коли трафік випадково або зловмисно надсилається не за призначенням або перехоплюється робочим навантаженням на скомпрометованому вузлі.
Взаємодію між Podʼами можна контролювати за допомогою мережевих політик, які обмежують взаємодію між Podʼами за мітками просторів імен або діапазонами IP-адрес. У багатоорендному середовищі, де потрібна сувора мережева ізоляція між орендарями, рекомендується починати зі стандартної політики, яка забороняє взаємодію між Podʼами, та ще одного правила, яке дозволяє всім Podʼам звертатися до сервера DNS для розвʼязання імен. Маючи таку стандартну політику, можна додавати більш дозвільні правила, що дозволяють взаємодію в межах простору імен. Також рекомендується не використовувати порожній селектор міток '{}' для поля namespaceSelector у визначенні мережевої політики, якщо потрібно дозволити трафік між просторами імен. Цю схему можна вдосконалювати за потреби. Зверніть увагу, що це стосується лише Podʼів у межах однієї панелі управління; Podʼи, що належать до різних віртуальних панелей управління, не можуть взаємодіяти між собою через мережу Kubernetes.
Інструменти керування просторами імен можуть спростити створення стандартних або спільних мережевих політик. Крім того, деякі з цих інструментів дозволяють примусово застосовувати узгоджений набір міток просторів імен у всьому кластері, що робить їх надійною основою для ваших політик.
Попередження:
Мережеві політики потребують втулка CNI, який підтримує реалізацію мережевих політик. Інакше ресурси NetworkPolicy ігноруватимуться.
Більш розвинену мережеву ізоляцію можуть забезпечувати service mesh, які надають політики 7-го рівня OSI на основі ідентичності робочих навантажень на додачу до просторів імен. Ці політики вищого рівня можуть полегшити керування багатоорендністю на основі просторів імен, особливо коли кілька просторів імен виділено одному орендарю. Вони часто також пропонують шифрування за допомогою взаємного TLS, захищаючи ваші дані навіть за наявності скомпрометованого вузла, і працюють на виділених або віртуальних кластерах. Однак вони можуть бути значно складнішими в керуванні й можуть підходити не всім користувачам.
Ізоляція сховищ
Kubernetes пропонує кілька типів томів, які можна використовувати як постійне сховище для робочих навантажень. Для безпеки та ізоляції даних рекомендовано динамічне надання томів, а типів томів, що використовують ресурси вузла, слід уникати.
StorageClasses дозволяють описувати власні «класи» сховищ, які пропонує ваш кластер, на основі рівнів якості обслуговування, політик резервного копіювання або власних політик, визначених адміністраторами кластера.
Podʼи можуть запитувати сховище за допомогою PersistentVolumeClaim. PersistentVolumeClaim — це ресурс у межах простору імен, що дозволяє ізолювати частини системи зберігання й виділяти їх орендарям у спільному кластері Kubernetes. Однак важливо зауважити, що PersistentVolume — це ресурс на рівні кластера, життєвий цикл якого не залежить від робочих навантажень і просторів імен.
Наприклад, ви можете налаштувати окремий StorageClass для кожного орендаря й використовувати це для зміцнення ізоляції. Якщо StorageClass спільний, слід встановити політику повторного використання Delete, щоб PersistentVolume не можна було повторно використовувати в різних просторах імен.
Ізоляція контейнерів у пісочниці
Podʼи Kubernetes складаються з одного або кількох контейнерів, що виконуються на робочих вузлах. Контейнери використовують віртуалізацію на рівні ОС і тому надають слабшу межу ізоляції, ніж віртуальні машини, що використовують апаратну віртуалізацію.
У спільному середовищі невиправлені вразливості на рівні застосунків і систем можуть бути використані зловмисниками для виходу за межі контейнера й віддаленого виконання коду, що дає доступ до ресурсів хоста. У деяких застосунках, наприклад у системах керування вмістом (CMS), клієнтам може бути дозволено завантажувати й виконувати недовірені скрипти чи код. У будь-якому разі бажані механізми подальшої ізоляції та захисту робочих навантажень за допомогою сильної ізоляції.
Ізоляція в пісочниці дає змогу ізолювати робочі навантаження, що працюють у спільному кластері. Зазвичай вона передбачає запуск кожного Podʼа в окремому середовищі виконання, такому як віртуальна машина або ядро в просторі користувача. Ізоляцію в пісочниці часто рекомендують, коли ви запускаєте недовірений код, а робочі навантаження вважаються зловмисними. Частково така ізоляція потрібна тому, що контейнери — це процеси, які працюють на спільному ядрі; вони монтують файлові системи, такі як /sys і /proc, з базового хоста, що робить їх менш безпечними, ніж застосунок у віртуальній машині з власним ядром. Хоча такі засоби контролю, як seccomp, AppArmor і SELinux, можна використовувати для зміцнення безпеки контейнерів, важко застосувати універсальний набір правил до всіх робочих навантажень у спільному кластері. Запуск робочих навантажень у пісочниці допомагає захистити хост від виходу з контейнера, коли зловмисник використовує вразливість, щоб отримати доступ до системи хоста й усіх процесів і файлів на цьому хості.
Віртуальні машини та ядра в просторі користувача — два популярні підходи до ізоляції в пісочниці.
Ізоляція вузлів
Ізоляція вузлів — ще одна техніка, яку можна використовувати для ізоляції робочих навантажень орендарів одне від одного. За ізоляції вузлів набір вузлів виділяється для запуску Podʼів певного орендаря, а спільне розміщення Podʼів різних орендарів заборонено. Така конфігурація зменшує проблему шумного орендаря, оскільки всі Podʼи на вузлі належать одному орендарю. Ризик розкриття інформації дещо нижчий за ізоляції вузлів, оскільки зловмисник, якому вдасться вийти за межі контейнера, матиме доступ лише до контейнерів і томів, змонтованих на цьому вузлі.
Хоча робочі навантаження різних орендарів працюють на різних вузлах, важливо памʼятати, що kubelet і (якщо не використовуються віртуальні панелі управління) сервіс API все ще є спільними сервісами. Кваліфікований зловмисник може використати дозволи, призначені kubelet або іншим Podʼам на вузлі, щоб переміщатися кластером і отримати доступ до робочих навантажень орендарів на інших вузлах. Якщо це викликає серйозне занепокоєння, розгляньте компенсаційні засоби контролю, такі як seccomp, AppArmor або SELinux, або використання контейнерів у пісочниці чи створення окремих кластерів для кожного орендаря.
Ізоляцію вузлів дещо простіше обґрунтувати з погляду виставлення рахунків, ніж ізоляцію контейнерів у пісочниці, оскільки витрати можна розподіляти за вузлами, а не за Podʼами. Вона також має менше проблем із сумісністю та продуктивністю й може бути простішою в реалізації, ніж ізоляція контейнерів у пісочниці. Наприклад, вузли кожного орендаря можна налаштувати з taints, щоб на них могли працювати лише Podʼи з відповідною toleration. Потім змінювальний вебхук може автоматично додавати tolerations і спорідненість вузлів до Podʼів, розгорнутих у просторах імен орендарів, щоб вони працювали на певному наборі вузлів, призначених цьому орендарю.
У цьому розділі розглянуто інші конструкції та шаблони Kubernetes, що стосуються багатоорендності.
API Priority and Fairness
API Priority and Fairness — це можливість Kubernetes, яка дозволяє призначати пріоритет певним Podʼам, що працюють у кластері. Коли застосунок викликає API Kubernetes, API-сервер оцінює пріоритет, призначений Podʼу. Виклики від Podʼів із вищим пріоритетом виконуються раніше за виклики з нижчим пріоритетом. За високої конкуренції виклики з нижчим пріоритетом можуть ставитися в чергу, доки сервер не звільниться, або ви можете відхиляти запити.
Використання API Priority and Fairness не дуже поширене в середовищах SaaS, якщо тільки ви не дозволяєте клієнтам запускати застосунки, що взаємодіють з API Kubernetes, наприклад контролер.
Якість обслуговування (QoS)
Коли ви запускаєте застосунок SaaS, вам може знадобитися можливість пропонувати різним орендарям різні рівні якості обслуговування (QoS). Наприклад, у вас може бути безкоштовний сервіс (freemium) з меншими гарантіями продуктивності та меншим набором можливостей і платний рівень сервісу з конкретними гарантіями продуктивності. На щастя, у Kubernetes є кілька конструкцій, які допомагають досягти цього в спільному кластері, зокрема мережевий QoS, класи сховищ, а також пріоритет і витіснення Podʼів. Ідея кожної з них полягає в тому, щоб надавати орендарям ту якість обслуговування, за яку вони заплатили. Почнімо з мережевого QoS.
Зазвичай усі Podʼи на вузлі використовують спільний мережевий інтерфейс. Без мережевого QoS деякі Podʼи можуть споживати непропорційно велику частку доступної пропускної здатності за рахунок інших Podʼів. Втулок bandwidth Kubernetes створює для мережі розширений ресурс, який дозволяє використовувати конструкції ресурсів Kubernetes, тобто запити й обмеження, щоб застосовувати обмеження швидкості до Podʼів за допомогою черг Linux tc. Зверніть увагу, що згідно з документацією про мережеві втулки цей втулок вважається експериментальним, і його слід ретельно перевірити перед використанням у промислових середовищах.
Для QoS сховища вам, імовірно, знадобиться створити різні класи сховищ або профілі з різними характеристиками продуктивності. Кожен профіль сховища можна повʼязати з окремим рівнем обслуговування, оптимізованим для різних робочих навантажень, наприклад щодо IO, резервування чи пропускної здатності. Може знадобитися додаткова логіка, щоб орендар міг повʼязати відповідний профіль сховища зі своїм робочим навантаженням.
Нарешті, є пріоритет і витіснення Podʼів, де ви можете призначати Podʼам значення пріоритету. Під час планування Podʼів планувальник намагатиметься виселити Podʼи з нижчим пріоритетом, коли бракує ресурсів для планування Podʼів із вищим пріоритетом. Якщо у вас є сценарій, де орендарі мають різні рівні обслуговування в спільному кластері, наприклад безкоштовний і платний, ви можете за допомогою цієї можливості надати вищий пріоритет певним рівням.
DNS
Кластери Kubernetes містять сервіс системи доменних імен (DNS), який перетворює імена на IP-адреси для всіх Services і Podʼів. Стандартно сервіс DNS Kubernetes дозволяє пошук у всіх просторах імен кластера.
У багатоорендних середовищах, де орендарі мають доступ до Podʼів та інших ресурсів Kubernetes, або де потрібна сильніша ізоляція, може знадобитися заборонити Podʼам шукати сервіси в інших просторах імен. Ви можете обмежити пошук DNS між просторами імен, налаштувавши правила безпеки для сервісу DNS. Наприклад, CoreDNS (стандартний сервіс DNS для Kubernetes) може використовувати метадані Kubernetes, щоб обмежувати запити Podʼами та Services у межах простору імен. Докладніше дивіться приклад такого налаштування в документації CoreDNS.
Оператори — це контролери Kubernetes, які керують застосунками. Оператори можуть спростити керування кількома екземплярами застосунку, наприклад сервісу баз даних, що робить їх поширеним будівельним блоком у сценарії багатоклієнтської (SaaS) багатоорендності.
Оператори, що використовуються в багатоорендному середовищі, повинні дотримуватися суворішого набору настанов. Зокрема, Оператор повинен:
Підтримувати створення ресурсів у різних просторах імен орендарів, а не лише в просторі імен, де розгорнуто Оператор.
Гарантувати, що Podʼи налаштовані із запитами та обмеженнями ресурсів, щоб забезпечити планування й справедливість.
Підтримувати налаштування Podʼів для технік ізоляції панелі даних, таких як ізоляція вузлів і контейнери в пісочниці.
Реалізації
Існує два основні способи спільного використання кластера Kubernetes для багатоорендності: за допомогою просторів імен (тобто простір імен на орендаря) або віртуалізації панелі управління (тобто віртуальна панель управління на орендаря).
В обох випадках рекомендовано також ізоляцію панелі даних і врахування додаткових міркувань, таких як API Priority and Fairness.
Ізоляція за просторами імен добре підтримується в Kubernetes, майже не потребує ресурсів і надає механізми належної взаємодії орендарів, наприклад дозволяючи взаємодію між сервісами. Однак її може бути складно налаштувати, і вона не застосовується до ресурсів Kubernetes, які не можуть належати простору імен, таких як Custom Resource Definitions, Storage Classes і Webhooks.
Віртуалізація панелі управління дозволяє ізолювати ресурси поза просторами імен ціною дещо більшого використання ресурсів і складнішого спільного використання між орендарями. Це хороший варіант, коли ізоляції за просторами імен недостатньо, але виділені кластери небажані через високу вартість їх підтримки (особливо on-prem) або через вищі накладні витрати й відсутність спільного використання ресурсів. Однак навіть у віртуалізованій панелі управління використання просторів імен, імовірно, теж дасть переваги.
Обидва варіанти докладніше описано в розділах нижче.
Простір імен на орендаря
Як уже згадувалося, варто розглянути ізоляцію кожного робочого навантаження у власному просторі імен, навіть якщо ви використовуєте виділені кластери або віртуалізовані панелі управління. Це гарантує, що кожне робоче навантаження має доступ лише до власних ресурсів, таких як ConfigMaps і Secrets, і дозволяє налаштувати окремі політики безпеки для кожного робочого навантаження. Крім того, рекомендується давати кожному простору імен назву, унікальну в межах усього вашого парку (тобто навіть якщо вони в окремих кластерах), оскільки це дає гнучкість для переходу між виділеними та спільними кластерами в майбутньому або для використання багатокластерних інструментів, таких як service mesh.
З іншого боку, є також переваги в призначенні просторів імен на рівні орендаря, а не лише робочого навантаження, оскільки часто існують політики, що застосовуються до всіх робочих навантажень одного орендаря. Однак це створює власні проблеми. По-перше, це ускладнює або унеможливлює налаштування політик для окремих робочих навантажень, а по-друге, може бути складно визначити єдиний рівень «оренди», якому слід надати простір імен. Наприклад, в організації можуть бути підрозділи, команди та підкоманди — кому з них призначити простір імен?
Один із можливих підходів — організувати простори імен в ієрархії та спільно використовувати між ними певні політики й ресурси. Це може охоплювати керування мітками просторів імен, життєвими циклами просторів імен, делегованим доступом і спільними квотами ресурсів для повʼязаних просторів імен. Ці можливості можуть бути корисними як у багатокомандних, так і в багатоклієнтських сценаріях.
Віртуальна панель управління на орендаря
Ще одна форма ізоляції панелі управління — використання розширень Kubernetes, щоб надати кожному орендарю віртуальну панель управління, яка дозволяє розділити ресурси API на рівні кластера. Разом із цією моделлю можна використовувати техніки ізоляції панелі даних для безпечного керування робочими вузлами різних орендарів.
Модель багатоорендності на основі віртуальної панелі управління розширює багатоорендність на основі просторів імен, надаючи кожному орендарю окремі компоненти панелі управління, а отже, повний контроль над ресурсами на рівні кластера й сервісами надбудов. Робочі вузли спільні для всіх орендарів і керуються кластером Kubernetes, який зазвичай недоступний орендарям. Цей кластер часто називають суперкластером (super-cluster) або іноді хост-кластером (host-cluster). Оскільки панель управління орендаря не повʼязана безпосередньо з базовими обчислювальними ресурсами, її називають віртуальною панеллю управління.
Віртуальна панель управління зазвичай складається з API-сервера Kubernetes, менеджера контролерів і сховища даних etcd. Вона взаємодіє із суперкластером через контролер синхронізації метаданих, який координує зміни між панелями управління орендарів і панеллю управління суперкластера.
Завдяки виділеним панелям управління для кожного орендаря вирішується більшість проблем ізоляції, спричинених використанням одного API-сервера всіма орендарями. Приклади таких проблем: шумні сусіди в панелі управління, неконтрольований радіус ураження від помилкових конфігурацій політик і конфлікти між обʼєктами на рівні кластера, такими як вебхуки та CRD. Отже, модель віртуальної панелі управління особливо підходить для випадків, коли кожному орендарю потрібен доступ до API-сервера Kubernetes і він очікує повної керованості кластера.
Покращена ізоляція досягається ціною запуску й підтримки окремої віртуальної панелі управління для кожного орендаря. Крім того, панелі управління для кожного орендаря не вирішують проблем ізоляції в панелі даних, таких як шумні сусіди на рівні вузла або загрози безпеці. Їх усе ще потрібно вирішувати окремо.
6.8.12 - Посібник зі зміцнення безпеки — динамічне виділення ресурсів
Інформація про зміцнення безпеки авторизації та шаблонів доступу для динамічного виділення ресурсів (DRA).
Динамічне виділення ресурсів (DRA) додає потужні можливості планування та керування пристроями. Оскільки компоненти DRA оновлюють статус ResourceClaim, адміністратори кластера мають налаштувати авторизацію цих оновлень за допомогою явного RBAC з мінімальними привілеями.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Починаючи з Kubernetes v1.36, оновлення статусу DRA використовують синтетичні субресурси та, в деяких випадках, спеціалізовані дієслова з урахуванням вузла.
Зміцнення дозволів на оновлення статусу DRA
Для оновлень статусу DRA, окрім надання дозволів update на субресурс resourceclaims/status, адміністратори кластера мають надавати дозволи на конкретні «синтетичні» субресурси залежно від того, які саме поля потрібно змінювати компоненту. Це застосовує принцип мінімальних привілеїв до планувальника, власних контролерів і драйверів DRA.
Перевірки авторизації DRA поділяються на два синтетичні субресурси:
resourceclaims/binding
Потрібно для зміни status.allocation та status.reservedFor.
Зазвичай надається kube-scheduler та власним контролерам виділення.
Використовує стандартні дієслова update та patch.
resourceclaims/driver
Потрібно для зміни status.devices.
Перевірка виконується для кожного драйвера, щоб запобігти втручанню драйверів у пристрої на різних вузлах та/або від інших драйверів.
Використовує дієслова з урахуванням вузла для суворішої області дії.
Дієслова DRA з урахуванням вузла
Під час авторизації оновлень resourceclaims/driver використовуйте відповідний спеціалізований префікс дієслова:
associated-node:<verb> (наприклад, associated-node:update)
Для драйверів, локальних для вузла.
API-сервер перевіряє звʼязок драйвера, що надсилає запит, із вузлом.
arbitrary-node:<verb> (наприклад, arbitrary-node:patch)
Для контролерів панелі управління або багатовузлових контролерів, які можуть оновлювати заявки з будь-якого вузла.
6.8.13 - Посібник зі зміцнення безпеки — механізми автентифікації
Інформація про варіанти автентифікації в Kubernetes та їх властивості безпеки.
Вибір відповідних механізмів автентифікації — ключовий аспект захисту вашого кластера. Kubernetes надає кілька вбудованих механізмів, кожен із власними перевагами та недоліками, які слід ретельно враховувати під час вибору найкращого механізму автентифікації для вашого кластера.
Загалом рекомендується вмикати якомога менше механізмів автентифікації, щоб спростити керування користувачами й уникнути ситуацій, коли користувачі зберігають доступ до кластера, який їм більше не потрібен.
Важливо зазначити, що Kubernetes не має вбудованої бази даних користувачів у кластері. Натомість він отримує інформацію про користувачів із налаштованої системи автентифікації й використовує її для прийняття рішень щодо авторизації. Тому для аудиту доступу користувачів потрібно переглядати облікові дані з кожного налаштованого джерела автентифікації.
Для промислових кластерів із багатьма користувачами, які безпосередньо звертаються до API Kubernetes, рекомендується використовувати зовнішні джерела автентифікації, такі як OIDC. Внутрішні механізми автентифікації, такі як клієнтські сертифікати та токени ServiceAccount, описані нижче, не підходять для цього сценарію.
Автентифікація за клієнтським сертифікатом X.509
Kubernetes використовує автентифікацію за клієнтським сертифікатом X.509 для системних компонентів, наприклад коли kubelet автентифікується на API-сервері. Хоча цей механізм можна використовувати й для автентифікації користувачів, він може не підходити для промислового використання через кілька обмежень:
Клієнтські сертифікати не можна відкликати окремо. Скомпрометований сертифікат зловмисник може використовувати до завершення його строку дії. Щоб зменшити цей ризик, рекомендується налаштовувати короткий строк дії для облікових даних користувачів, створених за допомогою клієнтських сертифікатів.
Якщо сертифікат потрібно анулювати, необхідно змінити ключі центру сертифікації, що може створити ризики для доступності кластера.
У кластері немає постійного запису про створені клієнтські сертифікати. Тому, якщо вам потрібно їх відстежувати, усі видані сертифікати слід записувати.
Приватні ключі для автентифікації за клієнтським сертифікатом не можна захистити паролем. Будь-хто, хто може прочитати файл із ключем, зможе ним скористатися.
Автентифікація за клієнтським сертифікатом потребує прямого зʼєднання клієнта з API-сервером без проміжних точок завершення TLS, що може ускладнити архітектуру мережі.
Дані про групи вбудовані в значення O клієнтського сертифіката, тому членство користувача в групах не можна змінити протягом строку дії сертифіката.
Файл статичних токенів
Хоча Kubernetes дозволяє завантажувати облікові дані з файлу статичних токенів, розташованого на дисках вузлів панелі управління, цей підхід не рекомендується для промислових серверів з кількох причин:
Облікові дані зберігаються у відкритому вигляді на дисках вузлів панелі управління, що може бути ризиком для безпеки.
Зміна будь-яких облікових даних потребує перезапуску процесу API-сервера для набуття чинності, що може вплинути на доступність.
Немає механізму, який дозволяв би користувачам ротувати свої облікові дані. Щоб ротувати облікові дані, адміністратор кластера має змінити токен на диску та передати його користувачам.
Немає механізму блокування для запобігання атакам підбору (brute force).
Токени bootstrap
Токени bootstrap використовуються для приєднання вузлів до кластерів і не рекомендуються для автентифікації користувачів з кількох причин:
Вони мають жорстко задане членство в групах, непридатне для загального використання, тому не підходять для автентифікації.
Створення токенів bootstrap вручну може призвести до появи слабких токенів, які може вгадати зловмисник, що є ризиком для безпеки.
Немає механізму блокування для запобігання атакам підбору, тому зловмисникам легше вгадати або зламати токен.
Токени ServiceAccount у Secret
Secrets для ServiceAccount доступні як варіант для автентифікації робочих навантажень кластера на API-сервері. У Kubernetes < 1.23 це був стандартний варіант, однак їх замінюють токени TokenRequest API. Хоча ці Secrets можна використовувати для автентифікації користувачів, зазвичай вони не підходять із кількох причин:
Для них не можна задати строк дії, і вони залишаються чинними, доки відповідний ServiceAccount не буде видалено.
Токени автентифікації видимі будь-якому користувачу кластера, який може читати Secrets у просторі імен, де їх визначено.
ServiceAccount не можна додавати до довільних груп, що ускладнює керування RBAC там, де вони використовуються.
Токени TokenRequest API
TokenRequest API — корисний інструмент для створення короткострокових облікових даних для автентифікації сервісів на API-сервері або в сторонніх системах. Однак загалом його не рекомендується використовувати для автентифікації користувачів, оскільки немає способу відкликання, а безпечно передавати облікові дані користувачам може бути складно.
Під час використання токенів TokenRequest для автентифікації сервісів рекомендується задавати короткий строк дії, щоб зменшити наслідки компрометації токенів.
Автентифікація токенами OpenID Connect
Kubernetes підтримує інтеграцію зовнішніх сервісів автентифікації з API Kubernetes за допомогою OpenID Connect (OIDC). Існує багато програмного забезпечення для інтеграції Kubernetes із постачальником ідентифікації. Однак під час використання автентифікації OIDC у Kubernetes важливо врахувати такі заходи зі зміцнення безпеки:
Програмне забезпечення, встановлене в кластері для підтримки автентифікації OIDC, має бути ізольоване від звичайних робочих навантажень, оскільки воно працюватиме з високими привілеями.
Деякі керовані сервіси Kubernetes обмежують перелік постачальників OIDC, які можна використовувати.
Як і токени TokenRequest, токени OIDC повинні мати короткий строк дії, щоб зменшити наслідки компрометації токенів.
Автентифікація за токеном через вебхук
Автентифікація за токеном через вебхук — ще один варіант інтеграції зовнішніх постачальників автентифікації в Kubernetes. Цей механізм дозволяє звертатися через вебхук до сервісу автентифікації, що працює в кластері або поза ним, для прийняття рішення щодо автентифікації. Важливо зазначити, що придатність цього механізму, ймовірно, залежатиме від програмного забезпечення сервісу автентифікації, і є певні особливості Kubernetes, які варто врахувати.
Для налаштування автентифікації через вебхук потрібен доступ до файлових систем серверів панелі управління. Це означає, що в керованому Kubernetes це неможливо, якщо постачальник спеціально не надасть таку можливість. Крім того, будь-яке програмне забезпечення, встановлене в кластері для підтримки цього доступу, має бути ізольоване від звичайних робочих навантажень, оскільки воно працюватиме з високими привілеями.
Проксі автентифікації
Ще один варіант інтеграції зовнішніх систем автентифікації в Kubernetes — проксі автентифікації. За цього механізму Kubernetes очікує отримувати від проксі запити з певними значеннями заголовків, які вказують імʼя користувача та членство в групах для авторизації. Важливо зазначити, що під час використання цього механізму слід врахувати певні особливості.
По-перше, між проксі та API-сервером Kubernetes слід використовувати безпечно налаштований TLS, щоб зменшити ризик перехоплення трафіку або атак зі сніфінгом. Це гарантує безпеку звʼязку між проксі та API-сервером Kubernetes.
По-друге, важливо памʼятати, що зловмисник, який може змінювати заголовки запиту, може отримати неавторизований доступ до ресурсів Kubernetes. Тому важливо забезпечити належний захист заголовків, щоб їх не можна було підробити.
У цьому документі описано, як покращити захищеність планувальника.
Неправильно налаштований планувальник може мати наслідки для безпеки. Такий планувальник може націлюватися на певні вузли й виселяти робочі навантаження чи застосунки, які спільно використовують вузол і його ресурси. Це може допомогти зловмиснику провести атаку Yo-Yo — атаку на вразливий автомасштабувальник.
Конфігурація kube-scheduler
Параметри командного рядка автентифікації та авторизації планувальника
Під час налаштування автентифікації слід переконатися, що автентифікація kube-scheduler залишається узгодженою з автентифікацією kube-api-server. Якщо в запиті немає заголовків автентифікації, автентифікація має відбуватися через kube-api-server, що забезпечує узгодженість автентифікації в кластері.
authentication-kubeconfig: Переконайтеся, що ви надали правильний kubeconfig, щоб планувальник міг отримувати параметри конфігурації автентифікації з API-сервера. Цей файл kubeconfig має бути захищено суворими правами доступу до файлів.
authentication-tolerate-lookup-failure: Встановіть значення false, щоб планувальник завжди отримував свою конфігурацію автентифікації з API-сервера.
authentication-skip-lookup: Встановіть значення false, щоб планувальник завжди отримував свою конфігурацію автентифікації з API-сервера.
authorization-always-allow-paths: Ці шляхи повинні відповідати даними, придатними для анонімної авторизації. Стандартно /healthz,/readyz,/livez.
profiling: Встановіть значення false, щоб вимкнути точки доступу профілювання, які надають налагоджувальну інформацію, але не повинні бути ввімкнені в промислових кластерах, оскільки становлять ризик відмови в обслуговуванні або витоку інформації. Аргумент --profiling застарів, і тепер його можна задати через KubeScheduler DebuggingConfiguration. Профілювання можна вимкнути в конфігурації kube-scheduler, встановивши enableProfiling у false.
requestheader-client-ca-file: Не передавайте цей аргумент.
Параметри командного рядка для мережевих налаштувань планувальника
bind-address: У більшості випадків kube-scheduler не потребує зовнішнього доступу. Встановлення адреси привʼязки на localhost є безпечною практикою.
permit-address-sharing: Встановіть значення false, щоб вимкнути спільне використання зʼєднань через SO_REUSEADDR. SO_REUSEADDR може призвести до повторного використання завершених зʼєднань, які перебувають у стані TIME_WAIT.
permit-port-sharing: Стандартно: false. Використовуйте стандартне значення, якщо ви не впевнені, що розумієте наслідки для безпеки.
Параметри командного рядка планувальника для TLS
tls-cipher-suites: Завжди надавайте список бажаних наборів шифрів. Це гарантує, що шифрування ніколи не відбуватиметься за допомогою ненадійних наборів шифрів.
Конфігурації планування для власних планувальників
Під час використання власних планувальників, заснованих на коді планування Kubernetes, адміністратори кластерів мають бути обережними із втулками, які використовують точки розширенняqueueSort, prefilter, filter або permit. Ці точки розширення керують різними етапами процесу планування, і неправильна конфігурація може вплинути на поведінку kube-scheduler у вашому кластері.
Основні міркування
Одночасно може бути увімкнено лише один втулок, який використовує точку розширення queueSort. Усі втулки, які використовують queueSort, слід ретельно перевіряти.
Втулки, які реалізують точку розширення prefilter або filter, потенційно можуть позначити всі вузли як непридатні для планування. Це може зупинити планування нових Podʼів.
Втулки, які реалізують точку розширення permit, можуть перешкоджати привʼязці Podʼа або затримувати її. Такі втулки мають бути ретельно перевірені адміністратором кластера.
Якщо ви використовуєте втулок, який не належить до стандартних, розгляньте можливість вимкнення точок розширення queueSort, filter і permit так:
apiVersion:kubescheduler.config.k8s.io/v1kind:KubeSchedulerConfigurationprofiles:- schedulerName:my-schedulerplugins:# Вимкніть певні втулки для різних точок розширення# Ви можете вимкнути всі втулки для точки розширення за допомогою "*"queueSort:disabled:- name:"*"# Вимкнути всі втулки queueSort# - name: "PrioritySort" # Вимкнути певний втулок queueSortfilter:disabled:- name:"*"# Вимкнути всі втулки фільтрів# - name: "NodeResourcesFit" # Вимкнути певний втулок фільтруванняpermit:disabled:- name:"*"# Вимкнути всі втулки дозволів# - name: "TaintToleration" # Вимкнути певний втулок
Це створить профіль планувальника my-scheduler. Щоразу, коли в .spec Podʼа немає значення .spec.schedulerName, для цього Podʼа працює kube-scheduler зі своєю основною конфігурацією та стандартними втулками. Якщо ви визначите Pod із .spec.schedulerName, встановленим у my-scheduler, kube-scheduler запуститься, але з власною конфігурацією; у цій конфігурації точки розширення queueSort, filter і permit вимкнено. Якщо ви використовуєте цю KubeSchedulerConfiguration, не запускаєте жодного власного планувальника, а потім визначите Pod із .spec.schedulerName, встановленим у nonexistent-scheduler (або будь-яку іншу назву планувальника, якого немає у вашому кластері), для Podʼа не буде згенеровано жодних подій.
Заборона додавання міток вузлам
Адміністратор кластера має подбати про те, щоб користувачі кластера не могли додавати мітки вузлам. Зловмисник може використати nodeSelector, щоб запланувати робочі навантаження на вузли, де їх не повинно бути.
6.8.15 - Ризики обходу API-сервера Kubernetes
Інформація про архітектуру безпеки, що стосується API-сервера та інших компонентів
API-сервер Kubernetes — головна точка входу до кластера для зовнішніх сторін (користувачів і сервісів), що з ним взаємодіють.
У межах цієї ролі API-сервер має кілька ключових вбудованих засобів контролю безпеки, таких як логування аудиту та контролери допуску. Однак існують способи змінити конфігурацію або вміст кластера, оминаючи ці засоби контролю.
На цій сторінці описано способи обходу вбудованих в API-сервер Kubernetes засобів контролю безпеки, щоб оператори кластера й архітектори безпеки могли переконатися, що ці обхідні шляхи належно обмежені.
Статичні Podʼи
kubelet на кожному вузлі завантажує та безпосередньо керує всіма маніфестами, що зберігаються в зазначеній теці або завантажуються з конкретної URL-адреси як статичні Podʼи у вашому кластері. API-сервер не керує цими статичними Podʼами. Зловмисник із правами запису в це місце може змінити конфігурацію статичних Podʼів, завантажених із цього джерела, або додати нові статичні Podʼи.
Статичним Podʼам заборонено доступ до інших обʼєктів API Kubernetes. Наприклад, не можна налаштувати статичний Pod на монтування Secret із кластера. Однак ці Podʼи можуть виконувати інші чутливі з погляду безпеки дії, наприклад використовувати монтування hostPath з базового вузла.
Стандартно kubelet створює дзеркальний Pod, щоб статичні Podʼи були видимими в API Kubernetes. Однак якщо під час створення Podʼа зловмисник вкаже недійсну назву простору імен, Pod не буде видимий в API Kubernetes, і його зможуть виявити лише інструменти з доступом до уражених хостів.
Якщо статичний Pod не проходить контроль допуску, kubelet не зареєструє Pod на API-сервері. Однак Pod все одно працює на вузлі. Докладніше дивіться в issue kubeadm #1541.
Якщо вузол використовує статичні Podʼи, обмежте доступ до файлової системи з текою маніфестів статичних Podʼів або до URL лише користувачами, яким він потрібен.
Обмежте доступ до параметрів і файлів конфігурації kubelet, щоб зловмисник не міг задати шлях або URL статичних Podʼів.
Регулярно проводьте аудит усіх звернень до тек або вебсховищ із маніфестами статичних Podʼів і файлами конфігурації kubelet та централізовано звітуйте про них.
API kubelet
kubelet надає HTTP API, який зазвичай доступний через TCP-порт 10250 на робочих вузлах кластера. API також може бути доступний на вузлах панелі управління залежно від дистрибутива Kubernetes. Прямий доступ до API дозволяє розкривати інформацію про Podʼи, що працюють на вузлі, отримувати логи цих Podʼів і виконувати команди в кожному контейнері на вузлі.
Деякі з цих точок доступу підтримують протоколи Websocket через HTTP-запити GET, які авторизуються за допомогою дієслова get. Це означає, що дозвіл get на nodes/proxy не є дозволом лише для читання й авторизує доступ до точок доступу, які можна використовувати для виконання команд у будь-якому контейнері на вузлі.
Коли у користувачів кластера Kubernetes є доступ RBAC до субресурсів обʼєкта Node, цей доступ слугує авторизацією для взаємодії з API kubelet. Точний доступ залежить від того, доступ до якого субресурсу надано, як детально описано в розділі авторизація kubelet.
Прямий доступ до API kubelet не підлягає контролю допуску й не реєструється логуванням аудиту Kubernetes. Зловмисник із прямим доступом до цього API може обійти засоби контролю, які виявляють певні дії або запобігають їм.
API kubelet можна налаштувати на автентифікацію запитів кількома способами. Стандартно конфігурація kubelet дозволяє анонімний доступ. Більшість провайдерів Kubernetes змінюють стандартну конфігурацію на автентифікацію через вебхук і сертифікати. Це дозволяє панелі управління переконатися, що викликач має право доступу до ресурсу API nodes або його субресурсів. Стандартний анонімний доступ не дає панелі управління такого підтвердження.
Зменшення ризиків
Обмежте доступ до субресурсів обʼєкта API nodes за допомогою механізмів, таких як RBAC. Надавайте цей доступ лише за потреби, наприклад сервісам моніторингу.
Уникайте надання загального дозволу nodes/proxy, навіть лише з дієсловом get. Натомість надавайте детальні дозволи.
Обмежте доступ до порту kubelet. Дозволяйте доступ до порту лише зазначеним та довіреним діапазонам IP-адрес.
Переконайтеся, що для автентифікації kubelet встановлено режим webhook або сертифікатів.
Переконайтеся, що неавтентифікований порт kubelet лише для читання не ввімкнено в кластері.
API etcd
Кластери Kubernetes використовують etcd як сховище даних. Сервіс etcd прослуховує TCP-порт 2379. Доступ потрібен лише API-серверу Kubernetes та інструментам резервного копіювання, які ви використовуєте. Прямий доступ до цього API дозволяє розкривати або змінювати будь-які дані, що зберігаються в кластері.
Доступом до API etcd зазвичай керує автентифікація за клієнтськими сертифікатами. Будь-який сертифікат, виданий центром сертифікації, якому довіряє etcd, надає повний доступ до даних в etcd.
Прямий доступ до etcd не підлягає контролю допуску Kubernetes і не реєструється логуванням аудиту Kubernetes. Зловмисник, який має доступ на читання до приватного ключа клієнтського сертифіката etcd API-сервера (або може створити новий довірений клієнтський сертифікат), може отримати права адміністратора кластера, отримавши доступ до Secrets кластера або змінивши правила доступу. Навіть без підвищення привілеїв RBAC у Kubernetes зловмисник, який може змінювати etcd, може отримати будь-який обʼєкт API або створити нові робочі навантаження в кластері.
Багато провайдерів Kubernetes налаштовують etcd на використання взаємного TLS (клієнт і сервер перевіряють сертифікати один одного для автентифікації). Загальноприйнятої реалізації авторизації для API etcd немає, хоча така можливість існує. Оскільки моделі авторизації немає, будь-який сертифікат із клієнтським доступом до etcd можна використати для повного доступу до etcd. Зазвичай клієнтські сертифікати etcd, які використовуються лише для перевірки справності, також можуть надавати повний доступ на читання та запис.
Зменшення ризиків
Переконайтеся, що центр сертифікації, якому довіряє etcd, використовується лише для автентифікації в цьому сервісі.
Контролюйте доступ до приватного ключа сертифіката сервера etcd, а також до клієнтського сертифіката й ключа API-сервера.
Розгляньте обмеження доступу до порту etcd на рівні мережі, щоб дозволити доступ лише із зазначених і довірених діапазонів IP-адрес.
Сокет середовища виконання контейнерів
На кожному вузлі кластера Kubernetes доступ до взаємодії з контейнерами контролює середовище виконання контейнерів (або середовища, якщо ви налаштували більше одного). Зазвичай середовище виконання контейнерів надає сокет Unix, до якого має доступ kubelet. Зловмисник із доступом до цього сокета може запускати нові контейнери або взаємодіяти із запущеними контейнерами.
На рівні кластера вплив такого доступу залежить від того, чи мають контейнери на скомпрометованому вузлі доступ до Secrets або інших конфіденційних даних, які зловмисник може використати для підвищення привілеїв на інших робочих вузлах чи в компонентах панелі управління.
Зменшення ризиків
Суворо контролюйте доступ до сокетів середовища виконання контейнерів у файловій системі. За можливості обмежте цей доступ користувачем root.
Ізолюйте kubelet від інших компонентів, що працюють на вузлі, використовуючи механізми, такі як простори імен ядра Linux.
Обмежте або заборонте використання монтувань hostPath, що охоплюють сокет середовища виконання контейнерів безпосередньо або через монтування батьківської теки. Крім того, монтування hostPath слід налаштовувати лише для читання, щоб зменшити ризик обходу обмежень тек зловмисниками.
Обмежте доступ користувачів до вузлів, особливо обмежте доступ суперкористувача до вузлів.
6.8.16 - Обмеження безпеки ядра Linux для Podʼів та контейнерів
Огляд модулів безпеки ядра Linux та обмежень, які можна використовувати для зміцнення ваших Podʼів і контейнерів.
На цій сторінці описано деякі можливості безпеки, вбудовані в ядро Linux, які ви можете використовувати у своїх робочих навантаженнях Kubernetes. Щоб дізнатися, як застосувати ці можливості до ваших Podʼів і контейнерів, дивіться Налаштування контексту безпеки для Podʼа або контейнера. Ви вже маєте бути знайомі з Linux та основами робочих навантажень Kubernetes.
Запуск робочих навантажень без привілеїв root
Коли ви розгортаєте робоче навантаження в Kubernetes, використовуйте специфікацію Podʼа, щоб заборонити йому працювати від імені користувача root на вузлі. За допомогою securityContext Podʼа можна визначити конкретного користувача та групу Linux для процесів у Podʼі та явно заборонити контейнерам працювати від імені root. Значення, встановлені в маніфесті Podʼа, мають вищий пріоритет за аналогічні значення в образі контейнера, що особливо корисно, якщо ви запускаєте образи, які вам не належать.
Увага:
Переконайтеся, що користувач або група, яку ви призначаєте робочому навантаженню, має дозволи, потрібні для правильної роботи застосунку. Зміна користувача або групи на таких, що не мають потрібних дозволів, може призвести до проблем із доступом до файлів або збоїв операцій.
Налаштування описаних на цій сторінці можливостей безпеки ядра забезпечує детальний контроль над діями процесів у вашому кластері, але керування цими налаштуваннями може бути складним у великому масштабі. Запуск контейнерів не від імені root або в просторах імен користувачів, якщо вам потрібні привілеї root, зменшує ймовірність того, що вам доведеться застосовувати налаштовані можливості безпеки ядра.
Можливості безпеки в ядрі Linux
Kubernetes дозволяє налаштовувати та використовувати можливості ядра Linux для кращої ізоляції та зміцнення ваших контейнеризованих робочих навантажень. Серед поширених можливостей:
Режим безпечних обчислень (seccomp): фільтрування системних викликів, які може робити процес
AppArmor: обмеження привілеїв доступу окремих програм
Security Enhanced Linux (SELinux): призначення міток безпеки обʼєктам для зручнішого застосування політик безпеки
Щоб налаштувати одну з цих можливостей, операційна система ваших вузлів має вмикати її в ядрі. Наприклад, Ubuntu 7.10 і новіші стандартно вмикають AppArmor. Щоб дізнатися, чи ввімкнено певну можливість у вашій ОС, зверніться до документації ОС.
Поле securityContext у специфікації Podʼа визначає обмеження, що застосовуються до цих процесів. Воно також підтримує інші налаштування безпеки, такі як конкретні capabilities Linux або дозволи на доступ до файлів за допомогою UID і GID. Докладніше дивіться в розділі Налаштування контексту безпеки для Podʼа або контейнера.
seccomp
Деяким вашим робочим навантаженням можуть бути потрібні привілеї для виконання певних дій від імені користувача root на хост-машині вузла. Linux використовує capabilities, щоб розділити доступні привілеї на категорії, тож процеси можуть отримувати привілеї, потрібні для певних дій, без надання всіх привілеїв. Кожна capability має набір системних викликів (syscalls), які може робити процес. seccomp дозволяє обмежувати ці окремі syscalls. Його можна використовувати, щоб ізолювати привілеї процесу в пісочниці, обмежуючи виклики, які він може робити з простору користувача до ядра.
У Kubernetes для запуску контейнерів на кожному вузлі використовується середовище виконання контейнерів. Приклади середовищ — CRI-O, Docker або containerd. Кожне середовище стандартно дозволяє лише підмножину capabilities Linux. Ви можете додатково обмежити дозволені syscalls окремо за допомогою профілю seccomp. Середовища виконання контейнерів зазвичай містять стандартний профіль seccomp. Kubernetes дозволяє автоматично застосовувати до ваших Podʼів і контейнерів профілі seccomp, завантажені на вузол.
Примітка:
У Kubernetes також є налаштування allowPrivilegeEscalation для Podʼів і контейнерів. Якщо встановити його в false, процеси не зможуть отримувати нові capabilities, а непривілейовані користувачі не зможуть змінити застосований профіль seccomp на менш суворий.
Докладніше про seccomp дивіться в розділі Seccomp BPF документації ядра Linux.
Міркування щодо seccomp
seccomp — це низькорівнева конфігурація безпеки, яку варто налаштовувати самостійно лише тоді, коли потрібен детальний контроль над системними викликами Linux. Використання seccomp, особливо у великому масштабі, має такі ризики:
Конфігурації можуть ламатися під час оновлень застосунків
Зловмисники все ще можуть використовувати дозволені syscalls для експлуатації вразливостей
Керування профілями окремих застосунків стає складним у великому масштабі
Рекомендація: Використовуйте стандартний профіль seccomp, що постачається з вашим середовищем виконання контейнерів. Якщо потрібне більш ізольоване середовище, розгляньте пісочницю, таку як gVisor. Пісочниці усувають наведені вище ризики власних профілів seccomp, але потребують більше обчислювальних ресурсів на вузлах і можуть мати проблеми сумісності з GPU та іншим спеціалізованим обладнанням.
AppArmor та SELinux: обовʼязковий контроль доступу на основі політик
Для зміцнення робочих навантажень Kubernetes можна використовувати механізми обовʼязкового контролю доступу (MAC) Linux на основі політик, такі як AppArmor і SELinux.
AppArmor
AppArmor — це модуль безпеки ядра Linux, який доповнює стандартні дозволи Linux на основі користувачів і груп, обмежуючи програми певним набором ресурсів. AppArmor можна налаштувати для будь-якого застосунку, щоб зменшити його потенційну поверхню атаки й забезпечити багаторівневий захист. Він налаштовується через профілі, що дозволяють доступ, потрібний конкретній програмі чи контейнеру, зокрема capabilities Linux, мережевий доступ і дозволи на файли. Кожен профіль може працювати в режимі примусового застосування (enforcing), який блокує доступ до заборонених ресурсів, або в режимі скарг (complain), який лише повідомляє про порушення.
AppArmor може допомогти зробити розгортання безпечнішим, обмежуючи дії контейнерів, та/або покращити аудит через системні логи. Середовище виконання контейнерів може постачатися зі стандартним профілем AppArmor, або ви можете використовувати власний профіль.
SELinux — це модуль безпеки ядра Linux, який дозволяє обмежувати доступ певного субʼєкта, такого як процес, до файлів у вашій системі. Ви визначаєте політики безпеки, які застосовуються до субʼєктів із певними мітками SELinux. Коли процес із міткою SELinux намагається отримати доступ до файлу, сервер SELinux перевіряє, чи дозволяє політика безпеки цього процесу такий доступ, і приймає рішення про авторизацію.
У Kubernetes ви можете встановити мітку SELinux у полі securityContext вашого маніфесту. Вказані мітки призначаються цим процесам. Якщо ви налаштували політики безпеки, що стосуються цих міток, ядро ОС хоста застосовує ці політики.
Операційна система на ваших вузлах Linux зазвичай містить або AppArmor, або SELinux. Обидва механізми забезпечують схожий захист, але мають такі відмінності:
Налаштування: AppArmor використовує профілі для визначення доступу до ресурсів. SELinux використовує політики, які застосовуються до певних міток.
Застосування політики: В AppArmor ви визначаєте ресурси за допомогою шляхів до файлів. SELinux ідентифікує ресурс за його індексним дескриптором (inode).
Підсумок можливостей
У наведеній нижче таблиці описано сценарії використання та область дії кожного засобу контролю безпеки. Ви можете використовувати всі ці засоби разом, щоб створити більш захищену систему.
Підсумок можливостей безпеки ядра Linux
Можливість безпеки
Опис
Як використовувати
Приклад
seccomp
Обмежуйте окремі виклики ядра в просторі користувача. Зменшує ймовірність того, що вразливість, яка використовує обмежений системний виклик, скомпрометує систему.
Вказуйте завантажений профіль seccomp у специфікації Podʼа або контейнера, щоб застосувати його обмеження до процесів у Podʼі.
Відхиляйте системний виклик unshare, який використовувався в CVE-2022-0185.
AppArmor
Обмежуйте доступ програм до певних ресурсів. Зменшує поверхню атаки програми. Покращує логування аудиту.
Вкажіть завантажений профіль AppArmor у специфікації контейнера.
Заборонити програмі, що працює лише для читання, запис за будь-яким шляхом у системі.
SELinux
Обмежуйте доступ до ресурсів, таких як файли, застосунки, порти та процеси за допомогою міток та політик безпеки.
Вкажіть обмеження доступу для конкретних міток. Позначте процеси цими мітками, щоб застосувати обмеження доступу, повʼязані з міткою.
Заборонити контейнеру доступ до файлів поза його власною файловою системою.
Примітка:
Механізми на кшталт AppArmor і SELinux можуть забезпечувати захист, що виходить за межі контейнера. Наприклад, SELinux може допомогти помʼякшити CVE-2019-5736.
Міркування щодо керування власними конфігураціями
seccomp, AppArmor і SELinux зазвичай мають стандартну конфігурацію, що надає базовий захист. Ви також можете створювати власні профілі й політики, що відповідають вимогам ваших робочих навантажень. Керування цими власними конфігураціями та їх розповсюдження у великому масштабі може бути складним, особливо якщо ви використовуєте всі три можливості разом. Для цього використовуйте інструмент на кшталт Kubernetes Security Profiles Operator.
Можливості безпеки на рівні ядра та привілейовані контейнери
Kubernetes дозволяє вказати, що деякі довірені контейнери можуть працювати в привілейованому режимі. Будь-який контейнер у Podʼі може працювати в привілейованому режимі, щоб використовувати адміністративні capabilities операційної системи, які інакше були б недоступні. Це доступно і для Windows, і для Linux.
Привілейовані контейнери явно перевизначають деякі обмеження ядра Linux, які ви можете використовувати у своїх робочих навантаженнях:
seccomp: Привілейовані контейнери працюють із профілем seccomp Unconfined, перевизначаючи будь-який профіль seccomp, вказаний у маніфесті.
AppArmor: Привілейовані контейнери ігнорують будь-які застосовані профілі AppArmor.
SELinux: Привілейовані контейнери працюють у домені unconfined_t.
Привілейовані контейнери
Будь-який контейнер у Podʼі може ввімкнути привілейований режим, якщо встановити privileged: true у полі securityContext контейнера. Привілейовані контейнери перевизначають або скасовують багато інших налаштувань зміцнення безпеки, таких як застосований профіль seccomp, профіль AppArmor або обмеження SELinux. Привілейовані контейнери отримують усі capabilities Linux, зокрема ті, які їм не потрібні. Наприклад, користувач root у привілейованому контейнері може використовувати capabilities CAP_SYS_ADMIN і CAP_NET_ADMIN на вузлі, оминаючи конфігурацію seccomp середовища виконання та інші обмеження.
У більшості випадків слід уникати привілейованих контейнерів і натомість надавати контейнеру потрібні capabilities за допомогою поля capabilities у полі securityContext. Використовуйте привілейований режим, лише якщо потрібна capability, яку не можна надати через securityContext. Це корисно для контейнерів, яким потрібні адміністративні capabilities операційної системи, наприклад для керування мережевим стеком або доступу до апаратних пристроїв.
У Kubernetes 1.26 і новіших ви також можете запускати контейнери Windows у подібному привілейованому режимі, встановивши прапорець windowsOptions.hostProcess у контексті безпеки специфікації Podʼа. Докладніше дивіться в розділі Створення HostProcess Pod для Windows.
Рекомендації
Перш ніж налаштовувати можливості безпеки на рівні ядра, розгляньте впровадження ізоляції на рівні мережі. Докладніше читайте в розділі Список перевірки безпеки.
Якщо немає потреби в іншому, запускайте робочі навантаження Linux не від імені root, вказавши конкретні ідентифікатори користувача та групи в маніфесті Podʼа та runAsNonRoot: true.
Крім того, ви можете запускати робочі навантаження в просторах імен користувачів, встановивши hostUsers: false у маніфесті Podʼа. Це дозволяє запускати контейнери від імені root у просторі імен користувача, але не від імені root у просторі імен хоста на вузлі. Ця можливість ще на ранніх етапах розробки й може не мати потрібного вам рівня підтримки. Інструкції дивіться в розділі Використання простору імен користувачів із Podʼом.
Базовий список перевірки для забезпечення безпеки в кластерах Kubernetes.
Цей список перевірки має на меті надати базовий перелік настанов із посиланнями на докладнішу документацію з кожної теми. Він не претендує на вичерпність і буде змінюватися з часом.
Як читати й використовувати цей документ:
Порядок тем не відображає порядок пріоритетів.
Деякі пункти списку описано докладніше в абзаці під списком кожного розділу.
Увага:
Самих лише списків перевірки недостатньо для досягнення належного рівня безпеки. Належний рівень безпеки потребує постійної уваги й удосконалення, але список перевірки може бути першим кроком на нескінченному шляху до готовності в питаннях безпеки. Деякі рекомендації в цьому списку можуть бути надто обмежувальними або надто мʼякими для ваших конкретних потреб у безпеці. Оскільки безпека Kubernetes не є універсальною для всіх, кожну категорію пунктів списку слід оцінювати окремо.
Автентифікація та авторизація
Група system:masters не використовується для автентифікації користувачів чи компонентів після початкового налаштування.
Компонент kube-controller-manager працює з увімкненим параметром --use-service-account-credentials.
Кореневий сертифікат захищений (або офлайн CA, або керований онлайн CA з ефективними засобами контролю доступу).
Проміжні та кінцеві сертифікати мають строк дії не більше ніж 3 роки наперед.
Існує процес періодичного перегляду доступу, і перегляди відбуваються з інтервалом не більше ніж 24 місяці.
Після початкового налаштування ні користувачі, ні компоненти не повинні автентифікуватися в API Kubernetes як system:masters. Так само слід уникати запуску всього kube-controller-manager від імені system:masters. Фактично system:masters слід використовувати лише як механізм аварійного доступу, а не як адміністративного користувача.
Безпека мережі
CNI-втулки, що використовуються, підтримують мережеві політики.
Мережеві політики для вхідного та вихідного трафіку застосовано до всіх робочих навантажень у кластері.
У кожному просторі імен діють стандартні мережеві політики, які вибирають усі Podʼи та забороняють усе.
За потреби використовується service mesh для шифрування всіх зʼєднань усередині кластера.
Доступ до API Kubernetes, API kubelet та etcd не відкрито публічно в Інтернеті.
Доступ робочих навантажень до API хмарних метаданих фільтрується.
Використання LoadBalancer та ExternalIPs обмежено.
Низка втулків Container Network Interface (CNI) дозволяє обмежувати мережеві ресурси, з якими можуть взаємодіяти Podʼи. Найчастіше це робиться за допомогою мережевих політик, які є ресурсом у межах простору імен для визначення правил. Стандартні мережеві політики, які блокують увесь вихідний і вхідний трафік у кожному просторі імен, вибираючи всі Podʼи, допомагають застосувати підхід зі списком дозволеного й переконатися, що жодне робоче навантаження не пропущено.
Не всі CNI-втулки забезпечують шифрування під час передавання. Якщо обраний втулок не має цієї можливості, альтернативним рішенням може бути використання service mesh.
Сховище даних etcd панелі управління повинно мати засоби обмеження доступу й не повинно бути публічно доступним в Інтернеті. Крім того, для безпечного звʼязку з ним слід використовувати взаємний TLS (mTLS). Центр сертифікації для цього має бути окремим, лише для etcd.
Зовнішній доступ з Інтернету до API-сервера Kubernetes слід обмежити, щоб не відкривати API публічно. Будьте обережні: багато керованих дистрибутивів Kubernetes стандартно відкривають публічний доступ до API-сервера. У такому разі для доступу до сервера можна використовувати хост-бастіон.
Доступ до API kubelet слід обмежити й не відкривати публічно: стандартні налаштування автентифікації та авторизації, якщо файл конфігурації не вказано прапорцем --config, є надто дозвільними.
Якщо Kubernetes розміщено в хмарного провайдера, доступ Podʼів до API хмарних метаданих 169.254.169.254 також слід обмежити або заблокувати, якщо він не потрібен, оскільки це може призвести до витоку інформації.
Права RBAC create, update, patch, delete для робочих навантажень надаються лише за потреби.
Для всіх просторів імен визначено й примусово застосовано відповідну політику стандартів безпеки Podʼів.
Для робочих навантажень встановлено обмеження памʼяті, що дорівнює запиту або менше за нього.
Для чутливих робочих навантажень можна встановити обмеження CPU.
На вузлах, що його підтримують, увімкнено Seccomp з відповідним профілем syscalls для програм.
На вузлах, що їх підтримують, увімкнено AppArmor або SELinux з відповідним профілем для програм.
Авторизація RBAC є важливою, але не може бути достатньо деталізованою, щоб авторизувати дії з ресурсами Podʼів (або з будь-яким ресурсом, який керує Podʼами). Єдиним рівнем деталізації є дієслова API для самого ресурсу, наприклад create для Podʼів. Без додаткового контролю допуску дозвіл на створення цих ресурсів надає прямий необмежений доступ до придатних для планування вузлів кластера.
Стандарти безпеки Podʼів визначають три різні політики: privileged, baseline і restricted, які обмежують, як можна встановлювати поля PodSpec, що стосуються безпеки. Ці стандарти можна примусово застосовувати на рівні простору імен за допомогою нового допуску Pod Security, стандартно ввімкненого, або стороннього вебхука допуску. Зверніть увагу, що, на відміну від вилученого допуску PodSecurityPolicy, який він замінює, допуск Pod Security можна легко поєднувати з вебхуками допуску та зовнішніми сервісами.
Політика restricted допуску Pod Security, найсуворіша політика з набору стандартів безпеки Podʼів, може працювати в кількох режимах, warn, audit або enforce, щоб поступово застосовувати найвідповідніший контекст безпеки згідно з рекомендаціями з безпеки. Проте контекст безпеки Podʼів слід досліджувати окремо, щоб обмежити привілеї та доступ, які Podʼи можуть мати понад наперед визначені стандарти безпеки, для конкретних сценаріїв використання.
Обмеження памʼяті та CPU слід встановлювати, щоб обмежити ресурси памʼяті та CPU, які Pod може споживати на вузлі, і таким чином запобігти можливим DoS-атакам зі зловмисних або скомпрометованих робочих навантажень. Таку політику може примусово застосовувати контролер допуску. Зверніть увагу, що обмеження CPU спричиняють тротлінг і тому можуть мати небажаний вплив на можливості автомасштабування або на ефективність, тобто на виконання процесу в режимі best effort з доступними ресурсами CPU.
Увага:
Обмеження памʼяті, що перевищує запит, може наразити весь вузол на проблеми з OOM.
Увімкнення Seccomp
Seccomp означає режим безпечних обчислень (secure computing mode) і є можливістю ядра Linux з версії 2.6.12. Його можна використовувати, щоб ізолювати привілеї процесу в пісочниці, обмежуючи виклики, які він може робити з простору користувача до ядра. Kubernetes дозволяє автоматично застосовувати до ваших Podʼів і контейнерів профілі seccomp, завантажені на вузол.
Seccomp може покращити безпеку ваших робочих навантажень, зменшуючи поверхню атаки через системні виклики ядра Linux, доступну всередині контейнерів. Режим фільтрації seccomp використовує BPF для створення списків дозволених або заборонених конкретних системних викликів, які називаються профілями.
Починаючи з Kubernetes 1.27, ви можете ввімкнути використання RuntimeDefault як стандартного профілю seccomp для всіх робочих навантажень. На цю тему є навчальний матеріал з безпеки. Крім того, Kubernetes Security Profiles Operator — це проєкт, що полегшує керування seccomp і його використання в кластерах.
Примітка:
Seccomp доступний лише на вузлах Linux.
Увімкнення AppArmor або SELinux
AppArmor
AppArmor — це модуль безпеки ядра Linux, який може забезпечити простий спосіб реалізації обовʼязкового контролю доступу (MAC, Mandatory Access Control) та кращого аудиту через системні логи. На вузлах, які його підтримують, примусово застосовується стандартний профіль AppArmor, або можна налаштувати власний профіль. Як і seccomp, AppArmor налаштовується через профілі, де кожен профіль працює або в режимі примусового застосування (enforcing), який блокує доступ до заборонених ресурсів, або в режимі скарг (complain), який лише повідомляє про порушення. Профілі AppArmor застосовуються до кожного контейнера окремо за допомогою анотації, що дозволяє процесам отримувати саме ті привілеї, які їм потрібні.
SELinux також є модулем безпеки ядра Linux, який надає механізм підтримки політик безпеки контролю доступу, зокрема обовʼязкового контролю доступу (MAC). Мітки SELinux можна призначати контейнерам або Podʼам через їхній розділ securityContext.
Логи аудиту, якщо їх увімкнено, захищені від загального доступу.
Розташування Podʼів
Розташування Podʼів відповідає рівням чутливості застосунку.
Чутливі застосунки працюють ізольовано на вузлах або з окремими середовищами виконання в пісочниці.
Podʼи різних рівнів чутливості, наприклад Pod застосунку та API-сервер Kubernetes, слід розгортати на окремих вузлах. Мета ізоляції вузлів — не дати зловмиснику після виходу за межі контейнера застосунку отримати прямий доступ до застосунків із вищим рівнем чутливості й легко переміщуватися кластером. Це розділення слід забезпечувати примусово, щоб Podʼи випадково не розгорталися на тому самому вузлі. Для цього можна використовувати такі можливості:
Пари ключ-значення в специфікації Podʼа, які вказують, на яких вузлах його розгортати. Їх можна примусово застосовувати на рівні простору імен і кластера за допомогою контролера допуску PodNodeSelector.
Контролер допуску, який дозволяє адміністраторам обмежувати дозволені tolerations у межах простору імен. Podʼи в просторі імен можуть використовувати лише tolerations, вказані в ключах анотації обʼєкта простору імен, які задають набір стандартних і дозволених tolerations.
RuntimeClass — це можливість вибору конфігурації середовища виконання контейнерів. Ця конфігурація використовується для запуску контейнерів Podʼа й може забезпечувати більшу або меншу ізоляцію від хоста ціною додаткових витрат продуктивності.
Secrets
ConfigMaps не використовуються для зберігання конфіденційних даних.
Для Secret API налаштовано шифрування у стані спокою.
За потреби розгорнуто й доступний механізм для додавання Secrets, що зберігаються в сторонньому сховищі.
Токени ServiceAccount не монтуються в Podʼи, яким вони не потрібні.
Конфіденційні дані, потрібні Podʼам, слід зберігати в обʼєктах Secret Kubernetes, а не в альтернативах на кшталт ConfigMap. Ресурси Secret, що зберігаються в etcd, слід шифрувати у стані спокою.
Podʼи, яким потрібні Secrets, повинні отримувати їх автоматично змонтованими через томи, бажано збереженими в памʼяті, як-от за допомогою параметра emptyDir.medium. Цей механізм також можна використовувати для додавання Secrets зі сторонніх сховищ у вигляді томів, як-от у Secrets Store CSI Driver. Цьому способу слід надавати перевагу перед наданням ServiceAccount Podʼа доступу RBAC до Secrets. Це дозволить додавати Secrets у Pod як змінні середовища або файли. Зверніть увагу, що спосіб зі змінними середовища може бути більш схильним до витоків через аварійні дампи в логах і неконфіденційну природу змінних середовища в Linux, на відміну від механізму дозволів на файли.
Токени ServiceAccount не слід монтувати в Podʼи, яким вони не потрібні. Це можна налаштувати, встановивши automountServiceAccountToken у false або в ServiceAccount, щоб застосувати це до всього простору імен, або окремо для Podʼа. Для Kubernetes v1.22 і новіших використовуйте привʼязані ServiceAccounts для обмежених у часі облікових даних ServiceAccount.
Образи
Мінімізуйте непотрібний вміст в образах контейнерів.
Образи контейнерів налаштовано на запуск від імені непривілейованого користувача.
На образи контейнерів посилаються за дайджестами sha256 (а не за теґами), або походження образу підтверджується перевіркою його цифрового підпису під час розгортання через контроль допуску.
Образи контейнерів регулярно скануються під час створення та розгортання, а для відомого вразливого програмного забезпечення застосовуються виправлення.
Образ контейнера повинен містити лише мінімум, потрібний для запуску програми, яку він пакує. Бажано лише програму та її залежності, а сам образ слід збирати з мінімально можливої бази. Зокрема, образи, що використовуються в промисловому середовищі, не повинні містити оболонок або засобів налагодження, оскільки для усунення несправностей можна використовувати ефемерний контейнер налагодження.
Збирайте образи так, щоб вони одразу запускалися від імені непривілейованого користувача, за допомогою інструкції USER у Dockerfile. Контекст безпеки дозволяє запускати образ контейнера від імені певного користувача та групи за допомогою runAsUser і runAsGroup, навіть якщо їх не вказано в маніфесті образу. Однак дозволи на файли в шарах образу можуть унеможливити простий запуск процесу від імені нового непривілейованого користувача без зміни образу.
Уникайте посилань на образ за теґом, особливо за теґом latest, оскільки образ за теґом можна легко змінити в реєстрі. Надавайте перевагу повному дайджесту sha256, який є унікальним для маніфесту образу. Цю політику можна примусово застосовувати за допомогою ImagePolicyWebhook. Підписи образів також можна автоматично перевіряти контролером допуску під час розгортання, щоб підтверджувати їхню автентичність і цілісність.
Сканування образу контейнера може запобігти потраплянню критичних вразливостей до кластера разом з образом. Сканування образу слід завершувати до розгортання образу контейнера в кластері, і зазвичай воно виконується як частина процесу розгортання в конвеєрі CI/CD. Мета сканування образу — отримати інформацію про можливі вразливості та їх запобігання в образі контейнера, наприклад оцінку Common Vulnerability Scoring System (CVSS). Якщо результати сканування поєднати з правилами відповідності конвеєра, до промислового середовища потраплять лише образи контейнерів із належними виправленнями.
Контролери допуску
Увімкнено відповідний набір контролерів допуску.
Політика безпеки Podʼів примусово застосовується за допомогою Pod Security Admission та/або контролера допуску на основі вебхука.
Втулки ланцюжка допуску та вебхуки налаштовано безпечно.
Контролери допуску можуть допомогти покращити безпеку кластера. Однак вони самі можуть становити ризики, оскільки розширюють API-сервер і мають бути належно захищені.
У наведених нижче списках подано низку контролерів допуску, які варто розглянути для покращення безпеки вашого кластера та застосунку. Сюди входять контролери, на які можуть бути посилання в інших частинах цього документа.
Ця перша група контролерів допуску містить втулки, стандартно ввімкнені. Залишайте їх увімкненими, якщо тільки не розумієте, що робите:
Обмежує дозволи kubelet лише зміною ресурсів API Podʼів, які йому належать, або ресурсу API вузла, що його представляє. Він також не дозволяє kubelet використовувати анотацію node-restriction.kubernetes.io/, яку зловмисник із доступом до облікових даних kubelet міг би використати, щоб впливати на розміщення Podʼів на контрольованому вузлі.
Третя група містить втулки, які стандартно не ввімкнені, але їх можна розглянути для певних сценаріїв використання:
Базові рекомендації щодо забезпечення безпеки застосунків у Kubernetes, орієнтовані на розробників застосунків.
Цей список перевірки містить основні рекомендації щодо захисту застосунків, що працюють у Kubernetes, з погляду розробника. Він не є вичерпним і змінюватиметься з часом.
Як читати та використовувати цей документ:
Порядок тем не відображає пріоритетність.
Деякі пункти списку детально описані в абзаці нижче списку кожного розділу.
Цей список передбачає, що розробник — це користувач кластера Kubernetes, який взаємодіє з обʼєктами в межах простору імен.
Увага:
Самих лише списків перевірки не достатньо для досягнення належного рівня безпеки. Належний рівень безпеки потребує постійної уваги та вдосконалення, але список перевірки може бути першим кроком на нескінченному шляху до готовності в питаннях безпеки. Деякі рекомендації в цьому списку можуть бути занадто суворими або занадто мʼякими для ваших конкретних потреб у безпеці. Оскільки безпека Kubernetes не є універсальною, кожну категорію пунктів списку слід оцінювати окремо.
Базове зміцнення безпеки
Наведений нижче список містить рекомендації з базового зміцнення безпеки, які стосуються більшості застосунків, що розгортаються в Kubernetes.
Дизайн застосунків
Дотримуйтеся відповідних принципів безпеки під час проєктування застосунків.
Застосунок налаштовано з відповідним класом QoS через запити й обмеження ресурсів.
Для робочих навантажень встановлено обмеження памʼяті, яке дорівнює запиту або перевищує його.
Для чутливих робочих навантажень можна встановити обмеження CPU.
ServiceAccount
Уникайте використання ServiceAccount default. Створюйте ServiceAccount для кожного робочого навантаження або мікросервісу.
automountServiceAccountToken слід встановити в false, якщо Podʼу не потрібен доступ до API Kubernetes для роботи.
Рекомендації для securityContext на рівні Podʼа
Встановіть runAsNonRoot: true.
Налаштуйте контейнер на виконання від імені менш привілейованого користувача (наприклад, за допомогою runAsUser і runAsGroup) і налаштуйте відповідні дозволи на файли або теки в образі контейнера.
За потреби додайте допоміжну групу через fsGroup для доступу до постійних томів.
Застосунок розгортається в просторі імен, де застосовується відповідний стандарт безпеки Podʼів. Якщо ви не можете контролювати це застосування в кластерах, де розгортається застосунок, врахуйте це в документації або через додатковий багаторівневий захист (defense in depth).
Рекомендації для securityContext на рівні контейнера
Вимкніть підвищення привілеїв за допомогою allowPrivilegeEscalation: false.
Налаштуйте кореневу файлову систему лише для читання за допомогою readOnlyRootFilesystem: true.
Вилучіть усі capabilities з контейнерів і поверніть лише ті, які потрібні для роботи контейнера.
Контроль доступу на основі ролей (RBAC)
Дозволи, такі як create, patch, update і delete, слід надавати лише за потребою.
Уникайте дозволів RBAC на створення або оновлення ролей, що може призвести до підвищення привілеїв.
Перегляньте привʼязки для групи system:unauthenticated і видаліть їх, якщо можливо, оскільки це надає доступ будь-кому, хто може підʼєднатися до API-сервера на мережевому рівні.
Для чутливих робочих навантажень розгляньте можливість надання рекомендованої ValidatingAdmissionPolicy, яка додатково обмежує дозволені дії запису.
Безпека образів
Використовуйте інструмент для сканування образів перед розгортанням контейнерів у кластері Kubernetes.
Використовуйте підписування контейнерів для перевірки підпису образу контейнера перед розгортанням у кластері Kubernetes.
Мережеві політики
Налаштуйте NetworkPolicies, щоб дозволити лише очікуваний вхідний та вихідний трафік Podʼів.
Переконайтеся, що ваш кластер підтримує та застосовує NetworkPolicy. Якщо ви пишете застосунок, який користувачі розгортатимуть у різних кластерах, подумайте, чи можна припускати, що NetworkPolicy доступна й застосовується.
Розширене зміцнення безпеки
У цьому розділі посібника розглянуто деякі розширені аспекти зміцнення безпеки, які можуть бути корисними залежно від налаштування середовища Kubernetes.
Налаштуйте відповідні класи виконання для контейнерів.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Деяким контейнерам може знадобитися інший рівень ізоляції, ніж той, що забезпечує стандартне середовище виконання кластера. runtimeClassName можна використовувати у podspec для визначення іншого класу виконання.
Для чутливих робочих навантажень розгляньте використання інструментів емуляції ядра, таких як gVisor, або віртуалізованої ізоляції за допомогою механізму, такого як kata-containers.
У середовищах із високою довірою розгляньте використання конфіденційних віртуальних машин, щоб ще більше підвищити безпеку кластера.
6.9 - Політики
Керування безпекою та найкращими практиками за допомогою політик.
Політики Kubernetes — це конфігурації, які керують іншими конфігураціями або поведінкою під час виконання. Kubernetes пропонує різні форми політик, описані нижче:
Застосування політик за допомогою обʼєктів API
Деякі обʼєкти API діють як політики. Ось кілька прикладів:
NetworkPolicies можна використовувати для обмеження вхідного та вихідного трафіку робочого навантаження.
LimitRanges керують обмеженнями розподілу ресурсів для різних типів обʼєктів.
Застосування політик за допомогою контролерів допуску
Контролер допуску працює в API-сервері та може перевіряти або змінювати запити до API. Деякі контролери допуску застосовують політики. Наприклад, контролер допуску AlwaysPullImages змінює новий Pod, встановлюючи для нього політику завантаження образу Always.
У Kubernetes є кілька вбудованих контролерів допуску, які можна налаштувати за допомогою прапорця --enable-admission-plugins API-сервера.
Детальні відомості про контролери допуску, з повним списком доступних контролерів допуску, ви знайдете в окремому розділі:
Застосування політик за допомогою ValidatingAdmissionPolicy
Політики перевірки допуску дають змогу виконувати налаштовувані перевірки в API-сервері за допомогою мови виразів Common Expression Language (CEL). Наприклад, ValidatingAdmissionPolicy можна використати, щоб заборонити використання теґу образу latest.
ValidatingAdmissionPolicy працює із запитом до API і може використовуватися для блокування, аудиту та попередження користувачів про невідповідні конфігурації.
Детальні відомості про API ValidatingAdmissionPolicy з прикладами ви знайдете в окремому розділі:
Застосування політик за допомогою динамічного контролю допуску
Динамічні контролери допуску (або вебхуки допуску) працюють поза API-сервером як окремі застосунки, які реєструються для отримання запитів вебхуків, щоб виконувати перевірку або зміну запитів до API.
Динамічні контролери допуску можна використовувати для застосування політик до запитів до API та запуску інших робочих процесів на основі політик. Динамічний контролер допуску може виконувати складні перевірки, зокрема ті, що потребують отримання інших ресурсів кластера та зовнішніх даних. Наприклад, перевірка образу може шукати дані в реєстрах OCI, щоб перевірити підписи та атестації образів контейнерів.
Детальні відомості про динамічний контроль допуску ви знайдете в окремому розділі:
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Динамічні контролери допуску, які діють як гнучкі рушії політик, розробляються в екосистемі Kubernetes, серед них:
Менеджери ресурсів вузлів можуть керувати обчислювальними ресурсами, памʼяттю та ресурсами пристроїв для робочих навантажень, критичних до затримок, і робочих навантажень із високою пропускною здатністю.
6.9.1 - Діапазони обмежень
Стандартно контейнери запускаються з необмеженими обчислювальними ресурсами у кластері Kubernetes. Використовуючи квоти ресурсів Kubernetes, адміністратори (також відомі як оператори кластера) можуть обмежувати споживання та створення ресурсів кластера (таких як час CPU, памʼять та постійне сховище) у визначеному просторі імен. У межах простору імен Pod може використовувати стільки CPU та памʼяті, скільки дозволяють ResourceQuotas, що застосовуються до цього простору імен. Як оператору кластера або адміністратору на рівні простору імен вам також може бути важливо переконатися, що один обʼєкт не може монополізувати всі доступні ресурси у просторі імен.
LimitRange — це політика для обмеження виділення ресурсів (обмежень і запитів), які можна вказати для кожного відповідного типу обʼєктів (такого як Pod або PersistentVolumeClaim) у просторі імен.
LimitRange надає обмеження, які можуть:
Застосовувати мінімальне та максимальне використання обчислювальних ресурсів на Pod або контейнер у просторі імен.
Застосовувати мінімальний та максимальний запит на сховище для PersistentVolumeClaim у просторі імен.
Застосовувати співвідношення між запитом та обмеженням для ресурсу у просторі імен.
Встановлювати стандартний запит/обмеження для обчислювальних ресурсів у просторі імен та автоматично додавати їх до контейнерів під час виконання.
Kubernetes обмежує виділення ресурсів для Podʼів у певному просторі імен, якщо у цьому просторі імен є хоча б один обʼєкт LimitRange.
Користувачі створюють (або намагаються створити) обʼєкти у цьому просторі імен, такі як Podʼи або PersistentVolumeClaims.
По-перше, контролер допуску LimitRange застосовує стандартні значення запиту та обмеження для всіх Podʼів (та їхніх контейнерів), які не задають вимог до обчислювальних ресурсів.
По-друге, LimitRange відстежує використання, щоб воно не перевищувало мінімум, максимум і співвідношення ресурсів, визначені в будь-якому LimitRange у цьому просторі імен.
Якщо ви намагаєтеся створити або оновити обʼєкт (Pod або PersistentVolumeClaim), який порушує обмеження LimitRange, ваш запит до API-сервера буде відхилено з HTTP-кодом стану 403 Forbidden та повідомленням, що пояснює порушене обмеження.
Якщо ви додаєте в простір імен LimitRange, який застосовується до обчислювальних ресурсів, таких як cpu та memory, ви повинні вказати запити або обмеження для цих значень. Інакше система може відхилити створення Podʼа.
Перевірка LimitRange відбувається лише на етапі допуску Podʼа, а не для запущених Podʼів. Якщо ви додаєте або змінюєте LimitRange, Podʼи, які вже існують у цьому просторі імен, залишаються без змін.
Якщо у просторі імен існує два або більше обʼєктів LimitRange, то не визначено, яке стандартне значення буде застосовано.
LimitRange та перевірки допуску для Podʼів
LimitRange не перевіряє узгодженість стандартних значень, які він застосовує. Це означає, що стандартне значення для limit, встановлене LimitRange, може бути меншим за значення request, вказане для контейнера в специфікації, яку клієнт надсилає до API-сервера. Якщо це станеться, фінальний Pod не буде придатним для планування.
Наприклад, ви визначаєте LimitRange таким маніфестом:
Примітка:
Наведені далі приклади працюють у просторі імен default вашого кластера, оскільки параметр namespace не визначено, а область дії LimitRange обмежена рівнем простору імен. Це означає, що будь-які посилання або операції в цих прикладах взаємодіятимуть з елементами в просторі імен default вашого кластера. Ви можете перевизначити робочий простір імен, налаштувавши namespace у полі metadata.namespace.
apiVersion:v1kind:LimitRangemetadata:name:cpu-resource-constraintspec:limits:- default:# ця секція визначає типові обмеженняcpu:500mdefaultRequest:# ця секція визначає типові запитиcpu:500mmax:# max та min визначають діапазон обмеженняcpu:"1"min:cpu:100mtype:Container
разом із Podʼом, який оголошує запит ресурсу CPU 700m, але не обмеження:
тоді цей Pod не буде заплановано, і він завершиться помилкою, схожою на таку:
Pod "example-conflict-with-limitrange-cpu" is invalid: spec.containers[0].resources.requests: Invalid value: "700m": must be less than or equal to cpu limit
Якщо ви встановите і request, і limit, то цей новий Pod буде успішно заплановано, навіть за наявності того самого LimitRange:
Приклади політик, які можна створити за допомогою LimitRange:
У кластері з 2 вузлів місткістю 8 GiB RAM та 16 ядер обмежте Podʼи в просторі імен запитом 100m CPU з максимальним обмеженням 500m для CPU та запитом 200Mi для памʼяті з максимальним обмеженням 600Mi для памʼяті.
Визначте стандартне обмеження та запит CPU на рівні 150m та стандартний запит памʼяті на рівні 300Mi для контейнерів, що запускаються без запитів CPU та памʼяті у своїх специфікаціях.
У випадку, коли загальні обмеження простору імен менші за суму обмежень Podʼів/контейнерів, може виникнути конкуренція за ресурси. У цьому випадку контейнери або Podʼи не будуть створені.
Ні конкуренція, ні зміни LimitRange не впливають на вже створені ресурси.
Коли кілька користувачів або команд спільно використовують кластер із фіксованою кількістю вузлів, існує ризик, що одна команда використає більше за свою справедливу частку ресурсів.
Квоти ресурсів — це інструмент, за допомогою якого адміністратори розвʼязують цю проблему.
Ані конкуренція, ані зміни до квоти не вплинуть на вже створені ресурси.
Як працюють ResourceQuotas у Kubernetes
ResourceQuotas працюють так:
Різні команди працюють у різних просторах імен. Цей поділ можна забезпечити за допомогою RBAC або будь-якого іншого механізму авторизації.
Адміністратор кластера створює принаймні одну ResourceQuota для кожного простору імен.
Щоб ці вимоги залишалися чинними, адміністратор кластера також повинен обмежити доступ до видалення або оновлення цієї ResourceQuota, наприклад, визначивши ValidatingAdmissionPolicy.
Користувачі створюють ресурси (Podʼи, Services тощо) у просторі імен, а система квот відстежує використання, щоб воно не перевищувало жорстких обмежень ресурсів, визначених у ResourceQuota.
Ви можете застосувати до ResourceQuota область дії, щоб обмежити, де вона застосовується.
Якщо створення або оновлення ресурсу порушує обмеження квоти, панель управління відхиляє цей запит із кодом стану HTTP 403 Forbidden. Помилка містить повідомлення з поясненням обмеження, яке було б порушено.
Якщо квоти увімкнено в просторі імен для таких ресурсів, як cpu та memory, користувачі повинні вказувати запити або обмеження для цих значень під час визначення Podʼа; інакше система квот може відхилити створення Podʼа.
Ви можете визначити LimitRange, щоб примусово встановлювати стандартні значення для Podʼів, які не задають вимог до обчислювальних ресурсів (щоб користувачам не доводилося памʼятати про це).
Часто ви не створюєте Podʼи безпосередньо; наприклад, ви зазвичай створюєте обʼєкт керування робочим навантаженням, такий як Deployment. Якщо ви створюєте Deployment, який намагається використати більше ресурсів, ніж доступно, створення Deployment (або іншого обʼєкта керування робочим навантаженням) буде успішним, але Deployment може бути не в змозі забезпечити існування всіх керованих ним Podʼів. У цьому випадку ви можете перевірити стан Deployment, наприклад, за допомогою kubectl describe, щоб дізнатися, що сталося.
Для ресурсів cpu та memory ResourceQuotas вимагають, щоб кожен (новий) Pod у цьому просторі імен встановлював обмеження для цього ресурсу. Якщо ви застосовуєте квоту ресурсів у просторі імен для cpu або memory, ви та інші клієнти повинні вказувати requests або limits для цього ресурсу для кожного нового Podʼа, який ви надсилаєте. Якщо ви цього не зробите, панель управління може відхилити допуск цього Podʼа.
Для інших ресурсів: ResourceQuota працює та ігнорує Podʼи в просторі імен, які не встановлюють обмеження або запит для цього ресурсу. Це означає, що ви можете створити новий Pod без обмеження/запиту тимчасового сховища, якщо квота ресурсів обмежує тимчасове сховище цього простору імен.
Ви можете використовувати LimitRange для автоматичного встановлення стандартного запиту для цих ресурсів.
Приклади політик, які можна створити за допомогою просторів імен та квот:
У кластері місткістю 32 GiB RAM і 16 ядер дозвольте команді A використовувати 20 GiB і 10 ядер, дозвольте команді B використовувати 10 GiB і 4 ядра, а 2 GiB і 2 ядра залиште в резерві для майбутнього розподілу.
Обмежте простір імен "testing" використанням 1 ядра та 1 GiB RAM. Дозвольте простору імен "production" використовувати будь-який обсяг.
У випадку, коли загальна місткість кластера менша за суму квот просторів імен, може виникнути конкуренція за ресурси. Це обробляється за принципом «перший прийшов — перший обслужений».
Увімкнення квоти ресурсів
Підтримка ResourceQuota стандартно увімкнена в багатьох дистрибутивах Kubernetes. Вона увімкнена, коли прапорець --enable-admission-plugins=API-сервера має ResourceQuota серед своїх аргументів.
Квота ресурсів застосовується в певному просторі імен, коли у цьому просторі імен є
ResourceQuota.
Типи квот ресурсів
Механізм ResourceQuota дозволяє застосовувати різні види обмежень. У цьому розділі описано типи обмежень, які можна застосовувати.
Квота на інфраструктурні ресурси
Ви можете обмежити загальну суму обчислювальних ресурсів, які можна запитати в певному просторі імен.
Підтримуються такі типи ресурсів:
Назва ресурсу
Опис
limits.cpu
Для всіх Podʼів у нетермінальному стані сума обмежень CPU не може перевищувати це значення.
limits.memory
Для всіх Podʼів у нетермінальному стані сума обмежень памʼяті не може перевищувати це значення.
requests.cpu
Для всіх Podʼів у нетермінальному стані сума запитів CPU не може перевищувати це значення.
requests.memory
Для всіх Podʼів у нетермінальному стані сума запитів памʼяті не може перевищувати це значення.
hugepages-<size>
Для всіх Podʼів у нетермінальному стані кількість запитів великих сторінок зазначеного розміру не може перевищувати це значення.
cpu
Те саме, що і requests.cpu
memory
Те саме, що і requests.memory
Квота для розширених ресурсів
Крім згаданих вище ресурсів, у випуску 1.10 було додано підтримку квот для розширених ресурсів.
Оскільки overcommit для розширених ресурсів не дозволяється, немає сенсу вказувати і requests, і limits для одного й того самого розширеного ресурсу у квоті. Тому для розширених ресурсів дозволені лише елементи квоти з префіксом requests..
Візьмімо як приклад ресурс GPU: якщо назва ресурсу — nvidia.com/gpu і ви хочете обмежити загальну кількість запитаних GPU в просторі імен до 4, ви можете визначити квоту так:
Запити на ресурси DRA (Dynamic Resource Allocation) можуть запитувати ресурси DRA за класом пристроїв. Наприклад, для класу пристроїв із назвою examplegpu, якщо ви хочете обмежити загальну кількість GPU, запитаних у просторі імен, до 4, ви можете визначити квоту так:
examplegpu.deviceclass.resource.k8s.io/devices: 4
Коли увімкнено виділення розширених ресурсів за допомогою DRA, той самий клас пристроїв із назвою examplegpu можна запитувати через розширений ресурс або явно, коли в полі ExtendedResourceName класу пристроїв задано, скажімо, example.com/gpu, тоді ви можете визначити квоту так:
requests.example.com/gpu: 4
або неявно, використовуючи похідну назву розширеного ресурсу від назви класу пристроїв examplegpu, тоді ви можете визначити квоту так:
Усі пристрої, запитані через запити на ресурси або розширені ресурси, враховуються у всіх трьох наведених вище квотах. Квота розширеного ресурсу, наприклад requests.example.com/gpu: 4, також враховує пристрої, надані втулком пристроїв.
Для всіх Podʼів у просторі імен сума запитів на локальне тимчасове сховище не може перевищувати це значення.
limits.ephemeral-storage
Для всіх Podʼів у просторі імен сума обмежень на локальне тимчасове сховище не може перевищувати це значення.
ephemeral-storage
Те саме, що і requests.ephemeral-storage.
Примітка:
Під час використання середовища виконання контейнерів CRI логи контейнерів зараховуються до квоти тимчасового сховища. Це може призвести до неочікуваного виселення Podʼів, які вичерпали свої квоти сховища.
Ви можете встановити квоту на загальну кількість одного конкретного типу ресурсу в API Kubernetes, використовуючи такий синтаксис:
count/<resource>.<group> для ресурсів із груп API, що не належать до основної (non-core)
count/<resource> для ресурсів з основної групи API (core)
Наприклад, API PodTemplate входить до основної групи API, тому, якщо ви хочете обмежити кількість обʼєктів PodTemplate у просторі імен, використовуйте count/podtemplates.
Такі типи квот корисні для захисту від вичерпання сховища панелі управління. Наприклад, ви можете обмежити кількість Secrets на сервері, враховуючи їхній великий розмір. Занадто велика кількість Secrets у кластері може фактично завадити запуску серверів і контролерів. Ви можете встановити квоту для Jobs, щоб захиститися від неправильно налаштованого CronJob. CronJobs, які створюють занадто багато Jobs у просторі імен, можуть призвести до відмови в обслуговуванні.
Якщо ви визначаєте квоту таким чином, вона застосовується до API Kubernetes, які є частиною API-сервера, та до будь-яких власних ресурсів, що підтримуються CustomResourceDefinition. Наприклад, щоб створити квоту на власний ресурс widgets у групі API example.com, використовуйте count/widgets.example.com. Якщо ви використовуєте агрегацію API для додавання власних API, які не визначені як CustomResourceDefinitions, основна панель управління Kubernetes не застосовує квоту до агрегованого API. Очікується, що сервер розширення API забезпечуватиме застосування квоти, якщо це доречно для цього власного API.
Загальний синтаксис
Нижче наведено список поширених прикладів типів обʼєктів, які ви можете захотіти підпорядкувати квоті на кількість обʼєктів, перелічених за рядками конфігурації, які ви будете використовувати.
count/pods
count/persistentvolumeclaims
count/services
count/secrets
count/configmaps
count/deployments.apps
count/replicasets.apps
count/statefulsets.apps
count/jobs.batch
count/cronjobs.batch
Спеціалізований синтаксис
Існує інший синтаксис для встановлення такого самого типу квоти, який працює лише для певних типів API. Підтримуються такі типи:
Назва ресурсу
Опис
configmaps
Загальна кількість ConfigMaps, які можуть існувати в просторі імен.
Загальна кількість Podʼів у нетермінальному стані, які можуть існувати в просторі імен. Pod перебуває в термінальному стані, якщо .status.phase in (Failed, Succeeded) є true.
replicationcontrollers
Загальна кількість ReplicationControllers, які можуть існувати в просторі імен.
resourcequotas
Загальна кількість ResourceQuotas, які можуть існувати в просторі імен.
services
Загальна кількість Services, які можуть існувати в просторі імен.
services.loadbalancers
Загальна кількість Services типу LoadBalancer, які можуть існувати в просторі імен.
services.nodeports
Загальна кількість NodePorts, виділених Services типу NodePort чи LoadBalancer, які можуть існувати в просторі імен.
secrets
Загальна кількість Secrets, які можуть існувати в просторі імен.
Наприклад, квота pods рахує та обмежує максимальну кількість pods, створених в одному просторі імен, які не є термінальними. Ви можете встановити квоту pods у просторі імен, щоб уникнути випадку, коли користувач створює багато невеликих Podʼів і вичерпує запас IP-адрес Podʼів у кластері.
Name: test
Namespace: myspace
Resource Used Hard
-------- ---- ----
count/deployments.apps 1 2
count/pods 2 3
count/replicasets.apps 1 4
count/secrets 1 4
Квота та місткість кластера
ResourceQuotas не залежать від місткості кластера. Вони виражаються в абсолютних одиницях. Отже, якщо ви додаєте вузли до свого кластера, це не дає автоматично кожному простору імен можливості споживати більше ресурсів.
Іноді можуть знадобитися більш складні політики, такі як:
Пропорційно розподіляти загальні ресурси кластера між кількома командами.
Дозволяти кожному орендарю збільшувати використання ресурсів за потреби, але мати щедре обмеження, щоб запобігти випадковому вичерпанню ресурсів.
Виявляти попит з боку одного простору імен, додавати вузли та збільшувати квоту.
Такі політики можна реалізувати, використовуючи ResourceQuotas як будівельні блоки, написавши «контролер», який стежить за використанням квот і коригує жорсткі обмеження квот кожного простору імен відповідно до інших сигналів.
Зверніть увагу, що квота ресурсів розподіляє сукупні ресурси кластера, але не створює обмежень щодо вузлів: Podʼи з кількох просторів імен можуть працювати на одному вузлі.
Області дії квоти
Кожна квота може мати повʼязаний набір scopes. Квота вимірюватиме використання ресурсу лише тоді, коли він відповідає перетину перелічених областей дії.
Коли до квоти додається область дії, вона обмежує кількість підтримуваних ресурсів тими, що стосуються цієї області дії. Ресурси, вказані у квоті поза дозволеним набором, призводять до помилки перевірки.
Відповідає PersistentVolumeClaims, які посилаються на вказаний клас атрибутів тому.
ResourceQuotas із заданою областю дії також можуть мати необовʼязкове поле scopeSelector. Ви визначаєте один або кілька виразів відповідності, які вказують operators і, якщо це доречно, набір values для відповідності. Наприклад:
scopeSelector:matchExpressions:- scopeName:BestEffort# Відповідає Podʼам із якістю обслуговування best-effortoperator:Exists# необовʼязково; для області дії BestEffort "Exists" мається на увазі
scopeSelector підтримує такі значення в полі operator:
In
NotIn
Exists
DoesNotExist
Якщо оператором є In або NotIn, поле values повинно мати щонайменше одне значення. Наприклад:
Якщо оператором є Exists або DoesNotExist, поле valuesНЕ повинно бути вказане.
Область дії для Podʼів Best effort
Ця область дії відстежує лише квоту, спожиту Podʼами. Вона відповідає лише Podʼам, які мають клас QoSbest-effort.
operator для scopeSelector повинен бути Exists.
Область дії для Podʼів Not-best-effort
Ця область дії відстежує лише квоту, спожиту Podʼами. Вона відповідає лише Podʼам, які мають клас QoSGuaranteed або Burstable.
operator для scopeSelector повинен бути Exists.
Область дії для Podʼів Non-terminating
Ця область дії відстежує лише квоту, спожиту Podʼами, які не завершуються. operator для scopeSelector повинен бути Exists.
Pod вважається таким, що не завершується, якщо поле .spec.activeDeadlineSeconds не встановлено.
Ви можете використовувати ResourceQuota з цією областю дії для керування такими ресурсами:
count.pods
pods
cpu
memory
requests.cpu
requests.memory
limits.cpu
limits.memory
Область дії Podʼів Terminating
Ця область дії відстежує лише квоту, спожиту Podʼами, які завершуються. operator для scopeSelector повинен бути Exists.
Pod вважається таким, що завершується, якщо поле .spec.activeDeadlineSeconds встановлено на будь-яке число.
Ви можете використовувати ResourceQuota з цією областю дії для керування такими ресурсами:
count.pods
pods
cpu
memory
requests.cpu
requests.memory
limits.cpu
limits.memory
Область дії спорідненості Podʼів між просторами імен
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Ви можете використовувати область дії квотиCrossNamespacePodAffinity, щоб обмежити, які простори імен можуть мати Podʼи з правилами спорідненості, що охоплюють кілька просторів імен. Зокрема, вона контролює, яким Podʼам дозволено встановлювати поля namespaces або namespaceSelector у правилах (анти)спорідненості Podʼів.
Може бути бажаним не дозволяти користувачам використовувати правила спорідненості між просторами імен, оскільки Pod з обмеженнями антиспорідненості може не дати Podʼам з усіх інших просторів імен бути запланованими в домені відмов.
За допомогою цієї області дії ви (як адміністратор кластера) можете заборонити певним просторам імен (наприклад, foo-ns у наведеному нижче прикладі) мати Podʼи, які використовують спорідненість Podʼів між просторами імен. Для цього створіть у цьому просторі імен обʼєкт ResourceQuota з областю дії CrossNamespacePodAffinity та жорстким обмеженням 0:
Якщо ви хочете стандартно заборонити використання namespaces та namespaceSelector і дозволити його лише для певних просторів імен, ви можете налаштувати CrossNamespacePodAffinity як обмежений ресурс, встановивши для прапорця kube-apiserver --admission-control-config-file шлях до такого конфігураційного файлу:
За такої конфігурації Podʼи можуть використовувати namespaces та namespaceSelector у спорідненості Podʼів лише тоді, коли простір імен, у якому вони створені, має обʼєкт квоти ресурсів з областю дії CrossNamespacePodAffinity та жорстким обмеженням, більшим або рівним кількості Podʼів, що використовують ці поля.
Область дії PriorityClass
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.17
ResourceQuota з областю дії PriorityClass відповідає лише тим Podʼам, які мають певний клас пріоритету, і лише якщо будь-який scopeSelector у специфікації квоти вибирає певний Pod.
Podʼи можна створювати з певним пріоритетом. Ви можете контролювати споживання системних ресурсів Podʼом на основі його пріоритету, використовуючи поле scopeSelector у специфікації квоти.
Коли область дії квоти задано для PriorityClass за допомогою поля scopeSelector, ResourceQuota може відстежувати (і обмежувати) лише такі ресурси:
pods
cpu
memory
ephemeral-storage
limits.cpu
limits.memory
limits.ephemeral-storage
requests.cpu
requests.memory
requests.ephemeral-storage
Приклад
Цей приклад створює ResourceQuota, яка відповідає Podʼам з певними пріоритетами. Приклад працює так:
Podʼи в кластері мають один із трьох PriorityClasses: "low", "medium", "high".
Якщо ви хочете спробувати це, використовуйте тестовий кластер і налаштуйте ці три PriorityClasses, перш ніж продовжувати.
Для кожного пріоритету створюється один обʼєкт квоти.
Перевірте, що статистика "Used" для квоти пріоритету "high", pods-high, змінилася, а інші дві квоти залишилися без змін.
kubectl describe quota
Name: pods-high
Namespace: default
Resource Used Hard
-------- ---- ----
cpu 500m 1k
memory 10Gi 200Gi
pods 1 10
Name: pods-low
Namespace: default
Resource Used Hard
-------- ---- ----
cpu 0 5
memory 0 10Gi
pods 0 10
Name: pods-medium
Namespace: default
Resource Used Hard
-------- ---- ----
cpu 0 10
memory 0 20Gi
pods 0 10
Стандартне обмеження споживання PriorityClass
Може бути бажаним, щоб Podʼи з певним пріоритетом, наприклад "cluster-services", дозволялися в просторі імен тоді й лише тоді, коли існує відповідний обʼєкт квоти.
За допомогою цього механізму оператори можуть обмежувати використання певних високопріоритетних класів обмеженою кількістю просторів імен, і не кожен простір імен зможе стандартно споживати ці класи пріоритету.
Для цього потрібно використати прапорець kube-apiserver--admission-control-config-file, щоб передати шлях до такого конфігураційного файлу:
У цьому випадку створення Podʼа буде дозволено, якщо:
priorityClassName Podʼа не вказано.
priorityClassName Podʼа має значення, відмінне від cluster-services.
priorityClassName Podʼа встановлено на cluster-services, Pod створюється у просторі імен kube-system і пройшов перевірку квоти ресурсів.
Запит на створення Podʼа буде відхилено, якщо його priorityClassName встановлено на cluster-services і Pod створюється в просторі імен, відмінному від kube-system.
Область дії VolumeAttributesClass
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate VolumeAttributesClass, Kubernetes ignores it but does not report any error.
Ця область дії відстежує лише квоту, спожиту PersistentVolumeClaims.
PersistentVolumeClaims можна створювати з певним VolumeAttributesClass і змінювати після створення. Ви можете контролювати споживання ресурсів сховища PVC на основі повʼязаних VolumeAttributesClasses, використовуючи поле scopeSelector у специфікації квоти.
PVC посилається на повʼязаний VolumeAttributesClass через такі поля:
Kubernetes дозволяє обмежувати кількість ідентифікаторів процесів (PID), які може використовувати Pod. Також можна зарезервувати певну кількість доступних для розподілу PID для кожного вузла для використання операційною системою та демонами (а не Podʼами).
Ідентифікатори процесів (PID) є фундаментальним ресурсом на вузлах. Досягти обмеження на кількість завдань, не досягнувши жодних інших обмежень ресурсів, дуже просто, і це може призвести до нестабільної роботи хост-машини.
Адміністраторам кластерів потрібні механізми, щоб гарантувати, що Podʼи, які працюють у кластері, не зможуть спричинити вичерпання PID, яке перешкоджає роботі демонів хоста (таких як kubelet або kube-proxy, а потенційно й середовище виконання контейнерів). Крім того, важливо обмежувати PID між Podʼами, щоб вони мали обмежений вплив на інші робочі навантаження на тому самому вузлі.
Примітка:
На деяких інсталяціях Linux операційна система стандартно встановлює низьке обмеження PID, наприклад 32768. Розгляньте можливість збільшення значення /proc/sys/kernel/pid_max.
Ви можете налаштувати kubelet для обмеження кількості PID, які може споживати конкретний Pod. Наприклад, якщо ОС хоста вашого вузла налаштовано на використання максимум 262144 PID і очікується, що на ньому розміщуватиметься менше ніж 250 Podʼів, можна надати кожному Podʼу бюджет у 1000 PID, щоб запобігти вичерпанню загальної кількості доступних PID на вузлі. Якщо адміністратор хоче застосувати overcommit для PID, як для CPU чи памʼяті, це теж можливо, але з певними додатковими ризиками. У будь-якому випадку один Pod не зможе вивести з ладу всю машину. Цей вид обмеження ресурсів допомагає запобігти впливу простих форк-бомб на роботу всього кластера.
Обмеження PID на рівні Podʼа дозволяє адміністраторам захистити один Pod від іншого, але не гарантує, що всі Podʼи, заплановані на цей хост, не зможуть вплинути на вузол загалом. Обмеження на рівні Podʼа також не захищає самі агенти вузла від вичерпання PID.
Ви також можете зарезервувати певну кількість PID для накладних витрат вузла, окремо від виділених для Podʼів. Це подібно до того, як ви можете резервувати CPU, памʼять чи інші ресурси для використання операційною системою та іншими засобами поза Podʼами та їхніми контейнерами.
Обмеження PID є важливим доповненням до запитів і обмежень обчислювальних ресурсів. Однак ви вказуєте його інакше: замість того, щоб визначати обмеження ресурсу Podʼа в .spec Podʼа, ви налаштовуєте обмеження як параметр kubelet. Обмеження PID, визначені в Podʼі, наразі не підтримуються.
Увага:
Це означає, що обмеження, яке застосовується до Podʼа, може відрізнятися залежно від того, куди заплановано Pod. Щоб спростити ситуацію, найкраще, щоб усі вузли використовували однакові обмеження та резервування ресурсу PID.
Обмеження PID вузла
Kubernetes дозволяє зарезервувати певну кількість ідентифікаторів процесів для системного використання. Щоб налаштувати резервування, використовуйте параметр pid=<кількість> у параметрах командного рядка kubelet --system-reserved та --kube-reserved. Вказане вами значення оголошує, що вказану кількість ідентифікаторів процесів буде зарезервовано відповідно для системи в цілому та для системних демонів Kubernetes.
Обмеження PID на рівні Podʼа
Kubernetes дозволяє обмежити кількість процесів, запущених у Podʼі. Ви вказуєте це обмеження на рівні вузла, а не налаштовуєте його як обмеження ресурсів для певного Podʼа. Кожен вузол може мати власне обмеження PID. Щоб налаштувати обмеження, ви можете вказати параметр командного рядка kubelet --pod-max-pids або встановити PodPidsLimit у конфігураційному файлі kubelet.
Виселення на основі PID
Ви можете налаштувати kubelet так, щоб він починав завершувати Pod, коли той поводиться некоректно та споживає аномальну кількість ресурсів. Ця можливість називається виселенням (eviction). Ви можете налаштувати обробку випадків нестачі ресурсів для різних сигналів виселення. Використовуйте сигнал виселення pid.available, щоб налаштувати поріг кількості PID, які використовує Pod. Ви можете встановити мʼякі та жорсткі політики виселення. Однак навіть із жорсткою політикою виселення, якщо кількість PID зростає дуже швидко, вузол усе ще може перейти в нестабільний стан, досягнувши обмеження PID вузла. Значення сигналу виселення обчислюється періодично і НЕ забезпечує дотримання обмеження.
Обмеження PID — на рівні Podʼа та на рівні вузла — встановлює жорстку межу. Щойно її буде досягнуто, робоче навантаження почне отримувати помилки під час спроб отримати новий PID. Це може призвести або не призвести до повторного планування Podʼа, залежно від того, як робоче навантаження реагує на ці помилки та як для Podʼа налаштовано проби життєздатності та готовності. Однак, якщо обмеження встановлено правильно, ви можете гарантувати, що робочі навантаження інших Podʼів та системні процеси не вичерпають PID, коли один Pod поводиться некоректно.
У Kubernetes планування означає забезпечення відповідності Podʼіввузлам, щоб kubelet міг їх запустити. Витіснення — це процес завершення роботи Podʼів з нижчим пріоритетом, щоб Podʼи з вищим пріоритетом могли плануватися на вузлах. Виселення — це процес завершення роботи одного або кількох Podʼів на вузлах.
Порушення роботи Podʼа — це процес, під час якого Podʼи на вузлах припиняють роботу добровільно або примусово.
Добровільне порушення навмисно запускають власники застосунків або адміністратори кластера. Невідворотне порушення є ненавмисним і може бути спричинене неминучими проблемами, такими як вичерпання ресурсів вузлів, або випадковим видаленням.
Kubernetes дозволяє запускати кілька планувальників в одному кластері.
Ця сторінка описує загальні принципи запуску кількох планувальників у кластері, припускаючи, що принаймні один із цих планувальників є стандартним kube-scheduler. Якщо ви запускаєте лише власні або сторонні планувальники, зверніться до їхньої документації.
Стратегії розгортання
Під час запуску кількох планувальників ви повинні вирішити, як вони взаємодіють один з одним та з вузлами кластера. Існує три поширені сценарії розгортання:
Висока доступність (репліки у стані очікування)
Якщо ви хочете запустити єдиний логічний планувальник (такий як kube-scheduler), але забезпечити його доступність у разі збою, ви повинні запустити кілька реплік планувальника та увімкнути вибір лідера (leader election).
Коли вибір лідера увімкнено, лише одна репліка (лідер) є активною та планує Podʼи, тоді як інші залишаються в режимі очікування. Якщо активний лідер зазнає збою, одна з реплік у стані очікування автоматично виграє вибори лідера та переймає роботу з планування.
Якщо ви хочете використовувати різні конфігурації або правила планування для різних робочих навантажень, ви можете налаштувати один екземпляр kube-scheduler з кількома профілями планування або запустити кілька окремих екземплярів kube-scheduler.
Кілька профілів в одному екземплярі: Один процес kube-scheduler може запускати кілька профілів (кожен з унікальною назвою планувальника). Оскільки ці профілі працюють в одному процесі та спільно використовують одну чергу планування та кеш, вони не приймають конфліктних рішень щодо планування. Ви все ще можете використовувати спорідненість вузлів, якщо хочете ізолювати робочі навантаження, спрямовуючи кожен профіль до певного пулу вузлів.
Кілька окремих екземплярів: Якщо ви запускаєте кілька окремих процесів kube-scheduler (розгортання), вони не координуються між собою і можуть приймати конфліктні рішення щодо планування (наприклад, виділяти ресурси вузла понад наявні). Щоб цього уникнути, кожен екземпляр планувальника має націлюватися на неперетинну множину вузлів за допомогою спорідненості вузлів.
Поєднання kube-scheduler з власними планувальниками
Якщо ви запускаєте kube-scheduler разом із власними або сторонніми планувальниками, запускайте їх на різних пулах вузлів, щоб уникнути конфліктів ресурсів. Залежно від того, як спроєктований ваш власний планувальник, він може підтримувати роботу в конфігурації active-active або вимагати власного механізму вибору лідера. Завжди перевіряйте документацію до вашого власного планувальника.
У Kubernetes планування означає забезпечення відповідності Podʼіввузлам, щоб Kubelet міг їх запустити.
Огляд планування
Планувальник відстежує новостворені Podʼи, які не мають призначеного вузла. Для кожного виявленого Podʼа планувальник стає відповідальним за пошук найкращого вузла для його запуску. Планувальник приймає рішення про розміщення Podʼа, враховуючи принципи планування, описані нижче.
Якщо ви хочете зрозуміти, чому Podʼи розміщуються на певному вузлі, або якщо ви плануєте реалізувати власний планувальник, ця сторінка допоможе вам дізнатися більше про планування.
kube-scheduler
kube-scheduler є стандартним планувальником для Kubernetes і працює як частина панелі управління. kube-scheduler розроблено так, що, якщо ви хочете і вам треба, ви можете написати власний компонент планування і використовувати його замість стандартного.
Kube-scheduler вибирає оптимальний вузол для запуску нових або ще не запланованих Podʼів. Оскільки контейнери в Podʼах, і самі Podʼи, можуть мати різні вимоги, планувальник відфільтровує будь-які вузли, які не відповідають конкретним потребам планування Podʼа. Крім того, через API можна вказати вузол для Podʼа під час його створення, але це робиться тільки у виняткових випадках.
У кластері вузли, які відповідають вимогам планування для Podʼа, називаються придатними (feasible) вузлами. Якщо жоден з вузлів не підходить, Pod залишається незапланованим до тих пір, поки планувальник не зможе розмістити його.
Планувальник знаходить придатні вузли для Podʼів, а потім виконує набір функцій для оцінки таких вузлів і вибирає вузол з найвищою оцінкою серед придатних для запуску Podʼа. Потім планувальник повідомляє API-сервер про це рішення в процесі, який називається привʼязкою (binding).
Фактори, які потрібно враховувати під час прийняття рішень про планування, включають індивідуальні та загальні вимоги до ресурсів, обмеження апаратного забезпечення, програмного забезпечення та політик, специфікації спорідненості та антиспорідненості, розташування даних, взаємовплив між робочими навантаженнями та інше.
Вибір вузла в kube-scheduler
kube-scheduler вибирає вузол для Podʼа в два етапи:
Фільтрація.
Оцінювання.
На етапі фільтрації визначається набір вузлів, на яких можна розмістити Pod. Наприклад, фільтр PodFitsResources перевіряє, чи має вузол-кандидат достатньо доступних ресурсів, щоб задовольнити конкретні запити Podʼа на ресурси. Після цього етапу список вузлів містить придатні вузли; часто їх буде більше одного. Якщо список порожній, цей Pod (поки що) неможливо запланувати.
На етапі оцінювання планувальник ранжує вузли, що залишилися, щоб вибрати найбільш придатне розміщення для Podʼа. Планувальник надає кожному вузлу, який залишився після фільтрації, оцінку, базуючись на активних правилах оцінки.
На останньому етапі kube-scheduler призначає Pod вузлу з найвищим рейтингом. Якщо є більше одного вузла з однаковими оцінками, kube-scheduler вибирає один з них випадковим чином.
Є два підтримуваних способи налаштування поведінки фільтрації та оцінювання планувальника:
Політики планування дозволяють налаштувати Предикати для фільтрації та Пріоритети для оцінювання.
Профілі планування дозволяють налаштувати втулки, які реалізують різні етапи планування, включаючи: QueueSort, Filter, Score, Bind, Reserve, Permit та інші. Ви також можете налаштувати kube-scheduler для запуску різних профілів.
Ви можете обмежити Pod так, щоб він міг запускатися лише на конкретних вузлах або віддавав перевагу запуску на певних вузлах. Є кілька способів зробити це, і всі рекомендовані підходи використовують селектори міток для полегшення вибору. Зазвичай вам не потрібно встановлювати жодні обмеження такого роду; планувальник автоматично робить розумне розміщення (наприклад, розподіл Podʼів по вузлах так, щоб не розміщувати Podʼи на вузлі з недостатньою кількістю вільних ресурсів). Однак є обставини, коли ви можете захотіти контролювати, на якому вузлі розгортається Pod, наприклад, щоб переконатися, що Pod потрапляє на вузол з прикріпленим до нього SSD, або щоб розмістити в одній зоні доступності Podʼи двох різних сервісів, які багато взаємодіють.
Ви можете використовувати будь-який з наступних методів для вибору місця, де Kubernetes планує конкретні Podʼи:
Значення цих міток залежить від хмарного провайдера, і їх надійність не гарантується. Наприклад, значення kubernetes.io/hostname може бути таким самим, як назва вузла, у деяких середовищах і відрізнятися в інших середовищах.
Ізоляція/обмеження вузлів
Додавання міток до вузлів дозволяє спрямовувати Podʼи на планування на конкретних вузлах або групах вузлів. Ви можете використовувати цю функціональність, щоб забезпечити, що певні Podʼи працюватимуть тільки на вузлах із певною ізоляцією, безпекою або регуляторними властивостями.
Якщо ви використовуєте мітки для ізоляції вузлів, обирайте ключі міток, які kubelet не може змінювати. Це заважає скомпрометованому вузлу встановлювати ці мітки на себе, щоб планувальник планував робочі навантаження на скомпрометований вузол.
Втулок допуску NodeRestriction перешкоджає kubelet встановлювати або змінювати мітки з префіксом node-restriction.kubernetes.io/.
Щоб скористатися цим префіксом міток для ізоляції вузлів:
Переконайтеся, що ви використовуєте авторизатор вузлів і увімкнули втулок допуску NodeRestriction.
Додайте мітки з префіксом node-restriction.kubernetes.io/ на ваші вузли, і використовуйте ці мітки у ваших селекторах вузлів. Наприклад, example.com.node-restriction.kubernetes.io/fips=true або example.com.node-restriction.kubernetes.io/pci-dss=true.
nodeSelector
nodeSelector є найпростішим рекомендованим способом обмеження вибору вузла. Ви можете додати поле nodeSelector до специфікації вашого Podʼа і вказати мітки вузла, які має мати цільовий вузол. Kubernetes розміщує Pod лише на тих вузлах, які мають всі мітки, які ви вказали.
nodeSelector є найпростішим способом обмежити Podʼи вузлами з певними мітками. Спорідненість та антиспорідненість розширюють типи обмежень, які ви можете визначити. Деякі з переваг спорідненості та антиспорідненості включають:
Мова (анти)спорідненості є більш виразною. nodeSelector вибирає лише вузли з усіма вказаними мітками. (Анти)спорідненість дає вам більший контроль над логікою вибору.
Ви можете вказати, що правило є soft або preferred, щоб планувальник все одно запланував Pod, навіть якщо не може знайти відповідний вузол.
Ви можете обмежити Pod, використовуючи мітки на інших Podʼах, які працюють на вузлі (або в іншому топологічному домені), а не лише мітки вузла, що дозволяє визначати правила для того, які Podʼи можуть бути розміщені разом на вузлі.
Можливість affinity складається з двох типів спорідненості:
Спорідненість вузла працює подібно до поля nodeSelector, але є виразнішою і дозволяє вказувати мʼякі правила.
(Анти)спорідненість між Podʼами дозволяє обмежувати Podʼи відносно міток інших Podʼів.
Спорідненість вузлів
Спорідненість вузлів концептуально подібна до nodeSelector і дозволяє вам обмежувати, на яких вузлах може бути запланований ваш Pod на основі міток вузла. Існують два типи спорідненості вузла:
requiredDuringSchedulingIgnoredDuringExecution: Планувальник не може запланувати Pod, якщо правило не виконується. Це працює подібно до nodeSelector, але з більш виразним синтаксисом.
preferredDuringSchedulingIgnoredDuringExecution: Планувальник намагається знайти вузол, який відповідає правилу. Якщо відповідний вузол недоступний, планувальник все одно планує Pod.
Примітка:
У попередніх типах IgnoredDuringExecution означає, що якщо мітки вузла змінюються після того, як Kubernetes запланував Pod, Pod продовжує працювати.
Ви можете вказати спорідненість вузлів, використовуючи поле .spec.affinity.nodeAffinity в специфікації вашого Podʼа.
Наприклад, розгляньте наступну специфікацію Podʼа:
Вузол повинен мати мітку з ключем topology.kubernetes.io/zone, а значення цієї мітки повинно бути або antarctica-east1, або antarctica-west1.
Вузол бажано має мітку з ключем another-node-label-key, а значення another-node-label-value.
Ви можете використовувати поле operator, щоб вказати логічний оператор, який Kubernetes буде використовувати під час інтерпретації правил. Ви можете використовувати In, NotIn, Exists, DoesNotExist, Gt і Lt.
Прочитайте розділ Оператори, щоб дізнатися більше про те, як вони працюють.
NotIn та DoesNotExist дозволяють визначати поведінку антиспорідненості. Як альтернативу ви можете використовувати taints вузлів для відштовхування Podʼів від конкретних вузлів.
Примітка:
Якщо ви вказуєте як nodeSelector, так і nodeAffinity, обидва вони повинні задовольнятися для того, щоб Pod був запланований на вузол.
Якщо ви вказуєте кілька умов в nodeSelectorTerms, повʼязаних з типами nodeAffinity, то Pod може бути запланований на вузол, якщо одна з вказаних умов може бути задоволеною (умови зʼєднуються логічним OR).
Якщо ви вказуєте кілька виразів в одному полі matchExpressions, повʼязаному з умовою в nodeSelectorTerms, то Pod може бути запланований на вузол лише в тому випадку, якщо всі вирази задовольняються (вирази зʼєднуються логічним AND).
Ви можете вказати weight (вагу) від 1 до 100 для кожного екземпляра спорідненості типу preferredDuringSchedulingIgnoredDuringExecution. Коли планувальник знаходить вузли, які відповідають усім іншим вимогам планування Podʼа, планувальник проходить по кожному правилу preferred, якому задовольняє вузол, і додає значення weight для цього виразу до суми.
Кінцева сума додається до оцінки інших функцій пріоритету для вузла. Вузли з найвищою загальною оцінкою отримують пріоритет, коли планувальник приймає рішення щодо планування Podʼа.
Наприклад, розгляньте наступну специфікацію Podʼа:
Якщо існують два можливих вузли, які відповідають правилу preferredDuringSchedulingIgnoredDuringExecution, один з міткою label-1:key-1, а інший з міткою label-2:key-2, планувальник бере до уваги weight кожного вузла і додає вагу до інших оцінок для цього вузла, і планує Pod на вузол з найвищою кінцевою оцінкою.
Примітка:
Якщо ви хочете, щоб Kubernetes успішно запланував Podʼи в цьому прикладі, вам потрібно мати наявні вузли з міткою kubernetes.io/os=linux.
Спорідненість вузлів для кожного профілю планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.20
Під час налаштування кількох профілів планування ви можете повʼязати профіль зі спорідненістю вузлів, що є корисним, якщо профіль застосовується лише до певного набору вузлів. Для цього додайте addedAffinity до поля args втулка NodeAffinity у конфігурації планувальника. Наприклад:
addedAffinity застосовується до всіх Podʼів, які встановлюють .spec.schedulerName в foo-scheduler, на додачу до NodeAffinity, вказаного в PodSpec. Тобто, щоб відповідати Podʼу, вузли мають задовольняти addedAffinity та .spec.NodeAffinity Podʼа.
Оскільки addedAffinity не є видимим для кінцевих користувачів, його поведінка може бути неочікуваною для них. Використовуйте мітки вузлів, які мають чіткий взаємозвʼязок із назвою профілю планувальника.
Примітка:
Контролер DaemonSet, який створює Podʼи для DaemonSet, не підтримує профілі планування. Коли контролер DaemonSet створює Podʼи, стандартний планувальник Kubernetes розміщує ці Podʼи та дотримується будь-яких правил nodeAffinity в контролері DaemonSet.
Спорідненість та антиспорідненість між Podʼами
Спорідненість та антиспорідненість між Podʼами дозволяють обмежити, на яких вузлах ваші Podʼи можуть бути заплановані на основі міток Podʼів, які вже працюють на цьому вузлі, а не міток вузлів.
Типи спорідненості та антиспорідненості між Podʼами
Спорідненість та антиспорідненість між Podʼами мають такий вигляд: «цей Pod повинен (або, у випадку антиспорідненості, не повинен) працювати у X, якщо на цьому X вже працюють один або кілька Podʼів, які задовольняють правило Y», де X є топологічним доменом, таким як вузол, стійка, зона або регіон хмарного провайдера чи щось подібне, а Y — це правило, яке Kubernetes намагається задовольнити.
Ви виражаєте ці правила (Y) як селектори міток з необовʼязковим повʼязаним списком просторів імен. Podʼи є обʼєктами з простором імен в Kubernetes, тому мітки Podʼів також неявно мають простори імен. Будь-які селектори міток для міток Podʼа повинні вказувати простори імен, в яких Kubernetes має переглядати ці мітки.
Ви виражаєте топологічний домен (X), використовуючи topologyKey, який є ключем для мітки вузла, яку система використовує для позначення домену. Для прикладу дивіться у Відомі мітки, анотації та taints.
Примітка:
Спорідненість та антиспорідненість між Podʼами потребують значних обсягів обчислень, що може значно сповільнити планування у великих кластерах. Ми не рекомендуємо використовувати їх у кластерах розміром понад кілька сотень вузлів.
Примітка:
Антиспорідненість Podʼа вимагає, щоб вузли мали узгоджені мітки, іншими словами, кожен вузол в кластері повинен мати відповідну мітку, яка відповідає topologyKey. Якщо деякі або всі вузли не мають вказаної мітки topologyKey, це може призвести до непередбачуваної поведінки.
Подібно до спорідненості вузлів, існують два типи спорідненості та антиспорідненості Podʼа:
requiredDuringSchedulingIgnoredDuringExecution
preferredDuringSchedulingIgnoredDuringExecution
Наприклад, ви можете використовувати спорідненість requiredDuringSchedulingIgnoredDuringExecution,
щоб повідомити планувальнику про те, що потрібно розмістити Podʼи двох сервісів в одній зоні хмарного провайдера, оскільки вони взаємодіють між собою дуже часто. Так само ви можете використовувати антиспорідненість
preferredDuringSchedulingIgnoredDuringExecution, щоб розподілити Podʼи сервісу по різних зонах хмарного провайдера.
Для використання спорідненості між Podʼами використовуйте поле affinity.podAffinity в специфікації Podʼа. Для антиспорідненості між Podʼами використовуйте поле affinity.podAntiAffinity в специфікації Podʼа.
Поведінка планування
Під час планування нового Podʼа планувальник Kubernetes оцінює правила спорідненості/антиспорідненості Podʼа в контексті поточного стану кластера:
Жорсткі обмеження (фільтрація вузлів):
podAffinity.requiredDuringSchedulingIgnoredDuringExecution та podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution:
Планувальник гарантує, що новий Pod буде призначено вузлам, які задовольняють ці обовʼязкові правила спорідненості та антиспорідненості, на основі наявних Podʼів.
Мʼякі обмеження (оцінювання):
podAffinity.preferredDuringSchedulingIgnoredDuringExecution та podAntiAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Планувальник оцінює вузли на основі того, наскільки добре вони відповідають цим бажаним правилам спорідненості та антиспорідненості, щоб оптимізувати розміщення Podʼів.
Ігноровані поля:
Наявні в Podʼах podAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Ці бажані правила спорідненості не враховуються під час прийняття рішення щодо планування нових Podʼів.
Наявні в Podʼах podAntiAffinity.preferredDuringSchedulingIgnoredDuringExecution:
Аналогічно, під час планування ігноруються бажані правила антиспорідненості наявних Podʼів.
Планування групи Podʼів зі спорідненістю між собою
Якщо поточний Pod, який планується, є першим у серії Podʼів, що мають спорідненість між собою, його можна планувати, якщо він проходить всі інші перевірки спорідненості. Це визначається тим, що не існує іншого Podʼа в кластері, який відповідає простору імен та селектору цього Podʼа, що Pod відповідає власним умовам і обраний вузол відповідає всім запитаним топологіям. Це забезпечує відсутність взаємного блокування навіть у випадку, якщо всі Podʼи мають вказану спорідненість між Podʼами.
У цьому прикладі визначено одне правило спорідненості Podʼа та одне правило антиспорідненості Podʼа. Правило спорідненості Podʼа використовує «hard» requiredDuringSchedulingIgnoredDuringExecution, тоді як правило антиспорідненості використовує «soft» preferredDuringSchedulingIgnoredDuringExecution.
Правило спорідненості вказує, що планувальник може розмістити Pod лише на вузлі, який належить до певної зони, де інші Podʼи мають мітку security=S1. Наприклад, якщо у нас є кластер із призначеною зоною, скажімо, «Zone V», що складається з вузлів з міткою topology.kubernetes.io/zone=V, планувальник може призначити Pod на будь-який вузол у Zone V, якщо принаймні один Pod у Zone V вже має мітку security=S1. І навпаки, якщо в Zone V немає Podʼів з мітками security=S1, планувальник не призначить Pod з прикладу ні на один вузол в цій зоні.
Правило антиспорідненості вказує, що планувальник повинен уникати призначення Podʼа на вузол, якщо цей вузол належить до певної зони, де інші Podʼи мають мітку security=S2. Наприклад, якщо у нас є кластер із призначеною зоною, скажімо, «Zone R», що складається з вузлів з міткою topology.kubernetes.io/zone=R, планувальник повинен уникати призначення Podʼа на будь-який вузол у Zone R, якщо принаймні один Pod у Zone R вже має мітку security=S2. І навпаки, правило антиспорідненості не впливає на планування у Zone R, якщо немає Podʼів з мітками security=S2.
Щоб ближче ознайомитися з прикладами спорідненості та антиспорідненості Podʼів, зверніться до проєктної документації.
В полі operator для спорідненості та антиспорідненості Podʼа можна використовувати значення In, NotIn, Exists та DoesNotExist.
Для отримання додаткової інформації про те, як це працює, перегляньте Оператори.
У принципі, topologyKey може бути будь-яким допустимим ключем мітки з такими винятками з причин продуктивності та безпеки:
Для спорідненості та антиспорідненості Podʼа порожнє поле topologyKey не дозволяється як для requiredDuringSchedulingIgnoredDuringExecution, так і для preferredDuringSchedulingIgnoredDuringExecution.
Для правил антиспорідненості Podʼа requiredDuringSchedulingIgnoredDuringExecution контролер допуску LimitPodHardAntiAffinityTopology обмежує topologyKey до kubernetes.io/hostname. Ви можете змінити або вимкнути контролер допуску, якщо хочете дозволити власні топології.
Крім labelSelector та topologyKey, ви можете за бажанням вказати список просторів імен, з якими labelSelector повинен зіставлятися, використовуючи поле namespaces на тому ж рівні, що й labelSelector та topologyKey. Якщо поле відсутнє або порожнє, namespaces стандартно відповідає простору імен Podʼа, де зʼявляється визначення спорідненості/антиспорідненості.
Селектор простору імен
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Ви також можете вибирати відповідні простори імен за допомогою namespaceSelector, який є запитом міток до набору просторів імен. Умова спорідненості застосовується до просторів імен, вибраних як namespaceSelector, так і полем namespaces. Зверніть увагу, що порожній namespaceSelector ({}) відповідає всім просторам імен, тоді як null або порожній список namespaces і null namespaceSelector відповідають простору імен Podʼа, де визначено правило.
matchLabelKeys
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate MatchLabelKeysInPodAffinity, Kubernetes ignores it but does not report any error.
Примітка:
Поле matchLabelKeys перебуває на рівні бета-версії та є стандартно увімкненим в Kubernetes 1.37. Якщо ви бажаєте його вимкнути, вам потрібно зробити це явним чином за допомогою вимкнення функціональної можливості MatchLabelKeysInPodAffinity.
У Kubernetes є необовʼязкове поле matchLabelKeys для спорідненості або антиспорідненості Podʼа. Це поле вказує ключі для міток, які повинні відповідати міткам вхідного Podʼа під час задоволення спорідненості (антиспорідненості) Podʼа.
Ці ключі використовуються для отримання значень з міток Podʼа; ці ключ-значення міток поєднуються (використовуючи AND) з обмеженнями відповідно до поля labelSelector. Обʼєднане фільтрування вибирає набір наявних Podʼів, які будуть враховуватися під час розрахунку спорідненості (антиспорідненості) Podʼа.
Увага:
Не рекомендується використовувати matchLabelKeys з мітками, які можуть оновлюватися безпосередньо на Podʼах. Навіть якщо ви редагуєте мітку Podʼів, вказану у matchLabelKeys, безпосередньо, (тобто не через deployment), kube-apiserver не відобразить оновлення мітки в обʼєднаному labelSelector.
Поширеним випадком є використання matchLabelKeys разом із pod-template-hash (встановленим у Podʼах, керованих як частина Deployment, де значення унікальне для кожної ревізії). Використання pod-template-hash в matchLabelKeys дозволяє вам спрямовувати Podʼи, які належать до тієї ж ревізії, що й вхідний Pod, щоб поетапне оновлення не порушувало спорідненість.
apiVersion:apps/v1kind:Deploymentmetadata:name:application-server...spec:template:spec:affinity:podAffinity:requiredDuringSchedulingIgnoredDuringExecution:- labelSelector:matchExpressions:- key:appoperator:Invalues:- databasetopologyKey:topology.kubernetes.io/zone# Тільки Podʼи з певного розгортання беруться до уваги під час обчислення спорідненості Podʼа.# Якщо ви оновите Deployment, Podʼи-замінники дотримуватимуться своїх власних правил спорідненості# (якщо вони визначені в новому шаблоні Podʼа).matchLabelKeys:- pod-template-hash
mismatchLabelKeys
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.33
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.29 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate MatchLabelKeysInPodAffinity, Kubernetes ignores it but does not report any error.
Примітка:
Поле mismatchLabelKeys перебуває на рівні бета-версії та є стандартно увімкненим в Kubernetes 1.37. Якщо ви бажаєте його вимкнути, вам потрібно зробити це явним чином за допомогою вимкнення функціональної можливості MatchLabelKeysInPodAffinity.
Kubernetes включає необовʼязкове поле mismatchLabelKeys для спорідненості або антиспорідненості Podʼа. Це поле вказує ключі для міток, які не повинні мати збігу з мітками вхідного Podʼа, під час задоволення спорідненості чи антиспорідненості Podʼа.
Увага:
Не рекомендується використовувати mismatchLabelKeys з мітками, які можуть оновлюватися безпосередньо на Podʼах. Навіть якщо ви відредагуєте мітку Podʼів, вказану у mismatchLabelKeys, безпосередньо (тобто не через deployment), kube-apiserver не відобразить оновлення мітки в обʼєднаному labelSelector.
Один з прикладів використання — це забезпечення того, що Podʼи будуть розміщені в топологічному домені (вузол, зона і т. д.), де розміщені лише Podʼи від того ж орендаря або команди. Іншими словами, ви хочете уникнути запуску Podʼів від двох різних орендарів в одному топологічному домені одночасно.
apiVersion:v1kind:Podmetadata:labels:# Припустимо, що всі відповідні Podʼи мають встановлену мітку "tenant"tenant:tenant-a...spec:affinity:podAffinity:requiredDuringSchedulingIgnoredDuringExecution:# переконаємось, що Podʼи, повʼязані з цим орендарем, потрапляють у відповідний пул вузлів- matchLabelKeys:- tenantlabelSelector:{}topologyKey:node-poolpodAntiAffinity:requiredDuringSchedulingIgnoredDuringExecution:# переконаємось, що Podʼи, повʼязані з цим орендарем, не можуть розміщуватися на вузлах,# які використовуються для іншого орендаря- mismatchLabelKeys:- tenant# незалежно від значення мітки "tenant" для цього Podʼа, заборонити# розміщення на вузлах у будь-якому пулі, де працює будь-який Pod# від іншого орендаря.labelSelector:# Ми повинні мати labelSelector, який обирає лише Podʼи з міткою tenant,# інакше цей Pod матиме антиспорідненість до Podʼів з daemonsetʼів, наприклад,# які не повинні мати мітку tenant.matchExpressions:- key:tenantoperator:ExiststopologyKey:node-pool
Ще кілька практичних прикладів
Спорідненість та антиспорідненість між Podʼами можуть бути ще кориснішими, коли вони використовуються з колекціями вищого рівня, такими як ReplicaSets, StatefulSets, Deployments і т. д. Ці правила дозволяють налаштувати спільне розташування набору робочих навантажень у визначеній топології; наприклад, віддаючи перевагу розміщенню двох повʼязаних Podʼів на одному вузлі.
Наприклад: уявіть кластер з трьох вузлів. Ви використовуєте кластер для запуску вебзастосунку, а також кешу в памʼяті (наприклад, Redis). Для цього прикладу також припустімо, що затримка між вебзастосунком і кешем має бути настільки низькою, наскільки це практично можливо. Ви можете використовувати спорідненість та антиспорідненість між Podʼами, щоб розміщувати вебсервери разом із кешем, наскільки це можливо.
У наступному прикладі Deployment для кешу Redis репліки отримують мітку app=store. Правило podAntiAffinity повідомляє планувальникові уникати розміщення кількох реплік з міткою app=store на одному вузлі. Це створює кожен кеш на окремому вузлі.
У наступному прикладі Deployment для вебсерверів створює репліки з міткою app=web-store. Правило спорідненості Podʼа повідомляє планувальнику розмістити кожну репліку на вузлі, де є Pod з міткою app=store. Правило антиспорідненості Podʼа повідомляє планувальнику ніколи не розміщати кілька серверів app=web-store на одному вузлі.
Створення цих двох попередніх Deploymentʼів призводить до наступної структури кластера, де кожен вебсервер розміщений разом із кешем, на трьох окремих вузлах.
node-1
node-2
node-3
webserver-1
webserver-2
webserver-3
cache-1
cache-2
cache-3
Загальний ефект полягає в тому, що кожен екземпляр кешу ймовірно використовується одним клієнтом, який працює на тому ж самому вузлі. Цей підхід спрямований на мінімізацію як перекосу (нерівномірного навантаження), так і затримки.
У вас можуть бути інші причини використання антиспорідненості Podʼа. Дивіться навчальний матеріал із ZooKeeper
для прикладу StatefulSet, налаштованого з антиспорідненістю для забезпечення високої
доступності, використовуючи ту ж саму техніку, що й цей приклад.
nodeName
nodeName є більш прямим способом вибору вузла, ніж спорідненість або nodeSelector. nodeName — це поле в специфікації Podʼа. Якщо поле nodeName не порожнє, планувальник ігнорує Pod, і kubelet на названому вузлі намагається розмістити Pod на цьому вузлі. Використання nodeName переважає використання nodeSelector або правил спорідненості та антиспорідненості.
Деякі з обмежень використання nodeName для вибору вузлів:
Якщо зазначений вузол не існує, Pod не буде запущено, і у деяких випадках його може бути автоматично видалено.
Якщо зазначений вузол не має достатньо ресурсів для розміщення Podʼа, Pod зазнає збою, а його причина вказуватиме чому, наприклад, OutOfmemory або OutOfcpu.
Назви вузлів у хмарних середовищах не завжди передбачувані або стабільні.
Попередження:
nodeName призначений для використання власними планувальниками або у більш складних випадках, де вам потрібно обійти будь-які налаштовані планувальники. Обхід планувальників може призвести до Podʼів зі збоєм, якщо призначені вузли перевантажені. Ви можете використовувати спорідненість вузлів або поле nodeSelector, щоб призначити Pod до певного вузла без обходу планувальників.
Нижче наведено приклад специфікації Podʼа з використанням поля nodeName:
Наведений вище Pod буде запущено лише на вузлі kube-01.
nominatedNodeName
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
nominatedNodeName може використовуватись для зовнішніх компонентів, щоб номінувати вузол для Podʼа в очікуванні. Ця номінація працює за принципом best-effort: її може бути проігноровано, якщо планувальник визначить, що Pod не може перейти до номінованого вузла.
Крім того, це поле може бути (пере)записане планувальником:
Якщо планувальник знаходить вузол для номінації через витіснення.
Якщо планувальник вирішує, куди йде Pod, і переміщує його в цикл привʼязки.
Зверніть увагу, що в цьому випадку nominatedNodeName встановлюється лише тоді, коли Pod повинен пройти через точки розширення WaitOnPermit або PreBind.
Ось приклад статусу Podʼа з використанням поля nominatedNodeName:
Ви можете використовувати обмеження топології розміщення для керування тим, як Podʼи розподіляються по вашому кластеру серед доменів відмов, таких як регіони, зони, вузли або будь-які інші топологічні домени, які ви визначаєте. Ви можете це зробити, щоб покращити продуктивність, очікувану доступність або
загальне використання.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Podʼи успадковують мітки топології (topology.kubernetes.io/zone та topology.kubernetes.io/region) від призначеного їм вузла, якщо такі мітки присутні. Ці мітки можна потім використовувати через Downward API, щоб забезпечити робоче навантаження інформацією про топологію вузлів.
Ось приклад Podʼа, що використовує Downward API для своєї зони та регіону:
Наступні логічні оператори можна використовувати в полі operator для nodeAffinity та podAffinity, згаданих вище.
Оператор
Поведінка
In
Значення мітки присутнє у заданому наборі рядків
NotIn
Значення мітки не міститься у заданому наборі рядків
Exists
Мітка з цим ключем існує на обʼєкті
DoesNotExist
На обʼєкті не існує мітки з цим ключем
Наступні оператори можна використовувати лише з nodeAffinity.
Оператор
Поведінка
Gt
Значення поля буде інтерпретовано як ціле число, і це ціле число, отримане в результаті обробки значення мітки, визначеної цим селектором, буде більшим ніж це ціле число.
Lt
Значення поля буде інтерпретовано як ціле число, і це ціле число, отримане в результаті обробки значення мітки, визначеної цим селектором, буде меншим ніж це ціле число.
Примітка:
Оператори Gt та Lt не працюватимуть з нецілими значеннями. Якщо вказане значення не вдається розібрати як ціле число, Pod не вдасться запланувати. Крім того, Gt та Lt не доступні для podAffinity.
6.10.4 - Накладні витрати, повʼязані з роботою Podʼів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Коли ви запускаєте Pod на вузлі, сам Pod потребує певної кількості системних ресурсів. Ці ресурси додаються до ресурсів, необхідних для запуску контейнерів всередині Podʼа. У Kubernetes накладні витрати Podʼа (Pod Overhead) — це спосіб обліку ресурсів, які використовуються інфраструктурою Podʼа, понад запити та обмеження контейнерів.
У Kubernetes накладні витрати Podʼа встановлюються під час допуску відповідно до накладних витрат, повʼязаних із RuntimeClass Podʼа.
Накладні витрати Podʼа враховуються на додачу до суми запитів ресурсів контейнерів під час планування Podʼа. Так само kubelet включатиме накладні витрати Podʼа під час визначення розміру cgroup Podʼа і під час ранжування Podʼів для виселення.
Налаштування накладних витрат Podʼа
Вам потрібно переконатися, що використовується RuntimeClass, який визначає поле overhead.
Приклад використання
Для роботи з накладними витратами Podʼів вам потрібен RuntimeClass, який визначає поле overhead. Наприклад, ви можете використати таке визначення RuntimeClass із середовищем виконання контейнерів з віртуалізацією (у цьому прикладі Kata Containers у поєднанні з монітором віртуальної машини Firecracker), яке використовує приблизно 120MiB на Pod для віртуальної машини та гостьової ОС:
# Вам потрібно змінити цей приклад, щоб назва та накладні витрати ресурсів на Pod# відповідали тим, що додає середовище виконання контейнерів у вашому кластері.apiVersion:node.k8s.io/v1kind:RuntimeClassmetadata:name:kata-fchandler:kata-fcoverhead:podFixed:memory:"120Mi"cpu:"250m"
Робочі навантаження, створені із зазначенням обробника RuntimeClass kata-fc, враховуватимуть накладні витрати памʼяті та CPU в обчисленнях квот ресурсів, під час планування на вузли, а також під час визначення розміру cgroup Podʼа.
Якщо у визначенні Podʼа вказані лише limits, kubelet виведе requests з цих обмежень і встановить їх такими ж, як і визначені limits.
Під час допуску контролер допуску RuntimeClass оновлює PodSpec робочого навантаження, щоб додати overhead, описаний у RuntimeClass. Якщо в PodSpec це поле вже визначено, Pod буде відхилено. У наведеному прикладі, оскільки вказано лише назву RuntimeClass, контролер допуску змінює Pod, додаючи overhead.
Після того, як контролер допуску RuntimeClass вніс зміни, ви можете перевірити оновлене значення накладних витрат Podʼа:
kubectl get pod test-pod -o jsonpath='{.spec.overhead}'
Вивід:
map[cpu:250m memory:120Mi]
Якщо визначено ResourceQuota, то враховується сума запитів контейнерів, а також поле overhead.
Коли kube-scheduler вирішує, на якому вузлі слід запускати новий Pod, він бере до уваги overhead цього Podʼа, а також суму запитів контейнерів для цього Podʼа. Для цього прикладу планувальник додає запити та overhead, а потім шукає вузол, на якому є 2,25 CPU та 320 MiB вільної памʼяті.
Після того, як Pod заплановано на вузол, kubelet на цьому вузлі створює нову cgroup для Podʼа. Саме в цьому Podʼі базове середовище виконання контейнерів створюватиме контейнери.
Якщо для кожного контейнера визначено обмеження ресурсу (Guaranteed QoS або Burstable QoS з визначеними обмеженнями), то kubelet встановлює верхнє обмеження для cgroup Podʼа, повʼязаної з цим ресурсом (cpu.cfs_quota_us для CPU та memory.limit_in_bytes для памʼяті). Це верхнє обмеження базується на сумі обмежень контейнерів плюс поле overhead, визначене в PodSpec.
Для CPU, якщо Pod має Guaranteed або Burstable QoS, то kubelet встановлює cpu.shares на основі суми запитів контейнерів плюс поле overhead, визначене в PodSpec.
Повертаючись до нашого прикладу, перевірте запити контейнерів для робочого навантаження:
kubectl get pod test-pod -o jsonpath='{.spec.containers[*].resources.limits}'
Загальні запити контейнерів становлять 2000m CPU та 200MiB памʼяті:
Вивід показує запити для 2250m CPU та 320MiB памʼяті. Запити включають накладні витрати Podʼа:
Namespace Name CPU Requests CPU Limits Memory Requests Memory Limits AGE
--------- ---- ------------ ---------- --------------- ------------- ---
default test-pod 2250m (56%) 2250m (56%) 320Mi (1%) 320Mi (1%) 36m
Перевірка обмежень cgroup Podʼа
Перевірте cgroup памʼяті Podʼа на вузлі, де працює робоче навантаження. У наступному прикладі використовується crictl на вузлі, який надає інтерфейс командного рядка для сумісних із CRI середовищ виконання контейнерів. Це складний приклад, що демонструє поведінку накладних витрат Podʼа, і не очікується, що користувачам потрібно буде безпосередньо перевіряти cgroups на вузлі.
Спочатку на конкретному вузлі визначте ідентифікатор Podʼа:
# Виконайте це на вузлі, де заплановано PodPOD_ID="$(sudo crictl pods --name test-pod -q)"
З цього можна визначити шлях cgroup Podʼа:
# Виконайте це на вузлі, де заплановано Podsudo crictl inspectp -o=json $POD_ID| grep cgroupsPath
Отриманий шлях cgroup включає контейнер pause Podʼа. Cgroup рівня Podʼа розташована на одну теку вище.
У цьому конкретному випадку шлях cgroup Podʼа — kubepods/podd7f4b509-cf94-4951-9417-d1087c92a5b2. Перевірте налаштування памʼяті cgroup рівня Podʼа:
# Виконайте це на вузлі, де заплановано Pod.# Також змініть назву cgroup, щоб вона відповідала cgroup, виділеній для вашого Podʼа. cat /sys/fs/cgroup/memory/kubepods/podd7f4b509-cf94-4951-9417-d1087c92a5b2/memory.limit_in_bytes
Це 320 MiB, як і очікувалося:
335544320
Спостережуваність
Деякі метрики kube_pod_overhead_* доступні у kube-state-metrics для ідентифікації використання накладних витрат Podʼа та спостереження за стабільністю робочих навантажень, які працюють з визначеними накладними витратами.
Podʼи вважалися готовими до планування відразу після створення. Планувальник Kubernetes виконує всі необхідні дії для знаходження вузлів для розміщення всіх Podʼів, що очікують. Однак на практиці деякі Podʼи можуть перебувати в стані «бракує необхідних ресурсів» («miss-essential-resources») протягом тривалого періоду. Ці Podʼи фактично створюють непотрібне навантаження на планувальник (і на залежні від нього інтегратори, такі як Cluster AutoScaler).
Шляхом вказання/видалення поля .spec.schedulingGates для Podʼа ви можете контролювати, коли Pod готовий до розгляду для планування.
Налаштування schedulingGates Podʼа
Поле schedulingGates містить список рядків, і кожний рядок сприймається як критерій, який повинен бути задоволений перед тим, як Pod буде вважатися придатним для планування. Це поле можна ініціалізувати лише під час створення Podʼа (клієнтом або шляхом зміни під час допуску). Після створення кожен schedulingGate можна видалити у довільному порядку, але додавання нового шлюзу планування заборонено.
stateDiagram-v2
s1: Pod створено
s2: Очікування планування Podʼа
s3: Pod готовий до планування
s4: Pod виконується
if: шлюзи планування порожні?
[*] --> s1
s1 --> if
s2 --> if: шлюз планування видалено
if --> s2: ні
if --> s3: так
s3 --> s4
s4 --> [*]
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
class s1,s2,s3,s4,if k8s
Схема. schedulingGates Podʼа
Приклад використання
Щоб позначити Pod як не готовий до планування, ви можете створити його з одним або кількома шлюзами планування так:
Щоб повідомити планувальнику, що цей Pod готовий до планування, ви можете повністю видалити його schedulingGates шляхом повторного застосування зміненого маніфеста:
Ви можете перевірити, чи очищено schedulingGates, виконавши:
kubectl get pod test-pod -o jsonpath='{.spec.schedulingGates}'
Очікується, що вивід буде порожнім. І ви можете перевірити його останній стан, запустивши:
kubectl get pod test-pod -o wide
Враховуючи те, що test-pod не запитує жодних ресурсів CPU/памʼяті, очікується, що стан цього Podʼа перейде з попереднього SchedulingGated в Running:
NAME READY STATUS RESTARTS AGE IP NODE
test-pod 1/1 Running 0 15s 10.0.0.4 node-2
Спостережуваність
Метрика scheduler_pending_pods має нову мітку "gated", щоб відрізняти, чи були спроби запланувати Pod, але він був визначений як непридатний для планування, чи він явно позначений як не готовий для планування. Ви можете використовувати scheduler_pending_pods{queue="gated"} для перевірки результату метрики.
Змінювані директиви планування Podʼа
Ви можете змінювати директиви планування Podʼа, коли вони мають шлюзи планування, з певними обмеженнями. У загальних рисах, ви можете лише робити директиви планування Podʼа жорсткішими. Іншими словами, оновлені директиви призведуть до можливості розміщення Podʼів тільки на підмножині вузлів, з якими вони раніше мали збіг. Конкретніше, правила для оновлення директив планування Podʼа такі:
Для .spec.nodeSelector дозволяються лише додавання. Якщо відсутнє, його можна встановити.
Для spec.affinity.nodeAffinity, якщо nil, тоді дозволяється встановлення будь-чого.
Якщо NodeSelectorTerms був порожнім, дозволено встановлення. Якщо не порожній, тоді дозволяються лише додавання NodeSelectorRequirements до matchExpressions або fieldExpressions, а зміни наявних matchExpressions і fieldExpressions не будуть дозволені. Це тому, що умови в .requiredDuringSchedulingIgnoredDuringExecution.NodeSelectorTerms обʼєднуються через OR, тоді як вирази в nodeSelectorTerms[].matchExpressions та nodeSelectorTerms[].fieldExpressions обʼєднуються через AND.
Для .preferredDuringSchedulingIgnoredDuringExecution всі оновлення дозволені. Це повʼязано з тим, що бажані умови не є авторитетними, і тому контролери політики не перевіряють ці умови.
Ви можете використовувати обмеження топології розміщення для контролю того, як Podʼи розподіляються по вашому кластеру серед доменів відмов, таких як регіони, зони, вузли та інші визначені користувачем топологічні домени. Це може допомогти забезпечити високу доступність, а також ефективне використання ресурсів.
Ви можете встановити обмеження на рівні кластера як стандартні або налаштувати обмеження топології розміщення для окремих робочих навантажень.
Мотивація
Уявіть, що у вас є кластер, у якому до двадцяти вузлів, і ви хочете запустити робоче навантаження, яке автоматично масштабує кількість реплік, які використовує. Це може бути лише два Podʼи або аж пʼятнадцять. Коли є лише два Podʼи, ви б воліли, щоб обидва ці Podʼи не працювали на одному вузлі: ви ризикуєте, що відмова одного вузла зробить ваше робоче навантаження недоступним.
Крім цього базового використання, є кілька прикладів розширеного використання, які дають вашим робочим навантаженням змогу отримувати переваги у високій доступності та використанні кластера.
Під час масштабування та запуску більшої кількості Podʼів важливою стає інша проблема. Уявіть, що у вас є три вузли, на кожному з яких працює по пʼять Podʼів. Вузли мають достатню місткість для запуску такої кількості реплік; проте клієнти, які взаємодіють із цим робочим навантаженням, розподілені по трьох різних центрах обробки даних (або інфраструктурних зонах). Тепер вас менше турбує відмова одного вузла, але ви помічаєте, що затримка вища, ніж вам хотілося б, і ви платите за мережеві витрати, повʼязані з передаванням мережевого трафіку між різними зонами.
Ви вирішуєте, що за нормальної роботи ви б воліли мати приблизно однакову кількість реплік, запланованих у кожну інфраструктурну зону, і хотіли б, щоб кластер самозцілювався в разі виникнення проблеми.
Обмеження топології розміщення Podʼів пропонують вам декларативний спосіб це налаштувати.
Поле topologySpreadConstraints
У API Pod є поле spec.topologySpreadConstraints. Використання цього поля виглядає так:
---apiVersion:v1kind:Podmetadata:name:example-podspec:# Налаштувати обмеження топології розміщенняtopologySpreadConstraints:- maxSkew:<ціле число>minDomains:<ціле число># необовʼязковоtopologyKey:<рядок>whenUnsatisfiable:<рядок>labelSelector:<обʼєкт>matchLabelKeys:<список># необовʼязково; бета з v1.27nodeAffinityPolicy:[Honor|Ignore]# необовʼязково; бета з v1.26nodeTaintsPolicy:[Honor|Ignore]# необовʼязково; бета з v1.26### інші поля Pod тут
Примітка:
Для заданої пари значень topologyKey та whenUnsatisfiable може бути лише один topologySpreadConstraint. Наприклад, якщо ви визначили topologySpreadConstraint, що використовує topologyKey "kubernetes.io/hostname" і значення whenUnsatisfiable "DoNotSchedule", ви можете додати інший topologySpreadConstraint для topologyKey "kubernetes.io/hostname" лише в тому випадку, якщо використаєте інше значення whenUnsatisfiable.
Додаткову інформацію про це поле можна отримати, виконавши команду kubectl explain Pod.spec.topologySpreadConstraints або звернувшись до розділу планування довідки API для Pod.
Визначення обмеження топології розміщення
Ви можете визначити один або кілька записів topologySpreadConstraints, щоб вказати kube-scheduler, як розмістити кожний вхідний Pod відносно наявних Podʼів у вашому кластері. Ці поля такі:
maxSkew описує ступінь нерівномірності розподілу Podʼів. Ви повинні вказати це поле, а його значення має бути більшим за нуль. Його семантика відрізняється залежно від значення whenUnsatisfiable:
якщо ви виберете whenUnsatisfiable: DoNotSchedule, то maxSkew визначає максимально допустиму різницю між кількістю відповідних Podʼів у цільовій топології та глобальним мінімумом (мінімальною кількістю відповідних Podʼів у прийнятному домені або нулем, якщо кількість прийнятних доменів менша за MinDomains). Наприклад, якщо у вас є 3 зони, де кількість відповідних Podʼів становить 2, 2 та 1, а maxSkew встановлено на 1, то глобальний мінімум дорівнює 1.
якщо ви виберете whenUnsatisfiable: ScheduleAnyway, планувальник надає вищий пріоритет топологіям, які допомогли б зменшити перекіс.
minDomains вказує мінімальну кількість прийнятних доменів. Це поле є необовʼязковим. Домен — це певний екземпляр топології. Прийнятний домен — це домен, вузли якого відповідають селектору вузлів.
Примітка:
До Kubernetes v1.30 поле minDomains було доступне лише за умови, що функціональну можливість MinDomainsInPodTopologySpread увімкнено (стандартно увімкнена починаючи з v1.28). У старіших кластерах Kubernetes її може бути явно вимкнено, або поле може бути недоступним.
Значення minDomains має бути більшим за 0, якщо його вказано. Ви можете вказати minDomains лише разом із whenUnsatisfiable: DoNotSchedule.
Коли кількість прийнятних доменів з відповідними ключами топології менша за minDomains, під час розміщення Podʼів за топологією глобальний мінімум вважається рівним 0, а потім виконується обчислення skew. Глобальний мінімум — це мінімальна кількість відповідних Podʼів у прийнятному домені або нуль, якщо кількість прийнятних доменів менша за minDomains.
Коли кількість прийнятних доменів з відповідними ключами топології дорівнює minDomains або більша за нього, це значення не впливає на планування.
Якщо ви не вказуєте minDomains, обмеження поводиться так, ніби minDomains дорівнює 1.
topologyKey — ключ міток вузла. Вузли, які мають мітку з цим ключем та однаковими значеннями, вважаються такими, що належать до однієї топології. Кожен екземпляр топології (іншими словами, пара <ключ, значення>) називається доменом. Планувальник намагатиметься розмістити збалансовану кількість Podʼів у кожному домені. Також ми визначаємо прийнятний домен як домен, вузли якого відповідають вимогам nodeAffinityPolicy та nodeTaintsPolicy.
whenUnsatisfiable вказує, що робити з Podʼом, якщо він не задовольняє обмеження топології розміщення:
DoNotSchedule (стандартно) вказує планувальнику не планувати його.
ScheduleAnyway вказує планувальнику все одно його планувати, надаючи пріоритет вузлам, що мінімізують перекіс.
labelSelector використовується для пошуку відповідних Podʼів. Podʼи, які відповідають цьому селектору міток, враховуються для визначення кількості Podʼів у відповідному топологічному домені. Докладніше дивіться в розділі Селектори міток.
matchLabelKeys — це список ключів міток Podʼа для вибору групи Podʼів, для яких буде обчислено перекіс розподілу. Під час створення Podʼа kube-apiserver використовує ці ключі для пошуку значень у мітках вхідного Podʼа, і ці мітки ключ-значення буде обʼєднано з наявним labelSelector. Один і той самий ключ не може бути одночасно в matchLabelKeys і в labelSelector. matchLabelKeys не можна встановити, якщо не встановлено labelSelector. Ключі, яких немає в мітках Podʼа, буде проігноровано. Значення null або порожній список означає відповідність лише labelSelector.
Увага:
Не рекомендується використовувати matchLabelKeys з мітками, які можуть бути оновлені безпосередньо в Podʼах. Навіть якщо ви безпосередньо редагуєте мітку Podʼа, вказану в matchLabelKeys (тобто ви редагуєте Pod, а не Deployment), kube-apiserver не відображає оновлення мітки в обʼєднаному labelSelector.
З matchLabelKeys вам не потрібно оновлювати pod.spec між різними ревізіями. Контролеру/оператору достатньо встановити різні значення для того самого ключа мітки для різних ревізій. Наприклад, якщо ви налаштовуєте Deployment, ви можете використовувати мітку з ключем pod-template-hash, яка автоматично додається контролером Deployment, щоб розрізняти різні ревізії в одному Deployment.
Поле matchLabelKeys є полем рівня бета і стандартно увімкнене у 1.27. Ви можете вимкнути його, вимкнувши функціональну можливість MatchLabelKeysInPodTopologySpread.
До v1.34 matchLabelKeys оброблявся неявно. Починаючи з v1.34, мітки ключ-значення, що відповідають matchLabelKeys, явно обʼєднуються з labelSelector. Ви можете вимкнути це й повернутися до попередньої поведінки, вимкнувши функціональну можливість MatchLabelKeysInPodTopologySpreadSelectorMerge у kube-apiserver.
nodeAffinityPolicy вказує, як ми будемо обробляти nodeAffinity/nodeSelector Podʼа під час обчислення перекосу топології розміщення Podʼів. Варіанти:
Honor: до розрахунків включаються лише вузли, які відповідають nodeAffinity/nodeSelector.
Ignore: nodeAffinity/nodeSelector ігноруються. До розрахунків включаються всі вузли.
Якщо це значення є null, поведінка еквівалентна політиці Honor.
Примітка:
Поле nodeAffinityPolicy було полем рівня бета з v1.26 і стало загальнодоступним (GA) у v1.33. У бета-версії воно стандартно увімкнене, і ви можете вимкнути його, вимкнувши функціональну можливість NodeInclusionPolicyInPodTopologySpread.
nodeTaintsPolicy вказує, як ми будемо обробляти taints вузлів під час обчислення перекосу топології розміщення Podʼів. Варіанти:
Honor: включаються вузли без taints, а також вузли з taints, для яких вхідний Pod має toleration.
Ignore: taints вузла ігноруються. Включаються всі вузли.
Якщо це значення є null, поведінка еквівалентна політиці Ignore.
Примітка:
Поле nodeTaintsPolicy було полем рівня бета з v1.26 і стало загальнодоступним (GA) у v1.33. У бета-версії воно стандартно увімкнене, і ви можете вимкнути його, вимкнувши функціональну можливість NodeInclusionPolicyInPodTopologySpread.
Коли Pod визначає більше одного topologySpreadConstraint, ці обмеження поєднуються за допомогою логічної операції AND: kube-scheduler шукає для вхідного Podʼа вузол, який задовольняє всі налаштовані обмеження.
Мітки вузлів
Обмеження топології розміщення ґрунтуються на мітках вузлів, які визначають топологічні домени кожного вузла. Наприклад, вузол може мати такі мітки:
region:us-east-1zone:us-east-1a
Примітка:
Для стислості в цьому прикладі не використовуються відомі ключі міток topology.kubernetes.io/zone та topology.kubernetes.io/region. Однак рекомендується використовувати саме ці зареєстровані ключі міток, а не приватні (некваліфіковані) ключі міток region та zone, які використовуються тут.
Ви не можете робити надійних припущень щодо значення приватного ключа мітки в різних контекстах.
Припустимо, у вас є кластер із 4 вузлами з такими мітками:
NAME STATUS ROLES AGE VERSION LABELS
node1 Ready <none> 4m26s v1.16.0 node=node1,zone=zoneA
node2 Ready <none> 3m58s v1.16.0 node=node2,zone=zoneA
node3 Ready <none> 3m17s v1.16.0 node=node3,zone=zoneB
node4 Ready <none> 2m43s v1.16.0 node=node4,zone=zoneB
Тоді кластер логічно виглядає так:
graph TB
subgraph "zoneB"
n3(Node3)
n4(Node4)
end
subgraph "zoneA"
n1(Node1)
n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4 k8s;
class zoneA,zoneB cluster;
Узгодженість
Вам слід встановити однакові обмеження топології розміщення Podʼів для всіх Podʼів у групі.
Зазвичай, якщо ви використовуєте контролер робочого навантаження, такий як Deployment, шаблон Podʼа подбає про це за вас. Якщо ви змішуєте різні обмеження розподілу, Kubernetes дотримується визначення цього поля в API; однак поведінка з більшою ймовірністю стане заплутаною, а усунення несправностей буде менш простим.
Вам потрібен механізм, що забезпечує узгоджені мітки на всіх вузлах топологічного домену (наприклад, регіону хмарного провайдера). Щоб вам не доводилося додавати мітки до вузлів вручну, більшість кластерів автоматично заповнюють відомі мітки, такі як kubernetes.io/hostname. Перевірте, чи підтримує це ваш кластер.
Приклади обмежень топології розміщення
Приклад: одне обмеження топології розміщення
Припустимо, у вас є кластер із 4 вузлами, де 3 Podʼи з міткою foo: bar розташовані на вузлах node1, node2 та node3 відповідно:
graph BT
subgraph "zoneB"
p3(Pod) --> n3(Node3)
n4(Node4)
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class zoneA,zoneB cluster;
Якщо ви хочете, щоб вхідний Pod був рівномірно розподілений разом із наявними Podʼами по зонах, ви можете використати маніфест, схожий на такий:
У цьому маніфесті topologyKey: zone означає, що рівномірний розподіл буде застосовуватися лише до вузлів, які мають мітку zone: <будь-яке значення> (вузли, які не мають мітки zone, буде пропущено). Поле whenUnsatisfiable: DoNotSchedule вказує планувальнику залишити вхідний Pod в очікуванні, якщо планувальник не може знайти спосіб задовольнити обмеження.
Якщо планувальник розмістить цей вхідний Pod у зоні A, розподіл Podʼів стане [3, 1]. Це означає, що фактичний перекіс становить 2 (обчислюється як 3 - 1), що порушує maxSkew: 1. Щоб задовольнити обмеження та умови цього прикладу, вхідний Pod може бути розміщений лише на вузлі в зоні B:
graph BT
subgraph "zoneB"
p3(Pod) --> n3(Node3)
p4(mypod) --> n4(Node4)
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class p4 plain;
class zoneA,zoneB cluster;
або
graph BT
subgraph "zoneB"
p3(Pod) --> n3(Node3)
p4(mypod) --> n3
n4(Node4)
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class p4 plain;
class zoneA,zoneB cluster;
Ви можете змінити специфікацію Podʼа, щоб вона відповідала різним вимогам:
Змініть maxSkew на більше значення, наприклад 2, щоб вхідний Pod також можна було розмістити в зоні A.
Змініть topologyKey на node, щоб рівномірно розподілити Podʼи по вузлах, а не по зонах. У наведеному вище прикладі, якщо maxSkew залишиться 1, вхідний Pod може бути розміщений лише на вузлі node4.
Змініть whenUnsatisfiable: DoNotSchedule на whenUnsatisfiable: ScheduleAnyway, щоб вхідний Pod завжди був придатним для планування (за умови, що вимоги інших API планування задоволено). Однак перевага надається розміщенню в топологічному домені, який має менше відповідних Podʼів. (Памʼятайте, що ця перевага нормалізується разом з іншими внутрішніми пріоритетами планування, такими як коефіцієнт використання ресурсів.)
Приклад: кілька обмежень топології розміщення
Цей приклад базується на попередньому. Припустимо, у вас є кластер із 4 вузлами, де 3 наявні Podʼи з міткою foo: bar розташовані на вузлах node1, node2 і node3 відповідно:
graph BT
subgraph "zoneB"
p3(Pod) --> n3(Node3)
n4(Node4)
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class p4 plain;
class zoneA,zoneB cluster;
Ви можете поєднати два обмеження топології розміщення, щоб контролювати розподіл Podʼів як за вузлами, так і за зонами:
У цьому випадку, щоб відповідати першому обмеженню, вхідний Pod може бути розміщений лише на вузлах у зоні B; тоді як згідно з другим обмеженням вхідний Pod може бути запланований лише на вузол node4. Планувальник розглядає лише варіанти, які задовольняють усі визначені обмеження, тому єдиним допустимим розміщенням є вузол node4.
Приклад: конфліктні обмеження топології розміщення
Кілька обмежень можуть призвести до конфліктів. Припустимо, у вас є кластер із 3 вузлами у 2 зонах:
graph BT
subgraph "zoneB"
p4(Pod) --> n3(Node3)
p5(Pod) --> n3
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n1
p3(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3,p4,p5 k8s;
class zoneA,zoneB cluster;
Якщо ви застосуєте two-constraints.yaml (маніфест із попереднього прикладу) до цього кластера, ви побачите, що Pod mypod залишається у стані Pending. Це відбувається тому, що для задоволення першого обмеження Pod mypod може бути розміщений лише в зоні B; тоді як згідно з другим обмеженням Pod mypod може бути запланований лише на вузол node2. Перетин двох обмежень дає порожню множину, і планувальник не може розмістити Pod.
Щоб вийти з цієї ситуації, ви можете або збільшити значення maxSkew, або змінити одне з обмежень, щоб воно використовувало whenUnsatisfiable: ScheduleAnyway. Залежно від обставин, ви також можете вирішити видалити наявний Pod вручну — наприклад, якщо ви зʼясовуєте, чому розгортання виправлення помилки не просувається.
Взаємодія зі спорідненістю вузлів та селекторами вузлів
Планувальник пропустить вузли, що не відповідають, в обчисленнях перекосу, якщо у вхідного Podʼа визначено spec.nodeSelector або spec.affinity.nodeAffinity.
Приклад: обмеження топології розміщення зі спорідненістю вузлів
Припустимо, у вас є кластер із 5 вузлами, розташованими в зонах від A до C:
graph BT
subgraph "zoneB"
p3(Pod) --> n3(Node3)
n4(Node4)
end
subgraph "zoneA"
p1(Pod) --> n1(Node1)
p2(Pod) --> n2(Node2)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n1,n2,n3,n4,p1,p2,p3 k8s;
class p4 plain;
class zoneA,zoneB cluster;
graph BT
subgraph "zoneC"
n5(Node5)
end
classDef plain fill:#ddd,stroke:#fff,stroke-width:4px,color:#000;
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef cluster fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class n5 k8s;
class zoneC cluster;
і ви знаєте, що зону C потрібно виключити. У цьому випадку ви можете скласти маніфест, як наведено нижче, щоб Pod mypod був розміщений у зоні B, а не в зоні C. Так само Kubernetes враховує і spec.nodeSelector.
Тут є кілька неявних домовленостей, на які варто звернути увагу:
Відповідними кандидатами можуть бути лише ті Podʼи, що перебувають у тому самому просторі імен, що й вхідний Pod.
Планувальник розглядає лише ті вузли, у яких одночасно присутні всі topologySpreadConstraints[*].topologyKey. Вузли, у яких відсутній будь-який з цих topologyKeys, пропускаються. Це означає, що:
будь-які Podʼи, розташовані на цих пропущених вузлах, не впливають на обчислення maxSkew — у наведеному вище прикладі, припустимо, що вузол node1 не має мітки "zone", тоді 2 Podʼи буде проігноровано, тому вхідний Pod буде заплановано в зону A.
вхідний Pod не має шансів бути запланованим на такі вузли — у наведеному вище прикладі, припустимо, що вузол node5 має мітку з помилкоюzone-typo: zoneC (і не має встановленої мітки zone). Після приєднання вузла node5 до кластера його буде пропущено, і Podʼи цього робочого навантаження не плануватимуться на нього.
Враховуйте, що станеться, якщо topologySpreadConstraints[*].labelSelector вхідного Podʼа не відповідає його власним міткам. У наведеному вище прикладі, якщо ви видалите мітки вхідного Podʼа, його все ще можна розмістити на вузлах у зоні B, оскільки обмеження все ще виконуються. Проте після цього розміщення ступінь незбалансованості кластера залишається без змін — зона A все ще має 2 Podʼи з міткою foo: bar, а зона B має 1 Pod з міткою foo: bar. Якщо це не те, що ви очікуєте, оновіть topologySpreadConstraints[*].labelSelector робочого навантаження, щоб він відповідав міткам у шаблоні Podʼа.
Стандартні обмеження на рівні кластера
Для кластера можна встановити стандартні обмеження топології розміщення. Стандартні обмеження топології розміщення застосовуються до Podʼа тоді й лише тоді, коли:
Він не визначає жодних обмежень у своєму .spec.topologySpreadConstraints.
Він належить до Service, ReplicaSet, StatefulSet або ReplicationController.
Стандартні обмеження можна встановити як частину аргументів втулка PodTopologySpread у профілі планування. Обмеження задаються за допомогою того самого API, що описаний вище, за винятком того, що labelSelector має бути порожнім. Селектори обчислюються на основі Services, ReplicaSets, StatefulSets або ReplicationControllers, до яких належить Pod.
Якщо ви не налаштовуєте жодних стандартних обмежень на рівні кластера для топології розміщення Podʼів, то kube-scheduler діє так, ніби ви вказали такі стандартні обмеження топології:
Також застарілий втулок SelectorSpread, який забезпечує еквівалентну поведінку, стандартно вимкнений.
Примітка:
Втулок PodTopologySpread не оцінює вузли, які не мають ключів топології, вказаних в обмеженнях розподілу. Це може призвести до іншої стандартної поведінки порівняно із застарілим втулком SelectorSpread, коли використовуються стандартні обмеження топології.
Якщо ви не очікуєте, що на ваших вузлах будуть встановлені обидві мітки kubernetes.io/hostname та topology.kubernetes.io/zone, визначте власні обмеження замість використання стандартних обмежень Kubernetes.
Якщо ви не хочете використовувати стандартні обмеження топології розміщення Podʼів для вашого кластера, ви можете вимкнути їх, встановивши defaultingType у List і залишивши порожнім defaultConstraints у конфігурації втулка PodTopologySpread:
притягує Podʼи; ви можете спробувати упакувати будь-яку кількість Podʼів у відповідні топологічні домени.
podAntiAffinity
відштовхує Podʼи. Якщо ви встановите режим requiredDuringSchedulingIgnoredDuringExecution, то в один топологічний домен може бути запланований лише один Pod; якщо ви виберете preferredDuringSchedulingIgnoredDuringExecution, то втратите можливість примусово забезпечити дотримання обмеження.
Для точнішого контролю ви можете вказати обмеження топології розміщення, щоб розподіляти Podʼи по різних топологічних доменах — для досягнення високої доступності або економії коштів. Це також може допомогти під час поетапного оновлення робочих навантажень і плавного масштабування реплік.
Докладнішу інформацію див. у розділі Motivation пропозиції щодо вдосконалення про обмеження топології розміщення Podʼів.
Відомі обмеження
Немає гарантії, що обмеження залишаться задоволеними під час видалення Podʼів. Наприклад, зменшення масштабу Deployment може призвести до нерівномірного розподілу Podʼів.
Ви можете використовувати інструмент, такий як Descheduler, для перебалансування розподілу Podʼів.
Відповідні Podʼи на вузлах із taints враховуються. Див. Issue 80921.
Планувальник не має попереднього знання про всі зони або інші топологічні домени кластера. Вони визначаються на основі наявних вузлів у кластері. Це може призвести до проблем у кластерах з автомасштабуванням, коли пул вузлів (або група вузлів) масштабується до нуля вузлів, а ви очікуєте масштабування кластера, оскільки в цьому випадку ці топологічні домени не будуть враховуватися, поки в них не зʼявиться хоча б один вузол.
Ви можете обійти це, використовуючи автомасштабувальник вузлів, який враховує обмеження топології розміщення Podʼів і знає про загальний набір топологічних доменів.
Podʼи, які не відповідають власному labelSelector, створюють «Podʼи-привиди» (ghost pods). Якщо мітки Podʼа не відповідають labelSelector у його обмеженні топології розміщення, Pod не враховує себе в обчисленнях розподілу. Це означає:
Кілька таких Podʼів можуть просто накопичуватися в одній топології (доки не буде створено або видалено відповідні Podʼи), оскільки планування цих Podʼів не змінює результат обчислення розподілу.
Обмеження розподілу працює не так, як передбачалося, і, найімовірніше, не відповідає вашим очікуванням.
Переконайтеся, що мітки вашого Podʼа відповідають labelSelector у ваших обмеженнях розподілу. Зазвичай Pod має відповідати селектору власного обмеження топології розміщення.
Що далі
У статті блогу Introducing PodTopologySpread докладно пояснюється maxSkew, а також розглядаються деякі приклади розширеного використання.
Спорідненість вузлів (node affinity) — це властивість Podʼів, яка притягує їх до набору вузлів (або як перевага, або як жорстка вимога). Taints є протилежністю — вони дозволяють вузлу відштовхувати набір Podʼів.
Tolerations застосовуються до Podʼів. Tolerations дозволяють планувальнику планувати Podʼи на вузли з відповідними taints. Tolerations дозволяють планування, але не гарантують його: планувальник також оцінює інші параметри в межах своєї роботи.
Taints та tolerations працюють разом, щоб Podʼи не планувалися на непридатні вузли. На вузол накладається один або кілька taints; це означає, що вузол не повинен приймати жодних Podʼів, які не толерують ці taints.
Концепції
Ви додаєте taint до вузла за допомогою kubectl taint. Наприклад,
kubectl taint nodes node1 key1=value1:NoSchedule
додає taint до вузла node1. Taint має ключ key1, значення value1 і ефект taint NoSchedule. Це означає, що жодний Pod не зможе розміститись на node1, якщо він не має відповідної toleration.
Щоб видалити taint, доданий командою вище, можна виконати:
kubectl taint nodes node1 key1=value1:NoSchedule-
Ви вказуєте toleration для Podʼа в PodSpec. Обидві наступні tolerations «відповідають» taint, створеному за допомогою команди kubectl taint вище, тому Pod з будь-якою з них зможе розміститись на node1:
Стандартний планувальник Kubernetes бере до уваги taints та tolerations під час вибору вузла для запуску певного Podʼа. Проте, якщо ви вручну вказуєте .spec.nodeName для Podʼа, ця дія оминає планувальник; Pod тоді привʼязується до вузла, на який ви його призначили, навіть якщо на вибраному вами вузлі є taints типу NoSchedule. Якщо це трапиться і на вузлі також встановлено taint типу NoExecute, kubelet виселить Pod, якщо не встановлено відповідну toleration.
Ось приклад Podʼа, у якого визначено деякі tolerations:
Toleration «відповідає» taint, якщо ключі однакові та ефекти однакові, і:
operator — Exists (у цьому випадку не слід вказувати value), або
operator — Equal, а значення мають бути рівні.
Примітка:
Є два спеціальних випадки:
Якщо key порожній, то operator має бути Exists, що відповідає всім ключам і значенням. Зверніть увагу, що effect все одно має збігатися.
Порожній effect відповідає всім ефектам з ключем key1.
У наведеному вище прикладі використовувався effectNoSchedule. Також можна використовувати effectPreferNoSchedule.
Дозволені значення для поля effect:
NoExecute
Це впливає на Podʼи, які вже запущені на вузлі, таким чином:
Podʼи, які не толерують taint, негайно виселяються
Podʼи, які толерують taint, не вказуючи tolerationSeconds в їхній специфікації toleration, залишаються привʼязаними назавжди
Podʼи, які толерують taint із вказаним tolerationSeconds, залишаються привʼязаними протягом зазначеного часу. Після закінчення цього часу контролер життєвого циклу вузла виселяє Podʼи з вузла.
NoSchedule
На вузол із taint не буде заплановано нові Podʼи, якщо вони не мають відповідної toleration. Podʼи, які вже працюють на вузлі, не виселяються.
PreferNoSchedule
PreferNoSchedule — це «preference» або «soft» варіант NoSchedule. Панель управління спробує уникнути розміщення на вузлі Podʼа, який не толерує taint, але це не гарантовано.
На один вузол можна накласти кілька taints, а на один Pod — кілька tolerations. Kubernetes обробляє кілька taints і tolerations подібно до фільтра: спочатку беруться всі taints вузла, потім ігноруються ті, для яких Pod має відповідну toleration; решта неігнорованих taints мають зазначені ефекти на Pod. Зокрема,
якщо є принаймні один неігнорований taint з ефектом NoSchedule, тоді Kubernetes не буде планувати Pod на цей вузол
якщо немає неігнорованих taints з ефектом NoSchedule, але є принаймні один неігнорований taint з ефектом PreferNoSchedule, тоді Kubernetes спробує не планувати Pod на цей вузол
якщо є принаймні один неігнорований taint з ефектом NoExecute, тоді Pod буде виселено з вузла (якщо він вже працює на вузлі), і він не буде плануватися на вузол (якщо він ще не працює на вузлі).
Наприклад, уявіть, що ви накладаєте taint на вузол таким чином
У цьому випадку Pod не зможе плануватися на вузол, оскільки відсутня toleration, яка відповідає третьому taint. Але він зможе продовжувати працювати, якщо він вже працює на вузлі, коли до нього додається taint, оскільки третій taint — єдиний з трьох, який не толерується Podʼом.
Зазвичай, якщо до вузла додається taint з ефектом NoExecute, то будь-які Podʼи, які не толерують taint, будуть негайно виселені, а Podʼи, які толерують taint, ніколи не будуть виселені. Однак toleration з ефектом NoExecute може вказувати необовʼязкове поле tolerationSeconds, яке визначає, як довго Pod буде привʼязаний до вузла після додавання taint. Наприклад,
означає, що якщо цей Pod працює і до вузла додається відповідний taint, то Pod залишиться привʼязаним до вузла протягом 3600 секунд, а потім буде виселений. Якщо taint видаляється до цього часу, то Pod не буде виселений.
Оператори числового порівняння
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.35; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TaintTolerationComparisonOperators feature gate for all relevant components in your cluster.
Окрім Equal та Exists, ви можете використовувати числові оператори порівняння (Gt та Lt) для зіставлення taints із цілими значеннями. Це корисно для планування на основі порогових значень, наприклад для зіставлення вузлів за рівнем надійності або рівнем SLA.
Gt спрацьовує, коли значення taint більше за значення toleration.
Lt спрацьовує, коли значення taint менше за значення toleration.
Для числових операторів значення toleration та taint повинні бути дійсними цілими числами. Якщо одне зі значень не може бути розібране як ціле число, toleration не збігається.
Примітка:
Коли ви створюєте Pod, який використовує оператори tolerations Gt або Lt, API-сервер перевіряє, чи є значення toleration дійсними цілими числами. Значення taint на вузлах не перевіряються під час реєстрації вузлів. Якщо вузол має нечислове значення taint (наприклад, servicelevel.organization.example/agreed-service-level=high:NoSchedule), Podʼи з числовими операторами порівняння не відповідатимуть цьому taint і не зможуть плануватися на цьому вузлі.
Наприклад, якщо на вузли накладено taint зі значенням, що представляє угоду про рівень обслуговування (SLA):
Ця toleration відповідає taint на node1, оскільки 950 > 900 (значення taint більше за значення toleration для оператора Gt). Аналогічно, ви можете використовувати оператор Lt для зіставлення taints, де значення taint менше за значення toleration:
Під час використання числових операторів порівняння:
Значення toleration та taint повинні бути дійсними 64-бітними цілими числами зі знаком (нульові цифри на початку (наприклад, "0550") не допускаються).
Якщо значення не може бути розібране як ціле число, toleration не збігається.
Числові оператори працюють з усіма ефектами taint: NoSchedule, PreferNoSchedule та NoExecute.
Для PreferNoSchedule з числовими операторами: якщо toleration Podʼа не задовольняє числове порівняння (наприклад, значення taint < значення toleration під час використання Gt), планувальник надає вузлу нижчий пріоритет, але все одно може планувати там, якщо немає кращих варіантів.
Попередження:
Перед вимкненням функціональної можливості TaintTolerationComparisonOperators:
Ви повинні ідентифікувати всі робочі навантаження, що використовують оператори Gt або Lt, щоб уникнути гарячих циклів контролера.
Оновіть усі шаблони контролерів робочих навантажень, щоб замість них використовувати оператори Equal або Exists.
Видаліть усі Podʼи в стані очікування, які використовують оператори Gt або Lt.
Стежте за метрикою apiserver_request_total, щоб виявити сплески помилок перевірки.
Приклади використання
Taints та tolerations є гнучким способом спрямовувати Podʼи геть від вузлів або виселяти Podʼи, які не повинні працювати. Деякі з варіантів використання:
Виділені вузли: Якщо ви хочете виділити певний набір вузлів для виключного використання конкретним набором користувачів, ви можете додати taint на ці вузли (наприклад, kubectl taint nodes nodename dedicated=groupName:NoSchedule) і потім додати відповідну toleration до їхніх Podʼів (це найпростіше зробити за допомогою власного контролера допуску). Podʼам із tolerations буде дозволено використовувати вузли з taints (виділені), а також будь-які інші вузли в кластері. Якщо ви хочете виділити вузли для них та забезпечити, щоб вони використовували лише виділені вузли, то вам слід додатково додати мітку, аналогічну taint, до того ж набору вузлів (наприклад, dedicated=groupName), і контролер допуску повинен додатково додати спорідненість вузлів, щоб вимагати, щоб Podʼи могли плануватися лише на вузли з міткою dedicated=groupName.
Вузли зі спеціальним обладнанням: У кластері, де невелика підмножина вузлів має спеціалізоване обладнання (наприклад, GPU), бажано утримувати Podʼи, які не потребують спеціалізованого обладнання, поза цими вузлами, щоб залишити місце для Podʼів, що надійдуть пізніше й дійсно потребують спеціалізованого обладнання. Це можна зробити, накладаючи taints на вузли зі спеціалізованим обладнанням (наприклад, kubectl taint nodes nodename special=true:NoSchedule або kubectl taint nodes nodename special=true:PreferNoSchedule) і додаючи відповідну toleration до Podʼів, які використовують спеціалізоване обладнання. Як і у випадку з виділеними вузлами, найпростіше застосовувати tolerations за допомогою власного контролера допуску. Наприклад, рекомендується використовувати Розширені ресурси
для представлення спеціального обладнання, накладати на вузли зі спеціальним обладнанням taint з назвою розширеного ресурсу і запускати контролер допуску ExtendedResourceToleration. Тепер, оскільки на вузлах є taints, жоден Pod без toleration не буде плануватися на них. Але коли ви надсилаєте Pod, який запитує розширений ресурс, контролер допуску ExtendedResourceToleration автоматично додасть правильну toleration до Podʼа і цей Pod буде плануватися на вузли зі спеціальним обладнанням. Це забезпечить, що ці вузли зі спеціальним обладнанням виділені для Podʼів, які запитують таке обладнання, і вам не потрібно вручну додавати tolerations до ваших Podʼів.
Виселення на основі taint: Поведінка виселення, що налаштовується для кожного Podʼа, коли є проблеми з вузлом, яка описана в наступному розділі.
Виселення на основі taint
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.18
Контролер вузлів автоматично накладає taint на вузол, коли виконуються певні умови. Вбудованими є такі taints:
node.kubernetes.io/not-ready: Вузол не готовий. Це відповідає тому, що NodeCondition Ready має значення "False".
node.kubernetes.io/unreachable: Вузол недоступний для контролера вузлів. Це відповідає тому, що NodeCondition Ready має значення "Unknown".
node.kubernetes.io/memory-pressure: На вузлі є тиск на памʼять.
node.kubernetes.io/disk-pressure: На вузлі є тиск на диск.
node.kubernetes.io/pid-pressure: На вузлі є тиск на PID.
node.kubernetes.io/network-unavailable: Мережа вузла недоступна.
node.kubernetes.io/unschedulable: Вузол непридатний для планування.
node.cloudprovider.kubernetes.io/uninitialized: Коли kubelet запускається із «зовнішнім» хмарним провайдером, цей taint накладається на вузол, щоб позначити його як непридатний до використання. Після того як контролер з cloud-controller-manager ініціалізує цей вузол, kubelet видаляє цей taint.
Якщо вузол потрібно очистити, контролер вузлів або kubelet додає відповідні taints з ефектом NoExecute. Цей ефект стандартно додається для taints node.kubernetes.io/not-ready та node.kubernetes.io/unreachable. Якщо стан несправності повертається до норми, kubelet або контролер вузлів можуть видалити відповідні taints.
У деяких випадках, коли вузол недоступний, API-сервер не може спілкуватися з kubelet на вузлі. Рішення про видалення Podʼів не може бути передане до kubelet, доки звʼязок з API-сервером не буде відновлено. Протягом цього часу Podʼи, які заплановані для видалення, можуть продовжувати працювати на розділеному вузлі.
Примітка:
Панель управління обмежує швидкість додавання нових taints на вузли. Це обмеження швидкості керує кількістю виселень, які спричиняються, коли одночасно недоступно багато вузлів (наприклад, якщо відбувається збій мережі).
Ви можете вказати tolerationSeconds для Podʼа, щоб визначити, як довго цей Pod залишається привʼязаним до несправного вузла або вузла, який не відповідає.
Наприклад, ви можете довго зберігати застосунок з великою кількістю локального стану, привʼязаного до вузла, у разі розділу мережі, сподіваючись, що розділ відновиться, і, таким чином, можна уникнути виселення Podʼа. Toleration, яку ви встановили для цього Podʼа, може виглядати так:
Kubernetes автоматично додає toleration для node.kubernetes.io/not-ready та node.kubernetes.io/unreachable з tolerationSeconds=300, якщо тільки ви або контролер не встановили ці tolerations явно.
Ці автоматично додані tolerations означають, що Podʼи залишаються привʼязаними до вузлів протягом 5 хвилин після виявлення однієї з цих проблем.
Podʼи DaemonSet створюються з tolerations NoExecute для таких taints без tolerationSeconds:
node.kubernetes.io/unreachable
node.kubernetes.io/not-ready
Це забезпечує, що Podʼи DaemonSet ніколи не будуть виселені через ці проблеми.
Примітка:
Контролер вузлів відповідав за додавання taints до вузлів і виселення Podʼів. Але після 1.29 реалізація виселення на основі taint була переміщена з контролера вузлів в окремий і незалежний компонент під назвою taint-eviction-controller. Користувачі можуть за бажанням вимкнути виселення на основі taint, встановивши --controllers=-taint-eviction-controller в kube-controller-manager.
Накладання taints на вузли за станами
Панель управління, використовуючи контролер вузла, автоматично створює taints з ефектом NoSchedule для станів вузла.
Планувальник перевіряє taints, а не стани вузла, коли він приймає рішення про планування. Це забезпечує те, що стани вузла не впливають безпосередньо на планування. Наприклад, якщо стан вузла DiskPressure активний, панель управління додає taint node.kubernetes.io/disk-pressure і не планує нові Podʼи на уражений вузол. Якщо стан вузла MemoryPressure активний, панель управління додає taint node.kubernetes.io/memory-pressure.
Ви можете ігнорувати стани вузла для новостворених Podʼів, додавши відповідні tolerations Podʼів. Панель управління також додає toleration node.kubernetes.io/memory-pressure на Podʼи, які мають клас якості обслуговування інший, ніж BestEffort. Це тому, що Kubernetes вважає Podʼи у класах QoS Guaranteed або Burstable (навіть Podʼи без встановленого запиту на памʼять) здатними впоратися з тиском на памʼять, тоді як нові Podʼи BestEffort не плануються на уражений вузол.
Контролер DaemonSet автоматично додає наступні tolerations NoSchedule для всіх демонів, щоб запобігти порушенню роботи DaemonSets.
node.kubernetes.io/memory-pressure
node.kubernetes.io/disk-pressure
node.kubernetes.io/pid-pressure (1.14 або пізніше)
node.kubernetes.io/unschedulable (1.10 або пізніше)
node.kubernetes.io/network-unavailable (тільки для мережі хоста)
Додавання цих tolerations забезпечує сумісність з попередніми версіями. Ви також можете додавати довільні tolerations до DaemonSets.
Taints та tolerations пристроїв
Замість того, щоб накладати taints на цілі вузли, адміністратори можуть також накладати taints на окремі пристрої, коли кластер використовує динамічне виділення ресурсів для керування спеціальним обладнанням. Перевага полягає у тому, що taint можна спрямувати саме на те обладнання, яке є несправним або потребує обслуговування. Tolerations також підтримуються, і їх можна вказувати під час запиту пристроїв. Як і taints, вони застосовуються до всіх Podʼів, які спільно використовують один і той самий виділений пристрій.
Фреймворк планування — це архітектура на основі втулків для планувальника Kubernetes. Вона складається з набору API «втулків», які компілюються безпосередньо в планувальник. Ці API дозволяють реалізувати більшість можливостей планування у вигляді втулків, зберігаючи при цьому «ядро» планування легким та зручним у підтримці. Для отримання більш технічної інформації про дизайн фреймворку зверніться до проєктної пропозиції фреймворку планування.
Робочий процес фреймворку
Фреймворк планування визначає кілька точок розширення. Втулки планувальника реєструються для виклику в одній або кількох таких точках розширення. Деякі з цих втулків можуть змінювати рішення щодо планування, а деякі є суто інформаційними.
Кожна спроба запланувати один Pod розділяється на дві фази: цикл планування та цикл привʼязки.
Цикл планування та цикл привʼязки
Цикл планування вибирає вузол для Podʼа, а цикл привʼязки застосовує це рішення до кластера. Разом цикл планування та цикл привʼязки називаються «контекстом планування».
Цикли планування виконуються послідовно, тоді як цикли привʼязки можуть виконуватися паралельно.
Цикл планування або привʼязки може бути перерваний, якщо виявлено, що Pod непридатний для планування, або якщо відбувається внутрішня помилка. Pod буде повернуто у чергу і спроба буде повторена.
Інтерфейси
Наступне зображення показує контекст планування Podʼа та інтерфейси, які надає фреймворк планування.
Один втулок може реалізовувати кілька інтерфейсів для виконання складніших завдань або завдань зі збереженням стану.
Деякі інтерфейси відповідають точкам розширення планувальника, які можна налаштувати через конфігурацію планувальника.
Точки розширення фреймворку планування
PreEnqueue
Ці втулки викликаються перед додаванням Podʼів до внутрішньої активної черги, де Podʼи відзначаються як готові до планування.
Тільки коли всі втулки PreEnqueue повертають Success, Pod допускається до активної черги. В іншому випадку він поміщається у внутрішній список непридатних для планування Podʼів і не отримує стан Unschedulable.
Для отримання докладнішої інформації про те, як працюють внутрішні черги планувальника, прочитайте Черга планування в kube-scheduler.
EnqueueExtension
EnqueueExtension — це інтерфейс, де втулок може контролювати, чи потрібно повторно спробувати планування Podʼів, відхилених цим втулком, на основі змін у кластері. Втулки, які реалізують PreEnqueue, PreFilter, Filter, Reserve або Permit, повинні реалізувати цей інтерфейс.
QueueingHint
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.34; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.34. It was first available in the v1.28 release.
QueueingHint — це функція зворотного виклику для вирішення того, чи можна повторно поставити Pod до активної черги або черги backoff. Вона виконується кожного разу, коли в кластері відбувається певний вид події або зміна. Коли QueueingHint виявляє, що подія може зробити Pod придатним для планування, Pod поміщається в активну чергу або чергу backoff, щоб планувальник повторно спробував запланувати Pod.
QueueSort
Ці втулки використовуються для сортування Podʼів у черзі планування. Втулок сортування черги, по суті, надає функцію Less(Pod1, Pod2). Одночасно може бути увімкнений лише один втулок сортування черги.
PreFilter
Ці втулки використовуються для попередньої обробки інформації про Pod або для перевірки певних умов, яким мають відповідати кластер або Pod. Якщо втулок PreFilter повертає помилку, цикл планування переривається.
Filter
Ці втулки використовуються для відфільтрування вузлів, на яких не можна запустити Pod. Для кожного вузла планувальник буде викликати втулки фільтрації в налаштованому порядку. Якщо будь-який втулок фільтра позначає вузол як непридатний, для цього вузла не буде викликано інші втулки. Оцінка вузлів може відбуватися паралельно.
PostFilter
Ці втулки викликаються після фази фільтрації, але лише тоді, коли не було знайдено жодного придатного вузла для Podʼа. Втулки викликаються в налаштованому порядку. Якщо будь-який втулок postFilter позначає вузол як Schedulable, інші втулки не будуть викликані. Типовою реалізацією PostFilter є витіснення, яка намагається зробити Pod придатним для планування, витісняючи інші Podʼи.
PreScore
Ці втулки використовуються для виконання «попередньої оцінки», яка генерує спільний стан для використання втулками Score. Якщо втулок попередньої оцінки повертає помилку, цикл планування переривається.
Score
Ці втулки використовуються для ранжування вузлів, які пройшли фазу фільтрації. Планувальник викликає кожен втулок оцінювання для кожного вузла. Існує чіткий діапазон цілих чисел, який представляє мінімальні та максимальні оцінки. Після фази NormalizeScore планувальник поєднує оцінки вузла з усіх втулків згідно з налаштованими вагами втулків.
Оцінка місткості
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
У версії 1.32 для підтримки сховищ зі статичним наданням використовувалася функціональна можливість VolumeCapacityPriority. Починаючи з версії 1.33, нова функціональна можливість StorageCapacityScoring замінює стару VolumeCapacityPriority з додатковою підтримкою сховищ з динамічним наданням. Коли StorageCapacityScoring увімкнено, втулок VolumeBinding у kube-scheduler розширено, щоб оцінювати вузли на основі місткості сховища на кожному з них. Ця можливість застосовується до томів CSI, які підтримують місткість сховища, включно з локальним сховищем, яке підтримується драйвером CSI.
NormalizeScore
Ці втулки використовуються для модифікації оцінок перед тим, як планувальник обчислить кінцеве ранжування вузлів. Втулок, який реєструється для цієї точки розширення, буде викликаний з результатами Score від того ж втулка. Це робиться один раз для кожного втулка на один цикл планування.
Наприклад, припустимо, що втулок BlinkingLightScorer ранжує вузли на основі того, скільки лампочок, що блимають, в них є.
Однак максимальна кількість лампочок, що блимають, може бути невеликою порівняно з NodeScoreMax. Щоб виправити це, BlinkingLightScorer також повинен реєструватися для цієї точки розширення.
Якщо будь-який втулок NormalizeScore повертає помилку, цикл планування припиняється.
Примітка:
Втулки, які бажають виконати «pre-reserve», повинні використовувати точку розширення NormalizeScore.
Reserve
Втулок, який реалізує інтерфейс Reserve, має два методи, а саме Reserve та Unreserve, які підтримують дві інформаційні фази планування, які називаються Reserve та Unreserve, відповідно. Втулки, які підтримують стан часу виконання (так звані «втулки зі станом»), повинні використовувати ці фази, щоб отримувати від планувальника сповіщення про те, що ресурси на вузлі резервуються або звільняються для вказаного Podʼа.
Фаза резервування (Reserve) відбувається перед тим, як планувальник фактично привʼязує Pod до призначеного вузла. Вона існує для запобігання станам гонитви, поки планувальник чекає на успішну привʼязку. Метод Reserve кожного втулка Reserve може бути успішним або невдалим; якщо один виклик методу Reserve не вдасться, наступні втулки не виконуються, і фаза резервування вважається невдалою. Якщо метод Reserve всіх втулків успішний, фаза резервування вважається успішною, виконується решта циклу планування та циклу привʼязки.
Фаза скасування резервування (Unreserve) спрацьовує, якщо фаза резервування або пізніша фаза виявиться невдалою. У такому випадку метод Unreserveвсіх втулків резервування буде виконано в порядку, зворотному до викликів методів Reserve. Ця фаза існує для очищення стану, повʼязаного з зарезервованим Podʼом.
Увага:
Реалізація методу Unreserve у втулках Reserve повинна бути ідемпотентною і не може зазнавати невдачі.
Permit
Втулки Permit викликаються в кінці циклу планування для кожного Podʼа, щоб запобігти або затримати привʼязку до вузла-кандидата. Втулок дозволу може робити одну з трьох речей:
approve
Якщо всі втулки Permit схвалюють Pod, він відправляється для привʼязки.
deny
Якщо будь-який втулок Permit відхиляє Pod, він повертається до черги планування. Це спричинить запуск фази Unreserve у втулках Reserve.
wait (із тайм-аутом)
Якщо втулок Permit повертає «wait», тоді Pod залишається у внутрішньому списку Podʼів, що «очікують», і цикл привʼязки цього Podʼа починається, але безпосередньо блокується, поки він не буде схвалений. Якщо виникає тайм-аут, wait стає deny і Pod повертається до черги планування, спричиняючи запуск фази Unreserve у втулках Reserve.
Примітка:
Хоча будь-який втулок може мати доступ до списку Podʼів, що «очікують», та схвалювати їх (див. FrameworkHandle), ми очікуємо, що лише втулки Permit схвалюватимуть привʼязку зарезервованих Podʼів, які перебувають у стані «очікування». Після схвалення Podʼа він відправляється до фази PreBind.
PreBind
Ці втулки використовуються для виконання будь-яких необхідних операцій перед привʼязкою Podʼа. Наприклад, втулок PreBind може надавати мережевий том і монтувати його на цільовому вузлі перед тим, як дозволити Podʼу запускатися там.
Якщо будь-який втулок PreBind повертає помилку, Pod відхиляється і повертається до черги планування.
Bind
Ці втулки використовуються для привʼязки Podʼа до вузла. Втулки Bind не будуть викликані, поки всі втулки PreBind не завершаться. Кожен втулок привʼязки викликається в налаштованому порядку. Втулок привʼязки може вибрати, чи обробляти вказаний Pod. Якщо втулок привʼязки обирає Pod для опрацювання, решта втулків привʼязки пропускаються.
PostBind
Це інформаційний інтерфейс. Втулки PostBind викликаються після успішної привʼязки Podʼа. Це кінець циклу привʼязки, і його можна використати для очищення повʼязаних ресурсів.
API втулків
API втулків складається з двох кроків. По-перше, втулки повинні зареєструватися та отримати налаштування, а потім вони використовують інтерфейси точок розширення. Інтерфейси точок розширення мають такий вигляд.
Ви можете увімкнути або вимкнути втулки у конфігурації планувальника. Якщо ви використовуєте Kubernetes v1.18 або пізнішу версію, більшість втулків планування використовуються та є стандартно увімкненими.
Окрім стандартних втулків, ви також можете реалізувати власні втулки планування та налаштувати їх разом зі стандартними втулками. Ви можете дізнатися більше на scheduler-plugins.
Якщо ви використовуєте Kubernetes v1.18 або пізнішу версію, ви можете налаштувати набір втулків як профіль планувальника, а потім визначити кілька профілів для різних видів робочих навантажень. Дізнайтеся більше про кілька профілів.
6.10.9 - Групове планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Групове планування забезпечує, щоб група Podʼів була запланована з дотриманням принципу «все або нічого». Якщо кластер не може вмістити всю групу (або визначену мінімальну кількість Podʼів, вказану в minCount), жоден з Podʼів не привʼязується до вузла.
Примітка:
Хоча під час початкового розміщення планувальник ніколи не допускає кількості Podʼів, меншої за налаштований параметр minCount, фактична кількість запланованих Podʼів під час виконання може опуститися нижче цього порогу, якщо запущені Podʼи згодом будуть видалені або виселені, або якщо вимога щодо minCount збільшиться. У такому випадку планувальник розміщуватиме додаткові Podʼи лише тоді, коли сумарна кількість уже запланованих Podʼів та нових незапланованих Podʼів, розміщення яких стало можливим, досягне або перевищить значення minCount.
Ця можливість залежить від PodGroup API. Переконайтесь, що увімкнено функціональну можливість GenericWorkload та групу APIscheduling.k8s.io/v1beta1 у кластері.
Як це працює
Коли втулок GangScheduling увімкнено, планувальник змінює життєвий цикл Podʼів, що належать до PodGroup, для якого встановлено політику планування типу gang. Для кожного PodGroup цей процес відбувається за такими кроками:
Планувальник утримує Podʼи у фазі PreEnqueue, доки:
Вказаний обʼєкт PodGroup існує.
Кількість Podʼів, створених для PodGroup (як уже запланованих, так і незапланованих), принаймні дорівнює minCount.
PodGroup не потрапляє до активної черги планування, доки не будуть виконані обидві умови.
Після досягнення кворуму планувальник намагається знайти розміщення для всіх незапланованих Podʼів у групі. Він використовує цикл планування PodGroup, щоб прийняти одне, атомарне рішення щодо планування. Втулок GangScheduling реалізує точку розширення PlacementFeasible, яка викликається для кожного оцінюваного Podʼа під час циклу. Це використовується, щоб визначити, чи виконується обмеження minCount, шляхом порівняння кількості успішно розміщених Podʼів (включно з тими, що вже були заплановані в попередніх циклах) зі значенням minCount.
Якщо планувальник знаходить дійсні розміщення щонайменше для minCount Podʼів, він дозволяє цим успішно розміщеним Podʼам привʼязатися до призначених їм вузлів. Якщо він не може знайти достатньо розміщень для задоволення вимоги minCount, жоден з Podʼів не планується. Натомість вони переміщуються до черги непридатних для планування Podʼів, щоб чекати на звільнення ресурсів кластера, що дозволяє тим часом планувати інші робочі навантаження.
Ієрархічне групове планування з CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли увімкнено функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3, групове планування поширює свою підтримку на CompositePodGroups.
На відміну від PodGroups, які групують Podʼи, CompositePodGroups групують дочірні групи разом — або PodGroups, або інші CompositePodGroups. CompositePodGroup визначає політику планування, яка застосовується до його дочірніх груп під час планування:
політика gang з полем minGroupCount, яке вказує мінімальну кількість дочірніх груп (або обʼєктів CompositePodGroup, або PodGroup), які повинні бути заплановані разом як єдиний атомарний блок.
політика basic, яка вказує, що дочірні групи можна планувати незалежно.
Політика gang корисна для багатокомпонентних робочих навантажень, які потребують планування «все або нічого» для кількох дочірніх груп, забезпечуючи, що мінімальна кількість дочірніх груп планується разом. Прикладом робочого навантаження з такими потребами є репліковане навчання AI.
Політика basic може використовуватися для робочих навантажень, що складаються з кількох груп Podʼів, кожну з яких можна планувати як незалежну групу, наприклад, для робочих навантажень інференсу AI.
Ієрархічний кворум
Втулок GangScheduling затримує потрапляння кореневого обʼєкта CompositePodGroup до активної черги планування на етапі PreEnqueue доти, доки він не задовольнить вимоги ієрархічного кворуму. Цей кворум оцінюється знизу вгору — від кінцевих обʼєктів PodGroup аж до кореневого обʼєкта CompositePodGroup:
Кінцевий PodGroupзадовольняє кворум тоді і лише тоді, коли обʼєкт PodGroup існує та може потенційно задовольнити критерії своєї політики планування:
Для політики gang: принаймні minCount його складових Podʼів було створено.
Для політики basic: принаймні один з його складових Podʼів було створено.
CompositePodGroupзадовольняє кворум тоді і лише тоді, коли обʼєкт CompositePodGroup існує та може потенційно задовольнити критерії своєї політики планування:
Для політики gang: принаймні minGroupCount його безпосередніх дочірніх груп задовольняють кворум.
Для політики basic: принаймні одна з його безпосередніх дочірніх груп задовольняє кворум.
Загальний ієрархічний кворум задовольняється тоді і лише тоді, коли кореневий CompositePodGroup задовольняє кворум.
Зрештою, кореневий CompositePodGroup допускається до активної черги планування тоді і лише тоді, коли він задовольняє ієрархічний кворум та існує щонайменше один Pod, що очікує на планування та належить до одного з його нащадків PodGroups.
Здійсненність розміщення
Метод PlacementFeasible втулка GangScheduling підтримує оцінювання як для PodGroups, так і для CompositePodGroups. Він викликається циклом планування до початку оцінювання дочірніх груп та після оцінювання кожної дочірньої групи CompositePodGroup.
З урахуванням кількості дочірніх груп, які були успішно заплановані, та дочірніх груп, які ще не були оцінені в поточному циклі планування, PlacementFeasible визначає, чи обмеження політики групи все ще може бути досягнуте, дозволяючи циклу планування достроково припинити оцінювання CompositePodGroup, якщо його основна політика планування вже не може бути задоволена.
kube-scheduler — стандартний планувальник для Kubernetes. Він відповідає за розміщення Podʼів на вузлах кластера.
Вузли кластера, які відповідають вимогам планування Podʼа, називаються придатними (feasible) вузлами для Podʼа. Планувальник знаходить придатні вузли для Podʼа, а потім виконує набір функцій для оцінки цих вузлів, вибираючи вузол з найвищою оцінкою серед придатних для запуску Podʼа. Потім планувальник повідомляє API-сервер про це рішення в процесі, що називається привʼязкою (Binding).
На цій сторінці пояснюються оптимізації налаштування продуктивності, які є актуальними для великих кластерів Kubernetes.
У великих кластерах ви можете налаштувати роботу планувальника, збалансовуючи результати планування між часом відгуку (нові Podʼи розміщуються швидко) та точністю (планувальник рідко приймає погані рішення про розміщення).
Це налаштування задається через параметр kube-scheduler percentageOfNodesToScore. Цей параметр KubeSchedulerConfiguration визначає поріг для планування вузлів у вашому кластері.
Налаштування порога
Опція percentageOfNodesToScore приймає цілі числові значення від 0 до 100. Значення 0 є спеціальним числом, яке позначає, що kube-scheduler повинен використовувати вбудоване стандартне значення. Якщо ви встановлюєте percentageOfNodesToScore більше 100, kube-scheduler діє так, ніби ви встановили значення 100.
Щоб змінити значення, відредагуйте файл конфігурації kube-scheduler і перезапустіть планувальник. У багатьох випадках файл конфігурації можна знайти за шляхом /etc/kubernetes/config/kube-scheduler.yaml.
Після внесення цих змін ви можете виконати
kubectl get pods -n kube-system | grep kube-scheduler
щоб перевірити, що компонент kube-scheduler працює належним чином.
Поріг оцінки вузлів
Для поліпшення продуктивності планування kube-scheduler може припинити пошук придатних вузлів, як тільки він знайде їх достатню кількість. У великих кластерах це заощаджує час порівняно з підходом, який би враховував кожен вузол.
Ви вказуєте поріг для того, яка кількість вузлів є достатньою, як цілий відсоток від усіх вузлів у вашому кластері. Kube-scheduler перетворює це в ціле число вузлів. Під час планування, якщо kube-scheduler визначив достатню кількість придатних вузлів, щоб перевищити налаштований відсоток, він припиняє пошук додаткових придатних вузлів і переходить до фази оцінки.
Якщо ви не вказуєте поріг, Kubernetes розраховує значення за допомогою лінійної формули, яка дає 50% для кластера зі 100 вузлами та 10% для кластера з 5000 вузлів. Нижня межа для автоматичного значення — 5%.
Це означає, що kube-scheduler завжди оцінює принаймні 5% вашого кластера, незалежно від розміру кластера, якщо ви явно не встановили percentageOfNodesToScore менше ніж 5.
Якщо ви хочете, щоб планувальник оцінював всі вузли у вашому кластері, встановіть percentageOfNodesToScore на 100.
Приклад
Нижче наведено приклад конфігурації, яка встановлює percentageOfNodesToScore на 50%.
percentageOfNodesToScore повинен бути значенням від 1 до 100, а стандартне значення розраховується на основі розміру кластера. Також існує жорстко задане мінімальне значення в 100 вузлів.
Примітка:
У кластерах з менш ніж 100 придатними вузлами планувальник все ще перевіряє всі вузли, тому що недостатньо придатних вузлів для того, щоб рано зупинити пошук планувальника.
У малому кластері, якщо ви встановите низьке значення для percentageOfNodesToScore, ваші зміни майже не матимуть ефекту або не матимуть його зовсім, зі схожої причини.
Якщо у вашому кластері кілька сотень вузлів або менше, залиште цю опцію конфігурації у стандартному значенні. Внесення змін навряд чи суттєво покращить продуктивність планувальника.
Важливою деталлю, яку слід врахувати під час встановлення цього значення, є те, що коли на придатність перевіряється менша кількість вузлів кластера, деякі вузли не надсилаються на оцінку для цього Podʼа. В результаті вузол, який міг би отримати вищу оцінку для запуску цього Podʼа, може навіть не потрапити до фази оцінки. Це призведе до менш ідеального розміщення Podʼа.
Вам слід уникати встановлення percentageOfNodesToScore дуже низьким, щоб kube-scheduler не приймав часто погані рішення щодо розміщення Podʼа. Уникайте встановлення відсотка нижче 10%, якщо тільки пропускна здатність планувальника не є критичною для вашого застосунку та оцінка вузлів не є важливою. Іншими словами, ви віддаєте перевагу запуску Podʼа на будь-якому вузлі, який буде придатним.
Як планувальник проходиться по вузлах
Цей розділ призначений для тих, хто бажає зрозуміти внутрішні деталі цієї можливості.
Щоб всі вузли кластера мали рівні можливості бути враховані для запуску Podʼів, планувальник проходиться по вузлах по колу. Ви можете уявити, що вузли розташовані в масиві. Планувальник починає з початку масиву вузлів і перевіряє придатність вузлів, поки не знайде достатню кількість вузлів, як вказано у percentageOfNodesToScore. Для наступного Podʼа планувальник продовжує з точки в масиві вузлів, де він зупинився під час перевірки придатності вузлів для попереднього Podʼа.
Якщо вузли розташовані в кількох зонах, планувальник проходиться по вузлах у різних зонах, щоб вузли з різних зон враховувалися під час перевірок придатності. Наприклад, розгляньте шість вузлів у двох зонах:
Zone 1: Node 1, Node 2, Node 3, Node 4
Zone 2: Node 5, Node 6
Планувальник оцінює придатність вузлів у такому порядку:
Node 1, Node 5, Node 2, Node 6, Node 3, Node 4
Після проходження всіх вузлів він повертається до вузла 1.
Увімкнення опортуністичної пакетної обробки
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35; (стандартно увімкнено)
Під час планування великих робочих навантажень Podʼи часто мають еквівалентні обмеження планування та вимагають від планувальника виконання одних і тих же операцій знову і знову. Можливість Opportunistic Batching дозволяє планувальнику повторно використовувати результати фільтрації та оцінювання між циклами планування, що значно прискорює процес планування.
Завдяки повторній оцінці планувальник може продовжувати пакетну обробку в такій ситуації. Коли наступний Pod все ще може розміститися на раніше обраному вузлі, планувальник оновлює оцінку цього вузла та повертає його до кешованого списку кандидатів. Якщо повторна оцінка не вдається, планувальник повертається до наявної поведінки та очищає кеш.
Загалом ця можливість працює так:
Планувальник планує pod-1 і кешує результат планування.
Планувальник планує pod-2, 3, ... з кешованими результатами.
Термін дії кешу спливає через 0,5 секунди. Планувальник планує наступний Pod, який створює новий кеш.
Podʼи з еквівалентними обмеженнями планування мають надходити до циклу планування один за одним. Коли планувальник планує Pod з іншими обмеженнями, кеш не використовується, а замінюється новим.
Ми застосовуємо це пакетне планування до конкретних Podʼів, які:
Не мають спорідненості/антиспорідненості між Podʼами
Не мають обмежень топології розміщення
Не мають DRA (тобто не мають жодних ResourceClaims)
Не запитують розширені ресурси, які підтримуються DRA
Також, щоб увімкнути цю можливість, конфігурація планувальника повинна:
Встановити IgnorePreferredTermsOfExistingPodsInterPodAffinityArgs на true, щоб зробити пакетну обробку більш ефективною
Зверніть увагу, що в таких випадках:
Наявні Podʼи використовують обмеження спорідненості Podʼів, які відповідають будь-яким міткам запланованих Podʼів, можливість може не принести користі.
Використовуються власні втулки, які повинні реалізовувати точку розширення Signature.
Очікується, що обмеження та умови будуть змінюватися в майбутніх версіях.
6.10.11 - Витіснення з урахуванням робочого навантаження
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
У v1.36 логіка витіснення з урахуванням робочого навантаження вмикалася функціональною можливістю WorkloadAwarePreemption. Цю функціональну можливість було обʼєднано з функціональною можливістю GenericWorkload у v1.37.
Витіснення з урахуванням робочого навантаження (Workload-aware preemption) вводить механізм витіснення, спеціально розроблений для PodGroups. Коли PodGroup не може бути запланований, планувальник використовує логіку витіснення, яка намагається зробити можливим планування цього PodGroup. Цей підхід використовується виключно під час планування PodGroup і замінює стандартний механізм витіснення для Podʼів із цього PodGroup.
Коли ця можливість увімкнена, планувальник розглядає PodGroup як єдиний блок витіснення, а не оцінює окремі Podʼи з PodGroup окремо. Щоб звільнити місце для Podʼів групи, що очікують, він шукає жертви по всьому кластеру і знає, як обробляти та витісняти інші PodGroups як жертви відповідно до їхніх режимів порушення.
Процес витіснення з урахуванням робочого навантаження дотримується тих самих принципів, що й стандартне витіснення, з кількома відмінностями:
Домен по всьому кластеру: Замість оцінки витіснення вузол за вузлом, планувальник оцінює весь кластер як єдиний домен. Він обирає набір жертв на кількох вузлах, які можна видалити, щоб звільнити достатньо місця для планування PodGroup-витіснювача.
Ієрархія важливості жертв: Планувальник визначає, які одиниці витіснення (окремі Podʼи або PodGroups) є більш критичними і повинні бути захищені від витіснення, використовуючи сувору ієрархію:
Пріоритет: Одиниці з вищим пріоритетом завжди важливіші.
Тип робочого навантаження: PodGroups вважаються важливішими за окремі Podʼи з тим самим пріоритетом.
Розмір групи (PodGroups): Якщо обидві одиниці є PodGroups, той, що має більше членів (більший розмір), вважається важливішим.
Час запуску: Одиниці, які були запущені раніше, є важливішими.
Пріоритет і режим порушення групи Podʼів: Планувальник враховує конкретний пріоритет і режим порушення PodGroup для оцінки того, чи можна витісняти його Podʼи під час подій витіснення і як саме.
Міркування щодо продуктивності та оптимальності: З міркувань продуктивності витіснення з урахуванням робочого навантаження спочатку симулює видалення всіх потенційних жертв і виконує планування один раз. Потім воно намагається помилувати якомога більше жертв для обраного розміщення. Цей компроміс означає, що може існувати альтернативне розміщення, яке спричиняє менше витіснень, але воно не вибирається планувальником через міркування продуктивності.
Примітка:
Під час планування одного Podʼа застосовується стандартне витіснення Podʼів. У v1.36, коли планувальник виконує стандартне витіснення для одного Podʼа і намагається витіснити Pod, що належить до PodGroup, він не враховує поля priority або disruptionMode цього PodGroup. Це обмеження більше не застосовується у v1.37.
Алгоритм помилування
Під час виконання витіснення з урахуванням робочого навантаження планувальник запускає симуляцію, у якій він видаляє потенційних жертв витіснення та виконує алгоритм планування групи Podʼів. Потім він намагається помилувати якомога більше жертв для такого розміщення. Для цього планувальник повторно використовує CycleStates з планування групи Podʼів. Для кожної з потенційних жертв, відсортованих за їх важливістю, планувальник:
Додає Podʼи-жертви назад до їхніх вузлів та CycleStates Podʼів-витіснювачів.
Для кожного Podʼа в PodGroup (у тому ж порядку, що й в алгоритмі планування):
Запускає втулки Filter для Podʼа на його запропонованому вузлі
Додає Pod до його запропонованого вузла
Запускає втулки Reserve для Podʼа на його запропонованому вузлі
Якщо для кожного Podʼа фільтрація проходить успішно, Podʼи-жертви залишаються на своїх вузлах.
Якщо фільтрація не вдається принаймні для одного Podʼа, Podʼи-жертви видаляються з CycleStates та вузла.
В обох випадках планувальник видаляє Podʼи-витіснювачі з їхніх вузлів і викликає їх Unreserve, щоб наступна спроба помилування могла перевірити планування PodGroup. Потім планувальник переходить до іншої потенційної жертви, доки всі жертви не будуть оброблені.
Витіснення для CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, витіснення з урахуванням робочого навантаження також забезпечує підтримку CompositePodGroups.
Базовий механізм витіснення такий самий, як і для PodGroups — якщо планувальнику потрібно звільнити місткість, щоб розмістити кореневий CompositePodGroup, він оцінює витіснення для всієї ієрархії груп, а не для окремих Podʼів.
CompositePodGroups також можуть бути обрані як жертви витіснення. Процес вибору жертв скориговано, щоб враховувати CompositePodGroups наступним чином:
Ієрархія важливості жертв:
CompositePodGroups вважаються важливішими за окремі PodGroups з тим самим пріоритетом.
Для двох CompositePodGroups з однаковим пріоритетом важливішим вважається той, що має більше членів (більший розмір).
Режим порушення: Подібно до PodGroups, CompositePodGroups вказують режим порушення, який визначає, як слід обробляти їхні дочірні групи під час витіснення.
Окрім витіснення з урахуванням робочого навантаження, CompositePodGroups можуть бути обрані як жертви витіснення стандартним витісненням Podʼів під час циклу планування Podʼів, поряд із PodGroups та Podʼами. Стандартне витіснення Podʼів поділяє логіку ієрархії важливості жертв із витісненням з урахуванням робочого навантаження та враховує поле disruptionModeCompositePodGroups.
Ця стаття стосується пакування ресурсів у контексті планування одного Podʼа. Для пакування ресурсів під час планування груп Podʼів, будь ласка, прочитайте статтю про планування з урахуванням топології.
У втулку плануванняNodeResourcesFit kube-scheduler є дві стратегії оцінювання, які підтримують пакування ресурсів: MostAllocated та RequestedToCapacityRatio.
Увімкнення пакування ресурсів за допомогою стратегії MostAllocated
Стратегія MostAllocated оцінює вузли на основі використання ресурсів, віддаючи перевагу тим, у яких виділення вище. Для кожного типу ресурсів ви можете встановити вагу, щоб змінити його вплив на оцінку вузла.
Щоб встановити стратегію MostAllocated для втулка NodeResourcesFit, використовуйте конфігурацію планувальника, подібну до наступної:
За допомогою цієї конфігурації вузли оцінюються за зваженим середнім використанням усіх чотирьох ресурсів. Оскільки intel.com/foo та intel.com/bar мають вагу 3 порівняно з 1 для CPU та памʼяті, використання цих розширених ресурсів має втричі більший вплив на кінцеву оцінку вузла. Планувальник обирає вузол з найвищою оцінкою, прагнучи розміщувати Podʼи на вузлах з високим використанням ресурсів. Це допомагає підготуватися до зменшення кількості найменш використовуваних вузлів.
Щоб дізнатися більше про інші параметри та їх стандартну конфігурацію, див. документацію API для NodeResourcesFitArgs.
Увімкнення пакування ресурсів за допомогою стратегії RequestedToCapacityRatio
Стратегія RequestedToCapacityRatio дозволяє користувачам вказати ресурси разом з вагами для кожного ресурсу для оцінювання вузлів на основі відношення запиту до місткості. Це дозволяє користувачам пакувати розширені ресурси, використовуючи відповідні параметри для покращення використання дефіцитних ресурсів у великих кластерах. Вона віддає перевагу вузлам згідно з налаштованою функцією виділених ресурсів. Поведінкою RequestedToCapacityRatio в функції оцінювання NodeResourcesFit можна керувати за допомогою поля scoringStrategy. У межах поля scoringStrategy ви можете налаштувати два параметри: requestedToCapacityRatio та resources. Параметр shape в requestedToCapacityRatio дозволяє користувачу налаштувати функцію як least requested або most requested на основі значень utilization та score. Параметр resources охоплює як name ресурсу, що враховується під час оцінювання, так і відповідну weight, яка визначає вагу кожного ресурсу.
Нижче наведено приклад конфігурації, яка встановлює поведінку пакування для розширених ресурсів intel.com/foo та intel.com/bar за допомогою поля requestedToCapacityRatio.
В цьому прикладі лише розширені ресурси intel.com/foo та intel.com/bar зазначені в resources. Тому втулок NodeResourcesFit оцінює вузли виключно на основі використання цих двох ресурсів; CPU та памʼять не впливають на оцінку від цього втулка. Оскільки налаштована shape присвоює вищу оцінку зі збільшенням використання (score: 0 за utilization: 0, зростаючи до score: 10 за utilization: 100), планувальник віддає перевагу вузлам, де більше цих розширених ресурсів вже використовується, пакуючи запити на них на якомога меншу кількість вузлів.
Щоб включити CPU та памʼять у цю стратегію оцінювання, додайте їх до списку resources. Зверніть увагу, що всі ресурси в списку використовують одну й ту ж функцію shape, тому це застосує ту саму криву пакування до цих ресурсів.
Посилання на файл KubeSchedulerConfiguration з прапорцем kube-scheduler --config=/path/to/config/file передасть конфігурацію планувальнику.
Щоб дізнатися більше про інші параметри та їх стандартну конфігурацію, див. документацію API для NodeResourcesFitArgs.
Налаштування функції оцінювання
Параметр shape використовується для визначення поведінки функції RequestedToCapacityRatio.
Вищезазначені аргументи надають вузлу score 0, якщо utilization дорівнює 0%, та 10 для utilization 100%, що дозволяє пакування ресурсів. Щоб увімкнути least requested, значення оцінки потрібно обернути таким чином.
Параметр weight є необовʼязковим та встановлюється в 1, якщо його не вказано. Також weight не може бути відʼємним.
Оцінка вузла для розподілу місткості
Цей розділ призначений для тих, хто бажає зрозуміти внутрішні деталі цієї можливості. Нижче наведено приклад того, як обчислюється оцінка вузла для заданого набору значень.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Стандартний планувальник Kubernetes оцінює Podʼи послідовно. Коли кілька робочих навантажень, таких як завдання машинного навчання, подаються одночасно, ця послідовна оцінка може призвести до взаємних блокувань ресурсів. Наприклад, кожне з двох конкуруючих робочих навантажень може запланувати підмножину своїх Podʼів, споживаючи місткість кластера, але не залишаючи жодному з них достатньо ресурсів для повного запуску.
Цикл планування PodGroup оцінює групу Podʼів як єдине ціле. Планувальник намагається знайти розміщення для всіх Podʼів у групі одночасно. Якщо він не може знайти достатньо ресурсів для задоволення вимог усієї групи, жоден з Podʼів не буде привʼязаний до вузла.
Крім того, розгляд групи як єдиного цілого створює фундаментальну архітектуру, яка спрощує реалізацію інших можливостей планування на основі груп.
Ця можливість залежить від Workload API. Переконайтеся, що у кластері увімкнено групу APIscheduling.k8s.io/v1beta1.
Цикл планування PodGroup
Щоб підтримати планування групи Podʼів разом, kube-scheduler використовує цикл планування PodGroup. Замість обробки Podʼів окремо та утримання їх на етапі WaitOnPermit, планувальник оцінює всю групу Podʼів, що очікують і належать до конкретного PodGroup, колективно. Замість виконання окремих циклів планування для кожного Podʼа він оцінює здійсненність для всієї групи, а потім переходить безпосередньо до фази привʼязки.
Коли планувальник виявляє Pod, що належить до PodGroup, він повʼязує цей Pod із цим PodGroup, а не додає його безпосередньо до черги планування. PodGroup не потрапляє до черги планування, доки планувальник не виявить як обʼєкт PodGroup, так і принаймні один Pod, що належить до нього. Коли планувальник вибирає PodGroup, він отримує всі виявлені незаплановані Podʼи в цій групі. Потім він сортує їх детерміновано за пріоритетом та часом, коли вони були вперше виявлені планувальником, і ініціює цикл планування PodGroup таким чином:
Знімок стану кластера: Коли планувальник починає оцінювати PodGroup, він робить один знімок стану кластера, який зберігається протягом усього циклу. Це забезпечує консистентність оцінки для всієї групи та запобігає станам гонитви з іншими подіями.
Пошук здійсненних розміщень: Планувальник запускає алгоритм планування PodGroup, щоб знайти дійсні розміщення на вузлах для Podʼів у групі.
Атомарне рішення: Залежно від результату алгоритму, рішення про планування застосовується атомарно для всього PodGroup.
Success: Якщо планувальник знаходить достатньо ресурсів та дійсні розміщення для Podʼів (наприклад, задовольняючи обмеження minCount для групового планування), ці Podʼи переходять безпосередньо до циклу привʼязки до обраних вузлів. Будь-які залишкові непридатні для планування Podʼи в групі повторно ставляться безпосередньо в активну чергу планування без backoff, зберігаючи свою попередню мітку часу, щоб вони були негайно переоцінені для спроби витіснення.
Крім того, якщо до PodGroup додаються нові Podʼи, після того як інші вже були заплановані, цикл оцінює нові Podʼи, враховуючи вже наявні.
Failure: Якщо планувальник не може знайти достатньо ресурсів, щоб PodGroup став здійсненним (наприклад, не вдається задовольнити обмеження minCount), весь PodGroup вважається непридатним для планування.
Планувальник намагається зробити PodGroup придатним для планування, запускаючи точку розширення PodGroupPostFilter. Точка розширення PodGroupPostFilter втулка DefaultPreemption виконує витіснення з урахуванням робочого навантаження. Якщо будь-який втулок, що реалізує точку розширення PodGroupPostFilter, повертає Success, жодні інші втулки для точки розширення PodGroupPostFilter не виконуються.
Навіть коли втулок PodGroupPostFilter повертає Success, жоден Pod не привʼязується до вузла; натомість усі повертаються до черги планування в надії, що дії, виконані PodGroupPostFilter, зроблять PodGroup придатним для планування в наступному циклі. Застосовується стандартна логіка backoff планування, що дозволяє повторити спробу пізніше.
Використовуючи цей підхід з одним циклом, планувальник уникає неефективних вузьких місць, коли частково заплановані групи резервують ресурси кластера, чекаючи невизначено довго, поки решта їх групи не зможе розміститися.
Алгоритм планування PodGroup
Стандартний алгоритм планування PodGroup значною мірою покладається на базовий алгоритм планування на основі Podʼів. Він послідовно обробляє всі Podʼи і для кожного з них виконує таке:
Знаходить придатний вузол за допомогою стандартних фаз фільтрації та оцінки для кожного Podʼа.
Якщо Pod підходить, він тимчасово призначається та резервується на обраному вузлі до завершення роботи алгоритму планування.
Якщо Pod не підходить, планувальник не запускає точку розширення PostFilter. Натомість він покладається на точку розширення PodGroupPostFilter, яка виконується для всього PodGroup.
Перевіряє, чи відповідають придатні для планування Podʼи критеріям планування групи (наприклад, minCount для групового планування), викликаючи точку розширення PlacementFeasible після оцінки кожного Podʼа в групі на основі сукупних результатів планування. Якщо для будь-якого Podʼа повертається статус Success, PodGroup вважається здійсненним. Якщо алгоритм обробляє всі Podʼи без досягнення статусу Success або якщо під час цього циклу не заплановано жодного Podʼа, PodGroup вважається непридатним для планування.
Алгоритм планування розміщення
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TopologyAwareWorkloadScheduling feature gate for all relevant components in your cluster.
Алгоритм планування розміщення є альтернативним алгоритмом планування PodGroup, який використовує втулки планування для знаходження оптимального розміщення для розглянутого PodGroup. Користувачі можуть адаптувати алгоритм до своїх конкретних потреб, використовуючи та налаштовуючи втулки.
Алгоритм проходить три основні фази для цього PodGroup:
Фаза 1: Генерація кандидатів на розміщення
Генерує кандидатів на розміщення (підмножини вузлів, які теоретично можуть бути придатними для призначення PodGroup), наприклад, на основі обмежень планування PodGroup (які можуть бути визначені в обʼєкті PodGroup).
Ця фаза виконується в точці розширення PlacementGeneratePlugin.
Фаза 2: Фільтрація на рівні Podʼів і перевірка здійсненності
Перевіряє кожне запропоноване розміщення, запускаючи стандартний алгоритм планування PodGroup, щоб визначити, чи можна розмістити необхідну кількість Podʼів з PodGroup. Якщо це можливо, розміщення позначається як здійсненне.
Фаза 3: Оцінка та вибір розміщення
Оцінює всі здійсненні розміщення, щоб вибрати оптимальний домен для PodGroup.
Ця фаза виконується в точці розширення PlacementScorePlugin.
Обмеження
Алгоритм планування PodGroup покладається на специфічне сортування Podʼів і може не знайти дійсне розміщення, яке могло б бути виявлене під час обробки Podʼів групи в іншому порядку. Зокрема:
Для базових однорідних груп Podʼів (тобто тих, де всі Podʼи мають однакові вимоги до планування і не мають взаємозалежностей між Podʼами, таких як спорідненість, антиспорідненість або обмеження топології розміщення), очікується, що алгоритм знайде розміщення, якщо воно існує.
Для різнорідних груп Podʼів знаходження відповідного розміщення не гарантується.
Для груп Podʼів із взаємозалежностями між Podʼами знаходження відповідного розміщення не гарантується.
На додаток до вищезазначеного, у випадках, що включають взаємозалежності всередині групи (наприклад, коли можливість планування одного Podʼа залежить від іншого члена групи через спорідненість між Podʼами), цей алгоритм може не знайти розміщення незалежно від стану кластера через його детермінований порядок обробки.
Для забезпечення послідовної роботи протягом усього циклу алгоритм вимагає, щоб усі Podʼи, що належать до одного PodGroup, мали однакове поле .spec.schedulerName. Ця вимога перевіряється перед початком циклу, і PodGroup відхиляється, якщо ця умова не виконується.
Ієрархічне планування з CompositePodGroups
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, планувальник розширює цикл планування PodGroup для підтримки багаторівневих ієрархій груп.
В ієрархічному робочому навантаженні Podʼи належать до кінцевих обʼєктів PodGroup, які, своєю чергою, вказують батьківські ресурси CompositePodGroup аж до кореневого CompositePodGroup. Планувальник оцінює всю ієрархію груп як єдину, уніфіковану одиницю планування.
Виконання циклу ієрархічного планування
Після спостереження кореневого CompositePodGroup планувальник розміщує його в черзі планування, доки існує принаймні один Pod, що очікує та належить до ієрархії груп цього кореня.
Щойно кореневий CompositePodGroup задовольняє ієрархічний кворум, він потрапляє в активну чергу планування, з якої його може витягнути цикл планування. Цикл планування для CompositePodGroups виглядає так:
Уніфікований знімок кластера та перевірка: Планувальник робить знімок ресурсів кластера, щоб відобразити останній спостережений стан кластера. Він перевіряє, що форма ієрархії груп, витягнутої з черги, збігається зі знімком ієрархії, та перевіряє узгодженість конфігурації ієрархії (таку як однакові .spec.schedulerName та пріоритет серед Podʼів-членів).
Якщо форма ієрархії змінилася одночасно або не пройшла перевірку, цикл зупиняється та повторно ставить кореневий CompositePodGroup у чергу.
Генерація кандидатів на розміщення зверху вниз: На кожному рівні ієрархії, перед оцінкою дочірніх груп, планувальник викликає втулки PlacementGeneratePlugin, щоб згенерувати кандидатів на розміщення (підмножини вузлів) для групи, що оцінюється.
Кандидати на розміщення для дочірнього CompositePodGroup або кінцевого PodGroup генеруються виключно з підмножини вузлів, що належать до поточного оцінюваного розміщення батьківської групи. Для кореневого CompositePodGroup кандидати на розміщення генеруються по всіх доступних вузлах кластера.
Рекурсивна симуляція піддерева та перевірка здійсненності: Планувальник оцінює кожного кандидата на розміщення для CompositePodGroup, тимчасово припускаючи це розміщення у знімку кластера та рекурсивно плануючи його дочірні групи:
Рекурсивний обхід: Планувальник обходить дочірні групи в попередньо відсортованому порядку, викликаючи себе рекурсивно від CompositePodGroup вниз до кінцевих обʼєктів PodGroup. Для кожного кінцевого PodGroup планувальник запускає алгоритм планування розміщення, обмежений кандидатом на розміщення батьківської групи, щоб зробити попередні призначення Podʼів у памʼяті.
Перевірки здійсненності: Після оцінки кожної дочірньої групи планувальник викликає втулки PlacementFeasible, щоб визначити, чи може політика планування батьківської групи все ще бути виконана:
Якщо обмеження політики залишаються досяжними (або вже задоволені), планувальник продовжує оцінювати наступні сусідні групи.
Якщо обмеження політики більше не можуть бути задоволені, планувальник негайно перериває оцінку цього CompositePodGroup та скасовує всі попередні призначення Podʼів у памʼяті, зроблені для цієї групи.
Відкат симуляції: Після симуляції кандидата на розміщення (незалежно від успіху чи невдачі) планувальник скасовує попередні резервування вузлів, зроблені під час цієї симуляції, перед оцінкою наступного кандидата на розміщення.
Оцінка розміщення та фіксація піддерева: Після того, як усі кандидати на розміщення для CompositePodGroup були оцінені:
Оцінка: Якщо один або кілька кандидатів на розміщення є здійсненними, планувальник викликає втулки PlacementScorePlugin, щоб оцінити всіх здійсненних кандидатів на розміщення. Втулки оцінки оцінюють обʼєднані запропоновані призначення Podʼів по всіх дочірніх кінцевих обʼєктах PodGroup у піддереві та вибирають розміщення з найвищою загальною оцінкою.
Фіксація: Після вибору виграшного розміщення планувальник фіксує (припускає) попередні призначення Podʼів, що відповідають цьому оптимальному розміщенню, у памʼяті. Це гарантує, що наступні оцінки сусідніх груп або оцінки на рівні батьківської групи спостерігають узгоджені, оптимальні рішення планування для цього піддерева.
Якщо серед усіх згенерованих кандидатів не знайдено жодного здійсненного розміщення, весь CompositePodGroup вважається непридатним для планування.
Атомарна привʼязка: Якщо рекурсивна оцінка на кореневому рівні успішна та принаймні один Pod був успішно запланований, планувальник фіксує призначення Podʼів, переходячи до циклу привʼязки.
В іншому випадку весь CompositePodGroup вважається непридатним для планування.
Обмеження
Подібно до того, як алгоритм планування PodGroup покладається на специфічне сортування Podʼів, ієрархічний алгоритм планування покладається на специфічне сортування дочірніх груп у кожній ієрархії CompositePodGroup. В результаті він може не знайти дійсне розміщення, яке могло б бути виявлене під час обробки дочірніх груп в іншому порядку.
Крім того, оскільки планувальник оцінює ієрархії груп за допомогою жадібного підходу:
Знаходження дійсного розміщення не гарантується у всіх випадках, навіть якщо воно існує в кластері.
Навіть коли планувальник успішно знаходить дійсне розміщення для ієрархії CompositePodGroup, це розміщення не гарантовано є оптимальним по всьому кластеру.
Стани PodGroup
Після завершення циклу планування PodGroup планувальник оновлює стани в status.conditions PodGroup:
PodGroupInitiallyScheduled: повідомляє, чи був PodGroup успішно запланований вперше.
PodGroupInitiallyScheduled
Коли цикл планування успішний, стан встановлюється в True з причиною Scheduled. Для PodGroup з політикою gang це означає, що було розміщено принаймні minCount Podʼів.
Коли планування не вдається, стан встановлюється в False з однією з таких причин:
Unschedulable — групу не вдалося розмістити через обмеження ресурсів, правила спорідненості або антиспорідненості, або недостатню місткість для групи.
SchedulerError — планування не вдалося через внутрішню помилку планувальника (наприклад, під час розбору обмежень планування, таких як nodeAffinity).
Після того, як стан встановлено в True, він ніколи не змінюється.
Ви можете перевірити стани за допомогою:
kubectl get podgroup <name> -o jsonpath='{.status.conditions}'
Стани CompositePodGroup
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
6.10.14 - Планування робочих навантажень з урахуванням топології
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the TopologyAwareWorkloadScheduling feature gate for all relevant components in your cluster.
Планування з урахуванням топології (Topology-Aware Scheduling, TAS) є алгоритмом планування розміщення, який дозволяє знайти оптимальне розміщення для розглянутого PodGroup, гарантуючи, що всі Podʼи будуть розміщені разом у межах одного топологічного домену. Користувачі можуть налаштувати TAS відповідно до своїх конкретних потреб, змінюючи конфігурацію втулків TAS.
Фреймворк планування: налаштування втулків TAS
Планувальник включає нові та розширені вбудовані втулки, які реалізують точки розширення TAS:
TopologyPlacement: Реалізує інтерфейс PlacementGeneratePlugin. Він генерує кандидатів на розміщення, групуючи вузли на основі різних значень запитуваного ключа key топології (визначеного в PodGroup).
NodeResourcesFit: Розширено для реалізації інтерфейсу PlacementScorePlugin. Використовуючи подібну логіку до стандартного пакування Podʼів, він оцінює розміщення на основі коефіцієнта використання ресурсів на всіх вузлах у розміщенні. Використовується стратегія MostAllocated для максимізації використання ресурсів у розміщенні, а також успадковуються ваги ресурсів із стандартних налаштувань втулка pod-by-pod.
PodGroupPodsCount: Реалізує інтерфейс PlacementScorePlugin. Він оцінює кандидатів на розміщення на основі загальної кількості Podʼів у PodGroup, які можна успішно запланувати.
Налаштування ваг втулків та ваг ресурсів пакування
Стандартно втулки NodeResourcesFit та PodGroupPodsCount налаштовані з однаковими вагами (обидві стандартно мають вагу 1), щоб підтримувати хороший баланс між логікою пакування Podʼів та плануванням максимальної кількості Podʼів.
Ви можете змінити ці ваги або ваги ресурсів у стратегії пакування у вашій конфігурації KubeSchedulerConfiguration. Ось приклад фрагмента, який показує, як змінити ваги для обох втулків і як перевизначити ваги ресурсів для NodeResourcesFit. Остання зміна буде застосована як до алгоритмів планування pod-by-pod, так і до алгоритмів оцінки розміщення:
apiVersion:kubescheduler.config.k8s.io/v1kind:KubeSchedulerConfigurationprofiles:- schedulerName:default-schedulerplugins:placementScore:enabled:# 1) Зміна стандартних ваг втулків оцінки розміщення- name:NodeResourcesFitweight:2- name:PodGroupPodsCountweight:5pluginConfig:- name:NodeResourcesFitargs:# 2) Зміна ваг ресурсів для обох алгоритмів оцінки pod-by-pod та розміщенняscoringStrategy:# Тип буде враховуватися лише під час планування pod-by-pod. Оцінка розміщення завжди# використовує стратегію MostAllocatedtype:LeastAllocated# Ваги ресурсів будуть використовуватися як в алгоритмах планування pod-by-pod, так і в алгоритмах оцінки розміщенняresources:- name:cpuweight:2- name:memoryweight:3
Багаторівневі розміщення топології
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup та групу APIscheduling.k8s.io/v1alpha3 увімкнено, втулки планування з урахуванням топології розширюють свою підтримку на багаторівневі ієрархії CompositePodGroup. Ці втулки викликаються для CompositePodGroups під час ієрархічного планування.
Генерація кандидатів на розміщення
Для робочих навантажень, визначених з ієрархією CompositePodGroup, втулок TopologyPlacement генерує кандидатів на розміщення зверху вниз по ієрархії груп шляхом послідовного поділу:
Для кореневого CompositePodGroup втулок TopologyPlacement генерує кандидатів на розміщення по всіх доступних вузлах кластера, групуючи вузли на основі різних значень запитуваного ключа key топології.
Для дочірнього CompositePodGroup або кінцевого PodGroup втулок TopologyPlacement генерує кандидатів на розміщення, обмежених розміщенням, прийнятим батьківською групою. Він поділяє набір вузлів із розміщення батьківської групи, групуючи ці вузли на основі запитуваного ключа key топології дочірньої групи.
Примітка:
Якщо обмеження топології не вказано, втулок TopologyPlacement генерує одного кандидата на розміщення, еквівалентного розміщенню батьківської групи.
Аналогічно, якщо коренева група не вказує жодного обмеження топології, втулок генерує одного кандидата на розміщення, що відповідає всім доступним вузлам у кластері. Це також справедливо для однорівневих робочих навантажень, що використовують API PodGroup, де обмеження топології не вказано.
Оцінка розміщення
Під час оцінки кандидата на розміщення для CompositePodGroup втулки оцінки застосовують логіку, подібну до однорівневого випадку PodGroup:
PodGroupPodsCount: Оцінює кандидатів на розміщення на основі загальної кількості Podʼів (як уже запланованих, так і щойно прийнятих) по всіх дочірніх кінцевих PodGroups цього CompositePodGroup. Кандидати на розміщення, здатні вмістити більшу загальну кількість Podʼів по підієрархії, отримують вищі оцінки.
NodeResourcesFit: Агрегує запити ресурсів усіх запропонованих Podʼів по всіх дочірніх PodGroups цього CompositePodGroup та оцінює використання ресурсів по всіх вузлах у межах домену кандидата на розміщення.
Podʼи можуть мати пріоритет. Пріоритет вказує на важливість Podʼа порівняно з іншими Podʼами. Якщо Pod не може бути запланований, планувальник намагається витіснити (виселити) Podʼи з нижчим пріоритетом, щоб зробити можливим планування Podʼа в очікуванні.
Попередження:
У кластері, де не всі користувачі є довіреними, зловмисник може створити Podʼи з найвищими можливими пріоритетами, що призведе до виселення інших Podʼів або неможливості їх планування. Адміністратор може використовувати ResourceQuota, щоб запобігти користувачам створювати Podʼи з високими пріоритетами.
Створіть Podʼи з параметром priorityClassName, встановленим на один з доданих PriorityClasses. Звісно, вам не потрібно створювати Podʼи безпосередньо; зазвичай ви додаєте priorityClassName до шаблону Podʼа обʼєкта колекції, такого як Deployment.
Продовжуйте читати для отримання додаткової інформації про ці кроки.
PriorityClass
PriorityClass є обʼєктом, що не належить до простору імен, і визначає зіставлення назви класу пріоритету з цілим значенням пріоритету. Назва вказується в полі name метаданих обʼєкта PriorityClass. Значення вказується в обовʼязковому полі value. Чим вище значення, тим вищий пріоритет. Назва обʼєкта PriorityClass повинна бути дійсною назвою піддомену DNS, і вона не може мати префікс system-.
Обʼєкт PriorityClass може мати будь-яке 32-розрядне ціле значення, яке менше або дорівнює 1 мільярду. Це означає, що діапазон значень для обʼєкта PriorityClass становить від -2147483648 до 1000000000 включно. Більші числа зарезервовані для вбудованих PriorityClass, які представляють критичні системні Podʼи. Адміністратор кластера повинен створити один обʼєкт PriorityClass для кожного потрібного йому зіставлення.
Примітка:
Kubernetes вже поставляється з двома PriorityClasses: system-cluster-critical та system-node-critical. Ці спільні класи використовуються для забезпечення того, що критичні компоненти завжди плануються першими. Для Kubernetes v1.37 їхні значення пріоритету становлять 2000000000 для system-cluster-critical і 2000001000 для system-node-critical.
PriorityClass також має два необовʼязкові поля: globalDefault та description. Поле globalDefault вказує, що значення цього PriorityClass повинно використовуватися для Podʼів без priorityClassName. У системі може існувати лише один PriorityClass з globalDefault, встановленим в true. Якщо немає PriorityClass із встановленим globalDefault, пріоритет Podʼів без priorityClassName дорівнює нулю.
Поле description є довільним рядком. Воно призначене для сповіщення користувачів кластера про те, коли вони повинні використовувати цей PriorityClass.
Примітки щодо PodPriority та наявних кластерів
Якщо ви оновлюєте наявний кластер без цієї можливості, пріоритет ваших наявних Podʼів фактично дорівнює нулю.
Додавання PriorityClass з globalDefault, встановленим в true, не змінює пріоритети наявних Podʼів. Значення такого PriorityClass використовується тільки для Podʼів, створених після додавання PriorityClass.
Якщо ви видаляєте PriorityClass, наявні Podʼи, які використовують назву видаленого PriorityClass, залишаються незмінними, але ви не можете створювати більше Podʼів, які використовують назву видаленого PriorityClass.
Приклад PriorityClass
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priorityvalue:1000000globalDefault:falsedescription:"This priority class should be used for XYZ service pods only."
PriorityClass без витіснення
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.24
Podʼи з preemptionPolicy: Never будуть розміщені в черзі планування перед Podʼами з нижчим пріоритетом, але вони не можуть витісняти інші Podʼи. Pod без витіснення, який очікує на планування, залишиться в черзі планування, доки не буде достатньо вільних ресурсів і його можна буде запланувати. Podʼи без витіснення, як і інші Podʼи, підлягають backoff планувальника. Це означає, що якщо планувальник спробує запланувати ці Podʼи, і вони не можуть бути заплановані, повторні спроби будуть рідшими, що дозволяє іншим Podʼам з нижчим пріоритетом бути запланованими перед ними.
Podʼи без витіснення все ще можуть бути витіснені іншими Podʼами з високим пріоритетом.
Стандартне значення preemptionPolicy — PreemptLowerPriority, що дозволяє Podʼам цього PriorityClass витісняти Podʼи з нижчим пріоритетом (це наявна стандартна поведінка). Якщо preemptionPolicy встановлено в Never, Podʼи в цьому PriorityClass не витіснятимуть інші Podʼи.
Прикладом використання є робочі навантаження науки про дані. Користувач може надіслати завдання, якому він хоче дати пріоритет перед іншими робочими навантаженнями, але не бажає втрачати наявну роботу, витісняючи запущені Podʼи. Завдання з високим пріоритетом із preemptionPolicy: Never буде заплановано перед іншими Podʼами в черзі, щойно достатньо ресурсів кластера «природним чином» звільниться.
Приклад PriorityClass без витіснення
apiVersion:scheduling.k8s.io/v1kind:PriorityClassmetadata:name:high-priority-nonpreemptingvalue:1000000preemptionPolicy:NeverglobalDefault:falsedescription:"This priority class will not cause other pods to be preempted."
Пріоритет Podʼа
Після того, як у вас є один або кілька PriorityClasses, ви можете створювати Podʼи, які вказують одну з назв цих PriorityClasses у своїх специфікаціях. Контролер допуску пріоритетів використовує поле priorityClassName і заповнює ціле значення пріоритету. Якщо клас пріоритету не знайдено, Pod відхиляється.
Наведений нижче YAML — це приклад конфігурації Podʼа, який використовує PriorityClass, створений у попередньому прикладі. Контролер допуску пріоритетів перевіряє специфікацію та визначає пріоритет Podʼа як 1000000.
Коли пріоритет Podʼа увімкнено, планувальник впорядковує Podʼи в очікуванні за їх пріоритетом, і Pod в очікуванні розташовується в черзі планування попереду інших Podʼів в очікуванні з нижчим пріоритетом. В результаті Pod з вищим пріоритетом може бути запланований швидше, ніж Podʼи з нижчим пріоритетом, якщо його вимоги до планування виконуються. Якщо такий Pod не може бути запланований, планувальник продовжить спроби запланувати інші Podʼи з нижчим пріоритетом.
PodGroups та порядок планування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Коли функціональну можливість GenericWorkload увімкнено, PodGroups чергуються з окремими Podʼами в черзі планування. Обʼєкт PodGroup має власне поле priority, яке використовується для впорядкування відносно інших Podʼів та PodGroups. Деталі щодо того, як встановити пріоритет PodGroup, доступні на сторінці Порушення та пріоритет групи Podʼів.
CompositePodGroups та порядок планування
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CompositePodGroup feature gate for all relevant components in your cluster.
Коли функціональну можливість CompositePodGroup увімкнено, планувальник розглядає наступні обʼєкти як одиниці планування, які можуть бути поставлені в чергу:
Самостійні Podʼи — Podʼи, які не є частиною жодного PodGroup,
Самостійні PodGroups — PodGroups, які не вказують ParentCompositePodGroup,
Кореневі CompositePodGroups — CompositePodGroups, які не вказують ParentCompositePodGroup.
Ці обʼєкти вказують значення поля priority, яке використовується для визначення їх позиції в активній черзі планування.
Витіснення
Коли Podʼи створюються, вони потрапляють у чергу та очікують на планування. Планувальник вибирає Pod з черги та намагається запланувати його на вузлі. Якщо не знайдено жодного вузла, який задовольняє всі вказані вимоги Podʼа, для Podʼа в очікуванні спрацьовує логіка витіснення. Назвімо цей Pod в очікуванні P. Логіка витіснення спробує знайти вузол, де видалення одного або кількох Podʼів з нижчим пріоритетом, ніж P, дозволить запланувати P на цьому вузлі. Якщо такий вузол знайдено, один або кілька Podʼів з нижчим пріоритетом будуть виселені з вузла. Після того, як ці Podʼи зникнуть, P може бути запланований на вузлі.
Витіснення PodGroup
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the GenericWorkload feature gate for all relevant components in your cluster.
Коли функціональну можливість GenericWorkload увімкнено, PodGroups можуть брати участь у витісненні як ініціатор або як жертва. Коли PodGroup ініціює витіснення, він дотримується логіки витіснення з урахуванням робочого навантаження, щоб витіснити інші Podʼи та PodGroups і звільнити місце для себе. Коли Pod ініціює витіснення, PodGroup може стати жертвою. У цьому випадку поле priority PodGroup використовується для впорядкування відносно інших потенційних жертв, а поле disruptionMode використовується для визначення поведінки PodGroup під час порушення. Детальний опис цих полів доступний на сторінці Порушення та пріоритет групи Podʼів.
Інформація, доступна користувачеві
Коли Pod P витісняє один або кілька Podʼів на вузлі N, поле nominatedNodeName статусу Podʼа P встановлюється в назву вузла N. Це поле допомагає планувальнику відстежувати ресурси, зарезервовані для Podʼа P, і також надає користувачам інформацію про витіснення в їх кластерах.
Зверніть увагу, що Pod P не обовʼязково планується на «номінований вузол». Планувальник завжди спочатку спробує «номінований вузол», перед тим як перевіряти будь-які інші вузли. Після того, як Podʼи-жертви витіснено, вони отримують свій період коректного завершення. Якщо під час очікування на завершення роботи Podʼів-жертв стає доступним інший вузол, планувальник може використати інший вузол для планування Podʼа P. В результаті поля nominatedNodeName та nodeName специфікації Podʼа не завжди збігаються. Крім того, якщо планувальник витісняє Podʼи на вузлі N, а потім надходить Pod вищого пріоритету, ніж Pod P, планувальник може надати вузол N новому Podʼу вищого пріоритету. У такому випадку планувальник очищає nominatedNodeName Podʼа P. Цим самим планувальник робить Pod P придатним для витіснення Podʼів на іншому вузлі.
Обмеження витіснення
Коректне завершення роботи жертв витіснення
Коли Podʼи витісняються, жертви отримують свій період коректного завершення. У них є стільки часу, скільки вказано в цьому періоді, для завершення своєї роботи та виходу. Якщо вони цього не роблять, їх робота завершується примусово. Цей період коректного завершення створює проміжок часу між моментом, коли планувальник витісняє Podʼи, і моментом, коли Pod (P) в очікуванні може бути запланований на вузол (N). Тим часом планувальник продовжує планувати інші Podʼи в очікуванні. Поки жертви завершують роботу самі або примусово, планувальник намагається запланувати Podʼи з черги очікування. Тому зазвичай є проміжок часу між моментом, коли планувальник витісняє жертв, і моментом, коли Pod P буде заплановано. Щоб зменшити цей проміжок, можна встановити період коректного завершення для Podʼів з нижчим пріоритетом на нуль або мале число.
PodDisruptionBudget підтримується, але не гарантується
PodDisruptionBudget (PDB) дозволяє власникам застосунків обмежувати кількість Podʼів реплікованого застосунку, які одночасно недоступні через добровільні порушення. Kubernetes підтримує PDB під час витіснення Podʼів, але дотримання PDB відбувається за принципом best-effort. Планувальник намагається знайти жертв, PDB яких не буде перевищено в результаті витіснення, але якщо жодної такої жертви не знайдено, витіснення все одно відбудеться, і Podʼи з нижчим пріоритетом будуть видалені, попри перевищення їхнього PDB.
Спорідненість між Podʼами для Podʼів з нижчим пріоритетом
Вузол розглядається для витіснення тільки тоді, коли відповідь на це питання ствердна: «Якщо всі Podʼи з нижчим пріоритетом, ніж Pod в очікуванні, будуть видалені з вузла, чи може Pod в очікуванні бути запланований на цьому вузлі?»
Примітка:
Витіснення не обовʼязково видаляє всі Podʼи з нижчим пріоритетом. Якщо Pod в очікуванні може бути запланований, видаливши менше, ніж всі Podʼи з нижчим пріоритетом, то видаляється лише частина Podʼів з нижчим пріоритетом. Попри це, відповідь на попереднє питання повинна бути ствердною. Якщо відповідь негативна, то вузол не розглядається для витіснення.
Якщо Pod в очікуванні має спорідненість між Podʼами з одним або кількома Podʼами з нижчим пріоритетом на вузлі, правило спорідненості між Podʼами не може бути виконане за відсутності цих Podʼів з нижчим пріоритетом. У цьому випадку планувальник не витісняє жодних Podʼів на вузлі. Замість цього він шукає інший вузол. Планувальник може знайти відповідний вузол або може і не знайти. Немає гарантії, що Pod в очікуванні може бути запланований.
Рекомендованим рішенням для цієї проблеми є створення спорідненості між Podʼами лише з Podʼами з рівним або вищим пріоритетом.
Міжвузлове витіснення
Припустимо, що вузол N розглядається для витіснення, щоб запланувати Pod P в очікуванні на N. Планування P на N може стати здійсненним лише у випадку витіснення Podʼа на іншому вузлі. Ось приклад:
Pod P розглядається для вузла N.
Pod Q запущений на іншому вузлі в тій же зоні, що й вузол N.
Pod P має антиспорідненість по всій зоні з Podʼом Q (з topologyKey: topology.kubernetes.io/zone).
Інших випадків антиспорідненості між Podʼом P та іншими Podʼами в зоні немає.
Щоб запланувати Pod P на вузлі N, Pod Q може бути витіснений, але планувальник не виконує міжвузлове витіснення. Отже, Pod P буде вважатися непридатним для планування на вузлі N.
Якщо Pod Q буде видалено зі свого вузла, порушення антиспорідненості Podʼа буде усунено, і Pod P, можливо, можна буде запланувати на вузлі N.
Ми можемо розглянути додавання міжвузлового витіснення в майбутніх версіях, якщо буде достатньо попиту і якщо ми знайдемо алгоритм з прийнятною продуктивністю.
Витіснення для зміни розміру Podʼа на місці
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the InPlacePodVerticalScalingSchedulerPreemption feature gate for all relevant components in your cluster.
Коли функціональну можливість InPlacePodVerticalScalingSchedulerPreemption увімкнено, витіснення також застосовується, коли запит на зміну розміру запущеного Podʼа на місці має статус Deferred (тобто запитана зміна розміру тимчасово неможлива, але може стати можливою пізніше) через недостатню місткість вузла. Деталі щодо станів зміни розміру дивіться в статусі зміни розміру Podʼа.
Якщо Pod вищого пріоритету не може бути змінений на місці, оскільки його вузлу бракує доступних CPU або памʼяті, kube-scheduler намагається витіснити Podʼи нижчого пріоритету на цьому вузлі, щоб звільнити необхідну місткість.
Витіснення для зміни розміру Podʼа на місці відрізняється від стандартного витіснення під час розміщення Podʼа кількома ключовими способами:
Обмеження вузла: Витіснення суворо обмежене поточним призначеним вузлом Podʼа. Планувальник не оцінює інші вузли-кандидати по всьому кластеру.
Обчислення дельти ресурсів: Необхідна для витіснення місткість обчислюється на основі дельти ресурсів (різниці між бажаними та поточно виділеними ресурсами), а не загального запиту Podʼа.
Блокування ресурсів: Запитані ресурси Podʼа, розмір якого змінюється, вважаються вже спожитими для обліку ресурсів планувальника на цьому вузлі, не даючи іншим Podʼам нижчого пріоритету їх використовувати, доки зміна розміру не буде виконана або kubelet не видалить статус Deferred.
Статус номінованого вузла: Поле nominatedNodeName у статусі Podʼа не встановлюється, оскільки Pod вже призначений і працює на своєму цільовому вузлі.
Виконання kubelet: Планувальник ініціює витіснення, щоб звільнити місткість вузла, але не привʼязує Pod повторно. Kubelet виявляє щойно звільнену місткість на вузлі та виконує фактичну зміну розміру на місці.
Політика витіснення на рівні вузла: Витіснення можна вимкнути спеціально для змін розміру на місці на конкретних вузлах за допомогою поля spec.podPreemptionPolicy.disableResizePreemption специфікації Node. На відміну від стандартного витіснення, яке можна вимкнути лише для кожного класу пріоритету за допомогою preemptionPolicy: Never, це дозволяє операторам або системам автомасштабування вимикати витіснення на окремих вузлах.
Вимкнення витіснення для зміни розміру Podʼа на місці на рівні вузла
Оператори кластера та контролери можуть вимикати ініційоване планувальником витіснення, спричинене запитами на зміну розміру Podʼа на місці, на конкретних вузлах. Це корисно для вузлів, розмір яких можна змінювати, або вузлів із власними рішеннями автомасштабування, захищаючи наявні робочі навантаження від порушення та дозволяючи натомість усунути дефіцит ресурсів збільшенням розміру вузла.
Це налаштовується за допомогою поля spec.podPreemptionPolicy у специфікації Node. Якщо список disableResizePreemption не порожній, витіснення, спричинене зміною розміру, вимикається на цьому вузлі, і kube-scheduler пропускатиме спроби витіснення для будь-яких відкладених змін розміру, що виконуються на цьому вузлі.
Формат мітки: Кожен запис у списку disableResizePreemption повинен відповідати стандартному формату ключа мітки Kubernetes (наприклад, префікс піддомену DNS та назва, розділені /).
Максимальна кількість: Список може містити максимум 20 записів.
Непорожній список: Політика виконується (витіснення вимикається), якщо список містить принаймні один запис. Якщо список порожній або поле podPreemptionPolicy опущено, витіснення для зміни розміру на місці увімкнено на вузлі.
Розвʼязання проблем
Пріоритет та витіснення Podʼа можуть мати небажані побічні ефекти. Ось кілька прикладів потенційних проблем і способів їх вирішення.
Podʼи витісняються безпідставно
Витіснення видаляє наявні Podʼи з кластера під тиском на ресурси, щоб звільнити місце для високопріоритетних Podʼів в очікуванні. Якщо ви помилково встановили високі пріоритети для певних Podʼів, ці ненавмисно високопріоритетні Podʼи можуть спричинити витіснення у вашому кластері. Пріоритет Podʼа вказується встановленням поля priorityClassName в специфікації Podʼа. Потім ціле значення пріоритету визначається і заповнюється у поле prioritypodSpec.
Щоб розвʼязати цю проблему, ви можете змінити priorityClassName для цих Podʼів, щоб використовувати класи з нижчим пріоритетом, або залишити це поле порожнім. Порожній priorityClassName стандартно вважається нулем.
Коли Pod витісняється, для такого Podʼа будуть записані події. Витіснення повинно відбуватися лише тоді, коли в кластері недостатньо ресурсів для Podʼа. У таких випадках витіснення відбувається лише тоді, коли пріоритет Podʼа в очікуванні (витіснювача) вищий, ніж у Podʼів-жертв. Витіснення не повинно відбуватися, коли немає Podʼа в очікуванні, або коли Podʼи в очікуванні мають рівні або нижчі пріоритети, ніж у жертв. Якщо витіснення відбувається в таких сценаріях, будь ласка, повідомте про проблему.
Podʼи витісняються, але витіснювач не планується
Коли Podʼи витісняються, вони отримують запитаний період коректного завершення, який стандартно становить 30 секунд. Якщо Podʼи-жертви не завершуються протягом цього періоду, вони завершуються примусово. Після того, як усі жертви зникають, Pod-витіснювач може бути запланований.
Поки Pod-витіснювач чекає, доки жертви зникнуть, може бути створений Pod з вищим пріоритетом, який підходить на той самий вузол. У цьому випадку планувальник запланує Pod з вищим пріоритетом замість витіснювача.
Це очікувана поведінка: Pod з вищим пріоритетом повинен зайняти місце Podʼа з нижчим пріоритетом.
Podʼи з вищим пріоритетом витісняються раніше за Podʼи з нижчим пріоритетом
Планувальник намагається знайти вузли, на яких можна запустити Pod в очікуванні. Якщо вузол не знайдено, планувальник намагається видалити Podʼи з нижчим пріоритетом з довільного вузла, щоб звільнити місце для Podʼа в очікуванні. Якщо вузол з Podʼами низького пріоритету не може бути використаний для запуску Podʼа в очікуванні, планувальник може вибрати інший вузол з Podʼами вищого пріоритету (порівняно з Podʼами на іншому вузлі) для витіснення. Жертви все ще повинні мати нижчий пріоритет, ніж Pod-витіснювач.
Коли є доступні кілька вузлів для витіснення, планувальник намагається вибрати вузол з набором Podʼів з найнижчим пріоритетом. Однак якщо такі Podʼи мають PodDisruptionBudget, який буде перевищено, якщо вони будуть витіснені, то планувальник може вибрати інший вузол з Podʼами вищого пріоритету.
Коли є кілька вузлів для витіснення і жоден з вищезазначених сценаріїв не застосовується, планувальник вибирає вузол з найнижчим пріоритетом.
Взаємодія між пріоритетом Podʼа та якістю обслуговування
Пріоритет Podʼа та клас якості обслуговування є двома ортогональними можливостями з невеликою кількістю взаємодій та без стандартних обмежень щодо встановлення пріоритету Podʼа на основі його класів QoS. Логіка витіснення планувальника не враховує QoS під час вибору цілей витіснення. Витіснення враховує пріоритет Podʼа і намагається вибрати набір цілей з найнижчим пріоритетом. Podʼи вищого пріоритету розглядаються для витіснення лише тоді, коли видалення Podʼів з найнижчим пріоритетом не є достатнім для того, щоб дозволити планувальнику розмістити Pod-витіснювач, або якщо Podʼи з найнижчим пріоритетом захищені PodDisruptionBudget.
kubelet використовує пріоритет для визначення порядку Podʼів для виселення внаслідок тиску на вузол. Ви можете використовувати клас QoS для оцінки порядку, в якому найімовірніше будуть виселятися Podʼи. kubelet ранжує Podʼи для виселення на основі таких факторів:
Чи перевищує використання дефіцитного ресурсу запити
Пріоритет Podʼа
Обсяг використання ресурсів в порівнянні із запитами
Виселення kubelet внаслідок тиску на вузол не виселяє Podʼи, коли їх використання не перевищує їх запити. Якщо Pod з нижчим пріоритетом не перевищує свої запити, він не буде виселений. Інший Pod з вищим пріоритетом, який перевищує свої запити, може бути виселений.
Виселення внаслідок тиску на вузол — це процес, під час якого kubelet проактивно завершує роботу Podʼів, щоб звільнити ресурси на вузлах.
kubelet моніторить ресурси, такі як памʼять, простір на диску та inode файлової системи на вузлах вашого кластера. Коли один або кілька з цих ресурсів досягають певних рівнів використання, kubelet може проактивно завершити зі збоєм один або кілька Podʼів на вузлі, щоб звільнити ресурси та запобігти їх вичерпанню.
Під час виселення внаслідок тиску на вузол kubelet встановлює фазу для вибраних Podʼів в значення Failed та завершує роботу Podʼа.
kubelet не враховує ваш налаштований PodDisruptionBudget або параметр terminationGracePeriodSeconds Podʼа. Якщо ви використовуєте порогові значення мʼякого виселення, kubelet дотримується вашого налаштованого evictionMaxPodGracePeriod. Якщо ви використовуєте порогові значення жорсткого виселення, kubelet використовує період коректного завершення 0s (негайне вимкнення) для завершення роботи.
Поведінка самозцілення
kubelet намагається звільнити ресурси на рівні вузла перед тим, як завершувати роботу Podʼів кінцевих користувачів. Наприклад, він видаляє невикористані образи контейнерів, коли дискових ресурсів недостатньо.
Якщо Podʼами керує обʼєкт керування робочим навантаженням (такий як StatefulSet або Deployment), який замінює Podʼи зі збоєм, панель управління (kube-controller-manager) створює нові Podʼи на місці виселених Podʼів.
Самозцілення статичних Podʼів
Якщо ви запускаєте статичний Pod на вузлі, який перебуває під тиском на ресурси, kubelet може виселити цей статичний Pod. Потім kubelet намагається створити заміну, оскільки статичні Podʼи завжди представляють намір запустити Pod на цьому вузлі.
Kubelet враховує пріоритет статичного Podʼа під час створення заміни. Якщо маніфест статичного Podʼа вказує низький пріоритет, і в межах панелі управління кластера визначені Podʼи з вищим пріоритетом, і вузол перебуває під тиском на ресурси, то kubelet може не мати можливості звільнити місце для цього статичного Podʼа. Kubelet продовжує намагатися запустити всі статичні Podʼи навіть тоді, коли на вузлі є тиск на ресурси.
Сигнали та пороги виселення
Kubelet використовує різні параметри для прийняття рішень щодо виселення, такі як:
Сигнали виселення
Пороги виселення
Інтервали моніторингу
Сигнали виселення
Сигнали виселення — це поточний стан певного ресурсу в конкретний момент часу. Kubelet використовує сигнали виселення для прийняття рішень про виселення, порівнюючи їх з порогами виселення, які є мінімальною кількістю ресурсу, яка повинна бути доступна на вузлі.
У цій таблиці стовпець Опис показує, як kubelet отримує значення сигналу. Кожен сигнал підтримує відсоткове або літеральне значення. Kubelet обчислює відсоткове значення відносно загальної місткості, повʼязаної із сигналом.
Сигнали памʼяті
На вузлах Linux значення для memory.available походить з cgroupfs замість таких інструментів, як free -m. Це важливо, оскільки free -m не працює у контейнері, і якщо користувачі використовують можливість ресурсів вузла, доступних для розподілу, рішення про вичерпання ресурсів приймаються локально в частині ієрархії cgroup, що належить Podʼам кінцевих користувачів, а також на кореневому вузлі. Цей скрипт або скрипт cgroupv2 відтворює той самий набір кроків, які kubelet виконує для обчислення memory.available. Kubelet виключає зі свого обчислення inactive_file (кількість байтів памʼяті, що має файлове резервне сховище, у неактивному списку LRU), оскільки припускає, що цю памʼять можна звільнити під тиском.
Примітка:
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно увімкнено)
На вузлах із налаштованими hugepages kubelet віднімає загальну місткість hugepages вузла від memory.available, яку використовує менеджер виселення. Без цього коригування зарезервована під hugepages оперативна памʼять завищує AvailableBytes, оскільки контролер cgroup памʼяті не відстежує виділення hugetlb у своєму робочому наборі. Це може затримати виселення та призвести до OOM-завершень. Щоб відновити попередню поведінку, вимкніть функціональну можливість HugepageAwareEviction.
На Windows-вузлах значення memory.available отримується з глобального рівня комітів памʼяті вузла (запитується через системний виклик GetPerformanceInfo()) шляхом віднімання глобального значення CommitTotal від CommitLimit вузла. Зверніть увагу, що значення CommitLimit може змінюватися, якщо змінюється розмір файлу підкачки вузла!
Сигнали файлової системи
Kubelet розпізнає три конкретні ідентифікатори файлової системи, які можна використовувати із сигналами виселення (<identifier>.inodesFree або <identifier>.available):
nodefs: Основна файлова система вузла, використовується для локальних дискових томів, томів emptyDir, які не підтримуються памʼяттю, зберігання логів, ефемерного зберігання та іншого. Наприклад, nodefs містить /var/lib/kubelet.
imagefs: Необовʼязкова файлова система, яку середовища виконання контейнерів можуть використовувати для зберігання образів контейнерів (які є шарами тільки для читання). Якщо окремої файлової системи containerfs немає, файлова система образів також зберігає шари контейнера, доступні для запису.
containerfs: Необовʼязкова файлова система, яку середовища виконання контейнерів можуть використовувати для зберігання записуваних шарів контейнерів. Коли використовується containerfs, файлова система imagefs може бути розділена так, щоб зберігати лише образи (шари тільки для читання) і більше нічого.
Ці ідентифікатори описують файлові системи так, як їх бачить kubelet. Вони не завжди означають три різні точки монтування: у звичайних конфігураціях два або всі три ідентифікатори можуть посилатися на одну й ту ж базову файлову систему.
Примітка:
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.31; (стандартно увімкнено)
Можливість split image filesystem додає нові сигнали виселення, пороги та метрики для containerfs. Щоб використовувати containerfs, у випуску Kubernetes v1.37 потрібно увімкнути функціональну можливість KubeletSeparateDiskGC. Для Kubernetes v1.37 підтримку файлової системи containerfs пропонує лише CRI-O (v1.29 або вище).
Kubelet підтримує три поширені схеми розміщення файлових систем контейнерів:
Усе зберігається на єдиній nodefs, яку також називають «rootfs» або просто «root». У цій схемі nodefs, imagefs та containerfs посилаються на одну й ту саму базову файлову систему.
Сховище середовища виконання контейнерів розміщено на окремому диску, відокремленому від кореневої файлової системи. У цій схемі imagefs та containerfs посилаються на одну й ту саму базову файлову систему, яка зберігає як шари образів, так і записувані шари контейнерів. Це часто називають файловою системою «split disk» (або «separate disk»).
Записувані шари контейнерів розміщено на nodefs, а образи контейнерів (шари лише для читання) зберігаються на окремій imagefs. У цій схемі containerfs та nodefs посилаються на одну й ту саму базову файлову систему. Це часто називають файловою системою «split image».
Kubelet спробує автоматично виявити ці файлові системи з їхньою поточною конфігурацією безпосередньо з базового середовища виконання контейнерів і ігноруватиме інші локальні файлові системи вузла.
Kubelet не підтримує інші файлові системи контейнерів або конфігурації зберігання і наразі не підтримує кілька файлових систем для образів і контейнерів.
Застарілі можливості збору сміття kubelet
Деякі можливості збору сміття kubelet застаріли на користь виселення:
Наявний прапорець
Обґрунтування
--maximum-dead-containers
застаріло, щойно старі логи зберігаються поза контекстом контейнера
--maximum-dead-containers-per-container
застаріло, щойно старі логи зберігаються поза контекстом контейнера
--minimum-container-ttl-duration
застаріло, щойно старі логи зберігаються поза контекстом контейнера
Пороги виселення
Ви можете вказати власні пороги виселення для kubelet, які він буде використовувати під час прийняття рішень про виселення. Ви можете налаштувати мʼякі та жорсткі пороги виселення.
Пороги виселення мають формат [eviction-signal][operator][quantity], де:
operator — це оператор відношення, який ви хочете використати, наприклад, < (менше ніж).
quantity — це кількість порогу виселення, наприклад, 1Gi. Значення quantity повинно відповідати представленню кількості, яке використовується в Kubernetes. Ви можете використовувати як літеральні значення, так і відсотки (%).
Наприклад, якщо вузол має загальний обсяг памʼяті 10GiB і ви хочете ініціювати виселення, коли доступна памʼять опуститься нижче 1GiB, ви можете визначити поріг виселення як memory.available<10% або memory.available<1Gi (використовувати обидва варіанти одночасно не можна).
Мʼякі пороги виселення
Мʼякий поріг виселення поєднує в собі поріг виселення з обовʼязковим пільговим періодом, вказаним адміністратором. Kubelet не виселяє Podʼи до закінчення пільгового періоду. Kubelet повертає помилку під час запуску, якщо ви не вказали пільговий період.
Ви можете вказати як пільговий період для мʼякого порогу виселення, так і максимально дозволений період коректного завершення Podʼів, який kubelet використовуватиме під час виселення. Якщо ви вказали максимально дозволений період і мʼякий поріг виселення досягнуто, kubelet використовує менший із двох періодів. Якщо ви не вказали максимально дозволений період, kubelet негайно завершує роботу виселених Podʼів без коректного завершення.
Ви можете використовувати такі налаштування у файлі конфігурації kubelet:
evictionSoft: Набір порогів виселення, наприклад, memory.available<1.5Gi, які можуть ініціювати виселення Podʼів, якщо вони утримуються протягом вказаного пільгового періоду.
evictionSoftGracePeriod: Набір пільгових періодів для виселення, наприклад, memory.available=1m30s, які визначають, як довго мʼякий поріг виселення повинен утримуватися, перш ніж буде ініційовано виселення Podʼа.
evictionMaxPodGracePeriod: Максимально дозволений період коректного завершення (у секундах) для використання під час завершення Podʼів у відповідь на досягнення мʼякого порогу виселення.
Жорсткі пороги виселення
Жорсткий поріг виселення не має пільгового періоду. Коли досягнуто жорсткого порогу виселення, kubelet негайно завершує роботу Podʼів без коректного завершення, щоб звільнити дефіцитний ресурс.
Ви можете використовувати поле evictionHard для налаштування набору жорстких порогів виселення, наприклад memory.available<1Gi.
Kubelet має наступні стандартні жорсткі пороги виселення:
memory.available<100Mi (для вузлів Linux)
memory.available<500Mi (для вузлів Windows)
nodefs.available<10%
imagefs.available<15%
nodefs.inodesFree<5% (для вузлів Linux)
imagefs.inodesFree<5% (для вузлів Linux)
Ці стандартні значення жорстких порогів виселення будуть встановлені лише у випадку, якщо жоден з параметрів не змінено. Якщо ви зміните значення будь-якого параметра, то значення інших параметрів не будуть успадковані як стандартні та будуть встановлені в нуль. Щоб надати власні значення, ви повинні вказати всі пороги відповідно. Ви також можете встановити параметр MergeDefaultEvictionSettings у true у файлі конфігурації kubelet. Якщо встановити true і змінити будь-який параметр, то інші параметри успадкують свої стандартні значення, а не 0.
Стандартні пороги виселення для containerfs.available і containerfs.inodesFree (для Linux-вузлів) будуть встановлені таким чином:
Якщо containerfs та nodefs посилаються на одну й ту саму базову файлову систему, то пороги для containerfs встановлюються такими ж, як і для nodefs.
Якщо containerfs та imagefs посилаються на одну й ту саму базову файлову систему, то пороги для containerfs встановлюються такими ж, як і для imagefs.
Налаштування власних порогів, повʼязаних із containerfs, не підтримується, і буде видано попередження, якщо спробувати це зробити; будь-які надані власні значення будуть ігноровані.
Інтервал моніторингу виселення
Kubelet оцінює пороги виселення, виходячи з налаштованого housekeeping-interval, стандартне значення якого — 10s.
Стани вузла
Kubelet повідомляє про стани вузла, показуючи, що вузол перебуває під тиском через досягнення порогу жорсткого або мʼякого виселення, незалежно від налаштованих пільгових періодів.
Kubelet зіставляє сигнали виселення зі станами вузла таким чином:
Стан вузла
Сигнал виселення
Опис
MemoryPressure
memory.available
Доступна памʼять на вузлі досягла порогового значення для виселення
DiskPressure
nodefs.available, nodefs.inodesFree, imagefs.available, imagefs.inodesFree, containerfs.available, або containerfs.inodesFree
Доступне місце на диску та inode на кореневій файловій системі вузла, файловій системі образів або файловій системі контейнерів досягли порогового значення для виселення
PIDPressure
pid.available
Доступні ідентифікатори процесів на (Linux) вузлі зменшилися нижче порогового значення для виселення
Панель управління також зіставляє ці стани вузла на taints.
Kubelet оновлює стани вузла відповідно до налаштованого nodeStatusUpdateFrequency, стандартне значення якого — 10s.
Коливання станів вузла
У деяких випадках вузли коливаються вище та нижче мʼяких порогів виселення, не утримуючись протягом визначених пільгових періодів. Це призводить до того, що стан вузла, про який повідомляється, постійно перемикається між true та false, що призводить до поганих рішень щодо виселення.
Для захисту від коливань можна використовувати прапорець eviction-pressure-transition-period, який контролює, як довго kubelet повинен чекати перш ніж перевести стан вузла в інше значення. Період переходу має стандартне значення 5m.
Звільнення ресурсів на рівні вузла
Kubelet намагається звільнити ресурси на рівні вузла перед виселенням Podʼів кінцевих користувачів.
Коли вузол повідомляє про стан DiskPressure, kubelet звільняє ресурси на рівні вузла на основі файлових систем на вузлі.
Без imagefs або containerfs
Якщо на вузлі є лише файлова система nodefs, яка досягає порогів виселення, kubelet звільняє місце на диску в такому порядку:
Виконує збір сміття для мертвих Podʼів і контейнерів.
Видаляє непотрібні образи.
З використанням imagefs
Якщо на вузлі є окрема файлова система imagefs, яку використовують середовища виконання контейнерів, то kubelet робить таке:
Якщо файлова система nodefs досягає порогів виселення, то kubelet виконує збір сміття для мертвих Podʼів і контейнерів.
Якщо файлова система imagefs досягає порогів виселення, то kubelet видаляє всі невикористані образи.
З imagefs та containerfs
Якщо на вузлі налаштована окрема containerfs разом із файловою системою imagefs, які використовують середовища виконання контейнерів, то kubelet намагатиметься звільнити ресурси таким чином:
Якщо файлова система containerfs досягає порогів виселення, kubelet виконує збір сміття для мертвих Podʼів і контейнерів.
Якщо файлова система imagefs досягає порогів виселення, kubelet видаляє всі невикористані образи.
Вибір Podʼів для виселення kubelet
Якщо спроби kubelet звільнити ресурси на рівні вузла не знижують сигнал виселення нижче порогу, kubelet починає виселяти Podʼи кінцевих користувачів.
Kubelet використовує наступні параметри для визначення порядку виселення Podʼів:
Чи перевищує використання ресурсів Podʼа їх запити
Використання ресурсів Podʼа в порівнянні з запитами
В результаті kubelet ранжує та виселяє Podʼи в наступному порядку:
Podʼи BestEffort або Burstable, де використання перевищує запити. Ці Podʼи виселяються на основі їх пріоритету, а потім за тим, наскільки їхнє використання перевищує запит.
Podʼи Guaranteed та Burstable, де використання менше за запити, виселяються останніми, на основі їх пріоритету.
Примітка:
Kubelet не використовує клас QoS Podʼа для визначення порядку виселення. Ви можете використовувати клас QoS для оцінки найбільш ймовірного порядку виселення Podʼів під час звільнення ресурсів, таких як памʼять. Класифікація QoS не застосовується до запитів EphemeralStorage, тому вищезазначений сценарій не буде застосовуватися, якщо вузол, наприклад, перебуває під DiskPressure.
Podʼи Guaranteed гарантовані лише тоді, коли для всіх контейнерів вказано запити та обмеження, і вони є однаковими. Ці Podʼи ніколи не будуть виселятися через споживання ресурсів іншим Podʼом. Якщо системний демон (наприклад, kubelet та journald) споживає більше ресурсів, ніж було зарезервовано за допомогою розподілів systemReserved або kubeReserved, і на вузлі залишилися лише Guaranteed або Burstable Podʼи, які використовують менше ресурсів, ніж запити, то kubelet повинен вибрати Pod для виселення для збереження стабільності вузла та обмеження впливу нестачі ресурсів на інші Podʼи. У цьому випадку він вибере Podʼи з найнижчим пріоритетом першими.
Якщо ви використовуєте статичний Pod і хочете уникнути його виселення під час нестачі ресурсів, встановіть поле priority для цього Podʼа безпосередньо. Статичні Podʼи не підтримують поле priorityClassName.
Коли kubelet виселяє Podʼи у відповідь на вичерпання inode або ідентифікаторів процесів, він використовує відносний пріоритет Podʼів для визначення порядку виселення, оскільки для inode та PID не існує запитів.
Kubelet сортує Podʼи по-різному залежно від того, чи є на вузлі окрема файлова система imagefs чи containerfs:
Без imagefs або containerfs (nodefs і imagefs використовують одну і ту ж файлову систему)
Якщо nodefs ініціює виселення, kubelet сортує Podʼи на основі їх загального використання диска (локальні томи + логи та записуваний шар усіх контейнерів).
З imagefs (nodefs і imagefs — окремі файлові системи)
Якщо nodefs ініціює виселення, kubelet сортує Podʼи на основі використання nodefs (локальні томи + логи всіх контейнерів).
Якщо imagefs ініціює виселення, kubelet сортує Podʼи на основі використання записуваного шару всіх контейнерів.
З imagefs та containerfs (imagefs та containerfs розділені)
Якщо containerfs ініціює виселення, kubelet сортує Podʼи на основі використання containerfs (локальні томи + логи та записуваний шар усіх контейнерів).
Якщо imagefs ініціює виселення, kubelet сортує Podʼи на основі ранжування storage of images, яке відображає використання диска для даного образу.
Мінімальне звільнення ресурсів під час виселення
Примітка:
Станом на Kubernetes v1.37 ви не можете встановити власне значення для метрики containerfs.available. Конфігурація для цієї конкретної метрики буде встановлена автоматично, щоб відображати значення, задані для nodefs або imagefs, залежно від конфігурації.
У деяких випадках виселення Podʼів звільняє лише невелику кількість дефіцитного ресурсу. Це може призвести до того, що kubelet раз у раз досягатиме налаштованих порогів виселення та ініціюватиме кілька виселень.
Ви можете використовувати поле evictionMinimumReclaim у файлі конфігурації kubelet для налаштування мінімальної кількості звільнення для кожного ресурсу. Коли kubelet помічає нестачу ресурсу, він продовжує звільняти цей ресурс, доки не звільнить кількість, яку ви вказали.
Наприклад, наступна конфігурація встановлює мінімальні кількості звільнення:
У цьому прикладі, якщо сигнал nodefs.available досягає порога виселення, kubelet звільняє ресурс, доки сигнал не досягне порога в 1GiB, а потім продовжує звільняти мінімальну кількість 500MiB, доки доступний обсяг сховища nodefs не досягне 1,5GiB.
Аналогічно, kubelet намагається звільнити ресурс imagefs, доки значення imagefs.available не досягне 102Gi, що представляє 102GiB доступного сховища для образів контейнерів. Якщо кількість сховища, яку може звільнити kubelet, менша за 2GiB, kubelet нічого не звільняє.
Стандартно evictionMinimumReclaim дорівнює 0 для всіх ресурсів.
Поведінка в разі вичерпання памʼяті на вузлі
Якщо вузол зазнає події out of memory (OOM) до того, як kubelet зможе звільнити памʼять, вузол залежить від реагування oom_killer.
Kubelet встановлює значення oom_score_adj для кожного контейнера на основі QoS для Podʼа.
Kubelet також встановлює значення oom_score_adj рівне -997 для будь-яких контейнерів у Podʼах, які мають пріоритетsystem-node-critical.
Якщо kubelet не може звільнити памʼять до того, як вузол зазнає OOM, oom_killer обчислює оцінку oom_score на основі відсотка памʼяті, яку він використовує на вузлі, а потім додає oom_score_adj, щоб отримати ефективну оцінку oom_score для кожного контейнера. Потім він примусово завершує роботу контейнера з найвищою оцінкою.
Це означає, що спочатку припиняється робота контейнерів у Podʼах низького QoS, які споживають велику кількість памʼяті в порівнянні з їх запитами на планування.
На відміну від виселення Podʼа, якщо роботу контейнера було припинено через вичерпання памʼяті, kubelet може перезапустити його відповідно до його restartPolicy.
Поради
У наступних розділах описано найкращі практики конфігурації виселення.
Ресурси, доступні для планування, та політики виселення
Під час конфігурації kubelet з політикою виселення слід переконатися, що планувальник не розміщуватиме Podʼи, які спричинять виселення через те, що вони одразу створюють тиск на памʼять.
Розгляньте такий сценарій:
Обсяг памʼяті вузла: 10GiB
Оператор бажає зарезервувати 10% обсягу памʼяті для системних демонів (ядро, kubelet тощо)
Оператор бажає виселяти Podʼи за використання памʼяті на рівні 95%, щоб зменшити кількість випадків OOM у системі.
Для цього файл конфігурації kubelet заповнюється таким чином:
У цій конфігурації systemReserved резервує 1,5GiB памʼяті для системи, що становить 10% від загальної памʼяті + кількість порогу виселення.
Вузол може досягти порогу виселення, якщо Pod використовує більше, ніж його запит, або якщо система використовує більше 1GiB памʼяті, що знижує значення memory.available нижче 500MiB і спричиняє спрацювання порогу.
DaemonSets та виселення внаслідок тиску на вузол
Пріоритет Podʼа — це основний фактор під час прийняття рішень про виселення. Якщо вам не потрібно, щоб kubelet виселяв Podʼи, які належать до DaemonSet, встановіть цим Podʼам достатньо високий пріоритет, вказавши відповідний priorityClassName в специфікації Podʼа. Ви також можете використовувати нижчий пріоритет або стандартне значення, щоб дозволити запускати Podʼи з цього DaemonSet тільки тоді, коли є достатньо ресурсів.
Відомі проблеми
У наступних розділах описані відомі проблеми, повʼязані з обробкою вичерпання ресурсів.
kubelet може помітити тиск на памʼять не одразу
Стандартно kubelet опитує cAdvisor, щоб регулярно збирати статистику використання памʼяті. Якщо використання памʼяті швидко зростає протягом цього інтервалу, kubelet може не помітити MemoryPressure достатньо швидко, і OOM killer все одно буде викликано.
Ви можете використовувати поле конфігурації kernelMemcgNotification, щоб увімкнути API сповіщення memcg в kubelet і отримувати повідомлення негайно, коли перетинається поріг.
Якщо ви прагнете не екстремального використання, а розумного рівня overcommit, робочим обхідним рішенням цієї проблеми є використання полів конфігурації kubeReserved та systemReserved для виділення памʼяті для системи.
active_file памʼять не вважається доступною памʼяттю
В Linux ядро відстежує кількість байтів файлової памʼяті в активному списку LRU (least recently used) як статистику active_file. Kubelet розглядає області памʼяті active_file як такі, що не підлягають звільненню. Для робочих навантажень, що інтенсивно використовують локальне сховище з блоковою підтримкою, включаючи ефемерне локальне сховище, кеші ядра для файлів і блоків означають, що багато нещодавно використаних сторінок кеша, ймовірно, будуть враховані як active_file. Якщо достатньо цих буферів блоків ядра перебувають на активному списку LRU, kubelet може сприйняти це як високе використання ресурсів та накласти на вузол taint тиску на памʼять, що ініціює виселення Podʼів.
Ви можете обійти цю проблему, встановивши для контейнерів, які ймовірно виконують інтенсивну діяльність з операцій введення/виведення, однакове обмеження памʼяті та запит памʼяті. Вам потрібно оцінити або виміряти оптимальне значення обмеження памʼяті для цього контейнера.
Виселення, ініційоване API, — це процес, під час якого ви використовуєте Eviction API для створення обʼєкта Eviction, що запускає коректне завершення роботи Podʼа.
Ви можете ініціювати виселення, викликавши Eviction API безпосередньо або програмно,
використовуючи клієнт API-сервера, наприклад, команду kubectl drain. Це створює обʼєкт Eviction, що змушує API-сервер завершити роботу Podʼа.
Використання API для створення обʼєкта Eviction для Podʼа схоже на виконання контрольованої політикою операції DELETE над Podʼом.
Виклик Eviction API
Ви можете використовувати клієнтську бібліотеку Kubernetes, щоб отримати доступ до API Kubernetes та створити обʼєкт Eviction. Для цього надішліть POST-запит на виконання операції, подібний до наведеного нижче прикладу:
Коли ви запитуєте виселення за допомогою API, API-сервер виконує перевірки допуску
і відповідає одним із таких способів:
200 OK: виселення дозволено, субресурс Eviction створюється, і Pod видаляється, подібно до надсилання DELETE-запиту на URL Podʼа.
429 Too Many Requests: виселення на цей момент не дозволено через налаштований PodDisruptionBudget. Можливо, ви зможете спробувати виселення пізніше. Ви також можете отримати цю відповідь через обмеження швидкості API.
500 Internal Server Error: виселення не дозволено через помилкову конфігурацію, наприклад, якщо декілька PodDisruptionBudget посилаються на той самий Pod.
Якщо Pod, який ви хочете виселити, не є частиною робочого навантаження, яке має PodDisruptionBudget, API-сервер завжди повертає 200 OK та дозволяє виселення.
Якщо API-сервер дозволяє виселення, Pod видаляється так:
Ресурс Pod в API-сервері оновлюється з часовою міткою видалення, після чого API-сервер вважає ресурс Pod таким, що завершив роботу. Ресурс Pod також позначений налаштованим періодом належного завершення роботи.
kubelet на вузлі, на якому запущений локальний Pod, помічає, що ресурс Pod позначений для припинення та починає належним чином завершувати локальний Pod.
Поки kubelet завершує роботу Podʼа, панель управління видаляє Pod з обʼєктів EndpointSlice. В результаті контролери більше не вважають Pod за дійсний обʼєкт.
Після закінчення періоду належного завершення роботи для Podʼа kubelet примусово завершує локальний Pod.
kubelet повідомляє API-серверу, що ресурс Pod треба видалити.
API-сервер видаляє ресурс Pod.
Виправлення застряглих виселень
У деяких випадках ваші застосунки можуть потрапити в непрацездатний стан, де Eviction API буде повертати лише відповіді 429 або 500, поки ви не втрутитеся. Це може відбуватися, наприклад, якщо ReplicaSet створює Podʼи для вашого застосунку, але нові Podʼи не переходять в стан Ready. Ви також можете помітити цю поведінку у випадках, коли останній виселений Pod мав довгий період належного завершення роботи.
Якщо ви помічаєте застряглі виселення, спробуйте одне з таких рішень:
Скасуйте або призупиніть автоматизовану операцію, що викликає проблему. Дослідіть застряглий застосунок, перш ніж перезапустити операцію.
Почекайте трохи, а потім безпосередньо видаліть Pod з панелі управління вашого кластера замість використання Eviction API.
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.35 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate NodeDeclaredFeatures, Kubernetes ignores it but does not report any error.
Вузли Kubernetes використовують оголошені можливості для повідомлення про доступність конкретних можливостей, які є новими або вмикаються через feature gate. Компоненти панелі управління використовують цю інформацію для прийняття кращих рішень. Kube-scheduler за допомогою втулка NodeDeclaredFeatures гарантує, що Podʼи розміщуються тільки на вузлах, які явно підтримують можливості, необхідні для Podʼа. Крім того, контролер допуску NodeDeclaredFeatureValidator перевіряє оновлення Podʼів на відповідність оголошеним можливостям вузла.
Цей механізм допомагає керувати розбіжностями версій і покращувати стабільність кластера, особливо під час оновлення кластера або в середовищах зі змішаними версіями, де не на всіх вузлах можуть бути увімкнені однакові можливості. Він призначений для розробників можливостей Kubernetes, які впроваджують нові можливості на рівні вузлів, і працює у фоновому режимі; розробникам застосунків, які розгортають Podʼи, не потрібно безпосередньо взаємодіяти з цим механізмом.
Як це працює
Оголошена можливість — це рядок, який вузол перелічує в полі .status.declaredFeatures обʼєкта Node. Кожна можливість, яку можна оголосити, ідентифікує можливість на рівні вузла, яка все ще проходить через етапи розвитку можливостей Kubernetes.
Звіт про можливості Kubelet: під час запуску kubelet на кожному вузлі виявляє, які керовані можливості Kubernetes наразі увімкнені, і повідомляє про них у полі .status.declaredFeatures вузла. У це поле включаються лише можливості, що активно розробляються.
Фільтрування планувальника: стандартний планувальник kube-scheduler використовує втулок NodeDeclaredFeatures. Цей втулок:
На етапі PreFilter перевіряє PodSpec, щоб визначити набір можливостей вузла, необхідних для Podʼа.
На етапі Filter перевіряє, чи можливості, перелічені в .status.declaredFeatures вузла, відповідають вимогам, визначеним для Podʼа. Podʼи не плануються на вузлах, які не мають необхідних можливостей.
Власні планувальники також можуть використовувати поле .status.declaredFeatures для застосування подібних обмежень.
Контроль допуску: Контролер допуску NodeDeclaredFeatureValidator може відхиляти Podʼи, які вимагають можливостей, не оголошених вузлом, до якого вони привʼязані, запобігаючи проблемам під час оновлення Podʼів.
Допуск Kubelet: Як останній запобіжний захід, kubelet повторно перевіряє вимоги Podʼа до можливостей на відповідність можливостям, доступним на його вузлі, перед запуском Podʼа, і відхиляє Pod, якщо необхідна можливість відсутня.
Очищення після GA: Коли можливість стає доступною на всіх вузлах кластера (після того, як можливість переходить до GA і підтримувана розбіжність версій між панеллю управління та вузлами минула), вузли припиняють оголошувати можливість. Це досягається шляхом встановлення максимальної версії (MaxVersion) для кожної оголошеної можливості: kubeletʼи новіші за цю версію припиняють перелічувати можливість в .status.declaredFeatures, а планувальник і контролер допуску вважають можливість загальнодоступною та припиняють її перевіряти. Можливість зрештою видаляється з набору оголошених можливостей у рамках стандартного очищення можливостей після GA.
Pod вимагає цю можливість, якщо один із його контейнерів вказує правило перезапуску з дією RestartAllContainers:
apiVersion:v1kind:Podmetadata:name:example-podspec:containers:- name:mainimage:registry.k8s.io/busybox:1.27.2restartPolicy:Never # Якщо визначено правила, необхідно вказати політику перезапуску контейнераrestartPolicyRules:# Перезапустити весь Pod на місці за коду виходу 42- action:RestartAllContainersexitCodes:operator:Invalues:[42]
Під час планування цього Podʼа kube-scheduler розглядає лише вузли, які перелічують RestartAllContainersOnContainerExits у своєму .status.declaredFeatures. У кластері, де лише деякі вузли мають увімкнену цю функціональну можливість (наприклад, у середині оновлення кластера), це запобігає призначенню Podʼа вузлу, чий kubelet ігнорував би правило перезапуску.
Оголошені можливості також обмежують оновлення запущених Podʼів. Наприклад, оголошена можливість InPlacePodVerticalScalingInitContainers вказує, що вузол підтримує зміну розміру ресурсів init-контейнерів на місці. Якщо є спроба змінити розмір init-контейнера в запущеному Podʼі, контролер допуску NodeDeclaredFeatureValidator відхиляє оновлення, якщо вузол, на якому працює цей Pod, не оголошує цю можливість.
Як Kubernetes представляє, запитує, виділяє та обмежує ресурси, які споживають робочі навантаження.
Цей розділ описує, як Kubernetes представляє, запитує, виділяє та обмежує ресурси, які споживають робочі навантаження, включно зі спеціалізованими апаратними пристроями.
6.11.1 - Менеджери ресурсів
Для підтримки робочих навантажень, критичних до затримки та з високою пропускною здатністю, Kubernetes пропонує набір менеджерів ресурсів. Ці менеджери призначені для координації та оптимізації вирівнювання ресурсів вузла для Podʼів, налаштованих із конкретними вимогами до ресурсів CPU, пристроїв і памʼяті (hugepages).
Менеджер топології
This is a stable feature in Kubernetes, and has been since the 1.27 release. You can no longer toggle this feature (the associated feature gate has been removed).
Менеджер топології — це компонент kubelet, який координує набір компонентів, відповідальних за ці оптимізації. Щоб дізнатися більше, прочитайте Керування політиками топології на вузлі.
Менеджер CPU
This is a stable feature in Kubernetes, and has been since the 1.26 release. You can no longer toggle this feature (the associated feature gate has been removed).
Менеджер CPU — це компонент kubelet, який забезпечує ексклюзивне виділення ресурсів CPU. Для прийняття рішень щодо призначення ресурсів він консультується з менеджером топології. Щоб дізнатися більше, прочитайте Налаштування політик керування CPU на вузлі.
Політики призначення CPU Podʼам
Після привʼязки Podʼа до вузла kubelet на цьому вузлі може потребувати або мультиплексування наявного апаратного забезпечення (наприклад, спільного використання CPU між кількома Podʼами), або виділення апаратного забезпечення шляхом резервування певних ресурсів (наприклад, виділення одного або кількох CPU для виключного використання одним Podʼом).
Стандартно kubelet використовує квоту CFS для застосування обмежень CPU Podʼів. Коли на вузлі працює багато Podʼів, залежних від CPU, робоче навантаження може переміщуватися між різними ядрами CPU залежно від того, чи зазнає Pod тротлінгу і які ядра CPU доступні на момент планування. Багато робочих навантажень не чутливі до цієї міграції і тому нормально працюють без будь-якого втручання.
Однак для робочих навантажень, де спорідненість кешу CPU та затримка планування суттєво впливають на продуктивність, kubelet дозволяє використовувати альтернативні політики керування CPU, щоб визначати деякі вподобання щодо розміщення на вузлі. Це реалізовано за допомогою менеджера CPU та його політики. Доступні дві політики:
none: політика none явно вмикає наявну стандартну схему спорідненості CPU, не забезпечуючи спорідненості понад те, що автоматично робить планувальник ОС. Обмеження використання CPU для Podʼів Guaranteed та Podʼів Burstable застосовуються за допомогою квоти CFS.
static: політика static дозволяє контейнерам у Podʼах Guaranteed із цілочисельними requests CPU отримувати доступ до ексклюзивних CPU на вузлі. Ця ексклюзивність забезпечується за допомогою контролера cgroup cpuset.
Примітка:
Системні сервіси, такі як середовище виконання контейнерів і сам kubelet, можуть і надалі працювати на цих ексклюзивних CPU. Ексклюзивність поширюється лише на інші Podʼи.
Менеджер CPU не підтримує вимкнення та ввімкнення CPU під час роботи.
Політика static
Політика static забезпечує детальніше керування CPU та ексклюзивне призначення CPU. Ця політика керує спільним пулом CPU, який спочатку містить усі CPU вузла. Кількість CPU, доступних для ексклюзивного виділення, дорівнює загальній кількості CPU вузла за вирахуванням резервувань CPU, заданих конфігурацією kubelet. CPU, зарезервовані цими параметрами, беруться в цілій кількості з початкового спільного пулу за зростанням фізичного ідентифікатора ядра. Цей спільний пул є набором CPU, на яких працюють усі контейнери в Podʼах BestEffort та Burstable. Контейнери в Podʼах Guaranteed із дробовими requests CPU також працюють на CPU зі спільного пулу. Ексклюзивні CPU отримують лише контейнери, які є частиною Podʼа Guaranteed і мають цілочисельні requests CPU.
Примітка:
kubelet вимагає резервування CPU більше за нуль, коли ввімкнено політику static. Це тому, що нульове резервування CPU дозволило б спільному пулу стати порожнім.
Коли Podʼи Guaranteed, контейнери яких відповідають вимогам статичного призначення, плануються на вузол, CPU вилучаються зі спільного пулу та розміщуються в cpuset контейнера. Квота CFS не використовується для обмеження використання CPU цими контейнерами, оскільки їхнє використання обмежене самим доменом планування. Іншими словами, кількість CPU в cpuset контейнера дорівнює цілочисельному limit CPU, вказаному в специфікації Podʼа. Це статичне призначення підвищує спорідненість CPU та зменшує кількість перемикань контексту через тротлінг для робочого навантаження, залежного від CPU.
Розгляньмо контейнери в наведених нижче специфікаціях Podʼів:
spec:containers:- name:nginximage:nginx
Наведений вище Pod працює в класі QoS BestEffort, оскільки не вказано жодних requests чи limits ресурсів. Він працює в спільному пулі.
Наведений вище Pod працює в класі QoS Burstable, оскільки requests ресурсів не дорівнюють limits, а кількість cpu не вказана. Він працює в спільному пулі.
Наведений вище Pod працює в класі QoS Guaranteed, оскільки requests дорівнюють limits. І обмеження ресурсу CPU контейнера є цілим числом, більшим або рівним одиниці. Контейнер nginx отримує 2 ексклюзивні CPU.
Наведений вище Pod працює в класі QoS Guaranteed, оскільки requests дорівнюють limits. Але обмеження ресурсу CPU контейнера є дробовим. Він працює в спільному пулі.
Наведений вище Pod працює в класі QoS Guaranteed, оскільки вказано лише limits, а requests прирівнюються до limits, коли їх не вказано явно. І обмеження ресурсу CPU контейнера є цілим числом, більшим або рівним одиниці. Контейнер nginx отримує 2 ексклюзивні CPU.
Параметри політики static
Ось доступні параметри політики керування CPU static, перелічені в алфавітному порядку:
align-by-socket (alpha, стандартно приховано)
Вирівнювання CPU за межею фізичного пакета / сокета, а не за логічними межами NUMA (доступно з Kubernetes v1.25)
Розподіл CPU по різних доменах NUMA з метою рівномірного балансу між вибраними доменами (доступно з Kubernetes v1.23)
full-pcpus-only (GA, стандартно видимо)
Завжди виділяти повні фізичні ядра (доступно з Kubernetes v1.22, GA з Kubernetes v1.33)
strict-cpu-reservation (GA, стандартно видимо)
Запобігання запуску всіх Podʼів незалежно від їхнього класу якості обслуговування на зарезервованих CPU (доступно з Kubernetes v1.32, GA з Kubernetes v1.35)
Вирівнювання CPU за межею кешу uncore (Last-Level) за принципом best-effort (доступно з Kubernetes v1.32)
Ви можете вмикати або вимикати групи параметрів залежно від їхнього рівня зрілості за допомогою таких функціональних можливостей:
CPUManagerPolicyBetaOptions (стандартно увімкнено). Вимкніть, щоб приховати параметри рівня beta.
CPUManagerPolicyAlphaOptions (стандартно вимкнено). Увімкніть, щоб показати параметри рівня alpha.
Вам все одно потрібно ввімкнути кожен параметр за допомогою поля cpuManagerPolicyOptions у файлі конфігурації kubelet.
Щоб дізнатися більше про окремі параметри, які можна налаштувати, читайте далі.
full-pcpus-only
Якщо вказано параметр політики full-pcpus-only, політика static завжди виділятиме повні фізичні ядра. Стандартно, без цього параметра, політика static виділяє CPU за принципом найкращого збігу з урахуванням топології. На системах з увімкненим SMT політика може виділяти окремі віртуальні ядра, які відповідають апаратним потокам. Це може призвести до того, що різні контейнери використовуватимуть ті самі фізичні ядра; така поведінка, у свою чергу, сприяє проблемі шумних сусідів. З увімкненим параметром kubelet допустить Pod лише тоді, коли запит CPU всіх його контейнерів можна задовольнити виділенням повних фізичних ядер. Якщо Pod не проходить допуск, він переходить у стан Failed із повідомленням SMTAlignmentError.
distribute-cpus-across-numa
Якщо вказано параметр політики distribute-cpus-across-numa, політика static рівномірно розподілятиме CPU між вузлами NUMA у випадках, коли для виконання виділення потрібно більше одного вузла NUMA. Стандартно CPUManager розміщує CPU на одному вузлі NUMA, доки він не заповниться, а залишкові CPU просто переходять на наступний вузол NUMA. Це може спричинити небажані вузькі місця в паралельному коді, що використовує барʼєри (та подібні примітиви синхронізації), оскільки такий код зазвичай працює лише так швидко, як його найповільніший робочий процес (який сповільнюється через те, що принаймні на одному вузлі NUMA доступно менше CPU). Рівномірно розподіляючи CPU між вузлами NUMA, розробники застосунків можуть легше забезпечити, щоб жоден робочий процес не страждав від ефектів NUMA більше за інші, покращуючи загальну продуктивність таких застосунків.
align-by-socket
Якщо вказано параметр політики align-by-socket, CPU вважатимуться вирівняними за межею сокета під час вирішення того, як виділити CPU контейнеру. Стандартно CPUManager вирівнює виділення CPU за межею NUMA, що може призвести до зниження продуктивності, якщо для виконання виділення CPU потрібно взяти більш ніж з одного вузла NUMA. Хоча він намагається забезпечити виділення всіх CPU з мінімальної кількості вузлів NUMA, немає гарантії, що ці вузли NUMA будуть на одному сокеті. Вказавши CPUManager явно вирівнювати CPU за межею сокета, а не NUMA, ми можемо уникнути таких проблем. Зверніть увагу, що цей параметр політики несумісний із політикою single-numa-nodeTopologyManager і не застосовується до апаратного забезпечення, де кількість сокетів більша за кількість вузлів NUMA.
distribute-cpus-across-cores
Якщо вказано параметр політики distribute-cpus-across-cores, політика static намагатиметься виділяти віртуальні ядра (апаратні потоки) на різних фізичних ядрах. Стандартно CPUManager намагається розмістити CPU на якомога меншій кількості фізичних ядер, що може призвести до конкуренції між CPU на одному фізичному ядрі та спричинити вузькі місця продуктивності. Увімкнення політики distribute-cpus-across-cores забезпечує розподіл CPU на якомога більшій кількості фізичних ядер, зменшуючи конкуренцію на одному фізичному ядрі та покращуючи загальну продуктивність. Однак важливо зазначити, що ця стратегія може бути менш ефективною за високого навантаження системи. У таких умовах користь від зменшення конкуренції зменшується. Натомість стандартна поведінка може допомогти зменшити накладні витрати на міжядерну комунікацію, потенційно забезпечуючи кращу продуктивність за високого навантаження.
strict-cpu-reservation
Параметр reservedSystemCPUs у KubeletConfiguration або застарілий параметр командного рядка kubelet --reserved-cpus визначає явний набір CPU для системних демонів ОС і демонів Kubernetes. Докладніше про цей параметр читайте на сторінці Явно зарезервований список CPU. Стандартно ця ізоляція реалізована лише для Podʼів guaranteed із цілочисельними запитами CPU, але не для Podʼів burstable та best-effort (і Podʼів guaranteed із дробовими запитами CPU). Допуск лише порівнює запити CPU з доступними для розподілу CPU. Оскільки обмеження CPU вище за запит, стандартна поведінка дозволяє Podʼам burstable та best-effort вичерпати місткість reservedSystemCPUs і спричинити голодування сервісів ОС хоста в реальних розгортаннях. Якщо ввімкнено параметр політики strict-cpu-reservation, політика static не дозволить жодному робочому навантаженню використовувати ядра CPU, вказані в reservedSystemCPUs.
prefer-align-cpus-by-uncorecache
Якщо вказано політику prefer-align-cpus-by-uncorecache, політика static виділятиме ресурси CPU для окремих контейнерів так, щоб усі CPU, призначені контейнеру, використовували той самий блок кешу uncore (також відомий як кеш останнього рівня, Last-Level Cache або LLC). Стандартно CPUManager щільно розподіляє CPU, що може призвести до того, що контейнери отримають CPU з кількох кешів uncore. Цей параметр дозволяє CPUManager виділяти CPU так, щоб максимізувати ефективне використання кешу uncore. Виділення виконується за принципом best-effort з метою розмістити якомога більше CPU в межах одного кешу uncore. Якщо вимога контейнера до CPU перевищує місткість CPU одного кешу uncore, CPUManager мінімізує кількість використаних кешів uncore, щоб підтримувати оптимальне вирівнювання. Окремі робочі навантаження можуть виграти в продуктивності завдяки зменшенню затримки між кешами та впливу шумних сусідів на рівні кешу. Якщо CPUManager не може оптимально вирівняти CPU, хоча вузол має достатньо ресурсів, контейнер однаково буде допущено зі стандартною щільною поведінкою.
Менеджер памʼяті
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.32; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.32. It was first available in the v1.21 release.
Менеджер памʼяті — це компонент kubelet, який забезпечує ексклюзивне виділення ресурсів памʼяті. Для прийняття рішень щодо призначення ресурсів він консультується з менеджером топології. Щоб дізнатися більше, прочитайте Керування політиками управління памʼяттю на вузлі.
Політики призначення памʼяті Podʼам
Менеджер памʼяті Kubernetes виділяє ресурси оперативної памʼяті (памʼять і, за потреби, великі сторінки Linux) для Podʼів із класом QoSGuaranteed.
Менеджер памʼяті використовує протокол генерації підказок, щоб визначити найбільш придатну спорідненість NUMA для Podʼа. Менеджер памʼяті передає ці підказки спорідненості центральному менеджеру (менеджеру топології). На основі підказок і політики менеджера топології Pod відхиляється або допускається на вузол.
Крім того, менеджер памʼяті забезпечує виділення запитаної Podʼом памʼяті з мінімальної кількості вузлів NUMA.
Менеджер пристроїв — це компонент kubelet, який виділяє апаратні пристрої Podʼам за допомогою API втулків пристроїв. Для прийняття рішень щодо призначення ресурсів він консультується з менеджером топології, використовуючи інформацію про топологію, надану втулками пристроїв. Щоб дізнатися більше, прочитайте Інтеграція втулків пристроїв з менеджером топології.
Менеджери ресурсів на рівні Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the PodLevelResourceManagers feature gate for all relevant components in your cluster.
Підтримка ресурсів на рівні Podʼів для менеджерів ресурсів kubelet (топології, CPU та памʼяті) дозволяє менеджерам ресурсів використовувати .spec.resources безпосередньо для рішень щодо вирівнювання за NUMA та ексклюзивного виділення.
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.30 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate DynamicResourceAllocation, Kubernetes ignores it but does not report any error.
Цей розділ знайомить з динамічним виділенням ресурсів (Dynamic Resource Allocation, DRA) у Kubernetes.
DRA — можливість Kubernetes, яка дозволяє запитувати ресурси та спільно використовувати їх між Podʼами. Часто такими ресурсами є приєднані пристрої, як-от апаратні прискорювачі.
З DRA драйвери пристроїв і адміністратори кластера визначають класи пристроїв, які робочі навантаження можуть запитувати (claim). Kubernetes виділяє відповідні пристрої конкретним запитам (claims) і розміщує відповідні Podʼи на вузлах, які мають доступ до виділених пристроїв.
Виділення ресурсів за допомогою DRA схоже на динамічне надання томів, в якому ви використовуєте PersistentVolumeClaims, щоб запитати ємність сховища від класів сховища і запитувати заявлену ємність для використання у ваших Podʼах.
Переваги DRA
DRA надає гнучкий спосіб категоризації, запиту та використання пристроїв у вашому кластері. Використання DRA має такі переваги:
Гнучке фільтрування пристроїв: використовуйте загальну мову виразів (CEL) для виконання детального фільтрування за конкретними атрибутами пристроїв.
Спільне використання пристроїв: діліться одним і тим же ресурсом між кількома контейнерами або Podʼами, посилаючись на відповідну заявку на ресурс.
Конфігурація пристроїв: прикріплюйте специфічні для постачальника конфігурації пристроїв до вашої заявки на ресурс, що дозволяє конфігурувати пристрої для кожного робочого навантаження окремо, а не для кожного вузла, як це відбувається сьогодні.
Централізована категоризація пристроїв: драйвери пристроїв і адміністратори кластерів можуть використовувати класи пристроїв, щоб надати операторам застосунків категорії апаратного забезпечення, які оптимізовані для різних випадків використання. Наприклад, ви можете створити клас пристроїв, оптимізований за вартістю для загальних робочих навантажень, і клас пристроїв високої продуктивності для критичних завдань.
Спрощені запити Podʼів: за допомогою DRA операторам застосунків не потрібно вказувати кількість пристроїв у запитах ресурсів Podʼа. Замість цього Pod посилається на заявку на ресурс, а конфігурація пристроїв у цій заявці застосовується до Podʼа.
Ці переваги забезпечують значні поліпшення в робочому процесі виділення пристроїв у порівнянні з втулками пристроїв, які вимагають запитів пристроїв для кожного контейнера, не підтримують спільне використання пристроїв і не підтримують фільтрацію пристроїв на основі виразів.
Типи користувачів DRA
Процес використання DRA для виділення пристроїв включає такі типи користувачів:
Власник пристрою: відповідає за пристрої. Власники пристроїв можуть бути комерційними постачальниками, оператором кластера або іншою сутністю. Щоб використовувати DRA, пристрої повинні мати драйвери, сумісні з DRA, які виконують такі дії:
Створюють ResourceSlices, які надають Kubernetes інформацію про вузли та ресурси.
Оновлюють ResourceSlices, коли змінюється ємність ресурсів у кластері.
Налаштовують пристрої відповідно до заявки та приєднують їх до контейнерів через Container Device Interface (CDI).
За бажанням створюють DeviceClasses, які оператори робочих навантажень можуть використовувати для заявки на пристрої.
Адміністратор кластера: відповідає за налаштування кластерів і вузлів, підключення пристроїв, установку драйверів та подібні завдання. Щоб використовувати DRA, адміністратори кластерів виконують такі дії:
Підключають пристрої до вузлів.
Встановлюють драйвери пристроїв, які підтримують DRA.
За бажанням створюють DeviceClasses, які оператори робочих навантажень можуть використовувати для заявки на пристрої.
Оператор робочих навантажень: відповідає за розгортання та управління робочими навантаженнями в кластері. Щоб використовувати DRA для виділення пристроїв для Podʼів, оператори робочих навантажень виконують такі дії:
Створюють ResourceClaims або ResourceClaimTemplates, щоб запитати конкретні конфігурації в межах DeviceClasses.
Розгортають робочі навантаження, які використовують конкретні ResourceClaims або ResourceClaimTemplates.
Обмеження
Планувальник Kubernetes не підтримує витіснення для ресурсів DRA. Це означає, що наявний Pod, який працює на вузлі і використовує ресурси DRA, не може бути витіснений Podʼом з вищим пріоритетом, який також потребує ресурси DRA. Pod з високим пріоритетом залишатиметься в стані очікування, поки пристрій не стане доступним, що відбувається, коли конфліктуючий Pod завершує роботу або видаляється вручну.
Ця сторінка описує, як Kubernetes виділяє пристрої робочим навантаженням за допомогою динамічного виділення ресурсів (DRA) і як попередньо заплановані Podʼи взаємодіють з цим процесом.
Як працює виділення ресурсів з DRA
Наступні розділи описують робочий процес для різних типів користувачів DRA та для системи Kubernetes під час динамічного виділення ресурсів.
Робочий процес для користувачів
Створення драйвера: власники пристроїв або сторонні організації створюють драйвери, які можуть створювати та керувати ResourceSlices у кластері. Ці драйвери за бажанням також створюють DeviceClasses, які визначають категорію пристроїв та як їх запитувати.
Конфігурація кластера: адміністратори кластера створюють кластери, підключають пристрої до вузлів і встановлюють драйвери пристроїв DRA. Адміністратори кластера за бажанням створюють DeviceClasses, які визначають категорії пристроїв та як їх запитувати.
Заявки на ресурси: оператори навантаження створюють ResourceClaimTemplates або ResourceClaims, які запитують конкретні конфігурації пристроїв у межах DeviceClass. На тому ж етапі оператори навантаження модифікують свої маніфести Kubernetes, щоб запитувати ці ResourceClaimTemplates або ResourceClaims.
Робочий процес для Kubernetes
Створення ResourceSlice: драйвери в кластері створюють ResourceSlices, які представляють один або кілька пристроїв у керованому пулі подібних пристроїв.
Створення навантаження: панель управління кластера перевіряє нові навантаження на наявність посилань на ResourceClaimTemplates або на конкретні ResourceClaims.
Якщо навантаження використовує ResourceClaimTemplate, контролер з імʼям resourceclaim-controller генерує ResourceClaims для навантаження.
Якщо навантаження використовує конкретний ResourceClaim, Kubernetes перевіряє, чи існує цей ResourceClaim у кластері. Якщо ResourceClaim не існує, Podʼи не будуть розгорнуті.
Фільтрація ResourceSlice: для кожного Podʼа Kubernetes перевіряє ResourceSlices у кластері, щоб знайти пристрій, який задовольняє всі наступні критерії:
Вузли, які можуть отримати доступ до ресурсів, мають право запускати Pod.
ResourceSlice має невиділені ресурси, які відповідають вимогам ResourceClaim Podʼа.
Виділення ресурсів: після знаходження відповідного ResourceSlice для ResourceClaim Podʼа, планувальник Kubernetes оновлює ResourceClaim з деталями виділення ресурсів. Планувальник використовує стратегію першого підходящого варіанту та оцінює пули та ResourceSlices у лексикографічному порядку за їхніми іменами. Драйвери можуть пріоритизувати конкретні розділи ресурсів або пули, відповідно називаючи їх. Для отримання додаткової інформації див. Іменування та пріоритизація.
Планування Podʼа: коли виділення ресурсів завершено, планувальник розміщує Pod на вузлі, який може отримати доступ до виділеного ресурсу. Драйвер пристрою та kubelet на цьому вузлі координуються через gRPC, щоб налаштувати пристрій і доступ Podʼа до пристрою, якщо драйвер не оголосив необовʼязкові операції з вузлами для пристроїв, які не потребують локальної підготовки або очищення на вузлі.
Попередньо заплановані Podʼи
Коли ви, або інший клієнт API, створюєте Pod із вже встановленим spec.nodeName, планувальник пропускається. Якщо будь-який ResourceClaim, потрібний для цього Podʼа, ще не існує, не виділений або не зарезервований для Podʼа, то kubelet не зможе запустити Pod і періодично перевірятиме це, оскільки ці вимоги можуть бути задоволені пізніше.
Така ситуація також може виникнути, коли підтримка динамічного виділення ресурсів не була увімкнена в планувальнику на момент планування Podʼа (різниця версій, конфігурація, функціональна можливість і т. д.). kube-controller-manager виявляє це і намагається зробити Pod придатним до запуску, шляхом резервування потрібних ResourceClaims. Однак, це працює лише якщо вони були виділені планувальником для якогось іншого Podʼа.
Краще уникати оминання планувальника, оскільки Pod, який призначений для вузла, блокує нормальні ресурси (памʼять, CPU), які потім не можуть бути використані для інших Podʼів, поки Pod застряг. Щоб запустити Pod на певному вузлі, при цьому проходячи через звичайний потік планування, створіть Pod із селектором вузла, який точно відповідає бажаному вузлу:
Можливо, ви також зможете змінити вхідний Pod під час допуску, щоб скасувати поле .spec.nodeName і використовувати селектор вузла замість цього.
Умови привʼязки пристрою
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Умови привʼязки пристрою дозволяють планувальнику Kubernetes затримувати привʼязку Podʼа до тих пір, поки зовнішні ресурси, такі як GPU, підключені через комутаційну фабрику, або перепрограмовувані FPGA, не будуть підтверджені як готові.
Ця поведінка очікування реалізована в фазі PreBind фреймворку планування. Під час цієї фази планувальник перевіряє, чи всі необхідні умови пристрою є виконаними, перш ніж продовжити з привʼязкою.
Це покращує надійність планування, уникаючи передчасної привʼязки, і дозволяє координацію з зовнішніми контролерами пристроїв.
Щоб використовувати цю функцію, драйвери пристроїв (зазвичай керовані власниками драйверів) повинні опублікувати наступні поля в розділі DeviceResourceSlice. Адміністратори кластерів повинні увімкнути функціональні можливості DRADeviceBindingConditions і DRAResourceClaimDeviceStatus, щоб планувальник міг враховувати ці поля.
bindingConditions
Список типів станів, які повинні бути встановлені в True (у полі .status.conditions асоційованого ResourceClaim), перш ніж Pod може бути привʼязаний. Ці стани зазвичай представляють сигнали готовності, такі як DeviceAttached або DeviceInitialized.
bindingFailureConditions
Список типів станів, які, якщо встановлені в True у полі status.conditions асоційованого ResourceClaim, вказують на стан збою. Якщо будь-який з цих станів є True, планувальник скасує привʼязку та повторно запланує Pod.
bindsToNode
якщо встановлено в true, планувальник записує вибране імʼя вузла в полі status.allocation.nodeSelector ResourceClaim. Це не впливає на spec.nodeSelector Podʼа. Натомість він встановлює селектор вузла всередині ResourceClaim, який зовнішні контролери можуть використовувати для виконання специфічних для вузла операцій, таких як підключення або підготовка пристроїв.
Усі типи станів, перераховані в bindingConditions і bindingFailureConditions, оцінюються з поля status.conditions ResourceClaim. Зовнішні контролери відповідають за оновлення цих станів, використовуючи стандартну семантику станів Kubernetes (type, status, reason, message, lastTransitionTime).
Планувальник чекає до 600 секунд (типово), щоб усі bindingConditions стали True. Якщо тайм-аут досягається або будь-які bindingFailureConditions є True, планувальник очищає виділення та повторно планує Pod. Адміністратор кластера може налаштувати тривалість цього тайм-ауту, редагуючи файл конфігурації kube-scheduler.
Приклад налаштування цього тайм-ауту в KubeSchedulerConfiguration наведено нижче:
ResourceSlice націлений на вузли з міткою accelerator-type=high-performance, щоб планувальник використовував лише певний набір допустимих вузлів.
Планувальник вибирає один вузол з обраної групи (наприклад, node-3) і встановлює поле status.allocation.nodeSelector в ResourceClaim на це імʼя вузла.
Умова привʼязки dra.example.com/is-prepared вказує на те, що пристрій gpu-1 повинен бути підготовлений (стан is-prepared має статус True) перед привʼязкою.
Якщо підготовка пристрою gpu-1 не вдалася (стан preparing-failed має статус True), планувальник скасовує привʼязку.
Планувальник чекає до 600 секунд (типово), щоб пристрій став готовим.
Зовнішні контролери можуть використовувати селектор вузла в ResourceClaim для виконання операцій, специфічних для вузла, на вибраному вузлі.
Умови привʼязки пристроїв контролюються функціональною можливістю DRADeviceBindingConditions у kube-apiserver та kube-scheduler.
Ресурси вузла, доступні для виділення
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRANodeAllocatableResources feature gate for all relevant components in your cluster.
Пристрої, якими керує DRA, можуть мати базове споживання, що складається з ресурсів вузла, доступних для виділення, таких як cpu, memory або hugepages. Ця функція інтегрує ці запити на основі DRA у стандартний облік планувальника поряд зі звичайними запитами в spec Podʼа на ці ресурси.
Драйвери DRA визначають, як пристрої споживають ресурси вузла, доступні для виділення, за допомогою двох різних моделей:
Пряме зіставлення ресурсів (mapping): пристрій DRA безпосередньо надає стандартний ресурс вузла (такий як власний пул ядер CPU або блок памʼяті). Виділення за заявкою безпосередньо відповідає стандартній ємності CPU або памʼяті на вузлі.
Допоміжні накладні витрати пристрою (overhead): пристрій DRA (такий як GPU або прискорювач) потребує ресурсів хоста (таких як оперативна памʼять хоста) як вторинних накладних витрат для роботи, коли його виділено для Podʼа або контейнера.
Рекомендації для авторів Podʼів
При створенні PodSpec з використанням заявок для цих типів пристроїв слід враховувати кілька моментів:
Коли використовуються ресурси на рівні Podʼа, планувальник суворо перевіряє їх як для запитів, так і для лімітів контейнерів:
Сума всіх запитів контейнерів і ресурсів заявок DRA не повинна перевищувати запити на рівні Podʼа; в іншому випадку Pod не зможе бути запланований.
Ліміт кожного окремого контейнера плюс його виділення DRA не повинні перевищувати ліміти на рівні Podʼа; в іншому випадку Pod не зможе бути запланований.
Загальна потреба контейнера в ресурсах є сумою його ресурсів на рівні контейнера та будь-яких ресурсів вузла, доступних для виділення, з повʼязаних з ним заявок на ресурси.
Обмеження спільного використання заявок: заявки, що використовують пряме зіставлення ресурсів (mapping), не можуть бути спільними між кількома Podʼами. Заявки для пристроїв з overhead можуть підтримувати спільне використання пристроїв, і накладні витрати відстежуються для кожного Podʼа або контейнера окремо.
Podʼи із заявками DRA підтримують зміну розміру на місці для стандартних запитів у spec. Планувальник забезпечує, щоб змінені стандартні запити разом зі статичними виділеннями DRA все ще вміщувалися на вузлі.
Деталі для авторів драйверів DRA
Драйвери DRA оголошують це базове споживання ресурсів вузла, доступних для виділення, за допомогою поля nodeAllocatableResources для пристроїв у ResourceSlice. Це визначає перетворення запитуваного пристрою DRA або ємності у стандартні ресурси, які відстежуються у полі status.allocatable вузла (зверніть увагу, що розширені ресурси для цього поля не підтримуються). Це корисно як для драйверів, які безпосередньо надають нативні ресурси (наприклад, драйвер DRA для CPU або памʼяті), так і для пристроїв, які потребують допоміжних залежностей від вузла (наприклад, прискорювач, якому потрібна памʼять хоста).
Поле nodeAllocatableResources підтримує два різні випадки використання:
Зіставлення: використовується, коли пристрій DRA безпосередньо представляє стандартний ресурс (наприклад, драйвер DRA для CPU або памʼяті). Планувальник обчислює точну кількість, масштабуючи ємність за допомогою capacityMultiplier або масштабуючи кількість пристроїв за допомогою deviceMultiplier.
Накладні витрати: використовується, коли пристрій потребує допоміжних залежностей від вузла (наприклад, памʼять хоста, яку споживає GPU). Це може бути визначено як фіксована вартість perPod або змінна вартість perContainer, яка масштабується лінійно з кількістю контейнерів, що посилаються на пристрій.
Приклад: драйвер CPU DRA (Зіставлення)
Ось приклад, де драйвер CPU DRA відкриває сокет CPU як пул з 128 CPU, використовуючи споживчу ємність DRA. capacityKey повʼязує споживану ємність cpu.example.com/cpu безпосередньо зі стандартним ресурсом вузла cpu, доступним для виділення:
Після того як Pod було успішно привʼязано до вузла, точні кількості ресурсів вузла, доступних для виділення, виділених через DRA, агрегуються kube-scheduler і вбудовуються безпосередньо у поле status.nodeAllocatableResourceClaimStatuses Podʼа. Це забезпечує чітку, постійну передачу від планувальника до kubelet.
Ключовим моментом є те, що kubelet нативно споживає цей API для ідеального узгодження системних меж:
cgroups: cgroups Podʼа та контейнерів тепер включатимуть виділення на основі DRA, запобігаючи штучному обмеженню робочих навантажень ядром.
Оцінки OOM: kubelet враховує запити памʼяті DRA контейнера у його ефективному запиті памʼяті.
Ресурси вузла, доступні для виділення, є альфа-функцією і вмикаються, коли функціональну можливість DRANodeAllocatableResources увімкнено в kube-apiserver, kube-scheduler та kubelet.
6.11.2.2 - Спостережуваність динамічних ресурсів
Ця сторінка описує, як спостерігати за статусом і справністю ресурсів, які динамічно виділяються за допомогою DRA.
Спостережуваність динамічних ресурсів
Ви можете перевірити статус динамічно виділених ресурсів, використовуючи будь-який із наступних методів:
Служба gRPC PodResourcesLister kubelet дозволяє вам контролювати пристрої, що використовуються. Повідомлення DynamicResource надає інформацію, специфічну для динамічного виділення ресурсів, таку як назва пристрою та назва заявки. Детальніше див. Моніторинг ресурсів втулків пристроїв.
Статус пристрою ResourceClaim
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.37. It was first available in the v1.32 release.
Точність інформації, яку драйвер додає до поля status.devices ResourceClaim, залежить від драйвера. Оцінюйте драйвери, щоб вирішити, чи можете ви покладатися на це поле як на єдине джерело інформації про пристрої.
Якщо ви вимкнете функціональну можливість DRAResourceClaimDeviceStatus, поле status.devices автоматично очищається під час зберігання ResourceClaim. Статус пристрою ResourceClaim підтримується, коли з боку драйвера DRA можливо оновити наявний ResourceClaim, у якому встановлено поле status.devices.
У наведеному нижче прикладі поле status.devices ResourceClaim було заповнено драйвером (resource-driver.example.com), відповідальним за керування виділеним пристроєм:
apiVersion:resource.k8s.io/v1kind:ResourceClaimmetadata:name:macvlan-eth0spec:...status:allocation:devices:results:- device:eth0driver:resource-driver.example.compool:nic-worker-arequest:macvlan-eth0shareID:8e7acdf9-0290-4ecd-a801-a654b021d2b7consumedCapacity:resource-driver.example.com/bandwidth:1Gdevices:- conditions:- lastTransitionTime:"2025-10-21T08:38:17Z"message:Device successfully allocated and assigned to the podreason:NetworkReadystatus:"True"type:NetworkReadydevice:eth0driver:resource-driver.example.comnetworkData:hardwareAddress:00:01:ec:84:fb:51interfaceName:net1ips:- 10.10.1.2/24- 2001:db8::1/64pool:nic-worker-ashareID:8e7acdf9-0290-4ecd-a801-a654b021d2b7
Якщо пристрій не було виділено, запит драйвера на оновлення поля status.devices ResourceClaim із цим пристроєм відхиляється. Коли пристрій вивільняється (видаляється з status.allocation.devices), відповідний запис у status.devices автоматично видаляється.
Детальніше про поле status.devices див. у довіднику API
ResourceClaim.
Моніторинг справності пристроїв
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Kubernetes надає механізм для моніторингу та звітування про справність динамічно виділених ресурсів інфраструктури. Для застосунків зі збереженням стану, що працюють на спеціалізованому обладнанні, критично важливо знати, коли пристрій вийшов з ладу або став несправним. Також корисно дізнаватися, чи відновлюється пристрій.
Щоб використовувати цю функціональність, функціональна можливість ResourceHealthStatus має бути увімкнена (бета та типово увімкнена з v1.36), а драйвер DRA має реалізовувати службу gRPC DRAResourceHealth.
Коли драйвер DRA виявляє, що виділений пристрій став несправним, він повідомляє цей статус назад до kubelet. Ця інформація про справність потім безпосередньо відображається в статусі Podʼа. kubelet заповнює поле allocatedResourcesStatus у статусі кожного контейнера, деталізуючи справність кожного пристрою, призначеного цьому контейнеру. Кожен запис про справність ресурсу може містити необовʼязкове поле message з додатковим контекстом, зрозумілим людині, про стан справності, наприклад, деталі помилки або причини збою.
Якщо kubelet не отримує оновлення про справність від драйвера DRA протягом періоду очікування, статус справності пристрою позначається як "Unknown". Драйвери DRA можуть налаштовувати цей період очікування для кожного пристрою окремо, встановлюючи поле health_check_timeout_seconds у повідомленні gRPC DeviceHealth. Якщо не вказано, kubelet використовує типовий період очікування 30 секунд. Це дозволяє різним типам обладнання (наприклад, GPU, FPGA або пристроям зберігання) використовувати відповідні значення періоду очікування на основі їхніх характеристик звітування про справність.
Це забезпечує критично важливу видимість для користувачів і контролерів, щоб реагувати на збої обладнання. Для Podʼа, який зазнає збою, ви можете перевірити цей статус, щоб визначити, чи був збій повʼязаний із несправним пристроєм.
Примітка:
Статус справності пристрою не оновлюється в статусі Podʼа після завершення роботи Podʼа (наприклад, у стані Failed).
Статус пулу ресурсів
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.36; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRAResourcePoolStatus feature gate for all relevant components in your cluster.
Ви можете запитувати доступність пристроїв у пулах ресурсів за допомогою API ResourcePoolStatusRequest. Це забезпечує видимість того, скільки пристроїв доступно, виділено або недоступно в пулах ресурсів DRA вашого кластера.
Щоб перевірити статус пулу ресурсів:
Створіть ResourcePoolStatusRequest, вказавши назву драйвера (обовʼязково) та, за бажанням, обмеження на кількість повернутих пулів. Ви також можете обмежити його одним пулом, вказавши назву пулу:
apiVersion:resource.k8s.io/v1alpha3kind:ResourcePoolStatusRequestmetadata:name:check-gpusspec:driver:example.com/gpu# Optional: filter to a specific pool# poolName: my-pool# Optional: limit number of pools returned (default: 100, max: 1000)# limit: 10
kubectl get resourcepoolstatusrequest/check-gpus -o yaml
Статус включає:
poolCount: загальна кількість пулів, що відповідають фільтру (може перевищувати кількість перелічених пулів, якщо результат обрізано обмеженням).
pools: список деталей пулів, кожен з яких містить:
driver та poolName: ідентифікують пул.
generation: останнє покоління пулу, яке спостерігалось в ResourceSlices.
resourceSliceCount: кількість ResourceSlices, що складають пул.
totalDevices: загальна кількість пристроїв у пулі.
allocatedDevices: пристрої, наразі виділені заявкам.
availableDevices: пристрої, доступні для виділення
(totalDevices - allocatedDevices - unavailableDevices).
unavailableDevices: пристрої, недоступні через позначки taint або інші стани.
nodeName: вузол, повʼязаний із пулом, якщо такий є.
validationError: встановлюється, коли дані пулу не вдалося повністю перевірити (наприклад, під час розгортання покоління). Коли встановлено, поля кількості пристроїв можуть бути невстановленими.
Обʼєкти ResourcePoolStatusRequest обробляються один раз контролером у kube-controller-manager. Специфікація є незмінною після створення, а весь обʼєкт стає незмінним після заповнення статусу. Щоб отримати оновлені дані про доступність, видаліть і перестворіть запит. Завершені запити автоматично очищаються через 1 годину.
Ця функція вимагає явних дозволів RBAC на ресурс ResourcePoolStatusRequest. Жодна типова ClusterRole не включає цей дозвіл.
Статус пулу ресурсів контролюється функціональною можливістю DRAResourcePoolStatus у kube-apiserver та kube-controller-manager.
Підсумок розділів
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRAPartitionableDevicesType feature gate for all relevant components in your cluster.
Один фізичний пристрій, такий як GPU, може бути опублікований як кілька типів розділів (наприклад, повний GPU проти половинного розділу MIG), які використовують ті самі спільні лічильники. Оскільки ці розділи конкурують за ту саму базову ємність, проста кількість пристроїв не показує, скільки пристроїв кожного типу ще можна виділити. Для пулів з пристроями, що розділяються на розділи представлення partitionSummary відповідає на це питання. Для кожного типу розділу воно повідомляє:
attribute: повне імʼя атрибута пристрою, значення якого групує цей запис. Це spec.partitionTypeAttribute обʼєкта ResourceSlice або spec.defaultPartitionTypeAttribute запиту, коли ResourceSlice не оголошує жодного.
type: значення цього атрибута на пристрої (наприклад, Full або Half).
total: кількість пристроїв цього типу розділу в пулі.
allocatable: скільки додаткових пристроїв цього типу розділу ще можна було б виділити з урахуванням поточного споживання спільних лічильників.
Названий атрибут має бути рядковим атрибутом. Якщо атрибут типу розділу пристрою, що розділяється на розділи, відсутній або не є рядком (наприклад, ціле число, булеве значення або версія), пул повідомляє про помилку перевірки замість підсумку розділів. Немає спеціальної обробки для атрибутів типу список; нерядковий атрибут просто не є дійсним атрибутом типу розділу.
Щоб створити це представлення, драйвер позначає кожен пристрій, що розділяється на розділи, рядковим атрибутом, значення якого називає тип розділу, і вказує цей атрибут у полі partitionTypeAttribute обʼєкта ResourceSlice:
apiVersion:resource.k8s.io/v1kind:ResourceSlice# ...spec:# Кожен пристрій, що розділяється на розділи, у цьому ResourceSlice має цей атрибут; пристрої,# які мають однакове значення, несуть однакові витрати на спільний лічильник.partitionTypeAttribute:gpu.example.com/profile
Якщо драйвер ще не оновлено для оголошення partitionTypeAttribute, запит все одно може отримати підсумок розділів, вказавши резервний атрибут у своїй специфікації. Власний partitionTypeAttribute ResourceSlice завжди має перевагу; типове значення на рівні запиту застосовується лише до пристроїв, чий ResourceSlice не оголошує його:
apiVersion:resource.k8s.io/v1alpha3kind:ResourcePoolStatusRequestmetadata:name:check-gpu-partitionsspec:driver:gpu.example.com# Запасний атрибут групування для ResourceSlice, які не оголошують власного.defaultPartitionTypeAttribute:gpu.example.com/profile
Коли ні ResourceSlice, ні запит не вказують атрибут, пул з пристроями, що розділяються на розділи, не повідомляє partitionSummary.
Для пулів, що містять пристрої, які можуть спільно використовуватися (пристрої, які встановлюють allowMultipleAllocations і можуть споживатися кількома заявками), shareableSummary повідомляє сукупне використання ємності в межах пулу:
fullyAvailableDevices: пристрої, що можуть спільно використовуватися, у яких не спожито жодної ємності.
partiallyAvailableDevices: пристрої, що можуть спільно використовуватися, у яких спожито частину, але не всю ємність.
capacity: для кожної назви ємності сукупні обсяги total, consumed та available (total мінус consumed, ніколи не відʼємне) у межах пулу.
shareableSummary заповнюється лише тоді, коли принаймні один пристрій у пулі може спільно використовуватися. Він є частиною функції статусу пулу ресурсів (функціональна можливість DRAResourcePoolStatus) і не вимагає DRAPartitionableDevicesType; пристрої, що можуть спільно використовуватися, які він підсумовує, походять із функції споживчої ємності.
Метадані пристроїв DRA в контейнерах
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37
Драйвери DRA можуть надавати метадані пристроїв, такі як атрибути пристроїв (адреси шини PCI або UUID опосередкованих (mediated) пристроїв) та мережеву конфігурацію, безпосередньо контейнерам у вигляді JSON-файлів. Це дозволяє застосункам дізнаватися інформацію про виділені пристрої без запитів до API Kubernetes або використання власних контролерів.
Метадані пристроїв підпорядковуються тим самим правилам, що й доступ до пристроїв: вони доступні всередині контейнера лише тоді, коли цей контейнер запитує пристрій. Детальніше див. Запит пристроїв у робочих навантаженнях за допомогою DRA.
Протокол метаданих пристроїв
Протокол складається з чотирьох правил:
Шляхи до файлів. Файли метаданих розташовані всередині контейнерів у /var/run/kubernetes.io/dra-device-attributes. Для безпосередньо вказаного ResourceClaim шлях має вигляд resourceclaims/<claimName>/<requestName>/<driverName>-metadata.json. Для заявки, створеної з ResourceClaimTemplate, шлях має вигляд resourceclaimtemplates/<podClaimName>/<requestName>/<driverName>-metadata.json, де podClaimName — це pod.spec.resourceClaims[].name.
Коли запит використовує список пріоритетів, для сегмента шляху <requestName> використовується лише назва запиту верхнього рівня. Поле requests[].name у файлі містить повне посилання <request>/<subrequest>, наприклад gpu/high-memory.
JSON API. Кожен файл є потоком одного або кількох обʼєктів DeviceMetadata. Кожен обʼєкт має apiVersion та kind, відповідно до домовленостей API Kubernetes. Ті самі метадані кодуються один раз для кожної налаштованої версії API в порядку, вибраному драйвером. Споживачі використовують першу версію, яку вони можуть декодувати, і пропускають невідомі версії. Пошкоджений обʼєкт у відомій версії є помилкою.
Покоління. Початковий файл має metadata.generation, встановлене на 1. Кожне оновлення збільшує покоління, щоб споживачі могли виявляти зміни.
Надання контейнеру. Бібліотека втулка kubelet DRA використовує CDI для bind-mount кожного файлу лише для читання. Інші реалізації можуть використовувати інший механізм, якщо файл зʼявляється за необхідним шляхом і є доступним лише для читання.
Увімкнення метаданих пристроїв у драйвері
Метадані пристроїв — це функція на стороні драйвера. Вона не має функціональної можливості Kubernetes і типово вимкнена у бібліотеці втулка kubelet DRA. Драйвер має увімкнути функцію та явно вибрати версії, які він записує:
Версія v1beta1 є обовʼязковою. Драйвер також може записувати v1alpha1 для сумісності зі старішими споживачами. Порядок у зрізі є порядком у потоці метаданих; фреймворк не сортує версії. Драйвери мають ставити найновішу версію першою. Увімкнення метаданих пристроїв без версій, без v1beta1 або з невідомою версією призводить до збою втулка під час запуску.
Для кожного підготовленого пристрою драйвер може заповнити Device.Metadata за допомогою kubeletplugin.DeviceMetadata. Драйвери мають включати атрибути, які вони публікують для цього пристрою в його ResourceSlice, щоб робочі навантаження бачили ту саму інформацію під час виконання. Драйвери можуть також включати атрибути, які мають значення лише під час виконання. Для мережевих пристроїв, драйвери можуть додавати назви інтерфейсів, IP-адреси та апаратні адреси після конфігурації CNI, викликаючи UpdateRequestMetadata.
Посилання на API втулка kubelet вище описують інтеграцію для авторів драйверів. Фреймворк DRA не визначає універсального прапора командного рядка, тому оператори кластерів вмикають функцію через конфігурацію розгортання, надану їхнім драйвером.
Коли увімкнено, бібліотека втулка kubelet DRA записує файли метаданих під час підготовки виділених пристроїв. Вона також записує специфікації CDI типово до /var/run/cdi. Середовище виконання контейнерів має бути налаштоване на виявлення специфікацій CDI з цього каталогу. Бібліотека визначає мінімальну версію специфікації CDI, необхідну для кожної згенерованої специфікації.
Коли один запит виділяє пристрої від кількох драйверів DRA, кожен драйвер записує власний файл метаданих. Споживачі, які знають назву драйвера, мають побудувати точний шлях із назв заявки, запиту та драйвера. Споживачі Go можуть використовувати ReadResourceClaimMetadata або ReadResourceClaimTemplateMetadata, щоб прочитати та обʼєднати всі файли кожного драйвера для запиту.
Схема метаданих
Кожен обʼєкт у файлі метаданих відповідає API DeviceMetadata (metadata.resource.k8s.io/v1beta1).
Схема містить:
Стандартні метадані обʼєкта для ResourceClaim, включаючи її назву, простір імен, UID та покоління метаданих.
Необовʼязкове podClaimName для заявки, згенерованої з ResourceClaimTemplate.
Список запитів. Кожен запит має обовʼязкову назву та список виділених пристроїв.
Драйвер, пул та назву для кожного пристрою.
Необовʼязкові атрибути пристроїв та мережеві дані.
Значення атрибутів використовують те саме представлення, що й атрибути пристроїв ResourceSlice. Кожен атрибут має рівно одне скалярне значення (int, bool, string або version) або значення списку (ints, bools, strings або versions). Значення ємності пристроїв не включаються в метадані пристроїв.
Мережеві дані можуть містити interfaceName, ips та hardwareAddress. Про обмеження полів див. документацію API DeviceMetadata.
Наведений нижче приклад показує один обʼєкт у потоці метаданих для пристрою GPU, виділеного через ResourceClaimTemplate:
Втулок kubelet DRA не перевіряє метадані перед їх записом. Споживачі Go можуть увімкнути згенеровану перевірку під час декодування потоку. Декодування та перевірка мають окремі результати: помилка перевірки не перешкоджає поверненню успішно декодованого обʼєкта. Про використання див. Доступ до метаданих пристроїв DRA.
Негайні та відкладені метадані
Для негайних метаданих драйвер надає атрибути або мережеві дані під час підготовки заявки. Втулок kubelet DRA записує файл із поколінням 1 до запуску контейнера, що їх споживає.
Для відкладених метаданих драйвер може підготувати пристрій без атрибутів або мережевих даних. Початковий файл із поколінням 1 містить ідентичність пристрою. Пізніше драйвер викликає UpdateRequestMetadata, щоб атомарно замінити повний потік і збільшити покоління. Оновлення вимагає існування початкового файлу. Якщо підготовка пристрою не повертає жодних пристроїв для запиту, фреймворк не створює ні файлу метаданих, ні пристрою CDI метаданих для цього запиту.
Метадані залишаються доступними для кожного контейнера, що їх споживає, протягом усього життєвого циклу цього контейнера. Фреймворк видаляє файли метаданих та специфікації CDI після скасування підготовки заявки.
Власні драйвери, які не використовують бібліотеку втулка kubelet DRA, мають самостійно реалізувати протокол метаданих пристроїв. Це включає запис версіонованого потоку DeviceMetadata за правильними шляхами, збільшення metadata.generation при кожному оновленні та надання файлів лише для читання через CDI або еквівалентний механізм.
6.11.2.3 - Функції DRA
Ця сторінка описує необовʼязкові функції DRA для розширених випадків використання. Деякі з цих функцій вимагають підтримки з боку драйвера DRA. Для кожної функції зазначено її зрілість та функціональну можливість, яка її вмикає.
Пристрої, що розділяються на розділи
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Пристрої, представлені в DRA, не обовʼязково мають бути єдиним блоком, підключеним до однієї машини, але також можуть бути логічним пристроєм, що складається з кількох пристроїв, підключених до кількох машин. Ці пристрої можуть використовувати ресурси базових фізичних пристроїв, що перекриваються, тобто коли один логічний пристрій виділяється, інші пристрої стають недоступними.
В API ResourceSlice це представлено як список іменованих CounterSets, кожен з яких містить набір іменованих лічильників. Лічильники представляють ресурси, доступні на фізичному пристрої, які використовуються логічними пристроями, опублікованими через DRA.
Логічні пристрої можуть вказувати список ConsumesCounters. Кожен запис містить посилання на CounterSet та набір іменованих лічильників із кількостями, які вони споживатимуть. Отже, щоб пристрій можна було виділити, згадані набори лічильників повинні мати достатню кількість для лічильників, на які посилається пристрій.
CounterSets мають бути вказані в окремих ResourceSlices від пристроїв. Пристрої можуть споживати лічильники з будь-якого CounterSet, визначеного в тому самому пулі ресурсів, що й пристрій.
Ось приклад двох пристроїв, кожен з яких споживає 6Gi памʼяті зі спільного лічильника з 8Gi памʼяті. Таким чином, лише один із пристроїв може бути виділений у будь-який момент часу. Планувальник обробляє це, і це прозоро для споживача, оскільки API ResourceClaim не змінюється.
Пристрої, що розділяються на розділи, контролюються функціональною можливістю DRAPartitionableDevices у kube-apiserver та kube-scheduler.
Групи сумісності пристроїв
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRADeviceCompatibilityGroups feature gate for all relevant components in your cluster.
Групи сумісності пристроїв дозволяють драйверу DRA оголошувати, які розділені пристрої можуть бути спільно виділені на тому самому фізичному обладнанні. Без цієї функції несумісні комбінації пристроїв виявляються лише тоді, коли kubelet готує Pod на вузлі — що призводить до невдалої підготовки. З групами сумісності планувальник відхиляє несумісні комбінації на етапі планування, до початку будь-якої роботи на стороні вузла.
Це найбільш корисно для обладнання, яке підтримує взаємовиключні режими роботи. Наприклад, GPU, який може працювати в режимі MIG або в режимі vGPU: пристрій у режимі MIG та пристрій у режимі vGPU не можуть бути спільно виділені, оскільки вони несумісним чином споживають фізичні ресурси, що перекриваються. Оголошуючи compatibilityGroups, драйвер робить це обмеження видимим для планувальника.
Ця функція ґрунтується на пристроях, що розділяються на розділи: поле compatibilityGroups знаходиться в записах device.consumesCounters[], які існують лише для пристроїв, що розділяються на розділи. Обидві функціональні можливості DRADeviceCompatibilityGroups та DRAPartitionableDevices мають бути увімкнені в kube-apiserver та kube-scheduler.
Як це працює
Драйвер визначає список compatibilityGroups для кожного запису device.consumesCounters[] у ResourceSlice. Список містить щонайбільше 2 непрозорі рядкові назви, які представляють режим роботи або тип розділу цього пристрою на цьому конкретному наборі лічильників.
Коли планувальник виділяє кілька пристроїв, які використовують той самий набір лічильників, він обчислює перетин їхніх compatibilityGroups. Виділення успішне лише тоді, коли цей перетин не порожній — тобто кожен спільно виділений пристрій має принаймні одну спільну назву групи. Пристрої, які використовують різні набори лічильників, ніколи не порівнюються між собою.
Пристрій, який не оголошує жодних груп (невстановлений, nil або порожній список), розглядається як особливий випадок: він може бути спільно виділений лише з іншими пристроями без груп на тому самому наборі лічильників. Він ніколи не може бути спільно виділений з пристроєм, який оголошує одну або більше груп.
Обмеження застосовується до всіх заявок, що виділяються в одному циклі планування: якщо кожна з двох заявок виділяє пристрій з того самого набору лічильників, перетин груп між заявками також перевіряється.
Приклад
Розглянемо GPU, який може працювати в режимі MIG або в режимі vGPU. Драйвер публікує два пристрої, кожен з яких споживає 4 GiB з того самого спільного лічильника памʼяті обсягом 8 GiB. Лише на основі ємності лічильника обидва пристрої могли б бути виділені разом. Кожен пристрій оголошує свій режим роботи як групу сумісності, роблячи два режими взаємовиключними:
Якщо Pod або PodGroup запитує два пристрої з цього пулу, планувальник перевіряє, чи мають два вибрані пристрої спільну групу сумісності на наборі лічильників gpu-0-memory. Оскільки {"mig"} ∩ {"vgpu"} = ∅, пара відхиляється — навіть якщо набір лічильників має достатньо памʼяті для обох. Обидва запити можуть бути задоволені лише двома пристроями MIG (або двома пристроями vGPU) з пулу, де такі пари існують.
Обмеження
Кожен запис consumesCounters[] може оголошувати щонайбільше 2 назви груп.
Назви груп мають бути унікальними в межах одного запису.
Назви груп є непрозорими для Kubernetes; вони мають значення лише в межах пулу драйвера, що їх публікує.
Групи порівнюються для кожного набору лічильників окремо: групи на одному наборі лічильників не впливають на рішення про спільне виділення для іншого набору лічильників.
Безпека при різниці версій
Коли функціональну можливість DRADeviceCompatibilityGroups вимкнено (типово для альфа-версії), kube-apiserver видаляє поле compatibilityGroups з будь-якого нового або оновленого ResourceSlice — хіба що в старому обʼєкті це поле вже було встановлено. Тоді планувальник розглядає пристрої в будь-якому пулі, який раніше мав згруповані пристрої, як такі, що належать до неповного пулу, і повністю пропускає їх.
Лише непорожній список вважається встановленим полем: compatibilityGroups: null та compatibilityGroups: [] обробляються так само, як і пропуск поля. Пристрої з ними поводяться точно так само, як пристрої без груп — вони не змушують планувальник вважати пул неповним.
Групи сумісності пристроїв контролюються функціональною можливістю DRADeviceCompatibilityGroups у kube-apiserver та kube-scheduler. Функціональна можливість DRAPartitionableDevices також має бути увімкнена.
Споживча ємність
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Функція споживчої ємності дозволяє одним і тим самим пристроям споживатися кількома незалежними ResourceClaim, при цьому планувальник Kubernetes керує тим, скільки ємності пристрою використовує кожна заявка. Це аналогічно тому, як Podʼи можуть спільно використовувати ресурси на вузлі; ResourceClaim можуть спільно використовувати ресурси на пристрої.
Драйвер пристрою може встановити поле allowMultipleAllocations, додане в .spec.devices обʼєкта ResourceSlice, щоб дозволити виділення цього пристрою кільком незалежним ResourceClaim або кільком запитам у межах одного ResourceClaim.
Коли ви запитуєте рівно один вид пристрою в ResourceClaim, встановіть spec.devices.requests[].exactly.capacity, щоб вказати вимоги до ресурсів пристрою для кожного виділення. Для пріоритетного списку різних альтернатив встановіть capacity у
відповідних записах spec.devices.requests[].firstAvailable[].
Для пристрою, який дозволяє кілька виділень, запитана ємність береться з, або споживається з, його загальної ємності, концепція, відома як споживча ємність. Тоді планувальник гарантує, що сукупна спожита ємність у всіх заявках не перевищує загальну ємність пристрою. Крім того, автори драйверів можуть використовувати обмеження requestPolicy для окремих ємностей пристроїв, щоб контролювати, як ці ємності споживаються. Наприклад, автор драйвера може вказати, що певна ємність споживається лише приростами по 1Gi.
Ось приклад мережевого пристрою, який дозволяє кілька виділень і містить споживчу ємність пропускної здатності.
У цьому прикладі було вибрано пристрій, який допускає кілька виділень. Однак будь-який пристрій resource.example.com із принаймні запитаною пропускною здатністю 1G міг би задовольнити вимогу. Якби було вибрано пристрій, який не допускає кілька виділень, виділення призвело б до використання всього пристрою. Щоб примусово використовувати лише пристрої, які допускають кілька виділень, ви можете використати критерій CEL device.allowMultipleAllocations == true.
Обмеження DistinctAttribute
Коли ви запитуєте кілька пристроїв у ResourceClaim, ви можете використати обмеження DistinctAttribute, щоб гарантувати, що кожен виділений пристрій має різне значення для вказаного атрибута. Це обмеження було введено разом із функцією споживчої ємності.
Обмеження DistinctAttribute особливо корисне під час роботи з пристроями, які допускають кілька виділень. Воно запобігає виділенню одного й того самого пристрою кілька разів у межах одного ResourceClaim, навіть якщо цей пристрій дозволяє кілька виділень.
Окрім запобігання дублюванню виділень, це обмеження допомагає оптимізувати продуктивність, гарантуючи розподіл пристроїв на основі їхніх атрибутів. Наприклад, ви можете використати його для розподілу пристроїв між різними NUMA-вузлами, щоб оптимізувати пропускну здатність памʼяті та зменшити конкуренцію.
Деталізована авторизація статусу
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Починаючи з Kubernetes v1.36, DRA застосовує детальні перевірки авторизації для оновлень статусу ResourceClaim, використовуючи синтетичні субресурси та дієслова, що враховують вузли.
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the DRAOptionalNodeOperations feature gate for all relevant components in your cluster.
У динамічному виділенні ресурсів (DRA) kubelet координується з локальним для вузла драйвером через gRPC, щоб підготувати виділені пристрої перед запуском контейнера (NodePrepareResources) та скасувати їх підготовку після завершення роботи Podʼа (NodeUnprepareResources). Хоча така схема є критичною для локального для вузла обладнання, такого як GPU або FPGA, деякі ресурси керуються повністю в панелі управління і не потребують жодного локального налаштування на вузлі.
Функція необовʼязкових операцій з вузлами дозволяє драйверам ресурсів оголошувати, що певні локальні для вузла операції gRPC можуть бути пропущені. Після налаштування kubelet оминає пошук драйвера та виклики gRPC для цих пристроїв, усуваючи потребу розгортати та підтримувати порожні локальні для вузла драйвери на кожному робочому вузлі.
Конфігурація драйвера
Автори драйверів можуть вказати поле skipNodeOperations у
.spec.skipNodeOperations обʼєкта ResourceSlice. Це поле є списком унікальних рядків, які вказують локальні для вузла операції, що мають бути пропущені для всіх пристроїв у цьому ResourceSlice.
Допустимі значення:
"NodePrepareResources": пропускає виклики gRPC NodePrepareResources. Це значення можна вказати, лише якщо також вказано "NodeUnprepareResources" (або вказано "*"). Це обмеження запобігає застряганню Podʼів у стані Terminating, якщо локальний для вузла втулок відсутній, оскільки втулок не перевіряється під час запуску Podʼа, коли підготовку пропущено.
Коли Pod працює на вузлі, kubelet читає результати виділення. Якщо всі виділені пристрої для певного драйвера в межах ResourceClaim пропускають конкретну операцію, kubelet повністю оминає виклик цього хука gRPC для цього драйвера.
Експлуатаційні міркування
Оновлення драйвера на місці
Оскільки налаштування skipNodeOperations копіюється з ResourceSlice у ResourceClaim під час виділення, запущені Podʼи та активні виділення зберігають те налаштування, яке діяло на момент їх планування.
Якщо вимоги драйвера до операцій з вузлами оновлюються на місці (наприклад, змінюються з вимоги виконання операцій на їх пропуск), наявні заявки все ще використовуватимуть попередню конфігурацію. Щоб уникнути проблем, наприклад, зависання завершуваних Podʼів в очікуванні виведеного з експлуатації втулка вузла, адміністратори кластерів мають переконатися, що для драйвера не існує активних заявок, перш ніж змінювати його вимоги до операцій з вузлами або видаляти локальні для вузла DaemonSets драйвера.
Інтеграція з оголошеними функціями вузла
Щоб запобігти плануванню Podʼів на вузлах, де kubelet не підтримує пропуск операцій DRA (що призвело б до збою kubelet в очікуванні відсутнього втулка вузла), ця функція інтегрується з Оголошеними функціями вузла. Коли Pod використовує ResourceClaim із налаштованим skipNodeOperations, планувальник Kubernetes перевіряє, що цільовий вузол оголошує підтримку функції DRAOptionalNodeOperations у своєму .status.declaredFeatures, перш ніж планувати Pod.
Необовʼязкові операції з вузлами контролюються функціональною можливістю DRAOptionalNodeOperations у kube-apiserver, kube-scheduler та kubelet.
6.11.2.4 - Позначки taint та toleration пристроїв
Ця сторінка описує позначки taint та toleration пристроїв в DRA, які дозволяють драйверам та адміністраторам не допускати Podʼи до певних пристроїв або виселяти Podʼи, які вже їх використовують.
Позначки taint та toleration пристроїв
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate DRADeviceTaints, Kubernetes ignores it but does not report any error.
Позначки taint пристроїв схожі на позначки taint вузлів: taint має рядковий ключ, рядкове значення та ефект. Ефект застосовується до ResourceClaim, який використовує позначений пристрій, і до всіх Podʼів, які посилаються на цей ResourceClaim. Ефект "NoSchedule" запобігає плануванню цих Podʼів. Позначені пристрої ігноруються під час спроби виділити ResourceClaim, оскільки їх використання перешкоджало б плануванню Podʼів.
Ефект "NoExecute" передбачає "NoSchedule" і, крім того, спричиняє виселення всіх Podʼів, які вже були заплановані. Це виселення реалізовано в контролері виселення за позначками taint пристроїв у kube-controller-manager шляхом видалення відповідних Podʼів.
Ефект "None" ігнорується планувальником і контролером виселення. Драйвери DRA можуть використовувати його для передачі виняткових ситуацій адміністраторам або іншим контролерам, наприклад, погіршення справності пристрою. Адміністратори також можуть використовувати його для пробних запусків виселення Podʼів у DeviceTaintRules (детальніше про це нижче).
ResourceClaims можуть толерувати позначки taint. Якщо taint толерується, його ефект не застосовується. Порожній toleration відповідає всім позначкам taint. Toleration можна обмежити певними ефектами та/або певними парами ключ/значення. Toleration може перевіряти, що певний ключ існує, незалежно від його значення, або перевіряти конкретні значення ключа. Детальніше про це зіставлення див. у концепціях taint вузлів.
Виселення може бути відкладене шляхом толерування taint протягом певного періоду часу. Ця затримка починається в момент, коли taint додається до пристрою, що фіксується в полі taint.
Позначки taint застосовуються, як описано вище, також до ResourceClaims, які виділяють "всі" пристрої на вузлі. Усі пристрої мають бути непозначеними, або всі їхні позначки taint мають толеруватися. Виділення пристрою з адміністративним доступом також не є винятком. Адміністратор, який використовує цей режим, має явно толерувати всі позначки taint, щоб отримати доступ до позначених пристроїв.
Ви можете додавати позначки taint до пристроїв наступними способами, використовуючи вид API DeviceTaintRule.
Позначки taint, встановлені драйвером
Драйвер DRA може додавати позначки taint до інформації про пристрій, яку він публікує в ResourceSlices. Зверніться до документації драйвера DRA, щоб дізнатися, чи використовує драйвер позначки taint і які їхні ключі та значення.
Позначки taint, встановлені адміністратором
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.37. It was first available in the v1.35 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate DRADeviceTaintRules, Kubernetes ignores it but does not report any error.
Адміністратор або компонент панелі управління може позначити пристрої без необхідності вказувати драйверу DRA включати позначки taint у свою інформацію про пристрої в ResourceSlices. Вони роблять це, створюючи DeviceTaintRules. Кожен DeviceTaintRule додає одну позначку taint пристроям, які відповідають селектору пристроїв. Без такого селектора жодні пристрої не позначаються. Це ускладнює випадкове виселення всіх Podʼів, які використовують ResourceClaims, якщо селектор випадково пропущено.
Пристрої можуть бути вибрані шляхом вказання назви DeviceClass, драйвера, пулу та/або пристрою. DeviceClass вибирає всі пристрої, які вибираються селекторами в цьому DeviceClass. Лише з назвою драйвера адміністратор може позначити всі пристрої, якими керує цей драйвер, наприклад, під час проведення певного технічного обслуговування цього драйвера в усьому кластері. Додавання назви пулу може обмежити taint одним вузлом, якщо драйвер керує локальними для вузла пристроями.
Нарешті, додавання назви пристрою може вибрати один конкретний пристрій. Назва пристрою та назва пулу також можуть використовуватися окремо, якщо бажано. Наприклад, драйверам для локальних для вузла пристроїв рекомендується використовувати назву вузла як назву свого пулу. Тоді позначення за допомогою цієї назви пулу автоматично позначає всі пристрої на вузлі.
Драйвери можуть використовувати стабільні назви, як-от "gpu-0", які приховують, який саме пристрій наразі призначено цій назві. Щоб підтримати позначення конкретного екземпляра обладнання, у DeviceTaintRule можна використовувати селектори CEL для зіставлення з унікальним ID-атрибутом, специфічним для постачальника, якщо драйвер підтримує його для свого обладнання.
Taint застосовується, доки існує DeviceTaintRule. Його можна змінювати та видаляти в будь-який час. Ось один приклад DeviceTaintRule для вигаданого драйвера DRA:
apiVersion:resource.k8s.io/v1kind:DeviceTaintRulemetadata:name:examplespec:# Уся апаратна інсталяція для цього# конкретного драйвера не працює.# Виселити всі Podʼи і не планувати нові.deviceSelector:driver:dra.example.comtaint:key:dra.example.com/unhealthyvalue:Brokeneffect:NoExecute
kube-apiserver автоматично відстежує, коли було створено цю позначку taint, встановлюючи поле timeAdded у spec. Період дії toleration починається з цієї позначки часу. Під час оновлень, які змінюють ефект (див. імітований процес виселення нижче), kube-apiserver автоматично оновлює позначку часу. Користувачі можуть контролювати позначку часу явно, встановлюючи поле під час створення DeviceTaintRule та змінюючи його на інше значення під час оновлення.
Статус містить стан, доданий контролером виселення:
kubectl describe devicetaintrules
Name: example
...
Spec:
Device Selector:
Driver: dra.example.com
Taint:
Effect: NoExecute
Key: dra.example.com/unhealthy
Time Added: 2025-11-05T18:15:37Z
Value: Broken
Status:
Conditions:
Last Transition Time: 2025-11-05T18:15:37Z
Message: 1 pod evicted since starting the controller.
Observed Generation: 1
Reason: Completed
Status: False
Type: EvictionInProgress
Events: <none>
Podʼи виселяються шляхом їх видалення. Зазвичай це відбувається дуже швидко, за винятком випадків, коли toleration для taint відкладає це на певний період або коли є дуже багато Podʼів, які потрібно виселити. Коли це займає більше часу, повідомлення надає інформацію про поточний статус:
2 pods need to be evicted in 2 different namespaces. 1 pod evicted since starting the controller.
Стан може використовуватися для перевірки того, чи виселення наразі активне:
Стережіться потенційної гонитви між планувальником і контролером, які спостерігають нову позначку taint у різний час, що може призвести до того, що Podʼи все ще плануватимуться в момент, коли контролер вважає, що немає жодних, які потрібно виселити, і тому встановлює цей стан в False. На практиці ця гонитва стає дуже малоймовірною завдяки оновленню статусу лише після навмисної затримки в кілька секунд.
Для effect: None повідомлення надає інформацію про кількість відповідних пристроїв, скільки з них виділено та скільки Podʼів було б виселено, якби ефект був NoExecute. Це можна використовувати для пробного запуску перед фактичним запуском виселення:
Створіть DeviceTaintRule з бажаними селекторами та effect: None.
Перегляньте повідомлення:
3 published devices selected. 1 allocated device selected.
1 pod would be evicted in 1 namespace if the effect was NoExecute.
This information will not be updated again. Recreate the DeviceTaintRule to trigger an update.
Опубліковані пристрої — це ті, що перелічені в ResourceSlices. Їх позначення запобігає виділенню для нових Podʼів. Лише виділені пристрої спричиняють виселення Podʼів, які їх використовують.
Відредагуйте DeviceTaintRule та змініть ефект на NoExecute.
6.11.3 - Менеджери ресурсів на рівні Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the PodLevelResourceManagers feature gate for all relevant components in your cluster.
Підтримка ресурсів на рівні Podʼів для наявних менеджерів ресурсів (топології, CPU та памʼяті) розширює їх для обробки специфікацій ресурсів на рівні Podʼів. Коли цю можливість увімкнено (через функціональні можливості PodLevelResources та PodLevelResourceManagers), менеджери ресурсів можуть використовувати .spec.resources безпосередньо як основу для своїх рішень щодо виділення, переходячи від суто поконтейнерної моделі виділення до моделі, орієнтованої на Pod. Ця схема розділення впроваджує гнучкішу й потужнішу модель керування ресурсами, особливо для чутливих до продуктивності робочих навантажень. Вона дозволяє визначати гібридні моделі виділення, у яких деякі контейнери в Podʼі отримують ексклюзивні, вирівняні за NUMA ресурси, тоді як інші спільно використовують решту ресурсів зі спільного пулу на рівні Podʼа.
Щоб зрозуміти менеджери ресурсів на рівні Podʼів, корисно порівняти їх із традиційною моделлю, орієнтованою на контейнери. Раніше виділення ресурсів kubelet працювало суто за принципом «все або нічого»: щоб отримати ексклюзивні, вирівняні за NUMA ресурси для вашого робочого навантаження, кожен контейнер у Podʼі мав бути Guaranteed (із запитами, що дорівнюють обмеженням і для CPU, і для памʼяті).
Менеджери ресурсів на рівні Podʼів використовують .spec.resources, щоб забезпечити гнучке розділення на основі налаштованої області дії менеджера топології:
Область дії pod:kubelet виділяє та вирівнює за NUMA єдину «бульбашку» Podʼа для всього Podʼа на основі .spec.resources. Контейнери, які запитують ексклюзивні виділення, вирізають окремі частки всередині цієї «бульбашки», тоді як усі інші контейнери спільно використовують решту місткості «бульбашки» у спільному пулі, ізольованому на рівні Podʼа.
Область дії container: Вмикає гібридну модель виділення. kubelet дозволяє окремим контейнерам отримувати ексклюзивні, вирівняні за NUMA ресурси безпосередньо з доступного для розподілу пулу вузла, водночас використовуючи верхню межу .spec.resources Podʼа для обмеження сукупного споживання. Це дозволяє sidecar-контейнерам працювати в загальному спільному пулі вузла, не вимагаючи, щоб кожен контейнер у Podʼі був Guaranteed.
Повністю підтримуються як стандартні init-контейнери, так і init-контейнери з можливістю перезапуску (sidecar-контейнери). Вони можуть отримувати ексклюзивні частки ресурсів або використовувати спільний пул Podʼа, а менеджери ресурсів на рівні Podʼів дотримуються їхніх правил життєвого циклу (наприклад, повторно використовувані ресурси для стандартних init-контейнерів і постійні резервування для sidecar-контейнерів).
Глосарій
Специфікація ресурсів на рівні Podʼа
Бюджет ресурсів, визначений на рівні Podʼа в .spec.resources, який задає сукупні запити та обмеження для всього Podʼа.
Контейнер Guaranteed
Контейнер, запити ресурсів якого дорівнюють його обмеженням і для CPU (ексклюзивне виділення CPU вимагає додатного цілого значення), і для памʼяті. Відповідно до наявної поведінки kubelet, це робить контейнер придатним для ексклюзивного виділення ресурсів менеджерами ресурсів.
Ексклюзивна частка
Виділена частина ресурсів (наприклад, конкретні CPU або сторінки памʼяті), призначена виключно одному контейнеру, що забезпечує ізоляцію від інших контейнерів.
Спільний пул Podʼа
Підмножина виділених ресурсів Podʼа, яка залишається після резервування всіх ексклюзивних часток. Ці ресурси спільно використовуються всіма контейнерами в Podʼі, які не отримують ексклюзивного виділення. Хоча контейнери в цьому пулі спільно використовують ресурси один з одним, вони суворо ізольовані від ексклюзивних часток і загального спільного пулу вузла.
Як працюють менеджери ресурсів на рівні Podʼів
Менеджери ресурсів CPU та Memory працюють по-різному залежно від налаштованої області дії менеджера топології.
Область дії pod менеджера топології та ресурси на рівні Podʼів
Коли область дії менеджера топології встановлено в pod, kubelet виконує єдине вирівнювання за NUMA для всього Podʼа на основі бюджету ресурсів, визначеного в .spec.resources.
Отриманий вирівняний за NUMA пул ресурсів потім розділяється:
Ексклюзивні частки: Контейнери, які визначають ресурси Guaranteed (запити дорівнюють обмеженням і для CPU, і для памʼяті, а запит CPU є додатним цілим числом), отримують ексклюзивні частки із загального виділення Podʼа.
Спільний пул Podʼа: Решта ресурсів утворює спільний пул для всіх інших контейнерів у Podʼі, які не отримують ексклюзивного виділення. Хоча контейнери в цьому пулі спільно використовують ресурси один з одним, вони суворо ізольовані від ексклюзивних часток і загального спільного пулу вузла.
Зверніть увагу, що коли стандартні init-контейнери завершують виконання, їхні ресурси переходять у повторно використовуваний набір для Podʼа, а не повертаються до пулу ресурсів вузла. Оскільки вони виконуються послідовно, наступні контейнери застосунку можуть повторно використовувати ці ресурси (або для власних ексклюзивних часток, або для спільного пулу).
Це дозволяє розміщувати разом контейнери, які потребують ексклюзивних ресурсів (наприклад, високопродуктивний основний застосунок), з тими, які цього не потребують (наприклад, sidecar-контейнери для логування або моніторингу), і все це в межах одного вирівняного за NUMA Podʼа.
Розгляньмо контейнери в наведеній нижче специфікації Podʼа, де область дії менеджера топології — pod, а Pod має загальний бюджет у 4 CPU. main-app запитує ексклюзивну частку у 2 CPU, тоді як sidecar-контейнери спільно використовують решту 2 CPU у спільному пулі Podʼа:
apiVersion:v1kind:Podmetadata:name:pod-scope-mixedannotations:kubernetes.io/description:"A pod demonstrating pod-level scope where one container gets exclusive resources and others share the remaining pod resources in a shared pool."spec:# At Pod level, the Pod has CPU request equal to limits and memory request# also equal to memory limits. The main-app container meets the requirements# for the Guaranteed QoS class at container level, and the sidecar containers# don't specify any resource request. Under pod scope, this means that the# kubelet could statically assign 4 CPUs to the overall Pod, of which 2 are# assigned exclusively to the main-app container, and the remaining 2 are# shared by the sidecars in the pod's shared pool.resources:requests:cpu:"4"memory:"4Gi"limits:cpu:"4"memory:"4Gi"initContainers:- name:metrics-sidecar# Note: This is a placeholder image for demonstration purposes, not an#actual metrics helper.image:registry.k8s.io/pause:3.9restartPolicy:Always- name:logging-sidecar# Note: This is a placeholder image for demonstration purposes, not an# actual logging agent.image:registry.k8s.io/pause:3.9restartPolicy:Alwayscontainers:- name:main-app# Note: This is a placeholder image for demonstration purposes.image:registry.k8s.io/pause:3.9resources:requests:cpu:"2"memory:"2Gi"limits:cpu:"2"memory:"2Gi"
Важливі міркування:
Під час використання ресурсів на рівні Podʼів з областю дії pod менеджера топології є кілька важливих міркувань:
Обмеження порожнього спільного пулу: Ця конфігурація не дозволяє специфікації Podʼа, які призвели б до порожнього спільного пулу Podʼа, якщо є контейнери, які потребують такого пулу. Якщо сума запитів ресурсів усіх контейнерів, які є Guaranteed, точно дорівнює загальному бюджету ресурсів, і є принаймні один інший контейнер, який потребує спільного пулу, kubelet відхиляє Pod під час допуску.
Наприклад, наведений нижче Pod запитує бюджет на рівні Podʼа у 4 CPU. main-app потребує ексклюзивних 3 CPU, а metrics-sidecar — ексклюзивного 1 CPU. Оскільки у спільному пулі для logging-sidecar залишається 0 CPU, kubelet відхиляє цей Pod (та сама перевірка застосовується до памʼяті):
apiVersion:v1kind:Podmetadata:name:empty-shared-poolannotations:kubernetes.io/description:"A pod demonstrating a configuration that is rejected because exclusive containers consume the entire pod resource budget, leaving no resources for the remaining container in the shared pool."spec:# На рівні Podʼа запит Pod на CPU дорівнює лімітам, а запит на памʼять# також дорівнює лімітам памʼяті. Контейнери main-app і metrics-sidecar# відповідають вимогам класу QoS Guaranteed на рівні контейнера, а# контейнер logging-sidecar не вказує жодних запитів на ресурси. Оскільки# Guaranteed-контейнери споживають увесь ресурсний бюджет Podʼа,# залишаючи 0 CPU для спільного пулу, потрібного logging-sidecar, цей Pod# буде відхилено під час допуску.resources:requests:cpu:"4"memory:"4Gi"limits:cpu:"4"memory:"4Gi"initContainers:- name:metrics-sidecar# Примітка: це образ-заповнювач для демонстрації, а не# справжній допоміжний компонент для метрик.image:registry.k8s.io/pause:3.9restartPolicy:Alwaysresources:requests:cpu:"1"memory:"1Gi"limits:cpu:"1"memory:"1Gi"- name:logging-sidecar# Примітка: це образ-заповнювач для демонстрації, а не# справжній агент логування.image:registry.k8s.io/pause:3.9restartPolicy:Alwayscontainers:- name:main-app# Примітка: це образ-заповнювач для демонстрації.image:registry.k8s.io/pause:3.9resources:requests:cpu:"3"memory:"3Gi"limits:cpu:"3"memory:"3Gi"
Втрачені ресурси: Будь-які ресурси, надмірно виділені під час використання області дії pod (сума запитів контейнерів менша за бюджет на рівні Podʼа, і немає контейнерів спільного пулу, або контейнери спільного пулу не повністю використовують решту), залишаються призначеними та зарезервованими для Podʼа, фактично марнуючись протягом усього виконання Podʼа.
Постійний пул: Загальний пул ресурсів Podʼа (вирівнювання за NUMA та загальна зарезервована місткість) є постійним. Якщо контейнер спільного пулу аварійно завершується та перезапускається, загальне резервування ресурсів Podʼа залишається надійно закріпленим на вузлі. Вузол повертає ресурси до свого загального пулу лише тоді, коли завершується весь Pod.
Область дії container менеджера топології та ресурси на рівні Podʼів
Коли область дії менеджера топології встановлено в container, kubelet оцінює кожен контейнер окремо для ексклюзивного виділення.
Якщо весь Pod досягає класу QoSGuaranteed (завдяки відповідним значенням у .spec.resources на рівні Podʼа), ви можете поєднувати контейнери:
Контейнери з власними запитами Guaranteed отримують ексклюзивні, вирівняні за NUMA ресурси.
Інші контейнери в Podʼі, які не визначають запити Guaranteed, працюють у спільному пулі вузла.
На сукупне споживання ресурсів усіма контейнерами все одно діють обмеження .spec.resources Podʼа.
Ця область дії корисна, коли у вас є інфраструктурний sidecar-контейнер, який має бути вирівняний за конкретним вузлом NUMA для доступу до пристроїв, тоді як основне робоче навантаження може працювати в загальному спільному пулі вузла.
Розгляньмо контейнери в наведеній нижче специфікації Podʼа, де область дії менеджера топології — container, а Pod представляє робоче навантаження з інфраструктурним sidecar-контейнером і двома робочими процесами застосунку із загальним бюджетом у 4 CPU. infrastructure-sidecar отримує ексклюзивну, вирівняну за NUMA частку у 2 CPU. Два робочі процеси застосунку (worker-1 та worker-2) працюють у загальному спільному пулі вузла:
apiVersion:v1kind:Podmetadata:name:container-scope-mixedannotations:kubernetes.io/description:"A pod demonstrating container-level scope where one container gets exclusive resources and others run in the node's shared pool."spec:# At Pod level, the Pod has CPU request equal to limits and memory request# also equal to memory limits. The infrastructure-sidecar container meets the# requirements for the Guaranteed QoS class at container level, and the worker# containers don't specify any resource request. Under container scope, the# kubelet evaluates containers individually for exclusive allocation. This# means the infrastructure-sidecar gets an exclusive 2 CPU slice, while the# worker containers run in the node's general shared pool, all while bounded# by the overall pod limits.resources:requests:cpu:"4"memory:"4Gi"limits:cpu:"4"memory:"4Gi"initContainers:- name:infrastructure-sidecar# Note: This is a placeholder image for demonstration purposes, not an# actual infrastructure helper.image:registry.k8s.io/pause:3.9restartPolicy:Alwaysresources:requests:cpu:"2"memory:"2Gi"limits:cpu:"2"memory:"2Gi"containers:- name:worker-1# Note: This is a placeholder image for demonstration purposes.image:registry.k8s.io/pause:3.9- name:worker-2# Note: This is a placeholder image for demonstration purposes.image:registry.k8s.io/pause:3.9
Квота CPU (CFS)
Під час виконання змішаних робочих навантажень у межах Podʼа kubelet забезпечує ізоляцію по-різному залежно від виділення:
Ексклюзивні контейнери: Для контейнерів з ексклюзивними частками CPU застосування квоти CPU CFS вимкнено, що дозволяє їм працювати без тротлінгу планувальником Linux.
Контейнери спільного пулу Podʼа: Для контейнерів у спільному пулі Podʼа квоти CPU CFS увімкнено, що гарантує, що вони не споживають більше за залишковий бюджет Podʼа, і не дає їм заважати ексклюзивним контейнерам.
Постійний пул і перезапуски
Загальний пул ресурсів Podʼа (вирівнювання за NUMA та загальна зарезервована місткість) є постійним. Якщо контейнер у спільному пулі Podʼа аварійно завершується та перезапускається, загальне резервування ресурсів Podʼа залишається надійно закріпленим на вузлі. Вузол повертає ресурси до свого загального пулу лише тоді, коли завершується весь Pod.
Пониження версії kubelet та контрольні точки стану
У Kubernetes 1.36 увімкнення PodLevelResourceManagers оновило внутрішні файли контрольних точок стану kubelet (cpu_manager_state та memory_manager_state) до формату, який старіші версії kubelet не можуть завантажити. Якщо ви понизите версію kubelet 1.36 після активного використання, старіший kubelet не зможе запуститися; ви маєте виконати drain вузла, видалити ці файли контрольних точок і перезапустити kubelet.
У Kubernetes 1.37 файли контрольних точок використовують формат, сумісний із майбутніми версіями, щоб запобігти збоям запуску під час пониження версії, хоча версії kubelet 1.36 не відновлюють активні призначення ресурсів на рівні Podʼів. Докладні відомості про формати контрольних точок і відновлення дивіться в довіднику менеджерів ресурсів на рівні Podʼів.
Спостережуваність і метрики
Ви можете контролювати поведінку та справність менеджерів ресурсів як для виділень на рівні контейнерів, так і на рівні Podʼів за допомогою таких метрик kubelet (увімкнених через функціональну можливість PodLevelResourceManagers):
resource_manager_allocations_total: підраховує загальну кількість ексклюзивних виділень ресурсів, виконаних менеджером. Мітка source ("pod" або "node") розрізняє виділення з пулу на рівні вузла та попередньо виділеного пулу на рівні Podʼа.
resource_manager_allocation_errors_total: підраховує помилки, що виникають під час ексклюзивного виділення ресурсів, розрізняючи їх за передбачуваним джерелом source виділення ("pod" або "node").
resource_manager_container_assignments: відстежує сукупну кількість контейнерів, яким буде надано конкретний тип призначення ресурсів. Мітка assignment_type ("node_exclusive", "pod_exclusive", "pod_shared") забезпечує видимість того, скільки контейнерів працюють з ексклюзивними ресурсами (з пулу вузла або Podʼа) порівняно зі спільним пулом на рівні Podʼа.
PodResources API
У Kubernetes 1.37 локальний для вузла gRPC API PodResourceskubelet включає виділення ресурсів на рівні Podʼів, коли увімкнено PodLevelResourceManagers. Локальні для вузла агенти моніторингу та втулки пристроїв можуть запитувати призначення верхнього рівня для Podʼів (cpu_ids та memory), уникаючи подвійного підрахунку виділень на рівні контейнерів.
Функціональність реалізована лише для політики static менеджера CPU та політики Static менеджера памʼяті. Зверніть увагу, що політика BestEffort не підтримується для менеджера памʼяті.
Ця можливість підтримується лише на вузлах Linux. На вузлах Windows менеджери ресурсів для виділень на рівні Podʼів нічого не робитимуть (no-op).
Деталі низького рівня, що стосуються створення та адміністрування кластера Kubernetes.
Огляд адміністрування кластера призначений для всіх, хто створює кластер Kubernetes або адмініструє його. Він передбачає певне знайомство з основними концепціями Kubernetes.
Планування кластера
Приклади планування, встановлення та налаштування кластерів Kubernetes дивіться в посібниках у розділі Встановлення. Рішення, перелічені в цій статті, називаються дистрибутивами (distros).
Примітка:
Не всі дистрибутиви активно підтримуються. Вибирайте дистрибутиви, протестовані з нещодавньою версією Kubernetes.
Перед вибором посібника врахуйте таке:
Ви хочете спробувати Kubernetes на своєму компʼютері чи побудувати високодоступний кластер із кількома вузлами? Вибирайте дистрибутиви, які найкраще відповідають вашим потребам.
Ви використовуватимете кластер Kubernetes на хостингу, такий як Google Kubernetes Engine, чи розміщуватимете власний кластер?
Ваш кластер буде on-premises чи у хмарі (IaaS)? Kubernetes не підтримує гібридні кластери безпосередньо. Натомість ви можете налаштувати кілька кластерів.
Якщо ви налаштовуєте Kubernetes on-premises, визначте, яка мережева модель підходить найкраще.
Ви запускатимете Kubernetes на фізичному обладнанні (bare metal) чи на віртуальних машинах (VM)?
Ви хочете просто запустити кластер чи плануєте активно розробляти код проєкту Kubernetes? В останньому випадку виберіть дистрибутив, що активно розвивається. Деякі дистрибутиви використовують лише бінарні випуски, але пропонують ширший вибір.
Ознайомтеся з компонентами, необхідними для запуску кластера.
У кластері Kubernetes вузол може бути вимкнено планово й коректно або несподівано через такі причини, як відключення живлення чи інші зовнішні обставини. Вимкнення вузла може призвести до збою робочого навантаження, якщо перед вимкненням для вузла не виконано drain. Вимкнення вузла може бути коректним (graceful) або некоректним (non-graceful).
Увага:
Пакунок unattended-upgrades з Debian у своїй звичайній конфігурації конфліктує з коректним вимкненням вузла. Якщо ви використовуєте стандартну конфігурацію unattended-upgrades, яка змінює період коректного завершення під час вимкнення сервера, kubelet не зможе отримати блокування, потрібне для правильної обробки подій вимкнення.
Це відбувається, якщо значення shutdownGracePeriod перевищує 30 секунд. Щоб уникнути цього, ви можете приглушити частину конфігурації unattended-upgrades, зробивши /etc/systemd/logind.conf.d/unattended-upgrades-logind-maxdelay.conf символічним посиланням на /dev/null.
kubelet намагається виявити вимкнення системи вузла та завершує Podʼи, що працюють на вузлі.
kubelet забезпечує, щоб під час вимкнення вузла Podʼи проходили звичайний процес завершення Podʼа. Під час вимкнення вузла kubelet не приймає нові Podʼи (навіть якщо ці Podʼи вже привʼязані до вузла).
Увімкнення коректного вимкнення вузла
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.21; (стандартно увімкнено)
У Linux коректним вимкненням вузла керує функціональна можливість GracefulNodeShutdown, яку стандартно ввімкнено у версії 1.21.
Примітка:
Коректне вимкнення вузла залежить від systemd, оскільки використовує блокування інгібіторів systemd, щоб затримати вимкнення вузла на заданий час.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34; (стандартно увімкнено)
У Windows коректним вимкненням вузла керує функціональна можливість WindowsGracefulNodeShutdown, яку запроваджено у версії 1.32 як альфа-можливість. У Kubernetes 1.34 ця можливість перебуває на стадії бета й стандартно ввімкнена.
Примітка:
Коректне вимкнення вузла у Windows залежить від того, чи працює kubelet як служба Windows; тоді він матиме зареєстрований обробник керування службою, щоб затримати подію preshutdown на заданий час.
Коректне вимкнення вузла у Windows неможливо скасувати.
Якщо kubelet не працює як служба Windows, він не зможе встановити та відстежувати подію Preshutdown, і вузлу доведеться пройти процедуру некоректного вимкнення вузла, згадану вище.
Якщо коректне вимкнення вузла у Windows ввімкнено, але kubelet не працює як служба Windows, kubelet продовжить працювати, а не завершиться збоєм. Однак він запише в лог помилку про те, що його потрібно запускати як службу Windows.
Налаштування коректного вимкнення вузла
Зверніть увагу, що стандартно обидва параметри конфігурації, описані нижче, shutdownGracePeriod та shutdownGracePeriodCriticalPods, мають нульове значення, тому коректне вимкнення вузла не активоване. Щоб активувати цю можливість, обидва параметри потрібно правильно налаштувати, встановивши ненульові значення.
Щойно kubelet отримує сповіщення про вимкнення вузла, він встановлює на Node стан NotReady із reason зі значенням "node is shutting down". kube-scheduler враховує цей стан і не планує жодних Podʼів на цей вузол; очікується, що інші сторонні планувальники дотримуватимуться такої самої логіки. Це означає, що нові Podʼи не плануватимуться на цей вузол, а отже, жоден із них не запуститься.
kubelet також відхиляє Podʼи під час фази PodAdmission, якщо виявлено поточне вимкнення вузла, тому навіть Podʼи з toleration для node.kubernetes.io/not-ready:NoSchedule там не запустяться.
Коли kubelet встановлює цей стан на своєму Node через API, він також починає завершувати всі Podʼи, що працюють локально.
Під час коректного вимкнення kubelet завершує Podʼи у дві фази:
Визначає загальний час, на який вузол має затримати вимкнення. Це загальний період коректного завершення для звичайних і критичних Podʼів.
shutdownGracePeriodCriticalPods:
Визначає час, який використовується для завершення критичних Podʼів під час вимкнення вузла. Це значення має бути меншим за shutdownGracePeriod.
Примітка:
Є випадки, коли вимкнення вузла було скасовано системою (або, можливо, вручну адміністратором). У будь-якому з цих випадків вузол повернеться до стану Ready. Однак Podʼи, які вже розпочали процес завершення, не будуть відновлені kubelet і їх потрібно буде перепланувати.
Наприклад, якщо shutdownGracePeriod=30s, а shutdownGracePeriodCriticalPods=10s, kubelet затримає вимкнення вузла на 30 секунд. Під час вимкнення перші 20 (30-10) секунд буде зарезервовано для коректного завершення звичайних Podʼів, а останні 10 секунд — для завершення критичних Podʼів.
Примітка:
Коли Podʼи виселяються під час коректного вимкнення вузла, вони позначаються як вимкнені. Команда kubectl get pods показує статус виселених Podʼів як Terminated. А kubectl describe pod вказує, що Pod було виселено через вимкнення вузла:
Reason: Terminated
Message: Pod was terminated in response to imminent node shutdown.
Коректне вимкнення вузла на основі пріоритету Podʼів
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.24; (стандартно увімкнено)
Щоб забезпечити більшу гнучкість щодо порядку завершення Podʼів під час коректного вимкнення вузла, воно враховує PriorityClass Podʼів, за умови, що ви ввімкнули цю можливість у своєму кластері. Ця можливість дозволяє адміністраторам кластера явно визначати порядок завершення Podʼів під час коректного вимкнення вузла на основі класів пріоритету.
Можливість коректного вимкнення вузла, описана вище, вимикає Podʼи у дві фази: спочатку некритичні Podʼи, а потім критичні. Якщо потрібна додаткова гнучкість, щоб явно й докладніше визначити порядок Podʼів під час вимкнення, можна використовувати коректне вимкнення на основі пріоритету Podʼів.
Коли коректне вимкнення вузла враховує пріоритети Podʼів, його можна виконувати в кілька фаз, кожна з яких вимикає Podʼи певного класу пріоритету. У kubelet можна налаштувати конкретні фази та час вимкнення для кожної фази.
Наведена вище таблиця означає, що будь-який Pod зі значенням priority >= 100000 отримає лише 10 секунд на вимкнення, будь-який Pod зі значенням >= 10000 і < 100000 отримає 180 секунд на вимкнення, будь-який Pod зі значенням >= 1000 і < 10000 отримає 120 секунд на вимкнення. Нарешті, усі інші Podʼи отримають 60 секунд на вимкнення.
Не обовʼязково вказувати значення, відповідні всім класам. Наприклад, можна використовувати ці налаштування:
Значення класу пріоритету Podʼа
Період вимкнення
100000
300 секунд
1000
120 секунд
0
60 секунд
У цьому випадку Podʼи з custom-class-b потраплять до тієї самої групи вимкнення, що й custom-class-c.
Якщо в певному діапазоні немає Podʼів, kubelet не чекає на Podʼи в цьому діапазоні пріоритетів. Натомість kubelet одразу переходить до наступного діапазону значень класу пріоритету.
Якщо цю можливість увімкнено, а конфігурацію не надано, жодних дій з упорядкування не виконується.
Щоб використовувати цю можливість, потрібно ввімкнути функціональну можливість GracefulNodeShutdownBasedOnPodPriority і встановити в ShutdownGracePeriodByPodPriority у конфігурації kubelet потрібну конфігурацію зі значеннями класів пріоритету Podʼів та відповідними періодами вимкнення.
Примітка:
Можливість враховувати пріоритет Podʼів під час коректного вимкнення вузла запроваджено як альфа-можливість у Kubernetes v1.23. У Kubernetes 1.37 ця можливість перебуває на стадії бета й стандартно ввімкнена.
Метрики graceful_shutdown_start_time_seconds та graceful_shutdown_end_time_seconds надаються в підсистемі kubelet для моніторингу вимкнень вузлів.
Обробка некоректного вимкнення вузла
This is a stable feature in Kubernetes, and has been since the 1.28 release. You can no longer toggle this feature (the associated feature gate has been removed).
Вимкнення вузла може не виявити Node Shutdown Manager у kubelet — або тому, що команда не активує механізм блокування інгібіторів, який використовує kubelet, або через помилку користувача, тобто неправильне налаштування ShutdownGracePeriod та ShutdownGracePeriodCriticalPods. Докладніше дивіться в розділі Коректне вимкнення вузла вище.
Коли вузол вимкнено, але Node Shutdown Manager у kubelet цього не виявив, Podʼи, що входять до StatefulSet, застрягнуть у стані завершення на вимкненому вузлі та не зможуть перейти на новий запущений вузол. Це тому, що kubelet на вимкненому вузлі недоступний для видалення Podʼів, тому StatefulSet не може створити новий Pod з такою самою назвою. Якщо Podʼи використовують томи, VolumeAttachments не буде видалено з початкового вимкненого вузла, тому томи, які використовують ці Podʼи, не можна підʼєднати до нового запущеного вузла. Унаслідок цього застосунок, що працює в StatefulSet, не може функціонувати належним чином. Якщо початковий вимкнений вузол знову запрацює, kubelet видалить Podʼи, а нові Podʼи буде створено на іншому запущеному вузлі. Якщо початковий вимкнений вузол не запрацює, ці Podʼи назавжди застрягнуть у стані завершення на вимкненому вузлі.
Щоб помʼякшити цю ситуацію, користувач може вручну додати taint node.kubernetes.io/out-of-service з ефектом NoExecute або NoSchedule до вузла, позначивши його як виведений з експлуатації. Якщо вузол позначено цим taint, Podʼи на вузлі буде примусово видалено, якщо вони не мають відповідних tolerations, а операції відʼєднання томів для Podʼів, що завершуються на вузлі, відбудуться негайно. Це дозволяє Podʼам з виведеного з експлуатації вузла швидко відновитися на іншому вузлі.
Під час некоректного вимкнення Podʼи завершуються у дві фази:
Примусово видаляються Podʼи, які не мають відповідних tolerations out-of-service.
Негайно виконується операція відʼєднання томів для таких Podʼів.
Примітка:
Перш ніж додавати taint node.kubernetes.io/out-of-service, слід перевірити, що вузол уже вимкнений або знеструмлений (а не перебуває в процесі перезапуску).
Користувач має вручну видалити taint out-of-service після того, як Podʼи буде переміщено на новий вузол і користувач перевірить, що вимкнений вузол відновився, оскільки саме користувач додав цей taint.
Примусове відʼєднання сховища за тайм-аутом
У будь-якій ситуації, коли видалення Podʼа не вдалося протягом 6 хвилин, Kubernetes примусово відʼєднає томи, що розмонтовуються, якщо в цей момент вузол несправний. Будь-яке робоче навантаження, що все ще працює на вузлі й використовує примусово відʼєднаний том, спричинить порушення специфікації CSI, згідно з якою ControllerUnpublishVolume «має викликатися після того, як усі виклики NodeUnstageVolume та NodeUnpublishVolume для тому виконано й вони успішно завершилися». За таких обставин томи на цьому вузлі можуть зазнати пошкодження даних.
Примусове відʼєднання сховища є необовʼязковим; користувачі можуть натомість скористатися можливістю «Non-graceful node shutdown».
Примусове відʼєднання сховища за тайм-аутом можна вимкнути, встановивши поле конфігурації disable-force-detach-on-timeout у kube-controller-manager. Вимкнення цієї можливості означає, що для тому, розміщеного на вузлі, який несправний понад 6 хвилин, повʼязаний VolumeAttachment не буде видалено.
Після застосування цього налаштування несправні Podʼи, все ще приєднані до томів, потрібно відновлювати за допомогою процедури обробки некоректного вимкнення вузла, згаданої вище.
Kubernetes можна налаштувати на використання своп-памʼяті на вузлі, що дозволяє ядру звільняти фізичну памʼять, витісняючи сторінки до резервного сховища. Це корисно в багатьох сценаріях. Наприклад, на вузлах, де працюють робочі навантаження, яким може бути корисний своп, зокрема ті, що займають багато памʼяті, але в кожен момент часу звертаються лише до її частини. Своп також допомагає запобігти завершенню Podʼів під час стрибків тиску на памʼять, захищає вузли від стрибків використання памʼяті на рівні системи, які можуть порушити їх стабільність, дозволяє гнучкіше керувати памʼяттю на вузлі й багато іншого.
Вузли Linux підтримують своп; для його увімкнення потрібно налаштувати кожен вузол. Стандартно kubelet не запускається на вузлі Linux, на якому увімкнено своп.
Вузли Windows потребують простору свопу. Стандартно kubelet не запускається на вузлі Windows, на якому вимкнено своп.
Як це працює?
Використання свопу на вузлі можна уявити кількома способами. Якщо kubelet уже працює на вузлі, після налаштування свопу його потрібно перезапустити, щоб він виявив своп.
Коли kubelet запускається на вузлі, на якому своп налаштовано й доступно (з конфігурацією failSwapOn: false), kubelet:
Зможе запуститися на цьому вузлі з увімкненим свопом.
Вказуватиме реалізації Container Runtime Interface (CRI), яку часто називають середовищем виконання контейнерів, стандартно виділяти робочим навантаженням Kubernetes нульовий обсяг своп-памʼяті.
Конфігурація свопу на вузлі доступна адміністратору кластера через memorySwap у KubeletConfiguration. Як адміністратор кластера ви можете вказати поведінку вузла за наявності своп-памʼяті, встановивши memorySwap.swapBehavior.
Поведінка свопу
Вам потрібно вибрати поведінку свопу. Різні вузли у вашому кластері можуть використовувати різну поведінку свопу.
Для вузлів Linux можна вибрати таку поведінку свопу:
NoSwap (стандартно)
Робочі навантаження, що працюють як Podʼи на цьому вузлі, не використовують і не можуть використовувати своп.
LimitedSwap
Робочі навантаження Kubernetes можуть використовувати своп-памʼять.
Примітка:
Якщо ви виберете поведінку NoSwap і налаштуєте kubelet на допуск простору свопу (failSwapOn: false), ваші робочі навантаження не використовуватимуть своп.
Однак процеси поза контейнерами під керуванням Kubernetes, такі як сервіси systemd (і навіть сам kubelet!), можуть використовувати своп.
kubelet використовує API середовища виконання контейнерів і вказує йому застосувати певну конфігурацію (наприклад, для cgroup v2 — memory.swap.max) так, щоб увімкнути бажану конфігурацію свопу для контейнера. Для середовищ виконання, які використовують контрольні групи (cgroups), середовище виконання контейнерів відповідає за запис цих налаштувань до cgroup на рівні контейнера.
Спостережуваність використання свопу
Статистика метрик на рівні вузла та контейнера
kubelet тепер збирає статистику метрик на рівні вузла та контейнера, доступну через HTTP-точки доступу kubelet /metrics/resource (її використовують переважно інструменти моніторингу, такі як Prometheus) та /stats/summary (її використовують переважно автомасштабувальники). Це дозволяє клієнтам, які можуть безпосередньо надсилати запити до kubelet, відстежувати використання свопу та залишок своп-памʼяті під час використання LimitedSwap. Крім того, до cadvisor додано метрику machine_swap_bytes, яка показує загальну фізичну місткість свопу машини. Докладніше дивіться на цій сторінці.
Наприклад, підтримуються такі /metrics/resource:
node_swap_usage_bytes: поточне використання свопу вузлом у байтах.
container_swap_usage_bytes: поточне використання свопу контейнером у байтах.
container_swap_limit_bytes: поточне обмеження свопу контейнера в байтах.
Використання kubectl top --show-swap
Запити до метрик корисні, але дещо незручні, оскільки ці метрики призначені для програмного забезпечення, а не для людей. Щоб отримувати ці дані зручнішим способом, команду kubectl top розширено підтримкою метрик свопу через прапорець --show-swap.
Щоб отримати інформацію про використання свопу на вузлах, можна використовувати kubectl top nodes --show-swap:
Значення <unknown> вказує на те, що поле .status.nodeInfo.swap.capacity не встановлено для цього вузла. Імовірно, це означає, що на вузлі не налаштовано своп або, менш імовірно, що kubelet не може визначити місткість свопу вузла.
Виявлення свопу за допомогою Node Feature Discovery (NFD)
Node Feature Discovery — це надбудова Kubernetes для виявлення апаратних можливостей і конфігурації. Її можна використовувати, щоб виявити, на яких вузлах налаштовано своп.
Наприклад, щоб зʼясувати, на яких вузлах налаштовано своп, використайте таку команду:
kubectl get nodes -o jsonpath='{range .items[?(@.metadata.labels.feature\.node\.kubernetes\.io/memory-swap)]}{.metadata.name}{"\t"}{.metadata.labels.feature\.node\.kubernetes\.io/memory-swap}{"\n"}{end}'
У цьому прикладі своп налаштовано на вузлах k8s-worker1 та k8s-worker2, але не на k8s-worker3.
Ризики та застереження
Увага:
Настійно рекомендується шифрувати простір свопу. Докладніше дивіться в розділі томи в памʼяті.
Наявність свопу в системі знижує передбачуваність. Хоча своп може підвищити продуктивність, роблячи доступною більше оперативної памʼяті, повернення даних у памʼять є важкою операцією, іноді повільнішою на багато порядків, що може призвести до неочікуваного зниження продуктивності. Крім того, своп змінює поведінку системи під тиском на памʼять. Увімкнення свопу збільшує ризик галасливих сусідів, коли Podʼи, що часто використовують свою оперативну памʼять, можуть спричиняти витіснення інших Podʼів до свопу. Крім того, оскільки своп дозволяє робочим навантаженням у Kubernetes використовувати більше памʼяті, ніж можна передбачувано врахувати, а також через неочікувані конфігурації пакування, планувальник наразі не враховує використання своп-памʼяті. Це підвищує ризик галасливих сусідів.
Продуктивність вузла з увімкненою своп-памʼяттю залежить від фізичного сховища. Під час використання своп-памʼяті продуктивність буде значно гіршою в середовищі з обмеженою кількістю операцій вводу-виводу за секунду (IOPS), наприклад у хмарній віртуальній машині з тротлінгом вводу-виводу, порівняно зі швидшими носіями, такими як твердотільні накопичувачі або NVMe. Оскільки своп може спричиняти тиск на ввід-вивід, рекомендується надавати критично важливим системним демонам вищий пріоритет затримки вводу-виводу. Дивіться відповідний розділ у рекомендаціях нижче.
Томи в памʼяті
На вузлах Linux томи в памʼяті (такі як монтування томів secret або emptyDir з medium: Memory) реалізовано за допомогою файлової системи tmpfs. Вміст таких томів завжди має залишатися в памʼяті, тому його не слід витісняти на диск. Щоб вміст таких томів залишався в памʼяті, використовується параметр noswap для tmpfs.
Ядро Linux офіційно підтримує параметр noswap з версії 6.3 (докладніше дивіться у Вимогах до версії ядра Linux). Однак різні дистрибутиви часто переносять цей параметр монтування й у старіші версії Linux.
Щоб перевірити, чи підтримує вузол параметр noswap, kubelet виконує такі дії:
Якщо версія ядра вища за 6.3, вважається, що параметр noswap підтримується.
В іншому разі kubelet під час запуску спробує змонтувати фіктивний tmpfs з параметром noswap. Якщо kubelet отримає помилку, що вказує на невідомий параметр, вважатиметься, що noswap не підтримується, і його не буде використано. kubelet запише в лог запис, щоб попередити користувача, що томи в памʼяті можуть витіснятися на диск. Якщо kubelet виконає це успішно, фіктивний tmpfs буде видалено, а параметр noswap буде використано.
Якщо параметр noswap не підтримується, kubelet запише в лог попередження, а потім продовжить роботу.
Приклад налаштування свопу дивіться в розділі Налаштування своп-памʼяті на вузлах Kubernetes. Однак обробка зашифрованого свопу не входить до сфери відповідальності kubelet; це загальне питання конфігурації ОС, і його слід вирішувати на цьому рівні. Адміністратор відповідає за налаштування зашифрованого свопу, щоб зменшити цей ризик.
Виселення
Налаштування порогів виселення за памʼяттю для вузлів з увімкненим свопом може бути складним завданням.
Якщо своп вимкнено, доцільно налаштувати пороги виселення kubelet трохи нижче за місткість памʼяті вузла. Причина в тому, що Kubernetes має почати виселяти Podʼи до того, як на вузлі закінчиться памʼять і буде викликано OOM killer (Out Of Memory), оскільки OOM killer нічого не знає про Kubernetes, тому не враховує такі речі, як QoS, пріоритет Podʼів чи інші специфічні для Kubernetes чинники.
З увімкненим свопом ситуація складніша. У Linux параметр vm.min_free_kbytes визначає поріг памʼяті, за якого ядро починає агресивно вивільняти памʼять, зокрема витісняти сторінки до свопу. Якщо пороги виселення kubelet налаштовано так, що виселення відбувається раніше, ніж ядро почне вивільняти памʼять, робочі навантаження можуть ніколи не встигнути витіснити дані до свопу під час тиску на памʼять вузла. Однак занадто високі пороги виселення можуть призвести до вичерпання памʼяті на вузлі та виклику OOM killer, що теж не ідеально.
Щоб розвʼязати цю проблему, рекомендується встановлювати пороги виселення kubelet трохи нижчими за значення vm.min_free_kbytes. Так вузол може почати використовувати своп до того, як kubelet почне виселяти Podʼи, що дозволяє робочим навантаженням витісняти невикористовувані дані до свопу й запобігає виселенню. З іншого боку, оскільки значення лише трохи нижче, kubelet, імовірно, почне виселяти Podʼи до того, як на вузлі закінчиться памʼять, тим самим уникаючи OOM killer.
Значення vm.min_free_kbytes можна визначити, виконавши на вузлі таку команду:
cat /proc/sys/vm/min_free_kbytes
Невикористаний простір свопу
У режимі LimitedSwap обсяг свопу, доступний для Podʼа, визначається автоматично на основі частки запитаної памʼяті відносно загальної памʼяті вузла (докладніше дивіться розділ нижче).
Така архітектура означає, що зазвичай певна частина свопу залишатиметься недоступною для робочих навантажень Kubernetes. Наприклад, оскільки Kubernetes 1.37 не дозволяє використовувати своп Podʼам із класом QoS Guaranteed, обсяг свопу, пропорційний запиту памʼяті Podʼів Guaranteed, залишатиметься невикористаним робочими навантаженнями Kubernetes.
Така поведінка несе певний ризик у ситуації, коли багато Podʼів не мають права на своп. З іншого боку, вона фактично зберігає певний зарезервований системою обсяг своп-памʼяті, який можуть використовувати процеси поза межами Kubernetes, такі як системні демони й навіть сам kubelet.
Рекомендації щодо використання свопу в кластері Kubernetes
Вимкнення свопу для критично важливих системних демонів
Під час тестування та на основі відгуків користувачів було помічено, що продуктивність критично важливих системних демонів і сервісів може знижуватися. Це означає, що системні демони, зокрема kubelet, можуть працювати повільніше, ніж зазвичай. Якщо ви зіткнулися з цією проблемою, рекомендується налаштувати cgroup для system slice так, щоб запобігти свопінгу (тобто встановити memory.swap.max=0).
Захист критично важливих системних демонів від затримок вводу-виводу
Своп може збільшити навантаження вводу-виводу на вузлі. Коли тиск на памʼять змушує ядро швидко витісняти сторінки до свопу й повертати їх, критично важливі системні демони й сервіси, що покладаються на операції вводу-виводу, можуть зазнати зниження продуктивності.
Щоб помʼякшити це, користувачам systemd рекомендується надавати пріоритет system slice щодо затримки вводу-виводу. Користувачам без systemd рекомендується налаштувати окрему cgroup для системних демонів і процесів та так само надати їй пріоритет щодо затримки вводу-виводу. Цього можна досягти, встановивши io.latency для system slice, що надає йому вищий пріоритет вводу-виводу. Докладніше дивіться в документації cgroup.
Своп та вузли панелі управління
Проєкт Kubernetes рекомендує запускати вузли панелі управління без налаштованого простору свопу. Панель управління переважно розміщує Podʼи з класом QoS Guaranteed, тому своп зазвичай можна вимкнути. Основна проблема полягає в тому, що свопінг критично важливих сервісів на панелі управління може негативно вплинути на продуктивність.
Використання виділеного диска для свопу
Проєкт Kubernetes рекомендує використовувати зашифрований своп щоразу, коли ви запускаєте вузли з увімкненим свопом. Якщо своп розташований на розділі або в кореневій файловій системі, робочі навантаження можуть заважати системним процесам, яким потрібно записувати на диск. Коли вони використовують той самий диск, процеси можуть перевантажити своп, порушуючи ввід-вивід kubelet, середовища виконання контейнерів і systemd, що вплине на інші робочі навантаження. Оскільки простір свопу розташований на диску, важливо переконатися, що диск достатньо швидкий для запланованих сценаріїв. Альтернативно можна налаштувати пріоритети вводу-виводу між різними відображеними областями одного пристрою зберігання.
Планування з урахуванням свопу
Kubernetes 1.37 не підтримує розподіл Podʼів по вузлах з урахуванням використання своп-памʼяті. Планувальник зазвичай використовує запити ресурсів інфраструктури для вибору розміщення Podʼів, а Podʼи не запитують простір свопу; вони запитують лише memory. Це означає, що планувальник не враховує своп-памʼять під час прийняття рішень щодо планування. Хоча ми активно працюємо над цим, це ще не реалізовано.
Щоб Podʼи не планувалися на вузли зі своп-памʼяттю, якщо вони спеціально не призначені для її використання, адміністратори можуть додати taints на вузли з доступним свопом і так захиститися від цієї проблеми. Taints гарантують, що робочі навантаження, які допускають своп, не перетікатимуть під навантаженням на вузли без свопу.
Вибір сховища для оптимальної продуктивності
Пристрій зберігання, призначений для простору свопу, критично важливий для збереження чутливості системи під час високого використання памʼяті. Обертові жорсткі диски (HDD) погано підходять для цього, оскільки їх механічна природа вносить значну затримку, що призводить до серйозного зниження продуктивності та пробуксовування системи (thrashing). Для сучасних вимог до продуктивності, ймовірно, відповідним вибором для свопу є такий пристрій, як твердотільний накопичувач (SSD), оскільки його електронний доступ із низькою затримкою мінімізує сповільнення.
Подробиці поведінки свопу
Як визначається обмеження свопу для LimitedSwap?
Конфігурація своп-памʼяті, зокрема її обмежень, є значним викликом. Її не лише легко налаштувати неправильно, але й, оскільки це властивість рівня системи, будь-яке неправильне налаштування може поставити під загрозу весь вузол, а не лише конкретне робоче навантаження. Щоб зменшити цей ризик і забезпечити справність вузла, ми реалізували своп з автоматичною конфігурацією обмежень.
З LimitedSwap Podʼам, які не належать до класу QoS Burstable (тобто Podʼам із класом QoS BestEffort/Guaranteed), заборонено використовувати своп-памʼять. Podʼи з класом QoS BestEffort мають непередбачувані шаблони споживання памʼяті, а інформації про використання ними памʼяті немає, тому важко визначити безпечний обсяг своп-памʼяті. Натомість Podʼи з класом QoS Guaranteed зазвичай використовують для застосунків, які покладаються на точне виділення ресурсів, заданих робочим навантаженням, і на негайну доступність памʼяті. Щоб зберегти згадані вище гарантії безпеки та справності вузла, цим Podʼам не дозволено використовувати своп-памʼять, коли діє LimitedSwap. Крім того, високопріоритетним Podʼам не дозволено використовувати своп, щоб памʼять, яку вони споживають, завжди перебувала в RAM і була готова до використання.
Перш ніж докладно описати обчислення обмеження свопу, потрібно визначити такі терміни:
nodeTotalMemory: загальний обсяг фізичної памʼяті, доступної на вузлі.
totalPodsSwapAvailable: загальний обсяг своп-памʼяті на вузлі, доступний для використання Podʼами (частину своп-памʼяті може бути зарезервовано для потреб системи).
Іншими словами, обсяг свопу, який може використовувати контейнер, пропорційний його запиту памʼяті, загальній фізичній памʼяті вузла та загальному обсягу своп-памʼяті на вузлі, доступному для використання Podʼами.
Важливо зазначити, що для контейнерів у Podʼах із класом QoS Burstable можна відмовитися від використання свопу, вказавши запити памʼяті, що дорівнюють обмеженням памʼяті. Контейнери, налаштовані таким чином, не матимуть доступу до своп-памʼяті.
Довідкову інформацію дивіться в початковому KEP, KEP-2400, та його дизайні.
6.12.3 - Автомасштабування вузлів
Автоматично надавайте та консолідуйте вузли у вашому кластері, щоб адаптуватися до попиту та оптимізувати витрати.
Щоб запускати робочі навантаження у вашому кластері, вам потрібні вузли. Вузли у вашому кластері можуть автомасштабуватися, тобто динамічно надаватися або консолідуватися, щоб забезпечувати потрібну місткість і водночас оптимізувати витрати. Автомасштабування виконують автомасштабувальники вузлів.
Автомасштабувальники надають вузли, створюючи та видаляючи ресурси хмарного провайдера, на яких ті працюють. Найчастіше такими ресурсами є віртуальні машини.
Головна мета надання вузлів — зробити всі Podʼи придатними для планування. Цієї мети не завжди можна досягти через різні обмеження, зокрема досягнення налаштованих обмежень надання, несумісність конфігурації надання з певним набором Podʼів або брак місткості хмарного провайдера. Під час надання автомасштабувальники вузлів часто намагаються досягти додаткових цілей (наприклад, мінімізувати вартість наданих вузлів або збалансувати кількість вузлів між доменами відмов).
Конфігурація автомасштабувальника може також містити інші тригери надання вузлів (наприклад, падіння кількості вузлів нижче налаштованої мінімальної межі).
Примітка:
Раніше надання було відоме в Cluster Autoscaler як масштабування вгору (scale-up).
Обмеження планування Podʼів
Podʼи можуть задавати обмеження планування, щоб обмежити види вузлів, на яких їх можна запланувати. Автомасштабувальники вузлів враховують ці обмеження, щоб Podʼи в очікуванні можна було запланувати на наданих вузлах.
Найпоширеніший вид обмежень планування — це запити ресурсів, задані контейнерами Podʼів. Автомасштабувальники подбають про те, щоб надані вузли мали достатньо ресурсів для задоволення цих запитів. Однак вони не враховують безпосередньо реальне використання ресурсів Podʼами після їх запуску. Щоб автомасштабувати вузли на основі фактичного використання ресурсів робочими навантаженнями, ви можете поєднати горизонтальне автомасштабування робочих навантажень з автомасштабуванням вузлів.
Обмеження вузлів, що накладаються конфігурацією автомасштабувальника
Характеристики наданих вузлів (наприклад, кількість ресурсів, наявність певної мітки) залежать від конфігурації автомасштабувальника. Автомасштабувальники можуть або вибирати їх із заздалегідь визначеного набору конфігурацій вузлів, або використовувати автоматичне надання.
Автоматичне надання
Автоматичне надання вузлів — це режим надання, у якому користувачеві не потрібно повністю налаштовувати характеристики вузлів, які можуть бути надані. Натомість автомасштабувальник динамічно вибирає конфігурацію вузла на основі Podʼів в очікуванні, на які він реагує, а також попередньо налаштованих обмежень (наприклад, мінімальної кількості ресурсів або потреби в певній мітці).
Консолідація вузлів
Під час роботи кластера головне — щоб усі придатні для планування Podʼи працювали, а вартість кластера залишалася якомога нижчою. Для цього запити ресурсів Podʼів мають використовувати якомога більше ресурсів вузлів. З цього погляду загальне використання вузлів у кластері може слугувати непрямим показником того, наскільки економічно ефективним є кластер.
Примітка:
Правильне налаштування запитів ресурсів ваших Podʼів так само важливе для загальної економічної ефективності кластера, як і оптимізація використання вузлів. Досягти цього допоможе поєднання автомасштабування вузлів з вертикальним автомасштабуванням робочих навантажень.
Вузли у вашому кластері можна автоматично консолідувати, щоб покращити загальне використання вузлів, а отже, й економічну ефективність кластера. Консолідація відбувається через видалення з кластера набору недовикористаних вузлів. За потреби для їх заміни можна надати інший набір вузлів.
Консолідація, як і надання, під час прийняття рішень враховує лише запити ресурсів Podʼів, а не реальне використання ресурсів.
Для цілей консолідації вузол вважається порожнім, якщо на ньому працюють лише Podʼи DaemonSet і статичні Podʼи. Видаляти порожні вузли під час консолідації простіше, ніж непорожні, і автомасштабувальники часто мають оптимізації, створені спеціально для консолідації порожніх вузлів.
Видалення непорожніх вузлів під час консолідації спричиняє порушення — Podʼи, що працюють на них, завершуються, і, можливо, їх доведеться створити заново (наприклад, через Deployment). Однак усі такі перестворені Podʼи мають плануватися на наявні вузли кластера або на вузли-замінники, надані в межах консолідації. Зазвичай жоден Pod не повинен переходити в стан очікування внаслідок консолідації.
Примітка:
Автомасштабувальники передбачають, як перестворений Pod імовірно буде заплановано після надання або консолідації вузла, але вони не контролюють фактичне планування. Через це деякі Podʼи можуть перейти в стан очікування внаслідок консолідації — наприклад, якщо під час консолідації зʼявляється абсолютно новий Pod.
Конфігурація автомасштабувальника може також дозволяти запускати консолідацію за іншими умовами (наприклад, за часом, що минув від створення вузла), щоб оптимізувати інші властивості (наприклад, максимальну тривалість життя вузлів у кластері).
Подробиці виконання консолідації залежать від конфігурації конкретного автомасштабувальника.
Примітка:
Раніше консолідація була відома в Cluster Autoscaler як зменшення масштабу (scale-down).
Автомасштабувальники
Можливості, описані в попередніх розділах, надають автомасштабувальники вузлів. Окрім API Kubernetes, автомасштабувальники також мають взаємодіяти з API хмарних провайдерів, щоб надавати та консолідувати вузли. Це означає, що вони мають бути явно інтегровані з кожним підтримуваним хмарним провайдером. Продуктивність і набір можливостей певного автомасштабувальника можуть відрізнятися залежно від інтеграції з хмарним провайдером.
graph TD
na[Автомасштабувальник вузлів]
k8s[Kubernetes]
cp[Хмарний провайдер]
k8s --> |отримання Podʼів/вузлів|na
na --> |drain вузлів|k8s
na --> |створення/видалення ресурсів вузлів|cp
cp --> |отримання ресурсів вузлів|na
classDef white_on_blue fill:#326ce5,stroke:#fff,stroke-width:4px,color:#fff;
classDef blue_on_white fill:#fff,stroke:#bbb,stroke-width:2px,color:#326ce5;
class na blue_on_white;
class k8s,cp white_on_blue;
З погляду користувача кластера обидва автомасштабувальники мають забезпечувати схожий досвід автомасштабування вузлів. Обидва надаватимуть нові вузли для Podʼів, які неможливо запланувати, і обидва консолідуватимуть вузли, які більше не використовуються оптимально.
Різні автомасштабувальники можуть також надавати можливості, що виходять за межі описаного на цій сторінці автомасштабування вузлів, і ці додаткові можливості можуть у них відрізнятися.
Ознайомтеся з розділами нижче та документацією окремих автомасштабувальників за посиланнями, щоб вирішити, який із них краще підходить для вашого сценарію.
Cluster Autoscaler
Cluster Autoscaler додає вузли до попередньо налаштованих груп вузлів або видаляє їх звідти. Групи вузлів зазвичай відповідають певній групі ресурсів хмарного провайдера (найчастіше групі віртуальних машин). Один екземпляр Cluster Autoscaler може одночасно керувати кількома групами вузлів. Під час надання Cluster Autoscaler додає вузли до тієї групи, яка найкраще відповідає запитам Podʼів в очікуванні. Під час консолідації Cluster Autoscaler завжди вибирає конкретні вузли для видалення, а не просто змінює розмір базової групи ресурсів хмарного провайдера.
Karpenter автоматично надає вузли на основі конфігурацій NodePool, заданих оператором кластера. Karpenter керує всіма аспектами життєвого циклу вузла, а не лише автомасштабуванням. Це, зокрема, автоматична заміна вузлів, коли вони досягають певного віку, та автоматичне оновлення вузлів, коли випускаються нові образи робочих вузлів. Він працює безпосередньо з окремими ресурсами хмарного провайдера (найчастіше окремими віртуальними машинами) і не покладається на групи ресурсів хмарного провайдера.
Основні відмінності між Cluster Autoscaler та Karpenter:
Cluster Autoscaler надає можливості, повʼязані лише з автомасштабуванням вузлів. Karpenter має ширшу сферу застосування й надає також можливості для керування всім життєвим циклом вузлів (наприклад, використання порушень для автоматичного перестворення вузлів, коли вони досягають певного віку, або їх автоматичного оновлення до нових версій).
Cluster Autoscaler не підтримує автоматичне надання: групи вузлів, з яких він може надавати вузли, мають бути попередньо налаштовані. Karpenter підтримує автоматичне надання, тому користувачеві потрібно лише налаштувати набір обмежень для наданих вузлів, а не повністю налаштовувати однорідні групи.
Cluster Autoscaler надає інтеграції з хмарними провайдерами безпосередньо, тобто вони є частиною проєкту Kubernetes. Для Karpenter проєкт Kubernetes публікує Karpenter як бібліотеку, з якою хмарні провайдери можуть інтегруватися для створення автомасштабувальника вузлів.
Cluster Autoscaler надає інтеграції з багатьма хмарними провайдерами, зокрема з невеликими й менш популярними. З Karpenter інтегрується менше хмарних провайдерів, зокрема AWS та Azure.
Поєднання автомасштабування робочих навантажень і вузлів
Горизонтальне автомасштабування робочих навантажень
Автомасштабування вузлів зазвичай працює у відповідь на Podʼи — воно надає нові вузли для розміщення Podʼів, які неможливо запланувати, а потім консолідує вузли, коли вони більше не потрібні.
Горизонтальне автомасштабування робочих навантажень автоматично масштабує кількість реплік робочого навантаження, щоб підтримувати бажане середнє використання ресурсів у репліках. Іншими словами, воно автоматично створює нові Podʼи у відповідь на навантаження застосунку, а потім видаляє їх, коли навантаження зменшується.
Ви можете використовувати автомасштабування вузлів разом із горизонтальним автомасштабуванням робочих навантажень, щоб автомасштабувати вузли у вашому кластері на основі середнього реального використання ресурсів ваших Podʼів.
Якщо навантаження застосунку зростає, середнє використання його Podʼів також має зростати, що спонукає автомасштабування робочого навантаження створити нові Podʼи. Автомасштабування вузлів має надати нові вузли для розміщення нових Podʼів.
Коли навантаження застосунку зменшується, автомасштабування робочого навантаження має видалити непотрібні Podʼи. Автомасштабування вузлів, у свою чергу, має консолідувати вузли, які більше не потрібні.
За правильного налаштування цей шаблон гарантує, що ваш застосунок завжди матиме місткість вузлів для обробки сплесків навантаження, коли це потрібно, але вам не доведеться платити за місткість, коли вона не потрібна.
Вертикальне автомасштабування робочих навантажень
Під час використання автомасштабування вузлів важливо правильно встановлювати запити ресурсів Podʼів. Якщо запити певного Podʼа занадто низькі, надання для нього нового вузла може не допомогти йому реально запуститися. Якщо запити певного Podʼа занадто високі, це може помилково перешкоджати консолідації його вузла.
Ви можете використовувати автомасштабування вузлів разом із вертикальним автомасштабуванням робочих навантажень, щоб коригувати запити ресурсів ваших Podʼів, зберігаючи можливості автомасштабування вузлів у кластері.
Увага:
Під час використання автомасштабування вузлів не рекомендується налаштовувати вертикальне автомасштабування робочих навантажень для Podʼів DaemonSet. Автомасштабувальники мають передбачати, якими будуть Podʼи DaemonSet на новому вузлі, щоб прогнозувати доступні ресурси вузла. Вертикальне автомасштабування робочих навантажень може зробити ці прогнози ненадійними, що призведе до неправильних рішень щодо масштабування.
Супутні компоненти
У цьому розділі описано компоненти, що надають можливості, повʼязані з автомасштабуванням вузлів.
Descheduler
Descheduler — це компонент, що надає консолідацію вузлів на основі власних політик, а також інші можливості, повʼязані з оптимізацією вузлів і Podʼів (наприклад, видалення Podʼів, що часто перезапускаються).
Автомасштабувальники робочих навантажень на основі розміру кластера
Щоб дізнатися, як генерувати сертифікати для свого кластера, дивіться Сертифікати.
6.12.5 - Мережа в кластері
Мережа — центральна частина Kubernetes, але буває складно зрозуміти, як саме вона має працювати. Потрібно розвʼязати 4 окремі мережеві проблеми:
Взаємодія тісно повʼязаних контейнерів: цю проблему розвʼязують Podʼи та взаємодія через localhost.
Взаємодія між Podʼами: це основна тема цього документа.
Взаємодія Podʼів із Service: це описано на сторінці Services.
Взаємодія із Service ззовні: це також описано на сторінці Services.
Kubernetes — це система розподілу машин між застосунками. Зазвичай для розподілу машин потрібно переконатися, що два застосунки не намагаються використовувати одні й ті самі порти. Координувати порти між багатьма розробниками у великому масштабі дуже складно, і це наражає користувачів на проблеми на рівні кластера, які вони не можуть контролювати.
Динамічне призначення портів дуже ускладнює систему — кожен застосунок має приймати порти як прапорці, API-сервери мають уміти вставляти динамічні номери портів у блоки конфігурації, сервіси мають знати, як знаходити один одного, тощо. Щоб не мати з цим справи, Kubernetes обирає інший підхід.
Кластери Kubernetes потребують виділення IP-адрес, які не перекриваються, для Podʼів, Services та вузлів з діапазону доступних адрес, налаштованого в таких компонентах:
Мережевий втулок налаштований на призначення IP-адрес Podʼам.
kube-apiserver налаштований на призначення IP-адрес Services.
kubelet або cloud-controller-manager налаштовані на призначення IP-адрес вузлам.
Типи мереж у кластері
Залежно від налаштованих сімейств IP, кластери Kubernetes можна поділити на такі категорії:
Лише IPv4: мережевий втулок, kube-apiserver та kubelet/cloud-controller-manager налаштовані на призначення лише IPv4-адрес.
Лише IPv6: мережевий втулок, kube-apiserver та kubelet/cloud-controller-manager налаштовані на призначення лише IPv6-адрес.
Мережевий втулок налаштований на призначення адрес IPv4 та IPv6.
kube-apiserver налаштований на призначення адрес IPv4 та IPv6.
kubelet або cloud-controller-manager налаштовані на призначення адрес IPv4 та IPv6.
Усі компоненти мають бути узгоджені щодо налаштованого основного сімейства IP.
Кластери Kubernetes враховують лише сімейства IP, присутні в обʼєктах Pod, Service та Node, незалежно від наявних IP-адрес представлених обʼєктів. Наприклад, сервер або Pod може мати кілька IP-адрес, призначених його інтерфейсам, але під час реалізації мережевої моделі Kubernetes і визначення типу кластера враховуються лише IP-адреси в node.status.addresses або pod.status.ips.
Як реалізувати мережеву модель Kubernetes
Мережеву модель реалізує середовище виконання контейнерів на кожному вузлі. Найпоширеніші середовища виконання контейнерів використовують втулки Container Network Interface (CNI) для керування своїми мережевими можливостями та можливостями безпеки. Існує багато різних CNI-втулків від різних постачальників. Деякі з них надають лише базові можливості додавання та видалення мережевих інтерфейсів, тоді як інші пропонують складніші рішення, такі як інтеграція з іншими системами оркестрування контейнерів, запуск кількох CNI-втулків, розширені можливості IPAM тощо.
Неповний перелік мережевих надбудов, які підтримує Kubernetes, дивіться на цій сторінці.
Що далі
Ранній дизайн мережевої моделі та її обґрунтування докладніше описані в документі дизайну мережі. Про майбутні плани та поточну роботу над поліпшенням мережевих можливостей Kubernetes дивіться в KEPs SIG-Network.
6.12.6 - Спостережуваність
Дізнайтеся, як отримати наскрізну видимість кластера Kubernetes завдяки збору метрик, логів і трейсів.
У Kubernetes спостережуваність — це процес збору та аналізу метрик, логів і трейсів (їх часто називають трьома стовпами спостережуваності), щоб краще зрозуміти внутрішній стан, продуктивність і справність кластера.
Компоненти панелі управління Kubernetes, а також багато надбудов генерують і надсилають ці сигнали. Обʼєднуючи та корелюючи їх, ви можете отримати єдину картину панелі управління, надбудов і застосунків у всьому кластері.
На схемі 1 показано, як компоненти кластера надсилають три основні типи сигналів.
flowchart LR
A[Компоненти кластера] --> M[Конвеєр метрик]
A --> L[Конвеєр логів]
A --> T[Конвеєр трейсів]
M --> S[(Зберігання та аналіз)]
L --> S
T --> S
S --> O[Оператори та автоматизація]
Схема 1. Високорівневі сигнали, які надсилають компоненти кластера, та їх споживачі.
Метрики
Компоненти Kubernetes надають метрики у форматі Prometheus через свої точки доступу /metrics, зокрема:
kube-controller-manager
kube-proxy
kube-apiserver
kube-scheduler
kubelet
kubelet також надає метрики через /metrics/cadvisor, /metrics/resource та /metrics/probes, а надбудови, такі як kube-state-metrics, доповнюють ці сигнали панелі управління статусом обʼєктів Kubernetes.
Типовий конвеєр метрик Kubernetes періодично опитує ці точки доступу та зберігає отримані зразки в базі даних часових рядів (наприклад, у Prometheus).
API метрик Kubernetes надає дані про використання CPU та памʼяті вузлами та Podʼами. Команда kubectl top та такі компоненти, як HorizontalPodAutoscaler і VerticalPodAutoscaler, використовують цей API.
kubectl top підтримує як metrics.k8s.io/v1, так і metrics.k8s.io/v1beta1. Він надає перевагу v1, коли ця версія доступна, і повертається до v1beta1. У Kubernetes v1.37 контролер HorizontalPodAutoscaler підтримує лише metrics.k8s.io/v1beta1; підтримка metrics.k8s.io/v1 запланована, але ще недоступна.
На відміну від точок доступу метрик компонентів, описаних раніше, API метрик обслуговується через шар агрегації API Kubernetes. У вашому кластері має працювати Metrics Server або інша реалізація цього API. API метрик навмисно надає лише метрики ресурсів, потрібні для автомасштабування та базової перевірки; він не замінює повноцінний конвеєр моніторингу.
Щоб дізнатися про API, його реалізації та потік даних від kubelet до його клієнтів, дивіться конвеєр метрик ресурсів.
Логи містять хронологічні записи подій усередині застосунків, системних компонентів Kubernetes та дій, повʼязаних із безпекою, таких як логування аудиту.
Середовища виконання контейнерів отримують вивід контейнеризованого застосунку з потоків стандартного виводу (stdout) та стандартного виводу помилок (stderr). Хоча середовища виконання реалізують це по-різному, інтеграцію з kubelet стандартизовано через формат логування CRI, а kubelet робить ці логи доступними через kubectl logs.
Схема 3a. Архітектура логування на рівні вузла.
Логи системних компонентів фіксують події в кластері й часто корисні для налагодження та усунення несправностей. Ці компоненти поділяються на два види: ті, що працюють у контейнері, і ті, що працюють поза ним. Наприклад, kube-scheduler і kube-proxy зазвичай працюють у контейнерах, тоді як kubelet і середовище виконання контейнерів працюють безпосередньо на хості.
На машинах із systemd kubelet і середовище виконання контейнерів пишуть у journald. В іншому разі вони пишуть у файли .log у теці /var/log.
Системні компоненти, що працюють у контейнерах, завжди пишуть у файли .log у /var/log, оминаючи стандартний механізм логування контейнерів.
Логи системних компонентів і контейнерів, що зберігаються в /var/log, потребують ротації, щоб запобігти неконтрольованому зростанню. Деякі сценарії розгортання кластерів стандартно встановлюють ротацію логів; перевірте своє середовище та за потреби змініть налаштування. Докладніше про розташування, формати та параметри конфігурації дивіться в довідці щодо системних логів.
Більшість кластерів запускають агент логування на рівні вузла (наприклад, Fluent Bit або Fluentd), який стежить за цими файлами та пересилає записи до центрального сховища логів. У посібнику з архітектури логування пояснюється, як проєктувати такі конвеєри, налаштовувати термін зберігання та спрямовувати потоки логів до бекендів.
На схемі 3 показано типовий конвеєр агрегації логів.
flowchart LR
subgraph Джерела
A[Вивід застосунку в stdout / stderr]
B[Логи панелі управління]
C[Записи аудиту]
end
A --> N[Агент логування на рівні вузла]
B --> N
C --> N
N --> L[Центральне сховище логів]
L --> Q[Dashboards, сповіщення, SIEM]
Трейси фіксують, як запити проходять через компоненти та застосунки Kubernetes, повʼязуючи затримки, час і взаємозвʼязки між операціями. Збираючи трейси, ви можете візуалізувати проходження запиту від початку до кінця, діагностувати проблеми з продуктивністю та виявляти вузькі місця або несподівані взаємодії в панелі управління, надбудовах чи застосунках.
Kubernetes 1.37 може експортувати відрізки (spans) через OpenTelemetry Protocol (OTLP) — або безпосередньо через вбудовані експортери gRPC, або пересилаючи їх через OpenTelemetry Collector.
OpenTelemetry Collector отримує відрізки від компонентів і застосунків, обробляє їх (наприклад, застосовуючи відбір або редагування) і пересилає до бекенду трасування для зберігання та аналізу.
На схемі 4 показано типовий конвеєр розподіленого трасування.
flowchart LR
subgraph Джерела
A[Відрізки панелі управління]
B[Відрізки застосунків]
end
A --> X[OTLP exporter]
B --> X
X --> COL[OpenTelemetry Collector]
COL --> TS[(Бекенд трасування)]
TS --> V[Візуалізація та аналіз]
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Примітка: цей розділ містить посилання на сторонні проєкти, які надають можливості спостережуваності, потрібні для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти, які перелічені в алфавітному порядку. Щоб додати проєкт до цього списку, перед внесенням змін прочитайте посібник зі вмісту.
Інструменти метрик
Cortex пропонує горизонтально масштабоване, довгострокове сховище Prometheus.
Grafana Mimir — проєкт Grafana Labs, який надає багатоорендне, горизонтально масштабоване сховище, сумісне з Prometheus.
Prometheus — це система моніторингу, яка збирає та зберігає метрики з компонентів Kubernetes.
Thanos розширює Prometheus глобальними запитами, проріджуванням даних (downsampling) та підтримкою обʼєктного сховища.
Інструменти логування
Elasticsearch забезпечує розподілене індексування логів та пошук у них.
Fluent Bit збирає та пересилає логи контейнерів і вузлів із низьким споживанням ресурсів.
Fluentd маршрутизує та перетворює логи, надсилаючи їх до кількох місць призначення.
Grafana Loki зберігає логи у форматі на основі міток, натхненному Prometheus.
OpenSearch надає індексування логів і пошук із відкритим кодом, сумісні з API Elasticsearch.
Інструменти трасування
Grafana Tempo пропонує масштабоване та недороге сховище розподілених трейсів.
Jaeger збирає та візуалізує розподілені трейси для мікросервісів.
Логи застосунків можуть допомогти вам зрозуміти, що відбувається всередині застосунку. Логи особливо корисні для налагодження проблем і моніторингу активності кластера. Більшість сучасних застосунків мають певний механізм логування. Так само рушії контейнерів розроблені з підтримкою логування. Найпростіший і найпоширеніший метод логування для контейнеризованих застосунків — запис у стандартні потоки виводу та помилок.
Однак вбудованих можливостей рушія контейнерів або середовища виконання зазвичай недостатньо для повноцінного рішення для логування.
Наприклад, вам може знадобитися доступ до логів застосунку, якщо контейнер зазнає збою, Pod буде виселено або вузол вийде з ладу.
У кластері логи повинні мати окреме сховище та життєвий цикл, незалежний від вузлів, Podʼів чи контейнерів. Ця концепція називається логуванням на рівні кластера.
Архітектури логування на рівні кластера потребують окремого бекенду для зберігання, аналізу та запитів до логів. Kubernetes не надає власного рішення для зберігання логів. Натомість існує багато рішень для логування, які інтегруються з Kubernetes. У наведених нижче розділах описано, як обробляти та зберігати логи на вузлах.
Логи Podʼів та контейнерів
Kubernetes збирає логи з кожного контейнера в запущеному Podʼі.
У цьому прикладі використовується маніфест Pod з контейнером, який раз на секунду записує текст у стандартний потік виводу.
Для отримання логів використовуйте команду kubectl logs, як показано нижче:
kubectl logs counter
Вивід буде схожим на:
0: Fri Apr 1 11:42:23 UTC 2022
1: Fri Apr 1 11:42:24 UTC 2022
2: Fri Apr 1 11:42:25 UTC 2022
Ви можете використовувати kubectl logs --previous для отримання логів з попереднього запуску контейнера. Якщо ваш Pod має кілька контейнерів, вкажіть, логи якого контейнера ви хочете переглянути, додавши назву контейнера до команди з прапорцем -c, ось так:
kubectl logs counter -c count
Потоки логів контейнерів
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.32; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the PodLogsQuerySplitStreams feature gate for all relevant components in your cluster.
Як альфа-можливість, kubelet може розділяти логи двох стандартних потоків, які створює контейнер: стандартного виводу та стандартного потоку помилок. Щоб скористатися цією поведінкою, потрібно ввімкнути функціональну можливість PodLogsQuerySplitStreams. З увімкненою функціональною можливістю Kubernetes 1.37 надає доступ до цих потоків логів безпосередньо через Pod API. Ви можете отримати конкретний потік, вказавши його назву (Stdout або Stderr) за допомогою рядка запиту stream. Ви повинні мати доступ на читання субресурсу log цього Podʼа.
Щоб продемонструвати цю можливість, ви можете створити Pod, який періодично записуватиме текст як до стандартного потоку виводу, так і до потоку помилок.
Середовище виконання контейнерів обробляє та перенаправляє весь вивід у потоки stdout та stderr контейнеризованого застосунку. Різні середовища виконання контейнерів реалізують це по-різному; однак інтеграцію з kubelet стандартизовано як формат логування CRI.
Стандартно, якщо контейнер перезапускається, kubelet зберігає один завершений контейнер з його логами. Якщо Pod виселяється з вузла, усі відповідні контейнери також виселяються разом зі своїми логами.
kubelet надає клієнтам доступ до логів через спеціальну можливість API Kubernetes. Зазвичай доступ до неї здійснюється за допомогою команди kubectl logs.
Ротація логів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.21
kubelet відповідає за ротацію логів контейнерів і керування структурою тек логів. kubelet передає цю інформацію середовищу виконання контейнерів (через CRI), а середовище виконання записує логи контейнерів у вказане місце.
Ви можете налаштувати два параметри конфігурації kubelet, containerLogMaxSize (стандартно 10Mi) та containerLogMaxFiles (стандартно 5), за допомогою файлу конфігурації kubelet. Ці параметри дозволяють налаштувати максимальний розмір кожного файлу логу та максимальну кількість файлів для кожного контейнера відповідно.
Для ефективної ротації логів у кластерах, де робочі навантаження генерують великий обсяг логів, kubelet також надає механізм налаштування ротації: кількості одночасних ротацій логів та інтервалу, з яким логи відстежуються й за потреби ротуються. Ви можете налаштувати два параметри конфігурації kubelet, containerLogMaxWorkers та containerLogMonitorInterval, за допомогою файлу конфігурації kubelet.
Коли ви виконуєте kubectl logs, як у прикладі базового логування, kubelet на вузлі обробляє запит і читає безпосередньо з файлу логу. kubelet повертає вміст файлу логу.
Примітка:
Через kubectl logs доступний лише вміст останнього файлу логу.
Наприклад, якщо Pod пише 40 MiB логів і kubelet ротує логи після 10 MiB, виконання kubectl logs поверне максимум 10MiB даних.
Логи системних компонентів
Є два види системних компонентів: ті, що зазвичай працюють у контейнері, і ті, що безпосередньо беруть участь у запуску контейнерів. Наприклад:
kubelet і середовище виконання контейнерів не працюють у контейнерах. kubelet запускає ваші контейнери (згруповані в Podʼи).
Планувальник Kubernetes, менеджер контролерів та API-сервер працюють у Podʼах (зазвичай статичних Podʼах). Компонент etcd працює в панелі управління, найчастіше також як статичний Pod. Якщо ваш кластер використовує kube-proxy, зазвичай його запускають як DaemonSet.
Розташування логів
Те, як kubelet і середовище виконання контейнерів записують логи, залежить від операційної системи вузла:
На вузлах Linux, які використовують systemd, kubelet і середовище виконання контейнерів стандартно пишуть у journald. Для читання журналу systemd використовуйте journalctl; наприклад: journalctl -u kubelet.
Якщо systemd немає, kubelet і середовище виконання контейнерів пишуть у файли .log у теці /var/log. Якщо ви хочете, щоб логи записувалися в інше місце, можна запускати kubelet опосередковано через допоміжний інструмент kube-log-runner і за допомогою нього перенаправляти логи kubelet у вибрану вами теку.
Стандартно kubelet вказує середовищу виконання контейнерів записувати логи в теки всередині /var/log/pods.
Стандартно kubelet записує логи у файли всередині теки C:\var\logs (зверніть увагу, що це не C:\var\log).
Хоча C:\var\log є стандартним розташуванням цих логів у Kubernetes, деякі інструменти розгортання кластера налаштовують вузли Windows так, щоб логи записувалися в C:\var\log\kubelet.
Якщо ви хочете, щоб логи записувалися в інше місце, можна запускати kubelet опосередковано через допоміжний інструмент kube-log-runner і за допомогою нього перенаправляти логи kubelet у вибрану вами теку.
Однак стандартно kubelet вказує середовищу виконання контейнерів записувати логи в теку C:\var\log\pods.
Компоненти кластера Kubernetes, які працюють у Podʼах, пишуть у файли всередині теки /var/log, оминаючи стандартний механізм логування (ці компоненти не пишуть у журнал systemd). Ви можете використовувати механізми сховища Kubernetes, щоб підключити постійне сховище до контейнера, у якому працює компонент.
kubelet дозволяє змінити теку логів Podʼів зі стандартної /var/log/pods на власний шлях. Це можна зробити за допомогою параметра podLogsDir у файлі конфігурації kubelet.
Увага:
Важливо зазначити, що стандартне розташування /var/log/pods використовувалося протягом тривалого часу, і певні процеси можуть неявно використовувати цей шлях. Тому до зміни цього параметра слід підходити з обережністю і на власний ризик.
Ще одне застереження: kubelet підтримує розташування на тому самому диску, що й /var. В іншому разі, якщо логи розташовані в окремій від /var файловій системі, kubelet не відстежуватиме використання цієї файлової системи, що може призвести до проблем, якщо вона заповниться.
Докладніше про etcd та його логи дивіться в документації etcd. Знову ж таки, ви можете використовувати механізми сховища Kubernetes, щоб підключити постійне сховище до контейнера, у якому працює компонент.
Примітка:
Якщо ви розгортаєте компоненти кластера Kubernetes (наприклад, планувальник) так, щоб вони писали логи в том, спільний із батьківським вузлом, вам потрібно подбати про ротацію цих логів. Kubernetes не керує цією ротацією логів.
Ваша операційна система може автоматично виконувати певну ротацію логів — наприклад, якщо ви надаєте статичному Podʼу компонента спільний доступ до теки /var/log, ротація логів на рівні вузла обробляє файл у цій теці так само, як файл, записаний будь-яким компонентом поза Kubernetes.
Деякі інструменти розгортання враховують цю ротацію логів та автоматизують її; інші залишають це на вашу відповідальність.
Архітектури логування на рівні кластера
Хоча Kubernetes не надає власного рішення для логування на рівні кластера, існує кілька поширених підходів, які ви можете розглянути. Ось деякі варіанти:
Використання агента логування на рівні вузла, який працює на кожному вузлі.
Додавання в Pod застосунку спеціального sidecar-контейнера для логування.
Надсилання логів безпосередньо до бекенду із застосунку.
Використання агента логування на рівні вузла
Ви можете реалізувати логування на рівні кластера, розмістивши на кожному вузлі агент логування на рівні вузла. Агент логування — це спеціальний інструмент, який відкриває доступ до логів або надсилає їх до бекенду. Зазвичай агент логування — це контейнер, який має доступ до теки з файлами логів усіх контейнерів застосунків на цьому вузлі.
Оскільки агент логування повинен працювати на кожному вузлі, рекомендується запускати агента
як DaemonSet.
Логування на рівні вузла створює лише одного агента на вузол і не вимагає жодних змін у застосунках, що працюють на вузлі.
Контейнери пишуть у stdout та stderr, але без узгодженого формату. Агент на рівні вузла збирає
ці логи та пересилає їх для агрегації.
Використання sidecar-контейнера з агентом логування
Ви можете використовувати sidecar-контейнер одним із таких способів:
Sidecar-контейнер транслює логи застосунку у свій власний stdout.
У sidecar-контейнері працює агент логування, налаштований збирати логи з контейнера застосунку.
Sidecar-контейнер для трансляції
Якщо ваші sidecar-контейнери пишуть у власні потоки stdout та stderr, ви можете скористатися kubelet та агентом логування, які вже працюють на кожному вузлі. Sidecar-контейнери читають логи з файлу, сокета або journald. Кожен sidecar-контейнер виводить лог у свій власний потік stdout або stderr.
Цей підхід дозволяє розділити кілька потоків логів із різних частин вашого застосунку, деякі з яких можуть не підтримувати запис у stdout або stderr. Логіка перенаправлення логів мінімальна, тому це не створює значних накладних витрат. Крім того, оскільки stdout та stderr обробляє kubelet, ви можете використовувати вбудовані інструменти, такі як kubectl logs.
Наприклад, у Podʼі працює один контейнер, який записує до двох різних файлів логів у двох різних форматах. Ось маніфест для Podʼа:
apiVersion:v1kind:Podmetadata:name:counterspec:containers:- name:countimage:busybox:1.28args:- /bin/sh- -c- > i=0;
while true;
do
echo "$i: $(date)" >> /var/log/1.log;
echo "$(date) INFO $i" >> /var/log/2.log;
i=$((i+1));
sleep 1;
donevolumeMounts:- name:varlogmountPath:/var/logvolumes:- name:varlogemptyDir:{}
Не рекомендується записувати записи логів різних форматів в один потік логів, навіть якщо вам вдалося перенаправити обидва компоненти до потоку stdout контейнера. Натомість можна створити два sidecar-контейнери. Кожен sidecar-контейнер може читати кінець певного файлу логів зі спільного тому й перенаправляти логи до власного потоку stdout.
Ось маніфест для Podʼа, в якому є два sidecar-контейнери:
Тепер, коли ви запускаєте цей Pod, ви можете отримати доступ до кожного потоку логів окремо, запустивши такі команди:
kubectl logs counter count-log-1
Результат буде подібним до:
0: Fri Apr 1 11:42:26 UTC 2022
1: Fri Apr 1 11:42:27 UTC 2022
2: Fri Apr 1 11:42:28 UTC 2022
...
kubectl logs counter count-log-2
Результат буде подібним до:
Fri Apr 1 11:42:29 UTC 2022 INFO 0
Fri Apr 1 11:42:30 UTC 2022 INFO 0
Fri Apr 1 11:42:31 UTC 2022 INFO 0
...
Якщо ви встановили у свій кластер агент на рівні вузла, цей агент автоматично збиратиме ці потоки логів без додаткової конфігурації. За бажанням ви можете налаштувати агент на розбір рядків логів залежно від контейнера-джерела.
Навіть для Podʼів із низьким використанням CPU та памʼяті (порядку кількох мілікорів CPU та кількох мегабайтів памʼяті) запис логів у файл і їх подальша трансляція до stdout можуть подвоїти обсяг сховища, потрібний на вузлі. Якщо у вас є застосунок, який пише в один файл, рекомендується встановити /dev/stdout як місце призначення, а не застосовувати підхід із sidecar-контейнером для трансляції.
Sidecar-контейнери також можна використовувати для ротації файлів логів, які не може ротувати сам застосунок. Прикладом такого підходу є невеликий контейнер, який періодично запускає logrotate. Однак простіше використовувати stdout та stderr безпосередньо й залишити ротацію та політики зберігання kubelet.
Sidecar-контейнер з агентом логування
Якщо агент логування на рівні вузла недостатньо гнучкий для вашої ситуації, ви можете створити sidecar-контейнер з окремим агентом логування, налаштованим спеціально для роботи з вашим застосунком.
Примітка:
Використання агента логування в sidecar-контейнері може призвести до значного споживання ресурсів. Крім того, ви не зможете отримати доступ до цих логів за допомогою kubectl logs, оскільки вони не контролюються kubelet.
Ось два приклади маніфестів, які ви можете використати для реалізації sidecar-контейнера з агентом логування. Перший маніфест містить ConfigMap для налаштування fluentd.
apiVersion:v1kind:ConfigMapmetadata:name:fluentd-configdata:fluentd.conf:| <source>
type tail
format none
path /var/log/1.log
pos_file /var/log/1.log.pos
tag count.format1
</source>
<source>
type tail
format none
path /var/log/2.log
pos_file /var/log/2.log.pos
tag count.format2
</source>
<match **>
type google_cloud
</match>
Примітка:
У конфігураціях з прикладів ви можете замінити fluentd на будь-який агент логування, який читає з будь-якого джерела всередині контейнера застосунку.
Другий маніфест описує Pod із sidecar-контейнером, у якому працює fluentd. Pod монтує том, звідки fluentd може отримати свої конфігураційні дані.
6.12.8 - Рекомендації щодо використання вебхуків допуску
Рекомендації щодо проєктування та розгортання вебхуків допуску в Kubernetes.
На цій сторінці наведено рекомендації та міркування щодо проєктування вебхуків допуску в Kubernetes. Ця інформація призначена для операторів кластерів, які запускають сервери вебхуків допуску або сторонні застосунки, що змінюють або перевіряють ваші API-запити.
Перед читанням цієї сторінки переконайтеся, що ви знайомі з такими поняттями:
Контроль допуску відбувається, коли до API Kubernetes надсилається будь-який запит на створення, оновлення або видалення. Контролери допуску перехоплюють запити, що відповідають визначеним вами критеріям. Потім ці запити надсилаються до змінювальних або валідаційних вебхуків допуску. Такі вебхуки часто пишуть, щоб переконатися, що певні поля в специфікаціях обʼєктів існують або мають певні дозволені значення.
Вебхуки — це потужний механізм розширення API Kubernetes. Погано спроєктовані вебхуки часто спричиняють порушення роботи робочих навантажень, оскільки вебхуки мають великий контроль над обʼєктами в кластері. Як і інші механізми розширення API, вебхуки складно тестувати у великому масштабі на сумісність з усіма вашими робочими навантаженнями, іншими вебхуками, надбудовами та втулками.
Крім того, з кожним випуском Kubernetes додає або змінює API: зʼявляються нові можливості, можливості переходять на стадію бета чи стабільну, деякі застарівають. Навіть стабільні API Kubernetes можуть змінюватися. Наприклад, API Pod змінився у v1.29, щоб додати можливість sidecar-контейнерів. Хоча обʼєкт Kubernetes рідко стає несправним через новий API Kubernetes, вебхуки, які очікувано працювали з попередніми версіями API, можуть не впоратися з новішими змінами цього API. Це може призвести до неочікуваної поведінки після оновлення кластерів до новіших версій.
На цій сторінці описано поширені сценарії збоїв вебхуків і те, як уникнути їх завдяки обережному та продуманому проєктуванню й реалізації ваших вебхуків.
Перевірте, чи ви використовуєте вебхуки допуску
Навіть якщо ви не запускаєте власні вебхуки допуску, деякі сторонні застосунки, які ви запускаєте у своїх кластерах, можуть використовувати змінювальні або валідаційні вебхуки допуску.
Щоб перевірити, чи є у вашому кластері змінювальні вебхуки допуску, виконайте таку команду:
kubectl get mutatingwebhookconfigurations
У виводі буде перелічено всі змінювальні контролери допуску в кластері.
Щоб перевірити, чи є у вашому кластері валідаційні вебхуки допуску, виконайте таку команду:
kubectl get validatingwebhookconfigurations
У виводі буде перелічено всі валідаційні контролери допуску в кластері.
Вибір механізму контролю допуску
Kubernetes пропонує кілька варіантів контролю допуску та застосування політик. Розуміння того, коли використовувати конкретний варіант, допоможе покращити затримку та продуктивність, зменшити накладні витрати на керування й уникнути проблем під час оновлення версій. У наведеній нижче таблиці описано механізми, які дозволяють змінювати або перевіряти ресурси під час допуску:
Змінювальний і валідаційний контроль допуску в Kubernetes
Перехоплює API-запити перед допуском і перевіряє їх на відповідність виразам CEL.
Перевіряйте критичні конфігурації перед допуском ресурсу.
Забезпечуйте дотримання логіки політик за допомогою виразів CEL.
Загалом використовуйте контроль допуску на основі вебхуків, коли вам потрібен розширюваний спосіб оголошення або налаштування логіки. Використовуйте вбудований контроль допуску на основі CEL, коли потрібно оголосити простішу логіку без накладних витрат на роботу сервера вебхуків. Проєкт Kubernetes рекомендує за можливості використовувати контроль допуску на основі CEL.
Використовуйте вбудовану перевірку та стандартні значення для CustomResourceDefinitions
Якщо ви використовуєте CustomResourceDefinitions, не використовуйте вебхуки допуску для перевірки значень у специфікаціях CustomResource або для встановлення стандартних значень для полів. Kubernetes дозволяє вам визначати правила перевірки та стандартні значення полів під час створення CustomResourceDefinitions.
У цьому розділі описано рекомендації щодо покращення продуктивності та зменшення затримки. Стисло вони такі:
Консолідуйте вебхуки та обмежте кількість API-викликів на вебхук.
Використовуйте логи аудиту, щоб виявляти вебхуки, які повторюють одну й ту саму дію.
Використовуйте балансування навантаження для забезпечення доступності вебхука.
Встановіть невелике значення тайм-ауту для кожного вебхука.
Враховуйте потреби в доступності кластера під час проєктування вебхуків.
Проєктування вебхуків допуску для низької затримки
Змінювальні вебхуки допуску викликаються послідовно. Залежно від налаштування змінювальних вебхуків деякі з них можуть викликатися кілька разів. Кожен виклик змінювального вебхука додає затримку до процесу допуску. На відміну від них, валідаційні вебхуки викликаються паралельно.
Під час проєктування змінювальних вебхуків враховуйте ваші вимоги до затримки та її допустимий рівень. Чим більше змінювальних вебхуків у вашому кластері, тим більша ймовірність зростання затримки.
Щоб зменшити затримку, зверніть увагу на таке:
Консолідуйте вебхуки, які виконують подібні зміни різних обʼєктів.
Зменшіть кількість API-викликів, зроблених у логіці сервера змінювальних вебхуків.
Обмежте умови зіставлення кожного змінювального вебхука, щоб зменшити кількість вебхуків, які спрацьовують на конкретний API-запит.
Консолідуйте невеликі вебхуки в один сервер і конфігурацію для полегшення впорядкування та організації.
Враховуйте будь-які інші компоненти у вашому кластері, які можуть конфліктувати зі змінами, що їх вносить ваш вебхук. Наприклад, якщо ваш вебхук додає мітку, яку видаляє інший контролер, ваш вебхук викликається знову. Це призводить до циклу.
Щоб виявити такі цикли, спробуйте таке:
Оновіть політику аудиту вашого кластера, щоб записувати події аудиту. Використовуйте такі параметри:
level: RequestResponse
verbs: ["patch"]
omitStages: RequestReceived
Налаштуйте правило аудиту так, щоб створювати події для конкретних ресурсів, які змінює ваш вебхук.
Перевірте події аудиту: чи вебхуки повторно викликаються кілька разів із застосуванням того самого патча до того самого обʼєкта, чи поле обʼєкта кілька разів оновлюється й повертається назад.
Встановіть невелике значення тайм-ауту
Вебхуки допуску мають виконуватися якомога швидше (зазвичай за мілісекунди), оскільки вони збільшують затримку API-запитів. Використовуйте для вебхуків невеликий тайм-аут.
Використовуйте балансувальник навантаження для забезпечення доступності вебхука
Вебхуки допуску мають використовувати певну форму балансування навантаження для високої доступності та кращої продуктивності. Якщо вебхук працює всередині кластера, ви можете запустити кілька бекендів вебхука за Service типу ClusterIP.
Використовуйте модель розгортання з високою доступністю
Під час проєктування вебхука враховуйте вимоги до доступності вашого кластера. Наприклад, під час простою вузлів або збоїв у зонах Kubernetes позначає Podʼи як NotReady, щоб балансувальники навантаження могли перенаправити трафік до доступних зон і вузлів. Ці оновлення Podʼів можуть викликати ваші змінювальні вебхуки. Залежно від кількості задіяних Podʼів сервер змінювального вебхука може перевищити тайм-аут або спричинити затримки в обробці Podʼів. Унаслідок цього трафік не буде перенаправлено так швидко, як потрібно.
Враховуйте ситуації, подібні до наведеного прикладу, під час створення ваших вебхуків. Виключайте операції, які є результатом реакції Kubernetes на неминучі інциденти.
Фільтрація запитів
У цьому розділі наведено рекомендації щодо фільтрації запитів, які викликають конкретні вебхуки. Стисло вони такі:
Обмежте область дії вебхука, щоб уникати системних компонентів і запитів тільки для читання.
Обмежте вебхуки конкретними просторами імен.
Використовуйте умови зіставлення для точної фільтрації запитів.
Зіставляйте всі версії обʼєкта.
Обмежте область дії кожного вебхука
Вебхуки допуску викликаються лише тоді, коли API-запит відповідає конфігурації вебхука. Обмежте область дії кожного вебхука, щоб зменшити кількість непотрібних викликів до сервера вебхука. Зверніть увагу на такі обмеження області дії:
Уникайте зіставлення обʼєктів у просторі імен kube-system. Якщо ви запускаєте власні Podʼи в просторі імен kube-system, використовуйте objectSelector, щоб не змінити критичне робоче навантаження.
Не змінюйте Lease вузлів, які існують як обʼєкти Lease у системному просторі імен kube-node-lease. Зміна Lease вузлів може призвести до невдалих оновлень вузлів. Застосовуйте валідаційний контроль до обʼєктів Lease у цьому просторі імен, лише якщо ви впевнені, що він не поставить ваш кластер під загрозу.
Не зіставляйте TokenReview, SubjectAccessReview та інші віртуальні ресурси автентифікації та авторизації. Це завжди запити лише для читання, і їх перехоплення може порушити роботу вашого кластера. Починаючи з Kubernetes v1.37, вебхуки допуску стандартно не викликаються для цих ресурсів.
Обмежте кожен вебхук конкретним простором імен за допомогою namespaceSelector.
Фільтруйте конкретні запити за допомогою умов зіставлення
Контролери допуску підтримують кілька полів, за допомогою яких можна зіставляти запити, що відповідають певним критеріям. Наприклад, ви можете використовувати namespaceSelector, щоб відбирати запити, спрямовані на конкретний простір імен.
Для точнішої фільтрації запитів використовуйте поле matchConditions у конфігурації вебхука. Це поле дозволяє написати кілька виразів CEL, які мають повертати true, щоб запит викликав ваш вебхук допуску. Використання matchConditions може значно зменшити кількість викликів до вашого сервера вебхука.
Стандартно вебхуки допуску працюють для будь-яких версій API, які стосуються вказаного ресурсу. Цією поведінкою керує поле matchPolicy у конфігурації вебхука. Вкажіть значення Equivalent у полі matchPolicy або пропустіть це поле, щоб вебхук працював для будь-якої версії API.
У цьому розділі наведено рекомендації щодо області дії змін та особливостей полів обʼєктів. Стисло вони такі:
Застосовуйте патчі лише до тих полів, які цього потребують.
Не перезаписуйте значення масивів.
Уникайте побічних ефектів у змінах, коли це можливо.
Уникайте самозмін.
Дозволяйте запити в разі збою (fail open) і перевіряйте кінцевий стан.
Плануйте майбутні оновлення полів у наступних версіях.
Запобігайте самовиклику вебхуків.
Не змінюйте незмінні обʼєкти.
Застосовуйте патчі лише до потрібних полів
Сервери вебхуків допуску надсилають HTTP-відповіді, які вказують, що робити з конкретним запитом до API Kubernetes. Така відповідь є обʼєктом AdmissionReview. Змінювальний вебхук може додати конкретні поля для зміни перед дозволом допуску за допомогою полів patchType та patch у відповіді. Переконайтеся, що ви змінюєте лише ті поля, які потребують змін.
Наприклад, розгляньмо змінювальний вебхук, налаштований так, щоб Deployments web-server мали щонайменше три репліки. Коли запит на створення обʼєкта Deployment відповідає конфігурації вашого вебхука, вебхук має оновити лише значення поля spec.replicas.
Не перезаписуйте значення масивів
Поля у специфікаціях обʼєктів Kubernetes можуть містити масиви. Деякі масиви містять пари ключ:значення (наприклад, поле envVar у специфікації контейнера), тоді як інші масиви не мають ключів (наприклад, поле readinessGates у специфікації Pod). Порядок значень у полі масиву може бути важливим в деяких ситуаціях. Наприклад, порядок аргументів у полі args специфікації контейнера може впливати на контейнер.
Під час зміни масивів враховуйте таке:
За можливості використовуйте операцію JSONPatch add замість replace, щоб випадково не замінити потрібне значення.
Ставтеся до масивів, які не використовують пари ключ:значення, як до множин.
Переконайтеся, що значення в полі, яке ви змінюєте, не обовʼязково мають бути в певному порядку.
Не перезаписуйте наявні пари ключ:значення без крайньої потреби.
Будьте обережні під час зміни полів міток. Випадкова зміна може призвести до порушення селекторів міток, що призведе до непередбачуваної поведінки.
Уникайте побічних ефектів
Переконайтеся, що ваші вебхуки працюють лише з вмістом надісланого їм AdmissionReview і не вносять сторонніх змін. Такі додаткові зміни, які називають побічними ефектами, можуть спричинити конфлікти під час допуску, якщо їх належним чином не узгодити. Якщо вебхук не має побічних ефектів, поле .webhooks[].sideEffects слід встановити в None.
Якщо побічні ефекти потрібні під час оцінювання допуску, їх слід придушувати під час обробки обʼєкта AdmissionReview, у якому dryRun має значення true, а поле .webhooks[].sideEffects слід встановити в NoneOnDryRun.
Вебхук, що працює всередині кластера, може спричинити взаємоблокування власного розгортання, якщо його налаштовано перехоплювати ресурси, потрібні для запуску його власних Podʼів.
Наприклад, змінювальний вебхук допуску налаштовано так, щоб допускати запити create для Pod, лише якщо в Pod встановлено певну мітку (наприклад, env: prod). Сервер вебхука працює в Deployment, який не встановлює мітку env.
Коли вузол, на якому працюють Podʼи сервера вебхука, стає несправним, Deployment вебхука намагається перепланувати Podʼи на інший вузол. Однак наявний сервер вебхука відхиляє запити, оскільки мітку env не встановлено. Унаслідок цього міграція не може відбутися.
Виключіть простір імен, де працює ваш вебхук, за допомогою namespaceSelector.
Уникайте циклічних залежностей
Цикли залежностей можуть виникати у таких сценаріях:
Два вебхуки перевіряють Podʼи один одного. Якщо обидва вебхуки стають недоступними одночасно, жоден з них не може запуститися.
Ваш вебхук перехоплює компоненти надбудов кластера, такі як мережеві втулки або втулки сховища, від яких він залежить. Якщо і вебхук, і залежна надбудова стають недоступними, жоден із компонентів не може працювати.
Щоб уникнути таких циклів залежностей, спробуйте таке:
Не дозволяйте вебхукам перевіряти або змінювати інші вебхуки. Розгляньте можливість виключення конкретних просторів імен з-під дії вашого вебхука.
Не дозволяйте вашим вебхукам діяти на залежні надбудови, використовуючи objectSelector.
Дозволяйте запити в разі збою (fail open) і перевіряйте кінцевий стан
Змінювальні вебхуки допуску підтримують поле конфігурації failurePolicy. Це поле вказує, чи повинен API-сервер допустити або відхилити запит у разі збою вебхука. Збої вебхука можуть статися через тайм-аути або помилки у логіці сервера.
Стандартно вебхуки допуску встановлюють поле failurePolicy у Fail. API-сервер відхиляє запит, якщо вебхук зазнає збою. Однак таке стандартне відхилення може призвести до відхилення запитів, що відповідають вимогам, під час простою вебхука.
Дозвольте вашим змінювальним вебхукам «fail open», встановивши поле failurePolicy в Ignore. Використовуйте валідаційний контролер, щоб перевіряти стан запитів і переконуватися, що вони відповідають вашим політикам.
Цей підхід має такі переваги:
Простій змінювальних вебхуків не заважає розгортанню ресурсів, що відповідають вимогам.
Застосування політик відбувається під час валідаційного контролю допуску.
Змінювальні вебхуки не заважають іншим контролерам в кластері.
Плануйте майбутні оновлення полів
Загалом проєктуйте свої вебхуки з припущенням, що API Kubernetes можуть змінитися в наступній версії. Не пишіть сервер, який вважає стабільність API чимось гарантованим. Наприклад, випуск sidecar-контейнерів у Kubernetes додав поле restartPolicy до API Pod.
Запобігайте самовиклику вашого вебхука
Змінювальні вебхуки, які реагують на широкий спектр API-запитів, можуть ненавмисно викликати самі себе. Наприклад, розгляньмо вебхук, який реагує на всі запити в кластері. Якщо налаштувати вебхук на створення обʼєктів Event для кожної зміни, він реагуватиме на власні запити на створення обʼєктів Event.
Щоб уникнути цього, встановлюйте унікальну мітку на всі ресурси, які створює ваш вебхук. Виключіть цю мітку з умов зіставлення вашого вебхука.
Не змінюйте незмінні обʼєкти
Деякі обʼєкти Kubernetes в API-сервері не можуть змінюватися. Наприклад, коли ви розгортаєте статичний Pod, kubelet на вузлі створює в API-сервері дзеркальний Pod для відстеження статичного Podʼа. Однак зміни дзеркального Podʼа не поширюються на статичний Pod.
Не намагайтеся змінювати ці обʼєкти під час допуску. Усі дзеркальні Podʼи мають анотацію kubernetes.io/config.mirror. Щоб виключити дзеркальні Podʼи й водночас зменшити ризик безпеки від ігнорування анотації, дозволяйте статичним Podʼам працювати лише в конкретних просторах імен.
Порядок виклику змінювальних вебхуків та ідемпотентність
У цьому розділі наведено рекомендації щодо порядку виклику вебхуків і проєктування ідемпотентних вебхуків. Стисло вони такі:
Не покладайтеся на конкретний порядок виконання.
Перевіряйте зміни перед допуском.
Перевіряйте, чи зміни не перезаписуються іншими контролерами.
Переконайтеся, що набір змінювальних вебхуків є ідемпотентним, а не тільки окремі вебхуки.
Не покладайтеся на порядок виклику змінювальних вебхуків
Змінювальні вебхуки допуску не виконуються в стабільному порядку. Момент виклику конкретного вебхука може залежати від різних чинників. Не покладайтеся на те, що ваш вебхук виконається в певний момент процесу допуску. Інші вебхуки все ще можуть змінити ваш змінений обʼєкт.
Наведені нижче рекомендації можуть допомогти мінімізувати ризик ненавмисних змін:
Використовуйте політику повторного виклику, щоб відстежувати зміни обʼєкта іншими втулками й за потреби повторно запускати вебхук. Докладніше дивіться в розділі Політика повторного виклику.
Переконайтеся, що змінювальні вебхуки у вашому кластері є ідемпотентними
Кожен змінювальний вебхук допуску має бути ідемпотентним. Вебхук має бути здатним працювати з обʼєктом, який він уже змінив, не вносячи додаткових змін, окрім початкової.
Крім того, усі змінювальні вебхуки у вашому кластері мають бути ідемпотентними як сукупність. Після завершення фази змін контролю допуску кожен окремий змінювальний вебхук має бути здатним працювати з обʼєктом, не вносячи до нього додаткових змін.
Залежно від вашого середовища забезпечити ідемпотентність у великому масштабі може бути складно. Можуть допомогти такі рекомендації:
Використовуйте валідаційні контролери допуску, щоб перевіряти кінцевий стан критичних робочих навантажень.
Тестуйте свої розгортання в тестовому кластері, щоб побачити, чи не змінює той самий вебхук певні обʼєкти кілька разів.
Переконайтеся, що область дії кожного змінювального вебхука є конкретною та обмеженою.
У наведених нижче прикладах показано ідемпотентну логіку змін:
Для запиту create Pod встановіть поле .spec.securityContext.runAsNonRoot Pod у true.
Для запиту create Pod, якщо поле .spec.containers[].resources.limits контейнера не встановлено, встановіть стандартні обмеження ресурсів.
Для запиту create Pod додайте sidecar-контейнер із назвою foo-sidecar, якщо контейнера з назвою foo-sidecar ще немає.
У цих випадках вебхук можна безпечно викликати повторно, і він може допустити обʼєкт, у якому ці поля вже встановлено.
У наведених нижче прикладах показано неідемпотентну логіку змін:
Для запиту create Pod додайте sidecar-контейнер із назвою foo-sidecar і суфіксом із поточною позначкою часу (наприклад, foo-sidecar-19700101-000000).
Повторний виклик вебхука може призвести до того, що той самий sidecar буде додано до Podʼа кілька разів, щоразу з іншою назвою контейнера. Так само вебхук може додати дубльовані контейнери, якщо sidecar уже є в Podʼі, наданому користувачем.
Для запиту create/update Pod відхиліть запит, якщо Pod має мітку env, інакше додайте до Pod мітку env: prod.
Повторний виклик вебхука призведе до того, що вебхук завершиться збоєм на власному результаті.
Для запиту create Pod додайте sidecar-контейнер із назвою foo-sidecar без перевірки, чи існує контейнер foo-sidecar.
Повторний виклик вебхука призведе до дублювання контейнерів у Pod, через що запит стане недійсним і API-сервер його відхилить.
Тестування та перевірка змін
У цьому розділі наведено рекомендації щодо тестування змінювальних вебхуків і перевірки змінених обʼєктів. Стисло вони такі:
Тестуйте вебхуки в тестових середовищах.
Уникайте змін, які порушують перевірки.
Тестуйте оновлення мінорних версій на предмет регресій та конфліктів.
Перевіряйте змінені обʼєкти перед допуском.
Тестуйте вебхуки у тестових середовищах
Ретельне тестування має бути основною частиною вашого циклу випуску нових або оновлених вебхуків. За можливості тестуйте будь-які зміни вебхуків кластера в тестовому середовищі, яке максимально нагадує ваші промислові кластери. Принаймні використовуйте інструмент на кшталт minikube або kind, щоб створити невеликий тестовий кластер для змін вебхуків.
Переконайтеся, що зміни не порушують перевірки
Ваші змінювальні вебхуки не повинні порушувати жодні перевірки, що застосовуються до обʼєкта перед допуском. Наприклад, розгляньмо змінювальний вебхук, який встановлює стандартний запит CPU Podʼа на певне значення. Якщо обмеження CPU цього Podʼа нижче за змінений запит, Pod не пройде допуск.
Тестуйте кожен змінювальний вебхук на відповідність перевіркам, що працюють у вашому кластері.
Тестуйте оновлення мінорних версій для забезпечення послідовної поведінки
Перед оновленням промислових кластерів до нової мінорної версії протестуйте свої вебхуки та робочі навантаження в тестовому середовищі. Порівняйте результати, щоб переконатися, що ваші вебхуки й далі працюють очікувано після оновлення.
Крім того, використовуйте такі ресурси, щоб стежити за змінами API:
Змінювальні вебхуки виконуються до завершення перед запуском будь-яких валідаційних вебхуків. Стабільного порядку застосування змін до обʼєктів немає. Унаслідок цього ваші зміни може перезаписати змінювальний вебхук, який виконується пізніше.
Додайте до свого кластера валідаційний контролер допуску, такий як ValidatingAdmissionWebhook або ValidatingAdmissionPolicy, щоб переконатися, що ваші зміни збереглися. Наприклад, розгляньмо змінювальний вебхук, який додає поле restartPolicy: Always до певних init-контейнерів, щоб вони працювали як sidecar-контейнери. Ви можете запустити валідаційний вебхук, щоб переконатися, що ці init-контейнери зберегли конфігурацію restartPolicy: Always після завершення всіх змін.
У цьому розділі наведено рекомендації щодо розгортання змінювальних вебхуків допуску. Стисло вони такі:
Поступово розгортайте конфігурацію вебхука й відстежуйте проблеми за просторами імен.
Обмежте доступ до редагування ресурсів конфігурації вебхука.
Обмежте доступ до простору імен, де працює сервер вебхука, якщо сервер розташований у кластері.
Встановлення та увімкнення змінювального вебхука
Коли ви будете готові розгорнути змінювальний вебхук у кластері, виконайте дії в такому порядку:
Встановіть сервер вебхука та запустіть його.
Встановіть поле failurePolicy у маніфесті MutatingWebhookConfiguration в Ignore. Це допоможе уникнути порушень через неправильно налаштовані вебхуки.
Встановіть поле namespaceSelector у маніфесті MutatingWebhookConfiguration на тестовий простір імен.
Розгорніть MutatingWebhookConfiguration у вашому кластері.
Стежте за вебхуком у тестовому просторі імен, щоб виявити проблеми, а потім розгорніть вебхук в інших просторах імен. Якщо вебхук перехоплює API-запит, який не мав перехоплювати, призупиніть розгортання та скоригуйте область дії конфігурації вебхука.
Обмежте доступ до редагування змінювальних вебхуків
Змінювальні вебхуки — це потужні контролери Kubernetes. Використовуйте RBAC або інший механізм авторизації, щоб обмежити доступ до конфігурацій і серверів ваших вебхуків. Для RBAC переконайтеся, що такий доступ мають лише довірені субʼєкти:
Якщо сервер вашого змінювального вебхука працює у кластері, обмежте доступ до створення або зміни будь-яких ресурсів у цьому просторі імен.
Приклади якісних реалізацій
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Наведені нижче проєкти є прикладами «якісних» реалізацій власних серверів вебхуків. Ви можете використовувати їх як відправну точку під час проєктування власних вебхуків. Не використовуйте ці приклади як є; беріть їх за відправну точку й проєктуйте свої вебхуки так, щоб вони добре працювали у вашому конкретному середовищі.
6.12.9 - Рекомендації щодо динамічного виділення ресурсів для адміністраторів кластера
На цій сторінці описано рекомендації щодо налаштування кластера Kubernetes із використанням динамічного виділення ресурсів (DRA). Ці інструкції призначені для адміністраторів кластерів.
Окремі дозволи для API, повʼязаних з DRA
DRA оркеструється через низку різних API. Використовуйте інструменти авторизації (такі як RBAC або інше рішення), щоб контролювати доступ до потрібних API залежно від ролі вашого користувача.
Загалом доступ до DeviceClasses і ResourceSlices слід надавати лише адміністраторам і драйверам DRA. Операторам кластерів, які розгортатимуть Podʼи із заявками, потрібен доступ до API ResourceClaim і ResourceClaimTemplate; обидва ці API обмежені простором імен.
Розгортання та обслуговування драйверів DRA
Драйвери DRA — це сторонні застосунки, які працюють на кожному вузлі кластера й взаємодіють з апаратним забезпеченням цього вузла та вбудованими компонентами DRA Kubernetes. Процедура встановлення залежить від обраного драйвера, але, ймовірно, він розгортається як DaemonSet на всіх або на вибраних вузлах кластера (за допомогою селекторів вузлів або подібних механізмів).
Використовуйте драйвери з безперебійним оновленням, якщо це можливо
Драйвери DRA реалізують інтерфейс пакунка kubeletplugin. Ваш драйвер може підтримувати безперебійні оновлення завдяки реалізації властивості цього інтерфейсу, яка дозволяє двом версіям одного драйвера DRA співіснувати протягом короткого часу. Це доступно лише для kubelet версії 1.33 і новіших, і ваш драйвер може не підтримувати це для гетерогенних кластерів з підʼєднаними вузлами, на яких працюють старіші версії Kubernetes, — перевірте це в документації вашого драйвера.
Якщо безперебійні оновлення доступні у вашій ситуації, розгляньте можливість їх використання, щоб мінімізувати затримки планування під час оновлення драйвера.
Якщо ви не можете використовувати безперебійні оновлення, під час простою драйвера на час оновлення ви можете помітити, що:
Podʼи не можуть запускатися, якщо заявки, від яких вони залежать, ще не були підготовлені до використання.
Очищення після останнього Podʼа, який використовував заявку, відкладається, доки драйвер знову не стане доступним. Pod не позначається як завершений. Це не дає повторно використовувати ресурси цього Podʼа для інших Podʼів.
Запущені Podʼи продовжують працювати.
Переконайтеся, що драйвер DRA надає пробу життєздатності, і використовуйте її
Ваш драйвер DRA, ймовірно, реалізує gRPC-сокет для перевірок справності відповідно до рекомендацій щодо драйверів DRA. Найпростіший спосіб використати цей gRPC-сокет — налаштувати його як пробу життєздатності для DaemonSet, що розгортає ваш драйвер DRA. Документація вашого драйвера або інструменти розгортання вже можуть це містити, але якщо ви створюєте конфігурацію окремо або запускаєте драйвер DRA не як Pod Kubernetes, переконайтеся, що ваші інструменти оркестрування перезапускають драйвер DRA в разі невдалих перевірок справності цього gRPC-сокета. Це мінімізує випадкові простої драйвера DRA і дасть йому більше можливостей для самовідновлення, зменшуючи затримки планування або час на усунення несправностей.
Під час drain вузла виконуйте drain драйвера DRA якомога пізніше
Драйвер DRA відповідає за скасування підготовки всіх пристроїв, виділених Podʼам, і якщо для драйвера DRA буде виконано drain до видалення Podʼів із заявками, він не зможе завершити очищення. Якщо ви реалізуєте власну логіку drain для вузлів, перед завершенням самого драйвера DRA перевірте, що немає виділених або зарезервованих ResourceClaim чи ResourceClaimTemplates.
Відстежуйте та налаштовуйте компоненти для вищого навантаження, особливо у великомасштабних середовищах
Компонент панелі управління kube-scheduler та внутрішній контролер ResourceClaim, яким керує компонент kube-controller-manager, виконують основну роботу під час планування Podʼів із заявками на основі метаданих, що зберігаються в API DRA. Порівняно з Podʼами, запланованими без DRA, для Podʼів із заявками DRA зростають кількість викликів API-сервера, а також використання памʼяті й CPU цими компонентами. Крім того, локальні компоненти вузла, такі як драйвер DRA та kubelet, використовують API DRA для виділення апаратних запитів під час створення пісочниці Podʼа. Особливо у великомасштабних середовищах, де кластери мають багато вузлів та/або розгортають багато робочих навантажень, які інтенсивно використовують заявки на ресурси, визначені DRA, адміністратор кластера має налаштувати відповідні компоненти з урахуванням збільшеного навантаження.
Неправильне налаштування компонентів може мати прямі або лавиноподібні наслідки, що спричиняють різні симптоми протягом життєвого циклу Podʼа. Якщо параметри QPS та burst компонента kube-scheduler занадто низькі, планувальник може швидко визначити придатний вузол для Podʼа, але витратити більше часу на привʼязку Podʼа до цього вузла. З DRA під час планування Podʼа критично важливі параметри QPS та Burst у конфігурації client-go в kube-controller-manager.
Конкретні значення для налаштування вашого кластера залежать від різних чинників, таких як кількість вузлів/Podʼів, швидкість створення Podʼів, плинність, навіть у середовищах без DRA; докладніше дивіться в README SIG Scalability про пороги масштабованості Kubernetes. У тестах масштабування на кластері з увімкненим DRA зі 100 вузлами, 720 довгоживучими Podʼами (90% насичення) та 80 плинними Podʼами (10% плинності, 10 разів) зі швидкістю створення Jobs 10 QPS значення QPS для kube-controller-manager можна було встановити лише 75, а Burst — 150, щоб досягти таких самих цільових метрик, як для розгортань без DRA. На цій нижній межі спостерігалося, що обмежувач швидкості на стороні клієнта спрацьовував достатньо, щоб захистити API-сервер від вибухового сплеску, але межа була достатньо високою, щоб не вплинути на SLO запуску Podʼів. Хоча це гарна відправна точка, краще зрозуміти, як налаштувати різні компоненти, що найбільше впливають на продуктивність DRA у вашому розгортанні, можна, відстежуючи наведені нижче метрики. Докладніше про всі стабільні метрики Kubernetes дивіться в Довіднику метрик Kubernetes.
Метрики kube-controller-manager
Наведені нижче метрики докладно показують роботу внутрішнього контролера ResourceClaim, яким керує компонент kube-controller-manager.
Швидкість додавання до робочої черги: відстежуйте sum(rate(workqueue_adds_total{name="resource_claim"}[5m])), щоб оцінити, як швидко елементи додаються до контролера ResourceClaim.
Глибина робочої черги: відстежуйте sum(workqueue_depth{endpoint="kube-controller-manager",name="resource_claim"}), щоб виявити будь-які нагромадження в контролері ResourceClaim.
Тривалість обробки в робочій черзі: відстежуйте histogram_quantile(0.99,sum(rate(workqueue_work_duration_seconds_bucket{name="resource_claim"}[5m]))by(le)), щоб зрозуміти швидкість, з якою контролер ResourceClaim обробляє роботу.
Якщо ви спостерігаєте низьку швидкість додавання до робочої черги, високу глибину робочої черги та/або велику тривалість обробки в робочій черзі, це свідчить про те, що контролер працює не оптимально. Розгляньте можливість налаштування таких параметрів, як QPS, burst і конфігурації CPU/памʼяті.
Якщо ви спостерігаєте високу швидкість додавання до робочої черги, високу глибину робочої черги, але прийнятну тривалість обробки, це вказує на те, що контролер обробляє роботу, але паралелізму може бути недостатньо. Паралелізм жорстко закодований у контролері, тому як адміністратор кластера ви можете налаштувати це, зменшивши QPS створення Podʼів, щоб швидкість додавання до робочої черги ResourceClaim стала більш керованою.
Метрики kube-scheduler
Наведені нижче метрики планувальника є високорівневими й агрегують продуктивність усіх запланованих Podʼів, а не лише тих, що використовують DRA. Важливо зазначити, що на наскрізні метрики зрештою впливає продуктивність kube-controller-manager у створенні ResourceClaims з ResourceClaimTemplates у розгортаннях, які інтенсивно використовують ResourceClaimTemplates.
Наскрізна тривалість роботи планувальника: відстежуйте histogram_quantile(0.99,sum(increase(scheduler_pod_scheduling_sli_duration_seconds_bucket[5m]))by(le)).
Коли для Podʼа, привʼязаного до вузла, має бути задоволений ResourceClaim, kubelet викликає методи NodePrepareResources та NodeUnprepareResources драйвера DRA. Ви можете спостерігати цю поведінку з погляду kubelet за допомогою наведених нижче метрик.
Драйвери DRA реалізують інтерфейс пакунка kubeletplugin, який надає власну метрику для базових операцій gRPC NodePrepareResources та NodeUnprepareResources. Ви можете спостерігати цю поведінку з погляду внутрішнього kubeletplugin за допомогою наведених нижче метрик.
Операція DRA kubeletplugin gRPC NodePrepareResources: відстежуйте histogram_quantile(0.99,sum(rate(dra_grpc_operations_duration_seconds_bucket{method_name=~".*NodePrepareResources"}[5m]))by(le)).
Операція DRA kubeletplugin gRPC NodeUnprepareResources: відстежуйте histogram_quantile(0.99,sum(rate(dra_grpc_operations_duration_seconds_bucket{method_name=~".*NodeUnprepareResources"}[5m]))by(le)).
6.12.10 - Версія сумісності для компонентів панелі управління Kubernetes
Починаючи з випуску v1.32, ми запровадили для компонентів панелі управління Kubernetes налаштовувані параметри сумісності версій та емуляції, щоб зробити оновлення безпечнішими, надаючи адміністраторам кластерів більше контролю й дрібніші кроки.
Емульована версія
Параметр емуляції задається прапорцем --emulated-version компонентів панелі управління. Він дозволяє компоненту емулювати поведінку (API, можливості тощо) старішої версії Kubernetes.
Під час його використання доступні можливості відповідатимуть емульованій версії:
Будь-які можливості бінарної версії, додані після емульованої версії, будуть недоступні.
Будь-які можливості, вилучені після емульованої версії, будуть доступні.
Це дозволяє бінарному файлу певного випуску Kubernetes емулювати поведінку попередньої версії настільки точно, що сумісність з іншими компонентами системи можна визначати в термінах емульованої версії.
Значення --emulated-version має бути <= binaryVersion. Діапазон підтримуваних емульованих версій дивіться в довідці до прапорця --emulated-version.
6.12.11 - Метрики для системних компонентів Kubernetes
Метрики системних компонентів дають змогу краще зрозуміти, що відбувається всередині них. Метрики особливо корисні для побудови dashboards та сповіщень.
Компоненти Kubernetes надають метрики у форматі Prometheus. Цей формат — структурований звичайний текст, який можуть читати як люди, так і машини.
Метрики в Kubernetes
У більшості випадків метрики доступні в точці доступу /metrics HTTP-сервера. Для компонентів, які стандартно не відкривають цю точку доступу, її можна ввімкнути за допомогою прапорця --bind-address.
У промисловому середовищі варто налаштувати Prometheus Server або інший збирач метрик, щоб періодично збирати ці метрики й робити їх доступними в базі даних часових рядів.
Зверніть увагу, що kubelet також надає метрики через точки доступу /metrics/cadvisor, /metrics/resource та /metrics/probes. Ці метрики мають інший життєвий цикл.
Якщо ваш кластер використовує RBAC, для читання метрик потрібна авторизація через користувача, групу або ServiceAccount з ClusterRole, що дозволяє доступ до /metrics. Наприклад:
apiVersion:rbac.authorization.k8s.io/v1kind:ClusterRolemetadata:name:prometheusrules:- nonResourceURLs:- "/metrics"verbs:- get
Альфа-метрики не мають гарантій стабільності. Ці метрики можуть бути змінені або видалені в будь-який момент.
Бета-метрики дотримуються менш суворого контракту API, ніж стабільні. Із бета-метрик не можна вилучати мітки протягом їх життєвого циклу, однак мітки можна додавати, поки метрика перебуває на стадії бета.
Стабільні метрики гарантовано не змінюються. Це означає:
Стабільну метрику без ознаки застарілості не буде видалено чи перейменовано
Тип стабільної метрики не буде змінено
Застарілі метрики заплановано до видалення, але вони все ще доступні для використання. Ці метрики містять анотацію з версією, у якій вони стали застарілими.
Наприклад:
Перед застаріванням
# HELP some_counter this counts things
# TYPE some_counter counter
some_counter 0
Після застарівання
# HELP some_counter (Deprecated since 1.15.0) this counts things
# TYPE some_counter counter
some_counter 0
Приховані метрики більше не публікуються для збирання, але все ще доступні для використання. Застаріла метрика стає прихованою через певний час, залежно від її рівня стабільності:
STABLE метрики стають прихованими щонайменше через 3 випуски або 9 місяців, залежно від того, що довше.
BETA метрики стають прихованими щонайменше через 1 випуск або 4 місяці, залежно від того, що довше.
ALPHA метрики можуть бути приховані або видалені в тому самому випуску, в якому вони стали застарілими.
Щоб використовувати приховану метрику, її потрібно ввімкнути. Докладніше дивіться в розділі Показ прихованих метрик.
Видалені метрики більше не публікуються і не можуть бути використані.
Показ прихованих метрик
Як описано вище, адміністратори можуть увімкнути приховані метрики через прапорець командного рядка конкретного бінарного файлу. Це запасний варіант для адміністраторів, які пропустили міграцію з метрик, що стали застарілими в останньому випуску.
Прапорець show-hidden-metrics-for-version приймає версію, для якої потрібно показати метрики, що стали застарілими в цьому випуску. Версія зазначається як x.y, де x — мажорна версія, y — мінорна версія. Патч-версія не потрібна: хоча метрика може стати застарілою в патч-випуску, політика застарівання метрик працює на рівні мінорних випусків.
Прапорець може приймати лише попередню мінорну версію. Якщо ви хочете показати всі метрики, приховані в попередньому випуску, встановіть прапорець show-hidden-metrics-for-version на попередню версію. Використання надто старої версії не дозволено, оскільки це порушує політику застарівання метрик.
Наприклад, припустімо, що метрика A стала застарілою в 1.29. Версія, в якій метрика A стає прихованою, залежить від її рівня стабільності:
Якщо метрика A є ALPHA, вона може бути прихована в 1.29.
Якщо метрика A є BETA, вона буде прихована не раніше ніж у 1.30. Якщо ви оновлюєтесь до 1.30 і все ще потребуєте A, ви повинні використовувати прапорець командного рядка --show-hidden-metrics-for-version=1.29.
Якщо метрика A є STABLE, вона буде прихована не раніше ніж у 1.32. Якщо ви оновлюєтесь до 1.32 і все ще потребуєте A, ви повинні використовувати прапорець командного рядка --show-hidden-metrics-for-version=1.31.
Метрики компонентів
Метрики kube-controller-manager
Метрики менеджера контролерів дають важливе уявлення про продуктивність і справність менеджера контролерів. До цих метрик належать поширені метрики середовища виконання мови Go, такі як кількість go_routine, та специфічні для контролерів метрики, такі як затримки запитів до etcd або затримки API Cloudprovider (AWS, GCE, OpenStack), які можна використовувати для оцінки справності кластера.
Починаючи з Kubernetes 1.7, для операцій зі сховищем у GCE, AWS, Vsphere та OpenStack доступні докладні метрики Cloudprovider. Ці метрики можна використовувати для моніторингу справності операцій із постійними томами.
Планувальник надає необовʼязкові метрики, які повідомляють про запитані ресурси та бажані обмеження всіх запущених Podʼів. Ці метрики можна використовувати для побудови dashboards планування місткості, оцінки поточних або історичних обмежень планування, швидкого виявлення робочих навантажень, які не можуть бути заплановані через брак ресурсів, і порівняння фактичного використання із запитом Podʼа.
kube-scheduler визначає запити та обмеження ресурсів, налаштовані для кожного Podʼа; коли запит або обмеження не дорівнює нулю, kube-scheduler повідомляє часовий ряд метрик. Часовий ряд має такі мітки:
простір імен
назва Podʼа
вузол, на який заплановано Pod, або порожній рядок, якщо його ще не заплановано
пріоритет
призначений планувальник для цього Podʼа
назва ресурсу (наприклад, cpu)
одиниця ресурсу, якщо відома (наприклад, cores)
Щойно Pod завершує роботу (має restartPolicy зі значенням Never або OnFailure і перебуває у фазі Succeeded або Failed, або його видалено, і всі контейнери перебувають у стані завершення), часовий ряд більше не повідомляється, оскільки тепер планувальник може запланувати запуск інших Podʼів. Ці дві метрики називаються kube_pod_resource_request та kube_pod_resource_limit.
Метрики доступні через HTTP-точку доступу /metrics/resources. Для них потрібна авторизація для точки доступу /metrics/resources, яку зазвичай надає ClusterRole з дієсловом get для URL /metrics/resources, що не є ресурсом.
У Kubernetes 1.21 потрібно використовувати прапорець --show-hidden-metrics-for-version=1.20, щоб показати ці альфа-метрики.
Метрики kubelet Pressure Stall Information (PSI)
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.36. It was first available in the v1.33 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate KubeletPSI, Kubernetes ignores it but does not report any error.
Якщо в ядрі ввімкнено PSI (версія 4.20 або новіша), kubelet збирає Pressure Stall Information (PSI) щодо використання CPU, памʼяті та вводу-виводу. Інформація збирається на рівні вузла, Podʼа та контейнера.
Метрики Prometheus: надаються через точку доступу /metrics/cadvisor у вигляді кумулятивних лічильників (totals), що відображають загальний час затримки в секундах. Метрики доступні через цю точку доступу під такими назвами:
Summary API: надається через точку доступу /stats/summary, повертаючи як кумулятивні totals, так і ковзні середні (avg10, avg60, avg300) у форматі JSON. Ці середні значення показують відсоток часу, протягом якого завдання були затримані на ресурсі за відповідні інтервали 10 секунд, 60 секунд і 5 хвилин.
Ці метрики також нативно експортуються через відповідний файл вузла в /proc/pressure/ — cpu, memory та io — у такому форматі:
Як можна інтерпретувати ці метрики разом? Візьмемо, наприклад, такий запит до Summary API: kubectl get --raw "/api/v1/nodes/$(kubectl get nodes -o jsonpath='{.items[0].metadata.name}')/proxy/stats/summary" | jq '.pods[].containers[] | select(.name=="<CONTAINER_NAME>") | {name, cpu: .cpu.psi, memory: .memory.psi, io: .io.psi}'.
Це повертає інформацію у форматі JSON, як показано нижче.
Ось простий сценарій сплеску. Значення avg10 для cpu.some, що дорівнює 0.74, означає, що за останні 10 секунд принаймні одне завдання в цьому контейнері було затримано на CPU протягом 0.74% часу (0.0074 секунди або 74 мілісекунди). Оскільки avg10 (0.74) значно перевищує avg300 (0.21) для того самого ресурсу, це свідчить про недавній сплеск конкуренції за ресурси, а не про тривале вузьке місце. Якщо постійно стежити за метриками й avg300 також зростає, можна діагностувати серйознішу, тривалу проблему!
Крім того, зверніть увагу, що в цьому прикладі cpu.some показує тиск, тоді як cpu.full залишається на рівні 0.00. Це означає, що хоча деякі процеси були затримані в очікуванні часу CPU, контейнер загалом продовжував роботу. Ненульове значення full означало б, що всі завдання, які не простоюють, були затримані одночасно, а це набагато серйозніша проблема. Хоча значення total 35232438 не так зручно читати людині, воно показує кумулятивний час затримки в мікросекундах, що дозволяє виявляти сплески затримки, які інакше можуть не проявитися в середніх значеннях. Такі значення також корисні для систем моніторингу, таких як Prometheus, для точного обчислення темпів зростання за певні часові вікна. І наостанок: високий тиск на I/O разом із низьким тиском на памʼять може означати, що застосунок очікує на пропускну здатність диска, а не страждає від браку доступної оперативної памʼяті. Вузол не перевантажений за памʼяттю, тому варто окремо дослідити споживання диска.
Метрики PSI дають надійніший спосіб моніторингу конкуренції за ресурси в реальному часі на всіх рівнях для кожної cgroup, відкриваючи можливість динамічно обробляти робочі навантаження в усій системі. Докладніше про метрики PSI читайте в Understand PSI Metrics.
Ви можете явно вимкнути метрики за допомогою прапорця командного рядка --disabled-metrics. Це може знадобитися, наприклад, якщо метрика спричиняє проблеми з продуктивністю. Вхідні дані — це список вимкнених метрик (тобто --disabled-metrics=metric1,metric2).
Обмеження кардинальності метрик
Метрики з необмеженими вимірами можуть спричиняти проблеми з памʼяттю в компонентах, які вони інструментують. Щоб обмежити використання ресурсів, ви можете використовувати параметр командного рядка --allow-metric-labels, щоб динамічно налаштувати список дозволених значень міток для метрики.
На стадії альфа цей прапорець може приймати лише серію зіставлень як список дозволених міток метрики. Кожне зіставлення має формат <metric_name>,<label_name>=<allowed_labels>, де <allowed_labels> — розділений комами список допустимих назв міток.
Окрім командного рядка, це можна зробити й у конфігураційному файлі. Шлях до цього файлу можна вказати за допомогою аргументу командного рядка --allow-metric-labels-manifest для компонента. Ось приклад вмісту такого конфігураційного файлу:
Крім того, мета-метрика cardinality_enforcement_unexpected_categorizations_total записує кількість неочікуваних категоризацій під час обмеження кардинальності, тобто щоразу, коли трапляється значення мітки, не дозволене обмеженнями списку дозволених значень.
kube-state-metrics — це агент-надбудова для генерації та надання метрик на рівні кластера.
Стан обʼєктів Kubernetes в API Kubernetes можна надавати у вигляді метрик. Агент-надбудова kube-state-metrics може підʼєднуватися до API-сервера Kubernetes і надавати HTTP-точку доступу з метриками, згенерованими зі стану окремих обʼєктів у кластері. Він надає різну інформацію про стан обʼєктів, таку як мітки й анотації, час запуску та завершення, статус або фазу, у якій зараз перебуває обʼєкт. Наприклад, контейнери, що працюють у Podʼах, створюють метрику kube_pod_container_info. Вона містить як мітки назву контейнера, назву Podʼа, до якого він належить, простір імен, у якому працює Pod, назву образу контейнера, ідентифікатор образу, назву образу зі специфікації контейнера, ідентифікатор запущеного контейнера та ідентифікатор Podʼа.
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
Зовнішній компонент, здатний збирати дані з точки доступу kube-state-metrics (наприклад, через Prometheus), тепер можна використовувати для таких сценаріїв.
Приклад: використання метрик з kube-state-metrics для запиту стану кластера
Серії метрик, які генерує kube-state-metrics, допомагають глибше зрозуміти стан кластера, оскільки їх можна використовувати в запитах.
Якщо ви використовуєте Prometheus або інший інструмент із тією самою мовою запитів, наведений нижче запит PromQL повертає кількість Podʼів, які не готові:
count(kube_pod_status_ready{condition="false"}) by (namespace, pod)
Приклад: сповіщення на основі kube-state-metrics
Метрики, які генерує kube-state-metrics, також дозволяють налаштовувати сповіщення про проблеми в кластері.
Якщо ви використовуєте Prometheus або подібний інструмент із тією самою мовою правил сповіщень, наведене нижче сповіщення спрацює, якщо є Podʼи, які перебувають у стані Terminating понад 5 хвилин:
groups:- name:Pod staterules:- alert:PodsBlockedInTerminatingStateexpr:count(kube_pod_deletion_timestamp) by (namespace, pod) * count(kube_pod_status_reason{reason="NodeLost"} == 0) by (namespace, pod) > 0for:5mlabels:severity:pageannotations:summary:Pod {{$labels.namespace}}/{{$labels.pod}} blocked in Terminating state.
6.12.13 - Системні логи
Логи системних компонентів фіксують події, що відбуваються в кластері, і це може бути дуже корисно для налагодження. Ви можете налаштувати рівень деталізації логів, щоб бачити більше або менше подробиць. Логи можуть бути як грубозернистими, показуючи лише помилки в компоненті, так і дрібнозернистими, показуючи покрокове трасування подій (наприклад, логи доступу HTTP, зміни стану Podʼів, дії контролерів або рішення планувальника).
Попередження:
На відміну від описаних тут прапорців командного рядка, сам вивід логівне підпадає під гарантії стабільності API Kubernetes: окремі записи логів та їх форматування можуть змінюватися від випуску до випуску!
Klog
klog — це бібліотека логування Kubernetes. klog генерує повідомлення логів для системних компонентів Kubernetes.
Kubernetes поступово спрощує логування у своїх компонентах. Наведені нижче прапорці командного рядка klog застаріли, починаючи з Kubernetes v1.23, і вилучені в Kubernetes v1.26:
--add-dir-header
--alsologtostderr
--log-backtrace-at
--log-dir
--log-file
--log-file-max-size
--logtostderr
--one-output
--skip-headers
--skip-log-headers
--stderrthreshold
Вивід завжди записується у stderr незалежно від формату виводу. Очікується, що перенаправленням виводу займається компонент, який викликає компонент Kubernetes. Це може бути оболонка POSIX або інструмент на кшталт systemd.
У деяких випадках, наприклад у контейнері distroless або системній службі Windows, ці варіанти недоступні. Тоді можна використати бінарний файл kube-log-runner як обгортку навколо компонента Kubernetes для перенаправлення виводу. Попередньо зібраний бінарний файл входить до кількох базових образів Kubernetes під традиційною назвою /go-runner і як kube-log-runner в архівах випусків для сервера та вузлів.
Ця таблиця показує відповідність викликів kube-log-runner перенаправленню в оболонці:
Рядок повідомлення може містити перенесення рядків:
I1025 00:15:15.525108 1 example.go:79] This is a message
which has a line break.
Структуроване логування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.23
Попередження:
Міграція на структуровані повідомлення логів — поточний процес. У цій версії не всі повідомлення логів структуровані. Під час розбору файлів логів потрібно також обробляти неструктуровані повідомлення логів.
Форматування логів та серіалізація значень можуть змінюватися.
Структуроване логування додає до повідомлень логів єдину структуру, що дає змогу отримувати з них інформацію програмно. Ви можете зберігати та обробляти структуровані логи з меншими зусиллями та витратами. Код, який генерує повідомлення логу, визначає, чи використовує він традиційний неструктурований вивід klog, чи структуроване логування.
Стандартно структуровані повідомлення логів форматуються як текст у форматі, зворотно сумісному з традиційним klog:
I1025 00:15:15.525108 1 controller_utils.go:116] "Pod status updated" pod="kube-system/kubedns" status="ready"
Рядки беруться в лапки. Інші значення форматуються за допомогою %+v, через що повідомлення логів можуть продовжуватися на наступному рядку залежно від даних.
I1025 00:15:15.525108 1 example.go:116] "Example" data="This is text with a line break\nand \"quotation marks\"." someInt=1 someFloat=0.1 someStruct={StringField: First line,
second line.}
Контекстне логування
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.30
Контекстне логування побудоване на основі структурованого логування. Це переважно стосується того, як розробники використовують виклики логування: код, побудований на цій концепції, гнучкіший і підтримує додаткові сценарії використання, описані в KEP про контекстне логування.
Якщо розробники використовують у своїх компонентах додаткові функції, такі як WithValues або WithName, то записи логів міститимуть додаткову інформацію, яку передає у функції код, що їх викликає.
У Kubernetes 1.37 це керується функціональною можливістю ContextualLogging, яку стандартно ввімкнено. Інфраструктуру для цього додано у версії 1.24 без змін у компонентах. Команда component-base/logs/example показує, як використовувати нові виклики логування та як поводиться компонент, що підтримує контекстне логування.
$cd$GOPATH/src/k8s.io/kubernetes/staging/src/k8s.io/component-base/logs/example/cmd/
$ go run . --help
...
--feature-gates mapStringBool A set of key=value pairs that describe feature gates for alpha/experimental features. Options are:
AllAlpha=true|false (ALPHA - default=false)
AllBeta=true|false (BETA - default=false)
ContextualLogging=true|false (BETA - default=true)
$ go run . --feature-gates ContextualLogging=true...
I0222 15:13:31.645988 197901 example.go:54] "runtime" logger="example.myname" foo="bar" duration="1m0s"
I0222 15:13:31.646007 197901 example.go:55] "another runtime" logger="example" foo="bar" duration="1h0m0s" duration="1m0s"
Ключ logger та foo="bar" додано кодом, що викликає функцію, яка записує повідомлення runtime і значення duration="1m0s", без потреби змінювати цю функцію.
Коли контекстне логування вимкнено, WithValues і WithName нічого не роблять, а виклики логування проходять через глобальний логер klog. Тому цієї додаткової інформації більше немає у виводі логів:
$ go run . --feature-gates ContextualLogging=false...
I0222 15:14:40.497333 198174 example.go:54] "runtime" duration="1m0s"
I0222 15:14:40.497346 198174 example.go:55] "another runtime" duration="1h0m0s" duration="1m0s"
Не всі логи гарантовано записуються у форматі JSON (наприклад, під час запуску процесу). Якщо ви плануєте розбирати логи, переконайтеся, що можете обробляти й рядки логів, які не є JSON.
Назви полів та серіалізація JSON можуть змінюватися.
Прапорець --logging-format=json змінює формат логів із власного формату klog на формат JSON. Приклад логу у форматі JSON (відформатований для зручності читання):
{"ts":1580306777.04728,"v":4,"msg":"Pod status updated","pod":{"name":"nginx-1","namespace":"default"},"status":"ready"}
Ключі з особливим значенням:
ts — позначка часу у форматі Unix (обовʼязково, дійсне число)
v — рівень деталізації (лише для інформаційних повідомлень, не для повідомлень про помилки, ціле число)
err — рядок помилки (необовʼязково, рядок)
msg — повідомлення (обовʼязково, рядок)
Перелік компонентів, які наразі підтримують формат JSON:
Прапорець -v керує рівнем деталізації логів. Збільшення значення збільшує кількість подій, що логуються. Зменшення значення зменшує кількість подій, що логуються. Вищі рівні деталізації додають до логів дедалі менш важливі події. На рівні деталізації 0 логуються лише критичні події.
Розташування логів
Є два види системних компонентів: ті, що працюють у контейнері, і ті, що не працюють у контейнері. Наприклад:
Планувальник Kubernetes та kube-proxy працюють у контейнері.
На машинах із systemd kubelet і середовище виконання контейнерів пишуть у journald. В іншому разі вони пишуть у файли .log у теці /var/log. Системні компоненти всередині контейнерів завжди пишуть у файли .log у теці /var/log, оминаючи стандартний механізм логування. Як і для логів контейнерів, вам слід виконувати ротацію логів системних компонентів у теці /var/log. У кластерах Kubernetes, створених сценарієм kube-up.sh, ротацію логів налаштовано за допомогою інструмента logrotate. Інструмент logrotate виконує ротацію логів щодня або коли розмір логу перевищує 100MB.
Запит логів
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.36; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.36. It was first available in the v1.27 release.
Можливість Log Query допомагає налагоджувати проблеми на вузлах Linux і Windows. Запроваджена в Kubernetes v1.27, вона дозволяє переглядати логи сервісів, що працюють на вузлі. Щоб скористатися цією можливістю, переконайтеся, що для цільового вузла обидва параметри конфігурації kubelet enableSystemLogHandler та enableSystemLogQuery встановлено в true.
У Kubernetes v1.36 ця можливість стала стабільною, і функціональну можливість NodeLogQuery тепер зафіксовано в true, тобто її стандартно ввімкнено, а enableSystemLogHandler залишається єдиним параметром, потрібним для ввімкнення або вимкнення Log Query.
Стандартно enableSystemLogHandler має значення false, і його рекомендується залишати вимкненим, окрім випадків активного налагодження.
Попередження:
Надання дозволів на nodes/proxy (навіть лише дозволу get) також відкриває доступ до потужних API kubelet, які можна використовувати для виконання команд у будь-якому контейнері, що працює на вузлі, тому будьте обережні з керуванням цими дозволами. Докладніше дивіться в розділі Автентифікація/авторизація kubelet.
У Linux передбачається, що логи сервісів доступні через journald. У Windows передбачається, що логи сервісів доступні через провайдера логів застосунків. В обох операційних системах логи також доступні через читання файлів у /var/log/.
Якщо у вас є дозвіл на взаємодію з обʼєктами Node, ви можете спробувати цю можливість на всіх своїх вузлах або лише на їх частині. Ось приклад отримання логів сервісу kubelet із вузла:
# Отримати логи kubelet з вузла під назвою node-1.examplekubectl get --raw "/api/v1/nodes/node-1.example/proxy/logs/?query=kubelet"
Ви також можете отримувати файли, якщо вони розташовані в теці, з якої kubelet дозволяє отримувати логи. Наприклад, можна отримати лог із /var/log на вузлі Linux:
kubectl get --raw "/api/v1/nodes/<назва-вузла>/proxy/logs/?query=/<назва-файлу-логу>"
kubelet використовує евристику для отримання логів. Це допомагає, якщо ви не знаєте, чи певний системний сервіс записує логи до власного логера операційної системи, такого як journald, чи до файлу логу в /var/log/. Евристика спочатку перевіряє власний логер, а якщо він недоступний, намагається отримати перші логи з /var/log/<назва-сервісу> або /var/log/<назва-сервісу>.log чи /var/log/<назва-сервісу>/<назва-сервісу>.log.
Повний перелік параметрів, які можна використовувати:
Параметр
Опис
boot
показує повідомлення з певного завантаження системи
pattern
фільтрує записи логів за вказаним регулярним виразом, сумісним із PERL
query
вказує сервіс(и) або файли, з яких потрібно повернути логи (обовʼязково)
sinceTime
позначка часу RFC3339, починаючи з якої показувати логи (включно)
untilTime
позначка часу RFC3339, до якої показувати логи (включно)
tailLines
вказує, скільки рядків із кінця логу отримати; стандартно отримується весь лог
Приклад складнішого запиту:
# Отримати логи kubelet з вузла під назвою node-1.example, у яких є слово "error"kubectl get --raw "/api/v1/nodes/node-1.example/proxy/logs/?query=kubelet&pattern=error"
6.12.14 - Трейси для системних компонентів Kubernetes
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.27
Трейси системних компонентів реєструють затримки операцій у кластері та звʼязки між ними.
Компоненти Kubernetes надсилають трейси за допомогою протоколу OpenTelemetry з експортером gRPC, а зібрати їх і спрямувати до бекендів трасування можна за допомогою OpenTelemetry Collector.
Збір трейсів
Компоненти Kubernetes мають вбудовані експортери gRPC для OTLP, які експортують трейси через OpenTelemetry Collector або без нього.
Повний посібник зі збору трейсів і використання колектора дивіться в розділі Початок роботи з OpenTelemetry Collector. Однак є кілька особливостей, специфічних для компонентів Kubernetes.
Стандартно компоненти Kubernetes експортують трейси за допомогою експортера grpc для OTLP на порт IANA OpenTelemetry, 4317. Наприклад, якщо колектор працює як sidecar-контейнер поруч із компонентом Kubernetes, така конфігурація приймача збиратиме відрізки й записуватиме їх у стандартний вивід:
receivers:otlp:protocols:grpc:exporters:# Замініть цей експортер на експортер для вашого бекендуexporters:debug:verbosity:detailedservice:pipelines:traces:receivers:[otlp]exporters:[debug]
Щоб надсилати трейси безпосередньо до бекенду без колектора, вкажіть у полі endpoint файлу конфігурації трасування Kubernetes адресу потрібного бекенду трасування. Цей метод усуває потребу в колекторі та спрощує загальну структуру.
Для налаштування заголовків бекенду трасування, зокрема даних автентифікації, можна використовувати змінну середовища OTEL_EXPORTER_OTLP_HEADERS, дивіться Конфігурація експортера OTLP.
Крім того, для налаштування атрибутів ресурсів трейсів, таких як назва кластера Kubernetes, простір імен, назва Podʼа тощо, також можна використовувати змінну середовища OTEL_RESOURCE_ATTRIBUTES, дивіться Ресурс Kubernetes в OTLP.
Трейси компонентів
Трейси kube-apiserver
kube-apiserver генерує відрізки для вхідних HTTP-запитів, а також для вихідних запитів до вебхуків, etcd та повторно вхідних запитів. Він передає W3C Trace Context з вихідними запитами, але не використовує контекст трейса, доданий до вхідних запитів, оскільки kube-apiserver часто є публічною точкою доступу.
Увімкнення трасування в kube-apiserver
Щоб увімкнути трасування, передайте kube-apiserver файл конфігурації трасування за допомогою --tracing-config-file=<шлях-до-конфігурації>. Ось приклад конфігурації, яка записує відрізки для 1 з 10000 запитів і використовує стандартну точку доступу OpenTelemetry:
This is a stable feature in Kubernetes, and has been since version v1.34. It was first available in the v1.25 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate KubeletTracing, Kubernetes ignores it but does not report any error.
Інтерфейс CRI kubelet та його автентифіковані http-сервери інструментовано для генерації відрізків трейсів. Як і для apiserver, точку доступу та частоту відбору можна налаштувати. Поширення контексту трейсів також налаштовується. Рішення батьківського відрізка щодо відбору завжди враховується. Частота відбору з наданої конфігурації трасування застосовується до відрізків без батьківського. Якщо трасування ввімкнено без налаштованої точки доступу, використовується стандартна адреса приймача OpenTelemetry Collector "localhost:4317".
Увімкнення трасування в kubelet
Щоб увімкнути трасування, застосуйте конфігурацію трасування. Ось приклад фрагмента конфігурації kubelet, що записує відрізки для 1 з 10000 запитів і використовує стандартну точку доступу OpenTelemetry:
Якщо samplingRatePerMillion встановлено на мільйон (1000000), кожен відрізок буде надіслано до експортера.
kubelet у Kubernetes v1.37 збирає відрізки зі збору сміття, процедури синхронізації Podʼів, а також з кожного методу gRPC. kubelet передає контекст трейсів із запитами gRPC, щоб середовища виконання контейнерів з інструментуванням трейсів, такі як CRI-O та containerd, могли повʼязувати свої експортовані відрізки з контекстом трейсів від kubelet. Отримані трейси матимуть звʼязки батько-нащадок між відрізками kubelet і середовища виконання контейнерів, що дає корисний контекст під час налагодження проблем вузла.
Зверніть увагу, що експорт відрізків завжди спричиняє невеликі накладні витрати на мережу та CPU, залежно від загальної конфігурації системи. Якщо в кластері з увімкненим трасуванням виникає така проблема, помʼякшіть її, зменшивши samplingRatePerMillion або повністю вимкнувши трасування через видалення конфігурації.
Стабільність
Інструментування трасування все ще активно розробляється і може змінюватися різними способами. Це стосується назв відрізків, приєднаних атрибутів, інструментованих точок доступу тощо. Поки ця можливість не стане стабільною, гарантій зворотної сумісності для інструментування трасування немає.
Проксі/балансувальник навантаження перед одним або кількома apiserver:
наявність та реалізація різняться від кластера до кластера (наприклад, nginx)
розташований між усіма клієнтами та одним або кількома apiserver
діє як балансувальник навантаження, якщо є кілька apiserver.
Хмарні балансувальники навантаження для зовнішніх Services:
надаються деякими хмарними провайдерами (наприклад, AWS ELB, Google Cloud Load Balancer)
створюються автоматично, коли Service у Kubernetes має тип LoadBalancer
зазвичай підтримують лише UDP/TCP
підтримка SCTP залежить від реалізації балансувальника навантаження хмарного провайдера
реалізація залежить від хмарного провайдера.
Зазвичай користувачам Kubernetes не потрібно турбуватися ні про що, крім перших двох типів. За правильне налаштування решти типів зазвичай відповідає адміністратор кластера.
Запит на перенаправлення
Проксі замінили можливості перенаправлення. Перенаправлення визнано застарілими.
6.12.16 - API Priority and Fairness
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.29
Керування поведінкою API-сервера Kubernetes у ситуації перевантаження — ключове завдання адміністраторів кластера. kube-apiserver має певні засоби керування (тобто прапорці командного рядка --max-requests-inflight та --max-mutating-requests-inflight), щоб обмежити обсяг незавершеної роботи, яка приймається, запобігаючи перевантаженню й можливому збою API-сервера через потік вхідних запитів, але цих прапорців недостатньо, щоб найважливіші запити проходили в період високого навантаження.
Можливість API Priority and Fairness (APF) — це альтернатива, яка усуває згадані обмеження max-inflight. APF класифікує та ізолює запити точніше. Вона також запроваджує обмежене чергування, щоб під час дуже коротких сплесків запити не відхилялися. Запити вибираються з черг за технікою справедливого чергування, тому, наприклад, контролер, який погано поводиться, не позбавить ресурсів інші (навіть на тому самому рівні пріоритету).
Ця можливість розроблена так, щоб добре працювати зі стандартними контролерами, які використовують інформери й реагують на збої API-запитів експоненційним back-off, та з іншими клієнтами, що працюють так само.
Увага:
Деякі запити, класифіковані як «тривалі», — наприклад, віддалене виконання команд або читання кінця логів (tail), — не підпадають під фільтр API Priority and Fairness. Це також стосується прапорця --max-requests-inflight без увімкненої можливості API Priority and Fairness. API Priority and Fairness застосовується до запитів watch. Коли API Priority and Fairness вимкнено, запити watch не підпадають під обмеження --max-requests-inflight.
Увімкнення/вимкнення API Priority and Fairness
Можливість API Priority and Fairness керується прапорцем командного рядка і стандартно ввімкнена. Загальне пояснення доступних параметрів командного рядка kube-apiserver та способів їх увімкнення й вимкнення дивіться в розділі Options. Назва параметра командного рядка для APF — "--enable-priority-and-fairness". Ця можливість також використовує групу API із: (a) стабільною версією v1, запровадженою у 1.29 і стандартно ввімкненою, (b) версією v1beta3, стандартно ввімкненою і застарілою у v1.29. Ви можете вимкнути бета-версію групи API v1beta3, додавши такі прапорці командного рядка до виклику kube-apiserver:
kube-apiserver \
--runtime-config=flowcontrol.apiserver.k8s.io/v1beta3=false\
# …і інші прапорці, як завжди
Прапорець командного рядка --enable-priority-and-fairness=false вимкне можливість API Priority and Fairness.
Рекурсивні сценарії сервера
API Priority and Fairness слід використовувати обережно в рекурсивних сценаріях сервера. Це сценарії, у яких сервер A, обробляючи запит, надсилає допоміжний запит на сервер B. Сервер B може навіть зробити ще один допоміжний виклик назад до сервера A. У ситуаціях, коли контроль Priority and Fairness застосовується як до початкового запиту, так і до деяких допоміжних, незалежно від глибини рекурсії, існує небезпека інверсії пріоритетів та/або взаємоблокувань.
Один із прикладів рекурсії — коли kube-apiserver викликає вебхук допуску на сервері B, і під час обробки цього виклику сервер B робить ще один допоміжний запит назад до kube-apiserver. Інший приклад рекурсії — коли обʼєкт APIService вказує kube-apiserver делегувати запити щодо певної групи API власному зовнішньому серверу B (це одне з того, що називають «агрегацією»).
Коли відомо, що початковий запит належить до певного рівня пріоритету, а допоміжні контрольовані запити класифікуються на вищі рівні пріоритету, це одне з можливих рішень. Коли початкові запити можуть належати до будь-якого рівня пріоритету, допоміжні контрольовані запити мають бути звільнені від обмежень Priority and Fairness. Один зі способів зробити це — обʼєкти, які налаштовують класифікацію та обробку, описані нижче. Інший спосіб — повністю вимкнути Priority and Fairness на сервері B за допомогою описаних вище прийомів. Третій спосіб, найпростіший, коли сервер B не є kube-apiserver, — зібрати сервер B із вимкненим у коді Priority and Fairness.
Концепції
Можливість API Priority and Fairness складається з кількох окремих механізмів. Вхідні запити класифікуються за атрибутами запиту за допомогою FlowSchemas і призначаються рівням пріоритету. Рівні пріоритету додають певну ізоляцію завдяки окремим обмеженням паралелізму, тому запити, призначені різним рівням пріоритету, не можуть позбавити ресурсів один одного. У межах рівня пріоритету алгоритм справедливого чергування не дозволяє запитам із різних потоків позбавляти ресурсів один одного й дозволяє ставити запити в чергу, щоб сплески трафіку не спричиняли збої запитів, коли середнє навантаження прийнятно низьке.
Рівні пріоритету
Без увімкненої APF загальний паралелізм в API-сервері обмежується прапорцями kube-apiserver--max-requests-inflight та --max-mutating-requests-inflight. З увімкненою APF обмеження паралелізму, визначені цими прапорцями, сумуються, а потім сума розподіляється між налаштовуваним набором рівнів пріоритету. Кожен вхідний запит призначається одному рівню пріоритету, і кожен рівень пріоритету запускає лише стільки одночасних запитів, скільки дозволяє його власне обмеження.
Наприклад, стандартна конфігурація містить окремі рівні пріоритету для запитів виборів лідера, запитів від вбудованих контролерів і запитів від Podʼів. Це означає, що Pod, який поводиться погано й завалює API-сервер запитами, не може завадити виборам лідера чи діям вбудованих контролерів.
Обмеження паралелізму рівнів пріоритету періодично коригуються, що дозволяє недовикористаним рівням пріоритету тимчасово надавати паралелізм рівням із високим навантаженням. Ці обмеження базуються на номінальних обмеженнях і межах того, скільки паралелізму рівень пріоритету може надати та скільки може позичити; усі вони випливають з обʼєктів конфігурації, згаданих нижче.
Місця, які займає запит
Наведений вище опис керування паралелізмом — це базова модель. Запити мають різну тривалість, але в будь-який момент рахуються однаково під час порівняння з обмеженням паралелізму рівня пріоритету. У базовій моделі кожен запит займає одну одиницю паралелізму. Слово «місце» (seat) означає одну одиницю паралелізму; його навіяло те, як кожен пасажир у поїзді чи літаку займає одне з фіксованої кількості місць.
Але деякі запити займають більше ніж одне місце. Серед них запити list, які, за оцінкою сервера, повернуть велику кількість обʼєктів. Вони виявилися надзвичайно важким навантаженням для сервера. Тому сервер оцінює кількість обʼєктів, які буде повернуто, і вважає, що запит займає кількість місць, пропорційну цій оцінці.
Коригування часу виконання для запитів watch
API Priority and Fairness керує запитами watch, але це передбачає ще кілька відступів від базової поведінки. Перший стосується того, як довго запит watch вважається таким, що займає своє місце. Залежно від параметрів запиту відповідь на запит watch може починатися або не починатися зі сповіщень create для всіх відповідних наявних обʼєктів. API Priority and Fairness вважає, що запит watch звільняє своє місце, щойно цей початковий сплеск сповіщень (якщо він є) закінчився.
Звичайні сповіщення надсилаються одночасним сплеском до всіх відповідних потоків відповідей watch, коли сервер отримує сповіщення про створення, оновлення або видалення обʼєкта. Щоб врахувати цю роботу, API Priority and Fairness вважає, що кожен запит на запис займає місця ще певний час після завершення фактичного запису. Сервер оцінює кількість сповіщень, які буде надіслано, і коригує кількість місць запиту на запис і час їх зайнятості, щоб врахувати цю додаткову роботу.
Чергування
Навіть у межах рівня пріоритету може бути велика кількість різних джерел трафіку. У ситуації перевантаження важливо не дати одному потоку запитів позбавити ресурсів інші (зокрема, у відносно поширеному випадку, коли один клієнт із помилками завалює kube-apiserver запитами, такий клієнт в ідеалі взагалі не повинен помітно впливати на інших клієнтів). Для цього використовується алгоритм справедливого чергування, який обробляє запити, призначені одному рівню пріоритету. Кожен запит призначається потоку, який визначається назвою відповідної FlowSchema та розрізнювачем потоку — це або користувач, який надіслав запит, або простір імен цільового ресурсу, або нічого, — і система намагається надати приблизно однакову вагу запитам у різних потоках одного рівня пріоритету. Щоб різні екземпляри оброблялися окремо, контролери з багатьма екземплярами мають автентифікуватися з різними іменами користувачів.
Після класифікації запиту в потік API Priority and Fairness може призначити запит до черги. Для цього використовується техніка, відома як shuffle sharding, яка досить ефективно використовує черги, щоб ізолювати потоки низької інтенсивності від потоків високої інтенсивності.
Подробиці алгоритму чергування налаштовуються для кожного рівня пріоритету й дозволяють адміністраторам балансувати використання памʼяті, справедливість (властивість, за якої незалежні потоки просуваються, коли загальний трафік перевищує місткість), стійкість до сплесків трафіку та додаткову затримку через чергування.
Звільнені запити
Деякі запити вважаються настільки важливими, що на них не поширюються жодні обмеження цієї можливості. Ці винятки запобігають тому, щоб неправильно налаштоване керування потоком повністю вивело API-сервер з ладу.
Ресурси
API керування потоком використовує два види ресурсів. PriorityLevelConfigurations визначають доступні рівні пріоритету, частку доступного бюджету паралелізму, яку кожен із них може обробити, і дозволяють точно налаштовувати поведінку черг. FlowSchemas використовуються для класифікації окремих вхідних запитів, зіставляючи кожен з однією PriorityLevelConfiguration.
PriorityLevelConfiguration
PriorityLevelConfiguration представляє один рівень пріоритету. Кожна PriorityLevelConfiguration має незалежне обмеження на кількість незавершених запитів та обмеження на кількість запитів у черзі.
Номінальне обмеження паралелізму для PriorityLevelConfiguration задається не абсолютною кількістю місць, а «номінальними частками паралелізму» (nominal concurrency shares). Загальне обмеження паралелізму API-сервера розподіляється між наявними PriorityLevelConfiguration пропорційно цим часткам, що дає кожному рівню його номінальне обмеження в місцях. Це дозволяє адміністратору кластера збільшувати або зменшувати загальний обсяг трафіку до сервера, перезапускаючи kube-apiserver з іншим значенням --max-requests-inflight (або --max-mutating-requests-inflight), і максимально дозволений паралелізм усіх PriorityLevelConfiguration зросте (або зменшиться) на ту саму частку.
Увага:
У версіях до v1beta3 відповідне поле PriorityLevelConfiguration має назву "assured concurrency shares", а не "nominal concurrency shares". Також у випуску Kubernetes 1.25 та раніших періодичних коригувань не було: номінальні/гарантовані обмеження завжди застосовувалися без коригування.
Межі того, скільки паралелізму рівень пріоритету може надати та скільки може позичити, задаються в PriorityLevelConfiguration у відсотках від номінального обмеження рівня. Вони перетворюються на абсолютні кількості місць множенням на номінальне обмеження / 100.0 та округленням. Динамічно кориговане обмеження паралелізму рівня пріоритету має лежати між (a) нижньою межею: його номінальне обмеження мінус місця, які він може надати, та (b) верхньою межею: його номінальне обмеження плюс місця, які він може позичити. Під час кожного коригування динамічні обмеження визначаються так: кожен рівень пріоритету повертає надані місця, на які нещодавно зʼявився попит, а потім усі рівні спільно й справедливо відповідають на нещодавній попит на місця в межах щойно описаних меж.
Увага:
Коли можливість Priority and Fairness увімкнено, загальне обмеження паралелізму сервера дорівнює сумі --max-requests-inflight та --max-mutating-requests-inflight. Різниці між змінювальними та незмінювальними запитами більше немає; якщо ви хочете обробляти їх окремо для певного ресурсу, створіть окремі FlowSchemas, які відповідають змінювальним і незмінювальним дієсловам відповідно.
Коли обсяг вхідних запитів, призначених одній PriorityLevelConfiguration, перевищує її дозволений рівень паралелізму, поле type її специфікації визначає, що станеться із зайвими запитами. Тип Reject означає, що зайвий трафік буде негайно відхилено з помилкою HTTP 429 (Too Many Requests). Тип Queue означає, що запити понад поріг буде поставлено в чергу, а для балансування просування між потоками запитів використовуються техніки shuffle sharding і справедливого чергування.
Конфігурація чергування дозволяє налаштувати алгоритм справедливого чергування для рівня пріоритету. Подробиці алгоритму наведено в пропозиції щодо вдосконалення, а стисло:
Збільшення queues зменшує частоту зіткнень між різними потоками ціною більшого використання памʼяті. Значення 1 фактично вимикає логіку справедливого чергування, але все ще дозволяє ставити запити в чергу.
Збільшення queueLengthLimit дозволяє витримувати більші сплески трафіку без відкидання запитів ціною більшої затримки та використання памʼяті.
Зміна handSize дозволяє налаштувати ймовірність зіткнень між різними потоками та загальний паралелізм, доступний одному потоку в ситуації перевантаження.
Примітка:
Більше значення handSize зменшує ймовірність зіткнення двох окремих потоків (а отже, того, що один позбавить ресурсів інший), але збільшує ймовірність того, що невелика кількість потоків домінуватиме в apiserver. Більше значення handSize також потенційно збільшує затримку, яку може спричинити один потік із високим трафіком. Максимальна кількість запитів у черзі від одного потоку становить handSize * queueLengthLimit.
Нижче наведено таблицю з цікавим набором конфігурацій shuffle sharding, яка для кожної показує ймовірність того, що певну мишу (потік низької інтенсивності) розчавлять слони (потоки високої інтенсивності) для ілюстративного набору кількостей слонів. Цю таблицю обчислює https://play.golang.org/p/Gi0PLgVHiUg.
https://play.golang.org/p/Gi0PLgVHiUg, який обчислює цю таблицю.
Приклади конфігурацій shuffle sharding
HandSize
Черги
1 слон
4 слони
16 слонів
12
32
4.428838398950118e-09
0.11431348830099144
0.9935089607656024
10
32
1.550093439632541e-08
0.0626479840223545
0.9753101519027554
10
64
6.601827268370426e-12
0.00045571320990370776
0.49999929150089345
9
64
3.6310049976037345e-11
0.00045501212304112273
0.4282314876454858
8
64
2.25929199850899e-10
0.0004886697053040446
0.35935114681123076
8
128
6.994461389026097e-13
3.4055790161620863e-06
0.02746173137155063
7
128
1.0579122850901972e-11
6.960839379258192e-06
0.02406157386340147
7
256
7.597695465552631e-14
6.728547142019406e-08
0.0006709661542533682
6
256
2.7134626662687968e-12
2.9516464018476436e-07
0.0008895654642000348
6
512
4.116062922897309e-14
4.982983350480894e-09
2.26025764343413e-05
6
1024
6.337324016514285e-16
8.09060164312957e-11
4.517408062903668e-07
FlowSchema
FlowSchema зіставляє деякі вхідні запити й призначає їх рівню пріоритету. Кожен вхідний запит перевіряється за FlowSchemas, починаючи з тих, що мають найменше числове значення matchingPrecedence, і далі за зростанням. Перший збіг виграє.
Увага:
Для запиту має значення лише перша відповідна FlowSchema. Якщо одному вхідному запиту відповідає кілька FlowSchemas, його буде призначено на основі тієї, що має найвищий matchingPrecedence. Якщо одному запиту відповідає кілька FlowSchemas з однаковим matchingPrecedence, виграє та, що має лексикографічно менший name, але краще не покладатися на це, а подбати про те, щоб жодні дві FlowSchemas не мали однакового matchingPrecedence.
FlowSchema відповідає запиту, якщо відповідає принаймні одне з її rules. Правило відповідає, якщо запиту відповідають принаймні один з його subjectsта принаймні одне з його resourceRules або nonResourceRules (залежно від того, чи вхідний запит стосується ресурсу, чи нересурсного URL).
Для поля name у субʼєктах і полів verbs, apiGroups, resources, namespaces та nonResourceURLs ресурсних і нересурсних правил можна вказати шаблон *, щоб відповідати всім значенням цього поля, фактично прибираючи його з розгляду.
Поле distinguisherMethod.type у FlowSchema визначає, як запити, що відповідають цій схемі, розділятимуться на потоки. Це може бути ByUser, за якого один користувач не зможе позбавити інших користувачів місткості; ByNamespace, за якого запити до ресурсів в одному просторі імен не зможуть позбавити місткості запити до ресурсів в інших просторах імен; або порожнє значення (або distinguisherMethod можна взагалі пропустити), за якого всі запити, що відповідають цій FlowSchema, вважаються частиною одного потоку. Правильний вибір для FlowSchema залежить від ресурсу та вашого конкретного середовища.
Стандартні налаштування
Кожен kube-apiserver підтримує два різновиди обʼєктів конфігурації APF: обовʼязкові та рекомендовані.
Обовʼязкові обʼєкти конфігурації
Чотири обовʼязкові обʼєкти конфігурації відображають фіксовану вбудовану запобіжну поведінку. Це поведінка, яку сервери мають ще до появи цих обʼєктів, а коли ці обʼєкти існують, їх специфікації відображають цю поведінку. Ось ці чотири обовʼязкові обʼєкти.
Обовʼязковий рівень пріоритету exempt використовується для запитів, які взагалі не підлягають керуванню потоком: вони завжди запускаються негайно. Обовʼязкова FlowSchema exempt відносить усі запити з групи system:masters до цього рівня пріоритету. За потреби ви можете визначити інші FlowSchemas, які спрямовують інші запити на цей рівень пріоритету.
Обовʼязковий рівень пріоритету catch-all використовується разом з обовʼязковою FlowSchema catch-all, щоб кожен запит отримав певну класифікацію. Зазвичай не варто покладатися на цю конфігурацію catch-all; натомість за потреби створіть власні FlowSchema і PriorityLevelConfiguration типу catch-all (або використовуйте рекомендований рівень пріоритету global-default, який встановлюється стандартно). Оскільки звичайно він не має використовуватися, обовʼязковий рівень пріоритету catch-all має дуже малу частку паралелізму й не ставить запити в чергу.
Рекомендовані обʼєкти конфігурації
Рекомендовані FlowSchemas і PriorityLevelConfigurations становлять розумну стандартну конфігурацію. За бажання ви можете змінювати їх та/або створювати додаткові обʼєкти конфігурації. Якщо ваш кластер може зазнавати високого навантаження, варто подумати, яка конфігурація працюватиме найкраще.
Рекомендована конфігурація групує запити в шість рівнів пріоритету:
Рівень пріоритету node-high призначений для оновлень справності від вузлів.
Рівень пріоритету system призначений для запитів, не повʼязаних зі справністю, з групи system:nodes, тобто від kubelet, які мають зʼєднуватися з API-сервером, щоб на вузлах можна було планувати робочі навантаження.
Рівень пріоритету leader-election призначений для запитів виборів лідера від вбудованих контролерів (зокрема, запитів до endpoints, configmaps або leases, що надходять від користувачів system:kube-controller-manager чи system:kube-scheduler і ServiceAccount у просторі імен kube-system). Ці запити важливо ізолювати від іншого трафіку, оскільки збої у виборах лідера спричиняють збої та перезапуски відповідних контролерів, а це, у свою чергу, створює дорожчий трафік, коли нові контролери синхронізують свої інформери.
Рівень пріоритету workload-high призначений для інших запитів від вбудованих контролерів.
Рівень пріоритету workload-low призначений для запитів від будь-якого іншого ServiceAccount, що зазвичай охоплює всі запити від контролерів, які працюють у Podʼах.
Рівень пріоритету global-default обробляє весь інший трафік, наприклад, інтерактивні команди kubectl, запущені непривілейованими користувачами.
Рекомендовані FlowSchemas спрямовують запити на наведені вище рівні пріоритету, і тут вони не перелічені.
Підтримка обовʼязкових і рекомендованих обʼєктів конфігурації
Кожен kube-apiserver незалежно підтримує обовʼязкові та рекомендовані обʼєкти конфігурації, виконуючи початкову й періодичну обробку. Тому в ситуації із сумішшю серверів різних версій можливе постійне перезаписування (thrashing), доки різні сервери мають різні уявлення про правильний вміст цих обʼєктів.
Кожен kube-apiserver виконує початковий прохід підтримки обовʼязкових і рекомендованих обʼєктів конфігурації, а потім періодично (раз на хвилину) підтримує ці обʼєкти.
Для обовʼязкових обʼєктів конфігурації підтримка полягає в тому, щоб обʼєкт існував і, якщо існує, мав правильну специфікацію. Сервер не дозволяє створення чи оновлення зі специфікацією, яка не узгоджується із запобіжною поведінкою сервера.
Підтримка рекомендованих обʼєктів конфігурації розрахована на те, що їх специфікації можна перевизначати. Видалення, натомість, не враховується: підтримка відновить обʼєкт. Якщо рекомендований обʼєкт конфігурації вам не потрібен, його слід залишити, але задати специфікацію з мінімальними наслідками. Підтримка рекомендованих обʼєктів також розрахована на автоматичну міграцію під час розгортання нової версії kube-apiserver, хоча, можливо, з постійним перезаписуванням, доки працюють сервери різних версій.
Підтримка рекомендованого обʼєкта конфігурації полягає в його створенні зі специфікацією, рекомендованою сервером, якщо обʼєкт не існує. Якщо ж обʼєкт уже існує, поведінка підтримки залежить від того, хто контролює обʼєкт: kube-apiservers чи користувачі. У першому випадку сервер стежить, щоб специфікація обʼєкта відповідала рекомендованій сервером; у другому специфікація залишається без змін.
Щоб зʼясувати, хто контролює обʼєкт, спочатку шукається анотація з ключем apf.kubernetes.io/autoupdate-spec. Якщо така анотація є і її значення true, обʼєкт контролюють kube-apiservers. Якщо така анотація є і її значення false, обʼєкт контролюють користувачі. Якщо жодна з цих умов не виконується, перевіряється metadata.generation обʼєкта. Якщо воно дорівнює 1, обʼєкт контролюють kube-apiservers. Інакше обʼєкт контролюють користувачі. Ці правила запроваджено у випуску 1.22, а врахування metadata.generation потрібне для міграції з простішої попередньої поведінки. Користувачі, які хочуть контролювати рекомендований обʼєкт конфігурації, мають встановити його анотацію apf.kubernetes.io/autoupdate-spec у false.
Підтримка обовʼязкового або рекомендованого обʼєкта конфігурації також включає забезпечення наявності анотації apf.kubernetes.io/autoupdate-spec, яка точно відображає, чи контролюють обʼєкт kube-apiservers.
Підтримка також включає видалення обʼєктів, які не є ні обовʼязковими, ні рекомендованими, але мають анотацію apf.kubernetes.io/autoupdate-spec=true.
Звільнення перевірок справності від обмежень паралелізму
Рекомендована конфігурація не передбачає особливої обробки запитів перевірки справності до kube-apiservers від їхніх локальних kubelet, які зазвичай використовують захищений порт, але не надають облікових даних. За рекомендованої конфігурації ці запити призначаються FlowSchema global-default і відповідному рівню пріоритету global-default, де інший трафік може їх витіснити.
Якщо ви додасте наведену нижче додаткову FlowSchema, ці запити буде звільнено від обмеження частоти.
Увага:
Ця зміна також дозволяє будь-якому зловмиснику надсилати запити перевірки справності, що відповідають цій FlowSchema, у будь-якому обсязі. Якщо у вас є фільтр вебтрафіку або подібний зовнішній механізм безпеки для захисту API-сервера кластера від загального інтернет-трафіку, ви можете налаштувати правила блокування запитів перевірки справності, що надходять ззовні кластера.
У версіях Kubernetes до v1.20 мітки flow_schema та priority_level мали неузгоджені назви flowSchema та priorityLevel відповідно. Якщо ви використовуєте Kubernetes v1.19 або раніші версії, дивіться документацію для вашої версії.
Коли ви вмикаєте можливість API Priority and Fairness, kube-apiserver експортує додаткові метрики. Їх моніторинг допоможе визначити, чи не обмежує ваша конфігурація неналежним чином важливий трафік, або знайти робочі навантаження, які погано поводяться й можуть шкодити справності системи.
Рівень зрілості BETA
apiserver_flowcontrol_rejected_requests_total — це вектор лічильників (накопичувальний від запуску сервера) відхилених запитів із розбивкою за мітками flow_schema (вказує FlowSchema, що відповідала запиту), priority_level (вказує рівень, якому призначено запит) і reason. Мітка reason має одне з таких значень:
queue-full — у черзі вже забагато запитів.
concurrency-limit — PriorityLevelConfiguration налаштовано відхиляти зайві запити, а не ставити їх у чергу.
time-out — запит усе ще був у черзі, коли сплив граничний час перебування в черзі.
cancelled — запит не заблоковано від очищення (purge locked), і його вилучено з черги.
apiserver_flowcontrol_dispatched_requests_total — це вектор лічильників (накопичувальний від запуску сервера) запитів, які почали виконуватися, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_current_inqueue_requests — це вектор gauge із миттєвою кількістю запитів у черзі (що не виконуються) з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_current_executing_requests — це вектор gauge із миттєвою кількістю виконуваних запитів (що не чекають у черзі) з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_current_executing_seats — це вектор gauge із миттєвою кількістю зайнятих місць з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_request_wait_duration_seconds — це вектор гістограм часу перебування запитів у черзі з розбивкою за мітками flow_schema, priority_level та execute. Мітка execute вказує, чи почалося виконання запиту.
Примітка:
Оскільки кожна FlowSchema завжди призначає запити одній PriorityLevelConfiguration, ви можете додати гістограми всіх FlowSchemas одного рівня пріоритету, щоб отримати ефективну гістограму для запитів, призначених цьому рівню пріоритету.
apiserver_flowcontrol_nominal_limit_seats — це вектор gauge із номінальним обмеженням паралелізму кожного рівня пріоритету, обчисленим із загального обмеження паралелізму API-сервера та налаштованих номінальних часток паралелізму рівня пріоритету.
Рівень зрілості ALPHA
apiserver_current_inqueue_requests — це вектор gauge нещодавніх пікових значень кількості запитів у черзі, згрупованих за міткою request_kind, значення якої — mutating або readOnly. Ці пікові значення описують найбільше число, зафіксоване в щойно завершеному односекундному вікні. Вони доповнюють старіший вектор gauge apiserver_current_inflight_requests, який містить пікове значення кількості запитів, що активно обслуговуються, за останнє вікно.
apiserver_current_inqueue_seats — це вектор gauge із сумою за запитами в черзі найбільшої кількості місць, яку займе кожен із них, згрупованою за мітками flow_schema та priority_level.
apiserver_flowcontrol_read_vs_write_current_requests — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, кількості запитів із розбивкою за мітками phase (значення waiting та executing) та request_kind (значення mutating та readOnly). Кожне спостережуване значення — це відношення (від 0 до 1) кількості запитів до відповідного обмеження кількості запитів (обмеження обсягу черги для очікування та обмеження паралелізму для виконання).
apiserver_flowcontrol_request_concurrency_in_use — це вектор gauge із миттєвою кількістю зайнятих місць з розбивкою за priority_level та flow_schema.
apiserver_flowcontrol_priority_level_request_utilization — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, кількості запитів із розбивкою за мітками phase (значення waiting та executing) та priority_level. Кожне спостережуване значення — це відношення (від 0 до 1) кількості запитів до відповідного обмеження кількості запитів (обмеження обсягу черги для очікування та обмеження паралелізму для виконання).
apiserver_flowcontrol_priority_level_seat_utilization — це вектор гістограм спостережень, зроблених наприкінці кожної наносекунди, використання обмеження паралелізму рівня пріоритету з розбивкою за priority_level. Це використання — частка (кількість зайнятих місць) / (обмеження паралелізму). Ця метрика враховує всі етапи виконання (як звичайний, так і додаткову затримку наприкінці запису для відповідної роботи зі сповіщеннями) усіх запитів, крім WATCH; для них вона враховує лише початковий етап, на якому доставляються сповіщення про наявні обʼєкти. Кожна гістограма у векторі також має мітку phase: executing (для фази очікування обмеження місць немає).
apiserver_flowcontrol_request_queue_length_after_enqueue — це вектор гістограм довжини черг із розбивкою за priority_level та flow_schema, вибірку для якого становлять запити, поставлені в чергу. Кожен запит, що потрапляє в чергу, додає до своєї гістограми один зразок — довжину черги одразу після додавання запиту. Зверніть увагу, що це дає іншу статистику, ніж неупереджене опитування.
Примітка:
Викид у гістограмі тут означає, що, ймовірно, один потік (тобто запити одного користувача або для одного простору імен, залежно від конфігурації) завалює API-сервер запитами й зазнає тротлінгу. Якщо ж гістограма одного рівня пріоритету показує, що всі черги цього рівня довші, ніж на інших рівнях, може бути доцільно збільшити частки паралелізму цієї PriorityLevelConfiguration.
apiserver_flowcontrol_request_concurrency_limit — те саме, що й apiserver_flowcontrol_nominal_limit_seats. До запровадження позичання паралелізму між рівнями пріоритету ця метрика завжди дорівнювала apiserver_flowcontrol_current_limit_seats (якої не існувало як окремої метрики).
apiserver_flowcontrol_lower_limit_seats — це вектор gauge із нижньою межею динамічного обмеження паралелізму кожного рівня пріоритету.
apiserver_flowcontrol_upper_limit_seats — це вектор gauge із верхньою межею динамічного обмеження паралелізму кожного рівня пріоритету.
apiserver_flowcontrol_demand_seats — це вектор гістограм, що підраховує спостереження наприкінці кожної наносекунди відношення (попит на місця) / (номінальне обмеження паралелізму) для кожного рівня пріоритету. Попит на місця рівня пріоритету — це сума за запитами в черзі та запитами в початковій фазі виконання максимальної кількості місць, зайнятих у початковій і кінцевій фазах виконання запиту.
apiserver_flowcontrol_demand_seats_high_watermark — це вектор gauge із максимальним попитом на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_average — це вектор gauge із середнім за часом попитом на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_stdev — це вектор gauge зі зваженим за часом стандартним відхиленням генеральної сукупності попиту на місця для кожного рівня пріоритету за останній період коригування позичання паралелізму.
apiserver_flowcontrol_demand_seats_smoothed — це вектор gauge зі згладженим обвідним попитом на місця для кожного рівня пріоритету, визначеним під час останнього коригування паралелізму.
apiserver_flowcontrol_target_seats — це вектор gauge із цільовим значенням паралелізму для кожного рівня пріоритету, яке використовується в задачі розподілу позичання.
apiserver_flowcontrol_seat_fair_frac — це gauge із часткою справедливого розподілу, визначеною під час останнього коригування позичання.
apiserver_flowcontrol_current_limit_seats — це вектор gauge із динамічним обмеженням паралелізму для кожного рівня пріоритету, визначеним під час останнього коригування.
apiserver_flowcontrol_request_execution_seconds — це вектор гістограм фактичного часу виконання запитів з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_watch_count_samples — це вектор гістограм кількості активних запитів WATCH, що стосуються певного запису, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_work_estimated_seats — це вектор гістограм оціненої кількості місць (максимум для початкової та кінцевої стадій виконання), повʼязаних із запитами, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_request_dispatch_no_accommodation_total — це вектор лічильників кількості подій, які в принципі могли привести до запуску запиту, але не привели через брак доступного паралелізму, з розбивкою за flow_schema та priority_level.
apiserver_flowcontrol_epoch_advance_total — це вектор лічильників кількості спроб перевести лічильник прогресу рівня пріоритету назад, щоб уникнути числового переповнення, згрупований за priority_level та success.
Рекомендації щодо використання API Priority and Fairness
Коли певний рівень пріоритету перевищує дозволений паралелізм, запити можуть зазнавати більшої затримки або відкидатися з помилкою HTTP 429 (Too Many Requests). Щоб запобігти цим побічним ефектам APF, ви можете змінити робоче навантаження або скоригувати налаштування APF так, щоб місць для обслуговування ваших запитів було достатньо.
Щоб виявити, чи відкидаються запити через APF, перевірте такі метрики:
apiserver_flowcontrol_rejected_requests_total — загальна кількість відхилених запитів за FlowSchema та PriorityLevelConfiguration.
apiserver_flowcontrol_current_inqueue_requests — поточна кількість запитів у черзі за FlowSchema та PriorityLevelConfiguration.
apiserver_flowcontrol_request_wait_duration_seconds — затримка, додана до запитів, що очікують у черзі.
apiserver_flowcontrol_priority_level_seat_utilization — використання місць за PriorityLevelConfiguration.
Зміни робочого навантаження
Щоб запити не ставилися в чергу, не отримували додаткової затримки й не відкидалися через APF, ви можете оптимізувати їх так:
Зменшуйте швидкість виконання запитів. Менша кількість запитів за фіксований період означає, що в певний момент часу потрібно менше місць.
Уникайте одночасного надсилання великої кількості дорогих запитів. Запити можна оптимізувати так, щоб вони використовували менше місць або мали меншу затримку й утримували ці місця коротше. Запити list можуть займати більше 1 місця залежно від кількості обʼєктів, отриманих під час запиту. Обмеження кількості обʼєктів, що повертаються в запиті list, наприклад за допомогою поділу на сторінки (pagination), використовуватиме менше місць загалом за коротший період. Крім того, заміна запитів list запитами watch потребуватиме менших загальних часток паралелізму, оскільки запити watch займають лише 1 місце під час початкового сплеску сповіщень. Якщо використовуються потокові списки у версіях 1.27 і новіших, запити watch займатимуть під час початкового сплеску сповіщень стільки ж місць, скільки запит list, оскільки потрібно передати весь стан колекції. Зверніть увагу, що в обох випадках запит watch не утримує місць після цієї початкової фази.
Памʼятайте, що чергування чи відхилення запитів через APF може спричинити як збільшення кількості запитів, так і збільшення затримки наявних запитів. Наприклад, якщо запити, які зазвичай виконуються за 1 с, починають виконуватися за 60 с, APF може почати відхиляти запити, оскільки через цю затримку вони займають місця довше, ніж зазвичай. Якщо APF починає відхиляти запити на кількох рівнях пріоритету без значної зміни робочого навантаження, можливо, проблема в продуктивності панелі управління, а не в робочому навантаженні чи налаштуваннях APF.
Налаштування Priority and Fairness
Ви також можете змінити стандартні обʼєкти FlowSchema та PriorityLevelConfiguration або створити нові обʼєкти цих видів, щоб краще пристосувати їх до вашого робочого навантаження.
Налаштування APF можна змінити, щоб:
Надати більше місць запитам високого пріоритету.
Ізолювати необовʼязкові або дорогі запити, які вичерпали б рівень паралелізму, якби він був спільним з іншими потоками.
Надайте більше місць запитам високого пріоритету
За можливості кількість місць, доступних на всіх рівнях пріоритету конкретного kube-apiserver, можна збільшити, збільшивши значення прапорців max-requests-inflight та max-mutating-requests-inflight. Іншим варіантом є горизонтальне масштабування кількості екземплярів kube-apiserver, що збільшить загальний паралелізм на рівень пріоритету в усьому кластері за умови достатнього балансування навантаження запитів.
Ви можете створити нову FlowSchema, яка посилається на PriorityLevelConfiguration з більшим рівнем паралелізму. Ця PriorityLevelConfiguration може бути наявним або новим рівнем із власним набором номінальних часток паралелізму. Наприклад, можна додати нову FlowSchema, щоб змінити PriorityLevelConfiguration для ваших запитів із global-default на workload-low і збільшити кількість місць, доступних вашому користувачу. Створення нової PriorityLevelConfiguration зменшить кількість місць, призначених наявним рівням. Нагадаємо, що редагування стандартної FlowSchema або PriorityLevelConfiguration потребує встановлення анотації apf.kubernetes.io/autoupdate-spec у false.
Ви також можете збільшити NominalConcurrencyShares для PriorityLevelConfiguration, яка обслуговує ваші запити високого пріоритету. Або, для версій 1.26 і новіших, можна збільшити LendablePercent для конкурентних рівнів пріоритету, щоб цей рівень пріоритету мав більший пул місць, які він може позичати.
Ізолюйте необовʼязкові запити, щоб вони не позбавляли ресурсів інші потоки
Для ізоляції запитів ви можете створити FlowSchema, субʼєкт якої відповідає користувачу, що надсилає ці запити, або FlowSchema, що відповідає змісту запиту (відповідно до resourceRules). Далі цю FlowSchema можна зіставити з PriorityLevelConfiguration з малою часткою місць.
Наприклад, припустімо, що запити list для подій від Podʼів у просторі імен default використовують по 10 місць кожен і виконуються протягом 1 хвилини. Щоб ці дорогі запити не впливали на запити інших Podʼів, які використовують наявну FlowSchema service-accounts, можна застосувати наведену нижче FlowSchema, щоб ізолювати ці виклики list від інших запитів.
Приклад обʼєкта FlowSchema для ізоляції запитів list для подій:
Ця FlowSchema охоплює всі виклики list для подій, виконані стандартним ServiceAccount у просторі імен default. Пріоритет відповідності 8000 менший за значення 9000, яке використовує наявна FlowSchema service-accounts, тому ці виклики list для подій відповідатимуть list-events-default-service-account, а не service-accounts.
Для ізоляції цих запитів використовується PriorityLevelConfiguration catch-all. Рівень пріоритету catch-all має дуже малу частку паралелізму й не ставить запити в чергу.
Ви можете надсилати пропозиції та запити щодо можливостей через SIG API Machinery або канал у Slack, присвячений цій можливості.
6.12.17 - Встановлення надбудов
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Надбудови розширюють функціональність Kubernetes.
На цій сторінці перелічено деякі доступні надбудови з посиланнями на відповідні інструкції зі встановлення. Список не претендує на вичерпність.
Мережа та мережеві політики
ACI забезпечує інтегровану мережу контейнерів і мережеву безпеку з Cisco ACI.
Antrea працює на рівнях 3/4, щоб надавати мережеві сервіси та сервіси безпеки для Kubernetes, використовуючи Open vSwitch як мережеву площину даних. Antrea — це проєкт CNCF рівня Sandbox.
Calico — це провайдер мережі та мережевих політик. Calico підтримує гнучкий набір мережевих параметрів, тож ви можете вибрати найефективніший варіант для своєї ситуації, зокрема мережі без оверлею та оверлейні мережі, з BGP або без нього. Calico використовує той самий рушій для застосування мережевих політик до хостів, Podʼів і (якщо використовуються Istio та Envoy) застосунків на рівні service mesh.
Canal обʼєднує Flannel і Calico, забезпечуючи мережу та мережеві політики.
Cilium — це рішення для мережі, спостережуваності та безпеки з площиною даних на основі eBPF. Cilium надає просту пласку мережу рівня 3 з можливістю охоплення кількох кластерів у режимі нативної маршрутизації або в режимі оверлею/інкапсуляції та може застосовувати мережеві політики на рівнях L3-L7 за допомогою моделі безпеки на основі ідентичності, відокремленої від мережевої адресації. Cilium може замінити kube-proxy; він також пропонує додаткові можливості спостережуваності й безпеки, які вмикаються за бажанням. Cilium — це проєкт CNCF рівня Graduated.
CNI-Genie дозволяє Kubernetes безшовно підʼєднуватися до вибраних втулків CNI, таких як Calico, Canal, Flannel або Weave. CNI-Genie — це проєкт CNCF рівня Sandbox.
Contiv надає налаштовувану мережу (нативний L3 із BGP, оверлей із vxlan, класичний L2 і Cisco-SDN/ACI) для різних випадків використання та багатий фреймворк політик. Проєкт Contiv має повністю відкритий код. Інсталятор пропонує варіанти встановлення як на основі kubeadm, так і без нього.
Contrail, заснований на Tungsten Fabric, — це платформа з відкритим кодом для віртуалізації багатохмарних мереж і керування політиками. Contrail і Tungsten Fabric інтегровані із системами оркестрування, такими як Kubernetes, OpenShift, OpenStack і Mesos, і надають режими ізоляції для віртуальних машин, контейнерів/Podʼів і робочих навантажень на фізичному обладнанні.
Flannel — це провайдер оверлейної мережі, який можна використовувати з Kubernetes.
Gateway API — це проєкт із відкритим кодом, яким керує спільнота SIG Network, що надає виразний, розширюваний і орієнтований на ролі API для моделювання мережевої взаємодії сервісів.
Knitter — це втулок для підтримки кількох мережевих інтерфейсів у Podʼі Kubernetes.
kube-router — це готове рішення з відкритим кодом для мережі Kubernetes, метою якого є простота експлуатації та висока продуктивність. Воно використовує API Kubernetes, BGP і Golang для шляху керування та мережеві примітиви Linux (IPVS, nftables тощо) для шляху даних. Це альтернатива з низькими накладними витратами, яка використовується в k0s і k3s.
Multus — це мультивтулок для підтримки кількох мереж у Kubernetes, який підтримує всі втулки CNI (наприклад, Calico, Cilium, Contiv, Flannel), а також робочі навантаження на основі SRIOV, DPDK, OVS-DPDK і VPP у Kubernetes.
OVN-Kubernetes — це провайдер мережі для Kubernetes на основі OVN (Open Virtual Network), реалізації віртуальної мережі, що вийшла з проєкту Open vSwitch (OVS). OVN-Kubernetes надає реалізацію мережі на основі оверлею для Kubernetes, зокрема реалізацію балансування навантаження та мережевих політик на основі OVS.
Nodus — це втулок контролера CNI на основі OVN для забезпечення ланцюжків сервісних функцій (Service Function Chaining, SFC) у стилі cloud native.
NSX-T Container Plug-in (NCP) забезпечує інтеграцію між VMware NSX-T та оркестраторами контейнерів, такими як Kubernetes, а також інтеграцію між NSX-T та контейнерними платформами CaaS/PaaS, такими як Pivotal Container Service (PKS) та OpenShift.
Nuage — це платформа SDN, яка забезпечує мережу на основі політик між Podʼами Kubernetes і середовищами поза Kubernetes із моніторингом видимості та безпеки.
Romana — це мережеве рішення рівня 3 для мереж Podʼів, яке також підтримує API NetworkPolicy.
Spiderpool — це мережеве рішення базової мережі (underlay) та RDMA для Kubernetes. Spiderpool підтримується на фізичному обладнанні, віртуальних машинах і в публічних хмарних середовищах.
Terway — це набір втулків CNI на основі мережевих продуктів VPC та ECS від AlibabaCloud. Він забезпечує нативну мережу VPC і мережеві політики в середовищах AlibabaCloud.
Weave Net забезпечує мережу та мережеві політики, продовжує працювати з обох боків розділення мережі й не потребує зовнішньої бази даних.
Виявлення сервісів
CoreDNS — це гнучкий, розширюваний DNS-сервер, який можна встановити як внутрішньокластерний DNS для Podʼів.
Візуалізація та керування
Dashboard — це вебінтерфейс dashboard для Kubernetes.
Headlamp — це розширюваний інтерфейс користувача Kubernetes, який можна розгорнути в кластері або використовувати як настільний застосунок.
Інфраструктура
KubeVirt — це надбудова для запуску віртуальних машин у Kubernetes. Зазвичай працює в кластерах на фізичному обладнанні.
Кілька інших надбудов задокументовано в застарілій теці cluster/addons.
Надбудови, що добре підтримуються, мають бути вказані тут. Чекаємо на ваші PR!
6.12.18 - Координовані вибори лідера
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.33; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the CoordinatedLeaderElection feature gate for all relevant components in your cluster.
Kubernetes 1.37 містить бета-можливість, яка дозволяє компонентам панелі управління детерміновано обирати лідера через координовані вибори лідера. Це корисно для дотримання обмежень версійної розбіжності Kubernetes під час оновлення кластера. Наразі єдиною вбудованою стратегією вибору є OldestEmulationVersion, яка надає перевагу лідеру з найнижчою версією емуляції, потім за бінарною версією, а потім за позначкою часу створення.
Увімкнення координованих виборів лідера
Переконайтеся, що під час запуску API-сервера ввімкнено функціональну можливість CoordinatedLeaderElection і що ввімкнено групу API coordination.k8s.io/v1beta1.
Це можна зробити, встановивши прапорці --feature-gates="CoordinatedLeaderElection=true" та --runtime-config="coordination.k8s.io/v1beta1=true".
Конфігурація компонентів
За умови, що ви ввімкнули функціональну можливість CoordinatedLeaderElectionта групу API coordination.k8s.io/v1beta1, сумісні компоненти панелі управління автоматично використовують API LeaseCandidate і Lease, щоб обирати лідера за потреби.
У Kubernetes 1.37 два компоненти панелі управління (kube-controller-manager і kube-scheduler) автоматично використовують координовані вибори лідера, коли ввімкнено функціональну можливість і групу API.
Вибір лідера для компонентів Kubernetes
Kubernetes використовує Lease API для виборів лідера серед кількох екземплярів одного компонента панелі управління в кластері високої доступності, таких як kube-controller-manager або kube-scheduler.
Lease діє як легке розподілене блокування, збережене API-сервером Kubernetes. Всі запущені екземпляри компонента спостерігають або періодично читають відповідний обʼєкт Lease, щоб визначити, який екземпляр наразі виконує роль лідера.
ідентичність поточного лідера (наприклад, назва Podʼа або рядок на основі імені хоста).
acquireTime
час, коли було отримано лідерство.
renewTime
час останнього оновлення лідером.
leaseDurationSeconds
період дії Lease (кандидати мають чекати цей час плюс невеликий запас часу, перш ніж намагатися отримати прострочений Lease).
leaseTransitions
лічильник того, скільки разів лідерство переходило до іншого екземпляра.
Ці поля показують, який екземпляр утримує лідерство та як довго це лідерство залишається дійсним.
Коли Lease не існує або його термін дії минув (поточний час > renewTime + leaseDurationSeconds), екземпляри-кандидати намагаються оновити Lease, записавши свою ідентичність. Kubernetes покладається на оптимістичне керування паралелізмом через resourceVersion обʼєкта: через невідповідність версій під час одночасних спроб успішним є лише одне оновлення. Екземпляр, чиє оновлення прийнято, стає лідером.
Kubernetes використовує API LeaseCandidate для керування виборами лідера. Компоненти панелі управління, такі як kube-controller-manager та kube-scheduler, реєструють свою роль кандидата, створюючи обʼєкти LeaseCandidate, які відстежують усі екземпляри, що змагаються за лідерство, і містять метадані, зокрема ідентичність кандидата, бінарну версію та версію емуляції.
Під час виборів кандидати координують свої дії через спільний Lease. Панель управління Kubernetes гарантує, що лише один кандидат успішно отримує Lease і стає лідером, а всі інші залишаються послідовниками. Якщо поточний лідер не оновлює Lease протягом вибраного часу очікування, інші кандидати змагаються за лідерство й обирають нового лідера.
Після обрання лідер періодично оновлює свій Lease, змінюючи поле renewTime (наприклад, виконуючи оновлення кожні leaseDurationSeconds ÷ 2, щоб уникнути конфліктів, коли термін дії Lease ось-ось закінчиться). Поки оновлення відбуваються до закінчення терміну дії Lease, поточний екземпляр-лідер зберігає лідерство. Якщо лідер аварійно завершує роботу, стає недоступним або припиняє оновлювати Lease, термін дії цього Lease минає. Інші справні екземпляри виявляють прострочений Lease і намагаються провести нові вибори.
Цей механізм гарантує, що хоча для стабільності та відновлення може працювати кілька реплік компонента, лише один екземпляр одночасно активно виконує завдання керування, а інші залишаються в режимі очікування, стежать за Lease і готові швидко перейняти роботу в разі потреби.
6.13 - Windows у Kubernetes
Kubernetes підтримує вузли, на яких працює Microsoft Windows.
Kubernetes підтримує робочі вузли, що працюють на Linux або Microsoft Windows.
🛇 Цей елемент посилається на сторонній проєкт або продукт, який не є частиною Kubernetes. Докладніше
CNCF та її материнська організація Linux Foundation дотримуються нейтрального щодо постачальників підходу до сумісності. Ви можете приєднати свій сервер Windows до кластера Kubernetes як робочий вузол.
Застосунки Windows становлять значну частину сервісів та застосунків, що працюють у багатьох організаціях. Контейнери Windows дають змогу інкапсулювати процеси та пакувати залежності, що спрощує використання практик DevOps і дотримання патернів cloud native для застосунків Windows.
Організаціям, що інвестували в застосунки на базі Windows і Linux, не потрібно шукати окремі оркестратори для керування своїми робочими навантаженнями, що підвищує операційну ефективність їхніх розгортань незалежно від операційної системи.
Вузли Windows у Kubernetes
Щоб увімкнути оркестрування контейнерів Windows у Kubernetes, додайте вузли Windows до вашого наявного кластера Linux. Планування контейнерів Windows у Podʼах у Kubernetes подібне до планування контейнерів на базі Linux.
Щоб запускати контейнери Windows, ваш кластер Kubernetes має містити кілька операційних систем. Хоча панель управління можна запускати лише на Linux, ви можете розгортати робочі вузли, що працюють як на Windows, так і на Linux.
Вузли Windows підтримуються за умови, що операційною системою є Windows Server 2022 або Windows Server 2025.
У цьому документі термін контейнери Windows означає контейнери Windows з ізоляцією на рівні процесів. Kubernetes не підтримує запуск контейнерів Windows з ізоляцією Hyper-V.
Сумісність та обмеження
Деякі можливості вузлів доступні лише за використання певного середовища виконання контейнерів; інші недоступні на вузлах Windows, зокрема:
HugePages: не підтримуються для контейнерів Windows
Привілейовані контейнери: не підтримуються для контейнерів Windows. Контейнери HostProcess пропонують схожу функціональність.
TerminationGracePeriod: вимагає containerD
Підтримуються не всі можливості спільних просторів імен. Докладніше дивіться в розділі Сумісність API.
З точки зору API та kubectl контейнери Windows поводяться майже так само, як контейнери на базі Linux. Проте існують деякі помітні відмінності в ключовій функціональності, описані в цьому розділі.
Порівняння з Linux
Ключові елементи Kubernetes працюють у Windows так само, як і в Linux. У цьому розділі описано кілька ключових абстракцій робочих навантажень і те, як вони відображаються у Windows.
Pod — це базовий будівельний блок Kubernetes: найменша та найпростіша одиниця в обʼєктній моделі Kubernetes, яку ви створюєте або розгортаєте. Не можна розгортати контейнери Windows і Linux в одному Podʼі. Усі контейнери в Podʼі плануються на один вузол, де кожен вузол представляє певну платформу та архітектуру. З контейнерами Windows підтримуються такі можливості, властивості та події Podʼа:
Один або кілька контейнерів на Pod з ізоляцією процесів та спільним використанням томів
Поля status Podʼа
Проби готовності, життєздатності та запуску
Хуки життєвого циклу контейнера postStart та preStop
ConfigMap, Secrets: як змінні середовища або томи
Томи emptyDir
Монтування іменованих каналів хоста
Обмеження ресурсів
Поле OS:
Значення поля .spec.os.name має бути встановлено у windows, щоб вказати, що поточний Pod використовує контейнери Windows.
Якщо ви встановлюєте поле .spec.os.name у windows, ви не повинні встановлювати такі поля в .spec цього Podʼа:
У наведеному вище списку символи підстановки (*) позначають усі елементи списку. Наприклад, spec.containers[*].securityContext стосується обʼєкта SecurityContext для всіх контейнерів. Якщо вказано будь-яке з цих полів, API-сервер не прийме цей Pod.
Podʼи, ресурси робочих навантажень та Services є критично важливими елементами для керування робочими навантаженнями Windows у Kubernetes. Однак самі по собі вони недостатні для належного керування життєвим циклом робочих навантажень Windows у динамічному середовищі cloud native.
Деякі параметри командного рядка kubelet поводяться у Windows інакше, як описано нижче:
Параметр --windows-priorityclass дозволяє встановлювати пріоритет планування процесу kubelet (див. Керування ресурсами CPU)
Прапорці --kube-reserved, --system-reserved та --eviction-hard оновлюють NodeAllocatable
Виселення за допомогою --enforce-node-allocable не реалізовано
Під час роботи на вузлі Windows kubelet не має обмежень памʼяті або CPU. --kube-reserved та --system-reserved лише віднімаються від NodeAllocatable і не гарантують ресурсів для робочих навантажень. Докладніше дивіться в розділі Керування ресурсами для вузлів Windows.
Стан PIDPressure не реалізовано
kubelet не вживає дій щодо виселення через OOM
Сумісність API
Існують тонкі відмінності в роботі API Kubernetes для Windows, зумовлені ОС та середовищем виконання контейнерів. Деякі властивості робочих навантажень було розроблено для Linux, і вони не працюють у Windows.
На високому рівні відрізняються такі концепції ОС:
Ідентичність — Linux використовує ідентифікатор користувача (UID) та ідентифікатор групи (GID), які подаються як цілі числа. Імена користувачів і груп не є канонічними — це лише псевдоніми для UID+GID у /etc/groups або /etc/passwd. Windows використовує довший двійковий ідентифікатор безпеки (SID), який зберігається в базі даних Windows Security Access Manager (SAM). Ця база даних не є спільною між хостом і контейнерами або між контейнерами.
Права доступу до файлів — Windows використовує список керування доступом на основі (SID), тоді як POSIX-системи, такі як Linux, використовують бітову маску на основі дозволів обʼєкта та UID+GID, а також необовʼязкові списки керування доступом.
Шляхи до файлів — у Windows прийнято використовувати \ замість /. Бібліотеки вводу-виводу Go зазвичай приймають обидва варіанти й просто забезпечують їхню роботу, але коли ви задаєте шлях або командний рядок, що інтерпретується всередині контейнера, може знадобитися \.
Сигнали — інтерактивні застосунки Windows обробляють завершення інакше і можуть реалізовувати один або кілька таких механізмів:
UI-потік обробляє чітко визначені повідомлення, зокрема WM_CLOSE.
Консольні застосунки обробляють Ctrl-C або Ctrl-break за допомогою обробника керування (Control Handler).
Служби реєструють функцію обробника керування службою (Service Control Handler), яка може приймати коди керування SERVICE_CONTROL_STOP.
Коди виходу контейнера дотримуються тієї самої домовленості: 0 означає успіх, а ненульове значення — помилку. Конкретні коди помилок у Windows та Linux можуть відрізнятися. Однак коди виходу, які передають компоненти Kubernetes (kubelet, kube-proxy), залишаються незмінними.
Сумісність полів для специфікацій контейнера
У цьому списку наведено відмінності в роботі специфікацій контейнерів Podʼа між Windows та Linux:
Великі сторінки (huge pages) не реалізовані в середовищі виконання контейнерів Windows і недоступні. Вони потребують наявності привілею користувача, який не налаштовується для контейнерів.
requests.cpu та requests.memory — запити віднімаються від доступних ресурсів вузла, тому їх можна використовувати, щоб уникнути надмірного виділення ресурсів вузла. Проте вони не можуть гарантувати ресурси на вузлі з надмірно виділеними ресурсами. Як найкращу практику їх слід застосовувати до всіх контейнерів, якщо оператор хоче повністю уникнути надмірного виділення ресурсів.
securityContext.allowPrivilegeEscalation — неможливо у Windows; жодні можливості (capabilities) не підключені
securityContext.capabilities — можливості POSIX (capabilities) не реалізовані у Windows
securityContext.privileged — Windows не підтримує привілейовані контейнери, замість них використовуйте Контейнери HostProcess
securityContext.procMount — Windows не має файлової системи /proc
securityContext.readOnlyRootFilesystem — неможливо у Windows; для роботи реєстру та системних процесів усередині контейнера потрібен доступ на запис
securityContext.runAsGroup — неможливо у Windows, оскільки немає підтримки GID
securityContext.runAsNonRoot — це налаштування перешкоджатиме запуску контейнерів як ContainerAdministrator, який є найближчим еквівалентом користувача root у Windows.
securityContext.runAsUser — використовуйте runAsUserName замість цього
securityContext.seLinuxOptions — неможливо у Windows, оскільки SELinux специфічний для Linux
terminationMessagePath — тут є певні обмеження, оскільки Windows не підтримує зіставлення окремих файлів. Стандартне значення — /dev/termination-log, і воно працює, бо цей шлях стандартно не існує у Windows.
Сумісність полів для специфікацій Podʼа
У цьому списку наведено відмінності в роботі специфікацій Podʼа між Windows та Linux:
hostIPC та hostpid — спільне використання простору імен хоста неможливе у Windows
hostNetwork — використання мережі хоста неможливе у Windows
dnsPolicy — встановлення dnsPolicy Podʼа на ClusterFirstWithHostNet не підтримується у Windows, оскільки мережа хоста не надається. Podʼи завжди працюють з мережею контейнера.
shareProcessNamespace — це бета-можливість, яка залежить від просторів імен Linux, не реалізованих у Windows. Windows не може спільно використовувати простори імен процесів або кореневу файлову систему контейнера. Спільною може бути лише мережа.
terminationGracePeriodSeconds — це не повністю реалізовано в Docker у Windows, див. issue на GitHub. Наразі процес ENTRYPOINT отримує CTRL_SHUTDOWN_EVENT, потім Windows стандартно чекає 5 секунд і нарешті завершує всі процеси звичайним для Windows способом вимкнення. Стандартні 5 секунд насправді задані в реєстрі Windows усередині контейнера, тому їх можна перевизначити під час збирання контейнера.
volumeDevices — це бета-можливість, яка не реалізована у Windows. Windows не може підключати сирі блочні пристрої до Podʼів.
volumes
Якщо ви визначаєте том emptyDir, ви не можете встановити для нього джерело memory.
Ви не можете увімкнути mountPropagation для монтування томів, оскільки це не підтримується у Windows.
Доступ до мережі хоста
Kubernetes від v1.26 до v1.32 містив альфа-підтримку запуску Podʼів Windows у мережевому просторі імен хоста.
Kubernetes v1.37 не містить функціональної можливості WindowsHostNetwork і не підтримує запуск Podʼів Windows у мережевому просторі імен хоста.
Сумісність полів для контексту безпеки Podʼа
Лише поля securityContext.runAsNonRoot та securityContext.windowsOptions із полів securityContext Podʼа працюють у Windows.
У Podʼі Kubernetes спочатку створюється інфраструктурний контейнер, або контейнер «pause», щоб розмістити контейнер. У Linux для cgroups та просторів імен, що утворюють Pod, потрібен процес, який підтримує їхнє подальше існування; цей процес забезпечує pause. Контейнери, які належать до одного Podʼа, зокрема інфраструктурні та робочі контейнери, мають спільну мережеву кінцеву точку (та сама адреса IPv4 та/або IPv6, ті самі простори мережевих портів). Kubernetes використовує контейнери pause, щоб робочі контейнери могли аварійно завершуватися або перезапускатися без втрати мережевої конфігурації.
Kubernetes супроводжує багатоархітектурний образ із підтримкою Windows. Для Kubernetes v1.37.0 рекомендований образ pause — registry.k8s.io/pause:3.6. Вихідний код доступний на GitHub.
Microsoft супроводжує інший багатоархітектурний образ із підтримкою Linux та Windows amd64, який можна знайти як mcr.microsoft.com/oss/kubernetes/pause:3.6. Цей образ зібрано з того самого вихідного коду, що й образ, який супроводжує Kubernetes, але всі бінарні файли Windows підписані authenticode компанією Microsoft. Проєкт Kubernetes рекомендує використовувати образ, який супроводжує Microsoft, якщо ви розгортаєте у промисловому або подібному до промислового середовищі, що потребує підписаних бінарних файлів.
Із Windows працюють такі середовища виконання контейнерів:
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
ContainerD
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.20
Ви можете використовувати ContainerD версії 1.4.0+ як середовище виконання контейнерів для вузлів Kubernetes, які працюють на Windows.
На вузлах Windows діють суворі правила сумісності: версія операційної системи хоста повинна збігатися з версією операційної системи базового образу контейнера.
Для Kubernetes v1.37 сумісність операційних систем для вузлів Windows (та Podʼів) така:
Рекомендації та важливі аспекти апаратного забезпечення
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Примітка:
Наведені тут апаратні характеристики слід розглядати як розумні стандартні значення. Вони не є мінімальними вимогами чи конкретними рекомендаціями для промислових середовищ. Залежно від вимог вашого робочого навантаження ці значення може знадобитися скоригувати.
64-бітний процесор із 4 ядрами CPU або більше, здатний підтримувати віртуалізацію
Для оптимізації ресурсів системи, якщо графічний інтерфейс не потрібен, може бути краще використовувати інсталяцію Windows Server без варіанта встановлення Windows Desktop Experience, оскільки така конфігурація зазвичай звільняє більше ресурсів системи.
Оцінюючи дисковий простір для робочих вузлів Windows, врахуйте, що образи контейнерів Windows зазвичай більші за образи контейнерів Linux: розмір одного образу становить від 300 MB до понад 10 GB. Крім того, зверніть увагу, що диск C: у контейнерах Windows стандартно має віртуальний вільний розмір 20 GB: це не фактично зайнятий простір, а розмір диска, до якого може вирости один контейнер під час використання локального сховища на хості. Докладніше дивіться на сторінці Контейнери у Windows — документація про сховище контейнерів.
Отримання допомоги та усунення несправностей
Основним джерелом допомоги з усунення несправностей у вашому кластері Kubernetes має бути сторінка Усунення несправностей.
Додаткову допомогу з усунення несправностей, специфічну для Windows, наведено в цьому розділі. Логи є важливою складовою усунення несправностей у Kubernetes. Обовʼязково додавайте їх щоразу, коли звертаєтеся по допомогу до інших учасників. Дотримуйтесь інструкцій у настановах щодо збору логів від SIG Windows.
Повідомлення про проблеми та запити на нові можливості
Якщо у вас є щось схоже на помилку або ви хочете подати запит на нову можливість, дотримуйтесь настанов для учасників SIG Windows, щоб створити новий issue. Спочатку перегляньте список issues на випадок, якщо про проблему вже повідомляли, і додайте коментар про свій досвід та додаткові логи. Канал SIG Windows у Slack Kubernetes також є чудовим способом отримати початкову підтримку та ідеї щодо усунення несправностей перед створенням issue.
Перевірка правильності роботи кластера Windows
Проєкт Kubernetes надає специфікацію Windows Operational Readiness разом зі структурованим набором тестів. Цей набір поділено на дві групи тестів, базову та розширену, кожна з яких містить категорії, спрямовані на тестування конкретних областей. Його можна використовувати для перевірки всієї функціональності системи Windows та гібридної системи (разом із вузлами Linux) з повним покриттям.
Щоб налаштувати проєкт на щойно створеному кластері, дивіться інструкції в посібнику проєкту.
Інструменти розгортання
Інструмент kubeadm допомагає розгортати кластер Kubernetes, надаючи панель управління для керування кластером та вузли для запуску ваших робочих навантажень.
Проєкт Kubernetes cluster API також надає засоби для автоматизації розгортання вузлів Windows.
Інформацію про різні канали обслуговування Windows Server, зокрема їхні моделі підтримки, можна знайти на сторінці Канали обслуговування Windows Server.
6.13.2 - Посібник із запуску контейнерів Windows у Kubernetes
На цій сторінці наведено покроковий опис дій, які можна виконати, щоб запускати контейнери Windows за допомогою Kubernetes. Також на сторінці висвітлено деяку специфічну для Windows функціональність у Kubernetes.
Важливо зауважити, що створення та розгортання Services і робочих навантажень у Kubernetes відбувається майже однаково для контейнерів Linux та Windows. Команди kubectl для взаємодії з кластером ідентичні. Приклади на цій сторінці наведено, щоб ви могли швидко почати роботу з контейнерами Windows.
Цілі
Налаштувати приклад розгортання для запуску контейнерів Windows на вузлі Windows.
Перш ніж ви розпочнете
Ви вже повинні мати доступ до кластера Kubernetes, який містить робочий вузол, на якому працює Windows Server.
Початок роботи: Розгортання робочого навантаження Windows
Наведений нижче приклад файлу YAML розгортає простий вебсервер, що працює в контейнері Windows.
Створіть маніфест із назвою win-webserver.yaml з таким вмістом:
Зіставлення портів також підтримується, але для простоти в цьому прикладі порт 80 контейнера відкрито безпосередньо для Service.
Перевірте, що всі вузли справні:
kubectl get nodes
Розгорніть Service та спостерігайте за оновленнями Podʼів:
kubectl apply -f win-webserver.yaml
kubectl get pods -o wide -w
Коли Service розгорнуто правильно, обидва Podʼи позначаються як Ready. Щоб вийти з команди спостереження, натисніть Ctrl+C.
Перевірте успішність розгортання. Для перевірки:
Кілька Podʼів показуються з вузла панелі управління Linux, скористайтеся kubectl get pods
Звʼязок між вузлом і Podʼом через мережу, за допомогою curl перевірте порт 80 IP-адрес ваших Podʼів з вузла панелі управління Linux, щоб перевірити відповідь вебсервера
Звʼязок між Podʼами, пінг між Podʼами (і між хостами, якщо у вас більше одного вузла Windows) за допомогою kubectl exec
Звʼязок між Service і Podʼом, за допомогою curl перевірте віртуальну IP-адресу Service (її видно в kubectl get services) з вузла панелі управління Linux та з окремих Podʼів
Вхідне підключення, за допомогою curl перевірте NodePort з вузла панелі управління Linux або з машин поза кластером
Вихідне підключення, за допомогою curl перевірте зовнішні IP-адреси зсередини Podʼа, використовуючи kubectl exec
Примітка:
Хости контейнерів Windows не можуть отримати доступ до IP-адрес Services, запланованих на них, через поточні обмеження платформи мережевого стека Windows. Доступ до IP-адрес Services мають лише Podʼи Windows.
Спостережуваність
Збір логів робочих навантажень
Логи — важливий елемент спостережуваності; вони дозволяють користувачам отримувати інформацію про роботу робочих навантажень і є ключовою складовою усунення несправностей. Оскільки контейнери Windows та робочі навантаження всередині контейнерів Windows поводяться інакше, ніж контейнери Linux, користувачам було важко збирати логи, що обмежувало операційну видимість. Робочі навантаження Windows, наприклад, зазвичай налаштовані на логування в ETW (Event Tracing for Windows) або надсилання записів до журналу подій застосунку. LogMonitor, інструмент Microsoft з відкритим кодом, є рекомендованим способом моніторингу налаштованих джерел логів усередині контейнера Windows. LogMonitor підтримує моніторинг журналів подій, провайдерів ETW та власних логів застосунків, перенаправляючи їх у STDOUT для споживання через kubectl logs <pod>.
Дотримуйтеся інструкцій на сторінці LogMonitor на GitHub, щоб скопіювати його бінарні файли та файли конфігурації до всіх ваших контейнерів і додати необхідні точки входу, щоб LogMonitor міг надсилати ваші логи у STDOUT.
Налаштування користувача контейнера
Використання налаштовуваних імен користувачів контейнера
Контейнери Windows можна налаштувати для запуску своїх точок входу та процесів з іменами користувачів, відмінними від стандартних для образу. Дізнайтеся більше про це тут.
Керування ідентичністю робочих навантажень за допомогою службових облікових записів з груповим керуванням
Робочі навантаження контейнерів Windows можна налаштувати для використання службових облікових записів з груповим керуванням (Group Managed Service Accounts, GMSA). Службові облікові записи з груповим керуванням — це особливий тип облікових записів Active Directory, які забезпечують автоматичне керування паролями, спрощене керування іменами принципалів служб (service principal name, SPN) та можливість делегувати керування іншим адміністраторам на кількох серверах. Контейнери, налаштовані з GMSA, можуть отримувати доступ до зовнішніх ресурсів домену Active Directory, використовуючи ідентичність, налаштовану за допомогою GMSA. Дізнайтеся більше про налаштування та використання GMSA для контейнерів Windows тут.
Taints та tolerations
Користувачам необхідно використовувати певну комбінацію taints та селекторів вузлів, щоб планувати робочі навантаження Linux та Windows на вузли з відповідною ОС. Рекомендований підхід викладено нижче; одна з його головних цілей — не порушувати сумісність для наявних робочих навантажень Linux.
Ви можете (і повинні) встановлювати .spec.os.name для кожного Podʼа, щоб вказати операційну систему, для якої призначені контейнери в цьому Podʼі. Для Podʼів, які запускають контейнери Linux, встановіть .spec.os.name у linux. Для Podʼів, які запускають контейнери Windows, встановіть .spec.os.name у windows.
Планувальник не використовує значення .spec.os.name під час призначення Podʼів вузлам. Ви повинні використовувати звичайні механізми Kubernetes для призначення Podʼів вузлам, щоб панель управління вашого кластера розміщувала Podʼи на вузлах, на яких працює відповідна операційна система.
Значення .spec.os.name не впливає на планування Podʼів Windows, тому taints та tolerations (або селектори вузлів) усе ще потрібні, щоб Podʼи Windows потрапляли на відповідні вузли Windows.
Забезпечення розміщення робочих навантажень, специфічних для ОС, на відповідному хості контейнерів
Користувачі можуть забезпечити планування контейнерів Windows на відповідний хост за допомогою taints та tolerations. Усі вузли Kubernetes, на яких працює Kubernetes 1.37, мають такі стандартні мітки:
kubernetes.io/os = [windows|linux]
kubernetes.io/arch = [amd64|arm64|...]
Якщо специфікація Podʼа не вказує nodeSelector, такий як "kubernetes.io/os": windows, Pod може бути запланований на будь-який хост, Windows або Linux. Це може бути проблемою, оскільки контейнер Windows може працювати лише на Windows, а контейнер Linux — лише на Linux. Найкраща практика для Kubernetes 1.37 — використовувати nodeSelector.
Однак у багатьох випадках користувачі вже мають велику кількість розгортань для контейнерів Linux, а також екосистему готових конфігурацій, таких як Helm-чарти спільноти, і випадки програмної генерації Podʼів, наприклад за допомогою операторів. У таких ситуаціях ви можете вагатися, чи вносити зміни до конфігурації, щоб додати поля nodeSelector до всіх Podʼів і шаблонів Podʼів. Альтернативою є використання taints. Оскільки kubelet може встановлювати taints під час реєстрації, його можна легко змінити так, щоб він автоматично додавав taint лише під час роботи на Windows.
Якщо додати taint до всіх вузлів Windows, на них нічого не буде заплановано (зокрема й наявні Podʼи Linux). Щоб Pod Windows було заплановано на вузол Windows, йому потрібні і nodeSelector, і відповідна toleration для вибору Windows.
Робота з кількома версіями Windows в одному кластері
Версія Windows Server, яку використовує кожен Pod, повинна збігатися з версією вузла. Якщо ви хочете використовувати кілька версій Windows Server в одному кластері, то вам слід встановити додаткові мітки вузлів та поля nodeSelector.
Ця мітка відображає старший і молодший номери версії Windows та номер збірки, які повинні збігатися для сумісності. Ось значення для кожної версії Windows Server:
Назва продукту
Версія
Windows Server 2022
10.0.20348
Windows Server 2025
10.0.26100
Спрощення за допомогою RuntimeClass
RuntimeClass можна використовувати для спрощення роботи з taints та tolerations. Адміністратор кластера може створити обʼєкт RuntimeClass, який інкапсулює ці taints та tolerations.
Збережіть цей файл як runtimeClasses.yml. Він містить відповідний nodeSelector для ОС Windows, архітектури та версії.
Різні способи зміни поведінки вашого кластера Kubernetes.
Kubernetes добре налаштовується та розширюється. Тому потреба робити форк або надсилати патчі до коду проєкту Kubernetes виникає рідко.
У цьому посібнику описано варіанти налаштування кластера Kubernetes. Він призначений для операторів кластера, які хочуть зрозуміти, як адаптувати свій кластер Kubernetes до потреб робочого середовища. Розробникам, які є потенційними розробниками платформ чи учасниками проєкту Kubernetes, він також буде корисним як вступ до наявних точок і шаблонів розширення, а також їхніх компромісів та обмежень.
Підходи до налаштування можна загалом поділити на конфігурацію, яка передбачає лише зміну аргументів командного рядка, локальних файлів конфігурації або ресурсів API, та розширення, які передбачають запуск додаткових програм, додаткових мережевих сервісів або й того, й іншого. Цей документ присвячено переважно розширенням.
Конфігурація
Файли конфігурації та аргументи командного рядка описано в розділі Довідник онлайн-документації, де для кожного бінарного файлу є окрема сторінка:
Аргументи командного рядка та файли конфігурації не завжди можна змінити в сервісі Kubernetes, що надається провайдером, або в дистрибутиві з керованою інсталяцією. Коли їх можна змінювати, це зазвичай може робити лише оператор кластера. Крім того, вони можуть змінитися в майбутніх версіях Kubernetes, а їх налаштування може потребувати перезапуску процесів. З цих причин їх слід використовувати лише тоді, коли немає інших варіантів.
Вбудовані API політик, такі як ResourceQuota, NetworkPolicy та керування доступом на основі ролей (RBAC), є вбудованими API Kubernetes, які надають декларативно налаштовувані параметри політик. Ці API зазвичай доступні навіть у сервісах Kubernetes, що надаються провайдером, та в керованих інсталяціях Kubernetes. Вбудовані API політик дотримуються тих самих домовленостей, що й інші ресурси Kubernetes, такі як Podʼи. Коли ви використовуєте стабільний API політик, ви отримуєте переваги визначеної політики підтримки, як і для інших API Kubernetes. З цих причин, де це доречно, рекомендується використовувати API політик, а не файли конфігурації та аргументи командного рядка.
Розширення
Розширення — це програмні компоненти, які розширюють Kubernetes і глибоко з ним інтегруються. Вони адаптують його для підтримки нових типів ресурсів і нових видів обладнання.
Багато адміністраторів кластерів використовують екземпляри Kubernetes, що надаються провайдером, або встановлені з дистрибутива. У таких кластерах розширення вже попередньо встановлено. Тому більшості користувачів Kubernetes не потрібно встановлювати розширення, і ще меншій кількості потрібно створювати нові.
Шаблони розширень
Kubernetes спроєктовано для автоматизації шляхом написання клієнтських програм. Будь-яка програма, яка читає та/або записує дані в API Kubernetes, може забезпечувати корисну автоматизацію. Автоматизація може працювати як у кластері, так і поза ним. Дотримуючись настанов із цього документа, ви зможете писати високодоступну та надійну автоматизацію. Автоматизація зазвичай працює з будь-яким кластером Kubernetes, зокрема з кластерами, що надаються провайдером, і керованими інсталяціями.
Існує особливий шаблон написання клієнтських програм, які добре працюють із Kubernetes, відомий як шаблон контролера. Контролери зазвичай читають .spec обʼєкта, можливо, виконують певні дії, а потім оновлюють .status обʼєкта.
Контролер є клієнтом API Kubernetes. Коли Kubernetes є клієнтом і звертається до віддаленого сервісу, Kubernetes називає це вебхуком. Віддалений сервіс називається бекендом вебхука. Як і власні контролери, вебхуки додають точку відмови.
Примітка:
Поза Kubernetes термін «вебхук» зазвичай означає механізм асинхронних сповіщень, де виклик вебхука є одностороннім сповіщенням іншій системі чи компоненту. В екосистемі Kubernetes «вебхуками» часто називають навіть синхронні HTTP-виклики.
У моделі вебхуків Kubernetes надсилає мережевий запит до віддаленого сервісу. В альтернативній моделі бінарних втулків Kubernetes виконує бінарний файл (програму). Бінарні втулки використовуються в kubelet (наприклад, втулки сховища CSI та мережеві втулки CNI), а також у kubectl (дивіться Розширення kubectl за допомогою втулків).
Точки розширення
На цій діаграмі показано точки розширення в кластері Kubernetes та клієнти, які до нього звертаються.
Точки розширення Kubernetes
Пояснення до діаграми
Користувачі часто взаємодіють з API Kubernetes через kubectl. Втулки налаштовують поведінку клієнтів. Існують загальні розширення, які можна застосовувати до різних клієнтів, а також спеціальні способи розширення kubectl.
API-сервер обробляє всі запити. Кілька типів точок розширення в API-сервері дозволяють автентифікувати запити або блокувати їх на основі вмісту, редагувати вміст та обробляти видалення. Про це йдеться в розділі Розширення доступу до API.
API-сервер обслуговує різні види ресурсів. Вбудовані види ресурсів, такі як pods, визначені проєктом Kubernetes і не можуть бути змінені. Про розширення API Kubernetes читайте в розділі Розширення API.
Планувальник Kubernetes вирішує, на яких вузлах розмістити Podʼи. Існує кілька способів розширити планування, вони описані в розділі Розширення планувальника.
kubelet працює на серверах (вузлах) і допомагає Podʼам виглядати як віртуальні сервери з власними IP-адресами в мережі кластера. Мережеві втулки дозволяють різні реалізації мережі Podʼів.
Ви можете використовувати втулки пристроїв, щоб інтегрувати власне обладнання або інші спеціальні локальні можливості вузла і зробити їх доступними для Podʼів, що працюють у вашому кластері. kubelet містить підтримку роботи з втулками пристроїв.
kubelet також монтує та демонтує томи для Podʼів та їхніх контейнерів. Ви можете використовувати втулки сховища, щоб додати підтримку нових видів сховища та інших типів томів.
Блок-схема вибору точки розширення
Якщо ви не впевнені, з чого почати, вам може допомогти ця блок-схема. Зауважте, що деякі рішення можуть включати кілька типів розширень.
Блок-схема для вибору підходу до розширення
Розширення клієнта
Втулки для kubectl — це окремі бінарні файли, які додають або замінюють поведінку певних підкоманд. Інструмент kubectl також може інтегруватися з втулками облікових даних. Ці розширення впливають лише на локальне середовище окремого користувача, тому не можуть застосовувати політики для всього кластера.
Розгляньте можливість додавання власного ресурсу до Kubernetes, якщо ви хочете визначати нові контролери, обʼєкти конфігурації застосунків або інші декларативні API та керувати ними за допомогою інструментів Kubernetes, таких як kubectl.
Докладніше про власні ресурси дивіться на сторінці Власні ресурси.
Шар агрегації API
Ви можете використовувати шар агрегації API Kubernetes, щоб інтегрувати API Kubernetes з додатковими сервісами, такими як Metrics API.
Поєднання нових API з автоматизацією
Поєднання API власного ресурсу та циклу управління називається шаблоном контролера. Якщо ваш контролер заміняє оператора-людину, який розгортає інфраструктуру на основі бажаного стану, то він також може дотримуватися шаблону Operator. Шаблон Operator використовується для керування конкретними застосунками; зазвичай це застосунки, які зберігають стан і потребують уважного керування.
Ви також можете створювати власні API та цикли управління, які керують іншими ресурсами, такими як сховище, або визначають політики (наприклад, обмеження контролю доступу).
Зміна вбудованих ресурсів
Коли ви розширюєте API Kubernetes, додаючи власні ресурси, додані ресурси завжди потрапляють до нової групи API. Ви не можете замінити чи змінити наявні групи API. Додавання API не дає прямого впливу на поведінку наявних API (таких як Podʼи), тоді як розширення доступу до API це дозволяють.
Розширення доступу до API
Коли запит потрапляє до API-сервера Kubernetes, він спочатку автентифікується, потім авторизується, а потім проходить різні типи контролю допуску (деякі запити насправді не автентифікуються й обробляються особливим чином). Докладніше про цей процес дивіться в розділі Керування доступом до API Kubernetes.
Кожен крок процесу автентифікації/авторизації в Kubernetes пропонує точки розширення.
Автентифікація
Автентифікація зіставляє заголовки або сертифікати в усіх запитах з іменем користувача клієнта, який робить запит.
Kubernetes підтримує кілька вбудованих методів автентифікації. Він також може працювати за проксі-сервером автентифікації та надсилати токен із заголовка Authorization: до віддаленого сервісу для перевірки (вебхук автентифікації), якщо вбудовані методи вам не підходять.
Авторизація
Авторизація визначає, чи можуть певні користувачі читати, записувати та виконувати інші операції з ресурсами API. Вона працює на рівні цілих ресурсів і не розрізняє їх за довільними полями обʼєктів.
Якщо вбудовані варіанти авторизації вам не підходять, вебхук авторизації дозволяє викликати власний код, який приймає рішення про авторизацію.
Динамічний контроль допуску
Після авторизації запит, якщо це операція запису, також проходить кроки контролю допуску. На додаток до вбудованих кроків є кілька розширень:
Для прийняття довільних рішень щодо контролю допуску можна використовувати загальний вебхук допуску. Вебхуки допуску можуть відхиляти створення або оновлення. Деякі вебхуки допуску змінюють дані вхідного запиту до того, як Kubernetes обробить його далі.
Розширення інфраструктури
Втулки пристроїв
Втулки пристроїв дозволяють вузлу виявляти нові ресурси вузла (на додаток до вбудованих, таких як cpu та memory) за допомогою втулка пристроїв.
Втулки сховища
Втулки Container Storage Interface (CSI) дають змогу розширити Kubernetes підтримкою нових типів томів. Томи можуть спиратися на надійне зовнішнє сховище, надавати тимчасове сховище або пропонувати інтерфейс лише для читання до інформації, використовуючи парадигму файлової системи.
Kubernetes також містить підтримку втулків FlexVolume, які застаріли з Kubernetes v1.23 (на користь CSI).
Втулки FlexVolume дозволяють користувачам монтувати типи томів, які Kubernetes не підтримує нативно. Коли ви запускаєте Pod, який залежить від сховища FlexVolume, kubelet викликає бінарний втулок для монтування тому. Більше подробиць про цей підхід є в архівній проєктній пропозиції FlexVolume.
Вашому кластеру Kubernetes потрібен мережевий втулок, щоб мати робочу мережу Podʼів і підтримувати інші аспекти мережевої моделі Kubernetes.
Мережеві втулки дозволяють Kubernetes працювати з різними мережевими топологіями та технологіями.
Втулки kubelet image credential provider
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Постачальники облікових даних образів kubelet (kubelet image credential providers) — це втулки, які дозволяють kubelet динамічно отримувати облікові дані реєстрів образів. Ці облікові дані потім використовуються під час завантаження образів із реєстрів образів контейнерів, які відповідають конфігурації.
Втулки можуть взаємодіяти із зовнішніми сервісами або використовувати локальні файли для отримання облікових даних. Завдяки цьому kubelet не потребує статичних облікових даних для кожного реєстру й може підтримувати різні методи та протоколи автентифікації.
Планувальник — це особливий тип контролера, який стежить за Podʼами та призначає їх вузлам. Стандартний планувальник можна повністю замінити, продовжуючи використовувати інші компоненти Kubernetes, або ж одночасно запускати кілька планувальників.
Це значне завдання, і майже всі користувачі Kubernetes вважають, що їм не потрібно змінювати планувальник.
Ви можете контролювати, які втулки планування активні, або привʼязувати набори втулків до різних іменованих профілів планувальника. Ви також можете написати власний втулок, який інтегрується з однією або кількома точками розширення kube-scheduler.
Нарешті, вбудований компонент kube-scheduler підтримує вебхук, який дозволяє віддаленому HTTP-бекенду (розширенню планувальника) фільтрувати та/або пріоритизувати вузли, які kube-scheduler обирає для Podʼа.
Примітка:
За допомогою вебхука розширення планувальника ви можете впливати лише на фільтрування та пріоритизацію вузлів; інші точки розширення через інтеграцію вебхука недоступні.
Власні ресурси є розширенням API Kubernetes. Kubernetes надає два способи додавання власних ресурсів до вашого кластера:
Механізм CustomResourceDefinition (CRD) дозволяє декларативно визначити новий власний API із вказаними вами групою API, видом (kind) та схемою. Панель управління Kubernetes обслуговує ваш власний ресурс і забезпечує його зберігання. CRD дозволяють створювати нові типи ресурсів для вашого кластера без написання та запуску власного API-сервера.
Шар агрегації розташований за основним API-сервером, який діє як проксі. Така організація називається агрегацією API (AA) і дозволяє надавати спеціалізовані реалізації для ваших власних ресурсів, написавши та розгорнувши власний API-сервер. Основний API-сервер делегує вашому API-серверу запити до вказаних вами власних API, роблячи їх доступними для всіх своїх клієнтів.
6.14.1.1 - Власні ресурси
Власні ресурси — це екземпляри типів ресурсів, доданих до Kubernetes через розширення API. На цій сторінці розглядається, коли додавати власний ресурс до вашого кластера Kubernetes, а коли використовувати окремий сервіс. На ній описано два методи додавання власних ресурсів і те, як вибрати між ними.
Власні ресурси
Ресурс — це точка доступу в API Kubernetes, яка зберігає колекцію обʼєктів API певного виду; наприклад, вбудований ресурс pods містить колекцію обʼєктів Pod.
Власний ресурс — це розширення API Kubernetes, яке не обовʼязково доступне в стандартній інсталяції Kubernetes. Він є налаштуванням конкретної інсталяції Kubernetes. Однак багато основних функцій Kubernetes тепер побудовані з використанням власних ресурсів, що робить Kubernetes більш модульним.
Власні ресурси можуть зʼявлятися та зникати в запущеному кластері через динамічну реєстрацію, і адміністратори кластера можуть оновлювати власні ресурси незалежно від самого кластера. Щойно власний ресурс встановлено, користувачі можуть створювати його обʼєкти та отримувати до них доступ за допомогою kubectl, так само як для вбудованих ресурсів, таких як Pods.
Власні контролери
Самі по собі власні ресурси дозволяють зберігати та отримувати структуровані дані. Коли ви поєднуєте власний ресурс з власним контролером, власні ресурси надають справжній декларативний API.
Декларативний API Kubernetes забезпечує розділення обовʼязків. Ви оголошуєте бажаний стан вашого ресурсу. Контролер Kubernetes підтримує поточний стан обʼєктів Kubernetes відповідно до оголошеного вами бажаного стану. Це відрізняється від імперативного API, де ви вказуєте серверу, що робити.
Ви можете розгортати та оновлювати власний контролер на запущеному кластері, незалежно від життєвого циклу кластера. Власні контролери можуть працювати з будь-яким видом ресурсів, але вони особливо ефективні в поєднанні з власними ресурсами. Шаблон Operator поєднує власні ресурси та власні контролери. Ви можете використовувати власні контролери, щоб закодувати доменні знання про конкретні застосунки в розширення API Kubernetes.
Чи слід додавати власний ресурс до мого кластера Kubernetes?
Ваш API складається з відносно невеликої кількості відносно невеликих обʼєктів (ресурсів).
Обʼєкти визначають конфігурацію застосунків або інфраструктури.
Обʼєкти оновлюються відносно рідко.
Люди часто мають читати та записувати обʼєкти.
Основні операції з обʼєктами — це CRUD (створення, читання, оновлення та видалення).
Транзакції між обʼєктами не потрібні: API представляє бажаний стан, а не точний стан.
Імперативні API не є декларативними. Ознаки того, що ваш API може не бути декларативним:
Клієнт каже «зробіть це», а потім отримує синхронну відповідь, коли це виконано.
Клієнт каже «зробіть це», потім отримує ідентифікатор операції й повинен перевіряти окремий обʼєкт Operation, щоб визначити завершення запиту.
Ви говорите про віддалені виклики процедур (RPC).
Пряме зберігання великих обсягів даних; наприклад, понад кілька kB на обʼєкт або понад тисячі обʼєктів.
Потрібен доступ із високою пропускною здатністю (стабільно десятки запитів на секунду).
Зберігання даних кінцевих користувачів (наприклад, зображень, PII тощо) або інших великомасштабних даних, які обробляють застосунки.
Природні операції з обʼєктами не є CRUD-подібними.
API нелегко змоделювати як обʼєкти.
Ви вирішили подавати операції в очікуванні за допомогою ідентифікатора операції або обʼєкта операції.
Чи слід використовувати ConfigMap або власний ресурс?
Використовуйте ConfigMap, якщо виконується будь-яка з таких умов:
Існує наявний, добре задокументований формат файлу конфігурації, такий як mysql.cnf або pom.xml.
Ви хочете помістити всю конфігурацію в один ключ ConfigMap.
Файл конфігурації використовується насамперед програмою, що працює в Podʼі вашого кластера, для її самоналаштування.
Споживачі файлу воліють отримувати його через файл у Podʼі або змінну середовища в Podʼі, а не через API Kubernetes.
Ви хочете виконувати поетапні оновлення за допомогою Deployment тощо, коли файл оновлюється.
Примітка:
Використовуйте Secret для конфіденційних даних, який є схожим на ConfigMap, але безпечнішим.
Використовуйте власний ресурс (CRD або агрегований API), якщо виконується більшість із таких умов:
Ви хочете використовувати клієнтські бібліотеки та CLI Kubernetes для створення та оновлення нового ресурсу.
Ви хочете отримати підтримку на верхньому рівні від kubectl; наприклад, kubectl get my-object object-name.
Ви хочете побудувати нову автоматизацію, яка стежить за оновленнями нового обʼєкта, а потім виконує CRUD інших обʼєктів, або навпаки.
Ви хочете написати автоматизацію, яка обробляє оновлення обʼєкта.
Ви хочете використовувати домовленості API Kubernetes, такі як .spec, .status та .metadata.
Ви хочете, щоб обʼєкт був абстракцією над колекцією контрольованих ресурсів або узагальненням інших ресурсів.
Додавання власних ресурсів
Kubernetes надає два способи додавання власних ресурсів до вашого кластера:
CRD прості, і їх можна створити без будь-якого програмування.
Агрегація API потребує програмування, але дає більше контролю над поведінкою API, наприклад над тим, як зберігаються дані та як виконується перетворення між версіями API.
Kubernetes надає ці два варіанти, щоб задовольнити потреби різних користувачів, не жертвуючи ні простотою використання, ні гнучкістю.
Агреговані API — це підлеглі API-сервери, розташовані за основним API-сервером, який діє як проксі. Така організація називається агрегацією API (AA). Для користувачів API Kubernetes виглядає розширеним.
CRD дозволяють користувачам створювати нові типи ресурсів без додавання ще одного API-сервера. Щоб використовувати CRD, не потрібно розуміти агрегацію API.
Незалежно від способу встановлення нові ресурси називаються власними ресурсами (Custom Resources), щоб відрізняти їх від вбудованих ресурсів Kubernetes (таких як Podʼи).
Примітка:
Уникайте використання власного ресурсу як сховища даних застосунків, кінцевих користувачів або моніторингу: архітектурні рішення, які зберігають дані застосунків в API Kubernetes, зазвичай занадто тісно повʼязані.
З архітектурного погляду архітектури застосунків cloud native надають перевагу слабкому звʼязуванню між компонентами. Якщо частина вашого робочого навантаження потребує допоміжного сервісу для своєї звичайної роботи, запустіть цей допоміжний сервіс як компонент або використовуйте його як зовнішній сервіс. Таким чином ваше робоче навантаження не залежатиме від API Kubernetes у своїй звичайній роботі.
CustomResourceDefinitions
API-ресурс CustomResourceDefinition дозволяє вам визначати власні ресурси. Визначення обʼєкта CRD створює новий власний ресурс із вказаними вами назвою та схемою. API Kubernetes обслуговує та обробляє зберігання вашого власного ресурсу. Назва самого обʼєкта CRD має бути дійсною назвою DNS-піддомену, утвореною з визначеної назви ресурсу та його групи API; докладніше дивіться як створити CRD. Крім того, назва обʼєкта, вид/ресурс якого визначено CRD, також має бути дійсною назвою DNS-піддомену.
Це звільняє вас від написання власного API-сервера для обробки власного ресурсу, але загальний характер реалізації означає, що у вас менше гнучкості, ніж з агрегацією API-серверів.
Приклад того, як зареєструвати новий власний ресурс, працювати з екземплярами вашого нового типу ресурсу та використовувати контролер для обробки подій, дивіться в прикладі власного контролера.
Агрегація API-серверів
Зазвичай кожен ресурс в API Kubernetes потребує коду, який обробляє REST-запити та керує постійним зберіганням обʼєктів. Основний API-сервер Kubernetes обробляє вбудовані ресурси, такі як pods та services, а також може узагальнено обробляти власні ресурси через CRD.
Шар агрегації дозволяє вам надавати спеціалізовані реалізації для ваших власних ресурсів, написавши та розгорнувши власний API-сервер. Основний API-сервер делегує запити вашому API-серверу для власних ресурсів, які ви обробляєте, роблячи їх доступними для всіх своїх клієнтів.
Вибір методу для додавання власних ресурсів
CRD простіші у використанні. Агреговані API більш гнучкі. Виберіть метод, який найкраще відповідає вашим потребам.
Зазвичай CRD підходять, якщо:
У вас небагато полів
Ви використовуєте ресурс у своїй компанії або як частину невеликого проєкту з відкритим кодом (на відміну від комерційного продукту)
Порівняння простоти використання
CRD простіше створювати, ніж агреговані API.
CRD
Агрегований API
Не потребує програмування. Користувачі можуть вибрати будь-яку мову для контролера CRD.
Потребує програмування та збирання бінарного файлу й образу.
Немає додаткового сервісу для запуску; CRD обробляються API-сервером.
Додатковий сервіс, який потрібно створити і який може зазнати збою.
Після створення CRD постійна підтримка не потрібна. Усі виправлення помилок надходять разом зі звичайними оновленнями Kubernetes Master.
Може знадобитися періодично отримувати виправлення помилок з основного репозиторію (upstream), перезбирати й оновлювати агрегований API-сервер.
Не потрібно керувати кількома версіями вашого API; наприклад, коли ви контролюєте клієнта для цього ресурсу, ви можете оновлювати його синхронно з API.
Потрібно керувати кількома версіями вашого API; наприклад, коли розробляєте розширення для спільного використання.
Розширені можливості та гнучкість
Агреговані API пропонують більш розширені можливості API та налаштування інших можливостей; наприклад, рівня зберігання.
Можливість
Опис
CRD
Агрегований API
Валідація
Допомагає користувачам уникати помилок і дозволяє вам розвивати API незалежно від ваших клієнтів. Ці можливості найбільш корисні, коли є багато клієнтів, які не можуть оновитися одночасно.
Так. Більшість валідацій можна вказати в CRD за допомогою валідації OpenAPI v3.0. Функціональна можливість CRDValidationRatcheting дозволяє ігнорувати збої валідацій, вказаних за допомогою OpenAPI, якщо частина ресурсу, яка не пройшла валідацію, не змінювалася. Будь-які інші валідації підтримуються шляхом додавання валідаційного вебхука.
Так, довільні перевірки
Встановлення стандартних значень
Див. вище
Так, або через ключове слово defaultвалідації OpenAPI v3.0 (GA в 1.17), або через змінювальний вебхук (хоча він не виконуватиметься під час читання старих обʼєктів з etcd).
Так
Підтримка кількох версій
Дозволяє обслуговувати той самий обʼєкт через дві версії API. Може спростити такі зміни API, як перейменування полів. Менш важливо, якщо ви контролюєте версії клієнтів.
Якщо вам потрібне сховище з іншим режимом продуктивності (наприклад, база даних часових рядів замість сховища ключ-значення) або ізоляція для безпеки (наприклад, шифрування конфіденційної інформації тощо)
Ні
Так
Власна бізнес-логіка
Виконання довільних перевірок або дій під час створення, читання, оновлення або видалення обʼєкта
Дозволяє детальний контроль доступу, коли користувач записує розділ spec, а контролер — розділ status. Дозволяє збільшувати Generation обʼєкта під час зміни даних власного ресурсу (потребує окремих розділів spec і status у ресурсі)
Додавання операцій, відмінних від CRUD, таких як "logs" або "exec".
Ні
Так
strategic-merge-patch
Нові точки доступу підтримують PATCH з Content-Type: application/strategic-merge-patch+json. Корисно для оновлення обʼєктів, які можуть бути змінені як локально, так і сервером. Докладніше див. «Оновлення обʼєктів API на місці за допомогою kubectl patch»
Ні
Так
Protocol Buffers
Новий ресурс підтримує клієнтів, які хочуть використовувати Protocol Buffers
Ні
Так
Схема OpenAPI
Чи є схема OpenAPI (swagger) для типів, яку можна динамічно отримати із сервера? Чи захищений користувач від помилок у назвах полів завдяки тому, що можна встановлювати лише дозволені поля? Чи примусово перевіряються типи (іншими словами, чи неможливо помістити int у поле string)?
Чи накладає цей механізм розширення будь-які обмеження на назви обʼєктів, вид/ресурс яких визначено таким чином?
Так, назва такого обʼєкта має бути дійсною назвою DNS-піддомену.
Ні
Спільні можливості
Створюючи власний ресурс, через CRD або AA, ви отримуєте багато можливостей для вашого API порівняно з його реалізацією поза платформою Kubernetes:
Можливість
Що вона робить
CRUD
Нові точки доступу підтримують базові операції CRUD через HTTP та kubectl
Watch
Нові точки доступу підтримують операції Watch Kubernetes через HTTP
Discovery
Клієнти, такі як kubectl та dashboard, автоматично пропонують операції переліку, відображення та редагування полів для ваших ресурсів
json-patch
Нові точки доступу підтримують PATCH з Content-Type: application/json-patch+json
merge-patch
Нові точки доступу підтримують PATCH з Content-Type: application/merge-patch+json
HTTPS
Нові точки доступу використовують HTTPS
Вбудована автентифікація
Доступ до розширення використовує основний API-сервер (шар агрегації) для автентифікації
Вбудована авторизація
Доступ до розширення може повторно використовувати авторизацію основного API-сервера; наприклад, RBAC.
Завершувачі
Блокування видалення ресурсів розширення, доки не відбудеться зовнішнє очищення.
Вебхуки допуску
Встановлення стандартних значень і валідація ресурсів розширення під час будь-якої операції створення, оновлення або видалення.
Відображення в UI/CLI
Kubectl та dashboard можуть відображати ресурси розширення.
Невстановлене та порожнє
Клієнти можуть відрізняти невстановлені поля від полів із нульовим значенням.
Генерація клієнтських бібліотек
Kubernetes надає загальні клієнтські бібліотеки, а також інструменти для генерації клієнтських бібліотек для конкретних типів.
Мітки та анотації
Загальні метадані обʼєктів, які інструменти вміють редагувати для основних і власних ресурсів.
Підготовка до встановлення власного ресурсу
Перш ніж додавати власний ресурс до вашого кластера, слід врахувати кілька моментів.
Код сторонніх розробників і нові точки відмови
Хоча створення CRD саме по собі не додає нових точок відмови (наприклад, через запуск коду сторонніх розробників на вашому API-сервері), пакети (наприклад, Charts) або інші набори для встановлення часто містять CRD, а також Deployment з кодом сторонніх розробників, який реалізує бізнес-логіку нового власного ресурсу.
Встановлення агрегованого API-сервера завжди передбачає запуск нового Deployment.
Сховище
Власні ресурси споживають простір сховища так само, як і ConfigMaps. Створення занадто великої кількості власних ресурсів може перевантажити простір сховища вашого API-сервера.
Власні ресурси розміщуються у сховищі на основі поточної версії зберігання ресурсу, визначеної в специфікації CRD. Будь-яке оновлення власного ресурсу використовує поточну визначену версію зберігання для збереження ресурсу. Усі інші версії повинні або містити всі поля цієї версії, або визначати перетворення, щоб працювати належним чином.
Агреговані API-сервери можуть використовувати те саме сховище, що й основний API-сервер; у такому разі застосовується те саме застереження.
Автентифікація, авторизація та аудит
CRD завжди використовують ту саму автентифікацію, авторизацію та логування аудиту, що й вбудовані ресурси вашого API-сервера.
Якщо ви використовуєте RBAC для авторизації, більшість ролей RBAC не надають доступу до нових ресурсів (окрім ролі cluster-admin або будь-якої ролі, створеної з wildcard-правилами). Вам потрібно явно надати доступ до нових ресурсів. CRD та агреговані API часто постачаються з новими визначеннями ролей для типів, які вони додають.
Агреговані API-сервери можуть використовувати або не використовувати ту саму автентифікацію, авторизацію та аудит, що й основний API-сервер.
Доступ до власного ресурсу
Клієнтські бібліотеки Kubernetes можна використовувати для доступу до власних ресурсів. Не всі клієнтські бібліотеки підтримують власні ресурси. Клієнтські бібліотеки Go та Python підтримують.
Після додавання власного ресурсу ви можете отримати до нього доступ за допомогою:
kubectl
Динамічного клієнта Kubernetes.
REST-клієнта, який ви напишете.
Клієнта, згенерованого за допомогою інструментів генерації клієнтів Kubernetes (генерація клієнта є складним завданням, але деякі проєкти можуть постачати клієнта разом із CRD або AA).
Селектори полів власних ресурсів
Селектори полів дозволяють клієнтам вибирати власні ресурси за значенням одного чи кількох полів ресурсу.
Усі власні ресурси підтримують селектори полів metadata.name та metadata.namespace.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.32; (стандартно увімкнено)
More information about this feature
This is a stable feature in Kubernetes, and has been since version 1.32. It was first available in the v1.30 release.
Поле spec.versions[*].selectableFields у CustomResourceDefinition можна використовувати, щоб оголосити, які ще поля власного ресурсу можна використовувати в селекторах полів.
У цьому прикладі поля .spec.color та .spec.size додаються як поля, доступні для вибору.
Шар агрегації дозволяє розширювати Kubernetes додатковими API, понад те, що пропонують основні API Kubernetes. Додатковими API можуть бути як готові рішення, такі як сервер метрик, так і API, які ви розробляєте самостійно.
Шар агрегації працює в одному процесі з kube-apiserver. Поки ресурс розширення не зареєстровано, шар агрегації нічого не робить. Щоб зареєструвати API, ви додаєте обʼєкт APIService, який «заявляє права» на шлях URL в API Kubernetes. Після цього шар агрегації проксіюватиме все, що надсилається на цей шлях API (наприклад, /apis/myextension.mycompany.io/v1/…), до зареєстрованого APIService.
Найпоширеніший спосіб реалізації APIService — запуск API-сервера розширення в Podʼах, які працюють у вашому кластері. Якщо ви використовуєте API-сервер розширення для керування ресурсами у своєму кластері, API-сервер розширення (також пишеться як "extension-apiserver") зазвичай працює в парі з одним або кількома контролерами. Бібліотека apiserver-builder надає кістяк як для API-серверів розширення, так і для відповідних контролерів.
Затримки відповіді
API-сервери розширення повинні мати мережевий звʼязок із малою затримкою до kube-apiserver і від нього. Запити виявлення мають проходити шлях туди й назад від kube-apiserver за пʼять секунд або менше.
Якщо ваш API-сервер розширення не може відповідати цій вимозі щодо затримки, розгляньте зміни, які дозволять їй відповідати.
Дізнайтеся про концепції декларативної валідації, внутрішній механізм визначення правил валідації, який у майбутньому допоможе підтримувати валідацію під час розробки API-серверів розширення.
6.14.2 - Розширення для обчислень, сховища та мережі
Цей розділ охоплює розширення вашого кластера, які не входять до складу самого Kubernetes. Ви можете використовувати ці розширення, щоб покращити вузли у вашому кластері або надати мережеву інфраструктуру, яка зʼєднує Podʼи між собою.
Втулки Container Storage Interface (CSI) дають змогу розширити Kubernetes підтримкою нових типів томів. Томи можуть спиратися на надійне зовнішнє сховище, надавати тимчасове сховище або пропонувати інтерфейс лише для читання до інформації, використовуючи парадигму файлової системи.
Kubernetes також містить підтримку втулків FlexVolume, які застаріли з Kubernetes v1.23 (на користь CSI).
Втулки FlexVolume дозволяють користувачам монтувати типи томів, які Kubernetes не підтримує нативно. Коли ви запускаєте Pod, який залежить від сховища FlexVolume, kubelet викликає бінарний втулок для монтування тому. Більше подробиць про цей підхід є в архівній проєктній пропозиції FlexVolume.
Втулки пристроїв дозволяють вузлу виявляти нові можливості вузла (на додаток до вбудованих ресурсів вузла, таких як cpu та memory) і надавати ці власні локальні можливості вузла Podʼам, які їх запитують.
Мережеві втулки дозволяють Kubernetes працювати з різними мережевими топологіями та технологіями. Вашому кластеру Kubernetes потрібен мережевий втулок, щоб мати робочу мережу Podʼів і підтримувати інші аспекти мережевої моделі Kubernetes.
Kubernetes 1.37 сумісний із мережевими втулками CNI.
6.14.2.1 - Мережеві втулки
Kubernetes (з версії 1.3 до останньої 1.37 і, ймовірно, надалі) дозволяє використовувати втулки Container Network Interface (CNI) для мережі кластера. Ви повинні використовувати втулок CNI, сумісний з вашим кластером, який відповідає вашим потребам. У ширшій екосистемі Kubernetes доступні різні втулки (як з відкритим, так і із закритим кодом).
Ви повинні використовувати втулок CNI, сумісний зі специфікацією CNI v0.4.0 або новішими випусками. Проєкт Kubernetes рекомендує використовувати втулок, сумісний зі специфікацією CNI v1.0.0 (втулки можуть бути сумісними з кількома версіями специфікації).
Встановлення
Середовище виконання контейнерів (Container Runtime) у контексті мережі — це демон на вузлі, налаштований для надання сервісів CRI для kubelet. Зокрема, середовище виконання контейнерів повинно бути налаштоване на завантаження втулків CNI, необхідних для реалізації мережевої моделі Kubernetes.
Примітка:
До Kubernetes 1.24 втулками CNI також можна було керувати через kubelet за допомогою параметрів командного рядка cni-bin-dir та network-plugin. Ці параметри командного рядка було вилучено в Kubernetes 1.24, і керування CNI більше не входить до сфери відповідальності kubelet.
Конкретну інформацію про те, як середовище виконання контейнерів керує втулками CNI, дивіться в документації цього середовища виконання контейнерів, наприклад:
Конкретну інформацію про те, як встановити втулок CNI та керувати ним, дивіться в документації цього втулка або мережевого провайдера.
Вимоги до мережевих втулків
Loopback CNI
Крім втулка CNI, встановленого на вузлах для реалізації мережевої моделі Kubernetes, Kubernetes також вимагає, щоб середовища виконання контейнерів надавали інтерфейс loopback lo, який використовується для кожної пісочниці (пісочниці Podʼів, пісочниці віртуальних машин тощо). Реалізувати інтерфейс loopback можна, повторно використавши втулок CNI loopback або розробивши для цього власний код (дивіться цей приклад від CRI-O).
Підтримка hostPort
Мережевий втулок CNI підтримує hostPort. Ви можете використовувати офіційний втулок portmap, який пропонує команда втулків CNI, або власний втулок із функціональністю portMapping.
Якщо ви хочете увімкнути підтримку hostPort, ви повинні вказати portMappings capability у своєму cni-conf-dir. Наприклад:
Мережевий втулок CNI також підтримує формування вхідного та вихідного трафіку Podʼів. Ви можете використовувати офіційний втулок bandwidth, який пропонує команда втулків CNI, або власний втулок із функціональністю контролю пропускної здатності.
Якщо ви хочете увімкнути підтримку формування трафіку, ви повинні додати втулок bandwidth до файлу конфігурації CNI (стандартно /etc/cni/net.d) і переконатися, що його бінарний файл є у вашій теці бінарних файлів CNI (стандартно /opt/cni/bin).
Втулки пристроїв дозволяють налаштувати кластер із підтримкою пристроїв або ресурсів, які потребують специфічного для постачальника налаштування, наприклад GPU, NIC, FPGA або енергонезалежної основної памʼяті.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Kubernetes надає фреймворк втулків пристроїв, який ви можете використовувати для оголошення системних апаратних ресурсів для Kubelet.
Замість того, щоб змінювати код самого Kubernetes, постачальники можуть реалізувати втулок пристроїв, який ви розгортаєте вручну або як DaemonSet. До цільових пристроїв належать GPU, високопродуктивні NIC, FPGA, адаптери InfiniBand та інші подібні обчислювальні ресурси, які можуть потребувати специфічної для постачальника ініціалізації та налаштування.
Реєстрація втулка пристроїв
kubelet надає сервіс gRPC Registration:
service Registration {
rpc Register(RegisterRequest) returns (Empty) {}
}
Втулок пристроїв може зареєструвати себе в kubelet через цей сервіс gRPC. Під час реєстрації втулок пристроїв повинен надіслати:
Назву свого Unix-сокета.
Версію API втулків пристроїв, для якої його було зібрано.
ResourceName, який він хоче оголошувати. Тут ResourceName повинен відповідати схемі іменування розширених ресурсів у вигляді vendor-domain/resourcetype. (Наприклад, NVIDIA GPU оголошується як nvidia.com/gpu.)
Після успішної реєстрації втулок пристроїв надсилає kubelet список пристроїв, якими він керує, і тоді kubelet відповідає за оголошення цих ресурсів API-серверу як частини оновлення стану вузла. Наприклад, після того як втулок пристроїв зареєструє hardware-vendor.example/foo в kubelet і повідомить про два справні пристрої на вузлі, статус вузла оновлюється, щоб оголосити, що на вузлі встановлено 2 пристрої "Foo" і вони доступні.
Після цього користувачі можуть запитувати пристрої як частину специфікації Podʼа (див. container). Запит розширених ресурсів схожий на те, як ви керуєте запитами та обмеженнями для інших ресурсів, з такими відмінностями:
Розширені ресурси підтримуються лише як цілочисельні ресурси, і для них неможливий overcommit.
Пристрої не можна спільно використовувати між контейнерами.
Приклад
Припустимо, що в кластері Kubernetes працює втулок пристроїв, який оголошує ресурс hardware-vendor.example/foo на певних вузлах. Ось приклад Podʼа, який запитує цей ресурс для запуску демонстраційного робочого навантаження:
---apiVersion:v1kind:Podmetadata:name:demo-podspec:containers:- name:demo-container-1image:registry.k8s.io/pause:3.8resources:limits:hardware-vendor.example/foo:2## Цей Pod потребує 2 пристроїв hardware-vendor.example/foo# і може бути запланований лише на вузол, який може задовольнити# цю потребу.## Якщо на вузлі доступно більше 2 таких пристроїв, то# залишок буде доступний для використання іншими Podʼами.
Реалізація втулка пристроїв
Загальний робочий процес втулка пристроїв складається з таких кроків:
Ініціалізація. Під час цієї фази втулок пристроїв виконує специфічні для постачальника ініціалізацію та налаштування, щоб пристрої перебували в стані готовності.
Втулок запускає сервіс gRPC з Unix-сокетом за шляхом хоста /var/lib/kubelet/device-plugins/ (цей шлях жорстко закодовано, і на нього не впливають --root-dir kubelet або будь-яка інша конфігурація), який реалізує такі інтерфейси:
service DevicePlugin {
// GetDevicePluginOptions повертає параметри для передавання менеджеру пристроїв.
rpc GetDevicePluginOptions(Empty) returns (DevicePluginOptions) {}
// ListAndWatch повертає потік списку пристроїв
// Кожного разу, коли змінюється стан пристрою або пристрій зникає, ListAndWatch
// повертає новий список
rpc ListAndWatch(Empty) returns (stream ListAndWatchResponse) {}
// Allocate викликається під час створення контейнера, щоб втулок
// пристроїв міг виконати операції, специфічні для пристрою, і повідомити kubelet
// про кроки, потрібні, щоб зробити пристрій доступним у контейнері
rpc Allocate(AllocateRequest) returns (AllocateResponse) {}
// GetPreferredAllocation повертає набір пріоритетних пристроїв для виділення
// зі списку доступних. Не гарантується, що отримане пріоритетне виділення
// буде тим, яке зрештою виконає devicemanager. Воно лише допомагає devicemanager
// приймати обґрунтованіші рішення про виділення, коли це можливо.
rpc GetPreferredAllocation(PreferredAllocationRequest) returns (PreferredAllocationResponse) {}
// PreStartContainer викликається, якщо це вказано втулком пристроїв під час фази реєстрації,
// перед кожним запуском контейнера. Втулок пристроїв може виконати специфічні для пристрою операції,
// такі як скидання пристрою перед наданням пристроїв контейнеру.
rpc PreStartContainer(PreStartContainerRequest) returns (PreStartContainerResponse) {}
}
Примітка:
Втулки не зобовʼязані надавати корисні реалізації GetPreferredAllocation() або PreStartContainer(). Прапорці, що вказують на доступність цих викликів, якщо такі є, слід встановлювати в повідомленні DevicePluginOptions, яке повертає виклик GetDevicePluginOptions(). kubelet завжди викликатиме GetDevicePluginOptions(), щоб дізнатися, які необовʼязкові функції доступні, перш ніж викликати будь-яку з них безпосередньо.
Втулок реєструється в kubelet через Unix-сокет за шляхом хоста /var/lib/kubelet/device-plugins/kubelet.sock.
Примітка:
Послідовність робочого процесу є важливою. Для успішної реєстрації втулок МАЄ почати обслуговування сервісу gRPC до реєстрації в kubelet.
Після успішної реєстрації втулок пристроїв працює в режимі обслуговування, під час якого він постійно відстежує справність пристроїв і повідомляє kubelet про будь-які зміни стану пристрою. Він також відповідає за обслуговування запитів gRPC Allocate. Під час Allocate втулок пристроїв може виконувати підготовку, специфічну для пристрою; наприклад, очищення GPU або ініціалізацію QRNG. Якщо операції успішні, втулок пристроїв повертає AllocateResponse, який містить конфігурації середовища виконання контейнерів для доступу до виділених пристроїв. kubelet передає цю інформацію середовищу виконання контейнерів.
AllocateResponse містить нуль або більше обʼєктів ContainerAllocateResponse. У них втулок пристроїв визначає зміни, які потрібно внести у визначення контейнера, щоб надати доступ до пристрою. Ці зміни включають:
Обробка повних назв пристроїв CDI менеджером пристроїв потребує, щоб функціональну можливість DevicePluginCDIDevices було увімкнено і для kubelet, і для kube-apiserver. Її було додано як альфа-можливість у Kubernetes v1.28, вона перейшла до бета у v1.29 і до GA у v1.31.
Обробка перезапусків kubelet
Очікується, що втулок пристроїв виявлятиме перезапуски kubelet і повторно реєструватиметься в новому екземплярі kubelet. Новий екземпляр kubelet під час запуску видаляє всі наявні Unix-сокети в /var/lib/kubelet/device-plugins (жорстко закодований шлях для втулків пристроїв). Втулок пристроїв може відстежувати видалення свого Unix-сокета й повторно реєструватися після такої події.
Втулок пристроїв та несправні пристрої
Бувають випадки, коли пристрої виходять з ладу або вимикаються. Обовʼязок втулка пристроїв у такому випадку — повідомити kubelet про ситуацію за допомогою API ListAndWatchResponse.
Після того як пристрій позначено як несправний, kubelet зменшить кількість доступних для розподілу одиниць цього ресурсу на вузлі, щоб показати, скільки пристроїв можна використовувати для планування нових Podʼів. Кількість місткості для цього ресурсу не зміниться.
Podʼи, які були призначені несправним пристроям, і далі залишатимуться призначеними цьому пристрою. Зазвичай код, що покладається на пристрій, почне збоїти, і Pod може перейти у фазу Failed, якщо restartPolicy для Podʼа не був Always, а інакше увійти в цикл збоїв.
До Kubernetes v1.31, щоб дізнатися, чи повʼязаний Pod із несправним пристроєм, потрібно було використовувати PodResources API.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.36; (стандартно увімкнено)
Коли функціональна можливість ResourceHealthStatus увімкнена (бета, стандартно увімкнена з v1.36), до статусу кожного контейнера в .status кожного Podʼа додається поле allocatedResourcesStatus. Поле allocatedResourcesStatus надає інформацію про справність кожного пристрою, призначеного контейнеру. Кожен запис про справність ресурсу може містити необовʼязкове поле message з додатковим зрозумілим для людини контекстом про стан справності, наприклад подробиці помилок або причини відмови.
Для Podʼа, що завершився збоєм, або коли ви підозрюєте несправність, ви можете використовувати цей статус, щоб зрозуміти, чи може поведінка Podʼа бути повʼязана зі збоєм пристрою. Наприклад, якщо прискорювач повідомляє про перегрів, поле allocatedResourcesStatus може про це повідомити.
Розгортання втулка пристроїв
Ви можете розгорнути втулок пристроїв як DaemonSet, як пакунок для операційної системи вузла або вручну.
Канонічна тека /var/lib/kubelet/device-plugins (жорстко закодована в kubelet) потребує привілейованого доступу, тому втулок пристроїв повинен працювати у привілейованому контексті безпеки. Якщо ви розгортаєте втулок пристроїв як DaemonSet, теку /var/lib/kubelet/device-plugins потрібно змонтувати як Том у PodSpec втулка.
Якщо ви обираєте підхід із DaemonSet, ви можете покластися на Kubernetes, щоб розміщувати Pod втулка пристроїв на вузлах, перезапускати Pod демона після збою та допомагати автоматизувати оновлення.
Сумісність API
Раніше схема керування версіями вимагала, щоб версія API втулків пристроїв точно відповідала версії kubelet. Відтоді як у v1.12 ця можливість перейшла до бета, це більше не є жорсткою вимогою. API має версії й залишається стабільним із переходу цієї можливості до бета. Завдяки цьому оновлення kubelet мають бути безшовними, але до стабілізації в API все ще можуть відбуватися зміни, тож не гарантовано, що оновлення нічого не зламають.
Примітка:
Хоча компонент Kubernetes Device Manager є загальнодоступною можливістю, API втулків пристроїв не є стабільним. Інформацію про API втулків пристроїв та сумісність версій дивіться на сторінці Версії API втулків пристроїв.
Як проєкт, Kubernetes рекомендує розробникам втулків пристроїв:
Стежити за змінами API втулків пристроїв у майбутніх випусках.
Підтримувати кілька версій API втулків пристроїв для зворотної та прямої сумісності.
Щоб запускати втулки пристроїв на вузлах, які потрібно оновити до випуску Kubernetes з новішою версією API втулків пристроїв, оновіть свої втулки пристроїв до підтримки обох версій, перш ніж оновлювати ці вузли. Такий підхід забезпечить безперервну роботу виділення пристроїв під час оновлення.
Моніторинг ресурсів втулка пристроїв
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.28
Для моніторингу ресурсів, наданих втулками пристроїв, агенти моніторингу повинні мати змогу виявляти набір пристроїв, які використовуються на вузлі, та отримувати метадані, що описують, з яким контейнером має бути повʼязана метрика. Метрики Prometheus, які надають агенти моніторингу пристроїв, мають відповідати настановам щодо інструментування Kubernetes, ідентифікуючи контейнери за допомогою міток prometheus pod, namespace та container.
kubelet надає сервіс gRPC для виявлення пристроїв, що використовуються, та надання метаданих про ці пристрої:
// PodResourcesLister — це сервіс, який надається kubelet, який надає інформацію про
// ресурси вузла, використані контейнерами та Podʼами на вузлі
service PodResourcesLister {
rpc List(ListPodResourcesRequest) returns (ListPodResourcesResponse) {}
rpc GetAllocatableResources(AllocatableResourcesRequest) returns (AllocatableResourcesResponse) {}
rpc Get(GetPodResourcesRequest) returns (GetPodResourcesResponse) {}
}
Точка доступу gRPC List
Точка доступу List надає інформацію про ресурси запущених Podʼів із такими подробицями, як ідентифікатори виключно виділених CPU, ідентифікатор пристрою, яким його повідомили втулки пристроїв, та ідентифікатор вузла NUMA, де виділено ці пристрої. Також для машин на базі NUMA вона містить інформацію про памʼять і великі сторінки (hugepages), зарезервовані для контейнера.
Починаючи з Kubernetes v1.27, точка доступу List може надавати інформацію про ресурси запущених Podʼів, виділені в ResourceClaims через API DynamicResourceAllocation. Починаючи з Kubernetes v1.34, ця можливість стандартно увімкнена.
// ListPodResourcesResponse — це відповідь, повернута функцією List
message ListPodResourcesResponse {
repeated PodResources pod_resources = 1;
}
// PodResources містить інформацію про ресурси вузла, призначені для Podʼа
message PodResources {
string name = 1;
string namespace = 2;
repeated ContainerResources containers = 3;
}
// ContainerResources містить інформацію про ресурси, призначені для контейнера
message ContainerResources {
string name = 1;
repeated ContainerDevices devices = 2;
repeated int64 cpu_ids = 3;
repeated ContainerMemory memory = 4;
repeated DynamicResource dynamic_resources = 5;
}
// ContainerMemory містить інформацію про памʼять та великі сторінки, призначені для контейнера
message ContainerMemory {
string memory_type = 1;
uint64 size = 2;
TopologyInfo topology = 3;
}
// Topology описує апаратну топологію ресурсу
message TopologyInfo {
repeated NUMANode nodes = 1;
}
// NUMA представлення NUMA-вузла
message NUMANode {
int64 ID = 1;
}
// ContainerDevices містить інформацію про пристрої, призначені для контейнера
message ContainerDevices {
string resource_name = 1;
repeated string device_ids = 2;
TopologyInfo topology = 3;
}
// DynamicResource містить інформацію про пристрої, призначені для контейнера за допомогою Dynamic Resource Allocation
message DynamicResource {
string class_name = 1;
string claim_name = 2;
string claim_namespace = 3;
repeated ClaimResource claim_resources = 4;
}
// ClaimResource містить інформацію про ресурси у втулках
message ClaimResource {
repeated CDIDevice cdi_devices = 1 [(gogoproto.customname) = "CDIDevices"];
}
// CDIDevice визначає інформацію про пристрій CDI
message CDIDevice {
// Повністю кваліфіковане імʼя пристрою CDI
// наприклад: vendor.com/gpu=gpudevice1
// див. більше деталей в специфікації CDI:
// https://github.com/container-orchestrated-devices/container-device-interface/blob/main/SPEC.md
string name = 1;
}
Примітка:
cpu_ids у ContainerResources у точці доступу List відповідають виключно виділеним CPU, призначеним певному контейнеру. Якщо мета — оцінити CPU, які належать до спільного пулу, точку доступу List потрібно використовувати разом із точкою доступу GetAllocatableResources, як пояснено нижче:
Викличте GetAllocatableResources, щоб отримати список усіх доступних для розподілу CPU
Викличте GetCpuIds для всіх ContainerResources у системі
Відніміть усі CPU з викликів GetCpuIds від результату виклику GetAllocatableResources
Точка доступу gRPC GetAllocatableResources
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.28
GetAllocatableResources надає інформацію про ресурси, початково доступні на робочому вузлі. Вона надає більше інформації, ніж kubelet експортує в APIServer.
Примітка:
GetAllocatableResources слід використовувати лише для оцінки доступних для розподілу ресурсів на вузлі. Якщо мета — оцінити вільні/нерозподілені ресурси, її слід використовувати разом із точкою доступу List(). Результат, отриманий від GetAllocatableResources, залишатиметься тим самим, доки не зміняться базові ресурси, доступні kubelet. Це відбувається рідко, але коли відбувається (наприклад, hotplug/hotunplug, зміни справності пристроїв), клієнт має викликати точку доступу GetAllocatableResources.
Однак виклику точки доступу GetAllocatableResources недостатньо в разі оновлення CPU та/або памʼяті: щоб відобразити правильні значення місткості та доступних для розподілу ресурсів, kubelet потрібно перезапустити.
// AllocatableResourcesResponses містить інформацію про всі пристрої, відомі kubelet
message AllocatableResourcesResponse {
repeated ContainerDevices devices = 1;
repeated int64 cpu_ids = 2;
repeated ContainerMemory memory = 3;
}
ContainerDevices справді надають інформацію про топологію, вказуючи, до яких комірок NUMA привʼязаний пристрій. Комірки NUMA ідентифікуються за допомогою непрозорого цілочисельного ідентифікатора, значення якого відповідає тому, що повідомляють втулки пристроїв, коли реєструються в kubelet.
Сервіс gRPC обслуговується через unix-сокет pod-resources/kubelet.sock у кореневій теці kubelet (зазвичай /var/lib/kubelet/pod-resources/kubelet.sock). Агенти моніторингу ресурсів втулків пристроїв можна розгортати як демон або як DaemonSet. Канонічна тека pod-resources у кореневій теці kubelet (зазвичай /var/lib/kubelet/pod-resources) потребує привілейованого доступу, тому агенти моніторингу повинні працювати у привілейованому контексті безпеки. Якщо агент моніторингу пристроїв працює як DaemonSet, теку pod-resources потрібно змонтувати як Том у PodSpec агента моніторингу пристроїв.
Примітка:
Під час доступу до pod-resources/kubelet.sock з DaemonSet або будь-якого іншого застосунку, розгорнутого як контейнер на хості, який монтує сокет як том, доброю практикою є монтувати теку pod-resources, а не сам файл сокета. Це гарантує, що після перезапуску kubelet контейнер зможе повторно підключитися до цього сокета.
На типовому вузлі Linux це означає монтування /var/lib/kubelet/pod-resources/ замість /var/lib/kubelet/pod-resources/kubelet.sock.
Монтуваннями контейнера керують через inode, що посилається на сокет або теку, залежно від того, що було змонтовано. Під час перезапуску kubelet сокет видаляється і створюється новий, а тека залишається недоторканою. Тому початковий inode сокета стає непридатним для використання. inode теки продовжує працювати.
Точка доступу gRPC Get
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34
Точка доступу Get надає інформацію про ресурси запущеного Podʼа. Вона надає інформацію, подібну до описаної для точки доступу List. Точка доступу Get потребує PodName і PodNamespace запущеного Podʼа.
// GetPodResourcesRequest містить інформацію про Pod
message GetPodResourcesRequest {
string pod_name = 1;
string pod_namespace = 2;
}
Точка доступу Get може надавати інформацію про Pod, повʼязану з динамічними ресурсами, виділеними через API динамічного виділення ресурсів. Починаючи з Kubernetes v1.34, ця можливість стандартно увімкнена.
Інтеграція втулка пристроїв з менеджером топології
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.27
Менеджер топології (Topology Manager) — це компонент kubelet, який дозволяє координувати ресурси з урахуванням топології. Для цього API втулків пристроїв (Device Plugin API) було розширено структурою TopologyInfo.
Втулки пристроїв, які хочуть використовувати менеджер топології, можуть надсилати заповнену структуру TopologyInfo як частину реєстрації пристрою разом з ідентифікаторами пристроїв та станом їхньої справності. Потім менеджер пристроїв використає цю інформацію, щоб проконсультуватися з менеджером топології та прийняти рішення щодо призначення ресурсів.
TopologyInfo підтримує встановлення поля nodes у nil або у список вузлів NUMA. Це дозволяє втулку пристроїв оголошувати пристрій, який охоплює кілька вузлів NUMA.
Встановлення TopologyInfo у nil або надання порожнього списку вузлів NUMA для певного пристрою вказує на те, що втулок пристроїв не має переваг щодо спорідненості NUMA для цього пристрою.
Приклад структури TopologyInfo, заповненої для пристрою втулком пристроїв:
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Ось деякі приклади реалізації втулків пристроїв:
Akri, який дозволяє легко надавати доступ до різнорідних кінцевих пристроїв (таких як IP-камери та USB-пристрої).
Оператори — це програмні розширення Kubernetes, які використовують власні ресурси для керування застосунками та їхніми компонентами. Оператори дотримуються принципів Kubernetes, зокрема циклу управління.
Мотивація
Шаблон Operator має на меті відтворити ключову мету людини-оператора, яка керує сервісом або набором сервісів. Люди-оператори, які відповідають за конкретні застосунки та сервіси, мають глибокі знання про те, як система повинна поводитися, як її розгортати та як реагувати на проблеми.
Люди, які запускають робочі навантаження в Kubernetes, часто воліють використовувати автоматизацію для виконання повторюваних завдань. Шаблон Operator показує, як написати код для автоматизації завдання понад те, що надає сам Kubernetes.
Оператори в Kubernetes
Kubernetes створений для автоматизації. Із коробки ви отримуєте багато вбудованої автоматизації від ядра Kubernetes. Ви можете використовувати Kubernetes для автоматизації розгортання та запуску робочих навантажень, і ви можете автоматизувати те, як це робить Kubernetes.
Концепція шаблону Operator Kubernetes дозволяє розширити поведінку кластера без зміни коду самого Kubernetes, повʼязавши контролери з одним або кількома власними ресурсами. Оператори є клієнтами API Kubernetes, які діють як контролери для власного ресурсу.
Приклад оператора
Деякі завдання, які можна автоматизувати за допомогою оператора, включають:
розгортання застосунку за запитом
створення та відновлення резервних копій стану цього застосунку
оброблення оновлень коду застосунку разом із повʼязаними змінами, такими як схеми баз даних або додаткові параметри конфігурації
публікація Service для застосунків, які не підтримують API Kubernetes для їх виявлення
імітація відмови в усьому кластері або його частині для перевірки його стійкості
обрання лідера для розподіленого застосунку без внутрішнього процесу виборів учасників
Як може виглядати оператор докладніше? Ось приклад:
Власний ресурс з назвою SampleDB, який можна налаштувати в кластері.
Deployment, який забезпечує роботу Podʼа, що містить контролерну частину оператора.
Образ контейнера з кодом оператора.
Код контролера, який надсилає запити до панелі управління, щоб дізнатися, які ресурси SampleDB налаштовано.
Ядром оператора є код, який підказує API-серверу, як привести реальний стан у відповідність до налаштованих ресурсів.
Якщо ви додаєте новий SampleDB, оператор налаштовує PersistentVolumeClaims для надійного сховища бази даних, StatefulSet для запуску SampleDB та Job для початкової конфігурації.
Якщо ви видаляєте його, оператор робить знімок, а потім переконується, що StatefulSet і томи також видалено.
Оператор також керує регулярним резервним копіюванням бази даних. Для кожного ресурсу SampleDB оператор визначає, коли створити Pod, який може підʼєднатися до бази даних і зробити резервні копії. Ці Podʼи покладаються на ConfigMap та/або Secret, що містить параметри підʼєднання до бази даних та облікові дані.
Оскільки оператор має на меті надійну автоматизацію ресурсу, яким він керує, у ньому буде додатковий допоміжний код. У цьому прикладі код перевіряє, чи працює база даних на старій версії, і якщо так, створює обʼєкти Job, які оновлюють її для вас.
Розгортання операторів
Найпоширеніший спосіб розгортання оператора — додавання CustomResourceDefinition та повʼязаного з ним контролера до вашого кластера. Контролер зазвичай працює за межами панелі управління, так само як і будь-який контейнеризований застосунок. Наприклад, ви можете запустити контролер у своєму кластері як Deployment.
Використання операторів
Після розгортання оператора ви використовуєте його, додаючи, змінюючи або видаляючи ресурси того виду, який використовує оператор. Продовжуючи наведений вище приклад, ви налаштуєте Deployment для самого оператора, а потім:
kubectl get SampleDB # пошук налаштованих баз данихkubectl edit SampleDB/example-database # ручна зміна деяких параметрів
…і все! Оператор подбає про застосування змін, а також про підтримання наявного сервісу в належному стані.
Створення власних операторів
Якщо в екосистемі немає оператора, який реалізує потрібну вам поведінку, ви можете створити власний.
Ви також можете реалізувати оператор (тобто контролер) будь-якою мовою або в будь-якому середовищі виконання, що може діяти як клієнт API Kubernetes.
Нижче наведено кілька бібліотек та інструментів, які можна використовувати для написання власного оператора cloud native.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Прочитайте оригінальну статтю CoreOS, яка представила шаблон Operator (це архівна версія оригінальної статті).
Ознайомтесь зі статтею від Google Cloud про найкращі практики створення операторів
7 - Завдання
Цей розділ документації Kubernetes містить сторінки, які показують, як виконувати окремі завдання. Сторінка завдання показує, як виконати одну дію, зазвичай за допомогою короткої послідовності кроків.
Налаштування інструментів Kubernetes на вашому компʼютері.
Примітка:
Щоб налаштувати середовище для практики, дивіться сторінку Навчальне середовище.
kubectl
Інструмент командного рядка Kubernetes, kubectl, дозволяє виконувати команди в кластерах Kubernetes. За допомогою kubectl можна розгортати застосунки, оглядати ресурси кластера й керувати ними, а також переглядати логи. Докладніше, зокрема повний перелік операцій kubectl, дивіться в довідковій документації kubectl.
kubectl можна встановити на різних платформах Linux, macOS і Windows. Виберіть свою операційну систему нижче.
Подібно до kind, minikube — це інструмент, який дозволяє запускати Kubernetes локально. minikube запускає локальний кластер Kubernetes «все в одному» або багатовузловий кластер на вашому персональному компʼютері (зокрема на ПК з Windows, macOS і Linux), щоб ви могли випробувати Kubernetes або використовувати його для щоденної розробки.
Якщо ваша мета — встановити інструмент, скористайтеся офіційним посібником Get Started!.
Ви можете використовувати інструмент kubeadm для створення кластерів Kubernetes і керування ними. Він виконує дії, потрібні для зручного запуску мінімально життєздатного захищеного кластера.
7.1.1 - Встановлення та налаштування kubectl у Linux
Перш ніж ви розпочнете
Вам потрібно використовувати версію kubectl, яка має мінорну версію, що відрізняється не більше ніж на одиницю від мінорної версії вашого кластера. Наприклад, клієнт v1.37 може співпрацювати з панелями управління v1.36, v1.37 та v1.38. Використання останньої сумісної версії kubectl допомагає уникнути непередбачуваних проблем.
Встановлення kubectl у Linux
Існують наступні методи встановлення kubectl у Linux:
Якщо у вас немає прав root на цільовій системі, все одно можна встановити
kubectl у теку ~/.local/bin:
chmod +x kubectl
mkdir -p ~/.local/bin
mv ./kubectl ~/.local/bin/kubectl
# а потім додайте (в початок чи кінець) ~/.local/bin до $PATH
Перевірте, щоб переконатися, що встановлена вами версія є актуальною:
kubectl version --client
Або скористайтеся цим для детального перегляду версії:
kubectl version --client --output=yaml
Встановлення за допомогою стандартного пакетного менеджера
Оновіть індекс пакунків apt та встановіть пакунки, необхідні для використання репозиторію apt Kubernetes:
sudo apt-get update
# apt-transport-https може бути макетним пакетом; якщо так, ви можете пропустити цей пакетsudo apt-get install -y apt-transport-https ca-certificates curl gnupg
Завантажте публічний ключ підпису для репозиторіїв пакунків Kubernetes. Той самий ключ підпису використовується для всіх репозиторіїв, тому ви можете проігнорувати версію в URL:
# Якщо тека `/etc/apt/keyrings` не існує, її слід створити перед запуском curl, прочитайте примітку нижче.# sudo mkdir -p -m 755 /etc/apt/keyringscurl -fsSL https://pkgs.k8s.io/core:/stable:/v1.37/deb/Release.key | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
sudo chmod 644 /etc/apt/keyrings/kubernetes-apt-keyring.gpg # дозволяє непривілейованим програмам APT читати цей ключ
Примітка:
У випусках, старіших за Debian 12 і Ubuntu 22.04, тека /etc/apt/keyrings типово не існує, її слід створити перед запуском команди curl.
Додайте відповідний репозиторій Kubernetes apt. Якщо ви хочете використовувати версію Kubernetes, відмінну від v1.37, замініть v1.37 на потрібну мінорну версію в команді нижче:
# Це перезапише будь-яку існуючу конфігурацію в /etc/apt/sources.list.d/kubernetes.listecho'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/v1.37/deb/ /'| sudo tee /etc/apt/sources.list.d/kubernetes.list
sudo chmod 644 /etc/apt/sources.list.d/kubernetes.list # допомагає правильно працювати з такими інструментами, як command-not-found
Примітка:
Щоб оновити kubectl до іншого мінорного випуску, вам потрібно буде збільшити версію в /etc/apt/sources.list.d/kubernetes.list перед виконанням apt-get update та apt-get upgrade. Цю процедуру більш докладно описано в Зміні репозиторію пакунків Kubernetes.
Оновіть індекс пакунків apt, а потім встановіть kubectl:
Додайте репозиторій Kubernetes yum. Якщо ви хочете використовувати версію Kubernetes, відмінну від v1.37, замініть v1.37 на потрібну мінорну версію в команді нижче.
# Це перезапише будь-яку існуючу конфігурацію у /etc/yum.repos.d/kubernetes.repocat <<EOF | sudo tee /etc/yum.repos.d/kubernetes.repo
[kubernetes]
name=Kubernetes
baseurl=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/
enabled=1
gpgcheck=1
gpgkey=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/repodata/repomd.xml.key
EOF
Примітка:
Щоб оновити kubectl до іншого мінорного випуску, вам потрібно буде збільшити версію в /etc/yum.repos.d/kubernetes.repo перед виконанням dnf update. Цю процедуру більш докладно описано в Зміні репозиторію пакунків Kubernetes.
Встановіть kubectl за допомогою dnf:
sudo dnf install -y kubectl
Додайте репозиторій Kubernetes zypper. Якщо ви хочете використовувати версію Kubernetes, відмінну від v1.37, замініть v1.37 на потрібну мінорну версію в команді нижче.
# Це перезапише будь-яку існуючу конфігурацію у /etc/zypp/repos.d/kubernetes.repocat <<EOF | sudo tee /etc/zypp/repos.d/kubernetes.repo
[kubernetes]
name=Kubernetes
baseurl=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/
enabled=1
gpgcheck=1
gpgkey=https://pkgs.k8s.io/core:/stable:/v1.37/rpm/repodata/repomd.xml.key
EOF
Примітка:
Щоб оновити kubectl до іншого мінорного випуску, вам потрібно буде збільшити версію в /etc/zypp/repos.d/kubernetes.repo перед виконанням zypper update. Цю процедуру більш докладно описано в
Зміні репозиторію пакунків Kubernetes.
Оновіть zypper і підтвердіть додавання нового репозиторію:
sudo zypper update
Коли зʼявиться таке повідомлення, натисніть 't' або 'a':
New repository or package signing key received:
Repository: Kubernetes
Key Fingerprint: 1111 2222 3333 4444 5555 6666 7777 8888 9999 AAAA
Key Name: isv:kubernetes OBS Project <isv:kubernetes@build.opensuse.org>
Key Algorithm: RSA 2048
Key Created: Thu 25 Aug 2022 01:21:11 PM -03
Key Expires: Sat 02 Nov 2024 01:21:11 PM -03 (expires in 85 days)
Rpm Name: gpg-pubkey-9a296436-6307a177
Note: Signing data enables the recipient to verify that no modifications occurred after the data
were signed. Accepting data with no, wrong or unknown signature can lead to a corrupted system
and in extreme cases even to a system compromise.
Note: A GPG pubkey is clearly identified by its fingerprint. Do not rely on the key's name. If
you are not sure whether the presented key is authentic, ask the repository provider or check
their web site. Many providers maintain a web page showing the fingerprints of the GPG keys they
are using.
Do you want to reject the key, trust temporarily, or trust always? [r/t/a/?] (r): a
Встановіть kubectl, використовуючи zypper:
sudo zypper install -y kubectl
Встановлення за допомогою іншого пакетного менеджера
Якщо ви користуєтеся Ubuntu або іншим дистрибутивом Linux, який підтримує менеджер пакунків snap, kubectl доступний як застосунок snap.
snap install kubectl --classic
kubectl version --client
Якщо ви користуєтеся Linux і використовуєте пакетний менеджер Homebrew, kubectl доступний для встановлення.
brew install kubectl
kubectl version --client
Перевірка конфігурації kubectl
Щоб kubectl міг знайти кластер Kubernetes і отримати до нього доступ, йому потрібен файл kubeconfig, який створюється автоматично, коли ви створюєте кластер за допомогою kube-up.sh або успішно розгортаєте кластер Minikube. Стандартно конфігурація kubectl міститься в ~/.kube/config.
Перевірте, що kubectl правильно налаштований, отримавши стан кластера:
kubectl cluster-info
Якщо у відповідь ви бачите URL, kubectl правильно налаштований для доступу до вашого кластера.
Якщо ви бачите повідомлення, подібне до наведеного нижче, kubectl налаштований неправильно або не може підʼєднатися до кластера Kubernetes.
The connection to the server <server-name:port> was refused - did you specify the right host or port?
Наприклад, якщо ви плануєте запускати кластер Kubernetes на своєму ноутбуці (локально), спочатку потрібно встановити інструмент на кшталт Minikube, а потім повторно виконати наведені вище команди.
Якщо kubectl cluster-info повертає у відповідь URL, але ви не можете отримати доступ до кластера, перевірте, чи він правильно налаштований, за допомогою такої команди:
kubectl cluster-info dump
Усунення несправностей із повідомленням про помилку 'No Auth Provider Found'
У Kubernetes 1.26 з kubectl вилучено вбудовану автентифікацію для керованих сервісів Kubernetes таких хмарних провайдерів. Ці провайдери випустили втулки kubectl, що забезпечують автентифікацію для їхніх хмар. Інструкції дивіться в документації провайдера:
Те саме повідомлення про помилку може мати й інші причини, не повʼязані з цією зміною.
Необовʼязкові налаштування та втулки kubectl
Увімкнення автодоповнення оболонки
kubectl надає підтримку автодоповнення для оболонок Bash, Zsh, Fish та PowerShell, що може зекономити вам багато часу на набір тексту.
Нижче наведені процедури для налаштування автодоповнення для оболонок Bash, Fish та Zsh.
Вступ
Скрипт автодоповнення kubectl для Bash можна згенерувати командою kubectl completion bash. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Однак скрипт автодоповнення залежить від bash-completion, тому спочатку потрібно встановити це програмне забезпечення (ви можете перевірити, чи вже встановлено bash-completion, виконавши type _init_completion).
Встановлення bash-completion
bash-completion є в багатьох менеджерах пакунків (див. тут). Ви можете встановити його за допомогою apt-get install bash-completion, dnf install bash-completion тощо.
Наведені вище команди створюють /usr/share/bash-completion/bash_completion, основний скрипт bash-completion. Залежно від вашого менеджера пакунків може знадобитися вручну підключити цей файл у файлі ~/.bashrc.
Щоб це зʼясувати, перезавантажте оболонку й виконайте type _init_completion. Якщо команда виконується успішно, усе вже налаштовано; інакше додайте наведене нижче до файлу ~/.bashrc:
source /usr/share/bash-completion/bash_completion
Перезавантажте оболонку й перевірте, що bash-completion правильно встановлено, виконавши type _init_completion.
Увімкнення автодоповнення kubectl
Bash
Тепер потрібно забезпечити підключення скрипта автодоповнення kubectl в усіх сеансах оболонки. Це можна зробити двома способами:
Якщо у вас є псевдонім для kubectl, ви можете розширити автодоповнення оболонки, щоб воно працювало з цим псевдонімом:
echo'alias k=kubectl' >>~/.bashrc
echo'complete -o default -F __start_kubectl k' >>~/.bashrc
Примітка:
bash-completion підключає всі скрипти автодоповнення з /etc/bash_completion.d.
Обидва підходи рівноцінні. Після перезавантаження оболонки автодоповнення kubectl має працювати. Щоб увімкнути автодоповнення bash у поточному сеансі оболонки, підключіть файл ~/.bashrc:
source ~/.bashrc
Примітка:
Автодоповнення для Fish потребує kubectl версії 1.23 або новішої.
Скрипт автодоповнення kubectl для Fish можна згенерувати командою kubectl completion fish. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Щоб зробити це в усіх сеансах оболонки, додайте такий рядок до файлу ~/.config/fish/config.fish:
kubectl completion fish |source
Після перезавантаження оболонки автодоповнення kubectl має працювати.
Скрипт автодоповнення kubectl для Zsh можна згенерувати командою kubectl completion zsh. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Щоб зробити це в усіх сеансах оболонки, додайте наведене нижче до файлу ~/.zshrc:
source <(kubectl completion zsh)
Якщо у вас є псевдонім для kubectl, автодоповнення kubectl автоматично працюватиме з ним.
Після перезавантаження оболонки автодоповнення kubectl має працювати.
Якщо ви отримуєте помилку на кшталт 2: command not found: compdef, додайте наведене нижче на початок файлу ~/.zshrc:
autoload -Uz compinit
compinit
Налаштування kuberc
Дивіться kuberc для отримання докладної інформації.
Встановлення втулка kubectl convert
Втулок для інструмента командного рядка Kubernetes kubectl, який дозволяє конвертувати маніфести між різними версіями API. Це може бути особливо корисно для міграції маніфестів на незастарілу версію API в новіших випусках Kubernetes. Докладніше дивіться в розділі перехід на незастарілі API.
Завантажте останній випуск за допомогою наступної команди:
7.1.2 - Встановлення та налаштування kubectl у macOS
Перш ніж ви розпочнете
Вам потрібно використовувати версію kubectl, яка має мінорну версію, що відрізняється не більше ніж на одиницю від мінорної версії вашого кластера. Наприклад, клієнт v1.37 може співпрацювати з панелями управління v1.36, v1.37 та v1.38. Використання останньої сумісної версії kubectl допомагає уникнути непередбачуваних проблем.
Встановлення kubectl у macOS
Існують наступні методи встановлення kubectl у macOS:
Переконайтеся, що /usr/local/bin є у вашій змінній середовища PATH.
Перевірте, що встановлена версія kubectl актуальна:
kubectl version --client
Або використовуйте це для детального перегляду версії:
kubectl version --client --output=yaml
Після встановлення та перевірки kubectl видаліть файл контрольної суми:
rm kubectl.sha256
Встановлення за допомогою Homebrew у macOS
Якщо ви користуєтеся macOS і пакетним менеджером Homebrew, ви можете встановити kubectl за допомогою Homebrew.
Виконайте команду встановлення:
brew install kubectl
або
brew install kubernetes-cli
Перевірте, що встановлена версія актуальна:
kubectl version --client
Встановлення за допомогою Macports у macOS
Якщо ви користуєтеся macOS і пакетним менеджером Macports, ви можете встановити kubectl за допомогою Macports.
Виконайте команду встановлення:
sudo port selfupdate
sudo port install kubectl
Перевірте, що встановлена версія актуальна:
kubectl version --client
Перевірка конфігурації kubectl
Щоб kubectl міг знайти кластер Kubernetes і отримати до нього доступ, йому потрібен файл kubeconfig, який створюється автоматично, коли ви створюєте кластер за допомогою kube-up.sh або успішно розгортаєте кластер Minikube. Стандартно конфігурація kubectl міститься в ~/.kube/config.
Перевірте, що kubectl правильно налаштований, отримавши стан кластера:
kubectl cluster-info
Якщо у відповідь ви бачите URL, kubectl правильно налаштований для доступу до вашого кластера.
Якщо ви бачите повідомлення, подібне до наведеного нижче, kubectl налаштований неправильно або не може підʼєднатися до кластера Kubernetes.
The connection to the server <server-name:port> was refused - did you specify the right host or port?
Наприклад, якщо ви плануєте запускати кластер Kubernetes на своєму ноутбуці (локально), спочатку потрібно встановити інструмент на кшталт Minikube, а потім повторно виконати наведені вище команди.
Якщо kubectl cluster-info повертає у відповідь URL, але ви не можете отримати доступ до кластера, перевірте, чи він правильно налаштований, за допомогою такої команди:
kubectl cluster-info dump
Усунення несправностей із повідомленням про помилку 'No Auth Provider Found'
У Kubernetes 1.26 з kubectl вилучено вбудовану автентифікацію для керованих сервісів Kubernetes таких хмарних провайдерів. Ці провайдери випустили втулки kubectl, що забезпечують автентифікацію для їхніх хмар. Інструкції дивіться в документації провайдера:
Те саме повідомлення про помилку може мати й інші причини, не повʼязані з цією зміною.
Необовʼязкові налаштування та втулки kubectl
Увімкнення автодоповнення оболонки
kubectl надає підтримку автодоповнення для оболонок Bash, Zsh, Fish та PowerShell, що може значно зекономити ваш час при введенні команд.
Нижче подані процедури для налаштування автодоповнення для оболонок Bash, Fish та Zsh.
Вступ
Скрипт автодоповнення kubectl для Bash можна згенерувати командою kubectl completion bash. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Однак скрипт автодоповнення kubectl залежить від bash-completion, який потрібно встановити заздалегідь.
Попередження:
Існують дві версії bash-completion: v1 і v2. V1 призначена для Bash 3.2 (стандартна версія в macOS), а v2 — для Bash 4.1+. Скрипт автодоповнення kubectl не працює правильно з bash-completion v1 і Bash 3.2. Він потребує bash-completion v2 і Bash 4.1+. Отже, щоб правильно використовувати автодоповнення kubectl у macOS, потрібно встановити й використовувати Bash 4.1+ (інструкції). Наведені нижче інструкції передбачають, що ви використовуєте Bash 4.1+ (тобто будь-яку версію Bash 4.1 або новішу).
Оновлення Bash
Ці інструкції передбачають, що ви використовуєте Bash 4.1+. Перевірити версію Bash можна, виконавши:
echo$BASH_VERSION
Якщо вона надто стара, ви можете встановити або оновити її за допомогою Homebrew:
brew install bash
Перезавантажте оболонку й перевірте, що використовується потрібна версія:
echo$BASH_VERSION$SHELL
Зазвичай Homebrew встановлює його в /usr/local/bin/bash.
Встановлення bash-completion
Примітка:
Як уже зазначалося, ці інструкції передбачають використання Bash 4.1+, тобто ви встановлюватимете bash-completion v2 (на відміну від Bash 3.2 і bash-completion v1, де автодоповнення kubectl не працюватиме).
Ви можете перевірити, чи вже встановлено bash-completion v2, за допомогою type _init_completion. Якщо ні, встановіть його за допомогою Homebrew:
brew install bash-completion@2
Як зазначено у виводі цієї команди, додайте наведене нижче до файлу ~/.bash_profile:
Якщо у вас є псевдонім для kubectl, ви можете розширити автодоповнення оболонки, щоб воно працювало з цим псевдонімом:
echo'alias k=kubectl' >>~/.bash_profile
echo'complete -o default -F __start_kubectl k' >>~/.bash_profile
Якщо ви встановили kubectl за допомогою Homebrew (як пояснено тут), скрипт автодоповнення kubectl вже має бути в /usr/local/etc/bash_completion.d/kubectl. У цьому випадку нічого робити не потрібно.
Примітка:
Установлення bash-completion v2 через Homebrew підключає всі файли з теки BASH_COMPLETION_COMPAT_DIR, тому два останні способи працюють.
У будь-якому разі після перезавантаження оболонки автодоповнення kubectl має працювати.
Примітка:
Автодоповнення для Fish потребує kubectl версії 1.23 або новішої.
Скрипт автодоповнення kubectl для Fish можна згенерувати командою kubectl completion fish. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Щоб зробити це в усіх сеансах оболонки, додайте такий рядок до файлу ~/.config/fish/config.fish:
kubectl completion fish |source
Після перезавантаження оболонки автодоповнення kubectl має працювати.
Скрипт автодоповнення kubectl для Zsh можна згенерувати командою kubectl completion zsh. Підключення цього скрипта у вашій оболонці вмикає автодоповнення kubectl.
Щоб зробити це в усіх сеансах оболонки, додайте наведене нижче до файлу ~/.zshrc:
source <(kubectl completion zsh)
Якщо у вас є псевдонім для kubectl, автодоповнення kubectl автоматично працюватиме з ним.
Після перезавантаження оболонки автодоповнення kubectl має працювати.
Якщо ви отримуєте помилку на кшталт 2: command not found: compdef, додайте наведене нижче на початок файлу ~/.zshrc:
autoload -Uz compinit
compinit
Налаштування kuberc
Дивіться kuberc для отримання докладної інформації.
Встановлення втулка kubectl convert
Втулок для інструмента командного рядка Kubernetes kubectl, який дозволяє конвертувати маніфести між різними версіями API. Це може бути особливо корисно для міграції маніфестів на незастарілу версію API в новіших випусках Kubernetes. Докладніше дивіться в розділі перехід на незастарілі API.
7.1.3 - Встановлення та налаштування kubectl у Windows
Перш ніж ви розпочнете
Вам потрібно використовувати версію kubectl, яка має мінорну версію, що відрізняється не більше ніж на одиницю від мінорної версії вашого кластера. Наприклад, клієнт v1.37 може співпрацювати з панелями управління v1.36, v1.37 та v1.38. Використання останньої сумісної версії kubectl допомагає уникнути непередбачуваних проблем.
Встановлення kubectl у Windows
Існують наступні методи встановлення kubectl у Windows:
Встановлення бінарного файлу kubectl у Windows (через пряме завантаження або curl)
У вас є два варіанти встановлення kubectl на вашому пристрої з Windows
Безпосереднє завантаження:
Завантажте останню версію 1.37 патчу безпосередньо для вашої архітектури, відвідавши сторінку випуску Kubernetes. Переконайтеся, що вибрано правильний двійковий файл для вашої архітектури (наприклад, amd64, arm64 тощо).
Використовуючи curl:
Якщо у вас встановлено curl, використайте цю команду:
Додайте на початок чи в кінець змінної середовища PATH шлях до теки з kubectl.
Перевірте, що версія kubectl збігається з завантаженою:
kubectl version --client
Або використайте це для детального перегляду версії:
kubectl version --client --output=yaml
Примітка:
Docker Desktop for Windows додає свою власну версію kubectl до PATH. Якщо ви вже встановили Docker Desktop раніше, можливо, вам потрібно розмістити свій шлях в PATH перед тим, який додається інсталятором Docker Desktop, або видалити kubectl Docker Desktop.
Встановлення у Windows за допомогою Chocolatey, Scoop або winget
Для встановлення kubectl у Windows ви можете використовувати пакетний менеджер Chocolatey, командний інсталятор Scoop, або менеджер пакунків winget.
chocoinstallkubernetes-cli
scoopinstallkubectl
wingetinstall-e--idKubernetes.kubectl
Перевірте, що встановлена версія актуальна:
kubectlversion--client
Перейдіть до вашої домашньої теки:
# Якщо ви використовуєте cmd.exe, виконайте: cd %USERPROFILE%cd ~
Створіть теку .kube:
mkdir.kube
Перейдіть до теки .kube, що ви щойно створили:
cd .kube
Налаштуйте kubectl для використання віддаленого кластера Kubernetes:
New-Itemconfig-typefile
Примітка:
Редагуйте файл конфігурації за допомогою текстового редактора на ваш вибір, наприклад, Notepad.
Перевірка конфігурації kubectl
Щоб kubectl міг знайти кластер Kubernetes і отримати до нього доступ, йому потрібен файл kubeconfig, який створюється автоматично, коли ви створюєте кластер за допомогою kube-up.sh або успішно розгортаєте кластер Minikube. Стандартно конфігурація kubectl міститься в ~/.kube/config.
Перевірте, що kubectl правильно налаштований, отримавши стан кластера:
kubectl cluster-info
Якщо у відповідь ви бачите URL, kubectl правильно налаштований для доступу до вашого кластера.
Якщо ви бачите повідомлення, подібне до наведеного нижче, kubectl налаштований неправильно або не може підʼєднатися до кластера Kubernetes.
The connection to the server <server-name:port> was refused - did you specify the right host or port?
Наприклад, якщо ви плануєте запускати кластер Kubernetes на своєму ноутбуці (локально), спочатку потрібно встановити інструмент на кшталт Minikube, а потім повторно виконати наведені вище команди.
Якщо kubectl cluster-info повертає у відповідь URL, але ви не можете отримати доступ до кластера, перевірте, чи він правильно налаштований, за допомогою такої команди:
kubectl cluster-info dump
Усунення несправностей із повідомленням про помилку 'No Auth Provider Found'
У Kubernetes 1.26 з kubectl вилучено вбудовану автентифікацію для керованих сервісів Kubernetes таких хмарних провайдерів. Ці провайдери випустили втулки kubectl, що забезпечують автентифікацію для їхніх хмар. Інструкції дивіться в документації провайдера:
Ця команда генеруватиме скрипт автодоповнення під час кожного запуску PowerShell. Ви також можете додати згенерований скрипт безпосередньо до файлу $PROFILE.
Щоб додати згенерований скрипт до файлу $PROFILE, виконайте такий рядок у командному рядку PowerShell:
kubectlcompletionpowershell>>$PROFILE
Після перезавантаження оболонки автодоповнення kubectl має працювати.
Налаштування kuberc
Дивіться kuberc для отримання докладної інформації.
Встановлення втулка kubectl convert
Втулок для інструмента командного рядка Kubernetes kubectl, який дозволяє конвертувати маніфести між різними версіями API. Це може бути особливо корисно для міграції маніфестів на незастарілу версію API в новіших випусках Kubernetes. Докладніше дивіться в розділі перехід на незастарілі API.
Ця сторінка описує, як встановити Minikube - інструмент, який дозволяє
запустити Kubernetes кластер з однієї ноди у віртуальній машині на вашому персональному комп'ютері.
Перш ніж ви розпочнете
Для перевірки, чи підтримується віртуалізація на Linux, запустіть наступну команду і впевніться що її вивід не пустий:
grep -E --color 'vmx|svm' /proc/cpuinfo
Для перевірки, чи підтримується віртуалізація на macOS, запустіть наступну команду в терміналі.
sysctl -a | grep -E --color 'machdep.cpu.features|VMX'
Якщо ви бачите VMX у виводі (має бути кольоровий), то VT-x опція включена на вашому хості.
Для перевірки, чи підтримується віртуалізація на Windows 8 та версіях вище, запустіть наступну команду в терміналі
вашого або через command prompt.
systeminfo
Якщо ви бачите наступне, віртуалізація підтримується на Windows.
Hyper-V Requirements: VM Monitor Mode Extensions: Yes
Virtualization Enabled In Firmware: Yes
Second Level Address Translation: Yes
Data Execution Prevention Available: Yes
Якщо ви бачите наступнний вивід, на вашій системі вже встановлен гіпервізор і ви можете пропустити наступний крок.
Hyper-V Requirements: A hypervisor has been detected. Features required for Hyper-V will not be displayed.
Minikube також пітримує опцію --driver=none яка дозволяє запускати компоненти Kubernetes
на хост системі, ні в віртуальній машині.
Використання цього драйвера вимагає Docker та Linux оточення але не гіпервізор.
Якщо ви використувуєте none драйвер у Debian або похідних дістрибутивах, використовуйте .deb пакети для
Docker замість встановлення snap пакетів, які не працюють з Minikube.
Ви можете скачати .deb пакети звідси Docker.
Увага:
none VM драйвер може привести до проблем з безпекою та втрати даних.
Перед тим, як використовувати --driver=none, ознайомтесь з цієй документацієй для отримання додаткової інформації.
Minikube також підтримує vm-driver=podman схожий на Docker драйвер. Podman запущений як суперюзер (root user) це найкрайщий шлях забезпечити повний доступ ваших контейнерів до будь-якої функції, наявної у вашій системі.
Увага:
podman драйвер вимагає запущені контейнери з під root користувача оскільки звичайні облікові записи користувачів не мають повного доступу до всіх функцій операційної системи, які, можливо, потребуватимуть їх роботи.
Встановлення Minikube як Linux пакет
Доступні experimental пакети для Minikube; ви можете знайти Linux (AMD64) пакети
для Minikube's releases на сторінці GitHub.
Використовувайте ваш Linux інсталер пакетів для того, шоб поставити відповідний пакет.
Встановлення Minikube за допомогою прямого завантаження
Якщо ви не можете встановити Minikube за допомогою пакета, ви можете скачати автономний бінарний файл,
та використати його.
Щоб підтвердити успішну установку як гіпервізора, так і Minikube, ви можете запустити таку команду, щоб запустити локальний кластер Kubernetes:
Примітка:
Щоб встановити --driver за допомогою minikube start, введіть ім'я гіпервізора, який ви встановили, малими літерами, де <driver_name> згадано нижче. Повний список значень --driver доступний у вказуванні документації на драйвер VM.
minikube start --driver=<driver_name>
Після того як minikube start закінчився, запустіть команду нижче, щоб перевірити стан кластера:
minikube status
Якщо ваш кластер працює, вивід із "minikube status" має бути аналогічним:
Після того, як ви підтвердили, чи Minikube працює з обраним вами гіпервізором, ви можете продовжувати використовувати Minikube або ви можете зупинити кластер. Щоб зупинити кластер, запустіть:
minikube stop
Очистити локальний стан
Якщо ви раніше встановили Minikube та запустили:
minikube start
але minikube start повертає помилку:
machine does not exist
тоді вам треба очистити локальний стан minikube:
minikube delete
7.2 - Налагодження Podʼів
Цей посібник допоможе користувачам налагодити застосунки, які розгорнуті в Kubernetes і поводяться некоректно. Це не посібник для тих, хто хоче налагодити свій кластер. Для цього ознайомтеся з цим посібником.
Діагностика проблеми
Перший крок в усуненні несправностей — первинна оцінка. У чому проблема? У ваших Podʼах, ReplicationController чи Service?
Перший крок у налагодженні Podʼа — переглянути його. Перевірте поточний стан Podʼа й останні події такою командою:
kubectl describe pods ${POD_NAME}
Перегляньте стан контейнерів у Podʼі. Чи всі вони в стані Running? Чи були нещодавні перезапуски?
Продовжуйте налагодження залежно від стану Podʼів.
Мій Pod залишається в стані Pending
Якщо Pod застряг у стані Pending, це означає, що його не можна призначити на вузол. Зазвичай це стається через нестачу ресурсів того чи іншого типу, яка заважає плануванню. Перегляньте вивід команди kubectl describe ... вище. Там мають бути повідомлення від планувальника про те, чому він не може запланувати ваш Pod. Можливі причини:
У вас недостатньо ресурсів: можливо, ви вичерпали запас CPU або памʼяті в кластері; у такому разі потрібно видалити Podʼи, скоригувати запити ресурсів або додати нові вузли до кластера. Докладніше дивіться документ про обчислювальні ресурси.
Ви використовуєте hostPort: коли ви привʼязуєте Pod до hostPort, кількість місць, де можна запланувати цей Pod, обмежена. У більшості випадків hostPort не потрібен, спробуйте використати обʼєкт Service, щоб відкрити доступ до вашого Podʼа. Якщо hostPort вам усе ж потрібен, ви зможете запланувати лише стільки Podʼів, скільки вузлів у вашому кластері Kubernetes.
Мій Pod залишається у стані Waiting
Якщо Pod застряг у стані Waiting, його вже призначено на робочий вузол, але він не може працювати на цій машині. Знову ж таки, корисну інформацію має дати вивід kubectl describe .... Найпоширеніша причина Podʼів у стані Waiting — помилка завантаження образу. Перевірте три речі:
Переконайтеся, що ви правильно вказали імʼя образу.
Чи надіслали ви образ до реєстру?
Спробуйте вручну завантажити образ, щоб перевірити, чи його можна завантажити. Наприклад, якщо ви використовуєте Docker на своєму ПК, виконайте docker pull <image>.
Мій Pod залишається у стані Terminating
Якщо Pod застряг у стані Terminating, це означає, що для Podʼа надіслано запит на видалення, але панель управління не може видалити обʼєкт Pod.
Зазвичай таке стається, якщо Pod має завершувач, а в кластері встановлено вебхук допуску, який не дає панелі управління вилучити завершувач.
Щоб виявити такий сценарій, перевірте, чи є у вашому кластері ValidatingWebhookConfiguration або MutatingWebhookConfiguration, спрямовані на операції UPDATE для ресурсів pods.
Якщо вебхук надає третя сторона:
Переконайтеся, що ви використовуєте найновішу версію.
Вимкніть вебхук для операцій UPDATE.
Повідомте про проблему відповідному постачальнику.
Якщо ви автор вебхука:
Для змінювального вебхука переконайтеся, що він ніколи не змінює незмінні поля під час операцій UPDATE. Наприклад, зміни контейнерів зазвичай не дозволені.
Для валідаційного вебхука переконайтеся, що ваші політики валідації застосовуються лише до нових змін. Іншими словами, слід пропускати Podʼи з наявними порушеннями. Це дозволяє Podʼам, створеним до встановлення валідаційного вебхука, і далі працювати.
Мій Pod виходить з ладу або несправний іншим чином
Мій Pod працює, але не робить того, що я йому вказав
Якщо ваш Pod поводиться не так, як ви очікували, можливо, в описі Podʼа (наприклад, у файлі mypod.yaml на вашому локальному компʼютері) була помилка, яку мовчки проігнорували під час створення Podʼа. Часто якийсь розділ опису Podʼа вкладено неправильно або імʼя ключа написано з помилкою, тож ключ ігнорується. Наприклад, якщо ви написали command як commnd, Pod буде створено, але він не використовуватиме командний рядок, який ви задумали.
Насамперед видаліть свій Pod і спробуйте створити його знову з параметром --validate. Наприклад, виконайте kubectl apply --validate -f mypod.yaml. Якщо ви написали command як commnd, ви отримаєте помилку на кшталт такої:
I0805 10:43:25.129850 46757 schema.go:126] unknown field: commnd
I0805 10:43:25.129973 46757 schema.go:129] this may be a false alarm, see https://github.com/kubernetes/kubernetes/issues/6842
pods/mypod
Далі перевірте, чи збігається Pod на API-сервері з Podʼом, який ви хотіли створити (наприклад, з YAML-файлом на вашому локальному компʼютері). Наприклад, виконайте kubectl get pods/mypod -o yaml > mypod-on-apiserver.yaml, а потім вручну порівняйте початковий опис Podʼа, mypod.yaml, з тим, що ви отримали від API-сервера, mypod-on-apiserver.yaml. Зазвичай у версії з API-сервера будуть рядки, яких немає в початковій версії. Це очікувано. Однак якщо в початковому описі є рядки, яких немає у версії з API-сервера, це може свідчити про проблему зі специфікацією вашого Podʼа.
Налагодження ReplicationController
ReplicationController досить прості. Вони або можуть створювати Podʼи, або не можуть. Якщо вони не можуть створювати Podʼи, скористайтеся інструкціями вище, щоб налагодити свої Podʼи.
Також можна використати kubectl describe rc ${CONTROLLER_NAME}, щоб переглянути події, повʼязані з ReplicationController.
Налагодження Service
Service забезпечують балансування навантаження між набором Podʼів. Є кілька поширених проблем, через які Service можуть працювати неправильно. Наведені нижче інструкції допоможуть налагодити проблеми з Service.
Спершу переконайтеся, що для Service є точки доступу. Для кожного обʼєкта Service API-сервер робить доступними один або кілька ресурсів EndpointSlice.
Переглянути ці ресурси можна так:
kubectl get endpointslices -l kubernetes.io/service-name=${SERVICE_NAME}
Переконайтеся, що точки доступу в EndpointSlice відповідають кількості Podʼів, які мають входити до вашого Service. Наприклад, якщо ваш Service призначено для контейнера nginx з 3 репліками, ви маєте побачити три різні IP-адреси в EndpointSlice цього Service.
У моєму Service бракує точок доступу
Якщо точок доступу бракує, спробуйте вивести перелік Podʼів за мітками із селектора Service. Наприклад, у вас є Service з таким селектором:
...spec:selector:name:nginxtype:frontend
Можна використати:
kubectl get pods --selector=name=nginx,type=frontend
щоб вивести перелік Podʼів, які відповідають цьому селектору. Перевірте, чи список збігається з Podʼами, які мають обслуговувати ваш Service. Перевірте, чи containerPort Podʼа збігається з targetPort Service.
Якщо жоден із наведених вище кроків не розвʼязав вашої проблеми, виконайте інструкції з документа про налагодження Service, щоб переконатися, що ваш Service працює, має Endpoints, а ваші Podʼи справді обслуговують запити; що DNS працює, правила iptables встановлено, а kube-proxy поводиться правильно.
Для Kubernetes Metrics API пропонує базовий набір метрик для підтримки автоматичного масштабування та подібних випадків використання. Це API робить доступною інформацію про використання ресурсів вузлами й Podʼами, зокрема метрики CPU та памʼяті. Якщо ви розгорнете Metrics API у своєму кластері, клієнти API Kubernetes зможуть запитувати цю інформацію, а ви зможете використовувати механізми контролю доступу Kubernetes для керування дозволами на це.
HorizontalPodAutoscaler (HPA) і VerticalPodAutoscaler (VPA) використовують дані з Metrics API, щоб коригувати кількість реплік і ресурси робочих навантажень відповідно до попиту користувачів.
Ви також можете переглядати метрики ресурсів, використовуючи команду kubectl top.
Примітка:
Metrics API та конвеєр метрик, який воно уможливлює, надають лише мінімальний набір метрик CPU та памʼяті для автоматичного масштабування за допомогою HPA та / або VPA. Якщо ви хочете надати повніший набір метрик, ви можете доповнити простіший Metrics API, розгорнувши другий конвеєр метрик, який використовує Custom Metrics API.
flowchart RL
subgraph cluster[Кластер]
direction RL
S[
]
A[Сервер- метрик]
subgraph B[Вузли]
direction TB
D[cAdvisor] --> C[kubelet]
E[Середовище виконання контейнерів] --> D
E1[Середовище виконання контейнерів] --> D
P[Дані Podʼа] -.- C
end
L[API-сервер]
W[HPA]
C ---->|метрики ресурсів на рівні вузла| A -->|Metrics API| L --> W
end
L ---> K[kubectl top]
classDef box fill:#fff,stroke:#000,stroke-width:1px,color:#000;
class W,B,P,K,cluster,D,E,E1 box
classDef spacewhite fill:#ffffff,stroke:#fff,stroke-width:0px,color:#000
class S spacewhite
classDef k8s fill:#326ce5,stroke:#fff,stroke-width:1px,color:#fff;
class A,L,C k8s
Схема 1. Конвеєр метрик ресурсів
Компоненти архітектури, справа наліво на схемі, такі:
cAdvisor: демон, вбудований у kubelet, для збирання, агрегування та надання метрик контейнерів.
kubelet: агент вузла для керування ресурсами контейнерів. Метрики ресурсів доступні через точки доступу API kubelet /metrics/resource і /stats.
метрики ресурсів на рівні вузла: API, який надає kubelet для виявлення й отримання підсумкової статистики по вузлу, доступної через точку доступу /metrics/resource.
metrics-server: компонент-надбудова кластера, який збирає й агрегує метрики ресурсів, отримані від кожного kubelet. API-сервер обслуговує Metrics API для HPA, VPA і команди kubectl top. Metrics Server — це еталонна реалізація Metrics API.
Metrics API: API Kubernetes, що надає доступ до даних про CPU та памʼять, які використовуються для автомасштабування робочих навантажень. Щоб це працювало у вашому кластері, потрібен API-сервер розширення, який надає Metrics API.
Примітка:
cAdvisor підтримує читання метрик з cgroups, що працює зі звичайними середовищами виконання контейнерів у Linux. Якщо ви використовуєте середовище виконання контейнерів з іншим механізмом ізоляції ресурсів, наприклад віртуалізацією, це середовище виконання контейнерів має підтримувати метрики контейнерів CRI, щоб метрики були доступні kubelet.
Metrics API
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.37
Metrics-server реалізує Metrics API. Це API дає змогу отримати дані про використання CPU та памʼяті вузлами й Podʼами вашого кластера. Його основна роль — передавати метрики використання ресурсів компонентам автомасштабування K8s.
Ось приклад запиту до Metrics API для вузла minikube, обробленого через jq для зручного перегляду:
kubectl get --raw "/apis/metrics.k8s.io/v1/nodes/minikube"| jq '.'
Щоб отримати доступ до Metrics API, потрібно розгорнути metrics-server або інший адаптер, який його надає.
Вимірювання використання ресурсів
CPU
CPU відображається як середнє використання ядер, виміряне в одиницях CPU. Один CPU у Kubernetes еквівалентний 1 vCPU/ядру в хмарних провайдерів і 1 гіперпотоку на процесорах Intel на bare-metal.
Це значення отримують, обчислюючи швидкість зміни накопичувального лічильника CPU, який надає ядро (і в Linux, і в Windows). Часове вікно, використане для обчислення CPU, показано в полі window у Metrics API.
Щоб дізнатися більше про те, як Kubernetes розподіляє та вимірює ресурси CPU, дивіться значення CPU.
Памʼять
Памʼять відображається як робочий набір, виміряний у байтах, у момент збору метрики.
В ідеальному світі "робочий набір" — це обсяг памʼяті, що використовується й не може бути звільнений за умов тиску на памʼять. Однак обчислення робочого набору залежить від ОС хоста й, як правило, значною мірою покладається на евристики для отримання оцінки.
Модель Kubernetes для робочого набору контейнера очікує, що середовище виконання контейнерів враховує анонімну памʼять, повʼязану з відповідним контейнером. Метрика робочого набору зазвичай також включає деяку кешовану памʼять (file-backed), оскільки ОС хоста не завжди може звільнити сторінки.
Щоб дізнатися більше про те, як Kubernetes розподіляє та вимірює ресурси памʼяті, дивіться значення памʼяті.
Metrics Server
Metrics-server отримує метрики ресурсів від kubelet і надає їх через Metrics API на API-сервері Kubernetes для використання HPA та VPA. Ці метрики також можна переглядати командою kubectl top.
Metrics-server використовує API Kubernetes для відстеження вузлів і Podʼів у вашому кластері. Metrics-server запитує кожен вузол через HTTP, щоб отримати метрики. Metrics-server також будує внутрішнє подання метаданих Podʼів і зберігає кеш стану справності Podʼів. Ця кешована інформація про стан справності Podʼів доступна через API розширення, яке надає metrics-server.
Наприклад, для запиту HPA metrics-server має визначити, які Podʼи відповідають селекторам міток у Deployment.
Metrics-server викликає API kubelet для збору метрик з кожного вузла. Залежно від версії metrics-server використовується:
Точка доступу ресурсів метрик /metrics/resource у версії v0.6.0+ або
Точка доступу Summary API /stats/summary у старіших версіях
Щоб дізнатися про те, як kubelet надає метрики вузла, і як ви можете отримати до них доступ через API Kubernetes, прочитайте Дані метрик вузлів.
7.4 - Адміністрування кластера
Дізнайтеся про поширені завдання адміністрування кластера.
7.4.1 - Оновлення вузлів Linux
Ця сторінка пояснює, як оновити робочі вузли Linux, створені за допомогою kubeadm.
Перш ніж ви розпочнете
Вам потрібен доступ до оболонки на всіх вузлах, а інструмент командного рядка kubectl має бути налаштований для звʼязку з вашим кластером. Рекомендується виконувати цей підручник у кластері, що має принаймні два вузли, які не є вузлами панелі управління.
Якщо ви використовуєте репозиторії пакунків, що належать спільноті (pkgs.k8s.io), вам потрібно увімкнути репозиторій пакунків для потрібного мінорного релізу Kubernetes. Це пояснено в документі Зміна репозиторію пакунків Kubernetes.
Примітка: Сховища застарілих пакунків (apt.kubernetes.io та yum.kubernetes.io) визнані
застарілими та заморожені станом на 13 вересня 2023.
Наполегливо рекомендується використання нових репозиторіїв пакунків, розміщених за адресою pkgs.k8s.io,
які є обовʼязковими для встановлення версій Kubernetes, випущених після 13 вересня 2023 року.
Застарілі репозиторії та їх вміст можуть бути видалені у будь-який момент у майбутньому без попереднього повідомлення.
Нові репозиторії пакунків надають можливість завантаження версій Kubernetes, починаючи з v1.24.0.
Оновлення робочих вузлів
Оновлення kubeadm та kubectl
Оновіть kubeadm та kubectl:
Примітка:
kubectl має бути в межах однієї мінорної версії від kube-apiserver згідно з політикою розбіжності версій. Якщо ви оновлюєте панель управління через кілька мінорних версій перед оновленням робочих вузлів, локальний kubectl на вузлі може вийти за межі дозволеної розбіжності. Оновлення kubectl разом з kubeadm тут гарантує, що він залишається в межах підтримуваного діапазону версій протягом усього процесу оновлення вузла.
# замініть x у 1.37.x-* на останню версію патчаsudo apt-mark unhold kubeadm kubectl &&\
sudo apt-get update && sudo apt-get install -y kubeadm='1.37.x-*'kubectl='1.37.x-*'&&\
sudo apt-mark hold kubeadm kubectl
Для систем з DNF4 (Fedora < 41, RHEL/CentOS < 10):
# замініть x у 1.37.x-* на останню версію патчаsudo dnf install -y kubeadm-'1.37.x-*' kubectl-'1.37.x-*' --disableexcludes=kubernetes
Для систем з DNF5:
# замініть x у 1.37.x-* на останню версію патчаsudo dnf install -y kubeadm-'1.37.x-*' kubectl-'1.37.x-*' --setopt=disable_excludes=kubernetes
Виклик "kubeadm upgrade"
Для робочих вузлів це оновлює локальну конфігурацію kubelet:
sudo kubeadm upgrade node
Виконайте drain вузла
Підготуйте вузол до обслуговування, позначивши його як недоступний для планування та виселивши робочі навантаження:
# виконайте цю команду на вузлі панелі управління# замініть <node-to-drain> імʼям вузла, для якого ви виконуєте drainkubectl drain <node-to-drain> --ignore-daemonsets
Оновлення kubelet
Оновіть kubelet:
# замініть x у 1.37.x-* на останню версію патчаsudo apt-mark unhold kubelet &&\
sudo apt-get update && sudo apt-get install -y kubelet='1.37.x-*'&&\
sudo apt-mark hold kubelet
Для систем з DNF4 (Fedora < 41, RHEL/CentOS < 10):
# замініть x у 1.37.x-* на останню версію патчаsudo dnf install -y kubelet-'1.37.x-*' --disableexcludes=kubernetes
Для систем з DNF5:
# замініть x у 1.37.x-* на останню версію патчаsudo dnf install -y kubelet-'1.37.x-*' --setopt=disable_excludes=kubernetes
Ця сторінка пояснює, як оновити вузол Windows, створений за допомогою kubeadm.
Перш ніж ви розпочнете
Вам потрібен доступ до оболонки на всіх вузлах, а інструмент командного рядка kubectl має бути налаштований для звʼязку з вашим кластером. Рекомендується виконувати цей підручник у кластері, що має принаймні два вузли, які не є вузлами панелі управління.
Версія вашого Kubernetes сервера має бути не старішою ніж 1.17.
# замініть 1.37.0 на вашу бажану версіюcurl.exe-Lo<path-to-kubeadm.exe>"https://dl.k8s.io/v1.37.0/bin/windows/amd64/kubeadm.exe"
Виконайте drain вузла
З машини з доступом до API Kubernetes підготуйте вузол до обслуговування, позначивши його як недоступний для планування та виселивши робочі навантаження:
# замініть <node-to-drain> імʼям вашого вузла, для якого ви виконуєте drainkubectl drain <node-to-drain> --ignore-daemonsets
Якщо ви запускаєте kube-proxy в контейнері HostProcess всередині Podʼа, а не як службу Windows, ви можете оновити kube-proxy, застосувавши нову версію ваших маніфестів kube-proxy.
Виконайте uncordon вузла
З машини з доступом до API Kubernetes поверніть вузол в роботу, позначивши його як придатний для планування:
7.4.3 - Посилення безпеки динамічного виділення ресурсів у вашому кластері
Ця сторінка показує адміністраторам кластера, як посилити авторизацію для динамічного виділення ресурсів (DRA) з акцентом на доступ з мінімальними привілеями для оновлень статусу ResourceClaim.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Створіть обʼєкти ClusterRoleBinding для кожної ідентичності компонента та уникайте спільного використання широкої ролі між не повʼязаними між собою компонентами DRA.
Обмежте правила resourceclaims/driver за допомогою resourceNames, де це можливо, щоб ідентичність могла оновлювати статус лише для конкретного драйвера DRA, яким вона керує.
Перевірка та моніторинг
Перевірте, що кожна ідентичність має лише необхідні дієслова та субресурси.
Підтвердіть, що оновлення статусу DRA працюють після розгортання.
Спостерігайте за подіями аудиту API-сервера щодо відхилених запитів resourceclaims/binding та resourceclaims/driver.
7.5 - Запуск одноекземплярного застосунку зі збереженням стану
На цій сторінці показано, як запустити одноекземплярний застосунок зі збереженням стану в Kubernetes, використовуючи PersistentVolume та Deployment. Застосунок — MySQL.
Цілі
Створити PersistentVolume, що посилається на диск у вашому середовищі.
Створити Deployment MySQL.
Відкрити доступ до MySQL іншим Podʼам у кластері за відомим DNS-імʼям.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Ви можете запустити застосунок зі збереженням стану, створивши Deployment Kubernetes і підʼєднавши його до наявного PersistentVolume за допомогою PersistentVolumeClaim. Наприклад, цей файл YAML описує Deployment, який запускає MySQL і посилається на PersistentVolumeClaim. Файл визначає монтування тому для /var/lib/mysql, а потім створює PersistentVolumeClaim, що шукає том на 20G. Цю заявку задовольняє будь-який наявний том, що відповідає вимогам, або динамічний provisioner.
Примітка: пароль визначено у файлі конфігурації yaml, і це небезпечно. Безпечне рішення дивіться в розділі Kubernetes Secrets.
apiVersion:v1kind:Servicemetadata:name:mysqlspec:ports:- port:3306selector:app:mysqlclusterIP:None---apiVersion:apps/v1kind:Deploymentmetadata:name:mysqlspec:selector:matchLabels:app:mysqlstrategy:type:Recreatetemplate:metadata:labels:app:mysqlspec:containers:- image:mysql:9name:mysqlenv:# Use secret in real usage- name:MYSQL_ROOT_PASSWORDvalue:passwordports:- containerPort:3306name:mysqlvolumeMounts:- name:mysql-persistent-storagemountPath:/var/lib/mysqlvolumes:- name:mysql-persistent-storagepersistentVolumeClaim:claimName:mysql-pv-claim
Наведений вище файл YAML створює сервіс, який дає іншим Podʼам у кластері змогу отримувати доступ до бази даних. Параметр Service clusterIP: None дозволяє DNS-імені Service розвʼязуватися безпосередньо в IP-адресу Podʼа. Це оптимально, коли за Service стоїть лише один Pod і ви не маєте наміру збільшувати кількість Podʼів.
Запустіть клієнта MySQL, щоб підʼєднатися до сервера:
kubectl run -it --rm --image=mysql:9 --restart=Never mysql-client -- mysql -h mysql -ppassword
Ця команда створює в кластері новий Pod, у якому працює клієнт MySQL, і підʼєднує його до сервера через Service. Якщо зʼєднання встановлено, значить, ваша база даних MySQL зі збереженням стану запущена й працює.
Waiting for pod default/mysql-client-274442439-zyp6i to be running, status is Pending, pod ready: false
If you don't see a command prompt, try pressing enter.
mysql>
Оновлення
Образ або будь-яку іншу частину Deployment можна оновити як зазвичай за допомогою команди kubectl apply. Ось деякі запобіжні заходи, специфічні для застосунків зі збереженням стану:
Не масштабуйте застосунок. Це налаштування призначене лише для одноекземплярних застосунків. Базовий PersistentVolume можна змонтувати лише в один Pod. Про кластеризовані застосунки зі збереженням стану дивіться документацію StatefulSet.
Використовуйте strategy:type: Recreate у файлі конфігурації YAML для Deployment. Це вказує Kubernetes не використовувати поетапні оновлення. Поетапні оновлення не працюватимуть, оскільки одночасно не може працювати більше одного Podʼа. Стратегія Recreate зупинить перший Pod перед створенням нового з оновленою конфігурацією.
Якщо ви надали PersistentVolume вручну, вам також потрібно вручну видалити його й звільнити базовий ресурс. Якщо ви використовували динамічний provisioner, він автоматично видаляє PersistentVolume, коли бачить, що ви видалили PersistentVolumeClaim. Деякі динамічні provisioners (наприклад, для EBS і PD) також звільняють базовий ресурс під час видалення PersistentVolume.
7.6 - Запуск реплікованого застосунку зі збереженням стану
Ця сторінка показує, як запустити реплікований застосунок зі збереженням стану (StatefulSet). Цей застосунок — реплікована база даних MySQL. У топології цього прикладу є один головний сервер і кілька реплік, що використовують асинхронну реплікацію на основі рядків.
Примітка:
Ця конфігурація не призначена для промислового середовища. Налаштування MySQL залишаються на небезпечних типових значеннях, щоб зосередитися на загальних патернах запуску застосунків зі збереженням стану в Kubernetes.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
apiVersion:v1kind:ConfigMapmetadata:name:mysqllabels:app:mysqlapp.kubernetes.io/name:mysqldata:primary.cnf:| # Apply this config only on the primary.
[mysqld]
log-binreplica.cnf:| # Apply this config only on replicas.
[mysqld]
super-read-only
Цей ConfigMap надає перевизначення для my.cnf, що дозволяє вам незалежно керувати конфігурацією на головному сервері MySQL та його репліках. У цьому випадку ви хочете, щоб головний сервер міг надавати логи реплікації реплікам, а репліки відхиляли будь-які записи, які надходять не через реплікацію.
Немає нічого особливого у самому ConfigMap, що зумовлює застосування різних частин до різних Podʼів. Кожен Pod вирішує, яку частину дивитися при ініціалізації, на основі інформації, що надає контролер StatefulSet.
Створення Service
Створіть Service із наступного файлу конфігурації YAML:
# Headless service for stable DNS entries of StatefulSet members.apiVersion:v1kind:Servicemetadata:name:mysqllabels:app:mysqlapp.kubernetes.io/name:mysqlspec:ports:- name:mysqlport:3306clusterIP:Noneselector:app:mysql---# Client service for connecting to any MySQL instance for reads.# For writes, you must instead connect to the primary: mysql-0.mysql.apiVersion:v1kind:Servicemetadata:name:mysql-readlabels:app:mysqlapp.kubernetes.io/name:mysqlreadonly:"true"spec:ports:- name:mysqlport:3306selector:app:mysql
Headless Service надає місце для DNS-записів, які контролери StatefulSet створюють для кожного Podʼа, що є частиною набору. Оскільки headless Service називається mysql, Podʼи доступні через розвʼязання імені <pod-name>.mysql з будь-якого іншого Podʼа в тому самому кластері Kubernetes і просторі імен.
Клієнтський Service, з назвою mysql-read, є звичайним Service з власним кластерним IP, який розподіляє підключення між всіма Podʼами MySQL, які повідомляють про готовність. Набір потенційних точок доступу включає головний сервер MySQL та всі репліки.
Зверніть увагу, що лише запити на читання можуть використовувати клієнтський Service з балансуванням навантаження. Оскільки існує лише один головний сервер MySQL, клієнти повинні підключатися безпосередньо до головного Podʼа MySQL (через його DNS-запис у headless Service) для виконання записів.
Створення StatefulSet
Наостанок, створіть StatefulSet із наступного файлу конфігурації YAML:
Ви можете спостерігати за процесом запуску, виконавши:
kubectl get pods -l app=mysql --watch
Через деякий час ви повинні побачити, що всі 3 Podʼи стануть Running:
NAME READY STATUS RESTARTS AGE
mysql-0 2/2 Running 0 2m
mysql-1 2/2 Running 0 1m
mysql-2 2/2 Running 0 1m
Натисніть Ctrl+C, щоб скасувати перегляд.
Примітка:
Якщо ви не бачите жодних змін, переконайтеся, що у вас увімкнений динамічний provisioner PersistentVolume, як зазначено у передумовах.
Цей маніфест використовує різноманітні техніки для керування Podʼами зі збереженням стану в межах StatefulSet. У наступному розділі підкреслено деякі з цих технік, щоб пояснити, що відбувається під час створення Podʼів StatefulSet.
Розуміння ініціалізації Podʼа зі збереженням стану
Контролер StatefulSet запускає Podʼи по одному, в порядку їх індексів. Він чекає, доки кожен Pod не повідомить про готовність, перш ніж запустити наступний.
Крім того, контролер призначає кожному Podʼу унікальне, стабільне імʼя у формі <statefulset-name>-<ordinal-index>, в результаті отримуємо Podʼи з іменами mysql-0, mysql-1 та mysql-2.
Шаблон Podʼа у вищенаведеному маніфесті StatefulSet використовує ці властивості, щоб здійснити впорядкований запуск реплікації MySQL.
Створення конфігурації
Перед запуском будь-яких контейнерів у специфікації Podʼа, спочатку Pod запускає будь-які
контейнери ініціалізації у визначеному порядку.
Перший контейнер ініціалізації, init-mysql, генерує спеціальні конфігураційні файли MySQL на основі порядкового індексу.
Скрипт визначає свій власний порядковий індекс, витягуючи його з кінця імені Podʼа, яке повертається командою hostname. Потім він зберігає порядковий індекс (з числовим зміщенням для уникнення зарезервованих значень) у файлі з назвою server-id.cnf в теці conf.d MySQL. Це перетворює унікальний, стабільний ідентифікатор, наданий StatefulSet, у домен ідентифікаторів серверів MySQL, які вимагають таких же властивостей.
Скрипт у контейнері init-mysql також застосовує або primary.cnf, або replica.cnf з ConfigMap, копіюючи вміст у conf.d. Оскільки у топології цього прикладу є лише один головний сервер MySQL та будь-яка кількість реплік, скрипт призначає порядковий індекс 0 головному серверу, а всі інші — репліками. Разом з гарантією контролера StatefulSet щодо порядку розгортання, це забезпечує готовність головного сервера MySQL перед створенням реплік, щоб вони могли почати реплікацію.
Клонування наявних даних
Загалом, коли новий Pod приєднується до набору як репліка, він повинен припускати, що головний сервер MySQL може вже містити дані. Також він повинен припускати, що логи реплікації можуть не сягати самого початку. Ці консервативні припущення є ключем до того, щоб запущений StatefulSet міг масштабуватися вгору та вниз з часом, а не залишатися фіксованим на своєму початковому розмірі.
Другий контейнер ініціалізації, з назвою clone-mysql, виконує операцію клонування на реплікаційному Podʼі першого разу, коли він запускається на порожньому PersistentVolume. Це означає, що він копіює всі наявні дані з іншого працюючого Podʼа, таким чином, його локальний стан є достатньо консистентним для початку реплікації з головного сервера.
MySQL сам по собі не надає механізму для цього, тому приклад використовує популярний відкритий інструмент — Percona XtraBackup. Під час клонування сервер-джерело MySQL може мати знижену продуктивність. Щоб мінімізувати вплив на головний сервер MySQL, скрипт вказує кожному Podʼу отримувати дані з Podʼа, чий порядковий індекс на одиницю менший. Це працює через те, що контролер StatefulSet завжди гарантує, що Pod N є готовим перед запуском Podʼа N+1.
Початок реплікації
Після успішного завершення контейнерів ініціалізації запускаються звичайні контейнери. Podʼи MySQL складаються з контейнера mysql, в якому працює фактичний сервер mysqld, та контейнера xtrabackup, який діє як sidecar.
Sidecar xtrabackup переглядає клоновані файли даних і визначає, чи необхідно ініціалізувати реплікацію MySQL на репліці. У цьому випадку він чекає, доки mysqld буде готовий, а потім виконує команди CHANGE MASTER TO та START SLAVE з параметрами реплікації, отриманими з клонованих файлів XtraBackup.
Після того як репліка починає реплікацію, вона запамʼятовує свій головний сервер MySQL і автоматично підʼєднується, якщо сервер перезапускається або зʼєднання втрачається. Також, оскільки репліки шукають головний сервер за його стабільним DNS-імʼям (mysql-0.mysql), вони автоматично знаходять головний сервер навіть якщо він отримує новий IP Podʼа через перепланування.
Нарешті, після початку реплікації, контейнер xtrabackup слухає зʼєднання з інших Podʼів, які запитують клон даних. Цей сервер залишається активним нескінченно довго в разі, якщо StatefulSet масштабується вгору, або якщо наступний Pod втрачає свій PersistentVolumeClaim і потрібно повторно виконати клонування.
Надсилання клієнтського трафіку
Ви можете надіслати тестові запити до головного сервера MySQL (хост mysql-0.mysql) запустивши тимчасовий контейнер з образом mysql:5.7 і використовуючи бінарний файл клієнта mysql.
kubectl run mysql-client --image=mysql:5.7 -i --rm --restart=Never --\
mysql -h mysql-0.mysql <<EOF
CREATE DATABASE test;
CREATE TABLE test.messages (message VARCHAR(250));
INSERT INTO test.messages VALUES ('hello');
EOF
Використовуйте хост mysql-read, щоб надіслати тестові запити до будь-якого сервера, який повідомляє про готовність:
kubectl run mysql-client --image=mysql:5.7 -i -t --rm --restart=Never --\
mysql -h mysql-read -e "SELECT * FROM test.messages"
Ви повинні отримати вивід схожий на цей:
Waiting for pod default/mysql-client to be running, status is Pending, pod ready: false
+---------+
| message |
+---------+
| hello |
+---------+
pod "mysql-client" deleted
Щоб продемонструвати, що Service mysql-read розподіляє підключення між
серверами, ви можете запустити SELECT @@server_id у циклі:
kubectl run mysql-client-loop --image=mysql:5.7 -i -t --rm --restart=Never --\
bash -ic "while sleep 1; do mysql -h mysql-read -e 'SELECT @@server_id,NOW()'; done"
Ви повинні бачити, що @@server_id змінюється випадковим чином, оскільки може бути вибрана інша точка доступу при кожній спробі підключення:
Ви можете натиснути Ctrl+C, коли захочете зупинити цикл, але цікаво тримати його запущеним в іншому вікні, щоб бачити ефект від наступних кроків.
Симуляція відмови Podʼа та вузла
Щоб продемонструвати підвищену доступність читання з пулу реплік замість одного сервера, залиште цикл SELECT @@server_id, запущений вище, активним, тоді як ви змушуєте Pod вийти зі стану Ready.
Зламайте пробу готовності
Проба готовності для контейнера mysql виконує команду mysql -h 127.0.0.1 -e 'SELECT 1', щоб переконатися, що сервер запущений і може виконувати запити.
Один зі способів змусити цю пробу готовності не спрацювати — зламати цю команду:
kubectl exec mysql-2 -c mysql -- mv /usr/bin/mysql /usr/bin/mysql.off
Ця дія втручається у файлову систему контейнера Podʼа mysql-2 і перейменовує команду mysql, щоб проба готовності не могла її знайти. Через кілька секунд Pod повинен повідомити про один зі своїх контейнерів як неготовий, що можна перевірити за допомогою:
kubectl get pod mysql-2
Перевірте значення 1/2 у стовпці READY:
NAME READY STATUS RESTARTS AGE
mysql-2 1/2 Running 0 3m
На цьому етапі ви повинні бачити продовження роботи вашого циклу SELECT @@server_id, хоча він більше не повідомляє про 102. Нагадаємо, що скрипт init-mysql визначив server-id як 100 + $ordinal, тож ідентифікатор сервера 102 відповідає Podʼу mysql-2.
Тепер відновіть Pod і він повинен знову зʼявитися у виводі циклу через кілька секунд:
kubectl exec mysql-2 -c mysql -- mv /usr/bin/mysql.off /usr/bin/mysql
Видалення Podʼів
Контролер StatefulSet також створює Podʼи знову, якщо вони видалені, подібно до того, як це робить ReplicaSet для Podʼів без збереження стану.
kubectl delete pod mysql-2
Контролер StatefulSet помічає, що Podʼа mysql-2 більше не існує, і створює новий з тією ж назвою та повʼязаний з тим самим PersistentVolumeClaim. Ви повинні побачити, що ідентифікатор сервера 102 зникне з виводу циклу протягом певного часу і потім повернеться самостійно.
Виконайте drain вузла
Якщо у вашому кластері Kubernetes є кілька вузлів, ви можете симулювати відмову вузла (наприклад, під час оновлення вузлів) за допомогою команди drain.
Спочатку визначте, на якому вузлі знаходиться один із Podʼів MySQL:
kubectl get pod mysql-2 -o wide
Назва вузла повинна зʼявитися у останньому стовпчику:
NAME READY STATUS RESTARTS AGE IP NODE
mysql-2 2/2 Running 0 15m 10.244.5.27 kubernetes-node-9l2t
Потім виконайте drain вузла такою командою: вона виконує cordon вузла, щоб нові Podʼи не могли туди плануватися, а потім виселяє всі наявні Podʼи. Замість <node-name> підставте назву вузла, яку ви знайшли на попередньому кроці.
Увага:
Drain вузла може вплинути на інші робочі навантаження та застосунки, що працюють на тому ж вузлі. Виконуйте наступний крок тільки на тестовому кластері.
# Дивіться вище поради щодо впливу на інші робочі навантаженняkubectl drain <node-name> --force --delete-emptydir-data --ignore-daemonsets
Тепер ви можете спостерігати, як Pod переплановується на іншому вузлі:
І знову, ви повинні побачити, що ідентифікатор сервера 102 зник з виводу циклу SELECT @@server_id протягом певного часу, а потім повернувся.
Тепер виконайте uncordon вузла, щоб повернути його до звичайного стану:
kubectl uncordon <node-name>
Масштабування кількості реплік
Коли ви використовуєте реплікацію MySQL, ви можете збільшувати пропускну здатність для запитів на читання, додаючи репліки. Для StatefulSet це можна зробити однією командою:
kubectl scale statefulset mysql --replicas=5
Спостерігайте, як нові Podʼи запускаються, виконавши:
kubectl get pods -l app=mysql --watch
Коли вони будуть готові, ви побачите, що ідентифікатори серверів 103 та 104 починають зʼявлятися у виводі циклу SELECT @@server_id.
Ви також можете перевірити, що ці нові сервери мають дані, які ви додали ще до того, як вони зʼявилися:
kubectl run mysql-client --image=mysql:5.7 -i -t --rm --restart=Never --\
mysql -h mysql-3.mysql -e "SELECT * FROM test.messages"
Waiting for pod default/mysql-client to be running, status is Pending, pod ready: false
+---------+
| message |
+---------+
| hello |
+---------+
pod "mysql-client" deleted
Зменшення кількості реплік так само безпроблемне:
kubectl scale statefulset mysql --replicas=3
Примітка:
Хоча збільшення створює нові PersistentVolumeClaims автоматично, зменшення автоматично не видаляє ці PVC.
Це дає вам можливість залишити ці ініціалізовані PVC для швидшого збільшення, або вилучити дані перед їх видаленням.
Ви можете перевірити це, виконавши:
kubectl get pvc -l app=mysql
Це покаже, що всі 5 PVC все ще існують, попри те, що StatefulSet був зменшений до 3:
Припиніть цикл SELECT @@server_id, натиснувши Ctrl+C в його терміналі або виконавши наступне з іншого терміналу:
kubectl delete pod mysql-client-loop --now
Видаліть StatefulSet. Це також розпочне завершення Podʼів.
kubectl delete statefulset mysql
Перевірте, що Podʼи зникають. Завершення їхньої роботи може зайняти деякий час.
kubectl get pods -l app=mysql
Ви будете знати, що Podʼи завершилися, коли вищезазначена команда поверне:
No resources found.
Видаліть ConfigMap, Services та PersistentVolumeClaims.
kubectl delete configmap,service,pvc -l app=mysql
Якщо ви вручну надавали PersistentVolumes, вам також потрібно вручну видалити їх, а також звільнити відповідні ресурси. Якщо ви використовували динамічний provisioner, він автоматично видаляє PersistentVolumes, коли бачить, що ви видалили PersistentVolumeClaims. Деякі динамічні provisioners (такі як ті, що стосуються EBS та PD) також звільняють відповідні ресурси при видаленні PersistentVolumes.
7.7 - Налагодження вузлів Kubernetes за допомогою crictl
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.11
crictl — це інтерфейс командного рядка для середовищ виконання контейнерів, сумісних з CRI. За його допомогою можна оглядати й налагоджувати середовища виконання контейнерів і застосунки на вузлі Kubernetes. crictl і його вихідний код розміщено в репозиторії cri-tools.
Перш ніж ви розпочнете
Для роботи crictl потрібна операційна система Linux із середовищем виконання CRI.
Встановлення crictl
Стиснений архів crictl для кількох різних архітектур можна завантажити зі сторінки релізів cri-tools. Завантажте версію, яка відповідає вашій версії Kubernetes. Розпакуйте архів і перемістіть crictl у теку з вашого системного шляху, наприклад /usr/local/bin/.
Загальне використання
Команда crictl має кілька підкоманд і прапорців середовища виконання. Докладніше дивіться crictl help або crictl <subcommand> help.
Точку доступу для crictl можна встановити одним із таких способів:
Встановіть прапорці --runtime-endpoint та --image-endpoint.
Встановіть змінні середовища CONTAINER_RUNTIME_ENDPOINT та IMAGE_SERVICE_ENDPOINT.
Встановіть точку доступу у файлі конфігурації /etc/crictl.yaml. Щоб вказати інший файл, використовуйте прапорець --config=PATH_TO_FILE під час запуску crictl.
Примітка:
Якщо ви не встановите точку доступу, crictl намагатиметься підʼєднатися до відомих точок доступу зі списку, що може вплинути на продуктивність.
Також можна вказати тайм-аут підʼєднання до сервера й увімкнути або вимкнути налагодження, задавши значення timeout або debug у файлі конфігурації або використавши прапорці командного рядка --timeout і --debug.
Щоб переглянути або змінити поточну конфігурацію, перегляньте або відредагуйте вміст /etc/crictl.yaml. Наприклад, з середовищем виконання контейнерів containerd конфігурація буде схожа на таку:
Наведені нижче приклади показують деякі команди crictl і приклади їхнього виводу.
Отримання переліку Podʼів
Вивести всі Podʼи:
crictl pods
Вивід подібний до такого:
POD ID CREATED STATE NAME NAMESPACE ATTEMPT
926f1b5a1d33a About a minute ago Ready sh-84d7dcf559-4r2gq default 0
4dccb216c4adb About a minute ago Ready nginx-65899c769f-wv2gp default 0
a86316e96fa89 17 hours ago Ready kube-proxy-gblk4 kube-system 0
919630b8f81f1 17 hours ago Ready nvidia-device-plugin-zgbbv kube-system 0
Вивести Podʼи за назвою:
crictl pods --name nginx-65899c769f-wv2gp
Вивід подібний до такого:
POD ID CREATED STATE NAME NAMESPACE ATTEMPT
4dccb216c4adb 2 minutes ago Ready nginx-65899c769f-wv2gp default 0
Вивести Podʼи за міткою:
crictl pods --label run=nginx
Вивід подібний до такого:
POD ID CREATED STATE NAME NAMESPACE ATTEMPT
4dccb216c4adb 2 minutes ago Ready nginx-65899c769f-wv2gp default 0
CONTAINER ID IMAGE CREATED STATE NAME ATTEMPT
1f73f2d81bf98 busybox@sha256:141c253bc4c3fd0a201d32dc1f493bcf3fff003b6df416dea4f41046e0f37d47 7 minutes ago Running sh 1
9c5951df22c78 busybox@sha256:141c253bc4c3fd0a201d32dc1f493bcf3fff003b6df416dea4f41046e0f37d47 8 minutes ago Exited sh 0
87d3992f84f74 nginx@sha256:d0a8828cccb73397acb0073bf34f4d7d8aa315263f1e7806bf8c55d8ac139d5f 8 minutes ago Running nginx 0
1941fb4da154f k8s-gcrio.azureedge.net/hyperkube-amd64@sha256:00d814b1f7763f4ab5be80c58e98140dfc69df107f253d7fdd714b30a714260a 18 hours ago Running kube-proxy 0
Вивести запущені контейнери:
crictl ps
Вивід подібний до такого:
CONTAINER ID IMAGE CREATED STATE NAME ATTEMPT
1f73f2d81bf98 busybox@sha256:141c253bc4c3fd0a201d32dc1f493bcf3fff003b6df416dea4f41046e0f37d47 6 minutes ago Running sh 1
87d3992f84f74 nginx@sha256:d0a8828cccb73397acb0073bf34f4d7d8aa315263f1e7806bf8c55d8ac139d5f 7 minutes ago Running nginx 0
1941fb4da154f k8s-gcrio.azureedge.net/hyperkube-amd64@sha256:00d814b1f7763f4ab5be80c58e98140dfc69df107f253d7fdd714b30a714260a 17 hours ago Running kube-proxy 0
Призначення інфраструктурних ресурсів для ваших робочих навантажень Kubernetes.
7.8.1 - Налаштування DRA у кластері
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.30 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate DynamicResourceAllocation, Kubernetes ignores it but does not report any error.
На цій сторінці показано, як налаштувати динамічне виділення ресурсів (DRA) у кластері Kubernetes шляхом активації груп API та налаштування класів пристроїв. Ці інструкції призначені для адміністраторів кластерів.
Про DRA
Можливість Kubernetes, яка дозволяє запитувати ресурси та спільно використовувати їх між Podʼами. Часто такими ресурсами є приєднані пристрої, як-от апаратні прискорювачі.
З DRA драйвери пристроїв і адміністратори кластера визначають класи пристроїв, які робочі навантаження можуть запитувати (claim). Kubernetes виділяє відповідні пристрої конкретним запитам (claims) і розміщує відповідні Podʼи на вузлах, які мають доступ до виділених пристроїв.
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Версія вашого Kubernetes сервера має бути не старішою ніж v1.34.
Для перевірки версії введіть kubectl version.
Підключіть пристрої до вашого кластера безпосередньо або опосередковано. Щоб уникнути можливих проблем із драйверами, дочекайтеся налаштування функції DRA для вашого кластера перед встановленням драйверів.
Опціонально: увімкніть додаткові групи API DRA
Загалом DRA є стабільною функцією в Kubernetes, проте деякі її аспекти можуть бути ще в стадії альфа- або бета-тестування. Якщо ви хочете використовувати будь-який аспект DRA, який ще не є стабільним, а повʼязана з ним функція залежить від спеціального типу API, тоді ви повинні увімкнути відповідні групи альфа- або бета-API.
Деякі старі драйвери або робочі навантаження DRA можуть все ще потребувати API v1beta1 з Kubernetes 1.30 або v1beta2 з Kubernetes 1.32. Тільки якщо потрібна підтримка цих версій, увімкніть наступні групи API:
Щоб перевірити правильність налаштування кластера, спробуйте вивести список DeviceClasses:
kubectl get deviceclasses
Якщо конфігурація компонентів була правильною, ви побачите подібний результат:
No resources found
Якщо DRA налаштовано неправильно, результат виконання попередньої команди буде схожий на:
error: the server doesn't have a resource type "deviceclasses"
Наприклад, це може статися, коли група API resource.k8s.io була вимкнена. Аналогічна перевірка застосовується до типів верхнього рівня якості альфа або бета.
Спробуйте наступні кроки для усунення несправностей:
Переконфігуруйте та перезапустіть компонент kube-apiserver.
Якщо повне поле .spec.resourceClaims видаляється з Podʼів, або якщо Podʼи плануються без урахування ResourceClaims, перевірте, чи не вимкнено функціональну можливість DynamicResourceAllocation для kube-apiserver, kube-controller-manager, kube-scheduler або kubelet.
Встановіть драйвери пристроїв
Після активації DRA для вашого кластера ви можете встановити драйвери для підключених пристроїв. Інструкції шукайте у документації власника пристрою або проєкту, що підтримує драйвери пристроїв. Встановлені драйвери мають бути сумісні з DRA.
Щоб перевірити роботу встановлених драйверів, виведіть список ResourceSlices у кластері:
kubectl get resourceslices
Вивід буде схожий на:
NAME NODE DRIVER POOL AGE
00000-driver.example.com-cluster-1-node-1-abcde cluster-1-node-1 driver.example.com cluster-1-device-pool-1-r1gc 7s
00000-driver.example.com-cluster-1-node-2-fghij cluster-1-node-2 driver.example.com cluster-1-device-pool-2-446z 8s
Спробуйте наступні кроки для усунення несправностей:
Перевірте стан драйвера DRA та шукайте повідомлення про помилки щодо публікації ResourceSlices у виводі його логів. Постачальник драйвера може надати додаткові інструкції щодо встановлення та усунення несправностей.
Створіть DeviceClasses
Ви можете визначити категорії пристроїв, які оператори ваших застосунків можуть запитувати у робочих навантаженнях, створюючи DeviceClasses. Деякі постачальники драйверів пристроїв також можуть вказати вам створити DeviceClasses під час встановлення драйверів.
ResourceSlices, які публікує ваш драйвер, містять інформацію про пристрої, якими керує драйвер, такі як ємність, метадані та атрибути. Ви можете використовувати Common Expression Language для фільтрації властивостей у DeviceClasses, що спрощує пошук пристроїв для операторів навантажень.
Щоб знайти властивості пристрою, які можна вибирати у DeviceClasses за допомогою виразів CEL, отримайте специфікацію ResourceSlice:
kubectl get resourceslice <resourceslice-name> -o yaml
Вивід буде схожий на:
apiVersion:resource.k8s.io/v1kind:ResourceSlice# рядки пропущено для ясностіspec:devices:- attributes:type:string:gpucapacity:memory:value:64Giname:gpu-0- attributes:type:string:gpucapacity:memory:value:64Giname:gpu-1driver:driver.example.comnodeName:cluster-1-node-1# рядки пропущено для ясності
Ви також можете переглянути документацію постачальника драйверів для доступних властивостей і значень.
Ознайомтеся з прикладом маніфесту DeviceClass, який вибирає будь-який пристрій, керований драйвером пристроїв driver.example.com:
7.8.2 - Виділення пристроїв робочим навантаженням за допомогою DRA
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.35
More information about this feature
This is a stable feature in Kubernetes, and has been since version v1.35. It was first available in the v1.30 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate DynamicResourceAllocation, Kubernetes ignores it but does not report any error.
На цій сторінці показано, як виділяти пристрої вашим Podʼам за допомогою динамічного виділення ресурсів (DRA). Ці інструкції призначені для операторів робочих навантажень. Перед прочитанням цієї сторінки ознайомтеся з принципами роботи DRA та термінами DRA, такими як ResourceClaims і ResourceClaimTemplates. Докладніше дивіться у розділі Динамічне виділення ресурсів (DRA).
Про виділення пристроїв за допомогою DRA
Як оператор робочих навантажень, ви можете запитувати пристрої для своїх навантажень, створюючи ResourceClaims або ResourceClaimTemplates. Під час розгортання навантаження Kubernetes і драйвери пристроїв знаходять доступні пристрої, виділяють їх вашим Podʼам і розміщують Podʼи на вузлах, які мають доступ до цих пристроїв.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Версія вашого Kubernetes сервера має бути не старішою ніж v1.34.
Для перевірки версії введіть kubectl version.
Переконайтеся, що адміністратор вашого кластера налаштував DRA, підключив пристрої та встановив драйвери. Докладніше дивіться у розділі Налаштування DRA у кластері.
Визначення пристроїв для подання заявок на них
Адміністратор вашого кластера або драйвери пристроїв створюють DeviceClasses, які визначають категорії пристроїв. Ви можете запитувати пристрої, використовуючи Common Expression Language для фільтрації за конкретними властивостями пристроїв.
Отримайте список DeviceClasses у кластері:
kubectl get deviceclasses
Вивід буде схожим на наступний:
NAME AGE
driver.example.com 16m
Якщо ви отримали помилку доступу, можливо, у вас немає прав для перегляду DeviceClasses. Зверніться до адміністратора кластера або постачальника драйверів щодо доступних властивостей пристроїв.
Запитування ресурсів
Ви можете запитувати ресурси з DeviceClass за допомогою ResourceClaims. Щоб створити ResourceClaim, виконайте одну з наступних дій:
Створіть ResourceClaim вручну, якщо ви хочете, щоб декілька Podʼів мали спільний доступ до одних і тих самих пристроїв, або якщо ви хочете, щоб заявка існувала довше, ніж Pod.
Використовуйте ResourceClaimTemplate, щоб Kubernetes генерував і керував ResourceClaims для кожного Podʼа. Створіть ResourceClaimTemplate, якщо ви хочете, щоб кожен Pod мав доступ до окремих пристроїв із подібними конфігураціями. Наприклад, вам може знадобитися одночасний доступ до пристроїв для Podʼів у Job, який використовує паралельне виконання.
Якщо ви безпосередньо посилаєтеся на конкретний ResourceClaim у Podʼі, цей ResourceClaim вже має існувати у кластері. Якщо зазначений ResourceClaim не існує, Pod залишатиметься у стані очікування, доки ResourceClaim не буде створено. Ви можете посилатися на автоматично згенерований ResourceClaim у Podʼі, але це не рекомендується, оскільки автоматично згенеровані ResourceClaims привʼязані до часу життя Podʼа, який спричинив їх створення.
Щоб створити робоче навантаження, яке запитує ресурси, виберіть одну з наступних опцій:
Запит пристроїв у робочих навантаженнях за допомогою DRA
Щоб запросити виділення пристроїв, вкажіть ResourceClaim або ResourceClaimTemplate у полі resourceClaims специфікації Podʼа. Потім запросіть конкретну заявку за назвою у полі resources.claims контейнера цього Podʼа. Ви можете вказати декілька записів у полі resourceClaims та використовувати конкретні заявки у різних контейнерах.
Коли робоче навантаження не запускається, як очікувалося, пройдіть ланцюжком від Job до Podʼів і до ResourceClaims та перевірте обʼєкти на кожному рівні за допомогою kubectl describe, щоб дізнатися, чи є якісь поля статусу або події, які можуть пояснити, чому робоче навантаження не запускається.
Коли створення Podʼа не вдається з must specify one of: resourceClaimName, resourceClaimTemplateName, перевірте, що всі записи в pod.spec.resourceClaims мають точно одне з цих полів. Якщо так, то можливо, що в кластері встановлено модифікуючий вебхук Podʼа, який був створений для API Kubernetes < 1.32. Попросіть адміністратора кластера перевірити це.
Очищення
Щоб видалити обʼєкти Kubernetes, створені у цьому завданні, виконайте наступні кроки:
Ця сторінка показує, як отримати доступ до метаданих пристроїв з контейнерів, які використовують динамічне виділення ресурсів (DRA). Метадані пристроїв дозволяють робочим навантаженням дізнаватися інформацію про виділені пристрої, таку як атрибути пристроїв або деталі мережевого інтерфейсу, шляхом читання JSON-файлів за відомими шляхами всередині контейнера.
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Переконайтесь, що адміністратор вашого кластера налаштував DRA, підключив пристрої та встановив драйвери. Для отримання додаткової інформації дивіться Налаштування DRA в кластері.
Переконайтесь, що драйвер DRA, розгорнутий у вашому кластері, підтримує метадані пристроїв. Автори драйверів, які використовують втулок kubelet DRA, вмикають підтримку за допомогою EnableDeviceMetadata та повинні включити metadata.resource.k8s.io/v1beta1 у вибрані версії. Драйвер також може видавати v1alpha1 для сумісності зі старішими споживачами.
Доступ до метаданих пристроїв за допомогою ResourceClaim
Коли ви використовуєте безпосередньо вказаний ResourceClaim для виділення пристроїв, файли метаданих пристроїв зʼявляються всередині контейнера за шляхом:
Файл метаданих — це JSON-потік. Він містить один обʼєкт для кожної версії API, вибраної драйвером, у порядку, налаштованому драйвером. Драйвери повинні розміщувати найновішу версію першою. Обʼєкти містять еквівалентні метадані пристрою, тому команда може вивести більше ніж один JSON-обʼєкт.
Вивід містить атрибути пристрою, такі як модель, версія драйвера та UUID пристрою. Ємності пристроїв не є частиною схеми метаданих. Дивіться схему метаданих для деталей структури JSON.
Доступ до метаданих пристроїв за допомогою ResourceClaimTemplate
Коли ви використовуєте ResourceClaimTemplate, Kubernetes генерує ResourceClaim для кожного Podʼа. Оскільки згенерована назва заявки непередбачувана, файли метаданих натомість зʼявляються за шляхом, який використовує імʼя посилання на заявку в Podʼі:
Цей маніфест створює ResourceClaimTemplate та Pod. Кожен Pod отримує власний згенерований ResourceClaim. Шлях до метаданих використовує імʼя посилання на заявку в Podʼі — my-gpu.
Пакунок k8s.io/dynamic-resource-allocation/devicemetadata надає готові функції для читання файлів метаданих. Ці функції автоматично обробляють узгодження версій, декодують потік метаданих і перетворюють його на внутрішні типи, щоб ваш код працював з різними версіями схеми без ручної перевірки версій. Вони пропускають обʼєкти з невідомими версіями API та повертають перший сумісний обʼєкт.
Функції, які читають усі драйвери, повертають *metadata.DeviceMetadata з обʼєднаними запитами та атрибутами кожного пристрою. Функції, які приймають імʼя драйвера, повертають повний обʼєкт метаданих із файлу цього драйвера.
Допоміжні функції читання декодують метадані без перевірки. Щоб увімкнути перевірку, відкрийте файл і використайте DecodeMetadataFromStream:
Декодування та перевірка мають окремі результати. Помилка перевірки не заважає декодеру заповнювати deviceMetadata. Перевірка корисна, коли метадані надходять від власного драйвера, оскільки втулок kubelet DRA не перевіряє обʼєкти перед їх записом.
Застосунки іншими мовами можуть декодувати JSON-потік по одному обʼєкту за раз, перевіряти кожен apiVersion, пропускати невідомі версії та використовувати першу версію, яку вони підтримують.
Для отримання додаткової інформації про дизайн див. KEP-5304.
7.9 - Аудит
Аудит Kubernetes надає важливий для безпеки хронологічний набір записів, що документують послідовність дій у кластері. Кластер проводить аудит дій, ініційованих користувачами, застосунками, які використовують API Kubernetes, і самою панеллю управління.
Аудит дає змогу адміністраторам кластера відповісти на такі запитання:
що сталося?
коли це сталося?
хто це ініціював?
з чим це сталося?
де це було помічено?
звідки це було ініційовано?
куди це прямувало?
Записи аудиту починають свій життєвий цикл у компоненті kube-apiserver. Кожен запит на кожному етапі виконання генерує подію аудиту, яку потім попередньо обробляють відповідно до певної політики й записують у бекенд. Політика визначає, що записується, а бекенди зберігають записи. Поточні реалізації бекендів — файли логів і вебхуки.
Кожен запит можна записати з відповідним етапом (stage). Визначено такі етапи:
RequestReceived — етап для подій, що генеруються, щойно обробник аудиту отримує запит, і до того, як запит передано далі ланцюжком обробників.
ResponseStarted — після надсилання заголовків відповіді, але до надсилання тіла відповіді. Цей етап генерується лише для тривалих запитів (наприклад, watch).
ResponseComplete — тіло відповіді завершено, і більше жодних байтів не буде надіслано.
Panic — події, що генеруються, коли сталася паніка.
Можливість логування аудиту збільшує споживання памʼяті API-сервером, оскільки для кожного запиту зберігається певний контекст, потрібний для аудиту. Споживання памʼяті залежить від конфігурації логування аудиту.
Політика аудиту
Політика аудиту визначає правила щодо того, які події слід записувати і які дані вони мають містити. Структуру обʼєкта політики аудиту визначено в групі API audit.k8s.io. Під час обробки подію по черзі порівнюють зі списком правил. Перше правило, що збіглося, встановлює рівень аудиту події. Визначено такі рівні аудиту:
None — не записувати події, які відповідають цьому правилу.
Metadata — записувати події з метаданими (користувач, що надіслав запит, часова мітка, ресурс, дієслово тощо), але без тіла запиту чи відповіді.
Request — записувати події з метаданими й тілом запиту, але без тіла відповіді. Це не стосується запитів, не повʼязаних з ресурсами.
RequestResponse — записувати події з метаданими запиту, тілом запиту й тілом відповіді. Це не стосується запитів, не повʼязаних з ресурсами.
Файл з політикою можна передати kube-apiserver за допомогою прапорця --audit-policy-file. Якщо прапорець пропущено, жодні події не записуються. Зверніть увагу, що поле rulesобовʼязково має бути у файлі політики аудиту. Політика без правил (0) вважається неприпустимою.
apiVersion:audit.k8s.io/v1# Це обовʼязково.kind:Policy# Не генерувати події аудиту для всіх запитів на етапі RequestReceived.omitStages:- "RequestReceived"rules:# Логувати зміни Podʼів на рівні RequestResponse- level:RequestResponseresources:- group:""# Ресурс "pods" не охоплює запити до будь-якого субресурсу Podʼів,# що узгоджується з політикою RBAC.resources:["pods"]# Логувати "pods/log", "pods/status" на рівні Metadata- level:Metadataresources:- group:""resources:["pods/log","pods/status"]# Не логувати запити до ConfigMap з назвою "controller-leader"- level:Noneresources:- group:""resources:["configmaps"]resourceNames:["controller-leader"]# Не логувати watch-запити від "system:kube-proxy" до endpoints або services- level:Noneusers:["system:kube-proxy"]verbs:["watch"]resources:- group:""# основна група APIresources:["endpoints","services"]# Не логувати автентифіковані запити до певних URL-шляхів, що не є ресурсами.- level:NoneuserGroups:["system:authenticated"]nonResourceURLs:- "/api*"# Зіставлення за шаблоном.- "/version"# Логувати тіло запитів на зміну ConfigMap у kube-system.- level:Requestresources:- group:""# основна група APIresources:["configmaps"]# Це правило застосовується тільки до ресурсів в просторі імен "kube-system".# Порожній рядок "" можна використовувати для вибору ресурсів без простору імен.namespaces:["kube-system"]# Логувати зміни ConfigMap і Secret у всіх інших просторах імен на рівні Metadata.- level:Metadataresources:- group:""# основна група APIresources:["secrets","configmaps"]# Логувати всі інші ресурси в групах core та extensions на рівні Request.- level:Requestresources:- group:""# основна група API- group:"extensions"# Версію групи НЕ слід вказувати.# Загальне правило для логування всіх інших запитів на рівні Metadata.- level:Metadata# Тривалі запити, як-от watch, що підпадають під це правило,# не генерують подію аудиту на етапі RequestReceived.omitStages:- "RequestReceived"
Можна використати мінімальний файл політики аудиту, щоб записувати всі запити на рівні Metadata:
# Записувати всі запити на рівні Metadata.apiVersion:audit.k8s.io/v1kind:Policyrules:- level:Metadata
Якщо ви створюєте власний профіль аудиту, за відправну точку можна взяти профіль аудиту для Google Container-Optimized OS. Перегляньте скрипт configure-helper.sh, який генерує файл політики аудиту. Більшу частину файлу політики аудиту можна побачити безпосередньо в скрипті.
Бекенди аудиту зберігають події аудиту в зовнішньому сховищі. Без додаткових налаштувань kube-apiserver надає два бекенди:
бекенд логів, який записує події у файлову систему
бекенд webhook, який надсилає події до зовнішнього HTTP API
У всіх випадках події аудиту мають структуру, визначену API Kubernetes у групі API audit.k8s.io.
Примітка:
У разі патчів тіло запиту — це масив JSON з операціями патча, а не обʼєкт JSON з відповідним обʼєктом API Kubernetes. Наприклад, наведене нижче тіло запиту є коректним запитом на патч до /apis/batch/v1/namespaces/some-namespace/jobs/some-job-name:
Бекенд логів записує події аудиту у файл у форматі JSONlines. Бекенд аудиту логів можна налаштувати за допомогою таких прапорців kube-apiserver:
--audit-log-path вказує шлях до файлу логу, який бекенд логів використовує для запису подій аудиту. Якщо цей прапорець не вказано, бекенд логів вимкнено. - означає стандартний вивід
--audit-log-maxage визначає максимальну кількість днів для зберігання старих файлів логів аудиту
--audit-log-maxbackup визначає максимальну кількість файлів логів аудиту для зберігання
--audit-log-maxsize визначає максимальний розмір файлу логу аудиту в мегабайтах, після якого виконується його ротація
Якщо панель управління вашого кластера запускає kube-apiserver як Pod, не забудьте змонтувати hostPath у розташування файлу політики й файлу логів, щоб записи аудиту зберігалися. Наприклад:
Бекенд аудиту webhook надсилає події аудиту до віддаленого веб-API, яке вважається різновидом API Kubernetes, зокрема щодо засобів автентифікації. Бекенд аудиту webhook можна налаштувати за допомогою таких прапорців kube-apiserver:
--audit-webhook-config-file вказує шлях до файлу з конфігурацією webhook. Конфігурація webhook фактично є спеціалізованим kubeconfig.
--audit-webhook-initial-backoff вказує час очікування після першого невдалого запиту перед повторною спробою. Подальші запити повторюються з експоненційною затримкою.
Файл конфігурації webhook використовує формат kubeconfig, щоб вказати віддалену адресу сервісу й облікові дані для підʼєднання до нього.
Пакетна обробка подій
Обидва бекенди, log і webhook, підтримують пакетну обробку. Нижче наведено перелік доступних прапорців для кожного бекенду. Стандартно пакетну обробку й тротлінг увімкнено для бекенду webhook і вимкнено для бекенду log.
--audit-webhook-mode визначає стратегію буферизації. Можливі значення:
batch — буферизувати події й асинхронно обробляти їх пакетами. Це стандартний режим для бекенду webhook.
blocking — блокувати відповіді API-сервера під час обробки кожної окремої події.
blocking-strict — те саме, що й blocking, але якщо під час логування аудиту на етапі RequestReceived стається збій, увесь запит до kube-apiserver завершується невдачею.
Такі прапорці використовуються лише в режимі batch:
--audit-webhook-batch-buffer-size визначає кількість подій для буферизації перед пакетною обробкою. Якщо швидкість надходження подій переповнює буфер, події відкидаються. Стандартне значення — 10000.
--audit-webhook-batch-max-size визначає максимальну кількість подій в одному пакеті. Стандартне значення — 400.
--audit-webhook-batch-max-wait визначає максимальний час очікування перед безумовною пакетною обробкою подій у черзі. Стандартне значення — 30 секунд.
--audit-webhook-batch-throttle-enable визначає, чи увімкнено тротлінг пакетів. Стандартно тротлінг увімкнено.
--audit-webhook-batch-throttle-qps визначає максимальну середню кількість пакетів, що генеруються за секунду. Стандартне значення — 10.
--audit-webhook-batch-throttle-burst визначає максимальну кількість пакетів, згенерованих у той самий момент, якщо дозволений QPS раніше використовувався не повністю. Стандартне значення — 15.
--audit-log-mode визначає стратегію буферизації. Можливі значення:
batch — буферизувати події й асинхронно обробляти їх пакетами. Пакетна обробка не рекомендується для бекенду log.
blocking — блокувати відповіді API-сервера під час обробки кожної окремої події. Це стандартний режим для бекенду log.
blocking-strict — те саме, що й blocking, але якщо під час логування аудиту на етапі RequestReceived стається збій, увесь запит до kube-apiserver завершується невдачею.
Такі прапорці використовуються лише в режимі batch (стандартно для бекенду log пакетну обробку вимкнено, і коли її вимкнено, усі прапорці, повʼязані з пакетною обробкою, ігноруються):
--audit-log-batch-buffer-size визначає кількість подій для буферизації перед пакетною обробкою. Якщо швидкість надходження подій переповнює буфер, події відкидаються.
--audit-log-batch-max-size визначає максимальну кількість подій в одному пакеті.
--audit-log-batch-max-wait визначає максимальний час очікування перед безумовною пакетною обробкою подій у черзі.
--audit-log-batch-throttle-enable визначає, чи увімкнено тротлінг пакетної обробки.
--audit-log-batch-throttle-qps визначає максимальну середню кількість пакетів, що генеруються за секунду.
--audit-log-batch-throttle-burst визначає максимальну кількість пакетів, згенерованих у той самий момент, якщо дозволений QPS раніше використовувався не повністю.
Налаштування параметрів
Параметри слід задавати з урахуванням навантаження на API-сервер.
Наприклад, якщо kube-apiserver отримує 100 запитів щосекунди і кожен запит проходить аудит лише на етапах ResponseStarted і ResponseComplete, слід розраховувати на ≅200 подій аудиту щосекунди. Якщо в пакеті до 100 подій, рівень тротлінгу слід встановити щонайменше 2 запити на секунду. Якщо бекенду може знадобитися до 5 секунд для запису подій, розмір буфера слід встановити так, щоб він вміщував події за 5 секунд, тобто 10 пакетів або 1000 подій.
Однак у більшості випадків стандартних параметрів має бути достатньо, і вам не потрібно задавати їх вручну. Щоб відстежувати стан підсистеми аудиту, можна переглядати такі метрики Prometheus, які надає kube-apiserver, а також логи.
Метрика apiserver_audit_event_total містить загальну кількість експортованих подій аудиту.
Метрика apiserver_audit_error_total містить загальну кількість подій, відкинутих через помилку під час експорту.
Обрізання записів логу
Обидва бекенди, логів і webhook, підтримують обмеження розміру подій, що записуються. Наприклад, ось перелік прапорців, доступних для бекенду логів:
audit-log-truncate-enabled — чи ввімкнено обрізання подій і пакетів.
audit-log-truncate-max-batch-size — максимальний розмір у байтах пакета, що надсилається до базового бекенду.
audit-log-truncate-max-event-size — максимальний розмір у байтах події аудиту, що надсилається до базового бекенду.
Стандартно обрізання вимкнено і для webhook, і для log; щоб увімкнути цю можливість, адміністратор кластера має встановити audit-log-truncate-enabled або audit-webhook-truncate-enabled.
Дізнайтеся більше про типи ресурсів Event і Policy з довідника конфігурації аудиту.
7.10 - Усунення несправностей керування топологією
Kubernetes приховує від користувача багато аспектів того, як Podʼи виконуються на вузлах. Це зроблено навмисно. Однак деяким робочим навантаженням для прийнятної роботи потрібні сильніші гарантії щодо затримки та/або продуктивності. kubelet надає методи для складніших політик розміщення робочих навантажень і водночас зберігає абстракцію вільною від явних директив розміщення.
Ви можете керувати топологією всередині вузлів. Це означає, що ви допомагаєте kubelet налаштувати операційну систему хоста так, щоб Podʼи й контейнери розміщувалися з правильного боку внутрішніх меж, таких як домени NUMA. (NUMA — абревіатура від non-uniform memory access (нерівномірний доступ до памʼяті); вона відображає ідею, що CPU можуть бути топологічно ближчими до певних ділянок памʼяті через фізичне розташування апаратних компонентів і спосіб їх зʼєднання.)
Джерела інформації для усунення несправностей
Щоб зʼясувати, чому Pod не вдалося розгорнути або чому його відхилено на вузлі в контексті керування топологією, можна скористатися такими засобами:
Статус Podʼа — показує помилки спорідненості топології
Системні логи — містять цінну інформацію для налагодження, наприклад, про згенеровані підказки
Файл стану kubelet — дамп внутрішнього стану менеджера памʼяті (включно з мапою вузлів і мапами памʼяті)
Ви можете використовувати API ресурсів втулка пристрою для отримання інформації про памʼять, зарезервовану для контейнерів
Усунення несправностей TopologyAffinityError
Ця помилка зазвичай виникає в таких ситуаціях:
вузол не має достатньо доступних ресурсів, щоб задовольнити запит Podʼа
запит Podʼа відхилено через обмеження певної політики менеджера топології
Помилка зʼявляється в статусі Podʼа:
kubectl get pods
NAME READY STATUS RESTARTS AGE
guaranteed 0/1 TopologyAffinityError 0 113s
Використовуйте kubectl describe pod <id> або kubectl events, щоб отримати детальне повідомлення про помилку:
Warning TopologyAffinityError 10m kubelet, dell8 Resources cannot be allocated with Topology locality
Перегляньте системні логи
Шукайте в системних логах записи щодо конкретного Podʼа.
Набір підказок, згенерованих менеджером CPU, має бути в логах. Також у логах можна знайти набір підказок, які менеджер памʼяті згенерував для Podʼа.
Менеджер топології обʼєднує ці підказки, щоб обчислити одну найкращу підказку. Найкраща підказка також має бути в логах.
Найкраща підказка вказує, де виділити всі ресурси. Менеджер топології перевіряє цю підказку на відповідність своїй поточній політиці й, залежно від результату, або допускає Pod на вузол, або відхиляє його.
Також шукайте в логах записи, повʼязані з менеджером памʼяті, наприклад, щоб знайти інформацію про оновлення cgroups і cpuset.mems.
Приклади
Перевірка стану менеджера памʼяті на вузлі
Спочатку розгорнімо зразковий Pod Guaranteed з такою специфікацією:
З файлу стану можна зробити висновок, що Pod закріплено за обома вузлами NUMA, тобто:
"numaAffinity":[0,1],
Термін «закріплений» означає, що споживання памʼяті Podʼом обмежено (через конфігурацію cgroups) цими вузлами NUMA.
Це автоматично означає, що менеджер памʼяті створив нову групу з цих двох вузлів NUMA, тобто вузлів NUMA з індексами 0 і 1.
Щоб проаналізувати ресурси памʼяті, доступні в групі, потрібно підсумувати відповідні записи з вузлів NUMA, що належать до групи.
Наприклад, загальний обсяг вільної «звичайної» памʼяті в групі можна обчислити, додавши вільну памʼять, доступну на кожному вузлі NUMA групи, тобто в розділі "memory" вузла NUMA 0 ("free":0) і вузла NUMA 1 ("free":103739236352). Отже, загальний обсяг вільної «звичайної» памʼяті в цій групі дорівнює 0 + 103739236352 байтів.
Рядок "systemReserved":3221225472 показує, що адміністратор цього вузла зарезервував 3221225472 байти (тобто 3Gi) для kubelet і системних процесів на вузлі NUMA 0 за допомогою прапорця --reserved-memory.
Перевірка API ресурсів втулка пристрою
kubelet надає gRPC-сервіс PodResourceLister, щоб уможливити виявлення ресурсів і повʼязаних з ними метаданих. Через його точку доступу gRPC List можна отримати інформацію про зарезервовану памʼять для кожного контейнера, яка міститься в повідомленні protobuf ContainerMemory.
Цю інформацію можна отримати лише для Podʼів класу QoS Guaranteed.
7.11 - Керування демонами кластера
Виконуйте поширені завдання керування DaemonSet, наприклад поетапне оновлення.
7.11.1 - Створення базового DaemonSet
На цій сторінці показано, як створити базовий DaemonSet, який запускає Pod на кожному вузлі кластера Kubernetes. Вона охоплює простий сценарій монтування файлу з хоста, логування його вмісту за допомогою init-контейнера і використання контейнера pause.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Кластер Kubernetes щонайменше з двома вузлами (один вузол панелі управління та один робочий вузол), щоб продемонструвати поведінку DaemonSets.
Визначення DaemonSet
У цьому завданні створюється базовий DaemonSet, який гарантує, що копія Podʼа планується на кожен вузол. Pod використовуватиме init-контейнер для читання й логування вмісту /etc/machine-id з хоста, а основним контейнером буде контейнер pause, який підтримує роботу Podʼа.
Цей простий приклад DaemonSet знайомить із ключовими компонентами, такими як init-контейнери й томи hostPath, які можна розширювати для складніших сценаріїв. Докладніше дивіться DaemonSet.
На цій сторінці показано, як виконати поетапне оновлення DaemonSet.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
OnDelete: Зі стратегією оновлення OnDelete після оновлення шаблону DaemonSet нові Podʼи DaemonSet створюватимуться лише тоді, коли ви вручну видалите старі Podʼи DaemonSet. Така сама поведінка була в DaemonSet у Kubernetes версії 1.5 або раніше.
RollingUpdate: Це стандартна стратегія оновлення. Зі стратегією оновлення RollingUpdate після оновлення шаблону DaemonSet старі Podʼи DaemonSet буде завершено, а нові Podʼи DaemonSet буде автоматично створено контрольованим чином. Протягом усього процесу оновлення на кожному вузлі працюватиме щонайбільше один Pod DaemonSet.
Виконання поетапного оновлення
Щоб увімкнути поетапне оновлення DaemonSet, потрібно встановити .spec.updateStrategy.type у RollingUpdate.
apiVersion:apps/v1kind:DaemonSetmetadata:name:fluentd-elasticsearchnamespace:kube-systemlabels:k8s-app:fluentd-loggingspec:selector:matchLabels:name:fluentd-elasticsearchupdateStrategy:type:RollingUpdaterollingUpdate:maxUnavailable:1template:metadata:labels:name:fluentd-elasticsearchspec:tolerations:# ці tolerations дозволяють запускати DaemonSet на вузлах панелі управління# видаліть їх, якщо ваші вузли панелі управління не повинні запускати Podʼи- key:node-role.kubernetes.io/control-planeoperator:Existseffect:NoSchedule- key:node-role.kubernetes.io/masteroperator:Existseffect:NoSchedulecontainers:- name:fluentd-elasticsearchimage:quay.io/fluentd_elasticsearch/fluentd:v5.0.1volumeMounts:- name:varlogmountPath:/var/log- name:varlibdockercontainersmountPath:/var/lib/docker/containersreadOnly:trueterminationGracePeriodSeconds:30volumes:- name:varloghostPath:path:/var/log- name:varlibdockercontainershostPath:path:/var/lib/docker/containers
Перевіривши стратегію оновлення в маніфесті DaemonSet, створіть DaemonSet:
Якщо вивід не RollingUpdate, поверніться й відповідно змініть обʼєкт DaemonSet або маніфест.
Оновлення шаблону DaemonSet
Будь-які оновлення .spec.template у DaemonSet зі стратегією RollingUpdate запускають поетапне оновлення. Оновімо DaemonSet, застосувавши новий файл YAML. Це можна зробити кількома різними командами kubectl.
apiVersion:apps/v1kind:DaemonSetmetadata:name:fluentd-elasticsearchnamespace:kube-systemlabels:k8s-app:fluentd-loggingspec:selector:matchLabels:name:fluentd-elasticsearchupdateStrategy:type:RollingUpdaterollingUpdate:maxUnavailable:1template:metadata:labels:name:fluentd-elasticsearchspec:tolerations:# ці tolerations дозволяють запускати DaemonSet на вузлах панелі управління# видаліть їх, якщо ваші вузли панелі управління не повинні запускати Podʼи- key:node-role.kubernetes.io/control-planeoperator:Existseffect:NoSchedule- key:node-role.kubernetes.io/masteroperator:Existseffect:NoSchedulecontainers:- name:fluentd-elasticsearchimage:quay.io/fluentd_elasticsearch/fluentd:v5.0.1resources:limits:memory:200Mirequests:cpu:100mmemory:200MivolumeMounts:- name:varlogmountPath:/var/log- name:varlibdockercontainersmountPath:/var/lib/docker/containersreadOnly:trueterminationGracePeriodSeconds:30volumes:- name:varloghostPath:path:/var/log- name:varlibdockercontainershostPath:path:/var/lib/docker/containers
Декларативні команди
Якщо ви оновлюєте DaemonSets за допомогою файлів конфігурації, використовуйте kubectl apply:
Якщо вам потрібно оновити лише образ контейнера у шаблоні DaemonSet, тобто
.spec.template.spec.containers[*].image, використовуйте kubectl set image:
kubectl set image ds/fluentd-elasticsearch fluentd-elasticsearch=quay.io/fluentd_elasticsearch/fluentd:v2.6.0 -n kube-system
Спостереження за станом поетапного оновлення
Нарешті, спостерігайте за станом розгортання останнього поетапного оновлення DaemonSet:
kubectl rollout status ds/fluentd-elasticsearch -n kube-system
Коли розгортання завершиться, вивід буде подібний до такого:
daemonset "fluentd-elasticsearch" successfully rolled out
Усунення несправностей
Поетапне оновлення DaemonSet застрягло
Іноді поетапне оновлення DaemonSet може застрягнути. Ось деякі можливі причини:
На деяких вузлах вичерпуються ресурси
Розгортання застрягло, оскільки нові Podʼи DaemonSet не можна запланувати щонайменше на один вузол. Таке можливо, коли на вузлі вичерпуються ресурси.
Коли це трапляється, знайдіть вузли, на яких не заплановано Podʼи DaemonSet, порівнявши вивід kubectl get nodes з виводом:
kubectl get pods -l name=fluentd-elasticsearch -o wide -n kube-system
Знайшовши ці вузли, видаліть із них деякі Podʼи, що не належать до DaemonSet, щоб звільнити місце для нових Podʼів DaemonSet.
Примітка:
Це спричинить порушення роботи сервісу, якщо видалені Podʼи не контролюються жодним контролером або не мають реплік. Це також не враховує PodDisruptionBudget.
Невдале розгортання
Якщо останнє оновлення шаблону DaemonSet невдале, наприклад контейнер постійно аварійно завершується (crash looping) або образу контейнера не існує (часто через одруківку), розгортання DaemonSet не просуватиметься.
Щоб виправити це, ще раз оновіть шаблон DaemonSet. Нове розгортання не блокуватиметься попередніми несправними розгортаннями.
Невідповідність годинників
Якщо в DaemonSet задано .spec.minReadySeconds, невідповідність годинників між панеллю управління та вузлами не дасть DaemonSet правильно визначати перебіг розгортання.
На цій сторінці показано, як виконати відкочування DaemonSet.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Причина зміни копіюється з анотації DaemonSet kubernetes.io/change-cause до його ревізій під час їх створення. Ви можете вказати --record=true у kubectl, щоб записати виконану команду в анотацію причини зміни.
Щоб переглянути подробиці конкретної ревізії:
kubectl rollout history daemonset <daemonset-name> --revision=1
# Вкажіть номер ревізії, отриманий на кроці 1, у --to-revisionkubectl rollout undo daemonset <daemonset-name> --to-revision=<revision>
Якщо команда виконається успішно, вона поверне:
daemonset "<daemonset-name>" rolled back
Примітка:
Якщо прапорець --to-revision не вказано, kubectl обирає найновішу ревізію.
Крок 3: Спостерігайте за перебігом відкочування DaemonSet
kubectl rollout undo daemonset наказує серверу почати відкочування DaemonSet. Фактичне відкочування виконується асинхронно всередині панелі управління кластера.
Щоб спостерігати за перебігом відкочування:
kubectl rollout status ds/<daemonset-name>
Коли відкочування завершиться, вивід буде подібний до такого:
daemonset "<daemonset-name>" successfully rolled out
Розуміння ревізій DaemonSet
На попередньому кроці kubectl rollout history ви отримали список ревізій DaemonSet. Кожна ревізія зберігається в ресурсі під назвою ControllerRevision.
Щоб побачити, що зберігається в кожній ревізії, знайдіть необроблені ресурси ревізій DaemonSet:
kubectl get controllerrevision -l <daemonset-selector-key>=<daemonset-selector-value>
Це поверне список ControllerRevisions:
NAME CONTROLLER REVISION AGE
<daemonset-name>-<revision-hash> DaemonSet/<daemonset-name> 1 1h
<daemonset-name>-<revision-hash> DaemonSet/<daemonset-name> 2 1h
Кожен ControllerRevision зберігає анотації та шаблон ревізії DaemonSet.
kubectl rollout undo бере конкретний ControllerRevision і замінює шаблон DaemonSet шаблоном, збереженим у ControllerRevision. kubectl rollout undo рівнозначний оновленню шаблону DaemonSet до попередньої ревізії іншими командами, такими як kubectl edit або kubectl apply.
Примітка:
Ревізії DaemonSet рухаються лише вперед. Тобто після завершення відкочування номер ревізії (поле .revision) ControllerRevision, до якого відбулося відкочування, збільшується. Наприклад, якщо в системі є ревізії 1 і 2 і ви відкочуєтеся з ревізії 2 до ревізії 1, ControllerRevision із .revision: 1 стане .revision: 3.
На цій сторінці показано, як запускати Podʼи лише на деяких вузлах у складі DaemonSet
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
Уявімо, що ви хочете запустити DaemonSet, але ці Podʼи демонів потрібно запускати лише на вузлах із локальним твердотільним сховищем (SSD). Наприклад, Pod може надавати вузлу сервіс кешування, а кеш корисний лише тоді, коли доступне локальне сховище з низькою затримкою.
Створіть DaemonSet з маніфесту, використовуючи kubectl create або kubectl apply.
Додамо мітку ssd=true ще одному вузлу.
kubectl label nodes example-node-3 ssd=true
Додавання мітки вузлу автоматично спонукає панель управління (а саме контролер DaemonSet) запустити новий Pod демона на цьому вузлі.
kubectl get pods -o wide
Вивід подібний до такого:
NAME READY STATUS RESTARTS AGE IP NODE
<daemonset-name><some-hash-01> 1/1 Running 0 13s ..... example-node-1
<daemonset-name><some-hash-02> 1/1 Running 0 13s ..... example-node-2
<daemonset-name><some-hash-03> 1/1 Running 0 5s ..... example-node-3
7.12 - Мережа
Дізнайтеся, як налаштувати мережу для вашого кластера.
7.12.1 - Додавання записів до файлу /etc/hosts у Podʼі за допомогою HostAliases
Додавання записів до файлу /etc/hosts у Podʼі дає змогу перевизначити розвʼязання імен хостів на рівні Podʼа, коли DNS та інші варіанти не підходять. Ви можете додавати ці власні записи за допомогою поля HostAliases у PodSpec.
Проєкт Kubernetes рекомендує змінювати конфігурацію DNS за допомогою поля hostAliases (частина .spec Podʼа), а не за допомогою init-контейнера чи інших засобів безпосереднього редагування /etc/hosts. Зміни, внесені іншим способом, kubelet може перезаписати під час створення або перезапуску Podʼа.
Стандартний вміст файлу hosts
Запустіть Pod із Nginx, якому призначено IP-адресу Podʼа:
kubectl run nginx --image nginx
pod/nginx created
Перевірте IP-адресу Podʼа:
kubectl get pods --output=wide
NAME READY STATUS RESTARTS AGE IP NODE
nginx 1/1 Running 0 13s 10.200.0.4 worker0
Стандартно файл hosts містить лише шаблонні записи IPv4 та IPv6, такі як localhost і власне імʼя хоста.
Додавання додаткових записів за допомогою hostAliases
Крім стандартних шаблонних записів, ви можете додати до файлу hosts інші записи. Наприклад, щоб розвʼязувати foo.local, bar.local у 127.0.0.1, а foo.remote, bar.remote у 10.1.2.3, налаштуйте HostAliases для Podʼа в полі .spec.hostAliases:
kubelet керує файлом hosts для кожного контейнера Podʼа, щоб середовище виконання контейнерів не змінювало цей файл після запуску контейнерів. Історично Kubernetes завжди використовував Docker Engine як середовище виконання контейнерів, а Docker Engine змінював файл /etc/hosts після запуску кожного контейнера.
Поточний Kubernetes може використовувати різні середовища виконання контейнерів; попри це, kubelet керує файлом hosts у кожному контейнері, щоб результат був очікуваним незалежно від середовища виконання контейнерів, яке ви використовуєте.
Увага:
Уникайте ручних змін файлу hosts усередині контейнера.
Якщо ви вносите ручні зміни до файлу hosts, ці зміни втрачаються, коли контейнер завершує роботу.
This is a stable feature in Kubernetes, and has been since version v1.33. It was first available in the v1.27 release. You can no longer disable or opt out of this feature or behavior (it is locked); if you explicitly set a value for the associated feature gate MultiCIDRServiceAllocator, Kubernetes ignores it but does not report any error.
У цьому документі описано, як переналаштувати стандартні діапазони IP-адрес Service, призначені кластеру.
Перш ніж ви розпочнете
Вам треба мати кластер Kubernetes, а також інструмент командного рядка kubectl має бути налаштований для роботи з вашим кластером. Рекомендується виконувати ці настанови у кластері, що має щонайменше два вузли, які не виконують роль вузлів управління. Якщо у вас немає кластера, ви можете створити його, за допомогою minikube або використовувати одну з цих пісочниць:
У цьому документі пояснено, як керувати діапазоном IP-адрес Service у кластері Kubernetes, що також впливає на сімейства IP, які кластер підтримує для Services.
Сімейства IP, доступні для ClusterIP у Service, визначаються прапорцем --service-cluster-ip-range у kube-apiserver. Щоб краще зрозуміти виділення IP-адрес Service, дивіться документацію Відстеження виділення IP-адрес Services.
Починаючи з Kubernetes 1.33, сімейства IP Service, налаштовані для кластера, відображаються в обʼєкті ServiceCIDR з назвою kubernetes. Обʼєкт ServiceCIDR kubernetes створює перший запущений екземпляр kube-apiserver на основі свого налаштованого прапорця --service-cluster-ip-range. Щоб забезпечити узгоджену поведінку кластера, усі екземпляри kube-apiserver мають бути налаштовані з однаковими значеннями --service-cluster-ip-range, які мають відповідати стандартному обʼєкту ServiceCIDR kubernetes.
Категорії переналаштування ServiceCIDR Kubernetes
Переналаштування ServiceCIDR зазвичай належить до однієї з таких категорій:
Розширення наявних ServiceCIDR: Це можна зробити динамічно, додавши нові обʼєкти ServiceCIDR без переналаштування kube-apiserver. Дивіться окрему документацію про Розширення діапазонів IP-адрес Service.
Перетворення з одного стека на подвійний стек зі збереженням первинного ServiceCIDR: Це передбачає додавання вторинного сімейства IP (IPv6 до кластера лише з IPv4 або IPv4 до кластера лише з IPv6) зі збереженням початкового сімейства IP як первинного. Для цього потрібно оновити конфігурацію kube-apiserver і відповідно змінити різні компоненти кластера, які мають працювати з цим додатковим сімейством IP. Серед цих компонентів, зокрема, kube-proxy, CNI або мережевий втулок, реалізації service mesh і сервіси DNS.
Перетворення з подвійного стека на один зі збереженням первинного ServiceCIDR: Це передбачає вилучення вторинного сімейства IP з кластера з подвійним стеком і повернення до одного сімейства IP зі збереженням початкового первинного сімейства IP. Окрім переналаштування компонентів відповідно до нового сімейства IP, може знадобитися розібратися з Services, які явно налаштовані на використання вилученого сімейства IP.
Усе, що призводить до зміни первинного ServiceCIDR: Повна заміна стандартного ServiceCIDR — складна операція. Якщо новий ServiceCIDR не перетинається з наявним, потрібно буде перенумерувати всі наявні Services і змінити Service kubernetes.default. Випадок, коли змінюється ще й первинне сімейство IP, ще складніший і може потребувати зміни кількох компонентів кластера (kubelet, мережевих втулків тощо) відповідно до нового первинного сімейства IP.
Ручні операції для заміни стандартного ServiceCIDR
Переналаштування стандартного ServiceCIDR потребує ручних дій з боку оператора кластера, адміністратора або програмного забезпечення, що керує життєвим циклом кластера. Зазвичай це такі дії:
Оновлення конфігурації kube-apiserver: змініть прапорець --service-cluster-ip-range, указавши нові діапазони IP.
Переналаштування мережевих компонентів: це критичний крок, і конкретна процедура залежить від мережевих компонентів, що використовуються. Він може охоплювати оновлення файлів конфігурації, перезапуск Podʼів агентів або оновлення компонентів для керування новими ServiceCIDR і бажаною конфігурацією сімейства IP для Podʼів. Такими компонентами можуть бути реалізація Services Kubernetes, наприклад kube-proxy, налаштований мережевий втулок і, можливо, інші мережеві компоненти, такі як контролери service mesh і сервери DNS, щоб вони могли правильно обробляти трафік і виконувати виявлення сервісів із новою конфігурацією сімейства IP.
Керування наявними Services: Services з IP-адресами зі старого CIDR потрібно обробити, якщо вони не входять до нових налаштованих діапазонів. Варіанти: повторне створення (що призводить до простою і призначення нових IP-адрес) або потенційно складніші стратегії переналаштування.
Повторне створення внутрішніх сервісів Kubernetes: Service kubernetes.default потрібно видалити й створити заново, щоб отримати IP-адресу з нового ServiceCIDR, якщо первинне сімейство IP змінено або замінено іншою мережею.
Приклад кроків переналаштування
Наведені нижче кроки описують контрольоване переналаштування з повною заміною стандартного ServiceCIDR і повторним створенням Service kubernetes.default:
Запустіть kube-apiserver з початковим --service-cluster-ip-range.
Створіть початкові Services, які отримують IP-адреси з цього діапазону.
Створіть новий ServiceCIDR як тимчасову ціль переналаштування.
Позначте стандартний ServiceCIDR kubernetes для видалення (він лишатиметься в очікуванні через наявні IP-адреси й завершувачі). Це запобігає новим виділенням зі старого діапазону.
Повторно створіть наявні Services. Тепер вони мають отримати IP-адреси з нового тимчасового ServiceCIDR.
Перезапустіть kube-apiserver із налаштованими новими ServiceCIDR і вимкніть старий екземпляр.
Видаліть Service kubernetes.default. Новий kube-apiserver створить його заново в новому ServiceCIDR.
Розширюйте kubectl, створюючи та встановлюючи втулки kubectl.
Цей посібник показує, як встановлювати й створювати розширення для kubectl. Розглядаючи основні команди kubectl як базові будівельні блоки для взаємодії з кластером Kubernetes, адміністратор кластера може вважати втулки засобом використання цих блоків для створення складнішої поведінки. Втулки розширюють kubectl новими підкомандами, додаючи нові й власні можливості, яких немає в основному дистрибутиві kubectl.
Перш ніж ви розпочнете
Вам потрібен встановлений робочий бінарний файл kubectl.
Встановлення втулків для kubectl
Втулок — це окремий виконуваний файл, назва якого починається з kubectl-. Щоб установити втулок, перемістіть його виконуваний файл у будь-яке місце у вашому PATH.
Ви також можете шукати й встановлювати втулки kubectl із відкритим кодом за допомогою Krew. Krew — це менеджер втулків, який підтримує спільнота Kubernetes SIG CLI.
Увага:
Втулки kubectl, доступні через індекс втулків Krew, не проходять перевірки безпеки. Сторонні втулки ви встановлюєте й запускаєте на власний ризик, оскільки це довільні програми, що виконуються на вашому компʼютері.
Пошук втулків
kubectl надає команду kubectl plugin list, яка шукає у вашому PATH дійсні виконувані файли втулків. Виконання цієї команди спричиняє обхід усіх файлів у вашому PATH. Усі файли, які є виконуваними й починаються з kubectl-, зʼявляться у виводі цієї команди у тому порядку, в якому вони розташовані у вашому PATH. Для всіх файлів, що починаються з kubectl- і не є виконуваними, буде показано попередження. Також буде показано попередження для всіх дійсних файлів втулків, назви яких перекривають одна одну.
Ви можете використовувати Krew, щоб шукати й встановлювати втулки kubectl з індексу втулків, який підтримує спільнота.
Створення втулків
kubectl дозволяє втулкам додавати власні команди створення вигляду kubectl create something: для цього в PATH має бути виконуваний файл kubectl-create-something.
Обмеження
Наразі неможливо створити втулки, які перезаписують наявні команди kubectl або розширюють інші команди, крім create. Наприклад, якщо створити втулок kubectl-version, він ніколи не виконуватиметься, оскільки наявна команда kubectl version завжди матиме пріоритет. Через це обмеження також не можна використовувати втулки для додавання нових підкоманд до наявних команд kubectl. Наприклад, якщо додати підкоманду kubectl attach vm, назвавши втулок kubectl-attach-vm, цей втулок буде проігноровано.
kubectl plugin list показує попередження для всіх дійсних втулків, які намагаються це зробити.
Написання втулків для kubectl
Ви можете написати втулок будь-якою мовою програмування або скриптом, що дозволяє створювати команди командного рядка.
Втулки не потребують встановлення чи попереднього завантаження. Виконувані файли втулків успадковують середовище від бінарного файлу kubectl. Втулок визначає шлях команди, який він реалізує, за своєю назвою. Наприклад, втулок із назвою kubectl-foo надає команду kubectl foo. Виконуваний файл втулка потрібно встановити десь у вашому PATH.
Приклад втулка
#!/bin/bash
# необовʼязкова обробка аргументівif[["$1"=="version"]]thenecho"1.0.0"exit0fi# необовʼязкова обробка аргументівif[["$1"=="config"]]thenecho"$KUBECONFIG"exit0fiecho"I am a plugin named kubectl-foo"
Використання втулка
Щоб використовувати втулок, зробіть його виконуваним:
sudo chmod +x ./kubectl-foo
і помістіть його в будь-яке місце у вашому PATH:
sudo mv ./kubectl-foo /usr/local/bin
Тепер ви можете викликати втулок як команду kubectl:
kubectl foo
I am a plugin named kubectl-foo
Усі аргументи та прапорці передаються виконуваному файлу без змін:
kubectl foo version
1.0.0
Усі змінні середовища також передаються виконуваному файлу без змін:
Крім того, першим аргументом, який передається втулку, завжди буде повний шлях до місця, де його викликано ($0 дорівнюватиме /usr/local/bin/kubectl-foo у наведеному вище прикладі).
Іменування втулків
Як видно з наведеного вище прикладу, втулок визначає шлях команди, яку він реалізує, за назвою свого файлу. Усі підкоманди в шляху команди, на яку націлений втулок, розділені дефісом (-). Наприклад, втулок, який має викликатися щоразу, коли користувач виконує команду kubectl foo bar baz, матиме назву файлу kubectl-foo-bar-baz.
Обробка прапорців та аргументів
Примітка:
Механізм втулків не створює жодних власних, специфічних для втулка значень або змінних середовища для процесу втулка.
Старіший механізм втулків kubectl надавав змінні середовища, такі як KUBECTL_PLUGINS_CURRENT_NAMESPACE; тепер такого немає.
Втулки kubectl мають самостійно розбирати та перевіряти всі передані їм аргументи. Докладніше про бібліотеку Go для авторів втулків дивіться в розділі використання пакунка command line runtime.
Нижче наведено кілька додаткових випадків, коли користувачі викликають ваш втулок із додатковими прапорцями та аргументами. Вони ґрунтуються на втулку kubectl-foo-bar-baz із наведеного вище сценарію.
Якщо ви виконаєте kubectl foo bar baz arg1 --flag=value arg2, механізм втулків kubectl спочатку спробує знайти втулок із найдовшою можливою назвою, у цьому випадку kubectl-foo-bar-baz-arg1. Не знайшовши такого втулка, kubectl вважатиме останнє значення, відокремлене дефісом, аргументом (тут arg1) і спробує знайти наступну найдовшу можливу назву, kubectl-foo-bar-baz. Знайшовши втулок із такою назвою, kubectl викличе його, передаючи всі аргументи й прапорці після назви втулка як аргументи процесу втулка.
Приклад:
# створимо втулокecho -e '#!/bin/bash\n\necho "My first command-line argument was $1"' > kubectl-foo-bar-baz
sudo chmod +x ./kubectl-foo-bar-baz
# встановимо ваш втулок, перемістивши його у теку з $PATHsudo mv ./kubectl-foo-bar-baz /usr/local/bin
# перевіримо, що kubectl розпізнав ваш втулокkubectl plugin list
The following kubectl-compatible plugins are available:
/usr/local/bin/kubectl-foo-bar-baz
# перевірте, що виклик вашого втулка через команду "kubectl" працює
# навіть тоді, коли користувач передає додаткові аргументи та прапорці
# до виконуваного файлу вашого втулка.
kubectl foo bar baz arg1 --meaningless-flag=true
My first command-line argument was arg1
Як бачите, ваш втулок було знайдено за командою kubectl, вказаною користувачем, а всі додаткові аргументи та прапорці після цього передано виконуваному файлу втулка без змін.
Назви з дефісами та підкреслюваннями
Хоча механізм втулків kubectl використовує дефіс (-) у назвах файлів втулків для розділення послідовності підкоманд, які обробляє втулок, усе ж можна створити команду втулка з дефісами у виклику з командного рядка, використовуючи підкреслення (_) у назві файлу.
Приклад:
# створимо втулок, що містить підкреслення в назві файлуecho -e '#!/bin/bash\n\necho "I am a plugin with a dash in my name"' > ./kubectl-foo_bar
sudo chmod +x ./kubectl-foo_bar
# перемістимо втулок у теку з $PATHsudo mv ./kubectl-foo_bar /usr/local/bin
# тепер ви можете викликати свій втулок через kubectl:kubectl foo-bar
I am a plugin with a dash in my name
Зверніть увагу, що підкреслення в назві файлу втулка не заважає використовувати команди на кшталт kubectl foo_bar. Команду з наведеного вище прикладу можна викликати і з дефісом (-), і з підкресленням (_):
# Ви можете викликати вашу власну команду з дефісомkubectl foo-bar
I am a plugin with a dash in my name
# Ви також можете викликати свою власну команду з підкресленнямиkubectl foo_bar
I am a plugin with a dash in my name
Конфлікти назв і перекриття
У вашому PATH може бути кілька втулків з однаковою назвою файлу в різних розташуваннях. Наприклад, якщо PATH має значення PATH=/usr/local/bin/plugins:/usr/local/bin/moreplugins, копія втулка kubectl-foo може існувати в /usr/local/bin/plugins і /usr/local/bin/moreplugins, і тоді вивід команди kubectl plugin list буде таким:
PATH=/usr/local/bin/plugins:/usr/local/bin/moreplugins kubectl plugin list
The following kubectl-compatible plugins are available:
/usr/local/bin/plugins/kubectl-foo
/usr/local/bin/moreplugins/kubectl-foo
- warning: /usr/local/bin/moreplugins/kubectl-foo is overshadowed by a similarly named plugin: /usr/local/bin/plugins/kubectl-foo
error: one plugin warning was found
У цьому сценарії попередження під /usr/local/bin/moreplugins/kubectl-foo повідомляє, що цей втулок ніколи не буде виконано. Натомість механізм втулків kubectl завжди спершу знайде й виконає файл, який першим трапляється у вашому PATH, тобто /usr/local/bin/plugins/kubectl-foo.
Щоб розвʼязати цю проблему, переконайтеся, що розташування втулка, який ви хочете використовувати з kubectl, завжди стоїть першим у вашому PATH. Наприклад, якщо ви хочете завжди використовувати /usr/local/bin/moreplugins/kubectl-foo під час виклику команди kubectl foo, змініть значення PATH на /usr/local/bin/moreplugins:/usr/local/bin/plugins.
Виклик за найдовшою назвою виконуваного файлу
Існує ще один вид перекриття, який може виникнути з назвами файлів втулків. Якщо в PATH користувача є два втулки, kubectl-foo-bar і kubectl-foo-bar-baz, механізм втулків kubectl завжди вибиратиме найдовшу можливу назву втулка для заданої команди користувача. Наведені нижче приклади це пояснюють:
# для заданої команди kubectl завжди вибиратиметься втулок із найдовшою можливою назвою файлуkubectl foo bar baz
Plugin kubectl-foo-bar-baz is executed
kubectl foo bar
Plugin kubectl-foo-bar is executed
kubectl foo bar baz buz
Plugin kubectl-foo-bar-baz is executed, with "buz" as its first argument
kubectl foo bar buz
Plugin kubectl-foo-bar is executed, with "buz" as its first argument
Таке проєктне рішення гарантує, що підкоманди втулка можна за потреби реалізувати в кількох файлах і вкладати їх під «батьківську» команду втулка:
Ви можете скористатися згаданою вище командою kubectl plugin list, щоб переконатися, що kubectl бачить ваш втулок, і перевірити, що немає попереджень, які заважають викликати його як команду kubectl.
kubectl plugin list
The following kubectl-compatible plugins are available:
test/fixtures/pkg/kubectl/plugins/kubectl-foo
/usr/local/bin/kubectl-foo
- warning: /usr/local/bin/kubectl-foo is overshadowed by a similarly named plugin: test/fixtures/pkg/kubectl/plugins/kubectl-foo
plugins/kubectl-invalid
- warning: plugins/kubectl-invalid identified as a kubectl plugin, but it is not executable
error: 2 plugin warnings were found
Використання пакунка command line runtime
Якщо ви пишете втулок для kubectl мовою Go, ви можете скористатися допоміжними бібліотеками cli-runtime.
Ці бібліотеки надають допоміжні засоби для розбору чи оновлення файлу kubeconfig користувача, для виконання запитів у стилі REST до API-сервера або для привʼязування прапорців, повʼязаних із конфігурацією та виводом.
Приклад використання інструментів із репозиторію CLI Runtime дивіться в Sample CLI Plugin.
Розповсюдження втулків для kubectl
Якщо ви розробили втулок для інших користувачів, варто подумати, як ви його пакуватимете, розповсюджуватимете й доставлятимете оновлення своїм користувачам.
Krew
Krew пропонує кросплатформний спосіб пакування й розповсюдження ваших втулків. Так ви використовуєте єдиний формат пакування для всіх цільових платформ (Linux, Windows, macOS тощо) і доставляєте оновлення своїм користувачам. Krew також підтримує індекс втулків, щоб інші люди могли знайти ваш втулок і встановити його.
Нативне / платформозалежне керування пакунками
Також ви можете використовувати традиційні менеджери пакунків, такі як apt або dnf у Linux, Chocolatey у Windows і Homebrew у macOS. Підійде будь-який менеджер пакунків, який може розмістити нові виконувані файли десь у PATH користувача. Якщо ви як автор втулка обираєте цей варіант, вам також доведеться оновлювати пакунок розповсюдження вашого втулка kubectl на кількох платформах для кожного випуску.
Вихідний код
Ви можете опублікувати вихідний код, наприклад як репозиторій Git. Якщо ви обираєте цей варіант, той, хто хоче використовувати цей втулок, має отримати код, налаштувати середовище збірки (якщо потрібна компіляція) і розгорнути втулок. Якщо ви також надаєте скомпільовані пакунки або використовуєте Krew, встановлення стане простішим.
Що далі
Перегляньте репозиторій Sample CLI Plugin, де є докладний приклад втулка, написаного мовою Go. Якщо виникнуть запитання, звертайтеся до команди SIG CLI.
Прочитайте про Krew, менеджер пакунків для втулків kubectl.
7.14 - Керування HugePages
Налаштування та керування великими сторінками як ресурсом, придатним для планування, у кластері.
This is a stable feature in Kubernetes, and has been since the 1.14 release. You can no longer toggle this feature (the associated feature gate has been removed).
Kubernetes підтримує виділення та використання застосунками в Podʼі заздалегідь виділених великих сторінок (huge pages). На цій сторінці описано, як користувачі можуть використовувати великі сторінки.
Вузол може заздалегідь виділяти великі сторінки кількох розмірів; наприклад, такий рядок у /etc/default/grub виділяє 2*1GiB сторінок розміром 1 GiB і 512*2 MiB сторінок розміром 2 MiB:
Для динамічно виділених сторінок (після завантаження системи) kubelet потрібно перезапустити, щоб нові виділення відобразилися.
API
Великі сторінки можна використовувати через вимоги до ресурсів на рівні контейнера з назвою ресурсу hugepages-<size>, де <size> — найкомпактніше двійкове позначення з цілочисельними значеннями, підтримуваними на конкретному вузлі. Наприклад, якщо вузол підтримує розміри сторінок 2048KiB і 1048576KiB, він надаватиме ресурси, придатні для планування, hugepages-2Mi та hugepages-1Gi. На відміну від CPU або памʼяті, великі сторінки не підтримують надмірне виділення (overcommit). Зверніть увагу, що під час запиту ресурсів великих сторінок також потрібно запитувати ресурси памʼяті або CPU.
Pod може використовувати кілька розмірів великих сторінок в одній специфікації Podʼа. У цьому випадку для всіх монтувань томів потрібно використовувати нотацію medium: HugePages-<hugepagesize>.
Запити великих сторінок мають дорівнювати обмеженням. Так відбувається стандартно, якщо обмеження вказано, а запити — ні.
Великі сторінки ізольовані на рівні контейнера, тому кожен контейнер має власне обмеження у своїй пісочниці cgroup, як запитано в специфікації контейнера.
Томи EmptyDir на основі великих сторінок не можуть споживати більше памʼяті великих сторінок, ніж запитує Pod.
Застосунки, що використовують великі сторінки через shmget() із SHM_HUGETLB, мають працювати з допоміжною групою, яка відповідає proc/sys/vm/hugetlb_shm_group.
Використанням великих сторінок у просторі імен можна керувати через ResourceQuota, подібно до інших обчислювальних ресурсів, таких як cpu або memory, за допомогою токена hugepages-<size>.
7.15 - Планування GPU
Налаштування та планування GPU для використання як ресурсу вузлів у кластері.
СТАН ФУНКЦІОНАЛУ:GA since Kubernetes v1.26
Kubernetes містить стабільну підтримку керування GPU (графічними процесорами) AMD і NVIDIA на різних вузлах вашого кластера за допомогою втулків пристроїв.
На цій сторінці описано, як користувачі можуть використовувати GPU, і наведено деякі обмеження реалізації.
Використання втулків пристроїв
Kubernetes реалізує втулки пристроїв, щоб надати Podʼам доступ до спеціалізованих апаратних можливостей, таких як GPU.
Примітка: Цей розділ містить посилання на проєкти сторонніх розробників, які надають функціонал, необхідний для Kubernetes. Автори проєкту Kubernetes не несуть відповідальності за ці проєкти. Проєкти вказано в алфавітному порядку. Щоб додати проєкт до цього списку, ознайомтеся з посібником з контенту перед надсиланням змін. Докладніше.
Як адміністратору вам потрібно встановити на вузлах драйвери GPU від відповідного постачальника обладнання й запустити відповідний втулок пристроїв від постачальника GPU. Ось кілька посилань на інструкції постачальників:
Після встановлення втулка ваш кластер надає власний ресурс, придатний для планування, наприклад amd.com/gpu або nvidia.com/gpu.
Ви можете використовувати ці GPU у своїх контейнерах, запитуючи власний ресурс GPU так само, як ви запитуєте cpu чи memory. Однак є деякі обмеження щодо того, як вказувати вимоги до ресурсів для власних пристроїв.
GPU слід вказувати лише в розділі limits, що означає:
Ви можете вказати limits для GPU без requests, оскільки Kubernetes стандартно використовує обмеження як значення запиту.
Ви можете вказати GPU і в limits, і в requests, але ці два значення мають бути однаковими.
Ви не можете вказати requests для GPU без limits.
Ось приклад маніфесту для Podʼа, який запитує GPU:
apiVersion:v1kind:Podmetadata:name:example-vector-addspec:restartPolicy:OnFailurecontainers:- name:example-vector-addimage:"registry.example/example-vector-add:v42"resources:limits:gpu-vendor.example/example-gpu:1# запит на 1 GPU
Керування кластерами з різними типами GPU
Якщо різні вузли вашого кластера мають різні типи GPU, ви можете використовувати мітки вузлів і селектори вузлів для планування Podʼів на відповідні вузли.
Наприклад:
# Додайте вузлам мітки з типом прискорювача, який вони мають.kubectl label nodes node1 accelerator=example-gpu-x100
kubectl label nodes node2 accelerator=other-gpu-k915
Ключ мітки accelerator — лише приклад; за бажання ви можете використовувати інший ключ мітки.
Автоматичне додавання міток вузлам
Як адміністратор ви можете автоматично виявляти всі вузли з підтримкою GPU й додавати їм мітки, розгорнувши Kubernetes Node Feature Discovery (NFD). NFD виявляє апаратні можливості, доступні на кожному вузлі кластера Kubernetes. Зазвичай NFD налаштовують оголошувати ці можливості як мітки вузлів, але NFD також може додавати розширені ресурси, анотації та taints вузлів. NFD сумісний з усіма підтримуваними версіями Kubernetes. Стандартно NFD створює мітки можливостей для виявлених можливостей. Адміністратори також можуть використовувати NFD, щоб додавати taints вузлам із певними можливостями, і тоді на цих вузлах можна буде планувати лише Podʼи, що запитують ці можливості.
Вам також потрібен втулок для NFD, який додає відповідні мітки вашим вузлам; це можуть бути загальні мітки або мітки конкретного постачальника. Ваш постачальник GPU може надавати сторонній втулок для NFD; докладніше дивіться в його документації.
apiVersion:v1kind:Podmetadata:name:example-vector-addspec:restartPolicy:OnFailure# Ви можете використовувати спорідненість вузлів Kubernetes, щоб запланувати цей Pod на вузол,# який надає тип GPU, потрібний його контейнеру для роботиaffinity:nodeAffinity:requiredDuringSchedulingIgnoredDuringExecution:nodeSelectorTerms:- matchExpressions:- key:"gpu.gpu-vendor.example/installed-memory"operator:Gt# (більше ніж)values:["40535"]- key:"feature.node.kubernetes.io/pci-10.present"# мітка можливості NFDvalues:["true"]# (необовʼязково) планувати лише на вузли з пристроєм PCI 10containers:- name:example-vector-addimage:"registry.example/example-vector-add:v42"resources:limits:gpu-vendor.example/example-gpu:1# запит на 1 GPU
У цьому розділі документації Kubernetes зібрані навчальні матеріали. Кожний матеріал показує, як досягти окремої мети, що більша за одне завдання. Зазвичай навчальний матеріал має декілька розділів, кожен з яких містить певну послідовність дій. До ознайомлення з навчальними матеріалами вам, можливо, знадобиться додати у закладки сторінку з Глосарієм для подальшого консультування.
Основи
Основи Kubernetes - детальний навчальний матеріал з інтерактивними уроками, що допоможе вам зрозуміти Kubernetes і спробувати його базову функціональність.
Якщо ви хочете написати навчальний матеріал, у статті
Використання шаблонів сторінок
ви знайдете інформацію про тип навчальної сторінки і шаблон.
9.1 - Привіт Minikube
З цього навчального матеріалу ви дізнаєтесь, як запустити у Kubernetes простий Hello World застосунок на Node.js за допомогою Minikube і Katacoda. Katacoda надає безплатне Kubernetes середовище, що доступне у вашому браузері.
Примітка:
Також ви можете навчатись за цим матеріалом, якщо встановили Minikube локально.
Цілі
Розгорнути Hello World застосунок у Minikube.
Запустити застосунок.
Переглянути логи застосунку.
Перш ніж ви розпочнете
У цьому навчальному матеріалі ми використовуємо образ контейнера, зібраний із наступних файлів:
Більше інформації про команду docker build ви знайдете у документації Docker.
Створення Minikube кластера
Натисніть кнопку Запуск термінала
Примітка:
Якщо Minikube встановлений локально, виконайте команду minikube start.
Відкрийте Kubernetes дашборд у браузері:
minikube dashboard
Тільки для Katacoda: у верхній частині вікна термінала натисніть знак плюс, а потім -- Select port to view on Host 1.
Тільки для Katacoda: введіть 30000, а потім натисніть Display Port.
Створення Deployment
Pod у Kubernetes -- це група з одного або декількох контейнерів, що об'єднані разом з метою адміністрування і роботи у мережі. У цьому навчальному матеріалі Pod має лише один контейнер. Kubernetes Deployment перевіряє стан Pod'а і перезапускає контейнер Pod'а, якщо контейнер перестає працювати. Створювати і масштабувати Pod'и рекомендується за допомогою Deployment'ів.
За допомогою команди kubectl create створіть Deployment, який керуватиме Pod'ом. Pod запускає контейнер на основі наданого Docker образу.
За умовчанням, Pod доступний лише за внутрішньою IP-адресою у межах Kubernetes кластера. Для того, щоб контейнер hello-node став доступний за межами віртуальної мережі Kubernetes, Pod необхідно відкрити як Kubernetes Service.
Відкрийте Pod для публічного доступу з інтернету за допомогою команди kubectl expose:
Прапорець `--type=LoadBalancer` вказує, що ви хочете відкрити доступ до Service за межами кластера.
Перегляньте інформацію про Service, який ви щойно створили:
kubectl get services
У виводі ви побачите подібну інформацію:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
hello-node LoadBalancer 10.108.144.78 <pending> 8080:30369/TCP 21s
kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 23m
Для хмарних провайдерів, що підтримують балансування навантаження, доступ до Service надається через зовнішню IP-адресу. Для Minikube, тип `LoadBalancer` робить Service доступним ззовні за допомогою команди `minikube service`.
Виконайте наступну команду:
minikube service hello-node
Тільки для Katacoda: натисніть знак плюс, а потім -- Select port to view on Host 1.
Тільки для Katacoda: запишіть п'ятизначний номер порту, що відображається напроти 8080 у виводі сервісу. Номер цього порту генерується довільно і тому може бути іншим у вашому випадку. Введіть номер порту у призначене для цього текстове поле і натисніть Display Port. У нашому прикладі номер порту 30369.
Це відкриє вікно браузера, в якому запущений ваш застосунок, і покаже повідомлення "Hello World".
Увімкнення розширень
Minikube має ряд вбудованих розширень, які можна увімкнути, вимкнути і відкрити у локальному Kubernetes оточенні.
9.7 - Відкриття доступу до застосунку за межами кластера
9.8 - Масштабування застосунку
9.9 - Оновлення застосунку
10 - Огляд стилю документації
Матеріали цього розділу містять настанови щодо стилю написання, форматування та організації вмісту, а також використання специфічних для документації Kubernetes налаштувань Hugo.
11 - Оновлення довідкової документації
Матеріали цього розділу описують, як генерувати довідкові посібники Kubernetes.
Щоб зібрати довідкову документацію, див. такі посібники:
┌──────────────────────────────────────────────────────────┐
│ KUBEADM │
│ Easily bootstrap a secure Kubernetes cluster │
│ │
│ Please give us feedback at: │
│ https://github.com/kubernetes/kubeadm/issues │
└──────────────────────────────────────────────────────────┘
Приклад використання:
Create a two-machine cluster with one control-plane node
(which controls the cluster), and one worker node
(where your workloads, like Pods and Deployments run).
┌──────────────────────────────────────────────────────────┐
│ On the first machine: │
├──────────────────────────────────────────────────────────┤
│ control-plane# kubeadm init │
└──────────────────────────────────────────────────────────┘
┌──────────────────────────────────────────────────────────┐
│ On the second machine: │
├──────────────────────────────────────────────────────────┤
│ worker# kubeadm join <arguments-returned-from-init> │
└──────────────────────────────────────────────────────────┘
You can then repeat the second step on as many other machines as you like.
Параметри
-h, --help
довідка для kubeadm
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2 -
Опис
Команди, повʼязані з обробкою сертифікатів Kubernetes
kubeadm certs [flags]
Параметри
-h, --help
довідка для certs
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.1 -
Генерує ключі сертифікатів
Опис
Ця команда виведе захищений випадково згенерований ключ сертифіката, який можна використовувати з командою "init".
Ви також можете скористатися командою "kubeadm init --upload-certs" без зазначення ключа сертифіката, і вона згенерує і виведе його для вас.
kubeadm certs certificate-key [flags]
Параметри
-h, --help
довідка для certificate-key
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.2 -
Перевіряє термін дії сертифікатів для кластера Kubernetes
Опис
Перевіряє термін дії сертифікатів у локальному PKI, яким керує kubeadm.
kubeadm certs check-expiration [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.3 -
Генерує ключі та запити на підписання сертифікатів
Опис
Генерує ключі та запити на підписання сертифікатів (CSR) для всіх сертифікатів, необхідних для роботи панелі управління. Ця команда також генерує часткові файли kubeconfig з даними приватного ключа в полі "users > user > client-key-data", і для кожного файлу kubeconfig створюється супутній файл ".csr".
Ця команда призначена для використання в режимі зовнішнього CA kubeadm. Вона генерує CSR, які ви потім можете подати на підписання до вашого зовнішнього центру сертифікації.
Закодовані в PEM підписані сертифікати повинні бути збережені поруч з файлами ключів, використовуючи ".crt" як розширення файлу, або, у випадку з файлами kubeconfig, закодований в PEM підписаний сертифікат повинен бути закодований у base64 і доданий до файлу kubeconfig в полі "users > user > client-certificate-data".
kubeadm certs generate-csr [flags]
Приклади
# The following command will generate keys and CSRs for all control-plane certificates and kubeconfig files:
kubeadm certs generate-csr --kubeconfig-dir /tmp/etc-k8s --cert-dir /tmp/etc-k8s/pki
Параметри
--cert-dir string
Шлях, де будуть збережені сертифікати
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для generate-csr
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.4 -
Опис
Поновлення сертифікатів для кластера Kubernetes
kubeadm certs renew [flags]
Параметри
-h, --help
довідка для renew
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.5 -
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання адміністратором і для самого kubeadm.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.6 -
Поновлення всіх доступних сертифікатів
Опис
Поновлює всі відомі сертифікати, необхідні для роботи панелі управління. Поновлення виконується безумовно, незалежно від дати закінчення терміну дії. Поновлення також можна виконувати окремо для більшого контролю.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.7 -
Опис
Поновлює сертифікат, який apiserver використовує для доступу до etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.8 -
Опис
Поновлює сертифікат, який API-сервер використовує для підключення до kubelet.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.9 -
Опис
Поновлює сертифікат для обслуговування API Kubernetes.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.10 -
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання менеджером контролерів.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.11 -
Опис
Поновлює сертифікат для проб життєздатності для перевірки стану справності etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.12 -
Опис
Поновлює сертифікат для вузлів etcd, щоб вони могли взаємодіяти один з одним.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.13 -
Опис
Поновлює сертифікат для обслуговування etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.14 -
Опис
Поновлення сертифіката клієнта front proxy.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.15 -
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання менеджером планувальника.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.2.16 -
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для суперадміністратора (super-admin).
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.3 -
Опис
Виводить код завершення команд для вказаної оболонки (bash або zsh). Код оболонки має бути виконаний, щоб забезпечити інтерактивне завершення команд kubeadm. Це можна зробити, підключивши його (source) у файлі .bash_profile.
Примітка: для цього потрібен фреймворк bash-completion.
Щоб встановити його на Mac, використовуйте homebrew: $ brew install bash-completion Після встановлення потрібно виконати bash_completion. Це можна зробити, додавши такий рядок до .bash_profile $ source $(brew --prefix)/etc/bash_completion
Якщо bash-completion не встановлено в Linux, встановіть пакет 'bash-completion' за допомогою менеджера пакетів вашого дистрибутива.
Примітка для користувачів zsh: [1] завершення команд у zsh підтримується лише у версіях zsh >= 5.2
kubeadm completion SHELL [flags]
Приклади
# Install bash completion on a Mac using homebrew
brew install bash-completion
printf "\n# Bash completion support\nsource $(brew --prefix)/etc/bash_completion\n" >> $HOME/.bash_profile
source $HOME/.bash_profile
# Load the kubeadm completion code for bash into the current shell
source <(kubeadm completion bash)
# Write bash completion code to a file and source it from .bash_profile
kubeadm completion bash > ~/.kube/kubeadm_completion.bash.inc
printf "\n# Kubeadm shell completion\nsource '$HOME/.kube/kubeadm_completion.bash.inc'\n" >> $HOME/.bash_profile
source $HOME/.bash_profile
# Load the kubeadm completion code for zsh[1] into the current shell
source <(kubeadm completion zsh)
Параметри
-h, --help
довідка для completion
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4 -
Керування конфігурацією для кластера kubeadm, збереженою у ConfigMap у кластері
Опис
У просторі імен kube-system є ConfigMap з назвою "kubeadm-config", який kubeadm використовує для зберігання внутрішньої конфігурації кластера. kubeadm CLI v1.8.0+ автоматично створює цей ConfigMap з конфігурацією, що використовується командою 'kubeadm init', але якщо ви ініціалізували кластер за допомогою kubeadm v1.7.x або нижчої версії, вам потрібно скористатися командою 'kubeadm init phase upload-config', щоб створити цей ConfigMap. Це необхідно для того, щоб команда 'kubeadm upgrade' могла правильно налаштувати ваш оновлений кластер.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.1 -
Опис
Взаємодія з образами контейнерів, які використовує kubeadm
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.2 -
Опис
Виводить список образів, які буде використовувати kubeadm. Файл конфігурації використовується у випадку налаштування будь-яких образів або сховищ образів
kubeadm config images list [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
--config string
Шлях до конфігураційного файлу kubeadm.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.3 -
Опис
Завантажує образи, які використовує kubeadm
kubeadm config images pull [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.4 -
Зчитує стару версію типів API конфігурації kubeadm з файлу і виводить аналогічний обʼєкт конфігурації для новішої версії
Опис
Ця команда дозволяє конвертувати обʼєкти конфігурації старих версій у найновішу підтримувану версію локально в інструменті CLI, нічого не змінюючи в кластері.
У цій версії kubeadm підтримуються такі версії API:
kubeadm.k8s.io/v1beta4
Крім того, kubeadm може записувати конфігурацію лише версії "kubeadm.k8s.io/v1beta4", але читати обидва типи. Тож незалежно від того, яку версію ви передаєте тут параметру --old-config, обʼєкт API буде прочитано, десеріалізовано, заповнено типовими значеннями, конвертовано, валідовано та повторно серіалізовано під час запису у stdout або в --new-config, якщо його вказано.
Іншими словами, вихідні дані цієї команди — це те, що kubeadm фактично прочитав би внутрішньо, якби ви передали цей файл команді "kubeadm init"
kubeadm config migrate [flags]
Параметри
--allow-experimental-api
Дозволити міграцію на експериментальні, ще не випущені API.
-h, --help
довідка для migrate
--new-config string
Шлях до отриманого еквівалентного конфігураційного файлу kubeadm з використанням нової версії API. Необовʼязково, якщо не вказано, вивід буде надіслано у STDOUT.
--old-config string
Шлях до конфігураційного файлу kubeadm, який використовує стару версію API і який має бути конвертований. Цей прапорець є обовʼязковим.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.6 -
Виводить типову конфігурацію init, яку можна використовувати для 'kubeadm init'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація init, яка використовується для 'kubeadm init'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
kubeadm config print init-defaults [flags]
Параметри
--component-configs strings
Список обʼєктів API конфігурації компонентів через кому для виводу типових значень. Доступні значення: [KubeProxyConfiguration KubeletConfiguration]. Якщо цей прапорець не встановлено, конфігурації компонентів не буде надруковано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.7 -
Виводить типову конфігурацію join, яка може бути використана для 'kubeadm join'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація команди join, яка використовується для 'kubeadm join'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.8 -
Виводить типову конфігурацію reset, яка може бути використана для 'kubeadm reset'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація команди reset, яка використовується для 'kubeadm reset'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.9 -
Виводить типову конфігурацію upgrade, яка може бути використана для 'kubeadm upgrade'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація команди upgrade, яка використовується для 'kubeadm upgrade'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.4.10 -
Зчитує файл, що містить конфігураційний API kubeadm, і повідомляє про будь-які проблеми під час валідації
Опис
Ця команда дозволяє перевірити файл конфігурації API kubeadm та повідомити про будь-які попередження та помилки. Якщо помилок немає, код завершення буде нульовим, в іншому випадку він буде ненульовим. Будь-які проблеми з розбором, такі як невідомі поля API, спричинять помилки. Невідомі версії API та поля з недійсними значеннями також спричинять помилки. Про будь-які інші помилки або попередження може бути повідомлено залежно від вмісту вхідного файлу.
У цій версії kubeadm підтримуються такі версії API:
kubeadm.k8s.io/v1beta4
kubeadm config validate [flags]
Параметри
--allow-deprecated-api
Дозволяє валідацію застарілих API.
--allow-experimental-api
Дозволяє валідацію експериментальних, невипущених API.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5 -
Опис
Запустіть цю команду, щоб налаштувати панель управління Kubernetes
Команда "init" виконує такі фази:
preflight Run pre-flight checks
certs Certificate generation
/ca Generate the self-signed Kubernetes CA to provision identities for other Kubernetes components
/apiserver Generate the certificate for serving the Kubernetes API
/apiserver-kubelet-client Generate the certificate for the API server to connect to kubelet
/front-proxy-ca Generate the self-signed CA to provision identities for front proxy
/front-proxy-client Generate the certificate for the front proxy client
/etcd-ca Generate the self-signed CA to provision identities for etcd
/etcd-server Generate the certificate for serving etcd
/etcd-peer Generate the certificate for etcd nodes to communicate with each other
/etcd-healthcheck-client Generate the certificate for liveness probes to healthcheck etcd
/apiserver-etcd-client Generate the certificate the apiserver uses to access etcd
/sa Generate a private key for signing service account tokens along with its public key
kubeconfig Generate all kubeconfig files necessary to establish the control plane and the admin kubeconfig file
/admin Generate a kubeconfig file for the admin to use and for kubeadm itself
/super-admin Generate a kubeconfig file for the super-admin
/kubelet Generate a kubeconfig file for the kubelet to use *only* for cluster bootstrapping purposes
/controller-manager Generate a kubeconfig file for the controller manager to use
/scheduler Generate a kubeconfig file for the scheduler to use
etcd Generate static Pod manifest file for local etcd
/local Generate the static Pod manifest file for a local, single-node local etcd instance
control-plane Generate all static Pod manifest files necessary to establish the control plane
/apiserver Generates the kube-apiserver static Pod manifest
/controller-manager Generates the kube-controller-manager static Pod manifest
/scheduler Generates the kube-scheduler static Pod manifest
kubelet-start Write kubelet settings and (re)start the kubelet
wait-control-plane Wait for the control plane to start
upload-config Upload the kubeadm and kubelet configuration to a ConfigMap
/kubeadm Upload the kubeadm ClusterConfiguration to a ConfigMap
/kubelet Upload the kubelet component config to a ConfigMap
upload-certs Upload certificates to kubeadm-certs
mark-control-plane Mark a node as a control-plane
bootstrap-token Generates bootstrap tokens used to join a node to a cluster
kubelet-finalize Updates settings relevant to the kubelet after TLS bootstrap
/enable-client-cert-rotation Enable kubelet client certificate rotation
addon Install required addons for passing conformance tests
/coredns Install the CoreDNS addon to a Kubernetes cluster
/kube-proxy Install the kube-proxy addon to a Kubernetes cluster
show-join-command Show the join command for control-plane and worker node
kubeadm init [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--certificate-key string
Ключ, що використовується для шифрування сертифікатів панелі управління у Secret kubeadm-certs. Ключ сертифіката — це шістнадцятковий рядок, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
-h, --help
довідка для init
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Токен для встановлення двосторонньої довіри між вузлами та вузлами панелі управління. Формат [a-z0-9]{6}.[a-z0-9]{16} — наприклад, abcdef.0123456789abcdef
--token-ttl duration Типово: 24h0m0s
Час до автоматичного видалення токена (наприклад, 1s, 2m, 3h). Якщо встановлено '0', термін дії токена ніколи не спливе
--upload-certs
Завантажити сертифікати панелі управління у Secret kubeadm-certs.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.1 -
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "init".
kubeadm init phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.2 -
Опис
Встановлює необхідні надбудови для проходження тестів на відповідність
kubeadm init phase addon [flags]
Параметри
-h, --help
довідка для addon
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.3 -
Опис
Встановлює всі надбудови
kubeadm init phase addon all [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Використовуйте альтернативний домен для сервісів, наприклад, "myorg.internal".
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.4 -
Встановлює надбудову CoreDNS в кластер Kubernetes
Опис
Встановлює компоненти надбудови CoreDNS через API-сервер. Зверніть увагу, що хоча DNS-сервер розгорнуто, його не буде заплановано, доки не буде встановлено CNI.
kubeadm init phase addon coredns [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--print-manifest
Вивести маніфести надбудов в STDOUT замість їх встановлення
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--print-manifest
Вивести маніфести надбудов в STDOUT замість їх встановлення
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.6 -
Генерує токени bootstrap, які використовуються для приєднання вузла до кластера
Опис
Токени bootstrap використовуються для встановлення двосторонньої довіри між вузлом, що приєднується до кластера, і вузлом панелі управління.
Ця команда виконує всі налаштування, необхідні для роботи токенів bootstrap, а потім створює початковий токен.
kubeadm init phase bootstrap-token [flags]
Приклади
# Make all the bootstrap token configurations and create an initial token, functionally
# equivalent to what generated by kubeadm init.
kubeadm init phase bootstrap-token
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.7 -
Опис
Генерування сертифікатів
kubeadm init phase certs [flags]
Параметри
-h, --help
довідка для certs
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.8 -
Опис
Генерує всі сертифікати
kubeadm init phase certs all [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для apiserver-kubelet-client
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.11 -
Опис
Генерує сертифікат для обслуговування API Kubernetes та зберігає його у файлах apiserver.crt та apiserver.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs apiserver [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для apiserver
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Використовуйте альтернативний домен для сервісів, наприклад, "myorg.internal".
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.12 -
Опис
Генерує самопідписаний центр сертифікації Kubernetes, щоб надати ідентифікатори для інших компонентів Kubernetes та зберігає їх у файлах ca.crt та ca.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs ca [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для ca
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.13 -
Опис
Генерує самопідписаний центр сертифікації (CA) для надання ідентифікаторів для etcd та зберігає його у файлах etcd/ca.crt та etcd/ca.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs etcd-ca [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-ca
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.14 -
Опис
Генерує сертифікат для проб життєздатності для перевірки справності etcd, та зберігає його у файлах etcd/healthcheck-client.crt та etcd/healthcheck-client.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для front-proxy-client
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.19 -
Генерує приватний ключ для підпису токенів службових облікових записів разом із його публічним ключем
Опис
Генерує приватний ключ для підпису токенів службових облікових записів разом із його публічним ключем та зберігає їх у файлах sa.key та sa.pub.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs sa [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для sa
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.20 -
Опис
Генерує всі файли маніфестів статичних Podʼів, потрібні для створення панелі управління
kubeadm init phase control-plane [flags]
Параметри
-h, --help
довідка для control-plane
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.21 -
Опис
Генерує всі файли маніфестів статичних Podʼів
kubeadm init phase control-plane all [flags]
Приклади
# Generates all static Pod manifest files for control plane components,
# functionally equivalent to what is generated by kubeadm init.
kubeadm init phase control-plane all
# Generates all static Pod manifest files using options read from a configuration file.
kubeadm init phase control-plane all --config config.yaml
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.22 -
Опис
Генерує маніфест статичного Podʼа для kube-apiserver
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.23 -
Опис
Генерує маніфест статичного Podʼа для kube-controller-manager
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.24 -
Опис
Генерує маніфест статичного Podʼа для kube-scheduler
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.25 -
Опис
Генерує файл маніфесту статичного Podʼа для локального etcd
kubeadm init phase etcd [flags]
Параметри
-h, --help
довідка для etcd
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.26 -
Опис
Генерує файл маніфесту статичного Podʼа для локального одновузлового екземпляра local etcd
kubeadm init phase etcd local [flags]
Приклади
# Generates the static Pod manifest file for etcd, functionally
# equivalent to what is generated by kubeadm init.
kubeadm init phase etcd local
# Generates the static Pod manifest file for etcd using options
# read from a configuration file.
kubeadm init phase etcd local --config config.yaml
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.27 -
Опис
Генерує всі файли kubeconfig, необхідні для встановлення панелі управління, та файл kubeconfig адміністратора
kubeadm init phase kubeconfig [flags]
Параметри
-h, --help
довідка для kubeconfig
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.28 -
Генерує файл kubeconfig для використання адміністратором та для самого kubeadm
Опис
Генерує файл kubeconfig для адміністратора та для самого kubeadm і зберігає його у файл admin.conf.
kubeadm init phase kubeconfig admin [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для admin
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.29 -
Опис
Генерує всі файли kubeconfig
kubeadm init phase kubeconfig all [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.30 -
Генерує файл kubeconfig для використання менеджером контролерів
Опис
Генерує файл kubeconfig для використання менеджером контролерів та зберігає його у файл controller-manager.conf
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для controller-manager
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.31 -
Генерує файл kubeconfig для використання kubelet лише для потреб початкового завантаження кластера
Опис
Генерує файл kubeconfig для використання kubelet та зберігає його у файл kubelet.conf.
Зауважте, що цей файл слід використовувати лише для потреб початкового завантаження кластера. Після запуску панелі управління слід запитувати всі облікові дані kubelet через CSR API.
kubeadm init phase kubeconfig kubelet [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubelet
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.32 -
Генерує файл kubeconfig для використання планувальником
Опис
Генерує файл kubeconfig для використання планувальником та зберігає його у файл scheduler.conf.
kubeadm init phase kubeconfig scheduler [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для scheduler
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.33 -
Опис
Генерує файл kubeconfig для суперадміністратора та зберігає його у файл super-admin.conf.
kubeadm init phase kubeconfig super-admin [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для super-admin
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.34 -
Опис
Оновлює налаштування, що стосуються kubelet, після TLS bootstrap
kubeadm init phase kubelet-finalize [flags]
Приклади
# Updates settings relevant to the kubelet after TLS bootstrap
kubeadm init phase kubelet-finalize all --config
Параметри
-h, --help
довідка для kubelet-finalize
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.35 -
Опис
Запускає всі фази kubelet-finalize
kubeadm init phase kubelet-finalize all [flags]
Приклади
# Updates settings relevant to the kubelet after TLS bootstrap
kubeadm init phase kubelet-finalize all --config
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для enable-client-cert-rotation
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.37 -
Записує налаштування kubelet та (пере)запускає kubelet
Опис
Записує файл з KubeletConfiguration та файл оточення з налаштуваннями kubelet для конкретного вузла, а потім (пере)запускає kubelet.
kubeadm init phase kubelet-start [flags]
Приклади
# Writes a dynamic environment file with kubelet flags from a InitConfiguration file.
kubeadm init phase kubelet-start --config config.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.38 -
Опис
Позначає вузол як вузол панелі управління
kubeadm init phase mark-control-plane [flags]
Приклади
# Applies control-plane label and taint to the current node, functionally equivalent to what executed by kubeadm init.
kubeadm init phase mark-control-plane --config config.yaml
# Applies control-plane label and taint to a specific node
kubeadm init phase mark-control-plane --node-name myNode
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для mark-control-plane
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.39 -
Опис
Виконує попередні перевірки для kubeadm init.
kubeadm init phase preflight [flags]
Приклади
# Run pre-flight checks for kubeadm init using a config file.
kubeadm init phase preflight --config kubeadm-config.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Вибрати реєстр контейнерів для завантаження образів панелі управління
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.40 -
Опис
Показує команду join для вузла панелі управління та робочого вузла
kubeadm init phase show-join-command [flags]
Параметри
-h, --help
довідка для show-join-command
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.41 -
Завантажує сертифікати до kubeadm-certs
Опис
Завантажує сертифікати панелі управління в Secret kubeadm-certs
kubeadm init phase upload-certs [flags]
Параметри
--certificate-key string
Ключ, що використовується для шифрування сертифікатів панелі управління у Secret kubeadm-certs. Ключ сертифіката — це шістнадцятковий рядок, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--skip-certificate-key-print
Не виводити ключ, який використовується для шифрування сертифікатів панелі управління.
--upload-certs
Завантажити сертифікати панелі управління у Secret kubeadm-certs.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.42 -
Опис
Завантажує конфігурації kubeadm та kubelet у ConfigMap
kubeadm init phase upload-config [flags]
Параметри
-h, --help
довідка для upload-config
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.43 -
Опис
Завантажує всю конфігурацію в ConfigMap
kubeadm init phase upload-config all [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.44 -
Опис
Завантажує ClusterConfiguration kubeadm до ConfigMap з назвою kubeadm-config у просторі імен kube-system. Це забезпечує правильну конфігурацію системних компонентів і безпроблемну роботу користувачів під час оновлення.
Альтернативно, ви можете використовувати kubeadm config.
kubeadm init phase upload-config kubeadm [flags]
Приклади
# upload the configuration of your cluster
kubeadm init phase upload-config kubeadm --config=myConfig.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.45 -
Завантажує конфігурацію компонента kubelet у ConfigMap
Опис
Завантажує конфігурацію kubelet, видобуту з обʼєкта kubeadm InitConfiguration, до ConfigMap kubelet-config у кластері
kubeadm init phase upload-config kubelet [flags]
Приклади
# Upload the kubelet configuration from the kubeadm Config file to a ConfigMap in the cluster.
kubeadm init phase upload-config kubelet --config kubeadm.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.5.46 -
Опис
Очікує запуску панелі управління
kubeadm init phase wait-control-plane [flags]
Параметри
-h, --help
довідка для wait-control-plane
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6 -
Запустіть цю команду на будь-якому компʼютері, який ви хочете приєднати до існуючого кластера
Опис
Під час приєднання до кластера, ініціалізованого kubeadm, необхідно встановити двосторонню довіру. Цей процес розділяється на виявлення (щоб Node довіряв панелі управління Kubernetes) та TLS bootstrap (щоб панель управління Kubernetes довіряла Node).
Існує 2 основні схеми виявлення. Перша — використовувати спільний токен разом з IP-адресою API-сервера. Друга — надати файл, який є підмножиною стандартного файлу kubeconfig. Файл discovery/kubeconfig підтримує токен, втулки автентифікації client-go ("exec"), "tokenFile" та "authProvider". Цей файл може бути локальним або завантаженим через HTTPS URL. Можливі форми: kubeadm join --discovery-token abcdef.1234567890abcdef 1.2.3.4:6443, kubeadm join --discovery-file path/to/file.conf або kubeadm join --discovery-file https://url/file.conf. Можна використовувати лише одну форму. Якщо інформація для виявлення завантажується з URL, обовʼязково використовувати HTTPS. Також у цьому випадку для перевірки зʼєднання використовується встановлений на хості набір сертифікатів CA.
Якщо ви використовуєте спільний токен для виявлення, слід також передати прапорець --discovery-token-ca-cert-hash для перевірки публічного ключа кореневого центру сертифікації (CA), наданого панеллю управління Kubernetes. Значення цього прапорця задається як "<hash-type>:<hex-encoded-value>", де підтримуваний тип хешу — "sha256". Хеш обчислюється по байтах обʼєкта Subject Public Key Info (SPKI) (як в RFC7469). Це значення доступне у виводі "kubeadm init" або може бути обчислене за допомогою стандартних інструментів. Прапорець --discovery-token-ca-cert-hash можна вказувати кілька разів, щоб дозволити більше одного публічного ключа.
Якщо ви не можете знати хеш публічного ключа CA заздалегідь, ви можете передати прапорець --discovery-token-unsafe-skip-ca-verification, щоб вимкнути цю перевірку. Це послаблює модель безпеки kubeadm, оскільки інші вузли потенційно можуть видавати себе за панель управління Kubernetes.
Механізм TLS bootstrap також працює через спільний токен. Він використовується для тимчасової автентифікації в панелі управління Kubernetes, щоб подати запит на підписання сертифіката (CSR) для локально створеної пари ключів. Типово kubeadm налаштовує панель управління Kubernetes на автоматичне схвалення цих запитів на підписання. Цей токен передається за допомогою прапорця --tls-bootstrap-token abcdef.1234567890abcdef.
Часто той самий токен використовується для обох частин. У цьому випадку замість окремого зазначення кожного токена можна використовувати прапорець --token.
Команда "join [api-server-endpoint]" виконує такі фази:
preflight Run join pre-flight checks
control-plane-prepare Prepare the machine for serving a control plane
/download-certs Download certificates shared among control-plane nodes from the kubeadm-certs Secret
/certs Generate the certificates for the new control plane components
/kubeconfig Generate the kubeconfig for the new control plane components
/control-plane Generate the manifests for the new control plane components
kubelet-start Write kubelet settings, certificates and (re)start the kubelet
etcd-join Join etcd for control plane nodes
kubelet-wait-bootstrap Wait for the kubelet to bootstrap itself
control-plane-join Join a machine as a control plane instance
/mark-control-plane Mark a node as a control-plane
wait-control-plane Wait for the control plane to start
kubeadm join [api-server-endpoint] [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для join
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--skip-phases strings
Список фаз, які потрібно пропустити
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.1 -
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "join"
kubeadm join phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.2 -
Опис
Приєднує машину як екземпляр панелі управління
kubeadm join phase control-plane-join [flags]
Приклади
# Joins a machine as a control plane instance
kubeadm join phase control-plane-join all
Параметри
-h, --help
довідка для control-plane-join
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.3 -
Опис
Приєднує машину як екземпляр панелі управління
kubeadm join phase control-plane-join all [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для mark-control-plane
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.5 -
Опис
Готує машину до обслуговування панелі управління
kubeadm join phase control-plane-prepare [flags]
Приклади
# Prepares the machine for serving a control plane
kubeadm join phase control-plane-prepare all
Параметри
-h, --help
довідка для control-plane-prepare
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.6 -
Опис
Готує машину до обслуговування панелі управління
kubeadm join phase control-plane-prepare all [api-server-endpoint] [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.7 -
Опис
Генерує сертифікати для нових компонентів панелі управління
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для certs
--node-name string
Вкажіть імʼя вузла.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.8 -
Опис
Генерує маніфести для нових компонентів панелі управління
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для control-plane
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.9 -
Опис
Завантажує сертифікати, спільні для вузлів панелі управління, з Secret kubeadm-certs
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для download-certs
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.10 -
Опис
Генерує kubeconfig для нових компонентів панелі управління
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubeconfig
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.11 -
Опис
Приєднує etcd для вузлів панелі управління
kubeadm join phase etcd-join [flags]
Приклади
# Joins etcd for a control plane instance
kubeadm join phase control-plane-join-etcd all
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-join
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.12 -
Записує налаштування kubelet, сертифікати та (пере)запускає kubelet
Опис
Записує файл з KubeletConfiguration та файл оточення з налаштуваннями kubelet для конкретного вузла, а потім (пере)запускає kubelet.
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubelet-start
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.13 -
Опис
Очікує, поки kubelet виконає власне початкове завантаження
kubeadm join phase kubelet-wait-bootstrap [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubelet-wait-bootstrap
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
# Run join pre-flight checks using a config file.
kubeadm join phase preflight --config kubeadm-config.yaml
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
--node-name string
Вкажіть імʼя вузла.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.6.15 -
Опис
Очікує запуску панелі управління
kubeadm join phase wait-control-plane [flags]
Параметри
-h, --help
довідка для wait-control-plane
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.7 -
Опис
Утиліти для файлів kubeconfig.
Параметри
-h, --help
довідка для kubeconfig
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.7.1 -
Опис
Виводить файл kubeconfig для додаткового користувача.
kubeadm kubeconfig user [flags]
Приклади
# Output a kubeconfig file for an additional user named foo
kubeadm kubeconfig user --client-name=foo
# Output a kubeconfig file for an additional user named foo using a kubeadm config file bar
kubeadm kubeconfig user --client-name=foo --config=bar
Параметри
--client-name string
Імʼя користувача. Буде використовуватися як CN у разі створення клієнтських сертифікатів
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для user
--org strings
Організації сертифіката клієнта. Буде використовуватися як O, якщо будуть створені клієнтські сертифікати
--token string
Токен, який слід використовувати як механізм автентифікації для цього kubeconfig замість клієнтських сертифікатів
--validity-period duration Типово: 8760h0m0s
Термін дії клієнтського сертифіката. Відраховується від поточного часу.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.8 -
Опис
Виконує максимально можливий відкат змін, зроблених на цьому хості командами 'kubeadm init' або 'kubeadm join'
Команда "reset" виконує наступні фази:
preflight Run reset pre-flight checks
remove-etcd-member Remove a local etcd member.
cleanup-node Run cleanup node.
kubeadm reset [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях до теки, де зберігаються сертифікати. Якщо вказано, очистити цю теку.
--cleanup-tmp-dir
Очистити теку "/etc/kubernetes/tmp"
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-f, --force
Виконати reset вузла без запиту на підтвердження.
-h, --help
довідка для reset
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--skip-phases strings
Список фаз, які потрібно пропустити
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.8.1 -
Опис
Використовуйте цю команду для виклику однієї фази процесу "reset"
kubeadm reset phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.8.2 -
Опис
Запускає очищення вузла.
kubeadm reset phase cleanup-node [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях до теки, де зберігаються сертифікати. Якщо вказано, очистити цю теку.
--cleanup-tmp-dir
Очистити теку "/etc/kubernetes/tmp"
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для cleanup-node
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.8.3 -
Виконує попередні перевірки reset
Опис
Виконує попередні перевірки для kubeadm reset.
kubeadm reset phase preflight [flags]
Параметри
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-f, --force
Виконати reset вузла без запиту на підтвердження.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.8.4 -
Опис
Видаляє локального учасника etcd для вузла панелі управління.
kubeadm reset phase remove-etcd-member [flags]
Параметри
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.9 -
Керує токенами bootstrap
Опис
Ця команда керує токенами bootstrap. Вона є опціональною та потрібна лише для розширених випадків використання.
Коротко кажучи, токени bootstrap використовуються для встановлення двосторонньої довіри між клієнтом і сервером. Токен bootstrap може бути використаний, коли клієнт (наприклад, вузол, який збирається приєднатися до кластера) має довіряти серверу, з яким він взаємодіє. У цьому випадку можна використовувати токен bootstrap зі способом використання "signing". Токени bootstrap також можуть слугувати способом дозволити короткострокову автентифікацію на API-сервері (токен слугує способом, щоб API-сервер довіряв клієнту), наприклад, для виконання TLS Bootstrap.
Що саме таке токен bootstrap?
Це Secret у просторі імен kube-system типу "bootstrap.kubernetes.io/token".
Токен bootstrap повинен мати форму "[a-z0-9]{6}.[a-z0-9]{16}". Перша частина є публічним ідентифікатором токена,
а друга — секретом токена (Token Secret), і її потрібно зберігати в таємниці за будь-яких обставин!
Secret повинен мати назву "bootstrap-token-(token-id)".
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.9.1 -
Створює токени bootstrap на сервері
Опис
Ця команда створить для вас токен bootstrap. Ви можете вказати способи використання цього токена, "час життя" і необовʼязковий опис, зрозумілий людині.
[token] — це власне токен, який потрібно записати. Це має бути безпечно згенерований випадковий токен у форматі "[a-z0-9]{6}.[a-z0-9]{16}". Якщо [token] не вказано, kubeadm натомість згенерує випадковий токен.
kubeadm token create [token]
Параметри
--certificate-key string
Якщо використовується разом із '--print-join-command', виводить повний прапорець 'kubeadm join', необхідний для приєднання до кластера в ролі панелі управління. Щоб створити новий ключ сертифіката, потрібно використати 'kubeadm init phase upload-certs --upload-certs'.
--config string
Шлях до конфігураційного файлу kubeadm.
--description string
Зрозумілий для людини опис того, як використовується цей токен.
Додаткові групи, від імені яких цей токен автентифікуватиметься, коли його використовують для автентифікації. Має відповідати "\Asystem:bootstrappers:[a-z0-9:-]{0,255}[a-z0-9]\z"
-h, --help
довідка для create
--print-join-command
Замість того, щоб виводити тільки токен, вивести повний прапорець 'kubeadm join', необхідний для приєднання до кластера за допомогою токена.
--ttl duration Типово: 24h0m0s
Час до автоматичного видалення токена (наприклад, 1s, 2m, 3h). Якщо встановлено '0', термін дії токена ніколи не спливе
--usages strings Типово: "signing,authentication"
Описує способи, якими можна використовувати цей токен. Ви можете передавати --usages кілька разів або надати список параметрів через кому. Допустимі параметри: [signing,authentication]
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.9.2 -
Видаляє токени bootstrap на сервері
Опис
Ця команда видалить для вас список токенів bootstrap.
Значення [token-value] — це повний токен у вигляді "[a-z0-9]{6}.[a-z0-9]{16}" або Token ID виду "[a-z0-9]{6}", який потрібно видалити.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.9.3 -
Генерує та виводить токен bootstrap, але не створює його на сервері
Опис
Ця команда виведе випадково згенерований токен bootstrap, який можна використовувати з командами "init" та "join".
Ви не зобовʼязані використовувати цю команду для створення токена. Ви можете зробити це самостійно, якщо він має формат "[a-z0-9]{6}.[a-z0-9]{16}". Ця команда надається для зручності створення токенів у зазначеному форматі.
Ви також можете використовувати "kubeadm init" без вказання токена, і він буде згенерований та виведений для вас.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.9.4 -
Виводить перелік токенів bootstrap на сервері
Опис
Ця команда виведе для вас перелік усіх токенів bootstrap.
kubeadm token list [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
-h, --help
довідка для list
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10 -
Опис
Оновлення кластера до новішої версії відбувається плавно за допомогою цієї команди
kubeadm upgrade [flags]
Параметри
-h, --help
довідка для upgrade
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.1 -
Опис
Оновлює кластер Kubernetes до вказаної версії
Команда "apply [version]" виконує наступні фази:
preflight Run preflight checks before upgrade
control-plane Upgrade the control plane
upload-config Upload the kubeadm and kubelet configurations to ConfigMaps
/kubeadm Upload the kubeadm ClusterConfiguration to a ConfigMap
/kubelet Upload the kubelet configuration to a ConfigMap
kubelet-config Upgrade the kubelet configuration for this node
bootstrap-token Configures bootstrap token and cluster-info RBAC rules
addon Upgrade the default kubeadm addons
/coredns Upgrade the CoreDNS addon
/kube-proxy Upgrade the kube-proxy addon
post-upgrade Run post upgrade tasks
kubeadm upgrade apply [version]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-f, --force
Примусове оновлення, навіть якщо деякі вимоги можуть бути не виконані. Це також передбачає неінтерактивний режим.
-h, --help
довідка для apply
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--print-config
Вказує, чи потрібно надрукувати файл конфігурації, який буде використаний під час оновлення.
--skip-phases strings
Список фаз, які потрібно пропустити
-y, --yes
Виконати оновлення і не запитувати підтвердження (режим без взаємодії).
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.2 -
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "apply"
kubeadm upgrade apply phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.3 -
Опис
Оновлює типові надбудови kubeadm
kubeadm upgrade apply phase addon [flags]
Параметри
-h, --help
довідка для addon
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.4 -
Опис
Оновлення всіх надбудов
kubeadm upgrade apply phase addon all [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.5 -
Опис
Оновлення надбудови CoreDNS
kubeadm upgrade apply phase addon coredns [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.7 -
Опис
Налаштовує токен bootstrap та правила cluster-info RBAC
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.8 -
Опис
Оновлення панелі управління
kubeadm upgrade apply phase control-plane [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.9 -
Опис
Оновлює конфігурацію kubelet для цього вузла, завантажуючи її з ConfigMap kubelet-config, що зберігається в кластері
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.10 -
Опис
Запуск завдань після оновлення
kubeadm upgrade apply phase post-upgrade [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.11 -
Опис
Запуск попередніх перевірок перед оновленням
kubeadm upgrade apply phase preflight [flags]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
-f, --force
Примусове оновлення, навіть якщо деякі вимоги можуть бути не виконані. Це також передбачає неінтерактивний режим.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-y, --yes
Виконати оновлення і не запитувати підтвердження (режим без взаємодії).
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.12 -
Опис
Завантаження конфігурацій kubeadm та kubelet до ConfigMaps
kubeadm upgrade apply phase upload-config [flags]
Параметри
-h, --help
довідка для upload-config
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.13 -
Опис
Завантаження всіх конфігурацій до ConfigMaps
kubeadm upgrade apply phase upload-config all [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.14 -
Опис
Завантаження kubeadm ClusterConfiguration до ConfigMap
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.16 -
Опис
Показує, які відмінності буде застосовано до наявних маніфестів статичних Podʼів. Дивіться також: kubeadm upgrade apply --dry-run
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.17 -
Опис
Команди upgrade для вузла в кластері
Команда "node" виконує наступні фази:
preflight Run upgrade node pre-flight checks
control-plane Upgrade the control plane instance deployed on this node, if any
kubelet-config Upgrade the kubelet configuration for this node
addon Upgrade the default kubeadm addons
/coredns Upgrade the CoreDNS addon
/kube-proxy Upgrade the kube-proxy addon
post-upgrade Run post upgrade tasks
kubeadm upgrade node [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-h, --help
довідка для node
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--skip-phases strings
Список фаз, які потрібно пропустити
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.18 -
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "node"
kubeadm upgrade node phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.19 -
Опис
Оновлює типові надбудови kubeadm
kubeadm upgrade node phase addon [flags]
Параметри
-h, --help
довідка для addon
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.20 -
Опис
Оновлення всіх надбудов
kubeadm upgrade node phase addon all [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.21 -
Опис
Оновлення надбудови CoreDNS
kubeadm upgrade node phase addon coredns [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.23 -
Опис
Оновлює екземпляр панелі управління, розгорнутий на цьому вузлі, якщо такий є
kubeadm upgrade node phase control-plane [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.24 -
Опис
Оновлює конфігурацію kubelet для цього вузла, завантажуючи її з ConfigMap kubelet-config, що зберігається в кластері
kubeadm upgrade node phase kubelet-config [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.25 -
Опис
Запуск завдань після оновлення
kubeadm upgrade node phase post-upgrade [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.26 -
Виконує попередні перевірки upgrade node
Опис
Виконує попередні перевірки для kubeadm upgrade node.
kubeadm upgrade node phase preflight [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.10.27 -
Опис
Перевіряє, до яких версій можна оновитися, і перевіряє, чи можна оновити ваш поточний кластер. Ця команда може бути виконана лише на вузлах панелі управління, де існує файл kubeconfig "admin.conf". Щоб пропустити перевірку Інтернету, вкажіть необовʼязковий параметр [version].
kubeadm upgrade plan [version] [flags]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--config string
Шлях до конфігураційного файлу kubeadm.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-h, --help
довідка для plan
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--print-config
Вказує, чи потрібно надрукувати файл конфігурації, який буде використаний під час оновлення.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.11 -
Опис
Виводить версію kubeadm
kubeadm version [flags]
Параметри
-h, --help
довідка для version
-o, --output string
Формат виводу; доступні варіанти: 'yaml', 'json' та 'short'
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.1.12 -
All files in this directory are auto-generated from other repos. Do not edit them manually. You must edit them in their upstream repo.
12.2 - kubeadm init
Ця команда ініціалізує вузол панелі управління Kubernetes.
Опис
Запустіть цю команду, щоб налаштувати панель управління Kubernetes
Команда "init" виконує такі фази:
preflight Run pre-flight checks
certs Certificate generation
/ca Generate the self-signed Kubernetes CA to provision identities for other Kubernetes components
/apiserver Generate the certificate for serving the Kubernetes API
/apiserver-kubelet-client Generate the certificate for the API server to connect to kubelet
/front-proxy-ca Generate the self-signed CA to provision identities for front proxy
/front-proxy-client Generate the certificate for the front proxy client
/etcd-ca Generate the self-signed CA to provision identities for etcd
/etcd-server Generate the certificate for serving etcd
/etcd-peer Generate the certificate for etcd nodes to communicate with each other
/etcd-healthcheck-client Generate the certificate for liveness probes to healthcheck etcd
/apiserver-etcd-client Generate the certificate the apiserver uses to access etcd
/sa Generate a private key for signing service account tokens along with its public key
kubeconfig Generate all kubeconfig files necessary to establish the control plane and the admin kubeconfig file
/admin Generate a kubeconfig file for the admin to use and for kubeadm itself
/super-admin Generate a kubeconfig file for the super-admin
/kubelet Generate a kubeconfig file for the kubelet to use *only* for cluster bootstrapping purposes
/controller-manager Generate a kubeconfig file for the controller manager to use
/scheduler Generate a kubeconfig file for the scheduler to use
etcd Generate static Pod manifest file for local etcd
/local Generate the static Pod manifest file for a local, single-node local etcd instance
control-plane Generate all static Pod manifest files necessary to establish the control plane
/apiserver Generates the kube-apiserver static Pod manifest
/controller-manager Generates the kube-controller-manager static Pod manifest
/scheduler Generates the kube-scheduler static Pod manifest
kubelet-start Write kubelet settings and (re)start the kubelet
wait-control-plane Wait for the control plane to start
upload-config Upload the kubeadm and kubelet configuration to a ConfigMap
/kubeadm Upload the kubeadm ClusterConfiguration to a ConfigMap
/kubelet Upload the kubelet component config to a ConfigMap
upload-certs Upload certificates to kubeadm-certs
mark-control-plane Mark a node as a control-plane
bootstrap-token Generates bootstrap tokens used to join a node to a cluster
kubelet-finalize Updates settings relevant to the kubelet after TLS bootstrap
/enable-client-cert-rotation Enable kubelet client certificate rotation
addon Install required addons for passing conformance tests
/coredns Install the CoreDNS addon to a Kubernetes cluster
/kube-proxy Install the kube-proxy addon to a Kubernetes cluster
show-join-command Show the join command for control-plane and worker node
kubeadm init [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--certificate-key string
Ключ, що використовується для шифрування сертифікатів панелі управління у Secret kubeadm-certs. Ключ сертифіката — це шістнадцятковий рядок, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
-h, --help
довідка для init
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Токен для встановлення двосторонньої довіри між вузлами та вузлами панелі управління. Формат [a-z0-9]{6}.[a-z0-9]{16} — наприклад, abcdef.0123456789abcdef
--token-ttl duration Типово: 24h0m0s
Час до автоматичного видалення токена (наприклад, 1s, 2m, 3h). Якщо встановлено '0', термін дії токена ніколи не спливе
--upload-certs
Завантажити сертифікати панелі управління у Secret kubeadm-certs.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Процес init
kubeadm init розгортає вузол панелі управління Kubernetes, виконуючи
наступні кроки:
Виконує серію попередніх перевірок, щоб перевірити стан системи
перед внесенням змін. Деякі перевірки лише видають попередження, інші вважаються
помилками, і kubeadm припиняє роботу, доки проблема не буде виправлена або
користувач не вкаже --ignore-preflight-errors=<list-of-errors>.
Генерує самопідписний CA для налаштування ідентифікаційних даних для кожного компонента в кластері. Користувач може надати свої власні сертифікат та/або ключ CA, помістивши їх у теку сертифікатів, налаштовану через --cert-dir
(типово /etc/kubernetes/pki).
Сертифікати API-сервера матимуть додаткові записи SAN для будь-яких аргументів --apiserver-cert-extra-sans, з приведенням до нижнього регістру за потреби.
Записує файли kubeconfig у /etc/kubernetes/ для kubelet, controller-manager та scheduler для підключення до API-сервера, кожен зі своїми ідентифікаційними даними. Також створюються додаткові файли kubeconfig: для kubeadm як адміністративної сутності (admin.conf) та для суперадміністратора, що може обходити RBAC (super-admin.conf).
Генерує маніфести статичних Podʼів для API-сервера, controller-manager та scheduler. Якщо зовнішній etcd не надано, створюється додатковий маніфест статичного Podʼа для etcd.
Маніфести статичних Podʼів записуються у /etc/kubernetes/manifests; kubelet стежить за цією текою, щоб створити Podʼи під час запуску.
Щойно Podʼи панелі управління будуть запущені та працюватимуть, процес kubeadm init може продовжитися.
Додає мітки та taint на вузол панелі управління, щоб жодні додаткові робочі навантаження не запускалися там.
Генерує токен, який додаткові вузли зможуть використовувати в майбутньому для реєстрації в панелі управління. За бажанням користувач може надати токен через --token, як описано в документації kubeadm token.
Виконує всі необхідні налаштування, щоб дозволити приєднання вузлів за допомогою механізму токенів bootstrap та TLS Bootstrap:
Записує ConfigMap, що надає всю необхідну для приєднання інформацію, та налаштовує відповідні правила доступу RBAC.
Надає токенам bootstrap доступ до API підписання CSR.
Налаштовує автоматичне схвалення нових запитів CSR.
Встановлює DNS-сервер (CoreDNS) та компоненти надбудови kube-proxy через API-сервер. Зверніть увагу, що хоча DNS-сервер розгорнуто, він не буде запланований до встановлення CNI.
Використання фаз init з kubeadm
kubeadm дозволяє створювати вузол панелі управління поетапно, використовуючи команду kubeadm init phase.
Щоб переглянути впорядкований список фаз та підфаз, можна викликати kubeadm init --help. Список буде розташований на початку екрана довідки, і кожна фаза матиме опис поруч із нею. Зверніть увагу, що під час виклику kubeadm init всі фази та підфази будуть виконані саме в такому порядку.
Деякі фази мають унікальні прапорці, тому, якщо ви хочете переглянути список доступних опцій, додайте --help, наприклад:
Ви також можете використовувати --help, щоб побачити список підфаз для певної батьківської фази:
sudo kubeadm init phase control-plane --help
kubeadm init також має прапорець --skip-phases, який можна використовувати для пропуску певних фаз. Прапорець приймає список назв фаз, які можна взяти з вищезгаданого впорядкованого списку.
Приклад:
sudo kubeadm init phase control-plane all --config=configfile.yaml
sudo kubeadm init phase etcd local --config=configfile.yaml
# тепер ви можете змінити файли маніфестів панелі управління та etcdsudo kubeadm init --skip-phases=control-plane,etcd --config=configfile.yaml
Цей приклад записує файли маніфестів для панелі управління та etcd у /etc/kubernetes/manifests на основі конфігурації в configfile.yaml. Це дозволяє вам змінити файли, а потім пропустити ці фази, використовуючи --skip-phases. Викликом останньої команди ви створите вузол панелі управління з власними файлами маніфестів.
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.22
Як альтернативу, ви можете використовувати поле skipPhases у InitConfiguration.
Використання kubeadm init з конфігураційним файлом
Увага:
Конфігураційний файл все ще вважається бета-версією і може змінитися в майбутніх версіях.
Можна налаштувати kubeadm init за допомогою конфігураційного файлу замість прапорців командного рядка, а деякі розширені функції можуть бути доступні лише як опції конфігураційного файлу. Цей файл передається за допомогою прапорця --config, і він повинен містити структуру ClusterConfiguration і, за бажанням, інші структури, розділені ---\n. Поєднання --config з іншими прапорцями в деяких випадках може бути недозволеним.
Якщо ваша конфігурація не використовує останню версію, рекомендується мігрувати її за допомогою команди kubeadm config migrate.
Для отримання додаткової інформації про поля та використання конфігурації ви можете перейти на нашу сторінку довідки API.
Використання kubeadm init з функціональними можливостями
kubeadm підтримує набір функціональних можливостей (feature gates), які унікальні для kubeadm і можуть бути застосовані лише під час створення кластера за допомогою kubeadm init. Ці функції можуть керувати поведінкою кластера. Функціональні можливості видаляються після того, як функція переходить до стадії GA.
Щоб передати функціональну можливість, можна використати прапорець --feature-gates для kubeadm init або додати елементи до поля featureGates, коли ви передаєте конфігураційний файл за допомогою --config.
Встановлення цього прапорця налаштовує контейнери статичних Podʼів компонентів панелі управління, розгорнутих kubeadm, для kube-apiserver, kube-controller-manager, kube-scheduler та etcd так, щоб вони запускалися від імені користувачів без прав root. Якщо прапорець не встановлено, ці компоненти запускаються з правами root. Ви можете змінити значення цієї функціональної можливості перед оновленням до новішої версії Kubernetes.
Список видалених функціональних можливостей:
Видалені функціональні можливості kubeadm
Функція
Alpha
Beta
GA
Видалена
ControlPlaneKubeletLocalMode
1.31
1.33
1.35
1.36
EtcdLearnerMode
1.27
1.29
1.32
1.33
IPv6DualStack
1.16
1.21
1.23
1.24
NodeLocalCRISocket
1.32
1.34
1.36
1.37
PublicKeysECDSA
1.19
-
-
1.37
UnversionedKubeletConfigMap
1.22
1.23
1.25
1.26
UpgradeAddonsBeforeControlPlane
1.28
-
-
1.31
WaitForAllControlPlaneComponents
1.30
1.33
1.34
1.35
Опис функціональних можливостей:
ControlPlaneKubeletLocalMode
З увімкненою функціональною можливістю під час приєднання нового вузла панелі управління kubeadm налаштовуватиме kubelet для підключення до локального kube-apiserver. Це гарантує, що під час поступових оновлень (rolling upgrades) не буде порушено політику розбіжності версій.
EtcdLearnerMode
Під час приєднання нового вузла панелі управління новий член etcd буде створений як учень (learner) і підвищений до члена з правом голосу лише після того, як дані etcd будуть повністю узгоджені.
IPv6DualStack
Цей прапорець допомагає налаштувати компоненти для подвійного стека, поки функція перебуває в розробці. Для отримання докладнішої інформації про підтримку подвійного стека в Kubernetes дивіться Підтримка подвійного стека за допомогою kubeadm.
NodeLocalCRISocket
З увімкненою функціональною можливістю kubeadm читатиме/записуватиме CRI-сокет для кожного вузла з/до файлу /var/lib/kubelet/instance-config.yaml замість того, щоб читати/записувати його з/до анотації kubeadm.alpha.kubernetes.io/cri-socket в обʼєкті Node. Новий файл застосовується як патч конфігурації екземпляра перед застосуванням будь-яких інших патчів, керованих користувачем, коли використовується прапорець --patches. Він містить єдине поле containerRuntimeEndpoint з формату файлу KubeletConfiguration. Якщо функціональну можливість увімкнено під час оновлення, але файл /var/lib/kubelet/instance-config.yaml ще не існує, kubeadm спробує прочитати значення CRI-сокета з файлу /var/lib/kubelet/kubeadm-flags.env.
PublicKeysECDSA
Можна використовувати для створення кластера, який використовує сертифікати ECDSA замість типового алгоритму RSA. Поновлення наявних сертифікатів ECDSA також підтримується за допомогою kubeadm certs renew, але ви не можете перемикатися між алгоритмами RSA і ECDSA на льоту або під час оновлень. У версіях Kubernetes до v1.31 була помилка, через яку ключі у згенерованих файлах kubeconfig використовували RSA, навіть якщо ви увімкнули функціональну можливість PublicKeysECDSA. Ця функціональна можливість застаріла на користь функціональності encryptionAlgorithm, доступної у kubeadm v1beta4.
UnversionedKubeletConfigMap
Цей прапорець керує назвою ConfigMap, в якому kubeadm зберігає дані конфігурації kubelet. Якщо цей прапорець не вказано або встановлено в true, ConfigMap називається kubelet-config. Якщо ви встановите цей прапорець у false, назва ConfigMap міститиме мажорну та мінорну версію Kubernetes (наприклад: kubelet-config-1.37). kubeadm забезпечує, що правила RBAC для читання та запису цього ConfigMap відповідають значенню, яке ви встановили. Коли kubeadm записує цей ConfigMap (під час kubeadm init або kubeadm upgrade apply), kubeadm враховує значення UnversionedKubeletConfigMap. Під час читання цього ConfigMap (під час kubeadm join, kubeadm reset, kubeadm upgrade...) kubeadm спочатку намагається використати назву ConfigMap без версії. Якщо це не вдається, kubeadm повертається до використання застарілої (версійної) назви для цього ConfigMap.
UpgradeAddonsBeforeControlPlane
Цю функціональну можливість було видалено. Її було представлено у v1.28 як застарілу функцію, а потім видалено у v1.31. Для документації щодо старіших версій, будь ласка, перейдіть на відповідну версію вебсайту.
WaitForAllControlPlaneComponents
З увімкненою функціональною можливістю kubeadm чекатиме, доки всі компоненти панелі управління (kube-apiserver, kube-controller-manager, kube-scheduler) на вузлі панелі управління не повідомлять про стан 200 на своїх точках доступу /livez або /healthz. Ці перевірки виконуються на https://ADDRESS:PORT/ENDPOINT.
PORT береться з --secure-port компонента.
ADDRESS — це --advertise-address для kube-apiserver та --bind-address для
kube-controller-manager та kube-scheduler.
ENDPOINT — це лише /healthz для kube-controller-manager, доки він також не підтримуватиме /livez.
Якщо ви вкажете власні ADDRESS або PORT у конфігурації kubeadm, їх буде враховано. Без увімкненої функціональної можливості kubeadm чекатиме лише на готовність kube-apiserver на вузлі панелі управління. Процес очікування починається одразу після того, як kubeadm запустить kubelet на хості. Рекомендується увімкнути цю функціональну можливість, якщо ви бажаєте спостерігати стан готовності всіх компонентів панелі управління під час виконання команд kubeadm init або kubeadm join.
Додавання параметрів kube-proxy
Для отримання інформації про параметри kube-proxy у конфігурації kubeadm дивіться:
Для запуску kubeadm без підключення до Інтернету необхідно попередньо завантажити потрібні образи панелі управління.
Ви можете отримати перелік та завантажити образи за допомогою підкоманди kubeadm config images:
kubeadm config images list
kubeadm config images pull
Ви можете передати --config вищенаведеним командам з файлом конфігурації kubeadm, щоб керувати полями kubernetesVersion та imageRepository.
Усі типові образи registry.k8s.io, необхідні kubeadm, підтримують кілька архітектур.
Використання власних образів
Типово kubeadm завантажує образи з registry.k8s.io. Якщо запитана версія Kubernetes є міткою CI (наприклад, ci/latest), використовується gcr.io/k8s-staging-ci-images.
Вказати kubernetesVersion, що впливає на версію образів.
Вказати альтернативний imageRepository, який буде використовуватися замість
registry.k8s.io.
Вказати конкретні imageRepository та imageTag для etcd або CoreDNS.
Шляхи образів у типовому registry.k8s.io та у власному репозиторії, вказаному за допомогою imageRepository, можуть відрізнятися з міркувань зворотної сумісності. Наприклад, образ може мати підшлях registry.k8s.io/subpath/image, але типово мати шлях my.customrepository.io/image під час використання власного репозиторію.
Щоб надіслати образи до вашого власного репозиторію за шляхами, які може використовувати kubeadm, вам потрібно:
Завантажити образи з типових шляхів у registry.k8s.io за допомогою kubeadm config images {list|pull}.
Надіслати образи за шляхами з kubeadm config images list --config=config.yaml,
де config.yaml містить власне значення imageRepository та/або imageTag для etcd та CoreDNS.
Передати той самий config.yaml до kubeadm init.
Власні образи sandbox (pause)
Щоб встановити для них власний образ, потрібно налаштувати ваше середовище виконання контейнерів на використання цього образу. Зверніться до документації вашого середовища виконання контейнерів, щоб дізнатися, як змінити це налаштування; для деяких середовищ виконання контейнерів ви також можете знайти поради у розділі Середовища виконання контейнерів.
Завантаження сертифікатів панелі управління до кластера
Додавши прапорець --upload-certs до kubeadm init, ви можете тимчасово завантажити сертифікати панелі управління до Secret у кластері. Зверніть увагу, що термін дії цього Secret автоматично спливе через 2 години. Сертифікати шифруються за допомогою 32-байтного ключа, який можна задати за допомогою --certificate-key. Той самий ключ можна використовувати для завантаження сертифікатів під час приєднання додаткових вузлів панелі управління, передавши --control-plane та --certificate-key до kubeadm join.
Для повторного завантаження сертифікатів після закінчення їхнього терміну дії можна використовувати таку команду фази:
Попередньо визначений certificateKey можна вказати в InitConfiguration під час передачі файлу конфігурації за допомогою --config.
Якщо попередньо визначений ключ сертифіката не передано до kubeadm init і
kubeadm init phase upload-certs, новий ключ буде згенеровано автоматично.
Для генерації нового ключа на вимогу можна використовувати таку команду:
kubeadm certs certificate-key
Управління сертифікатами за допомогою kubeadm
Докладну інформацію про управління сертифікатами за допомогою kubeadm дивіться в розділі Управління сертифікатами за допомогою kubeadm. Документ містить інформацію про використання зовнішнього центру сертифікації (CA), власних сертифікатів
та поновлення сертифікатів.
Керування drop-in файлом kubeadm для kubelet
Пакет kubeadm постачається з файлом конфігурації для запуску kubelet через systemd. Зауважте, що CLI kubeadm ніколи не торкається цього drop-in файлу. Цей drop-in файл є частиною DEB/RPM-пакунка kubeadm.
Типово kubeadm призначає імʼя вузла на основі адреси хоста машини. Ви можете змінити це налаштування за допомогою прапорця --node-name. Цей прапорець передає відповідне значення --hostname-override до kubelet.
Замість копіювання токена, який ви отримали з kubeadm init, на кожний вузол, як у базовому посібнику з kubeadm, ви можете розподіляти токен паралельно для полегшення автоматизації. Щоб реалізувати цю автоматизацію, вам потрібно знати IP-адресу, яку матиме вузол панелі управління після запуску, або використовувати DNS-імʼя чи адресу балансувальника навантаження.
Згенеруйте токен. Цей токен повинен мати форму <6 character string>.<16 character string>.
Формально він повинен відповідати регулярному виразу: [a-z0-9]{6}\.[a-z0-9]{16}.
kubeadm може згенерувати токен для вас:
kubeadm token generate
Запустіть одночасно вузол панелі управління та робочі вузли з цим токеном. Під час запуску вони мають знайти один одного та сформувати кластер. Той самий аргумент --token можна використовувати як у kubeadm init, так і у kubeadm join.
Аналогічно можна вчинити з --certificate-key під час приєднання додаткових вузлів панелі управління. Ключ можна згенерувати за допомогою:
kubeadm certs certificate-key
Щойно кластер запуститься, ви зможете використовувати файл /etc/kubernetes/admin.conf з вузла панелі управління для взаємодії з кластером з обліковими даними адміністратора або скористатися розділом Генерування файлів kubeconfig для додаткових користувачів.
Зауважте, що такий спосіб початкового розгортання має дещо послаблені гарантії безпеки, оскільки не дозволяє перевірити хеш кореневого CA за допомогою --discovery-token-ca-cert-hash (оскільки він не генерується під час підготовки вузлів). Докладніше дивіться в kubeadm join.
kubeadm join — щоб розгорнути робочий вузол
Kubernetes і приєднати його до кластера
kubeadm upgrade — щоб оновити кластер
Kubernetes до новішої версії
kubeadm reset — щоб скасувати будь-які зміни, внесені
на цьому хості командами kubeadm init або kubeadm join
12.3 - kubeadm join
Ця команда ініціалізує новий вузол Kubernetes і приєднує його до наявного кластера.
Запустіть цю команду на будь-якому компʼютері, який ви хочете приєднати до існуючого кластера
Опис
Під час приєднання до кластера, ініціалізованого kubeadm, необхідно встановити двосторонню довіру. Цей процес розділяється на виявлення (щоб Node довіряв панелі управління Kubernetes) та TLS bootstrap (щоб панель управління Kubernetes довіряла Node).
Існує 2 основні схеми виявлення. Перша — використовувати спільний токен разом з IP-адресою API-сервера. Друга — надати файл, який є підмножиною стандартного файлу kubeconfig. Файл discovery/kubeconfig підтримує токен, втулки автентифікації client-go ("exec"), "tokenFile" та "authProvider". Цей файл може бути локальним або завантаженим через HTTPS URL. Можливі форми: kubeadm join --discovery-token abcdef.1234567890abcdef 1.2.3.4:6443, kubeadm join --discovery-file path/to/file.conf або kubeadm join --discovery-file https://url/file.conf. Можна використовувати лише одну форму. Якщо інформація для виявлення завантажується з URL, обовʼязково використовувати HTTPS. Також у цьому випадку для перевірки зʼєднання використовується встановлений на хості набір сертифікатів CA.
Якщо ви використовуєте спільний токен для виявлення, слід також передати прапорець --discovery-token-ca-cert-hash для перевірки публічного ключа кореневого центру сертифікації (CA), наданого панеллю управління Kubernetes. Значення цього прапорця задається як "<hash-type>:<hex-encoded-value>", де підтримуваний тип хешу — "sha256". Хеш обчислюється по байтах обʼєкта Subject Public Key Info (SPKI) (як в RFC7469). Це значення доступне у виводі "kubeadm init" або може бути обчислене за допомогою стандартних інструментів. Прапорець --discovery-token-ca-cert-hash можна вказувати кілька разів, щоб дозволити більше одного публічного ключа.
Якщо ви не можете знати хеш публічного ключа CA заздалегідь, ви можете передати прапорець --discovery-token-unsafe-skip-ca-verification, щоб вимкнути цю перевірку. Це послаблює модель безпеки kubeadm, оскільки інші вузли потенційно можуть видавати себе за панель управління Kubernetes.
Механізм TLS bootstrap також працює через спільний токен. Він використовується для тимчасової автентифікації в панелі управління Kubernetes, щоб подати запит на підписання сертифіката (CSR) для локально створеної пари ключів. Типово kubeadm налаштовує панель управління Kubernetes на автоматичне схвалення цих запитів на підписання. Цей токен передається за допомогою прапорця --tls-bootstrap-token abcdef.1234567890abcdef.
Часто той самий токен використовується для обох частин. У цьому випадку замість окремого зазначення кожного токена можна використовувати прапорець --token.
Команда "join [api-server-endpoint]" виконує такі фази:
preflight Run join pre-flight checks
control-plane-prepare Prepare the machine for serving a control plane
/download-certs Download certificates shared among control-plane nodes from the kubeadm-certs Secret
/certs Generate the certificates for the new control plane components
/kubeconfig Generate the kubeconfig for the new control plane components
/control-plane Generate the manifests for the new control plane components
kubelet-start Write kubelet settings, certificates and (re)start the kubelet
etcd-join Join etcd for control plane nodes
kubelet-wait-bootstrap Wait for the kubelet to bootstrap itself
control-plane-join Join a machine as a control plane instance
/mark-control-plane Mark a node as a control-plane
wait-control-plane Wait for the control plane to start
kubeadm join [api-server-endpoint] [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для join
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--skip-phases strings
Список фаз, які потрібно пропустити
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Процес приєднання
kubeadm join ініціалізує робочий вузол Kubernetes або вузол панелі управління та додає його до кластера. Ця дія складається з наступних кроків для робочих вузлів:
kubeadm завантажує необхідну інформацію про кластер з API-сервера. Типово використовується токен bootstrap та хеш ключа CA для перевірки достовірності цих даних. Кореневий CA також може бути виявлений безпосередньо через файл або URL.
Як тільки інформація про кластер стає відомою, kubelet може розпочати процес TLS bootstrap.
TLS bootstrap використовує спільний токен для тимчасової автентифікації в API-сервері Kubernetes, щоб надіслати запит на підписання сертифіката (CSR); типово панель управління підписує цей CSR-запит автоматично.
Нарешті, kubeadm налаштовує локальний kubelet для підключення до API-сервера з остаточною ідентичністю, призначеною вузлу.
Для вузлів панелі управління виконуються додаткові кроки:
Завантаження з кластера сертифікатів, спільних для вузлів панелі управління (якщо це явно запитано користувачем).
Генерація маніфестів компонентів панелі управління, сертифікатів та kubeconfig.
Додавання нового локального члена etcd.
Використання фаз приєднання з kubeadm
Kubeadm дозволяє приєднати вузол до кластера фазами, використовуючи kubeadm join phase.
Щоб переглянути впорядкований список фаз та підфаз, можна викликати kubeadm join --help. Список буде розташований у верхній частині екрана довідки, і кожна фаза матиме опис поруч із нею. Зверніть увагу, що при виклику kubeadm join усі фази та підфази будуть виконані саме в цьому порядку.
Деякі фази мають унікальні прапорці, тому якщо ви хочете переглянути список доступних опцій, додайте --help, наприклад:
kubeadm join phase kubelet-start --help
Подібно до команди kubeadm init phase, команда kubeadm join phase дозволяє пропустити список фаз, використовуючи прапорець --skip-phases.
Крім того, ви можете використовувати поле skipPhases в JoinConfiguration.
Визначення, якому CA кластера довіряти
Процес виявлення kubeadm має кілька варіантів, кожен з яких має свої компроміси щодо безпеки. Правильний метод для вашого середовища залежить від того, як ви впроваджуєте вузли, та від ваших очікувань щодо безпеки вашої мережі та життєвого циклу вузлів.
Виявлення на основі токена з закріпленням CA
Це типовий режим у kubeadm. У цьому режимі kubeadm завантажує конфігурацію кластера (включаючи кореневий CA) та перевіряє її за допомогою токена, а також перевіряє, що відкритий ключ кореневого CA відповідає наданому хешу і що сертифікат API-сервера є дійсним відносно кореневого CA.
Хеш ключа CA має формат sha256:<hex_encoded_hash>. Типово значення хешу виводиться наприкінці роботи команди kubeadm init або у виводі команди kubeadm token create --print-join-command. Воно має стандартний формат (див. RFC7469) і також може бути обчислене сторонніми інструментами або системами розгортання. Наприклад, за допомогою OpenSSL CLI:
Ви також можете викликати join для вузла панелі управління з --certificate-key, щоб скопіювати сертифікати на цей вузол, якщо команда kubeadm init була викликана з --upload-certs.
Переваги:
Дозволяє вузлам початкового завантаження безпечно виявляти корінь довіри для вузла панелі управління, навіть якщо інші робочі вузли або мережа скомпрометовані.
Зручно виконувати вручну, оскільки вся необхідна інформація вміщується в одну команду kubeadm join.
Недоліки:
Хеш CA зазвичай не відомий до тих пір, поки вузол панелі управління не буде впроваджений, що може ускладнити створення автоматизованих інструментів впровадження, які використовують kubeadm. Генеруючи свій CA заздалегідь, ви можете обійти це обмеження.
Виявлення на основі токена без закріплення CA
Цей режим покладається лише на симетричний токен для підпису (HMAC-SHA256) інформації про виявлення, що встановлює корінь довіри для панелі управління. Щоб використовувати цей режим, вузли, що приєднуються, повинні пропустити перевірку хешу відкритого ключа CA, використовуючи --discovery-token-unsafe-skip-ca-verification. Якщо можливо, слід розглянути використання одного з інших режимів.
Токен можна створити заздалегідь і поділитися ним з вузлом панелі управління та робочими вузлами, які потім можуть проходити початкове завантаження паралельно без координації. Це дозволяє використовувати його в багатьох сценаріях розгортання.
Недоліки:
Якщо зловмисник зможе викрасти токен bootstrap через якусь уразливість, він зможе використати цей токен (разом з доступом на рівні мережі), щоб видавати себе за вузол панелі управління перед іншими вузлами початкового завантаження. Це може бути або не бути прийнятним компромісом у вашому середовищі.
Виявлення на основі файлів або HTTPS
Це забезпечує спосіб встановлення кореня довіри між вузлом панелі управління та вузлами початкового завантаження поза основним каналом (out-of-band). Розгляньте використання цього режиму, якщо ви створюєте автоматизоване розгортання за допомогою kubeadm. Формат файлу для виявлення — це звичайний файл Kubernetes kubeconfig.
Якщо файл для виявлення не містить облікових даних, буде використано токен виявлення TLS.
Дозволяє вузлам початкового завантаження безпечно виявляти корінь довіри для вузла панелі управління, навіть якщо мережа або інші робочі вузли скомпрометовані.
Недоліки:
Вимагає, щоб у вас був спосіб перенести інформацію про виявлення від вузла панелі управління до вузлів початкового завантаження. Якщо файл для виявлення містить облікові дані, ви повинні тримати його в секреті та передавати через захищений канал. Це можна зробити за допомогою вашого хмарного провайдера або інструменту розгортання.
Використання власних облікових даних kubelet з kubeadm join
Щоб дозволити kubeadm join використовувати заздалегідь визначені облікові дані kubelet і пропустити клієнтський TLS bootstrap та затвердження CSR для нового вузла:
На працюючому вузлі панелі управління в кластері, який має /etc/kubernetes/pki/ca.key, виконайте kubeadm kubeconfig user --org system:nodes --client-name system:node:$NODE > kubelet.conf. $NODE має бути встановлено на імʼя нового вузла.
Відредагуйте отриманий kubelet.conf вручну, щоб налаштувати імʼя кластера та точку доступу сервера, або запустіть kubeadm kubeconfig user --config (вона приймає InitConfiguration).
Типово увімкнено автоматичне затвердження CSR, яке по суті затверджує будь-який запит на клієнтський сертифікат для kubelet, якщо під час автентифікації використовувався токен bootstrap. Якщо ви не бажаєте, щоб кластер автоматично затверджував клієнтські сертифікати kubelet, ви можете вимкнути цю функцію, виконавши наступну команду:
Після цього команда kubeadm join буде блокуватися до тих пір, поки адміністратор вручну не затвердить поточний CSR:
За допомогою kubectl get csr ви можете побачити, що оригінальний CSR перебуває в стані Pending.
kubectl get csr
Результат буде подібним до такого:
NAME AGE REQUESTOR CONDITION
node-csr-c69HXe7aYcqkS1bKmH4faEnHAWxn6i2bHZ2mD04jZyQ 18s system:bootstrap:878f07 Pending
kubectl certificate approve дозволяє адміністратору затвердити CSR. Ця дія наказує контролеру підпису сертифікатів видати сертифікат запитувачеві з атрибутами, запитаними у CSR.
NAME AGE REQUESTOR CONDITION
node-csr-c69HXe7aYcqkS1bKmH4faEnHAWxn6i2bHZ2mD04jZyQ 1m system:bootstrap:878f07 Approved,Issued
Це змушує процес kubeadm join завершуватися успішно тільки у випадку, коли була виконана команда kubectl certificate approve.
Вимкнення загального доступу до ConfigMap cluster-info
Щоб забезпечити процес приєднання, в якому токен є єдиним елементом інформації для перевірки, типово у відкритий доступ викладається ConfigMap з деякими даними, необхідними для перевірки ідентичності вузла панелі управління. Хоча в цьому ConfigMap немає приватних даних, деякі користувачі можуть все одно бажати вимкнути цей доступ. Це призведе до втрати можливості використовувати прапорець --discovery-token у процесі kubeadm join. Ось кроки, як це зробити:
Отримайте файл cluster-info з API-сервера:
kubectl -n kube-public get cm cluster-info -o jsonpath='{.data.kubeconfig}'| tee cluster-info.yaml
Ці команди слід виконати після kubeadm init, але перед kubeadm join.
Використання kubeadm join з конфігураційним файлом
Увага:
Конфігураційний файл все ще вважається бета-версією і може змінюватися у майбутніх версіях.
Можна налаштувати kubeadm join, використовуючи конфігураційний файл замість прапорців командного рядка, і деякі більш розширені функції можуть бути доступні лише як опції конфігураційного файлу. Цей файл передається за допомогою прапорця --config і повинен містити структуру JoinConfiguration. У деяких випадках змішування --config з іншими прапорцями може бути недозволеним.
Якщо ваша конфігурація не використовує останню версію, рекомендується перейти на неї за допомогою команди kubeadm config migrate.
Для отримання додаткової інформації щодо полів та використання конфігурації ви можете перейти до нашого довідника API.
Що далі
kubeadm init для ініціалізації вузла панелі управління Kubernetes.
kubeadm token для управління токенами для kubeadm join.
kubeadm reset для скасування будь-яких змін, внесених на цьому хості командами kubeadm init або kubeadm join.
12.4 - kubeadm upgrade
kubeadm upgrade — це зручна команда, яка приховує складну логіку оновлення
за однією командою та підтримує як планування оновлення, так і його фактичне виконання.
Настанови щодо kubeadm upgrade
Кроки для виконання оновлення за допомогою kubeadm викладені в цьому документі.
Для старіших версій kubeadm зверніться до старіших наборів документації на сайті Kubernetes.
Ви можете використовувати kubeadm upgrade diff, щоб переглянути зміни, які буде застосовано до маніфестів статичних Podʼів.
У Kubernetes v1.15.0 і пізніших версіях kubeadm upgrade apply та kubeadm upgrade node також
автоматично поновлюють сертифікати, якими керує kubeadm, на цьому вузлі, включно з тими, що зберігаються у файлах kubeconfig.
Щоб відмовитися від цього, можна передати прапорець --certificate-renewal=false. Докладніше про поновлення
сертифікатів дивіться в документації з керування сертифікатами.
Примітка:
Команди kubeadm upgrade apply та kubeadm upgrade plan мають застарілий прапорець --config,
який дає змогу переналаштувати кластер під час планування або оновлення конкретного
вузла панелі управління. Зверніть увагу, що процес оновлення не розроблявся для такого сценарію, і є
повідомлення про неочікувані результати.
kubeadm upgrade plan
Опис
Перевіряє, до яких версій можна оновитися, і перевіряє, чи можна оновити ваш поточний кластер. Ця команда може бути виконана лише на вузлах панелі управління, де існує файл kubeconfig "admin.conf". Щоб пропустити перевірку Інтернету, вкажіть необовʼязковий параметр [version].
kubeadm upgrade plan [version] [flags]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--config string
Шлях до конфігураційного файлу kubeadm.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-h, --help
довідка для plan
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--print-config
Вказує, чи потрібно надрукувати файл конфігурації, який буде використаний під час оновлення.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm upgrade apply
Опис
Оновлює кластер Kubernetes до вказаної версії
Команда "apply [version]" виконує наступні фази:
preflight Run preflight checks before upgrade
control-plane Upgrade the control plane
upload-config Upload the kubeadm and kubelet configurations to ConfigMaps
/kubeadm Upload the kubeadm ClusterConfiguration to a ConfigMap
/kubelet Upload the kubelet configuration to a ConfigMap
kubelet-config Upgrade the kubelet configuration for this node
bootstrap-token Configures bootstrap token and cluster-info RBAC rules
addon Upgrade the default kubeadm addons
/coredns Upgrade the CoreDNS addon
/kube-proxy Upgrade the kube-proxy addon
post-upgrade Run post upgrade tasks
kubeadm upgrade apply [version]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-f, --force
Примусове оновлення, навіть якщо деякі вимоги можуть бути не виконані. Це також передбачає неінтерактивний режим.
-h, --help
довідка для apply
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--print-config
Вказує, чи потрібно надрукувати файл конфігурації, який буде використаний під час оновлення.
--skip-phases strings
Список фаз, які потрібно пропустити
-y, --yes
Виконати оновлення і не запитувати підтвердження (режим без взаємодії).
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm upgrade diff
Опис
Показує, які відмінності буде застосовано до наявних маніфестів статичних Podʼів. Дивіться також: kubeadm upgrade apply --dry-run
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm upgrade node
Опис
Команди upgrade для вузла в кластері
Команда "node" виконує наступні фази:
preflight Run upgrade node pre-flight checks
control-plane Upgrade the control plane instance deployed on this node, if any
kubelet-config Upgrade the kubelet configuration for this node
addon Upgrade the default kubeadm addons
/coredns Upgrade the CoreDNS addon
/kube-proxy Upgrade the kube-proxy addon
post-upgrade Run post upgrade tasks
kubeadm upgrade node [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
--etcd-upgrade Типово: true
Виконує оновлення etcd.
-h, --help
довідка для node
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--skip-phases strings
Список фаз, які потрібно пропустити
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm config, якщо ви ініціалізували свій кластер за допомогою kubeadm v1.7.x або старішої версії, щоб налаштувати кластер для kubeadm upgrade
12.5 - Фази kubeadm upgrade
kubeadm upgrade apply phase
За допомогою фаз kubeadm upgrade apply ви можете вибрати виконання окремих кроків початкового оновлення
вузла панелі управління.
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "apply"
kubeadm upgrade apply phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Запуск попередніх перевірок перед оновленням
kubeadm upgrade apply phase preflight [flags]
Параметри
--allow-experimental-upgrades
Показує нестабільні версії Kubernetes як альтернативу для оновлення і дозволяє оновлення до альфа/бета/кандидатів на випуск версій Kubernetes.
--allow-release-candidate-upgrades
Показує версії кандидатів на випуск Kubernetes як альтернативу для оновлення і дозволяє оновлювати до версій кандидатів на випуск Kubernetes.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
-f, --force
Примусове оновлення, навіть якщо деякі вимоги можуть бути не виконані. Це також передбачає неінтерактивний режим.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-y, --yes
Виконати оновлення і не запитувати підтвердження (режим без взаємодії).
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлення панелі управління
kubeadm upgrade apply phase control-plane [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Завантаження конфігурацій kubeadm та kubelet до ConfigMaps
kubeadm upgrade apply phase upload-config [flags]
Параметри
-h, --help
довідка для upload-config
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлює конфігурацію kubelet для цього вузла, завантажуючи її з ConfigMap kubelet-config, що зберігається в кластері
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Налаштовує токен bootstrap та правила cluster-info RBAC
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлює типові надбудови kubeadm
kubeadm upgrade apply phase addon [flags]
Параметри
-h, --help
довідка для addon
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Запуск завдань після оновлення
kubeadm upgrade apply phase post-upgrade [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести, які дії було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm upgrade node phase
За допомогою фаз kubeadm upgrade node ви можете вибрати виконання окремих кроків оновлення
вторинних вузлів панелі управління або робочих вузлів.
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "node"
kubeadm upgrade node phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Виконує попередні перевірки upgrade node
Опис
Виконує попередні перевірки для kubeadm upgrade node.
kubeadm upgrade node phase preflight [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлює екземпляр панелі управління, розгорнутий на цьому вузлі, якщо такий є
kubeadm upgrade node phase control-plane [flags]
Параметри
--certificate-renewal Типово: true
Виконує поновлення сертифікатів, що використовуються компонентами, які змінюються під час оновлень.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлює конфігурацію kubelet для цього вузла, завантажуючи її з ConfigMap kubelet-config, що зберігається в кластері
kubeadm upgrade node phase kubelet-config [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Оновлює типові надбудови kubeadm
kubeadm upgrade node phase addon [flags]
Параметри
-h, --help
довідка для addon
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Запуск завдань після оновлення
kubeadm upgrade node phase post-upgrade [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не змінювати жодного стану, лише вивести дії, які було б виконано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm init для розгортання вузла панелі управління Kubernetes
kubeadm alpha для випробування експериментальної функціональності
12.6 - kubeadm config
Під час виконання kubeadm init kubeadm вивантажує обʼєкт ClusterConfiguration у ваш кластер
у ConfigMap з назвою kubeadm-config у просторі імен kube-system. Потім ця конфігурація зчитується під час виконання
kubeadm join, kubeadm reset та kubeadm upgrade.
Ви можете використовувати kubeadm config print, щоб вивести типову статичну конфігурацію, яку kubeadm
використовує для kubeadm init і kubeadm join.
Примітка:
Вивід цієї команди призначений лише для прикладу. Ви повинні вручну відредагувати вивід
цієї команди, щоб адаптувати його до своїх налаштувань. Видаліть поля, щодо яких ви не впевнені, і kubeadm
спробує встановити для них типові значення під час виконання, аналізуючи хост.
Ви можете використовувати kubeadm config migrate для перетворення старих конфігураційних файлів, що містять застарілу
версію API, на новішу підтримувану версію API.
kubeadm config validate можна використовувати для перевірки конфігураційного файлу.
kubeadm config images list та kubeadm config images pull можна використовувати для виведення списку та завантаження образів,
необхідних kubeadm.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config print init-defaults
Виводить типову конфігурацію init, яку можна використовувати для 'kubeadm init'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація init, яка використовується для 'kubeadm init'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
kubeadm config print init-defaults [flags]
Параметри
--component-configs strings
Список обʼєктів API конфігурації компонентів через кому для виводу типових значень. Доступні значення: [KubeProxyConfiguration KubeletConfiguration]. Якщо цей прапорець не встановлено, конфігурації компонентів не буде надруковано.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config print join-defaults
Виводить типову конфігурацію join, яка може бути використана для 'kubeadm join'
Опис
Ця команда виводить обʼєкти, такі як типова конфігурація команди join, яка використовується для 'kubeadm join'.
Зверніть увагу, що конфіденційні значення, такі як поля Bootstrap Token, замінюються значеннями-заповнювачами, такими як "abcdef.0123456789abcdef", щоб пройти перевірку, але не виконувати реальні обчислення для створення токена.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config migrate
Зчитує стару версію типів API конфігурації kubeadm з файлу і виводить аналогічний обʼєкт конфігурації для новішої версії
Опис
Ця команда дозволяє конвертувати обʼєкти конфігурації старих версій у найновішу підтримувану версію локально в інструменті CLI, нічого не змінюючи в кластері.
У цій версії kubeadm підтримуються такі версії API:
kubeadm.k8s.io/v1beta4
Крім того, kubeadm може записувати конфігурацію лише версії "kubeadm.k8s.io/v1beta4", але читати обидва типи. Тож незалежно від того, яку версію ви передаєте тут параметру --old-config, обʼєкт API буде прочитано, десеріалізовано, заповнено типовими значеннями, конвертовано, валідовано та повторно серіалізовано під час запису у stdout або в --new-config, якщо його вказано.
Іншими словами, вихідні дані цієї команди — це те, що kubeadm фактично прочитав би внутрішньо, якби ви передали цей файл команді "kubeadm init"
kubeadm config migrate [flags]
Параметри
--allow-experimental-api
Дозволити міграцію на експериментальні, ще не випущені API.
-h, --help
довідка для migrate
--new-config string
Шлях до отриманого еквівалентного конфігураційного файлу kubeadm з використанням нової версії API. Необовʼязково, якщо не вказано, вивід буде надіслано у STDOUT.
--old-config string
Шлях до конфігураційного файлу kubeadm, який використовує стару версію API і який має бути конвертований. Цей прапорець є обовʼязковим.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config validate
Зчитує файл, що містить конфігураційний API kubeadm, і повідомляє про будь-які проблеми під час валідації
Опис
Ця команда дозволяє перевірити файл конфігурації API kubeadm та повідомити про будь-які попередження та помилки. Якщо помилок немає, код завершення буде нульовим, в іншому випадку він буде ненульовим. Будь-які проблеми з розбором, такі як невідомі поля API, спричинять помилки. Невідомі версії API та поля з недійсними значеннями також спричинять помилки. Про будь-які інші помилки або попередження може бути повідомлено залежно від вмісту вхідного файлу.
У цій версії kubeadm підтримуються такі версії API:
kubeadm.k8s.io/v1beta4
kubeadm config validate [flags]
Параметри
--allow-deprecated-api
Дозволяє валідацію застарілих API.
--allow-experimental-api
Дозволяє валідацію експериментальних, невипущених API.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config images list
Опис
Виводить список образів, які буде використовувати kubeadm. Файл конфігурації використовується у випадку налаштування будь-яких образів або сховищ образів
kubeadm config images list [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
--config string
Шлях до конфігураційного файлу kubeadm.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm config images pull
Опис
Завантажує образи, які використовує kubeadm
kubeadm config images pull [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm upgrade для оновлення кластера Kubernetes до новішої версії
12.7 - kubeadm reset
Виконує максимально можливий відкат змін, зроблених командами kubeadm init або kubeadm join.
Опис
Виконує максимально можливий відкат змін, зроблених на цьому хості командами 'kubeadm init' або 'kubeadm join'
Команда "reset" виконує наступні фази:
preflight Run reset pre-flight checks
remove-etcd-member Remove a local etcd member.
cleanup-node Run cleanup node.
kubeadm reset [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях до теки, де зберігаються сертифікати. Якщо вказано, очистити цю теку.
--cleanup-tmp-dir
Очистити теку "/etc/kubernetes/tmp"
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-f, --force
Виконати reset вузла без запиту на підтвердження.
-h, --help
довідка для reset
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--skip-phases strings
Список фаз, які потрібно пропустити
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Процес скидання
kubeadm reset відповідає за очищення локальної файлової системи вузла від файлів, створених за допомогою команд kubeadm init або kubeadm join. Для вузлів панелі управління reset також видаляє з кластера etcd локального члена stacked etcd цього вузла.
kubeadm reset phase можна використовувати для виконання окремих фаз наведеного вище процесу. Щоб пропустити список фаз, ви можете використовувати прапорець --skip-phases, який працює аналогічно до механізмів запуску фаз kubeadm join та kubeadm init.
kubeadm reset також підтримує прапорець --config для передачі структури ResetConfiguration.
Очищення зовнішніх членів etcd
kubeadm reset не видалить жодних даних etcd, якщо використовується зовнішній etcd. Це означає, що якщо ви знову виконаєте kubeadm init з використанням тих самих точок доступу etcd, ви побачите стан від попередніх кластерів.
Щоб видалити дані etcd, рекомендується використовувати клієнт, такий як etcdctl, наприклад:
Втулки CNI використовують теку /etc/cni/net.d для зберігання своїх конфігурацій. Команда kubeadm reset не очищує цю теку. Залишення конфігурації втулка CNI на хості може бути проблематичним, якщо той самий хост пізніше буде використано як новий вузол Kubernetes, а у цьому кластері буде розгорнуто інший втулок CNI. Це може призвести до конфлікту конфігурації між втулками CNI.
Щоб очистити теку, створіть резервну копію її вмісту, якщо потрібно, а потім виконайте наступну команду:
sudo rm -rf /etc/cni/net.d
Очищення правил мережевого трафіку
Команда kubeadm reset не очищує жодних правил iptables, nftables або IPVS, застосованих kube-proxy до хоста. Цикл контролю в kube-proxy гарантує, що правила на кожному вузлі будуть синхронізовані. Додаткові відомості наведено у статті Віртуальні IP-адреси та проксі-сервери Service.
Якщо залишити правила без очищення, не повинно виникнути жодних проблем, якщо хост пізніше буде повторно використано як вузол Kubernetes або якщо він слугуватиме для інших цілей.
Якщо ви бажаєте виконати таке очищення, ви можете використати той самий контейнер kube-proxy, який використовувався у вашому кластері, і прапорець --cleanup у бінарному файлі kube-proxy:
docker run --privileged --network=host -v /lib/modules:/lib/modules:ro --rm registry.k8s.io/kube-proxy:v1.37.0 sh -c "kube-proxy --cleanup && echo DONE"
Наприкінці виконання наведеної вище команди має бути виведено DONE. Замість Docker для запуску контейнера ви можете скористатися вашим улюбленим середовищем виконання контейнерів.
Очищення $HOME/.kube
Тека $HOME/.kube зазвичай містить конфігураційні файли та кеш kubectl. Хоча залишення вмісту $HOME/.kube/cache без очищення не є проблемою, у цій теці є один важливий файл. Це $HOME/.kube/config, і він використовується kubectl для автентифікації в API-сервері Kubernetes. Після завершення kubeadm init користувачеві пропонується скопіювати файл /etc/kubernetes/admin.conf у розташування $HOME/.kube/config і надати доступ до нього поточному користувачеві.
Команда kubeadm reset не очищує вміст теки $HOME/.kube. Залишення файлу $HOME/.kube/config без видалення може бути проблематичним, залежно від того, хто матиме доступ до цього хосту після виклику kubeadm reset. Якщо той самий кластер продовжує існувати, наполегливо рекомендуємо видалити цей файл, оскільки облікові дані адміністратора, що зберігаються в ньому, залишатимуться дійсними.
Щоб очистити теку, перегляньте її вміст, виконайте резервне копіювання, якщо потрібно, і виконайте наступну команду:
rm -rf $HOME/.kube
Коректне завершення роботи kube-apiserver
Якщо ваш kube-apiserver налаштований з прапорцем --shutdown-delay-duration, ви можете виконати наступні команди, щоб спробувати коректно завершити роботу запущеного Podʼа API-сервера, перед тим як виконати kubeadm reset:
yq eval -i '.spec.containers[0].command = []' /etc/kubernetes/manifests/kube-apiserver.yaml
timeout 60 sh -c 'while pgrep kube-apiserver >/dev/null; do sleep 1; done'||true
Що далі
kubeadm init для ініціалізації вузла панелі управління Kubernetes
kubeadm join для ініціалізації робочого вузла Kubernetes та приєднання його до кластера
12.8 - kubeadm token
Токени bootstrap використовуються для встановлення двосторонньої довіри між вузлом, що приєднується
до кластера, та вузлом панелі управління, як описано в розділі автентифікація за допомогою токенів bootstrap.
kubeadm init створює початковий токен з TTL 24 години. Наведені нижче команди дозволяють керувати
таким токеном, а також створювати нові токени та керувати ними.
kubeadm token create
Створює токени bootstrap на сервері
Опис
Ця команда створить для вас токен bootstrap. Ви можете вказати способи використання цього токена, "час життя" і необовʼязковий опис, зрозумілий людині.
[token] — це власне токен, який потрібно записати. Це має бути безпечно згенерований випадковий токен у форматі "[a-z0-9]{6}.[a-z0-9]{16}". Якщо [token] не вказано, kubeadm натомість згенерує випадковий токен.
kubeadm token create [token]
Параметри
--certificate-key string
Якщо використовується разом із '--print-join-command', виводить повний прапорець 'kubeadm join', необхідний для приєднання до кластера в ролі панелі управління. Щоб створити новий ключ сертифіката, потрібно використати 'kubeadm init phase upload-certs --upload-certs'.
--config string
Шлях до конфігураційного файлу kubeadm.
--description string
Зрозумілий для людини опис того, як використовується цей токен.
Додаткові групи, від імені яких цей токен автентифікуватиметься, коли його використовують для автентифікації. Має відповідати "\Asystem:bootstrappers:[a-z0-9:-]{0,255}[a-z0-9]\z"
-h, --help
довідка для create
--print-join-command
Замість того, щоб виводити тільки токен, вивести повний прапорець 'kubeadm join', необхідний для приєднання до кластера за допомогою токена.
--ttl duration Типово: 24h0m0s
Час до автоматичного видалення токена (наприклад, 1s, 2m, 3h). Якщо встановлено '0', термін дії токена ніколи не спливе
--usages strings Типово: "signing,authentication"
Описує способи, якими можна використовувати цей токен. Ви можете передавати --usages кілька разів або надати список параметрів через кому. Допустимі параметри: [signing,authentication]
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm token delete
Видаляє токени bootstrap на сервері
Опис
Ця команда видалить для вас список токенів bootstrap.
Значення [token-value] — це повний токен у вигляді "[a-z0-9]{6}.[a-z0-9]{16}" або Token ID виду "[a-z0-9]{6}", який потрібно видалити.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm token generate
Генерує та виводить токен bootstrap, але не створює його на сервері
Опис
Ця команда виведе випадково згенерований токен bootstrap, який можна використовувати з командами "init" та "join".
Ви не зобовʼязані використовувати цю команду для створення токена. Ви можете зробити це самостійно, якщо він має формат "[a-z0-9]{6}.[a-z0-9]{16}". Ця команда надається для зручності створення токенів у зазначеному форматі.
Ви також можете використовувати "kubeadm init" без вказання токена, і він буде згенерований та виведений для вас.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm token list
Виводить перелік токенів bootstrap на сервері
Опис
Ця команда виведе для вас перелік усіх токенів bootstrap.
kubeadm token list [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
-h, --help
довідка для list
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm join для розгортання робочого вузла Kubernetes і приєднання його до кластера
12.9 - kubeadm version
Ця команда виводить версію kubeadm.
Опис
Виводить версію kubeadm
kubeadm version [flags]
Параметри
-h, --help
довідка для version
-o, --output string
Формат виводу; доступні варіанти: 'yaml', 'json' та 'short'
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Набір операцій для роботи з сертифікатами Kubernetes.
Опис
Команди, повʼязані з обробкою сертифікатів Kubernetes
kubeadm certs [flags]
Параметри
-h, --help
довідка для certs
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm certs renew
Ви можете поновити всі сертифікати Kubernetes, використовуючи підкоманду all, або поновити їх вибірково.
Для отримання детальної інформації дивіться Ручне поновлення сертифікатів.
Опис
Поновлення сертифікатів для кластера Kubernetes
kubeadm certs renew [flags]
Параметри
-h, --help
довідка для renew
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Поновлення всіх доступних сертифікатів
Опис
Поновлює всі відомі сертифікати, необхідні для роботи панелі управління. Поновлення виконується безумовно, незалежно від дати закінчення терміну дії. Поновлення також можна виконувати окремо для більшого контролю.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання адміністратором і для самого kubeadm.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, який apiserver використовує для доступу до etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, який API-сервер використовує для підключення до kubelet.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат для обслуговування API Kubernetes.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання менеджером контролерів.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат для проб життєздатності для перевірки стану справності etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат для вузлів etcd, щоб вони могли взаємодіяти один з одним.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат для обслуговування etcd.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлення сертифіката клієнта front proxy.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для використання менеджером планувальника.
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Поновлює сертифікат, вбудований у файл kubeconfig для суперадміністратора (super-admin).
Поновлення виконується безумовно, незалежно від дати закінчення терміну дії сертифіката; додаткові атрибути, такі як SAN, будуть базуватися на наявних файлах/сертифікатах, нема потреби вказувати їх повторно.
Типово поновлення намагається використовувати центр сертифікації в локальному PKI, керованому kubeadm; як альтернативу можна використовувати API сертифікатів K8s для поновлення сертифікатів, або, як останній варіант, згенерувати CSR-запит.
Після поновлення, щоб зміни набули чинності, необхідно перезапустити компоненти панелі управління та, за потреби, повторно розповсюдити поновлений сертифікат, якщо файл використовується деінде.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm certs certificate-key
Цю команду можна використовувати для створення нового ключа сертифіката панелі управління.
Ключ можна передати як --certificate-key до kubeadm init
та kubeadm join,
щоб увімкнути автоматичне копіювання сертифікатів під час приєднання додаткових вузлів панелі управління.
Генерує ключі сертифікатів
Опис
Ця команда виведе захищений випадково згенерований ключ сертифіката, який можна використовувати з командою "init".
Ви також можете скористатися командою "kubeadm init --upload-certs" без зазначення ключа сертифіката, і вона згенерує і виведе його для вас.
kubeadm certs certificate-key [flags]
Параметри
-h, --help
довідка для certificate-key
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm certs check-expiration
Ця команда перевіряє термін дії сертифікатів у локальному PKI, яким керує kubeadm.
Для отримання детальної інформації дивіться
Перевірка терміну дії сертифікатів.
Перевіряє термін дії сертифікатів для кластера Kubernetes
Опис
Перевіряє термін дії сертифікатів у локальному PKI, яким керує kubeadm.
kubeadm certs check-expiration [flags]
Параметри
--allow-missing-template-keys Типово: true
Якщо true, ігнорувати будь-які помилки в шаблонах, коли поле або ключ map відсутні в шаблоні. Застосовується тільки до форматів виведення golang і jsonpath.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
-o, --output string Типово: "text"
Формат виводу. Один з: text|json|yaml|kyaml|go-template|go-template-file|template|templatefile|jsonpath|jsonpath-as-json|jsonpath-file.
--show-managed-fields
Якщо true, залишати managedFields при виведенні обʼєктів у форматі JSON або YAML.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm certs generate-csr
Цю команду можна використовувати для створення ключів і CSR для всіх сертифікатів панелі управління та файлів kubeconfig.
Після цього користувач може підписати CSR за допомогою центру сертифікації (CA) на свій вибір. Докладніше
про використання команди дивіться в розділі
Підписання запитів на підписання сертифікатів (CSR), створених kubeadm.
Генерує ключі та запити на підписання сертифікатів
Опис
Генерує ключі та запити на підписання сертифікатів (CSR) для всіх сертифікатів, необхідних для роботи панелі управління. Ця команда також генерує часткові файли kubeconfig з даними приватного ключа в полі "users > user > client-key-data", і для кожного файлу kubeconfig створюється супутній файл ".csr".
Ця команда призначена для використання в режимі зовнішнього CA kubeadm. Вона генерує CSR, які ви потім можете подати на підписання до вашого зовнішнього центру сертифікації.
Закодовані в PEM підписані сертифікати повинні бути збережені поруч з файлами ключів, використовуючи ".crt" як розширення файлу, або, у випадку з файлами kubeconfig, закодований в PEM підписаний сертифікат повинен бути закодований у base64 і доданий до файлу kubeconfig в полі "users > user > client-certificate-data".
kubeadm certs generate-csr [flags]
Приклади
# The following command will generate keys and CSRs for all control-plane certificates and kubeconfig files:
kubeadm certs generate-csr --kubeconfig-dir /tmp/etc-k8s --cert-dir /tmp/etc-k8s/pki
Параметри
--cert-dir string
Шлях, де будуть збережені сертифікати
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для generate-csr
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm init для розгортання вузла панелі управління Kubernetes
kubeadm reset для скасування будь-яких змін, внесених на цьому хості за допомогою kubeadm init або kubeadm join
12.11 - kubeadm init phase
kubeadm init phase дозволяє вам викликати атомарні кроки процесу початкового розгортання.
Таким чином, ви можете дозволити kubeadm виконати частину роботи, а самі заповнити прогалини,
якщо бажаєте застосувати власні налаштування.
kubeadm init phase узгоджується з процесом kubeadm init,
і за лаштунками обидва використовують той самий код.
kubeadm init phase preflight
Використовуючи цю команду, ви можете виконати попередні перевірки на вузлі панелі управління.
Опис
Виконує попередні перевірки для kubeadm init.
kubeadm init phase preflight [flags]
Приклади
# Run pre-flight checks for kubeadm init using a config file.
kubeadm init phase preflight --config kubeadm-config.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Вибрати реєстр контейнерів для завантаження образів панелі управління
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase certs
Може використовуватися для створення всіх сертифікатів, необхідних kubeadm.
Опис
Генерування сертифікатів
kubeadm init phase certs [flags]
Параметри
-h, --help
довідка для certs
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує всі сертифікати
kubeadm init phase certs all [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Використовуйте альтернативний домен для сервісів, наприклад, "myorg.internal".
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує самопідписаний центр сертифікації Kubernetes, щоб надати ідентифікатори для інших компонентів Kubernetes та зберігає їх у файлах ca.crt та ca.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs ca [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для ca
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує сертифікат для обслуговування API Kubernetes та зберігає його у файлах apiserver.crt та apiserver.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs apiserver [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-cert-extra-sans strings
Додаткові необовʼязкові альтернативні імена субʼєкта (SANs) для використання в сертифікаті обслуговування API-сервера. Можуть бути як IP-адреси, так і DNS-імена.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для apiserver
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для front-proxy-client
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує самопідписаний центр сертифікації (CA) для надання ідентифікаторів для etcd та зберігає його у файлах etcd/ca.crt та etcd/ca.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs etcd-ca [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-ca
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує сертифікати для обслуговування etcd, та зберігає їх у файлах etcd/server.crt та etcd/server.key.
Типові SANs: localhost, 127.0.0.1, 127.0.0.1, ::1
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs etcd-server [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-server
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує сертифікати для вузлів etcd для звʼязку між собою, та зберігає їх у файлах etcd/peer.crt та etcd/peer.key.
Типові SANs: localhost, 127.0.0.1, 127.0.0.1, ::1
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs etcd-peer [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-peer
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує сертифікат для проб життєздатності для перевірки справності etcd, та зберігає його у файлах etcd/healthcheck-client.crt та etcd/healthcheck-client.key.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для apiserver-etcd-client
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Генерує приватний ключ для підпису токенів службових облікових записів разом із його публічним ключем
Опис
Генерує приватний ключ для підпису токенів службових облікових записів разом із його публічним ключем та зберігає їх у файлах sa.key та sa.pub.
Якщо обидва файли вже існують, kubeadm пропускає крок генерації та використовує наявні файли.
kubeadm init phase certs sa [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для sa
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase kubeconfig
Ви можете створити всі необхідні файли kubeconfig, викликавши підкоманду all, або створювати їх окремо.
Опис
Генерує всі файли kubeconfig, необхідні для встановлення панелі управління, та файл kubeconfig адміністратора
kubeadm init phase kubeconfig [flags]
Параметри
-h, --help
довідка для kubeconfig
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує всі файли kubeconfig
kubeadm init phase kubeconfig all [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Генерує файл kubeconfig для використання адміністратором та для самого kubeadm
Опис
Генерує файл kubeconfig для адміністратора та для самого kubeadm і зберігає його у файл admin.conf.
kubeadm init phase kubeconfig admin [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для admin
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Генерує файл kubeconfig для використання kubelet лише для потреб початкового завантаження кластера
Опис
Генерує файл kubeconfig для використання kubelet та зберігає його у файл kubelet.conf.
Зауважте, що цей файл слід використовувати лише для потреб початкового завантаження кластера. Після запуску панелі управління слід запитувати всі облікові дані kubelet через CSR API.
kubeadm init phase kubeconfig kubelet [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubelet
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Генерує файл kubeconfig для використання менеджером контролерів
Опис
Генерує файл kubeconfig для використання менеджером контролерів та зберігає його у файл controller-manager.conf
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для controller-manager
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Генерує файл kubeconfig для використання планувальником
Опис
Генерує файл kubeconfig для використання планувальником та зберігає його у файл scheduler.conf.
kubeadm init phase kubeconfig scheduler [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для scheduler
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує файл kubeconfig для суперадміністратора та зберігає його у файл super-admin.conf.
kubeadm init phase kubeconfig super-admin [flags]
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для super-admin
--kubeconfig-dir string Типово: "/etc/kubernetes"
Шлях, де буде збережено файл kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase etcd
Використовуйте наступну фазу, щоб створити локальний екземпляр etcd на основі файлу статичного Podʼа.
Опис
Генерує файл маніфесту статичного Podʼа для локального etcd
kubeadm init phase etcd [flags]
Параметри
-h, --help
довідка для etcd
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує файл маніфесту статичного Podʼа для локального одновузлового екземпляра local etcd
kubeadm init phase etcd local [flags]
Приклади
# Generates the static Pod manifest file for etcd, functionally
# equivalent to what is generated by kubeadm init.
kubeadm init phase etcd local
# Generates the static Pod manifest file for etcd using options
# read from a configuration file.
kubeadm init phase etcd local --config config.yaml
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase control-plane
Використовуючи цю фазу, ви можете створити всі необхідні файли статичних Podʼів для компонентів панелі управління.
Опис
Генерує всі файли маніфестів статичних Podʼів, потрібні для створення панелі управління
kubeadm init phase control-plane [flags]
Параметри
-h, --help
довідка для control-plane
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує всі файли маніфестів статичних Podʼів
kubeadm init phase control-plane all [flags]
Приклади
# Generates all static Pod manifest files for control plane components,
# functionally equivalent to what is generated by kubeadm init.
kubeadm init phase control-plane all
# Generates all static Pod manifest files using options read from a configuration file.
kubeadm init phase control-plane all --config config.yaml
Параметри
--apiserver-advertise-address string
IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не встановлено, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Порт, до якого API-сервер буде привʼязуватися.
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane-endpoint string
Вказує стабільну IP-адресу або DNS-імʼя для панелі управління.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує маніфест статичного Podʼа для kube-apiserver
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує маніфест статичного Podʼа для kube-controller-manager
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує маніфест статичного Podʼа для kube-scheduler
Вибрати реєстр контейнерів для завантаження образів панелі управління
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase kubelet-start
Ця фаза запише файл конфігурації kubelet і файл змінних оточення, а потім запустить kubelet.
Записує налаштування kubelet та (пере)запускає kubelet
Опис
Записує файл з KubeletConfiguration та файл оточення з налаштуваннями kubelet для конкретного вузла, а потім (пере)запускає kubelet.
kubeadm init phase kubelet-start [flags]
Приклади
# Writes a dynamic environment file with kubelet flags from a InitConfiguration file.
kubeadm init phase kubelet-start --config config.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Вибрати реєстр контейнерів для завантаження образів панелі управління
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase wait-control-plane
У цій фазі kubeadm чекатиме, доки не запустяться компоненти панелі управління.
Опис
Очікує запуску панелі управління
kubeadm init phase wait-control-plane [flags]
Параметри
-h, --help
довідка для wait-control-plane
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase upload-config
За допомогою цієї команди ви можете завантажити конфігурацію kubeadm до вашого кластера.
Також ви можете скористатися kubeadm config.
Опис
Завантажує конфігурації kubeadm та kubelet у ConfigMap
kubeadm init phase upload-config [flags]
Параметри
-h, --help
довідка для upload-config
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Завантажує всю конфігурацію в ConfigMap
kubeadm init phase upload-config all [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Завантажує ClusterConfiguration kubeadm до ConfigMap з назвою kubeadm-config у просторі імен kube-system. Це забезпечує правильну конфігурацію системних компонентів і безпроблемну роботу користувачів під час оновлення.
Альтернативно, ви можете використовувати kubeadm config.
kubeadm init phase upload-config kubeadm [flags]
Приклади
# upload the configuration of your cluster
kubeadm init phase upload-config kubeadm --config=myConfig.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Завантажує конфігурацію компонента kubelet у ConfigMap
Опис
Завантажує конфігурацію kubelet, видобуту з обʼєкта kubeadm InitConfiguration, до ConfigMap kubelet-config у кластері
kubeadm init phase upload-config kubelet [flags]
Приклади
# Upload the kubelet configuration from the kubeadm Config file to a ConfigMap in the cluster.
kubeadm init phase upload-config kubelet --config kubeadm.yaml
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase upload-certs
Використовуйте наступну фазу, щоб завантажити сертифікати панелі управління до кластера.
Типово термін дії сертифікатів і ключа шифрування спливає через дві години.
Завантажує сертифікати до kubeadm-certs
Опис
Завантажує сертифікати панелі управління в Secret kubeadm-certs
kubeadm init phase upload-certs [flags]
Параметри
--certificate-key string
Ключ, що використовується для шифрування сертифікатів панелі управління у Secret kubeadm-certs. Ключ сертифіката — це шістнадцятковий рядок, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--skip-certificate-key-print
Не виводити ключ, який використовується для шифрування сертифікатів панелі управління.
--upload-certs
Завантажити сертифікати панелі управління у Secret kubeadm-certs.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase mark-control-plane
Використовуйте наступну фазу, щоб додати до вузла мітки та taint вузла панелі управління.
Опис
Позначає вузол як вузол панелі управління
kubeadm init phase mark-control-plane [flags]
Приклади
# Applies control-plane label and taint to the current node, functionally equivalent to what executed by kubeadm init.
kubeadm init phase mark-control-plane --config config.yaml
# Applies control-plane label and taint to a specific node
kubeadm init phase mark-control-plane --node-name myNode
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для mark-control-plane
--node-name string
Вкажіть імʼя вузла.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase bootstrap-token
Використовуйте наступну фазу для налаштування токенів bootstrap.
Генерує токени bootstrap, які використовуються для приєднання вузла до кластера
Опис
Токени bootstrap використовуються для встановлення двосторонньої довіри між вузлом, що приєднується до кластера, і вузлом панелі управління.
Ця команда виконує всі налаштування, необхідні для роботи токенів bootstrap, а потім створює початковий токен.
kubeadm init phase bootstrap-token [flags]
Приклади
# Make all the bootstrap token configurations and create an initial token, functionally
# equivalent to what generated by kubeadm init.
kubeadm init phase bootstrap-token
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase kubelet-finalize
Використовуйте наступну фазу для оновлення налаштувань kubelet після TLS
bootstrap. Ви можете використати підкоманду all, щоб запустити всі фази
kubelet-finalize.
Опис
Оновлює налаштування, що стосуються kubelet, після TLS bootstrap
kubeadm init phase kubelet-finalize [flags]
Приклади
# Updates settings relevant to the kubelet after TLS bootstrap
kubeadm init phase kubelet-finalize all --config
Параметри
-h, --help
довідка для kubelet-finalize
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Запускає всі фази kubelet-finalize
kubeadm init phase kubelet-finalize all [flags]
Приклади
# Updates settings relevant to the kubelet after TLS bootstrap
kubeadm init phase kubelet-finalize all --config
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях для збереження та зберігання сертифікатів.
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для enable-client-cert-rotation
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase bootstrap-token
Використовуйте наступну фазу для налаштування токенів bootstrap.
Генерує токени bootstrap, які використовуються для приєднання вузла до кластера
Опис
Токени bootstrap використовуються для встановлення двосторонньої довіри між вузлом, що приєднується до кластера, і вузлом панелі управління.
Ця команда виконує всі налаштування, необхідні для роботи токенів bootstrap, а потім створює початковий токен.
kubeadm init phase bootstrap-token [flags]
Приклади
# Make all the bootstrap token configurations and create an initial token, functionally
# equivalent to what generated by kubeadm init.
kubeadm init phase bootstrap-token
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Використовуйте альтернативний домен для сервісів, наприклад, "myorg.internal".
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Встановлює надбудову CoreDNS в кластер Kubernetes
Опис
Встановлює компоненти надбудови CoreDNS через API-сервер. Зверніть увагу, що хоча DNS-сервер розгорнуто, його не буде заплановано, доки не буде встановлено CNI.
kubeadm init phase addon coredns [flags]
Параметри
--config string
Шлях до конфігураційного файлу kubeadm.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
--feature-gates string
Набір пар ключ=значення, що описують функціональні можливості для різних функцій. Варіанти: RootlessControlPlane=true|false (ALPHA - default=false)
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--print-manifest
Вивести маніфести надбудов в STDOUT замість їх встановлення
--service-cidr string Типово: "10.96.0.0/12"
Використовуйте альтернативний діапазон IP-адрес для VIP сервісів.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
--kubernetes-version string Типово: "stable-1"
Вибрати конкретну версію Kubernetes для панелі управління.
--pod-network-cidr string
Вкажіть діапазон IP-адрес для мережі Podʼів. Якщо встановлено, панель управління автоматично виділить CIDR для кожного вузла.
--print-manifest
Вивести маніфести надбудов в STDOUT замість їх встановлення
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm init phase show-join-command
Показує команду, яку можна використовувати з kubeadm join.
Опис
Показує команду join для вузла панелі управління та робочого вузла
kubeadm init phase show-join-command [flags]
Параметри
-h, --help
довідка для show-join-command
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Докладніше про кожне поле конфігурації v1beta4 можна дізнатися на наших
сторінках довідки API.
Що далі
kubeadm init — щоб розгорнути вузол панелі управління Kubernetes
kubeadm reset — щоб скасувати будь-які зміни, внесені на цьому хості командами kubeadm init або kubeadm join
kubeadm alpha — щоб випробувати експериментальну функціональність
12.12 - kubeadm join phase
kubeadm join phase дозволяє викликати атомарні кроки процесу приєднання. Таким чином, ви можете дозволити kubeadm виконати частину роботи, а ви заповните прогалини, якщо захочете застосувати налаштування.
kubeadm join phase узгоджується з процесом приєднання kubeadm, і за лаштунками обидва використовують той самий код.
kubeadm join phase
Опис
Використовуйте цю команду для виклику однієї фази робочого процесу "join"
kubeadm join phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm join phase preflight
Використовуючи цю фазу, ви можете виконати попередні перевірки на вузлі, що приєднується.
# Run join pre-flight checks using a config file.
kubeadm join phase preflight --config kubeadm-config.yaml
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
--node-name string
Вкажіть імʼя вузла.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm join phase control-plane-prepare
Використовуючи цю фазу, ви можете підготувати вузол до обслуговування панелі управління.
Опис
Готує машину до обслуговування панелі управління
kubeadm join phase control-plane-prepare [flags]
Приклади
# Prepares the machine for serving a control plane
kubeadm join phase control-plane-prepare all
Параметри
-h, --help
довідка для control-plane-prepare
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Готує машину до обслуговування панелі управління
kubeadm join phase control-plane-prepare all [api-server-endpoint] [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--certificate-key string
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Завантажує сертифікати, спільні для вузлів панелі управління, з Secret kubeadm-certs
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для download-certs
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує сертифікати для нових компонентів панелі управління
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для certs
--node-name string
Вкажіть імʼя вузла.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує kubeconfig для нових компонентів панелі управління
Використовуйте цей ключ для розшифрування секретів сертифікатів, завантажених init. Ключ сертифіката — це рядок у шістнадцятковому кодуванні, який є ключем AES розміром 32 байти.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubeconfig
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Генерує маніфести для нових компонентів панелі управління
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--apiserver-bind-port int32 Типово: 6443
Якщо вузол має розміщувати новий екземпляр панелі управління, порт, до якого привʼязуватиметься API-сервер.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для control-plane
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm join phase kubelet-start
Використовуючи цю фазу, ви можете записати налаштування kubelet, сертифікати та (пере)запустити kubelet.
Записує налаштування kubelet, сертифікати та (пере)запускає kubelet
Опис
Записує файл з KubeletConfiguration та файл оточення з налаштуваннями kubelet для конкретного вузла, а потім (пере)запускає kubelet.
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--discovery-file string
Для виявлення на основі файлу, файл або URL, з якого буде завантажена інформація про кластер.
--discovery-token string
Для виявлення на основі токена, токен, який використовується для перевірки інформації про кластер, отриманої з API-сервера.
--discovery-token-ca-cert-hash strings
Для виявлення на основі токена, перевірити, що публічний ключ кореневого центру сертифікації відповідає цьому хешу (формат: "<type>:<value>").
--discovery-token-unsafe-skip-ca-verification
Для виявлення на основі токена, дозволити приєднання без закріплення --discovery-token-ca-cert-hash.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для kubelet-start
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
--tls-bootstrap-token string
Вкажіть токен, який використовується для тимчасової автентифікації в панелі управління Kubernetes під час приєднання вузла.
--token string
Використовуйте цей токен для discovery-token та tls-bootstrap-token, коли ці значення не вказані.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm join phase etcd-join
Приєднання нового члена etcd до кластера etcd.
Опис
Приєднує etcd для вузлів панелі управління
kubeadm join phase etcd-join [flags]
Приклади
# Joins etcd for a control plane instance
kubeadm join phase control-plane-join-etcd all
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для etcd-join
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm join phase control-plane-join
Використовуючи цю фазу, ви можете приєднати вузол як екземпляр панелі управління.
Опис
Приєднує машину як екземпляр панелі управління
kubeadm join phase control-plane-join [flags]
Приклади
# Joins a machine as a control plane instance
kubeadm join phase control-plane-join all
Параметри
-h, --help
довідка для control-plane-join
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Опис
Приєднує машину як екземпляр панелі управління
kubeadm join phase control-plane-join all [flags]
Параметри
--apiserver-advertise-address string
Якщо вузол має розміщувати новий екземпляр панелі управління, IP-адреса, яку API-сервер оголошуватиме як адресу, на якій він слухає. Якщо не вказано, буде використано типовий мережевий інтерфейс.
--config string
Шлях до конфігураційного файлу kubeadm.
--control-plane
Створити новий екземпляр панелі управління на цьому вузлі
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для all
--node-name string
Вкажіть імʼя вузла.
--patches string
Шлях до теки, що містить файли з іменами "target[suffix][+patchtype].extension". Наприклад, "kube-apiserver0+merge.yaml" або просто "etcd.json". "target" може бути одним з "kube-apiserver", "kube-controller-manager", "kube-scheduler", "etcd", "kubeletconfiguration", "corednsdeployment", "kubeproxydaemonset". "patchtype" може бути одним з "strategic", "merge" або "json", і вони відповідають форматам патчів, що підтримуються kubectl. Типовим "patchtype" є "strategic". "extension" повинен бути або "json", або "yaml". "suffix" є необовʼязковим рядком, який можна використовувати для визначення, які патчі застосовуються першими за алфавітно-цифровим порядком.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm kubeconfig user
За допомогою цієї команди можна вивести файл kubeconfig для додаткового користувача.
Опис
Виводить файл kubeconfig для додаткового користувача.
kubeadm kubeconfig user [flags]
Приклади
# Output a kubeconfig file for an additional user named foo
kubeadm kubeconfig user --client-name=foo
# Output a kubeconfig file for an additional user named foo using a kubeadm config file bar
kubeadm kubeconfig user --client-name=foo --config=bar
Параметри
--client-name string
Імʼя користувача. Буде використовуватися як CN у разі створення клієнтських сертифікатів
--config string
Шлях до конфігураційного файлу kubeadm.
-h, --help
довідка для user
--org strings
Організації сертифіката клієнта. Буде використовуватися як O, якщо будуть створені клієнтські сертифікати
--token string
Токен, який слід використовувати як механізм автентифікації для цього kubeconfig замість клієнтських сертифікатів
--validity-period duration Типово: 8760h0m0s
Термін дії клієнтського сертифіката. Відраховується від поточного часу.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
12.14 - kubeadm reset phase
kubeadm reset phase дозволяє вам викликати атомарні кроки процесу скидання вузла. Таким чином, ви можете дозволити kubeadm виконати частину роботи, а ви заповните прогалини, якщо захочете застосувати налаштування.
kubeadm reset phase узгоджується з процесом скидання kubeadm, і за лаштунками обидва використовують той самий код.
kubeadm reset phase
Опис
Використовуйте цю команду для виклику однієї фази процесу "reset"
kubeadm reset phase [flags]
Параметри
-h, --help
довідка для phase
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm reset phase preflight
За допомогою цієї фази ви можете виконати попередні перевірки на вузлі, який скидається.
Виконує попередні перевірки reset
Опис
Виконує попередні перевірки для kubeadm reset.
kubeadm reset phase preflight [flags]
Параметри
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-f, --force
Виконати reset вузла без запиту на підтвердження.
-h, --help
довідка для preflight
--ignore-preflight-errors strings
Список перевірок, помилки яких будуть показані як попередження. Приклад: 'IsPrivilegedUser,Swap'. Значення 'all' ігнорує помилки всіх перевірок.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm reset phase remove-etcd-member
За допомогою цієї фази ви можете вилучити члена etcd цього вузла панелі управління з кластера etcd.
Опис
Видаляє локального учасника etcd для вузла панелі управління.
kubeadm reset phase remove-etcd-member [flags]
Параметри
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
Файл kubeconfig, який використовується для спілкування з кластером. Якщо прапорець не встановлено, може бути переглянутий набір стандартних місць для пошуку наявного файлу kubeconfig.
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
kubeadm reset phase cleanup-node
За допомогою цієї фази ви можете виконати очищення на цьому вузлі.
Опис
Запускає очищення вузла.
kubeadm reset phase cleanup-node [flags]
Параметри
--cert-dir string Типово: "/etc/kubernetes/pki"
Шлях до теки, де зберігаються сертифікати. Якщо вказано, очистити цю теку.
--cleanup-tmp-dir
Очистити теку "/etc/kubernetes/tmp"
--cri-socket string
Шлях до сокета CRI для підключення. Якщо порожньо, kubeadm спробує автоматично визначити це значення; використовуйте цей параметр лише якщо у вас встановлено більше одного CRI або якщо у вас нестандартний сокет CRI.
--dry-run
Не застосовувати жодних змін; лише вивести, що було б зроблено.
-h, --help
довідка для cleanup-node
Параметри, успадковані від батьківських команд
--rootfs string
Шлях до 'справжньої' кореневої файлової системи хоста. Це змусить kubeadm виконати chroot у вказаний шлях.
Що далі
kubeadm init для ініціалізації вузла панелі управління Kubernetes
kubeadm reset для скасування будь-яких змін, внесених на цьому хості командами kubeadm init або kubeadm join
kubeadm alpha для випробування експериментальних функцій
13 - Інструмент командного рядка (kubectl)
Kubernetes надає інструмент командного рядка для взаємодії з панеллю управління кластера Kubernetes за допомогою API Kubernetes.
Цей інструмент має назву kubectl.
Для отримання налаштувань kubectl шукає файл config в теці $HOME/.kube. Ви можете вказати інший файл kubeconfig у змінній середовища KUBECONFIG або за допомогою прапорця --kubeconfig.
Цей огляд охоплює синтаксис kubectl, описує операції команд і містить поширені приклади. Докладніше про кожну команду, включаючи всі підтримувані прапорці та субкоманди, див. довідкову документацію kubectl.
Використовуйте такий синтаксис для виконання команд kubectl у вашому терміналі:
kubectl [command][TYPE][NAME][flags]
де command, TYPE, NAME та flags визначаються так:
command: Вказує операцію, яку ви хочете виконати з одним чи кількома ресурсами, наприклад create, get, describe, delete.
TYPE: Вказує тип ресурсу. Типи ресурсів нечутливі до регістру, і можна вказувати форми однини, множини чи абревіатури. Наприклад, такі команди виводять той самий результат:
kubectl get pod pod1
kubectl get pods pod1
kubectl get po pod1
NAME: Вказує імʼя ресурсу. Імена чутливі до регістру. Якщо імʼя пропущено, виводяться деталі для всіх ресурсів, наприклад kubectl get pods.
Під час виконання операції над кількома ресурсами можна вказати кожен ресурс за типом та іменем або вказати один чи кілька файлів:
Щоб вказати ресурси за типом та іменем:
Щоб групувати ресурси, якщо всі вони одного типу: TYPE1 name1 name2 name<#>.
Приклад: kubectl get pod example-pod1 example-pod2.
Щоб вказати кілька типів ресурсів окремо: TYPE1/name1 TYPE1/name2 TYPE2/name3 TYPE<#>/name<#>.
Приклад: kubectl get pod/example-pod1 replicationcontroller/example-rc1.
Щоб вказати ресурси за допомогою одного чи кількох файлів: -f file1 -f file2 -f file<#>.
Використовуйте YAML замість JSON, оскільки YAML зазвичай є зручнішим для користувача, особливо для файлів конфігурації.
Приклад: kubectl get -f ./pod.yaml
flags: Вказує необовʼязкові прапорці. Наприклад, ви можете використовувати прапорці -s або --server, щоб вказати адресу та порт API-сервера Kubernetes.
Увага:
Прапорці, які ви вказуєте в командному рядку, перевизначають типові значення та будь-які відповідні змінні середовища.
Якщо вам потрібна допомога, виконайте команду kubectl help у вікні термінала.
Автентифікація та перевизначення простору імен в кластері
Типово kubectl спочатку визначатиме, чи він виконується всередині Podʼа, і отже, в кластері. Програма починає з перевірки наявності змінних середовища KUBERNETES_SERVICE_HOST та KUBERNETES_SERVICE_PORT, а також наявності файлу токена службового облікового запису за шляхом /var/run/secrets/kubernetes.io/serviceaccount/token. Якщо всі три умови виконуються, вважається, що використовується автентифікація в кластері.
Для забезпечення зворотної сумісності, якщо під час автентифікації в кластері встановлено змінну середовища POD_NAMESPACE, вона перевизначить типовий простір імен, взятий з токена службового облікового запису. Це буде впливати на будь-які маніфести або інструменти, які покладаються на типовий простір імен.
Змінна середовища POD_NAMESPACE
Якщо змінна середовища POD_NAMESPACE встановлена, операції CLI для ресурсів з обмеженим простором імен будуть отримувати типове значення від цієї змінної. Наприклад, якщо значення змінної — seattle, kubectl get pods поверне Podʼи з простору імен seattle. Це тому, що Podʼи є ресурсом обмеженим простором імен, а в команді простір імен не вказано. Ознайомтесь з виводом kubectl api-resources, щоб визначити, чи ресурс обмежений простором імен чи ні.
Явне використання --namespace <value> перевизначає цю поведінку.
Як kubectl обробляє токени ServiceAccount
Якщо:
маємо файл токена службового облікового запису Kubernetes, змонтований за шляхом /var/run/secrets/kubernetes.io/serviceaccount/token, і
встановлено змінну середовища KUBERNETES_SERVICE_HOST, і
встановлено змінну середовища KUBERNETES_SERVICE_PORT, і
ви не вказуєте простір імен явно в командному рядку kubectl
тоді kubectl вважатиме, що він працює у вашому кластері. Інструмент kubectl знаходить простір імен цього ServiceAccount (це такий самий простір імен, що й у Podʼа) та діє відповідно до цього простору імен. Це відрізняється від того, що відбувається поза кластером; коли kubectl працює за межами кластера і ви не вказуєте простір імен, команда kubectl діє в просторі імен, встановленому для поточного контексту у вашій конфігурації клієнта. Щоб змінити типовий простір імен для kubectl, ви можете використовувати таку команду:
Отримати документацію про різні ресурси, такі як Podʼи, вузли, сервіси і т. д.
expose
kubectl expose (-f FILENAME | TYPE NAME | TYPE/NAME) [--port=port] [--protocol=TCP|UDP] [--target-port=number-or-name] [--name=name] [--external-ip=external-ip-of-service] [--type=type] [flags]
Надати доступ ззовні до контролера реплікації, Service або Pod як до нового Service Kubernetes.
get
kubectl get (-f FILENAME | TYPE [NAME | /NAME | -l label]) [--watch] [--sort-by=FIELD] [[-o | --output]=OUTPUT_FORMAT] [flags]
Вивести список ресурсів.
kustomize
kubectl kustomize <dir> [flags] [options]
Вивести список ресурсів API, згенерованих з інструкцій у файлі kustomization.yaml. Аргумент повинен бути шляхом до теки, що містить файл, або URL репозиторію git з суфіксом шляху, який вказує на те ж саме відносно кореня репозиторію.
label
kubectl label (-f FILENAME | TYPE NAME | TYPE/NAME) KEY_1=VAL_1 ... KEY_N=VAL_N [--overwrite] [--all] [--resource-version=version] [flags]
Додати або оновити мітки одного чи кількох ресурсів.
logs
kubectl logs POD [-c CONTAINER] [--follow] [flags]
Вивести логи контейнера у Podʼі.
options
kubectl options
Список глобальних параметрів командного рядка, які застосовуються до всіх команд.
patch
kubectl patch (-f FILENAME | TYPE NAME | TYPE/NAME) --patch PATCH [flags]
Оновити одне чи кілька полів ресурсу за допомогою процесу strategic merge patch.
plugin
kubectl plugin [flags] [options]
Надає інструменти для взаємодії з втулками.
port-forward
kubectl port-forward POD [LOCAL_PORT:]REMOTE_PORT [...[LOCAL_PORT_N:]REMOTE_PORT_N] [flags]
Переспрямувати один або кілька локальних портів у Pod.
Експериментально: чекати на певний стан одного чи кількох ресурсів.
Щоб дізнатися більше про операції, що виконують команди, див. довідку kubectl.
Типи ресурсів
У наступній таблиці наведено список всіх підтримуваних типів ресурсів та їхніх скорочених псевдонімів.
(Цей вивід можна отримати за допомогою kubectl api-resources, він був актуальним на момент Kubernetes 1.25.0)
ІМʼЯ
СКОРОЧЕННЯ
ВЕРСІЯ API
ПРОСТІР ІМЕН
ТИП
bindings
v1
true
Binding
componentstatuses
cs
v1
false
ComponentStatus
configmaps
cm
v1
true
ConfigMap
endpoints
ep
v1
true
Endpoints
events
ev
v1
true
Event
limitranges
limits
v1
true
LimitRange
namespaces
ns
v1
false
Namespace
nodes
no
v1
false
Node
persistentvolumeclaims
pvc
v1
true
PersistentVolumeClaim
persistentvolumes
pv
v1
false
PersistentVolume
pods
po
v1
true
Pod
podtemplates
v1
true
PodTemplate
replicationcontrollers
rc
v1
true
ReplicationController
resourcequotas
quota
v1
true
ResourceQuota
secrets
v1
true
Secret
serviceaccounts
sa
v1
true
ServiceAccount
services
svc
v1
true
Service
mutatingwebhookconfigurations
admissionregistration.k8s.io/v1
false
MutatingWebhookConfiguration
validatingwebhookconfigurations
admissionregistration.k8s.io/v1
false
ValidatingWebhookConfiguration
customresourcedefinitions
crd,crds
apiextensions.k8s.io/v1
false
CustomResourceDefinition
apiservices
apiregistration.k8s.io/v1
false
APIService
controllerrevisions
apps/v1
true
ControllerRevision
daemonsets
ds
apps/v1
true
DaemonSet
deployments
deploy
apps/v1
true
Deployment
replicasets
rs
apps/v1
true
ReplicaSet
statefulsets
sts
apps/v1
true
StatefulSet
tokenreviews
authentication.k8s.io/v1
false
TokenReview
localsubjectaccessreviews
authorization.k8s.io/v1
true
LocalSubjectAccessReview
selfsubjectaccessreviews
authorization.k8s.io/v1
false
SelfSubjectAccessReview
selfsubjectrulesreviews
authorization.k8s.io/v1
false
SelfSubjectRulesReview
subjectaccessreviews
authorization.k8s.io/v1
false
SubjectAccessReview
horizontalpodautoscalers
hpa
autoscaling/v2
true
HorizontalPodAutoscaler
cronjobs
cj
batch/v1
true
CronJob
jobs
batch/v1
true
Job
certificatesigningrequests
csr
certificates.k8s.io/v1
false
CertificateSigningRequest
leases
coordination.k8s.io/v1
true
Lease
endpointslices
discovery.k8s.io/v1
true
EndpointSlice
events
ev
events.k8s.io/v1
true
Event
flowschemas
flowcontrol.apiserver.k8s.io/v1beta2
false
FlowSchema
prioritylevelconfigurations
flowcontrol.apiserver.k8s.io/v1beta2
false
PriorityLevelConfiguration
ingressclasses
networking.k8s.io/v1
false
IngressClass
ingresses
ing
networking.k8s.io/v1
true
Ingress
networkpolicies
netpol
networking.k8s.io/v1
true
NetworkPolicy
runtimeclasses
node.k8s.io/v1
false
RuntimeClass
poddisruptionbudgets
pdb
policy/v1
true
PodDisruptionBudget
podsecuritypolicies
psp
policy/v1beta1
false
PodSecurityPolicy
clusterrolebindings
rbac.authorization.k8s.io/v1
false
ClusterRoleBinding
clusterroles
rbac.authorization.k8s.io/v1
false
ClusterRole
rolebindings
rbac.authorization.k8s.io/v1
true
RoleBinding
roles
rbac.authorization.k8s.io/v1
true
Role
priorityclasses
pc
scheduling.k8s.io/v1
false
PriorityClass
csidrivers
storage.k8s.io/v1
false
CSIDriver
csinodes
storage.k8s.io/v1
false
CSINode
csistoragecapacities
storage.k8s.io/v1
true
CSIStorageCapacity
storageclasses
sc
storage.k8s.io/v1
false
StorageClass
volumeattachments
storage.k8s.io/v1
false
VolumeAttachment
Параметри виводу
У наступних розділах описано, як форматувати або сортувати вивід деяких команд. Докладні відомості про те, які команди підтримують різні параметри виводу, див. у довідковій документації kubectl.
Форматування виводу
Типовий формат виводу для всіх команд kubectl – це читабельний текстовий формат. Щоб вивести деталі у вашому терміналі у певному форматі, ви можете додати прапорець -o або --output до підтримуваної команди kubectl.
Синтаксис
kubectl [command][TYPE][NAME] -o <output_format>
Залежно від операції kubectl, підтримуються такі формати виводу:
Формат виводу
Опис
-o custom-columns=<spec>
Вивести таблицю, використовуючи розділений комою список власних стовпців.
-o custom-columns-file=<filename>
Вивести таблицю, використовуючи шаблон власних стовпців у файлі <filename>.
Вивести у текстовому форматі з будь-якою додатковою інформацією. Для Podʼів додається імʼя вузла.
-o yaml
Вивести обʼєкт API у форматі YAML. KYAML є специфічним для Kubernetes діалектом YAML, і може читатись як YAML.
Приклад
У цьому прикладі така команда виводить інформацію про один Pod як обʼєкт у форматі YAML:
kubectl get pod web-pod-13je7 -o yaml
Нагадування: Дивіться довідку kubectl для отримання деталей щодо підтримуваних форматів виводу для кожної команди.
Власні стовпці
Щоб визначити власні стовпці та виводити лише ті деталі, які вам потрібні у вигляді таблиці, ви можете використовувати параметр custom-columns. Власні стовпці можна визначити безпосередньо в команді або у файлі шаблону: -o custom-columns=<spec> або -o custom-columns-file=<filename>.
Приклади
Безпосередньо в команді:
kubectl get pods <pod-name> -o custom-columns=NAME:.metadata.name,RSRC:.metadata.resourceVersion
Файл шаблону:
kubectl get pods <pod-name> -o custom-columns-file=template.txt
де template.txt містить:
NAME RSRC
metadata.name metadata.resourceVersion
Результат виконання будь-якої з команд буде подібний до:
NAME RSRC
submit-queue 610995
Стовпці на стороні сервера
kubectl підтримує отримання від сервера інформації про стовпці для обʼєктів. Це означає, що для будь-якого заданого ресурсу сервер поверне стовпці та рядки, що стосуються цього ресурсу, а клієнт їх виведе. Це дозволяє отримати послідовний, зручний для читання вивід для різних клієнтів, які використовуються для одного і того ж кластера, оскільки деталі виведення інкапсулює сервер.
Ця можливість типово увімкнена. Щоб вимкнути її, додайте прапорець --server-print=false до команди kubectl get.
Приклади
Щоб вивести інформацію про стан Podʼа, використовуйте команду на зразок такої:
kubectl get pods <pod-name> --server-print=false
Вивід буде подібний до:
NAME AGE
pod-name 1m
Сортування списку обʼєктів
Щоб вивести обʼєкти у відсортованому списку у вашому вікні термінала, ви можете додати прапорець --sort-by до підтримуваної команди kubectl. Впорядкуйте ваші обʼєкти, вказавши будь-яке числове чи рядкове поле з прапорцем --sort-by. Для вказання поля використовуйте вираз jsonpath.
Щоб вивести список Podʼів, відсортованих за назвами, виконайте:
kubectl get pods --sort-by=.metadata.name
Приклади: Загальні операції
Використовуйте цей набір прикладів, щоб ознайомитися з тим, як використовувати найпоширеніші операції kubectl:
kubectl apply — Застосувати або оновити ресурс із файлу чи stdin.
# Створити Service, використовуючи визначення у файлі example-service.yaml.kubectl apply -f example-service.yaml
# Створити контролер реплікації, використовуючи визначення у файлі example-controller.yaml.kubectl apply -f example-controller.yaml
# Створити обʼєкти, які визначені у файлах з розширеннями .yaml, .yml, або .json у теці <directory>.kubectl apply -f <directory>
kubectl get — Вивести список одного чи кількох ресурсів.
# Показати всі Podʼи у форматі звичайного тексту.kubectl get pods
# Показати всі Podʼи у форматі звичайного тексту з додатковою інформацією (наприклад, імʼям вузла).kubectl get pods -o wide
# Показати контролер реплікації із вказаним імʼям у форматі звичайного тексту. Порада: Ви можете скоротити та замінити тип ресурсу 'replicationcontroller' на скорочену назву 'rc'.kubectl get replicationcontroller <rc-name>
# Показати всі контролери реплікації та Service разом у форматі звичайного тексту.kubectl get rc,services
# Показати всі DaemonSet у форматі звичайного тексту.kubectl get ds
# Показати всі Podʼи, які працюють на вузлі server01kubectl get pods --field-selector=spec.nodeName=server01
kubectl describe — Показати детальний стан одного чи кількох ресурсів, типово включно з тими, що ще не ініціалізовані.
# Показати деталі вузла із імʼям <node-name>.kubectl describe nodes <node-name>
# Показати деталі Podʼа із імʼям <pod-name>.kubectl describe pods/<pod-name>
# Показати деталі всіх Podʼів, якими керує контролер реплікації з іменем <rc-name>.# Памʼятайте: Будь-які Podʼи, які створює контролер реплікації, отримують префікс із імʼям контролера реплікації.kubectl describe pods <rc-name>
# Описати всі Podʼиkubectl describe pods
Примітка:
Команда kubectl get зазвичай використовується для отримання одного чи кількох ресурсів того ж типу ресурсу. Вона має багатий набір прапорців, що дозволяють налаштовувати формат виводу за допомогою прапорця -o або --output, наприклад. Ви можете вказати прапорець -w або --watch, щоб почати слідкування за оновленнями для певного обʼєкта. Команда kubectl describe більше фокусується на описі багатьох повʼязаних аспектів вказаного ресурсу. Вона може робити кілька викликів до API-сервера для побудови виводу для користувача. Наприклад, команда kubectl describe node отримує не тільки інформацію про вузол, але й підсумок Podʼів, які працюють на ньому, події, створені для вузла, і т. д.
kubectl delete — Видалити ресурси або з використанням файлу, або з stdin, або вказавши селектори міток, імена, селектори ресурсів чи самі ресурси.
# Видалити Pod, використовуючи тип та імʼя, вказане у файлі pod.yaml.kubectl delete -f pod.yaml
# Видалити всі Podʼи та Service із міткою '<label-key>=<label-value>'.kubectl delete pods,services -l <label-key>=<label-value>
# Видалити всі Podʼи, включаючи неініціалізовані.kubectl delete pods --all
kubectl exec — Виконати команду у контейнері Podʼа.
# Отримати вивід виконання команди 'date' у Podʼі <pod-name>. Типово виводиться результат з першого контейнера.kubectl exec <pod-name> -- date
# Отримати вивід виконання команди 'date' у контейнері <container-name> Podʼа <pod-name>.kubectl exec <pod-name> -c <container-name> -- date
# Отримати інтерактивний TTY та виконати /bin/bash у Podʼі <pod-name>. Типово виводиться результат з першого контейнера.kubectl exec -ti <pod-name> -- /bin/bash
kubectl logs — Вивести логи для контейнера у Podʼі.
# Отримати знімок логів з Podʼа <pod-name>.kubectl logs <pod-name>
# Почати виведення логів у режимі стрічки з Podʼа <pod-name>. Це схоже на команду 'tail -f' у Linux.kubectl logs -f <pod-name>
kubectl diff — Переглянути відмінності запропонованих оновлень кластера.
Використовуйте цей набір прикладів, щоб ознайомитися із написанням та використанням втулків kubectl:
# створіть простий втулок будь-якою мовою та назвіть отриманий виконуваний файл# так, щоб його назва починалася з префікса "kubectl-"cat ./kubectl-hello
#!/bin/sh
# цей втулок виводить слова "hello world"echo"hello world"
Коли втулок написано, зробімо його виконуваним:
chmod a+x ./kubectl-hello
# та перемістіть його в місце, яке є у вашому шляху (PATH)sudo mv ./kubectl-hello /usr/local/bin
sudo chown root:root /usr/local/bin
# Тепер ви створили та "встановили" втулок kubectl.# Ви можете почати використовувати цей втулок, викликаючи його з kubectl, ніби це звичайна командаkubectl hello
hello world
# Ви можете "вилучити" втулок, видаливши його з теки у вашому# $PATH, де ви його розмістилиsudo rm /usr/local/bin/kubectl-hello
Щоб переглянути всі втулки, доступні для kubectl, використовуйте команду kubectl plugin list:
kubectl plugin list
Вивід буде схожий на:
The following kubectl-compatible plugins are available:
/usr/local/bin/kubectl-hello
/usr/local/bin/kubectl-foo
/usr/local/bin/kubectl-bar
kubectl plugin list також попереджає вас про втулки, які не мають прав на виконання, або які затінені іншими втулками; наприклад:
sudo chmod -x /usr/local/bin/kubectl-foo # прибрати дозвіл на виконанняkubectl plugin list
The following kubectl-compatible plugins are available:
/usr/local/bin/kubectl-hello
/usr/local/bin/kubectl-foo
- warning: /usr/local/bin/kubectl-foo identified as a plugin, but it is not executable
/usr/local/bin/kubectl-bar
error: one plugin warning was found
Втулки можна розглядати як спосіб будувати складнішу функціональність на основі наявних команд kubectl:
cat ./kubectl-whoami
У наступних кількох прикладах припускається, що файл kubectl-whoami вже має такий вміст:
#!/bin/bash
# цей втулок використовує команду `kubectl config` для виведення# інформації про поточного користувача, на основі вибраного контекстуkubectl config view --template='{{ range .contexts }}{{ if eq .name "'$(kubectl config current-context)'" }}Current user: {{ printf "%s\n" .context.user }}{{ end }}{{ end }}'
Запуск вищезазначеної команди дає вам вивід із зазначенням користувача для поточного контексту у вашому файлі KUBECONFIG:
# зробіть файл виконуванимsudo chmod +x ./kubectl-whoami
# та перемістіть його в теку з вашого PATHsudo mv ./kubectl-whoami /usr/local/bin
kubectl whoami
Current user: plugins-user
13.3 - Налаштування користувача для kubectl (kuberc)
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.34
Файл конфігурації Kubernetes kuberc дозволяє визначити налаштування для kubectl, такі як типові параметри та псевдоніми команд. На відміну від файлу kubeconfig, файл конфігурації kubercне містить відомостей про кластер, імен користувачів або паролів.
У системах Linux/POSIX типове розташування цього файлу конфігурації — $HOME/.kube/kuberc. У Windows типовий шлях схожий: %USERPROFILE%\.kube\kuberc. Щоб вказати kubectl шлях до власного файлу kuberc, скористайтеся параметром командного рядка --kuberc або встановіть змінну середовища KUBERC.
Файл kuberc, що використовує формат kubectl.config.k8s.io/v1beta1, дозволяє визначити такі типи налаштувань користувача:
Aliases — дозволяють створювати коротші версії ваших улюблених команд, за бажанням встановлюючи параметри та аргументи.
Defaults — дозволяють налаштовувати типові значення параметрів для ваших улюблених команд.
У конфігурації kuberc секція aliases дозволяє вам визначити власні скорочення для команд kubectl, за бажанням з попередньо встановленими аргументами та прапорцями командного рядка.
Наступний приклад визначає псевдонім kubectl getn для підкоманди kubectl get, додатково вказуючи формат виводу JSON: --output=json.
name — Імʼя псевдоніма не повинно збігатися з вбудованими командами.
command — Вкажіть вбудовану команду, яку буде виконувати ваш псевдонім. Це включає підтримку підкоманд, таких як create role.
options — Вкажіть типові значення для параметрів. Якщо ви явно вкажете параметр під час виконання kubectl, значення, яке ви надасте, матиме пріоритет над типовим значенням, визначеним у kuberc.
З цим псевдонімом виконання kubectl getn pods типово виведе JSON. Однак, якщо ви виконаєте kubectl getn pods -oyaml, вивід буде у форматі YAML.
Цей приклад розширює попередній, вводячи секцію prependArgs, яка дозволяє вставляти довільні аргументи безпосередньо після команди kubectl та її підкоманди (якщо така є).
name — Імʼя псевдоніма не повинно збігатися з вбудованими командами.
command — Вкажіть вбудовану команду, яку буде виконувати ваш псевдонім. Це включає підтримку підкоманд, таких як create role.
options — Вкажіть типові значення для параметрів. Якщо ви явно вкажете параметр під час виконання kubectl, значення, яке ви надасте, матиме пріоритет над типовим значенням, визначеним у kuberc.
prependArgs — Вкажіть явний аргумент, який буде розміщено відразу після команди. Тут це буде перетворено на kubectl get namespace test-ns --output json.
appendArgs
Цей приклад представляє механізм, подібний до вставлення аргументів на початок, але цього разу ми додаватимемо аргументи в кінець команди kubectl.
name — Імʼя псевдоніма не повинно збігатися з вбудованими командами.
command — Вкажіть вбудовану команду, яку буде виконувати ваш псевдонім. Це включає підтримку підкоманд, таких як create role.
options — Вкажіть типові значення для параметрів. Якщо ви явно вкажете параметр під час виконання kubectl, значення, яке ви надасте, матиме пріоритет над типовим значенням, визначеним у kuberc.
appendArgs — Вкажіть явні аргументи, які будуть розміщені в кінці команди. Тут це буде перетворено на kubectl run test-pod --namespace test-ns --image busybox -- custom-arg.
defaults
У рамках конфігурації kuberc секція defaults дозволяє вказати типові значення для аргументів командного рядка.
Цей приклад робить інтерактивне видалення типовим режимом для виклику kubectl delete:
command — Вбудована команда, це включає підтримку підкоманд, таких як create role.
options — Вкажіть типові значення для параметрів. Якщо ви явно вкажете параметр під час виконання kubectl, значення, яке ви надасте, матиме пріоритет над типовим значенням, визначеним у kuberc.
З цим налаштуванням, виконання kubectl delete pod/test-pod типово запитуватиме підтвердження. Однак, kubectl delete pod/test-pod --interactive=false обійде підтвердження.
Політика втулків облікових даних
СТАН ФУНКЦІОНАЛУ:Beta since Kubernetes v1.35
Ті, хто редагує kubeconfig, можуть вказати виконуваний втулок, який буде використовуватися для отримання облікових даних для автентифікації клієнта в кластері. У конфігурації kuberc ви можете встановити політику виконання для таких втулків за допомогою двох полів верхнього рівня. Обидва поля є необовʼязковими.
credentialPluginPolicy
Ви можете налаштувати політику для втулків облікових даних, використовуючи необовʼязкове поле credentialPluginPolicy. Для цього поля існує три допустимі значення:
"AllowAll"
Коли політика встановлена на "AllowAll", не буде жодних обмежень щодо того, які втулки можуть працювати. Ця поведінка така сама, як у версіях Kubernetes до 1.35.
"DenyAll"
Коли політика встановлена на "DenyAll", жодному втулку exec не буде дозволено запускатися.
"Allowlist"
Коли політика встановлена на "Allowlist", користувач може вибірково дозволяти виконання втулків облікових даних. Коли політика встановлена на "Allowlist", ви повинні також вказати поле credentialPluginAllowlist (також на верхньому рівні). Це поле описано нижче.
Примітка:
Для збереження зворотної сумісності невизначена або порожня credentialPluginPolicy рівнозначна явному встановленню політики на "AllowAll".
credentialPluginAllowlist
Примітка:
Встановлення цього поля, коли credentialPluginPolicy не є Allowlist (включно з випадками, коли це поле відсутнє або порожнє), вважається помилкою конфігурації.
Поле credentialPluginAllowlist визначає список наборів критеріїв (наборів вимог) для дозволу на виконання втулків облікових даних. Кожен набір вимог буде перевірятися по черзі; як тільки втулок відповідатиме всім вимогам хоча б одного набору, йому буде дозволено виконуватися. Тобто загальний результат застосування allowlist до втулка my-binary-plugin є логічним АБО рішень, прийнятих для кожного елемента списку.
Як приклад, розглянемо таку конфігурацію списку дозволених втулків:
В наведеному вище прикладі allowlist дозволить втулки з командами "foo", "bar", АБО "baz".
Примітка:
Щоб набір вимог був дійсним, він повинен мати принаймні одне поле, яке не є порожнім і явно вказане. Якщо всі поля порожні або не вказані, це вважається помилкою конфігурації, і втулку не буде дозволено виконуватися. Те саме стосується поля credentialPluginAllowlist, якщо воно не вказане або явно вказане як порожній список. Це зроблено для того, щоб запобігти ситуаціям, коли користувач неправильно вводить ключ credentialPluginAllowlist, думаючи, що вказав список дозволених, хоча насправді цього не зробив.
command задає назву втулка облікових даних, який можна виконувати. Воно може бути вказане як базова назва бажаного втулка або повний шлях. Якщо вказано як базова назва, рішення, прийняте цим полем, буде "allow", якщо виконується одна з двох таких умов:
Поле command точно дорівнює полю command втулка.
Визначення повного шляху виконується як для allowlist command, так і для command втулка, і результати збігаються.
Якщо вказано повний шлях, рішення, прийняте цим полем, є "allow", якщо виконується одна з таких умов:
Поле command точно дорівнює полю command втулка (тобто command втулка також є повним шляхом).
Визначення повного шляху виконується для поля command втулка, і поле command allowlist точно збігається.
Що стосується визначення повного шляху, згаданого раніше на цій сторінці, ні символічні посилання, ні шаблони оболонки (globs) не розкриваються.
Наприклад, розглянемо запис у allowlist з command/usr/local/bin/my-binary, де /usr/local/bin/my-binary є символічним посиланням на /this/is/a/target. Якщо command, вказаний у kubeconfig, є /this/is/a/target, він не буде дозволений. Щоб це працювало, потрібно явно додати /this/is/a/target до allowlist. З іншого боку, якщо kubeconfig має command як /usr/local/bin/my-binary, то allowlist дозволить його запуск.
Примітка:
Поки kuberc перебуває на стадії beta, name може використовуватися як псевдонім для command у записах allowlist. Починаючи з Kubernetes 1.36, name вважається застарілим на користь command. Надання обохname та command в одному записі allowlist вважається помилкою, оскільки ці налаштування критичні для безпеки. Поле name буде повністю вилучено, коли kuberc досягне GA.
Приклад
Приклад нижче показує політику "Allowlist" разом зі списком дозволених втулків:
Керування політикою втулків облікових даних за допомогою kubectl kuberc set
Замість того, щоб редагувати файл kuberc безпосередньо, ви можете використовувати kubectl kuberc set, щоб налаштувати політику втулків облікових даних з командного рядка.
# Встановити політику для заборони всіх втулків облікових данихkubectl kuberc set --section credentialplugin --policy DenyAll
# Встановити політику для дозволу всіх втулків облікових данихkubectl kuberc set --section credentialplugin --policy AllowAll
# Дозволити лише конкретні втулки облікових данихkubectl kuberc set --section credentialplugin \
--policy Allowlist \
--allowlist-entry command=my-trusted-binary \
--allowlist-entry command=my-other-trusted-binary
У цьому прикладі використано такі прапорці:
--section credentialplugin - Вибір секції конфігурації втулків облікових даних.
--policy - Обовʼязково. Встановіть політику на AllowAll, DenyAll або Allowlist.
--allowlist-entry - Обовʼязково, коли --policy=Allowlist. Вкажіть втулок, який потрібно дозволити, у вигляді пар key=value, розділених комами. Наразі підтримується лише ключ command (наприклад, command=<binary-name>), але формат передбачає майбутні додавання, такі як перевірка дайджесту або відкритого ключа. Повторіть цей прапорець, щоб дозволити кілька втулків.
Рекомендовані типові налаштування
Розробники kubectl рекомендують використовувати kuberc з такими типовими налаштуваннями:
Увага:
Якщо ви використовуєте провайдера керованого Kubernetes, перевірте документацію провайдера щодо того, які втулки exec потрібні у вашому середовищі, і замість цього використовуйте політику "Allowlist".
Якщо після встановлення політики "DenyAll", як показано нижче, виникнуть проблеми, перегляньте повідомлення про помилки kubectl, щоб зʼясувати, яким втулкам заборонено запуск, і порівняйте їх з документацією вашого провайдера. Нарешті, змініть політику на "Allowlist" і додайте необхідні втулки в поле credentialPluginAllowlist.
apiVersion:kubectl.config.k8s.io/v1beta1kind:Preferencedefaults:# (1) типово server-side apply- command:applyoptions:- name:server-sidedefault:"true"# (2) типово інтерактивне видалення- command:deleteoptions:- name:interactivedefault:"true"# Перед вибором DenyAll ознайомтеся з наведеною вище приміткою про провайдерів керованого KubernetescredentialPluginPolicy:DenyAll
У цьому прикладі застосовуються такі налаштування:
Типово — інтерактивне видалення щоразу, коли викликається kubectl delete, щоб запобігти випадковому видаленню ресурсів з кластера.
Запуск виконуваних втулків для облікових даних буде заборонено.
Вимкнення kuberc
Щоб тимчасово вимкнути функціональність kuberc, встановіть (і експортуйте) змінну середовища KUBERC зі значенням off:
exportKUBERC=off
або вимкніть функціональну можливість:
exportKUBECTL_KUBERC=false
Це може допомогти зʼясувати, чи не спричиняє проблему ваш kuberc.
14 - Інструменти компонентів
15 - Налагодження кластера
16 - Конфігураційні API
17 - Зовнішні API
18 - API kubelet
19 -
Стани життєвого циклу вузла
СТАН ФУНКЦІОНАЛУ:Alpha since Kubernetes v1.37; (стандартно вимкнено)
More information about this feature
To use this feature, you (or a cluster administrator) will need to enable the NodeLifecycleConditions feature gate for all relevant components in your cluster.
Стани життєвого циклу вузла повідомляють, чи проходить вузол через подію життєвого циклу, як-от drain, обслуговування або коректне вимкнення вузла (Graceful Node Shutdown). Вони дають спільний сигнал, який адміністратори кластера, контролери та сторонні інструменти можуть використовувати для керування життєвим циклом.
Доступні такі загальновідомі стани життєвого циклу:
Стани життєвого циклу вузла та їх значення.
Стан
Опис
DrainInProgress
Для вузла зараз виконується drain відповідно до обраних адміністратором критеріїв drain.
Drained
Вузол досяг обраних адміністратором критеріїв drain.
MaintenancePlanned
Очікується, що вузол зазнає змін у майбутньому. Якщо зміни впливають на робочі навантаження, виконайте drain вузла перед початком обслуговування.
MaintenanceInProgress
Вузол зараз проходить обслуговування. Обслуговування може включати розгортання апаратного або програмного забезпечення, усунення проблем, виведення з експлуатації або налагодження.
GracefulNodeShutdownInProgress
Визначено, що на вузлі триває коректне вимкнення вузла.
Поле status кожного стану життєвого циклу має таке значення:
True: стан життєвого циклу, про який повідомляє цей стан, зараз спостерігається.
False: стан життєвого циклу, про який повідомляє цей стан, зараз не спостерігається.
Unknown: той, хто записує стан, не може визначити, чи активний стан життєвого циклу.
Стани життєвого циклу — це спостереження, які дають корисний контекст щодо стану життєвого циклу вузла. Наприклад, використовуйте MaintenancePlanned, щоб повідомити, що вузол може перейти в обслуговування в майбутньому, або Drained, щоб повідомити, що обраних адміністратором критеріїв drain досягнуто.
Поле reason вказує, чому стан має свій поточний статус. Ті, хто записує стани, мають використовувати для reason стабільні значення у стилі CamelCase. Поле message може містити додаткові подробиці, зрозумілі людині.
Цей приклад повідомляє, що для вузла заплановано обслуговування:
status:conditions:- type:MaintenancePlannedstatus:"True"reason:MaintenanceWindowmessage:"Hardware maintenance is scheduled for this Node"lastTransitionTime:"2026-07-20T14:00:00Z"
Запис станів життєвого циклу
Адміністратор або контролер, уповноважений адміністратором, відповідає за встановлення та очищення станів життєвого циклу на вузлі.
Той, хто записує стан, визначає, коли стан життєвого циклу активний. Коли стан більше не активний, він встановлює для стану значення False або видаляє його.
Kubernetes не визначає виключного володіння записом, блокувань чи передачі між учасниками. Ті, хто записує стани, мають узгоджувати володіння поза цим API.
Примітка:
Основні контролери робочих навантажень не змінюють свою поведінку залежно від станів життєвого циклу. Встановлення стану життєвого циклу не впливає на основну поведінку вузла.
Наявні механізми керування життєвим циклом і далі слід використовувати:
Використовуйте kubectl cordon або встановіть .spec.unschedulable, щоб запобігти звичайному плануванню на вузол.
Використовуйте kubectl drain, щоб безпечно виселити Podʼи перед виведенням вузла з експлуатації.
Використовуйте taints і tolerations, щоб керувати плануванням Podʼів і політикою виселення.
Перегляд станів життєвого циклу
Використовуйте kubectl describe node, щоб переглянути всі стани вузла:
kubectl describe node <node-name>
Щоб вивести тип і статус кожного стану, використовуйте:
kubectl get node <node-name> \
-o jsonpath='{range .status.conditions[*]}{.type}={.status}{"\n"}{end}'
20 - Рекомендації з перекладу українською мовою
Дорогі друзі! Раді вітати вас у спільноті українських контриб'юторів проекту Kubernetes. Ця сторінка створена з метою полегшити вашу роботу при перекладі документації. Вона містить правила, якими ми керувалися під час перекладу, і базовий словник, який ми почали укладати. Перелічені у ньому терміни ви знайдете в українській версії документації Kubernetes. Будемо дуже вдячні, якщо ви допоможете нам доповнити цей словник і розширити правила перекладу.
Сподіваємось, наші рекомендації стануть вам у пригоді.
Загальний процес
Виберіть одне з найбільш витребуваних ішьюзів або будь-яке ішью і залиште в ньому коментар на кшталт "Працюю над цим". Ми надішлемо вам запрошення до організації та закріпимо цей ішьюз за вами.
Якщо ви виявили проблеми з перекладеним вмістом і не можете негайно їх виправити, створіть ішью у k/website з описом що не так, на якій сторінці (посилання) і додайте в опис ішью з нового рядка /language uk.
Скопіюйте оригінал і додайте його перед перекладом у якості коментаря. Це потрібно для спрощення відслідковування змін і процесу ревью. Приклади: для Markdown, для YAML.
У випадку, якщо у перекладі термін набуває неоднозначності і розуміння тексту ускладнюється, надайте у дужках англійський варіант, наприклад: кінцеві точки (endpoints). Якщо при перекладі термін втрачає своє значення, краще не перекладати його, наприклад: характеристики affinity.
Назви об'єктів Kubernetes залишаємо без перекладу і пишемо з великої літери: Service, Pod, Deployment, Volume, Namespace, за винятком терміна node (вузол). Назви об'єктів Kubernetes вважаємо за іменники ч.р. і відмінюємо за допомогою апострофа: Pod'ів, Deployment'ами.
Для слів, що закінчуються на приголосний, у родовому відмінку однини використовуємо закінчення -а: Pod'а, Deployment'а.
Слова, що закінчуються на голосний, не відмінюємо: доступ до Service, за допомогою Namespace. У множині використовуємо англійську форму: користуватися Services, спільні Volumes.
Частовживані і усталені за межами Kubernetes слова перекладаємо українською і пишемо з малої літери (label -> мітка). У випадку, якщо термін для означення об'єкта Kubernetes вживається у своєму загальному значенні поза контекстом Kubernetes (service як службова програма, deployment як розгортання), перекладаємо його і пишемо з малої літери, наприклад: service discovery -> виявлення сервісу, continuous deployment -> безперервне розгортання.
Складені слова вважаємо за власні назви і не перекладаємо (LabelSelector, kube-apiserver).
Для перевірки закінчень слів у родовому відмінку однини (-а/-я, -у/-ю) використовуйте онлайн словник. Якщо слова немає у словнику, визначте його відміну і далі відмінюйте за правилами. Докладніше дивіться тут.